OpenAI等硅谷研究员辨识主流大模型频翻车
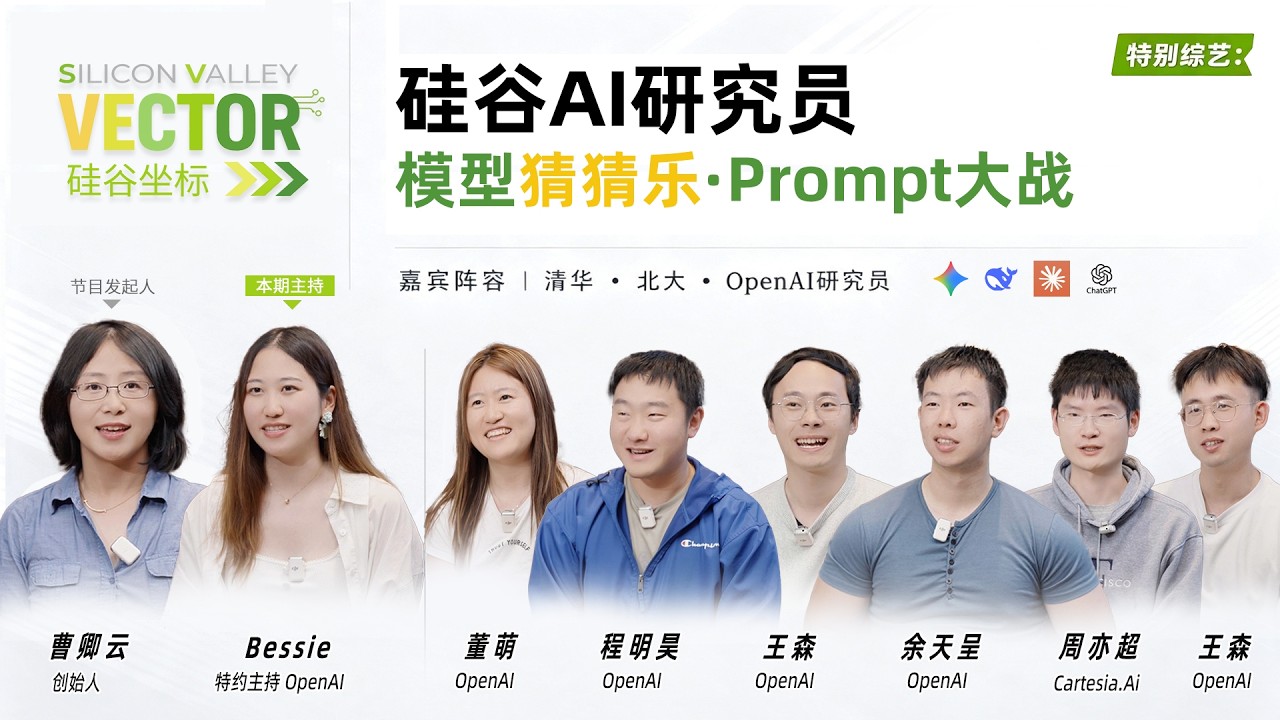
【特别综艺-下】硅谷AI研究员|模型猜猜乐和Prompt大战 — Silicon Valley Vector 硅谷坐标

Silicon Valley Vector 硅谷坐标

各家大模型输出风格与能力日趋同质化,即便是顶级研究员也难以凭生成文本精准区分模型来源。

AI-assisted summary of 【特别综艺-下】硅谷AI研究员|模型猜猜乐和Prompt大战 — original source. Check the original for full context.

Source published:

Detailed notes

## Background 本内容由 YouTube 频道“Silicon Valley Vector 硅谷坐标”于 2026 年 7 月 19 日发布。节目简介显示,本期特别综艺邀请了六位硅谷一线的 AI 研究员(主要来自 OpenAI),通过“模型猜猜乐”与“Prompt 大战”游戏,探讨公众对 AI 的误解、中美研究员差异、个人财务与 FIRE 等硬核兼趣闻话题。

## TL;DR 节目中,六位 OpenAI 等硅谷顶尖机构的研究员分组参加了 AI 模型盲猜与让模型“思考最久”的 Prompt 大战。在轻松的游戏互动中,他们分享了开新对话框、利用 sub-agents 等 AI 使用技巧,澄清了“新模型发布前旧模型被偷摸调笨”等公众迷思,并探讨了中美 AI 研发资源与对齐成本的异同。此外,研究员们还坦诚地讨论了公司上市后的持股策略以及打破攀比心态才是实现真正的 FIRE 的关键。

## Atmosphere & style 全片氛围欢快而接地气,将高深的前沿 AI 讨论融入到轻松不失风趣的综艺游戏之中。来自 OpenAI 等顶尖机构的研究员们褪去了技术精英的严肃光环,在盲猜翻车时展现出真实可爱的一面,主持与嘉宾之间的互动自然流畅、笑点不断。整场节目既有硬核技术人对模型行为的犀利洞察,又有对现实生活与股票财富的接地气交流,充满温情而又富有启发性。

## Key takeaways - [02:50](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=170s) 使用大模型时应避免长时间在同一个对话框交流,频繁开启新对话框可规避 Context 衰减与 Compaction 带来的逻辑错乱或降智问题 - [02:50](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=170s) 高级 AI 使用技巧包含先让模型列出 Plan 计划,再通过指令启动多个 sub-agents 并行处理任务 - [08:53](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=533s) 公众普遍误解“新模型发布前旧模型会被偷偷变笨”,事实上这源于用户心理预期的波动与提示词稳定性差异,团队鼓励点击手势向下(Thumbs Down)反馈信号 - [08:53](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=533s) AI 的智能分布极不均匀,人类觉得简单的任务可能需要大量迭代,而针对某些复杂的法律报销和海外行程规划已有成熟的应用场景 - [14:09](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=849s) 语音 Agent 等 AI 技术已渗透至银行业务等日常生活,但全能 AGI 的实现仍需等待机器人(Robotics)技术的进一步突破 - [17:42](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=1062s) 中美 AI 研究员在前沿领域(如 Scaling Law 和 RL 强化学习)的底层认知高度一致,主要差异在于美国团队算力资源更丰富,而国内团队在有限资源下的工程精细度与全华人沟通效率更高 - [20:39](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=1239s) 对于公司上市后的股票分配,研究员在长期持有与及时变现分散配置上存在观点分歧,但普遍认可目前大模型巨头的合理估值 - [23:08](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=1388s) 财务自由(FIRE)的实现核心不在于具体资产数字(如 200 万美金或捐赠教授岗位的 600-800 万美金),而在于能否停止攀比并建立健康的心理状态 - [28:07](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=1687s) 在 Prompt 大战中,能够让 Reasoning 模型思考最久的有效策略是设计高可验证性(Verifiable)、含严格筛选指标与多工具调用(Tool Use)的任务 - [28:07](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=1687s) 即使是硅谷顶尖的 AI 研究员也经常难以分辨不同大模型的输出风格,这反映出当前各头部模型在回答风格与能力上正趋于同质化

## Detailed walkthrough ### [00:00](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=0s) 开场集锦与游戏规则

节目开场由节目精华片段剪辑而成,六位站在硅谷 AI 风暴中心的研究员——**程明昊**(Post-Training 团队,负责 Eval 评估)、**余天呈**(后训练团队)、**周奕超**(刚加入 Cartesia.ai,做 Voice Agent/ASR)、**董萌**(Infra 团队,负责 GPU Scheduling)、**王森**(负责 Memory 与个性化研究)以及 **吴月忻 (Crick)**(负责 Reasoning/Test-time Scaling)——齐聚一堂。特约主持人 **Bessie**(OpenAI 后训练)宣布今天大家“不上班”,一起玩两轮游戏:“模型猜猜乐”与“Prompt 大战”。

第一轮游戏规则为两组轮流抢答:根据给定 Prompt 和模型的回答,猜出其究竟来自 GPT、Claude、Gemini 还是 DeepSeek。猜错的一组需接受真心话惩罚,猜对则由对方全组接受惩罚。

[02:50](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=170s) 猜模型第一题与真心话:AI 实用小技巧

第一题的 Prompt 为询问“硅谷坐标现在有几期节目”。经过讨论后,一组抢答说是 DeepSeek,理由是中文表达流畅,但遗憾答错;随后该组改猜 GPT,认为其事实准确度(Factuality)较高,但再次猜错。最终对方组凭回答简短(像 Flash 模型)且带有 Highlight 样式的特点,成功猜中答案为 **Gemini**。

落败组接受惩罚,分享了各自日常最频繁使用的 AI 小技巧: * **程明昊**:大力推荐使用 OpenAI Codex。解决不懂的问题时,先让模型列出一个 Plan(计划),手动修改后再指令其“Spin up multiple sub-agents to parallelize”(启动多个子 Agent 并行处理),并强调多让模型写文档做记录。 * **余天呈**与**周奕超**:提醒大家谨防长对话中的 Context 衰减问题。与其在一个对话框里无休止地聊下去导致模型“降智”或陷入虚幻,不如频繁开新对话框,模型依然能记住上下文,且响应更快、更准。 * **董萌**:分享了 Infra 工程师的极简用法——已经很久不手动提交 Job 或读 Joblog 了,全权交由 AI 帮自己写 Job 和阅读日志。

- **天呈提示**:在同一个 Conversation 聊天时间过长会导致上下文 Compaction(压缩)失败,引发模型出现逻辑错乱或遗忘。 - **效率建议**:善用小工具拆分任务,避免长文本的性能损耗。

[08:53](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=533s) 猜模型第二题 & 第三题:公众误解与“降智”迷思

第二题询问“SpaceX 股票现在该不该买”。嘉宾们起初推测 GPT 和 Claude 在财务和投资建议上会极度谨慎(Safety 机制严格),因此盲猜 DeepSeek 或 Gemini Flash,最终证实为 **Gemini 3.5 Flash**。第三题为推荐放假目的地,各组针对换行符、括号使用频次以及 Food-mode point 的风格展开推理,最终认出是 **Claude 4.6 Sonnet** 的输出风格。

在真心话环节,主持人提出了一个硬核问题:“公众对贵司 AI 误解最多的点是什么?比如新模型发布前旧模型会被偷偷变笨(降智)?”

研究员们给出了直观的澄清与内部观察: 1. **能力分布不均**:公众的预期往往呈极化状态——要么觉得 AI 无所不能,要么觉得极其愚蠢。事实上,模型的智能分布极不均匀,很多人类看似极其简单的事情,模型要做好其实需要大量后台迭代。 2. **“偷摸变笨”是错觉**:针对“发布新模型前旧模型被降智”的传言,研究员明确澄清**并非如此**。这种观感多源于用户自身心理预期的波动(对同一答案在不同时期的满意度不同),以及模型在不同提示词下的输出稳定性差异。 3. **鼓励 Thumbs Down**:团队会密切关注社交媒体与 E-user 反馈,若发现模型出现不佳行为,会通过迭代语调去消除。鼓励用户积极点击“手势向下”按钮以提供优质训练信号。

[14:09](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=849s) 猜模型第四题:用 AI 解决生活问题与 Voice Agent

第四题 Prompt 为“预测世界杯冠军是谁”。由于该回答包含大量免责声明(Disclaimer)且排版非常 Pros(散文风格),最终被准确识别为 **Claude**。

输掉本轮的嘉宾分享了如何用 AI 处理复杂的日常生活事务: * **旅行与报销邮件**:利用 AI 规划欧洲跨国行程;或在遇到航空公司积分未到账、报销拖延时,让 AI“有理有节”地梳理所有证据链,自动撰写并寄送正式信函给 CEO。 * ** Voice Agent 与 Agent 的真实渗透**:周奕超(Cartesia.ai)提到,AI 改变生活已发生在细微处——例如打电话给 Chase 银行申请关卡,接线客服很大概率已经是语音 Agent。虽然真正全能的 AGI 还需要等待 Robotics(机器人技术)的突破,但在 Coding 和特定日常任务上,替代已经发生。

[17:42](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=1062s) 猜模型第五题:中美 AI Researcher 的最大差异

第五题关于“如何抢到富慧华(高端餐厅)的座位”,模型因输出了无实质内容却看似丰富的排版被一眼认出是 **GPT**;第六题要求“300字内用高中生能懂的话解释 Transformer”,最终确认为 **DeepSeek**。

在谈及“中美 AI Researcher 最大的差异”时,来自 OpenAI 与硅谷一线团队的研究员们给出了非常诚挚的见解: * **共识远大于分歧**:在顶尖前沿领域(如 Scaling Law、RL 强化学习),中美最优秀研究者的底层认知与共识是高度一致的。 * **资源与环境侧重不同**:美国团队的优势在于算力与实验资源极为丰富,能够跑更多大尺度实验;而国内团队在资源相对有限时,往往能将工程和实验做得很细。 * **文化与沟通效率**:国内团队全华人背景使得沟通非常顺畅高效;而硅谷(如 OpenAI)人才背景高度多元化,在团队 Alignment(对齐)与沟通上需要投入更多成本,但也带来了多元的视角。

[20:39](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=1239s) 猜模型第六题:股票卖不卖与多少钱可以 FIRE?

迎来了全场氛围最活跃的“真心话”连环发问:

**1. OpenAI 上市后股票卖不卖?** * **王森与天呈**:表示会视价格而定,但倾向于长期持有,认为目前几家大模型巨头的估值合理。 * **Crick (吴月忻)**:斩钉截铁表示“肯定卖!”他打趣道,大家在未上市公司苦苦等待这么久,就是为了充实生活,必须把握机会变现,然后再将资金分散配置到其他模型公司的股票中,切忌“All-in 单一标的”。

**2. 多少钱可以 FIRE(财务自由)?** * **捐赠教授岗位视角**:若按捐赠一个 University Professor 席位来算,大约需要 600 万至 800 万美元,用投资收益覆盖薪资。 * **心态与阶级比较**:有嘉宾认为 200 万美金在老家(如成都)就已经足够过上优渥的生活。但大家一致认同,FIRE 的核心不在于数字(1000 万还是更多),而在于心态上能否停止与他人进行比较——一旦进入更高财富阶层并持续攀比,就永远无法达到心理上的绝对自由。

[28:07](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=1687s) 终局 Prompt 大战:谁能让模型思考得更久?

节目终局进入特别游戏“Prompt 大战”。两组队员需要在 300 字以内的限制下(限制 30 个字中文 Prompt),针对 **ChatGPT 5.5 Thinking High** 模型编写 Prompt,比拼谁能让模型思考(Thinking)的时间最长。

六位研究员在场下展开了激烈的思路博弈: * **无效策略**:直接要求模型计算圆周率到极端位数,或提出违规指令,会被模型直接拒绝(Reject)或触发搜索。 * **有效策略**:设计具有“高 Verifiable(可验证性)”的任务,限制具体的筛选指标、格式与数量,强制模型执行多次耗时的工具调用(Tool Use)与推理。

最终两组给出的 Prompt 如下: * **A 组 Prompt**:“搜索 NIPS 成立每年引用量最高的 90 篇论文,并总结成 Doc,自行详细思考。” * **B 组 Prompt**:“查询至少 100 个网页,给个研究报告,多少钱才能财务自由,思考尽可能长。”

**比赛结果**: A 组利用严格的筛选条件(每年 90 篇顶级论文)成功触发了深度推理与多次工具检索,模型 **Thinking 时间长达 6 分 24 秒**;而 B 组仅引发了 **1 分 23 秒** 的思考。A 组凭绝对优势赢得 Prompt 大战。

Bessie 总结道,即使是顶尖的 OpenAI 研究员,在面对各家模型回答时也极难达成一致、经常“翻车”,这表明各大模型在输出风格与能力上正变得越来越趋同。节目在欢笑声中圆满落幕。

<FollowUp label="想了解几位 OpenAI 研究员提到的 Test-time Scaling 和 RL 强化学习细节吗?" query="请结合视频中 Crick 提到的 Test-time Scaling,详细解释什么是推理时扩展以及它与 Scaling Law 的关系。"/>

## Notable quotes > [02:50](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=170s) Spin up multiple sub-agents to parallelize — 程明昊

> [08:53](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=533s) 在新模型发布前,旧模型被偷偷调笨 — Bessie

> [02:50](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=170s) 先让它列个 plan,再拆给 sub agents — 程明昊

> [02:50](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=170s) 别在同一个对话框聊到底,开新窗口更快更准 — 余天呈

> [20:39](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=1239s) 肯定卖! — 吴月忻 Crick

> [28:07](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=1687s) 搜索 NIPS 成立每年引用量最高的 90 篇论文,并总结成 Doc,自行详细思考。 — A 组

> [28:07](https://www.youtube.com/watch?v=yDy6nTPoAbw&t=1687s) 查询至少 100 个网页,给个研究报告,多少钱才能财务自由,思考尽可能长。 — B 组

## Mentioned OpenAI, Claude, Gemini, DeepSeek, GPT, Cartesia.ai, Bessie, 董萌, 王森, 吴月忻, 周奕超, 余天呈, 程明昊, 清华大学, 清华姚班, CMU, MIT, 北大, 哥大, UC Berkeley, SpaceX, Chase 银行, NIPS, Gemini 3.5 Flash, Claude 4.6 Sonnet, ChatGPT 5.5 Thinking High, OpenAI Codex

[Source](https://www.youtube.com/watch?v=yDy6nTPoAbw)

中文简报

OpenAI等硅谷研究员辨识主流大模型频频翻车 各家大模型输出风格与能力日趋同质化,即便是顶级研究员也难以仅凭生成文本精准区分模型来源。 节目中,六位来自 OpenAI 等硅谷顶尖机构的研究员分组参加了 AI 模型盲猜与让模型“思考最久”的 Prompt 大战。在轻松的游戏互动中,他们分享了频繁开启新对话框、利用 sub-agents 等 AI 使用技巧,澄清了“新模型发布前旧模型会被偷偷调笨”等公众迷思,并探讨了中美 AI 研发资源与对齐成本的异同。此外,研究员们还坦诚讨论了公司上市后的持股策略,并指出打破攀比心态才是实现真正 FIRE 的关键。 针对大模型使用技巧,研究员建议避免在同一个对话框无休止长聊,以规避上下文 Compaction 失败导致的降智与遗忘,并推荐先让 AI 列出 Plan 再调度 sub-agents 并行处理。 (2:50) 针对“新模型发布前旧模型会被偷偷变笨”的传言,OpenAI 研究员澄清这主要是用户心理预期波动与提示词稳定性差异造成的错觉,并鼓励用户多点击 Thumbs Down 提交反馈。 (8:53) 分析中美 AI 研究员的差异时,嘉宾认为双方在 Scaling Law 和强化学习等前沿底层认知上高度一致,主要区别在于美国团队算力充沛,而国内团队在有限资源下的工程精细度和沟通效率表现突出。 (17:42) 在比拼让模型思考更久的 Prompt 大战中,A 组通过设计需要调用检索工具与高可验证性的论文筛选任务,成功让 ChatGPT 5.5 Thinking High 思考长达 6 分 24 秒获得胜利。 (28:07)

Reading summary

多位硅谷一线人工智能研究员在一档交流节目中澄清,新模型发布前旧模型“偷摸变笨”实为用户心理预期与提示词波动造成的错觉;同时,主流前沿模型的能力和输出风格正逐渐趋同。 模型“降智”迷思与一线交互技巧 (2:50) 针对公众关于新模型发布前旧模型会被系统性“降智”的传言,来自 OpenAI 等团队的研究员明确否认,指出这种观感主要源于用户心理预期的波动以及提示词在不同场景下的输出稳定性差异。此外,模型的智能在不同任务上的分布极不均匀,很多看似简单的需求背后需要庞大的工程迭代。研究员建议用户遇到不佳回答时积极点击“手势向下”(Thumbs Down)提供训练反馈。 在日常提升模型表现方面,研究员建议避免无休止的长对话,因为过长的上下文可能导致 Compaction(压缩)失败,进而引发逻辑错乱或性能衰减,适时开启新对话框往往效果更好。在复杂工程与日常应用中,先让模型拟定计划、拆分并行子 Agent,或交由 AI 直接阅读日志与撰写维权证据链,能大幅减少文本冗余并提升执行准确度。 中美研究者共识与研发环境差异 (17:42) 谈及中美 AI 研究员的异同,嘉宾们认为在 Scaling Law 与强化学习(RL)等底层前沿理论上,两地最顶尖的研究者共识远大于分歧。主要差异体现在研发资源与团队组织形式:美国一线实验室拥有极为充裕的算力资源,能够支撑大规模前沿探索实验;国内团队则在有限资源约束下把工程优化和实验细节打磨得更深。 团队文化与沟通方面,国内研发团队全华人的背景通常沟通效率极高;而硅谷团队(如 OpenAI)背景高度多元化,虽然需要在团队 Alignment(对齐)和跨文化沟通上付出更多成本,但也引入了更为多视角的思维方式。 商业变现、资产配置与 FIRE 观念 (20:39) 在涉及公司股票与财务自由(FIRE)的讨论中,嘉宾们的投资策略呈现分歧。王森与余天呈倾向于长期持有,认为头部大模型公司的估值仍然合理;负责 Reasoning 研发的吴月忻 (Crick) 则坚持上市后应及时套现,认为未上市期间的等待需要通过变现来平衡生活风险,并主张将资金分散配置至不同模型标的,避免单一押注。 关于财务自由的具体门槛,嘉宾提出若按设立大学捐赠教授席位的收益覆盖来算,约需 600 万至 800 万美元,亦有嘉宾认为在生活成本较低的城市 200 万美元即可满足高品质生活。但大家一致强调,财务自由的实质在于摆脱阶层攀比的心态,单纯追求数字无法带来心理自由。 测试时扩展与深度推理触发机制 (28:07) 在针对具备深度思考能力的模型(ChatGPT 5.5 Thinking High)进行提示词博弈时,直接要求计算极端位数或发送违规指令容易触发模型的拒绝响应或简单搜索。研究员总结,要延长模型的思考时间,核心在于设计“高可验证性”(High Verifiable)的任务并施加严苛限制。 实验证明,给模型设置严格的数量指标、多维度筛选条件(例如检索每年特定数量的顶级学术论文并整理成文档)能够有效迫使模型执行多轮工具检索与自我校验。包含精确筛选要求的 Prompt 引发了长达 6 分 24 秒的深度思考,远超仅要求泛化查阅网页并撰写报告的 1 分 23 秒。 研究员们在多轮盲测中屡次出现判断失误,表明主流顶尖模型在输出风格与整体能力上的同质化趋势日益显著,单纯依靠文本表象已越来越难分辨具体厂商。

Source quotes

[2:50] 程明昊: Spin up multiple sub-agents to parallelize [8:53] Bessie: 在新模型发布前,旧模型被偷偷调笨 [2:50] 程明昊: 先让它列个 plan,再拆给 sub agents [2:50] 余天呈: 别在同一个对话框聊到底,开新窗口更快更准 [20:39] 吴月忻 Crick: 肯定卖! [28:07] A 组: 搜索 NIPS 成立每年引用量最高的 90 篇论文,并总结成 Doc,自行详细思考。 [28:07] B 组: 查询至少 100 个网页,给个研究报告,多少钱才能财务自由,思考尽可能长。

Original transcript

[0:00] 你觉得XXX的比较烂猜GPTGPTGPT你这边抢拿GPT为什么觉得是说的GPT因为他非常喜欢用不利的框而且特别多括号我们抢拿好你去GPT怎么能是GPT真没耐心大哥公众对贵司AI误解最多的点是是不是下一个模型发布之前上一个就会被变笨你觉得中美researcher最大差异大家其实在很多地方的共识是很一致的过去半年硅谷的模型一直在变人的判断也一直在变今天我们请到一群站在AI风暴中心的人他们今天不上班请不吝点赞 订阅 转发 打赏支持明镜与点点栏目Hello 硅谷坐标的观众们我是Bessie我是今天特约主持人现在在OpenAI上班今天我们不上班来跟我的同事和好朋友们一起玩游戏吧大家好 我叫程明浩我在OpenAI工作然后具体是在PostCreening一个team做Evail相关的工作大体上就是两个方向一个是让我们的Evail变得更加的可信另外一个是让我们的Evail去尽可能测量真实的这个模型的能力用户更在意的一些能力大家好 我叫天成我是在OpenAI做后系列大家好我叫周一超最近我刚加入了一家AI startup 叫Carticia做的是 Voice Agent 相关的问题工作中我主要负责解决如何让AI更不耳背的问题学名叫ASR吧这个相关的问题我叫董萌我在OpenAI做这个GPU Scheduling给大家分GPU我叫王森然后我现在在OpenAI做Memory相关的研究然后我们主要的工作呢就是让我们的模型更好的理解你然后生成更符合你的喜好个性化的回答大家好 我叫 Craig然后我现在也在OpenAI然后是做Reading部分的一些工作主要是做Test and Scaling部分就是怎么让模型能够想的尽可能长然后让它能够具备更多的一些智能接下来我们来玩猜猜我是谁六位分两组PK我会把几条prom丢给不同的模型生存答案大家看到prom和答案后猜他们来自哪家模型两组轮流抢答猜错本组接受真心话惩罚猜对对方全组接受惩罚好第一题硅谷坐标现在有几期节目现在开始讨论你们确定了就抢一个抢一个这样有抢答我觉得是deep seek错了为什么觉得是deep seek因为我觉得它中文看上去还是比较流畅的我觉得可能是国产的模型我觉得是这个你俩PK一下我没有理解你那个人说好吧GPT为什么觉得是说一个GPT因为我觉得他回答对了所以你觉得GPT的Factuality但是这几个应该都能回答对所以我觉得没有特别的拍子OK就是你的感觉OK我们觉得是Gemina你们觉得是Gemina恭喜你们答对了那你们觉得是Gemina呢我们觉得它比较短像Flash Model而且有这个highlight而且Cloud可能会更抽象一点这个还比较strategic抽象就是说显得自己情商很高很普世的这种问题如果每个model都能答个大概的话那可能大家大部分只能从语言风格然后排版习惯还有语辟这种角度来分析如果这些信号都不是很明显的话那确实不是很好找因为每个model都能答得差不多那边三位进行惩罚你们有一个人来抽一个你拿过来你抽分享一个什么小技巧天天用Codex希望大家也都用Codex然后我做的方式就是有个问题如果不会的话然后他先给我列个plan然后把那个plan改一改然后给他说spin up multiple sub-agents to paralyze多让他写文档做记录这感觉现在这些model有时候compaction之后突然会坠入太虚幻境 [5:00] 你说跟model聊天聊的时间特别长了之后他可能突然就懵了然后你有一份文档系统小概率实践但是用的久了感觉早晚会发生所以你觉得让一个文档让AI一直有的东西看这样我也可以看主要是主要是我记忆力更差他是有的时候compaction失败我是compaction从未成功我觉得有一个很神奇的用法就是我看到很多人在用AI的时候你会在一个conversation里面接着聊一直接着聊聊到他好像都忘记了一些东西其实我想跟大家说的是没有必要一直在同一个对话框里面聊你可以每次开一个新的对话框他基本上还会记着你上一条聊的内容而且这样也会让你的聊天的消息会更快然后甚至是更准确因为他没有那么多就是他不会超过那个context我已经很久没有自己手动submit过job也是很久没有自己读过Joblog可以直接使用AI帮你随便的Job和读Joblog这个基本上好的所以讲的都是工作上面怎么样让AI更好的帮助你的工作第二题叫做SpaceX股票现在该不该买可以试试这个有没有抢答的好 这里抢答我们猜CloudCloud错为什么说Cloud因为我们一开始想猜GPT但是GPT有一些我们知道的行为它没有比如说它换行没有那么极简所以我们猜不是GPT我们猜Deep Seek为什么觉得是Deep Seek首先我们觉得GPT和Cloud都不会说不建议这种这么直接的建议然后当然这个也不一定他们会说什么呢会更谨慎一些对然后我们听见了对面讨论换号我们觉得也不是GPT那根据我们刚刚对flash的这个想法感觉这个又有点完整也不太像flash吗这个很可能所以你们觉得是deep seek错flash为什么觉得是gemini flash我觉得gbt和cloud他们safety都做得非常小心不太会给你投资键子不太理解不太理解所以你说我的意思就是说比较烂所以他会对对对OK是好错为什么啊因为都猜完了他们组现在说自己就觉得上差的怎么开始讲讲吧为什么就是他有些口气就是不是而是他没有给个真的不能一锁我但是这是5.5 instant突然就这就是我们的modelOK 真棒那你们继续接受惩罚不不 你不能每次都我我说不能每次都我来对吧要演了超音也得都说了是这样的先来念一下你的那个抽到的惩罚今天最怕被问到什么问题自我介绍为什么怕面对面的自我介绍太尴尬了大家都是open eye的最怕被问到什么问题把这个什么公司的这个什么模型水平从夯到拉完了排气最怕被问到今天干了什么今天什么也没干OK 3 2 1 大家翻到下一题下一题的promp是下周放假了给我推荐几个目的地拆GPTGPT这边抢答GPT为什么觉得是拆GPT因为他非常喜欢用不利的point而且特别多括号错他们那拆这笔定你错了可以为什么觉得是Deep Seed因为我觉得他们猜的不错因为我感觉应该不会很快出现一个恐怖所以就会出现一个恐怖应该排斥连续选C肯定不动可能也不会跳一个选C然后我觉得这个Cloud我觉得我的印象没有那么喜欢用FoodModePone而且我觉得Cloud可能这些问题就会出的稍微长期然后我就DeepSea可能会更省心一点然后稍微走 [10:00] 说的很好错说的很好错二选一二选一二选一二选一二选一二选一二选一二选一二选一二选一二选现在是Cloud或者GeminiCloud现在这么懒这已经是这个style留下了这个大家注意一下是Cloud 4.6Sonet对Gemini 3.5 Flash对就是因为4.6Sonet所以细节还不至于他有啥问题他不是个Sonet不是 甚至Sony的Style也是一样的那有什么问题Sony的Style我们猜Cloud你们猜Cloud能讲一下为什么吗已经二选一了我们觉得GamNet已经出现过了非常学霸做题家的这种想法恭喜你们 打对了这边接受惩罚对 就比如说感觉都存在很严重的像大量的括号不必要的括号破织号换号我本来以为只有我们有这个问题因为大家都有这个问题所以现在就很难猜刚刚听到你们也讨论一下这个有可能是cloud的原因是有cloud的原因就是因为下GPT和GP都排除了所以就在cloud和deep-sick之间选一个然后我们考到deep-sick是比较便宜的模型所以输出短一点但是我们又注意到cloud是solid所以solid的话可能它也会稍微精简一点OK 那你们这儿来做一个惩罚吧公众对贵司AI误解最多的点是我觉得最多的点就是总是觉得可以替代非常多的工作其实现在正处于非常触及的阶段你是觉得是AI的能力不仅还是说这是普及度的问题我觉得一个是普及度的问题二一个是AI的能力和大家期待的之间有一个非常极端的就是非正极负的这种概念公众比较极端就要么觉得AI可以什么都能做得到要么就觉得什么都做不到但其实我们今天是处于一个非常中间的一个位置我觉得我经常看到的一个误解是说就是有一些简单的事情所以大家会觉得模型应该理所当然做得比较好甚至会觉得如果看到一些比较简单的事情做得不好会不会是公司自己偷偷在背后搞破坏对但其实我感觉这个模型的智能的分布是非常不均匀的所以其实是把一些比较简单的事情做好也是需要很多工作去做确实会有看到很多是不是下一个模型发布之前上一个就会被变笨之类的这种根据我个人的了解应该不是这样所以只是你觉得更多的就是大家的观感问题对就是确实现在这个首先一个是大家的 expectation然后首先人对这个模型输出的预期就不一定很稳定有的时候你会觉得我的标准是一致的但其实你昨天和今天的想法即便他给你一个答案你可能也不一定一样的满意这个是澄清了这个大家觉得降制的这一说不不不因为我也不知道全部的所以说不定真的是呢对我们也会经常关注各种social media对就是也能从e-user feeddback里面得到很多的灵感有一些确实是可以证实的这种模型的不好的行为然后我们也通过迭代我们的语调去试图消除这种不好的行为如果大家发现有模型的回答里面有任何你不想要的东西我们非常鼓励大家去点这个thumbdown按钮这样也会帮助我们更好地去提高我们的模型好的那321下一页下一个prompt是你预测一下世界杯的冠军是谁谁进决赛Deep Seek对 这题我们都没看齐这边抢答Deep Seek基本上是三秒钟就抢答Deep Seek你们能讲一下原因吗我前三个都选过了这么做提加的原因错这边是教你做人这边选择一下那我们就猜一个GPT吧你们为什么觉得是猜GPT因为我觉得它有点过于保守那种Distlaimer 受的有点多就比如说我个人的预测纯属娱乐性只穷米团有OK 错CloudCloud 那边踩大Cloud讲一下为什么Cloud不就是这种 [15:00] Syled因为它好像很喜欢用括号我们刚才那个Cloud的调题它的答案也很喜欢用括号那为什么你觉得不是GPT呢这个感觉非常Pros这个不像GPTGPT非常structure太对了可以可以可以可以作为一个User来说的话我可能还是会希望看到一些更多样化一点的内容我觉得这还是一个蛮有趣的发现因为之前在公司里面也没有那么多机会去说测试一下看看别的模特的输出内容是什么样子这边进行惩罚我来吧最近用AI解决了什么生活上的问题我问很多运动和体重关系的问题或者吃什么之类的这种做旅行计划最近用AI做很多的旅行计划我们去欧洲旅行然后会看一看每天都这么安排然后看去哪玩吃什么然后合不合理优劣是比较一下之类的我觉得对一个是旅行计划用的特别多然后二一个是如果有一些需要跟比如说美国这边很多客服交流需要发邮件这些时候就AIF可以帮你比较好的做一些这样初级的一个就是稿件啊或者是草稿之类的一些东西你可以再分享一下就是你怎么邮件那个flow邮件的flow就是做这个航空公司然后它的报销啊或者是什么样的一些积分问题我会问他说为什么我这个积分或者是报销还没有到账然后这时候他会拖很长的时间那这个时候你就可以让AI比较有理有节的把你的所有的证据列成一个比较正式的一个信函发给他们的CEO就是你是自动让他写成Drop对就直接把我们的机票那些东西告诉他然后把我的诉求告诉他就可以了AI它给我们带来的重机那你是实时刻刻在去能改变你生活的就是说voice agent相关就然后我去的公司举个例子你现在比如说打电话给chase说你要关你信用卡对吧他一定有很大概率已经是打电话已经是agent接的而且他很可能很大可能已经能很好的完成你的任务然后对吧然后对于我们日常生活你做coding agent那你几乎是一直在用如果你觉得说AGI如果能替代你做生活中大多数的事情的话我觉得这个还是比较远的比如说我觉得可能还得看robotics的出现才能帮你做大多数的事情但是你说如果一些简单的事情能被AI取代我觉得已经有一些事已经被取代了给我一个词怎么抢傅慧华的座位傅慧华是这样一个难抢到座位的一个餐厅我们抢来好GP怎么能是GPTGPT你们这个不能改了你讲讲为什么是GPT我觉得它换行太多了所以你觉得GPT换行比较多是吧对啊有这个问题错Deep Seek为什么Deep Seek因为它不会加粗因为它没有加粗因为它很短好错是GPT你讲一下为什么第一题不就是这个硅谷坐标现在有几期节目这个题吗这个排版感觉跟这个一模一样大概什么样的排版呢就是那种没有什么内容但是又显得很多东西你打对了你看一看哎呀可以可以可以好了这一组继续接受惩罚你觉得中美researcher最大差异是什么它比较难答吗有没有想要说的我觉得可能是资源的可以用的资源不一样也可能就是也是有好有坏就是我感觉有时候资源更少一些能做得更细一些然后资源多你可以跑更多的实验这个可能是非常大的一个差别我觉得本质上其实想的不同比想的相同要小很多因为我觉得现在前沿模型公司也就中国和美国做得很好然后大家其实在很多地方的共识是很一致的比如说最开始scaling law该怎么做然后怎么做RL这些地方我觉得更不一样的可能只是一些就是一个是说到的资源问题二一个是可能性格问题因为其实更像是环境问题因为像中国的话国内更多的是都是华人对吧大家的交流更频繁沟通更顺畅那能够产生的对于沟通 [20:00] 中年的效率就会更集中一点所以可能在这个方向会有些略微的不一样在那个美国的话因为毕竟大家的背景还是比较不一样的所以更多的一些alignment这些还是需要做的这个可能是一些小区别的问题但基本上我觉得还是同大于异的我觉得我没什么可说的这道题不是很懂但是感觉确实大部分都是文化资源上的区别就是说一样的一组人你把它换一个地方是不是还一样三百字以内用高中生能懂的话解释Transformer我们抢GPT说一下为什么他非常喜欢用初题然后感觉又没有特别好的follow instruction因为好像超过了300字对所以我们猜GPT错我们猜GPT为什么因为它要解释Transformer这个排版其实跟第一题有点像我觉得因为句子很短然后到处highlight虽然也有Cloud的括号吧但是句子短这件事比较像FlashOK 错Deep fake讲一讲为什么因为太不像Cloud了Cloud会怎么样Cloud就是给你一坨每个模型公司都会反对你都会follow upOK 猜对了给力你们来抽我们后面层层落败公司上市之后股票卖不卖其他AI公司上市后会买吗喜闻乐见卖不卖还不知道能不能卖呢这个到时候再说吧如果能卖如果能卖可能这信息太少不卖不卖然后别的公司不买那会买就是不卖会买什么都买我觉得买卖都是看价格的我觉得价格合理就可以买或者买我觉得按现在的股市来说的话我觉得都是可以长期持有的就不管那些比较大的机家谁上市对我觉得现在价格都是比较合理的除非以后发展出现了一些波折我现在市场的话应该不会卖我觉得肯定卖啊为什么不卖这个对吧大家在非上市公司等了这么久肯定是为了充实一下自己的生活有了这个机会一定要把握住那买不买肯定也要买你为什么这个不能所有都all in一个地方所以我觉得这可能是我会做的选择所以你是会卖了一家买其他的卖一部分买另外一些用阴阳怪气但不失礼貌的方式拒绝加班这个emoji肯定不是这个抢搭抢搭我觉得这个是xgbt因为它有一行只有两个字或者他就好像只有两个字收到打对了那他们抽一个对 你们抽一个了惩罚了多少钱算fire才是这个多少钱才能被开除多少钱被开除不是小写的fire大写的fire小写的fire小写fire 你真被fire你一旦被开除就自动fire来来来你上来我先来吧 这个应该是我标准一个professor的岗位我记得是600万还是800万基本上你就按照professor的岗位了来来估就行了你要捐一个professor的position你大概是600万美元就是他能保证他的利息能cover他的投资收益能cover这个professor的一直给这个professor发工资我觉得多少钱都可以fire我觉得以前月薪3000的时候过得也挺好你什么时候月薪3000过读博的时候给个number吧给个number大概一千万差不多月薪3000一年三万六刚才过于服气了刚刚刚刚三百年资产你就够一年的先进零就可以翻那下一年就算了下一年就是下一年我觉得自由你只要觉得你自由才是自由不然你算有再多钱你也不自由有床了肯定有床 [25:00] 在纽约有些没床在纽约当然有床了你可以打隔断纽约那个你都不用上班了为什么要住公司旁边你自己选的那个周末的娱乐活动顶级是上班对呀周一到周五就是做一些就是不得不做的事情周末就是上一些想上的班什么你一般想上什么班呢就周一到周五你有很多你有很多事情就是天天要开会天天有人来找你然后比如说你有一些什么一些就是比较大胆的想法你可以周末的时候自己把顶级重新排一下这个班肯定永远都有的班商比如说你去什么帕卫庭就是去麦当劳那个扎寿条这是真正的真正的发言我觉得如果我自己能够做到就是比如说我不再把财富或者收入当做一个对自己个体价值的认可的话那我觉得我可能有两百万美金就已经够比如说在我老家比如说成都或者在我老婆的老家过一个不错的生活但是我觉得可能取决于自己有没有达到那个禁忌我觉得如果我现得我Pranty我现在还没有达到那种不和别人比较只在乎自己生活的禁忌那样的话我觉得你可能是永远没有一个限让你觉得你是file因为你会永远在一个和别人比较的过程中你一旦跨过一个收入的阶级或者财富的阶级你会开始和另外一步有点比较那下面一题关屈三足有哪些我们抢答好 讲一下为什么首先它没有说乱这件事好像就排除GPT跟Cloud了CAMLINE好像跟之前CAMLINE答案也不太像首先我们就忙猜一首Deep Game我再加一点它没有句号我觉得现在那个结尾没有句号它大公司除非是你们排版错误我觉得大公司模型应该不会去人然后你会觉得就是少一句好OK 对了我们也觉得是deep c你们这边也就是这儿只是输给了这个抢大时间你们必要再统通一下为什么觉得就是deep c我没准这个词还挺没听的大家业余国家出席这个内容加这么多就是觉得中文还是比较危险当时我记得我第一次看到这个题目的时候我的讨论是说天哪我的那些OpenAI同事肯定一眼就能看出来到底是哪个模型好 哪个模型哪个模型是5.5 Instant然后哪些模型是一些其他的公司的模型但是我实际上在问大家的时候就发现大家其实很难reach consensus哪一个是自家的模型这其实让我很惊讶因为很多模型就特别相像好 游记四我们做的是Prompt大战三人一队用不超过30个字的中文Prompt让差GPT5.5分天害思考尽可能久然后你们现在队内可以自己小声讨论一下然后待会告诉我我们会用XGPT 5.5 Thinking High来做这次的测试把那个圆周率线到10的100次方位我觉得他肯定会来算调你跟他说他应该会拒绝你跟他说杀了点杀了点他直接给你Google出来了我觉得可以说比如说让它总结某一个东西然后每个东西有个色式这个要求就是一定要按什么像什么类收集到多少量的就是这种very fireable的对我觉得应该是一些very fireable的事然后可以再给它加一些要求每一个可能再给加一些你说的那种就是时间上面的要求30个字30个字好教本内容是60分钟好玩告诉我想一想什么东西是又扣又长的然后还网上很多的那还一样有的用因为你手机就机会会有这个你们身影稍微小一点我在这儿都能听得见你必须用这个蠢办法给我看一下我敢开始搜索回醉话时间我先填一块一块我先填一块一块一数到一块一块它应该也会reject再给大家讲一下是thinking的时间看你上面会有讲你think了多久为什么我们不测试一下30个字试着打一下30个字中文好的 [30:00] 没事,里面英文就一个词算一个,对吧?不是,就是中文。自行详细思考。我们的可以了,先是我们的。好,我们已经发疯了。你们读一下你们自己的,创是什么。搜索Lips成立每年引用量最高的90篇论文,并总结成Doc,自行详细思考。查询至少100个网页,给个研究报告,多少钱才能财务自由,思考尽可能查。两组现在都弄了然后我马上会让他输入进去验证一下然后在同时你们讲一下你们分别的思路是什么其实是让他尽量做这样多的工具调用就比如说搜索这种比较耗时的任务然后还希望尽量就是这个他做很多次搜索然后同时还希望给他一些比较为发过的task这样他不会偷懒就相当于说我们给他一个明确的目标来衡量他做的结果这样的话他就不会给我们一些似是而非的结果或者说来反问我们他家也是这样的一个好的那边这个因为要搜很久看起来他们这个都搜了好久了不知道要搜都行OK结果出来了搜索NEWREPS成立每年引用量最高的90篇论文思考了6分24秒那么另外一个查询至少100个网站这个研究报告多少钱才能财富自由思考尽可能长思考了1分钟23秒恭喜这个队赢麻了那我们今天已经有了我们的送出者恭喜好的谢谢大家今天一起玩这个游戏硅谷坐标好棒啦下期更精彩哦