丰田研究院推扩散策略训练机器人 拟2024年底前掌握千项技能
Toyota Research Institute
丰田研究院结合触觉遥操作与扩散策略,通过夜间离线训练赋予机器人复杂操作能力,并押注在海量基础技能积累后实现大行为模型的自主泛化。
AI-assisted summary of Teaching Robots New Behaviors — original source. Check the original for full context.
Source published:
Key ideas
- 丰田研究院(TRI)基于生成式 AI 技术扩散策略(Diffusion Policy),实现了仅需少量远程示教与数小时后台训练即可让机器人掌握灵巧操作的能力。 (0:09)
- 机器人学习周期大幅缩短至“下午示教、夜间训练、次日掌握”,目前已成功掌握包括削皮、倒水与翻松饼在内的 60 多种复杂行为。 (1:26)
- 触觉感知反馈成为机器人处理视线遮挡及盲区物理交互(如平底锅表面贴合)的关键技术支撑。 (1:26)
- TRI 计划在 2024 年底前将技能库扩充至 1,000 种以上,并通过舰队学习(Fleet Learning)工具实现技能在机器人机群间的即时共享与分发。 (2:19)
Detailed notes
## Background 该视频由丰田研究院(Toyota Research Institute, TRI)于 2023 年 9 月 19 日发布在 YouTube 平台上。视频简介指出,TRI 公布了一种通过人类演示让机器人快速掌握精巧操作行为的全新方法,并阐述了这项新能力的关键意义、技术突破以及未来的研发方向。
## TL;DR 丰田研究院介绍了基于生成式 AI 技术“扩散策略(Diffusion Policy)”的机器人训练新突破,旨在构建类似大语言模型的“大行为模型(LBM)”。人类研究员只需进行少量远程操作演示,配合提供盲区交互力感知的触觉传感器,机器人经过数小时离线训练即可掌握削皮、倾倒液体或翻松饼等复杂技能,目前已学会 60 多种行为。团队正打造涵盖仿真训练与“舰队学习”的系统化大纲,计划在 2024 年底前让机器人掌握上千种新动作,最终实现未受训新任务的自主通用泛化。
## Atmosphere & style 整段视频洋溢着前沿科技突破带来的严谨与振奋感,叙事风格沉稳而笃定。研究人员以亲历者的视角,将高深的生成式 AI 与“下午教、次日成”的从容日常形成反差,翻松饼等真实生活场景的成功演示极具说服力。言语中流露出面对技术飞速演进的真切敬畏与欣喜,让观众深刻感受到机器人工程正迎来黄金时代的澎湃动能。
## Bulletin - [00:09](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=9s) 丰田研究院(TRI)基于生成式 AI 技术扩散策略(Diffusion Policy),实现了仅需少量远程示教与数小时后台训练即可让机器人掌握灵巧操作的能力。 - [01:26](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=86s) 机器人学习周期大幅缩短至“下午示教、夜间训练、次日掌握”,目前已成功掌握包括削皮、倒水与翻松饼在内的 60 多种复杂行为。 - [01:26](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=86s) 触觉感知反馈成为机器人处理视线遮挡及盲区物理交互(如平底锅表面贴合)的关键技术支撑。 - [02:19](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=139s) TRI 计划在 2024 年底前将技能库扩充至 1,000 种以上,并通过舰队学习(Fleet Learning)工具实现技能在机器人机群间的即时共享与分发。
## Key takeaways - [00:09](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=9s) TRI 的核心愿景是让机器人成为家庭和工作场所中人类能力的放大器,具备高柔韧性、鲁棒性与通用性。 - [00:09](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=9s) 引入扩散策略(Diffusion Policy)生成式 AI 技术,显著减少了机器人学习所需的人工示教次数与训练时间。 - [00:09](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=9s) 扩散策略被视为构建大行为模型(Large Behavior Models, LBM)的关键基础,有望重现大语言模型带来的颠覆性突破。 - [00:09](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=9s) 新技术打破了以往抓取-放置(Pick and Place)等简单任务局限,无需重写代码即可支持工具使用、倒水与削皮等复杂任务。 - [01:26](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=86s) 机器人示教流程轻量化:人类操作员通过遥操作演示少量次数,算法在夜间完成离线训练,次日清晨即可投入使用。 - [01:26](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=86s) 触觉反馈在物理交互中不可或缺,尤其在工具与环境接触面被遮挡(如铲子翻松饼)的盲区操作中起决定性作用。 - [01:26](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=86s) 依托该方案,TRI 机器人目前已成功习得超过 60 种不同的精巧操作技能。 - [02:19](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=139s) TRI 正在构建“机器人幼儿园”式的系统化教学大纲,期望通过海量基础技能训练实现机器人对未示教任务的通用泛化。 - [02:19](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=139s) 技能扩展路线图规划激进:目标在年内掌握数百种新技能,并在 2024 年底前突破 1,000 项新行为。 - [02:19](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=139s) 团队将真实世界演示与仿真技术(Simulation)相结合,进一步加速算法训练与策略迭代。 - [02:19](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=139s) 借助舰队学习(Fleet Learning)机制,单台机器人习得的新技能可以瞬间同步至整个网络机群中。
## Detailed walkthrough ### [00:09](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=9s) 扩散策略与“大行为模型”的突破
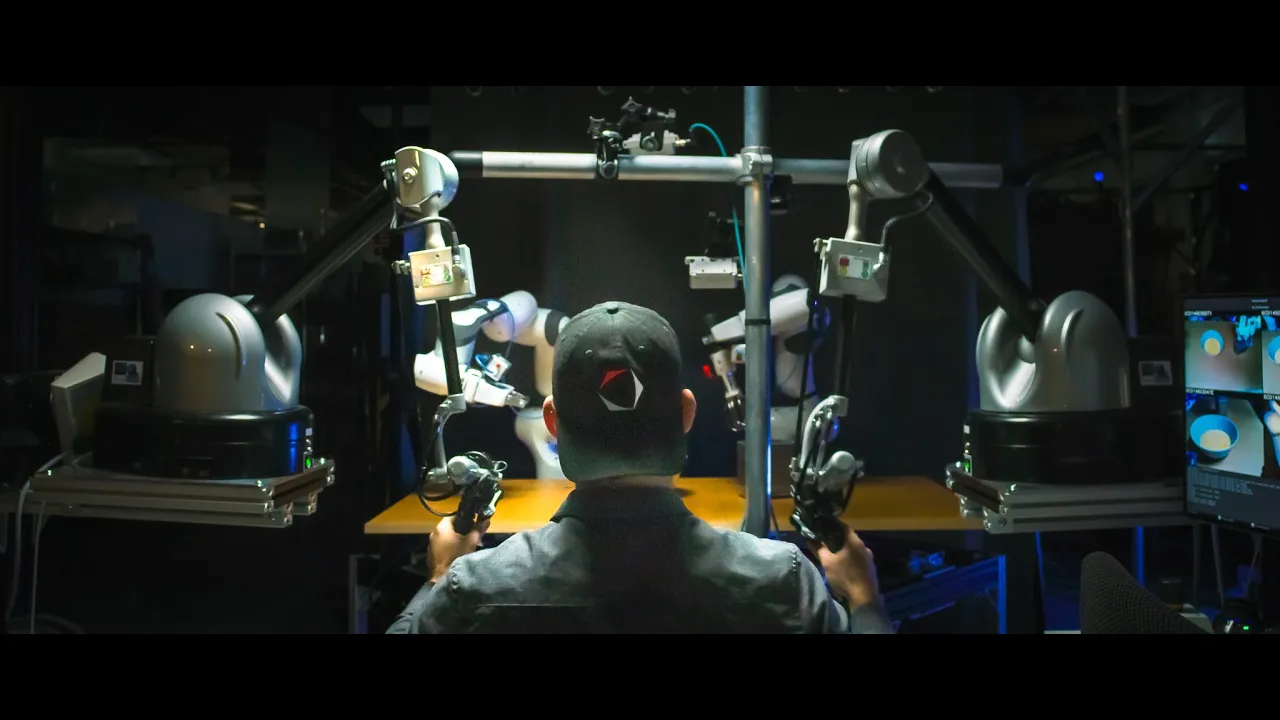
丰田研究院(Toyota Research Institute,简称 TRI)始终秉持一个核心愿景:机器人应当在家庭与工作场所中充当人类能力的放大器。为了让机器人变得更加柔韧、鲁棒且具备通用性,TRI 取得了关键的技术突破,推出了一种能够快速且轻松地教会机器人灵活精巧技能的全新方法。该方法基于一种被称为扩散策略(Diffusion Policy)的强大生成式 AI 技术。与以往的研究相比,新技术不仅大幅缩短了教学周期,还极大降低了所需的人工演示次数。TRI 认为,这项技术在构建所谓的“大行为模型”(Large Behavior Models, LBM)方面蕴藏着巨大潜力。正如视频中所强调的那样:
> “大规模言语モデルが チャットボットに変革をもたらしたように このような行动モデルによって ロボットは今までできなかった方法で 役立つ作业ができるようになります”
过往关于机器人抓取与操作的研究,绝大多数仅仅局限在简单的“抓取-放置”(Pick and Place)任务上,所涉及的操作对象也相对单纯。而 TRI 提出的全新方案打破了这种局限,力求将机器人硬件的极限性能榨干。现在,机器人已经能够自如地使用工具、倾倒液体以及给蔬菜削皮。尤为关键的是,机器人能以如此丰富多变的方式与真实环境交互,背后既不需要开发人员重写代码,也不需要通过传统手段显式编程输入新技能。
```mermaid flowchart TD accTitle: 扩散策略与大行为模型架构流程 accDescr: 描述从人类演示到生成式AI训练并最终形成大行为模型的流程
subgraph Phase1["演示与采集"] A["操作人员远程示教"] --> B["触觉与动作数据采集"] end
subgraph Phase2["AI训练"] B --> C["扩散策略 (Diffusion Policy)"] C --> D["后台数小时离线训练"] end
subgraph Phase3["行为泛化"] D --> E["大行为模型 (LBM)"] E --> F["丰富日常技能: 削皮/倒水/翻松饼"] end ```
[01:26](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=86s) 触觉感知赋能的教学流程与翻松饼实验
依托扩散策略,TRI 已经成功向机器人教授了 60 多种截然不同的复杂行为。整个教学过程极其轻便高效:首先由一名人类“教师”通过远程操作设备向机器人进行少量的动作演示;随后,AI 算法在后台利用扩散策略进行数小时的静默训练。TRI 团队将这种日常的工作节奏描述得非常从容——“午後ロボットに教え 一晩かけて学習させると 翌朝に新しい動作ができるようになっている というのが 私たちにとっての通常の手順です”。
为了支撑如此高水准的灵巧操作,从底层硬件到上层软件的每个细节都经过了精雕细琢。其中一个最为关键的核心要素,是为人类示教者配备了搭载触觉传感器的遥操作装置。研究发现,正如人类依赖触觉一样,触觉反馈对于机器人的策略学习具有不可替代的作用。最典型的例证便是“翻松饼”任务:
```mermaid flowchart LR accTitle: 触觉感知在翻松饼任务中的作用对比 accDescr: 展示有无触觉反馈在盲区交互中的表现差异
subgraph WithoutTactile["无触觉感知"] A1["视野被松饼遮挡"] --> B1["无法感知锅底接触力"] B1 --> C1["铲动失败/任务崩塌"] end
subgraph WithTactile["引入触觉反馈"] A2["环境交互力感知"] --> B2["精准贴合锅底滑动"] B2 --> C2["平稳成功翻面"] end ```
在翻面过程中,铲子下方被松饼遮挡,机器人必须依靠物理接触去“摸索”看不见的平底锅表面。研究人员指出:
> “触覚が無ければ ロボットは苦戦し上手くタスクをこなせません しかし 環境との相互作用を感じられるようになることで スキルの習得に成功します”
- 机器人学习周期:下午示教演示,夜间后台训练,次日清晨即可执行新动作。 - 触觉反馈的作用:在视线受阻的盲区操作(如锅底贴合、工具切削)中提供决定性的交互力感知。 - 已掌握技能数量:目前已涵盖超过 60 种不同的精巧操作任务。
[02:19](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=139s) 机器人“幼儿园”、群体学习与未来愿景
目前展示的成果仅仅是一个序幕,TRI 的真正重心在于实现完整的大行为模型。团队预判,机器人领域的下一个重大突破将发生在让其掌握“足够数量”的技能之后——届时机器人将实现质的飞跃,获得强大的通用泛化能力,能够自主执行从未被示教过的全新任务。为了实现这一跨越,团队正在构建一个循序渐进的系统化教学大纲,就如同开办一所“机器人的幼儿园”一样,旨在教会它们海量的基础技能,从而在未来能更好地与人类协同工作。
TRI 制定了激进的发展路线图:计划在年内教会机器人数百种新行为,并在 2024 年底前将这一数字推进到一千种以上。为了强化实体世界中的数据训练,团队还同步引入了仿真模拟技术作为有力补充。此外,TRI 正在开发“舰队学习”(Fleet Learning)的基础工具:一旦某台机器人学会了一项新技能,该成果便能瞬间共享给整个机群网络。
面对技术的突飞猛进,长期从事机器人研究的发言者由衷感叹道:
> “ほぼ毎日 私はロボットが前日できなかったことをやっているという 新しいメッセージで目覚めます ロボット工学者にとって 素晴らしい時代に突入したと言えるでしょう”
- 技能扩张目标:计划在年内拓展至数百项新技能,并在 2024 年底前突破 1,000 项新行为。 - 技术协同方案:采用现实演示与“仿真技术”(Simulation)相结合的方式加快学习。 - 群体学习机制(Fleet Learning):单机习得技能后,可通过中央工具即时同步分发至所有机器人。 - 研发感悟:甚至仅在一年前,研究人员都无法想象机器人能拥有如此惊人的灵巧度,技能迭代速度堪称日新月异。
## Notable quotes > [01:26](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=86s) 触覚が無ければ ロボットは苦戦し上手くタスクをこなせません しかし 環境との相互作用を感じられるようになることで スキルの習得に成功します — 研究人员
> [02:19](https://www.youtube.com/watch?v=w-CGSQAO5-Q&t=139s) ほぼ毎日 私はロボットが前日できなかったことをやっているという 新しいメッセージで目覚めます ロボット工学者にとって 素晴らしい時代に突入したと言えるでしょう — 发言者
## Mentioned 丰田研究院, TRI, Toyota Research Institute, 扩散策略, Diffusion Policy, 大行为模型, Large Behavior Models, LBM, 舰队学习, Fleet Learning
## Video description The Toyota Research Institute is unveiling a new approach that allows a robot to acquire new dexterous behaviors from demonstration. We’re going to walk through why this is a critical new capability, what advancements have made this possible, and where we are going next.
To learn more please have a look at the technical details in our Medium blog post: https://medium.com/toyotaresearch/tris-robots-learn-new-skills-in-an-afternoon-here-s-how-2c30b1a8c573
[Source](https://www.youtube.com/watch?v=w-CGSQAO5-Q)