DeepSeek开源常驻智能体架构 原型以操作系统原理破多任务瓶颈
AI技术投降派
智能体多任务瓶颈在于人类注意力而非模型能力,DeepSeek通过解耦调度层与并发工作层并引入操作系统级机制,将长尾任务耗时缩短近半。
AI-assisted summary of DeepSeek新研究原型智能体开源:给AI装了操作系统 — original source. Check the original for full context.
Source published:
Key ideas
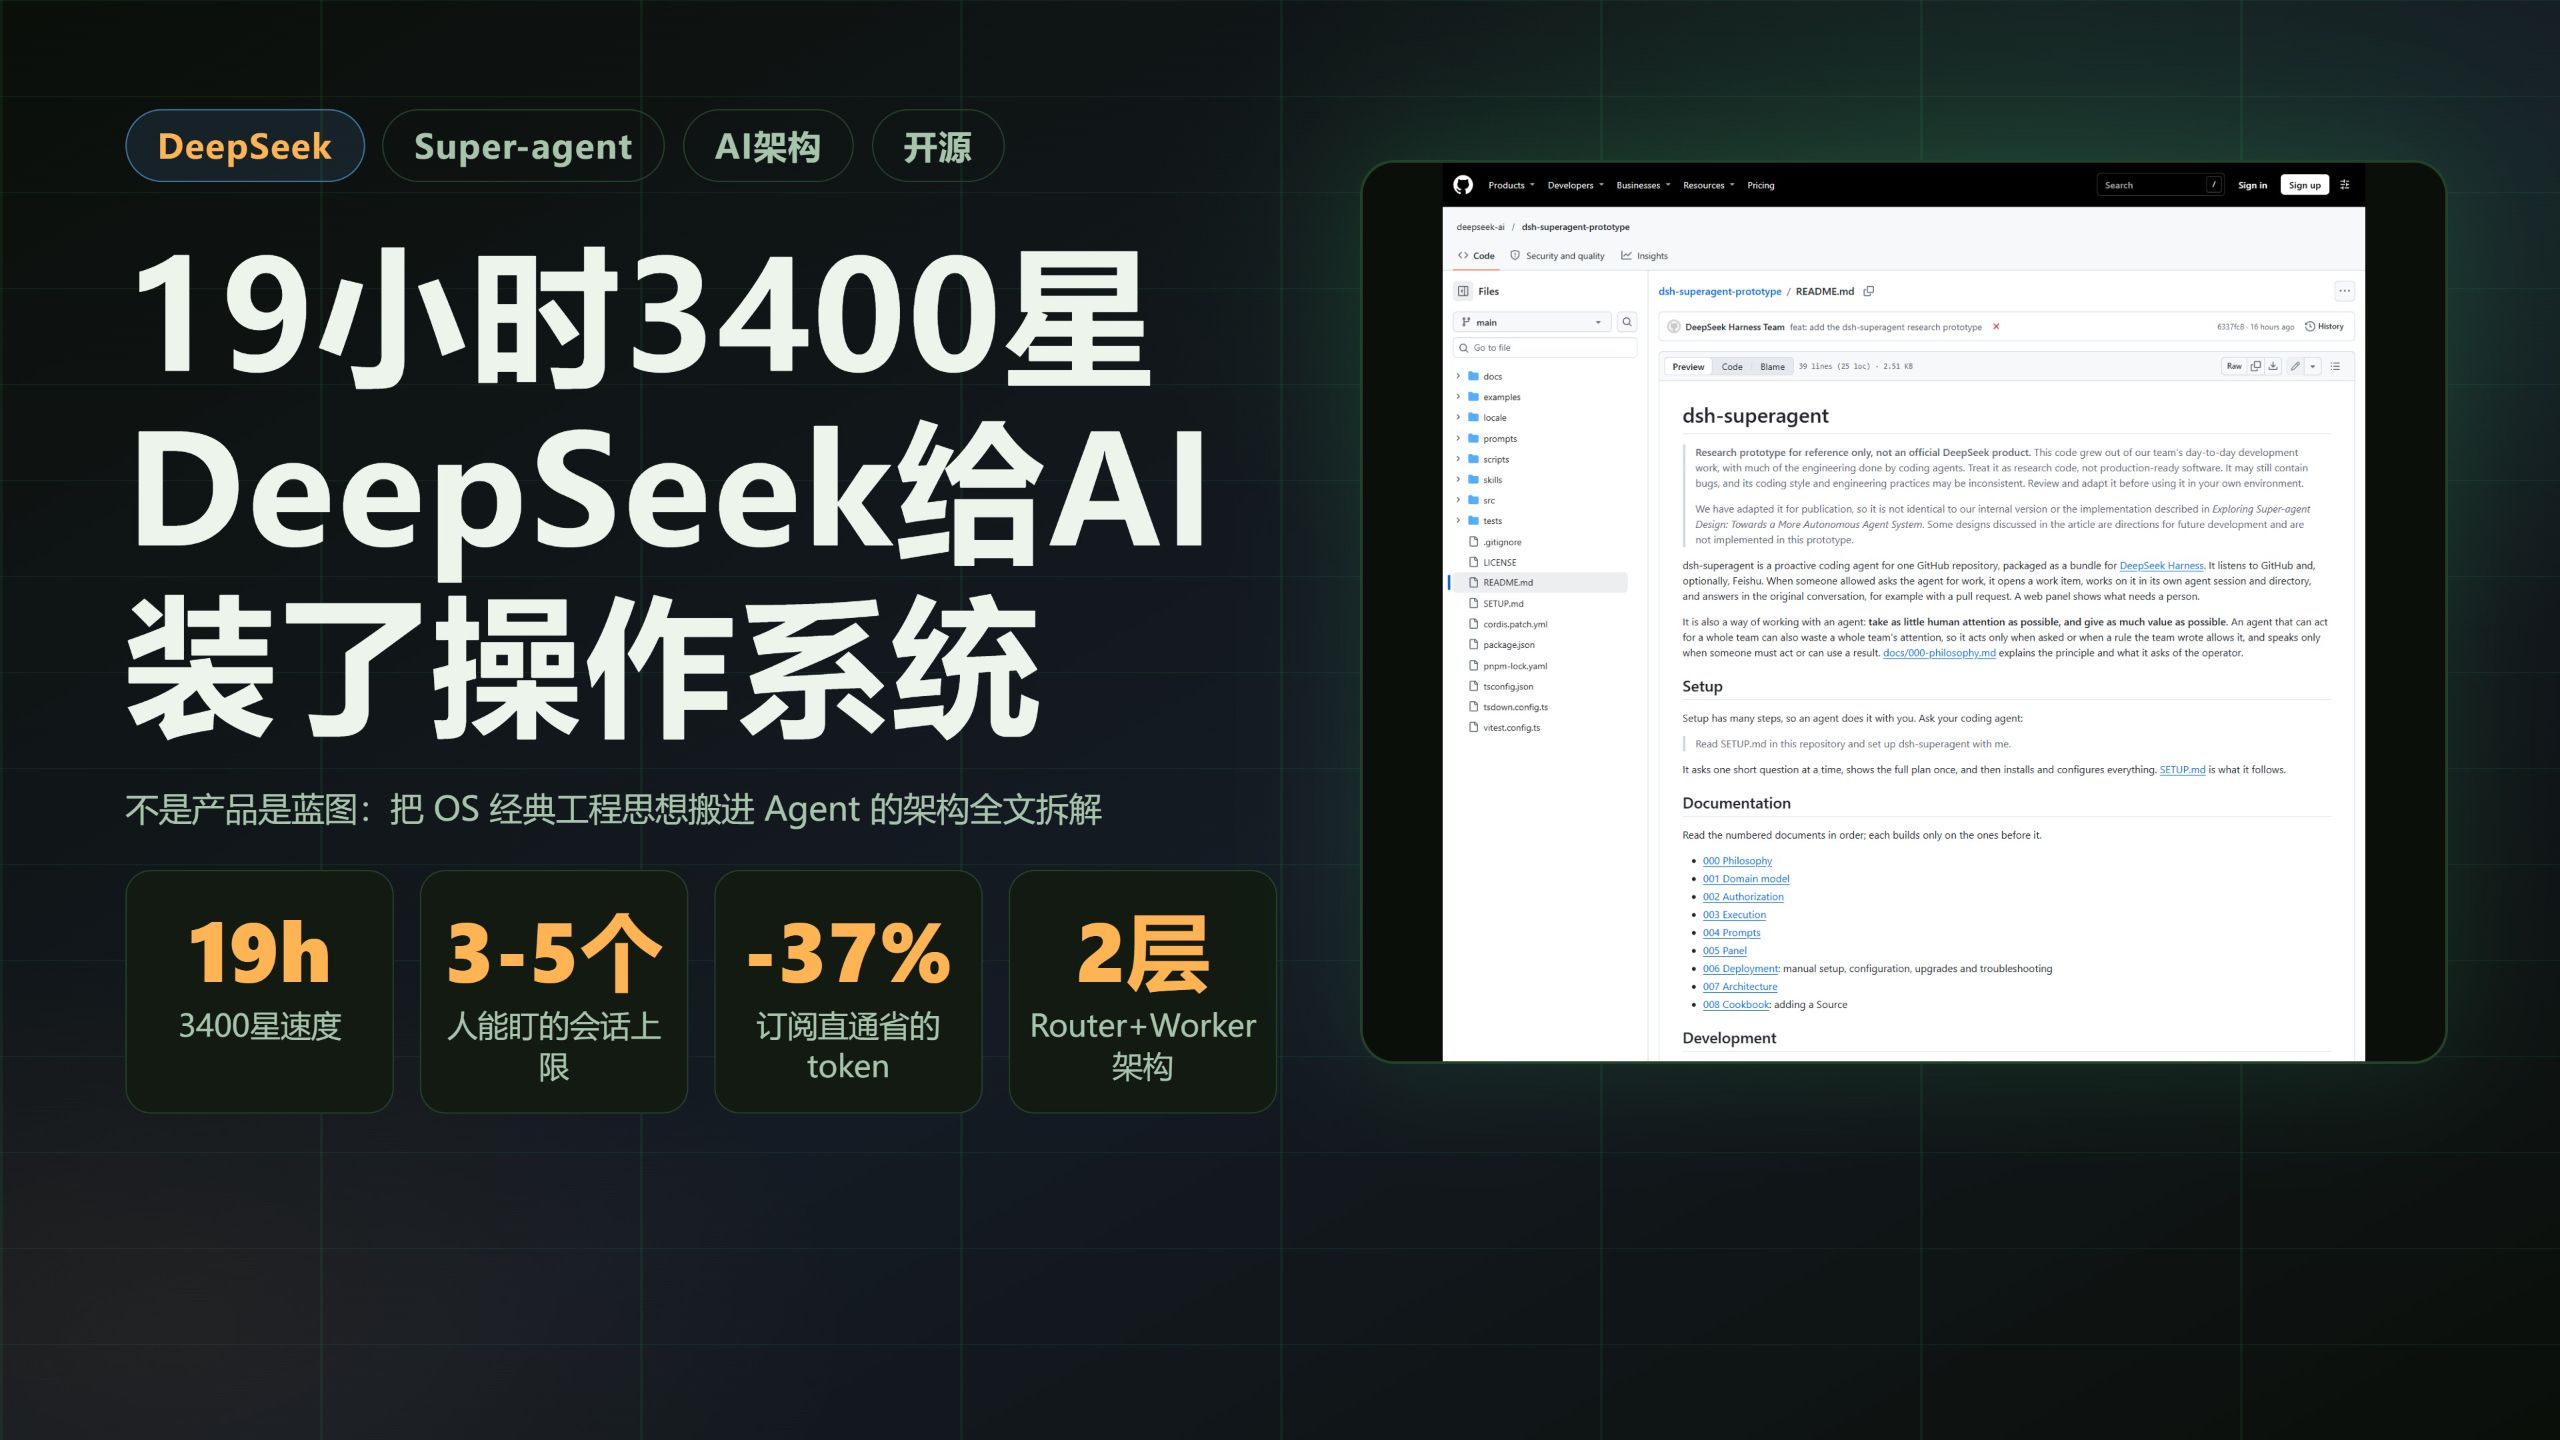
- DeepSeek 在各大厂发布常驻个人智能体 71 天后开源了 Super-agent 研究原型,上线 19 小时斩获 3400 星,旨在将操作系统工程思想引入智能体架构。 (0:05)
- 提出以双层解耦应对人类注意力瓶颈:常驻顶层的 Router 仅用轻量模型负责派活与记忆,底层的并发 Worker 隔离运行最强模型进行闭环执行。 (1:19)
- 设计程序快筛与模型慢判两道闸及话题直通链路,实验证明直通机制可为系统减少 30% 路由决策并节省 37% 的读缓存 Token 消耗。 (2:08)
- 在合成基准测试中,该并行调度架构下 50% 的任务在 12 分钟内完成,长尾控制在 16 分钟内,显著优于传统嵌套子代理对照组近 30 分钟的表现。 (5:21)
Detailed notes
## Background 该视频由 Bilibili 频道“AI技术投降派”于 2026 年 11 月 2 日发布。视频围绕 DeepSeek 在四大厂竞速推出常驻个人智能体后发布的全新架构蓝图与开源研究原型展开,拆解其如何将操作系统的核心思想引入智能体设计。
## TL;DR 视频深入剖析了 DeepSeek 针对“人类多任务注意力瓶颈”提出的超级智能体(Super-agent)蓝图。架构上采用轻量 Router 派活与上下文隔离 Worker 并发的双层解耦,配合“程序快筛+模型慢判”两道闸、同话题直通省流及静默投机执行机制。底层推行“计算、状态、环境”三分离,并将看门狗设计为具备语义问诊能力的独立智能体。原型仓库虽坦率说明了部分未落地的妥协与 AI 生成代码的事实,但其实验数据与操作系统化调度思想仍为长时程智能体研发提供了极具启发性的工程范式。
## Atmosphere & style 全片充斥着硬核技术极客的敏锐与冷静,解说语速紧凑、条理极度清晰,带着一种“穿透大厂营销迷雾,直击工程底层本质”的透彻感。开篇直切 71 天大厂竞速与一纸蓝图的悬念张力,中间层层展开严密的数据与架构对比,尾声回归计算机系统课的敬畏与笃定。听感上既有看到优雅系统设计时的豁然开朗,又有一种务实、诚恳且不盲目神化的技术思辨氛围。
## Bulletin - [00:05](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=5s) DeepSeek 在各大厂发布常驻个人智能体 71 天后开源了 Super-agent 研究原型,上线 19 小时斩获 3400 星,旨在将操作系统工程思想引入智能体架构。 - [01:19](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=79s) 提出以双层解耦应对人类注意力瓶颈:常驻顶层的 Router 仅用轻量模型负责派活与记忆,底层的并发 Worker 隔离运行最强模型进行闭环执行。 - [02:08](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=128s) 设计程序快筛与模型慢判两道闸及话题直通链路,实验证明直通机制可为系统减少 30% 路由决策并节省 37% 的读缓存 Token 消耗。 - [05:21](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=321s) 在合成基准测试中,该并行调度架构下 50% 的任务在 12 分钟内完成,长尾控制在 16 分钟内,显著优于传统嵌套子代理对照组近 30 分钟的表现。
## Key takeaways - [00:43](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=43s) 多任务处理瓶颈在于人类注意力而非模型能力,普通人仅能同时监控 3 到 5 个会话,常驻智能体需具备连续、高效、主动、持久四特征。 - [01:19](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=79s) 系统架构严格划分为路由层(Router)与工作层(Worker),Router 专注分发协调且不配命令行工具,改变了传统 Leader 深入细节的重推理模式。 - [02:08](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=128s) 外部事件驱动引入两道闸筛选机制,依次通过确定性代码快筛与小型模型语义慢判,过滤机械噪点与无价值事件。 - [02:35](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=155s) 同话题后续事件直接订阅直通 Worker 会话,绕过 Router 避免重复决策,有效降低 37% 读缓存 Token 消耗。 - [03:05](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=185s) 推行激进的投机执行模式,后台针对群聊问题静默复现并验证方案,仅在获得明确解法时介入反馈,减少无效打扰。 - [03:28](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=208s) 采用计算、状态、环境三分离设计,推理在云端无状态伸缩,状态沉淀于独立存储,私有代码与环境安全保留在本地宿主。 - [03:55](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=235s) 相较于 Anthropic 依赖版本历史串行交接的“接力跑”方案,DeepSeek 走向了常驻中央调度并发协同的“调度台”路线。 - [04:27](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=267s) 看门狗(Watchdog)本身被升级为独立的智能体会话,不仅兜底进程拉起,更运用语义判断 Worker 是否陷入原地打转并支持自然语言问诊。 - [05:21](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=321s) 开源原型坦率区分理论蓝图与工程实现:Router、Worker、两道闸及直通四项已落地,看门狗、分布式存算与投机执行在当前版本做了降级折中。 - [06:38](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=398s) 该蓝图本质是将调度、缓存、快慢路径、存算分离等操作系统经典范式引入智能体领域,推动单进程编码规范向操作系统级常驻进化。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=0s) 竞速71天与破局蓝图:多任务上限是人的注意力
在过去两个多月里,四家大厂前后脚发布了常驻的个人智能体产品(8月一家、9月两家、10月一家),节奏咬得极紧,最晚的一家比最早的一家整整晚了 71 天。然而就在第 72 天,DeepSeek 并没有发布竞品,而是甩出了一篇文章加上一个开源的研究原型,直接把常驻智能体底层的架构原理画成了一张系统级蓝图。该开源原型仓库在上线短短 19 个小时内就斩获了 3400 颗星。
之所以要从底层重构智能体,源于文章中一句直击痛点的论断:“单任务的上限取决于模型能力,多任务的上限取决于人的注意力。” 普通用户在实际操作中,通常只能同时紧盯 3 到 5 个活跃会话;当面对成倍增加的任务时,瓶颈往往不在于模型的能力上限,而在于人类用户的精力分身乏术。为了打破这一人机交互瓶颈,DeepSeek 提出了具备四大核心特征的“超级智能体(Super-agent)”形态: - **连续**:跨越不同会话交互,用户始终感觉在与同一个智能体对话。 - **高效**:多项任务在后台高度并发推进,彼此互不干扰。 - **主动**:持续感知并观察外部环境,发现异常或需求自主介入。 - **持久**:保持 24 小时全天候在线,即便遭遇崩溃也能自行恢复拉起。
[01:19](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=79s) 双层解耦架构:不干活的 Router 与隔离的并发 Worker
在系统拓扑上,DeepSeek 摒弃了由单一“团队长”深入每个细节的传统多智能体协作方式,将系统严格划分为两层架构:
```mermaid flowchart TD accTitle: 双层解耦架构图 accDescr: 展示路由层与工作层之间的分工与调用关系
subgraph UserLayer["用户交互层"] U["人类用户"] end
subgraph RouterLayer["路由层 (Router)"] R["常驻调度器<br/>(轻量模型 / 无命令行工具)"] Mem[("全局跨任务记忆")] R <--> Mem end
subgraph WorkerLayer["工作层 (Workers)"] W1["工作会话 1<br/>(最强模型 + 完整工具)"] W2["工作会话 2<br/>(最强模型 + 完整工具)"] W3["工作会话 N<br/>(最强模型 + 完整工具)"] end
U <-->|"统一交互"| R R -->|"分派任务"| W1 R -->|"分派任务"| W2 R -->|"分派任务"| W3 W1 -->|"内部汇报"| R W2 -->|"内部汇报"| R W3 -->|"内部汇报"| R ```
- **路由层(Router)**:常驻系统顶层,承接所有来自人类用户的交互输入,负责全局的任务分派、协调以及维护跨任务的长效记忆。尤为特别的是,路由层仅使用轻量模型驱动,甚至完全不配置命令行工具——它彻底践行“不干活,只管派活”的定位。 - **工作层(Workers)**:由一群彼此上下文完全隔离的工作会话组成。每个 Worker 都配备最顶级的推理模型和完整的外部工具链;Worker 绝对不与人类直接对话,所有产出均向上汇报给路由层,再由路由层汇总整理后统一输出给用户。
这种解耦彻底拉开了架构定位的差距:传统智能体团队的 Leader 往往要深入各个单项任务内部做细致拆解,承受极重的推理负担;而 DeepSeek 的路由层则退后一步,只聚焦于任务之间的高层流转与分派,“一个像项目经理,一个像调度台”。
[02:08](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=128s) 事件驱动机制:两道闸过滤、话题直通与投机执行
在真实环境中,群聊消息、邮件、代码审查(PR review)评论、CI/CD 持续集成构建结果等海量外部输入,都被系统统称为“触发器(Triggers)”。为了应对外部持续涌入的事件洪流,DeepSeek 设计了一整套精细的事件驱动流水线:
```mermaid flowchart LR accTitle: 事件驱动与直通流转图 accDescr: 外部事件经过两道闸筛选后分流至路由层或直通工作层
E["外部事件流<br/>(群聊 / 邮件 / CI 等)"] --> G1{"第一道闸<br/>(程序快筛)"} G1 -->|"过滤无用噪点"| Drop["丢弃"] G1 -->|"合规进入"| G2{"第二道闸<br/>(模型慢判)"} G2 -->|"语义无价值"| Drop
G2 -->|"新任务 / 全局事件"| R["路由层 (Router)"] G2 -.->|"同话题后续事件<br/>(直通优化)"| W["工作层 Worker"] R -->|"派发任务"| W ```
1. **两道闸过滤机制**: - **第一道闸(程序确定性筛选)**:用成本最低的常规代码逻辑先行过滤,挡掉绝大多数无意义的机械噪点。 - **第二道闸(模型语义判断)**:通过小型模型进行语义快判,评估该事件是否值得系统介入消耗算力。 2. **话题订阅直通优化**: 如果事件属于已有任务的延续(例如针对同一个 Pull Request 产生的新评论),系统会触发直通机制,绕过路由层直接送达对应的 Worker 会话。实验数据显示,一旦去掉直通链路,路由层的决策次数将激增 30%,读缓存(Prompt Cache)消耗的 Token 更是直接暴涨 37%。 3. **上下文内敛管理**: 系统严格遵循按需取回原则——仅将短期高频使用的信息保存在当前上下文窗口内,超出预算的历史数据沉淀在窗口外,通过事件引用链一跳一跳精准找回。作者在文章中直言:“浪费上下文窗口就是浪费模型的智能。” 4. **激进的投机执行(Speculative Execution)**: 当用户在工作群中刚刚提出问题或探讨 Bug 时,后台智能体已经开始悄悄尝试复现并寻找补丁方案。只有当后台明确确认了问题且验证了可行解,才会主动在群中给出修复成果;如果并未找到确定解,则全程保持静默,绝不造成多余的打扰。
[03:28](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=208s) 三分离架构:接力跑与调度台的分野
在底层系统设计上,该蓝图将要素彻底解耦为“计算、状态、环境”三分离,借此保障系统的高可用与物理隔离: - **计算无状态**:模型推理完全托管在云端,不保存任何状态,支持随意重启与水平扩容。 - **状态集中存**:所有会话状态持久化至外部数据库,系统的连续性完全依赖存储层,绝不随着特定进程的崩溃而陪葬。 - **环境留原地**:开发与执行环境完整保留在用户本地机器上,包含未提交的代码修改以及各种私有凭据;云端仅向本地派遣一个不维护状态的轻量代理(Lightweight Agent)代为执行本地命令。
该方案在精神上延续了 Anthropic 提出的“脑手分离”思想,但在长时程任务的执行拓扑上走向了截然不同的道路:
| 方案维度 | Anthropic 长时程方案(串行接力跑) | DeepSeek 超级智能体方案(并行调度台) | |:--- |:--- |:--- | | **拓扑结构** | 串行接力模式 | 集中调度并发模式 | | **会话协作** | 单个会话初始化环境,后续会话依次推进一步功能 | 常驻路由层总揽全局,隔离的多个 Worker 并发干活 | | **上下文传递** | 依赖进度文件与 Git 版本历史在会话间显式传递 | 路由层维护跨任务全局状态,按需直通 Worker | | **演进方向** | 类似单线交接的“接力跑” | 类似分工明确的“调度台” |
[04:27](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=267s) 智能体级看门狗(Watchdog):带外自省与动态问诊
以往系统层面的看门狗大多依赖系统守护进程或自动化脚本,而 DeepSeek 蓝图中的看门狗(Watchdog)本身就是一个由定时器触发的、具备独立外部控制环(Outer Control Loop)的智能体会话。它不仅负责基础设施层面的故障兜底与会话拉起,更承担了传统运维工具无法胜任的语义监控:通过模型来审视 Worker 的输出轨迹,深度研判其工作是否有“实质进展”,是否已陷入原地打转或逻辑跑偏。
作为一个全副武装的常驻智能体,运维人员可以用自然语言随时向看门狗发起问诊:“系统现在怎么样了?”甚至可以在系统运行状态下,直接让看门狗动态更新并下发主系统的 Prompt。
从技术演进上看,智能体异常监控经历了一整套技术谱系的迭代: - **三年前**:在 AutoGPT 等早期自主框架中,依赖进程内的简单死循环检测; - **去年**:普遍依赖各个工具内置的生命周期钩子(Lifecycle Hooks); - **上个月**:头部厂商开始推进硬件级别的带外监控; - **DeepSeek 的增量**:将看门狗演进为一个独立的、具备元认知与干预能力的完整智能体。
[05:21](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=321s) 原型账本:落地取舍、实验数据与操作系统回响
作者团队在开源交付上表现得极为坦率,开篇即给出了三重免责声明:“文章导语说这不是功能介绍,文章结尾说原型只为验证技术路线,仓库首页说这是研究代码。” 团队在原型实现与理论蓝图之间做出了清晰的取舍割舍:
```mermaid flowchart TD accTitle: 蓝图落地与取舍对比 accDescr: 原型代码实现的模块与妥协简化的模块对照
subgraph Landed["已落地实现 (4项)"] L1["路由层 (Router)"] L2["工作层 (Workers)"] L3["两级过滤 (程序闸 + 语义闸)"] L4["订阅直通 (同话题绕过 Router)"] end
subgraph Compromised["简化或未落地 (3项)"] C1["看门狗 ➔ 降级为确定性重试与恢复"] C2["云端存算分离 ➔ 降级为单机本地数据库"] C3["投机执行 ➔ 仅保留基础观察模式"] end ```
- **合成负载基准测试**: 在合成压力测试中,超级智能体架构展现出了显著的吞吐优势:50% 的任务在 12 分钟出头即顺利完成,即便是最慢的后 5% 长尾任务,耗时也死死压在 16 分钟以内;反观由单个会话嵌套子代理(Sub-agent)的对照组,长尾任务耗时普遍逼近 30 分钟。 - **工程实现内幕**: 仓库文档公开承认,该原型代码中有很大一部分工程代码是由编码智能体自动编写生成的。 - **操作系统思维的回归**: 作者在结语中指出,这套架构并没有凭空创造全新的高深理论,而是把计算机操作系统领域历经几十年沉淀验证的工程思想——进程调度、缓存机制、快慢路径分流、存算分离、外部看门狗——完整移植到了智能体体系中。如果说过去业界总结的“智能体工程 12 因子”规范的是单个进程内的编码纪律,那么这份蓝图所立下的,正是“操作系统级的常驻法则”。目前社区不仅在短短两天内发布了完全脱离特定宿主的独立复现,更有独立开发者感叹该设计与自己苦苦摸索半年的架构不谋而合。正如演讲者所言:“当智能体开始按操作系统的规则生活,也许是时候把系统课重新翻出来了。”
## Notable quotes > [00:00](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=0s) 单任务的上限取决于模型能力,多任务的上限取决于人的注意力。
> [05:21](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=321s) 当智能体开始按操作系统的规则生活,也许是时候把系统课重新翻出来了。 — AI技术投降派
> [02:08](https://www.bilibili.com/video/BV1Ltxh61Ej9?t=128s) 浪费上下文窗口就是浪费模型的智能。
## Mentioned DeepSeek, Anthropic, AutoGPT, AI技术投降派, Super-agent, Router, Worker, Watchdog
## Video description 过去两个多月,四家大厂前后脚发布了常驻的个人智能体,最晚的比最早的晚了 71 天。71 天后,DeepSeek 也发了一篇东西——不是产品,是一篇文章加一个研究原型:把这类产品底下的架构原理画成蓝图。原型仓库 19 小时 3400 颗星。
为什么要这么干?文章里有句扎心的话:单任务的上限取决于模型能力,多任务的上限取决于人的注意力。你一个人只能同时盯 3 到 5 个活跃会话——再多的任务,不是模型干不了,是你分身乏术。于是有了"Super-agent"四特征:连续、高效、主动、持久。
架构是两层的:常驻的 Router 只管派活不干活,轻量模型就够,甚至不配命令行工具;一群上下文隔离的 Worker 用最强模型并发干活,不跟人说话只汇报。事件驱动两道闸(程序快筛+模型慢判),同话题后续事件直通 Worker 绕过 Router——省下 37% 的读缓存 token。还有最激进的投机执行:群里还在讨论问题,后台已经悄悄复现找修复,确认了才拿出来,否则全程安静。计算/状态/环境三分离(沿用 Anthropic 脑手分离),Watchdog 不是进程而是另一个智能体会话——用模型判断工人有没有实质进展,还能自然语言问诊。
原型账本很诚实:落了四块(Router/Worker/两道闸/直通),没落三块(看门狗换成确定性重试、云化变本地库、投机执行只剩观察模式)。三处免责声明:不是功能介绍、只为验证技术路线、研究代码。实验里一半任务 12 分钟出头完成,对照组近 30 分钟。仓库自己承认:很大一部分工程是编码智能体写的。
文章结语说得很实在:没有提出新理论,只是把操作系统玩了几十年的东西搬进智能体——调度、缓存、快慢路径、存算分离、看门狗。十二因子管的是进程内纪律,这份蓝图管的是操作系统级的常驻。发布两天,社区已做出不依赖宿主的独立复现。当智能体开始按操作系统的规则生活,也许是时候把系统课翻出来了。
00:05 四家竞速71天,第72天来了一张蓝图 00:43 为什么:多任务上限是人的注意力 01:19 双层:不干活的Router只管派活 02:08 事件驱动:两道闸、直通省37%、投机执行 03:28 三分离:计算/状态/环境,接力跑vs调度台 04:27 看门狗:它自己也是个智能体 05:21 原型账本:落四块没落三块,代码是AI写的 06:38 收尾:把系统课翻出来
文章:mp.weixin.qq.com/s/zoS7GlReWPhfCjENGxXCdg(官方) 仓库:github.com/deepseek-ai/dsh-superagent-prototype
[Source](https://www.bilibili.com/video/BV1Ltxh61Ej9)