美团推1.6万亿参数AI模型 打价格战并用国产芯片训推
AI技术投降派
美团依靠5万卡国产集群与失败轨迹重训实现底层代际跨越并用两元百万Token压价抢滩,但宣传选择性剔除国产竞品且权重暂未真正开源。
AI-assisted summary of 美团LongCat-2.5 正式版开源 — original source. Check the original for full context.
Source published:
Key ideas
- 美团发布 1.6 万亿参数的 LongCat-2.5 正式版,MoE 架构下单 Token 激活约 480 亿参数,核心升级聚焦于原生视觉与长程智能体能力。 (0:00)
- 训练基于 5 万卡国产算力集群,通过超节点通信重构、W4A4 极限压缩量化及训推比特级一致性工程,克服了单卡显存不足 80GB 的硬件瓶颈。 (2:00)
- 商业化打出激进价格战,API 原生兼容 OpenAI 与 Anthropic 协议,限时折扣下输入 100 万 Token 仅需 2 元,Prompt 缓存命中低至 4 分钱。 (3:40)
- 官方宣称的“四项评测第一”经过筛选对比,且目前权重尚未开源,在代码复杂逻辑深度及超过 20 万 Token 的长上下文中仍存在退化问题。 (3:40)
Detailed notes
## Background 该视频由 Bilibili UP 主“AI技术投降派”于 2026 年 11 月 3 日发布。视频围绕美团最新发布的 1.6 万亿参数大模型 LongCat-2.5 正式版展开,深入剖析其评测表现、底层技术与商业策略;原视频未提供额外的简介内容。
## TL;DR 美团上线了 1.6 万亿参数的 MoE 架构大模型 LongCat-2.5 正式版,在原生多模态视觉与智能体能力上取得显著代际跃升。技术上,美团依托 5 万卡国产算力集群克服了显存不足 80G 的瓶颈,通过失败轨迹重训机制与 W4A4 量化优化了训推工程;商业上则兼容双主流接口并打起外卖式价格战。但拆解官方宣传后可见其评测排名存在精心筛选样本的“发布会数学”,且当前开源权重未正式放出,长上下文处理与深度代码编程仍存在明显短板。
## Atmosphere & style 视频整体呈现出清醒、辛辣且极度硬核的技术博主解构风格。UP 主既没有盲目为国产品牌“吹狂欢”,也没有全盘唱衰,而是带着技术侦探般的审视眼光,用“发布会数学”、“三盆冷水”等锐利词汇层层剥开公关包装。在犀利拆解水分的同时,叙事又对美团在国产硬件泥潭中扎实啃硬骨头的工程实力给予了敬意,整段讲解节奏紧凑、反转连连,散发着冷静理智却充满产业张力的工业现实感。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1sW4w6UEfE?t=0s) 美团发布 1.6 万亿参数的 LongCat-2.5 正式版,MoE 架构下单 Token 激活约 480 亿参数,核心升级聚焦于原生视觉与长程智能体能力。 - [02:00](https://www.bilibili.com/video/BV1sW4w6UEfE?t=120s) 训练基于 5 万卡国产算力集群,通过超节点通信重构、W4A4 极限压缩量化及训推比特级一致性工程,克服了单卡显存不足 80GB 的硬件瓶颈。 - [03:40](https://www.bilibili.com/video/BV1sW4w6UEfE?t=220s) 商业化打出激进价格战,API 原生兼容 OpenAI 与 Anthropic 协议,限时折扣下输入 100 万 Token 仅需 2 元,Prompt 缓存命中低至 4 分钱。 - [03:40](https://www.bilibili.com/video/BV1sW4w6UEfE?t=220s) 官方宣称的“四项评测第一”经过筛选对比,且目前权重尚未开源,在代码复杂逻辑深度及超过 20 万 Token 的长上下文中仍存在退化问题。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1sW4w6UEfE?t=0s) 美团自 15 个月前开源初代 Flash 以来,历经 2.0 正式版与 2.5 预览版,快速迭代至 1.6 万亿参数的 LongCat-2.5 正式版。 - [00:00](https://www.bilibili.com/video/BV1sW4w6UEfE?t=0s) LongCat-2.5 的核心增量在于原生视觉架构与长程 Agent 能力,而非参数体量的简单扩充。 - [00:00](https://www.bilibili.com/video/BV1sW4w6UEfE?t=0s) 官方“四项第一”看板仅对比了两款 GPT 与两款 Claude,若加入 DeepSeek、Kimi 等国产竞品,部分榜首项目需让贤。 - [00:00](https://www.bilibili.com/video/BV1sW4w6UEfE?t=0s) 模型代际内部进化显著,终端基准得分从 2.0 版的 3 分暴涨至 38.5 分,深度软件工程评测跃升至 64.6 分。 - [02:00](https://www.bilibili.com/video/BV1sW4w6UEfE?t=120s) 强化学习采用失败轨迹重训机制,将真实 Agent 任务中的失败过程重新打包为可复现、可验证的全新训练题目。 - [02:00](https://www.bilibili.com/video/BV1sW4w6UEfE?t=120s) 任务数据源自 GitHub 真实代码并附带先失败后通过的回归测试,通过断网与清除缓存等沙盒化手段阻断作弊捷径。 - [02:00](https://www.bilibili.com/video/BV1sW4w6UEfE?t=120s) 原生视觉方案将图像离散化为多层级词表并统一至文本 Token 空间,无需主干网络额外区分即可端到端完成 UI 生成与 3D 建模任务。 - [02:00](https://www.bilibili.com/video/BV1sW4w6UEfE?t=120s) 针对 5 万卡国产算力集群单卡显存不足 80GB 的现状,团队重构了并行通信策略,将通信高频域收敛至超节点内。 - [02:00](https://www.bilibili.com/video/BV1sW4w6UEfE?t=120s) 通过 W4A4(权重与激活均压缩至 4 比特)量化,推理吞吐比 INT8 基线提升超 40%,并实现了训练与推理在逐 Token 输出上的比特级数值一致性。 - [03:40](https://www.bilibili.com/video/BV1sW4w6UEfE?t=220s) API 同时原生兼容 OpenAI 与 Anthropic 协议规范,开发者可直接在 Claude Code 等生态工具中无缝替换 Base URL。 - [03:40](https://www.bilibili.com/video/BV1sW4w6UEfE?t=220s) 美团将本地生活价格策略复制到大模型赛道,推出输入 100 万 Token 售 2 元、缓存命中 4 分钱的进攻性定价与整点抢购玩法。 - [03:40](https://www.bilibili.com/video/BV1sW4w6UEfE?t=220s) 与 2.0 迅速开源不同,2.5 正式版目前在 GitHub 和 Hugging Face 仅挂出占位符,尚未开放权重下载。 - [03:40](https://www.bilibili.com/video/BV1sW4w6UEfE?t=220s) 模型在代码深水区与 Claude Opus 相比仍有 15 分的终端基准差距,长上下文达到 20 万 Token 附近时易出现逻辑原地打转。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1sW4w6UEfE?t=0s) “发布会数学”背后的真实战绩与代际跨越
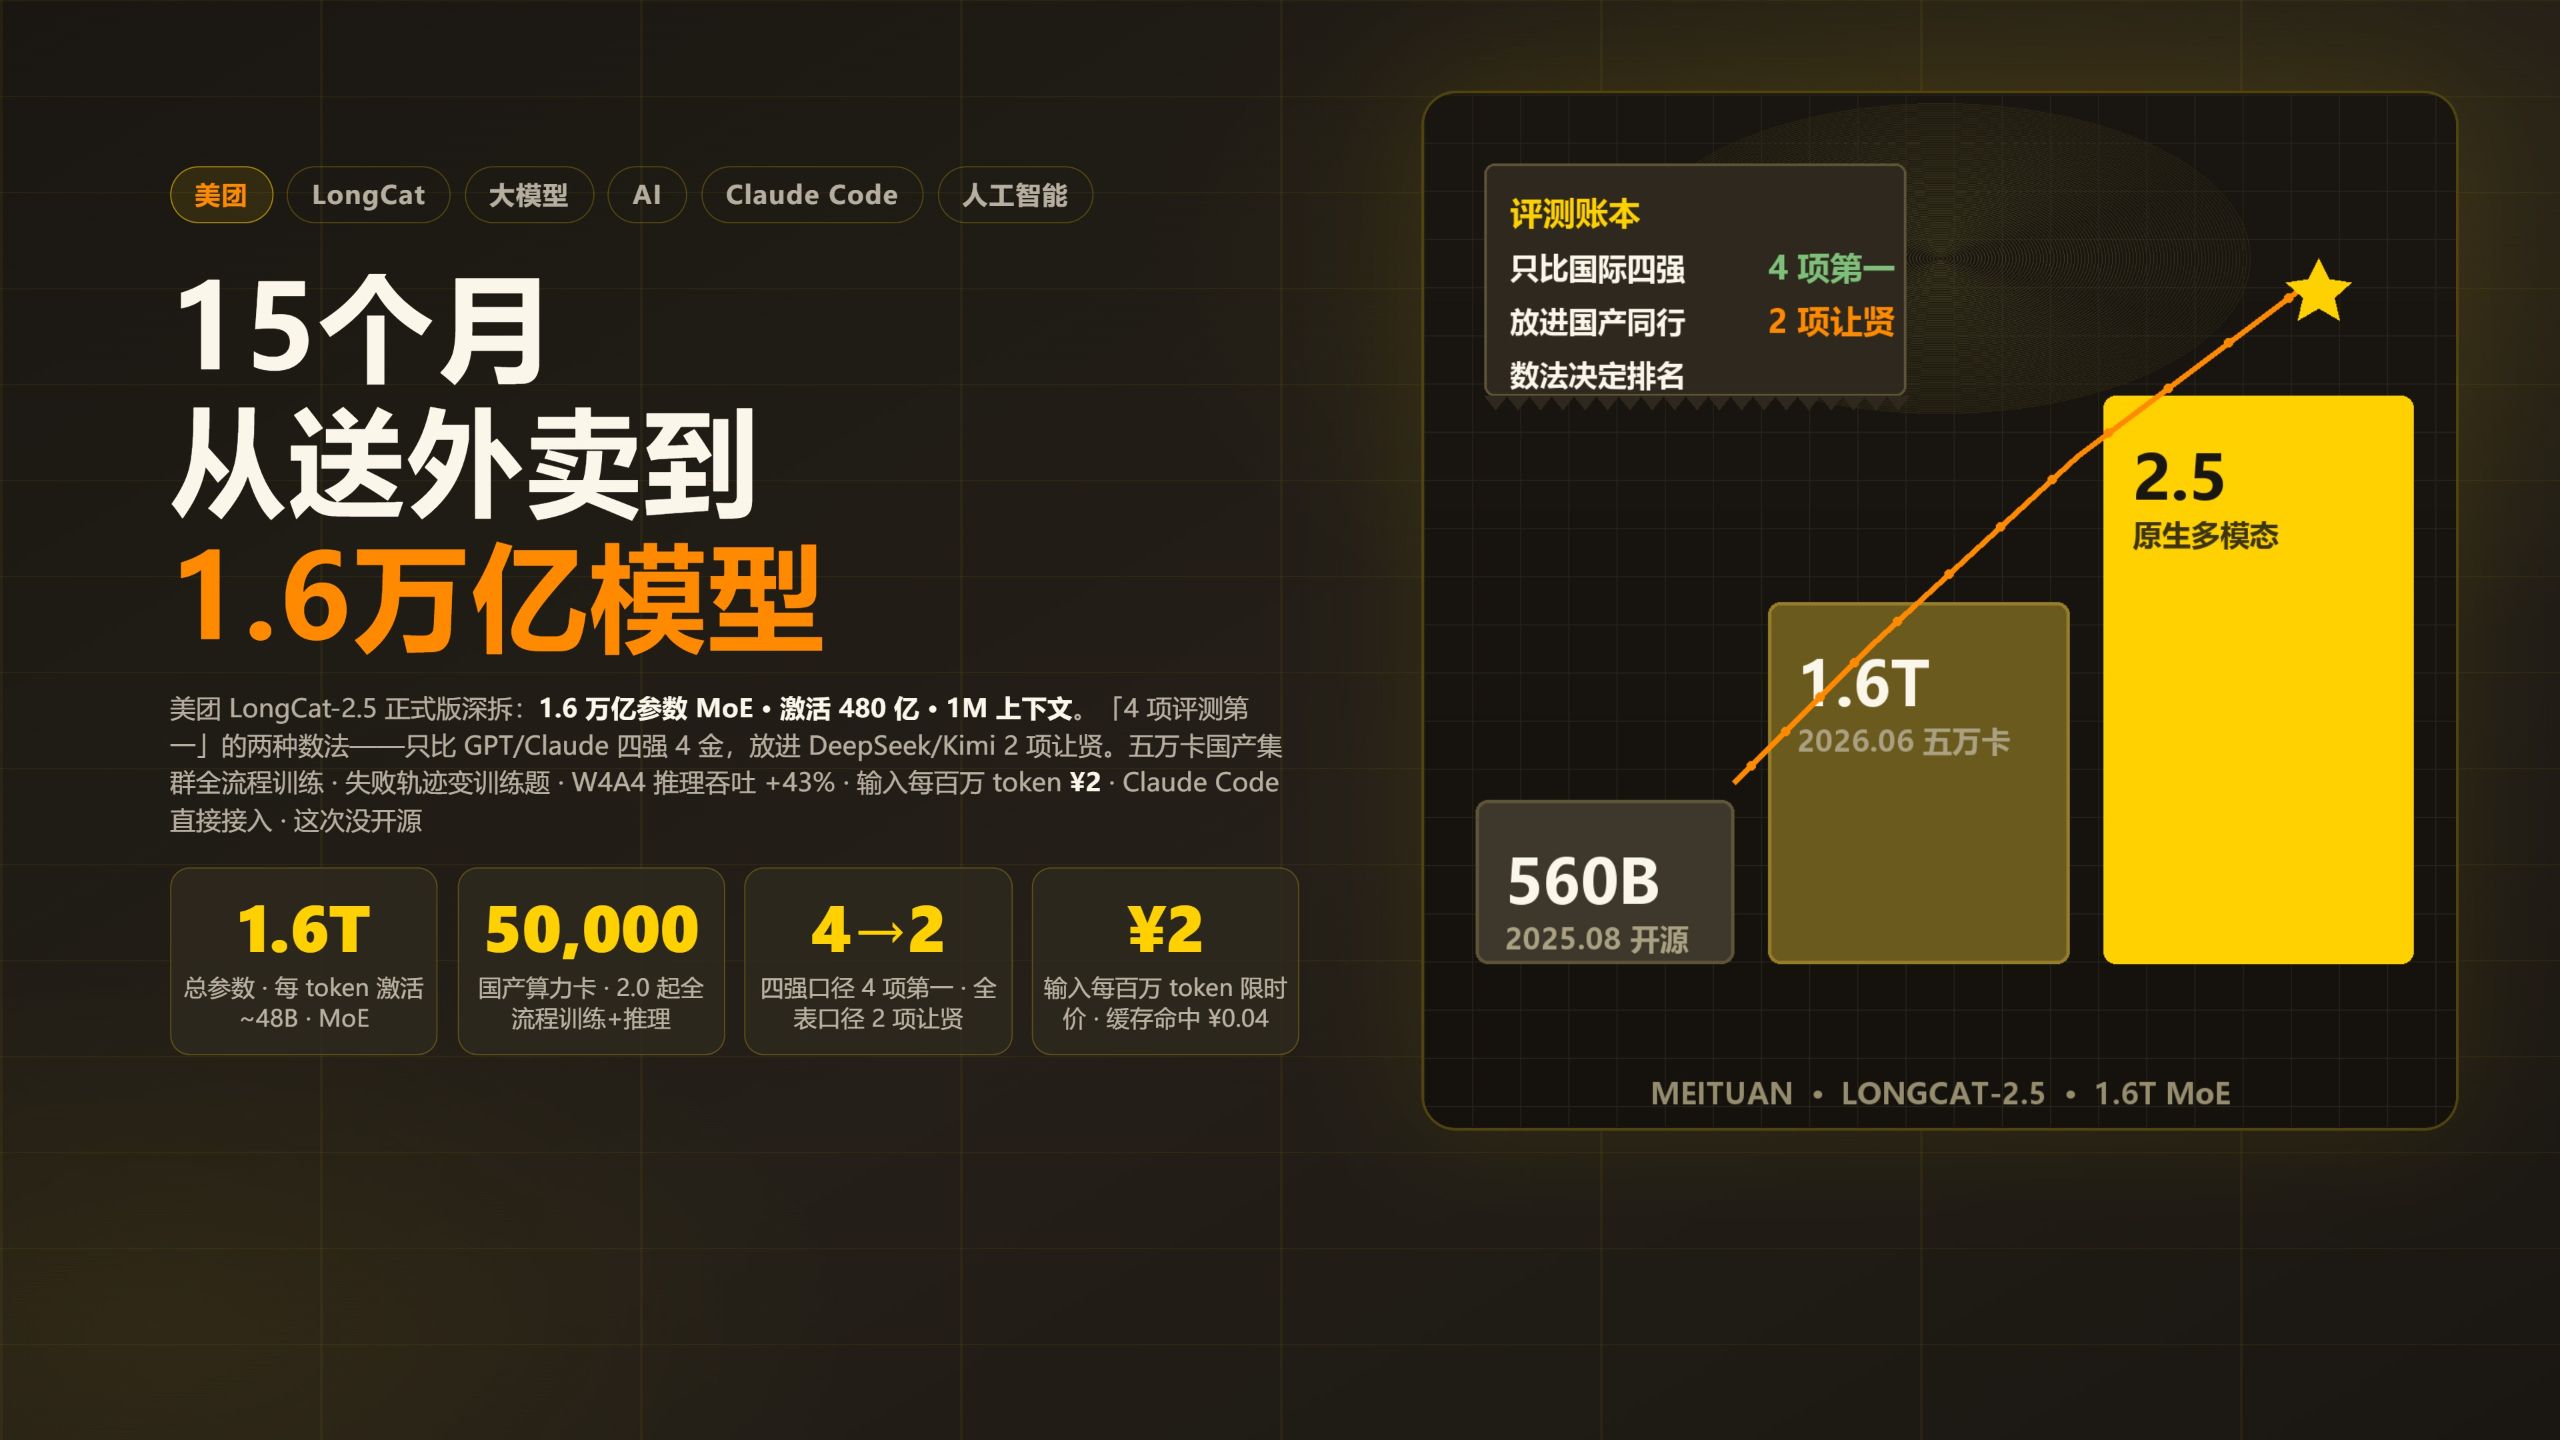
11月1日,美团正式上线了 LongCat-2.5 正式版大模型。这颗庞然大物总参数达到 1.6 万亿,每个 Token 激活约 480 亿参数。一家以送外卖起家的互联网公司,在短短 15 个月前才刚发布其第一个开源模型,如今已经能把自研模型的评测成绩与 OpenAI 的 GPT 和 Anthropic 的 Claude 放在同一张表格里正面硬碰硬。回溯其迭代轨迹:去年 8 月,美团直接开源了 5600 亿参数的第一代 LongCat Flash;今年 6 月 30 日,推出了 1.6 万亿参数的 2.0 正式版,成为业界首个宣称在 5 万卡国产算力集群上完成全流程训练和推理的万亿参数模型,并于 7 月开源了权重;9 月 25 日推出 2.5 预览版后,仅历时五周,2.5 正式版便拍马赶到。实际上,“1.6 万亿参数”并非本次的新增量,上一代 2.0 就已是此等体量,2.5 真正的核心迭代在于另外两处硬指标:原生视觉能力与长程智能体(Agent)。
官方宣传统稿主打“四项评测第一”,但这个成绩在数据解读上颇有玄机。美团官方展示的看板仅挑选了四款国际顶尖模型作对比——两款 GPT 与两款 Claude Opus。在这张经过挑选的对比表里,LongCat-2.5 确实斩获四项第一,例如 Browse Comp 拿下 91.9 分,Automation Bench 拿下 51.8 分,以及在 3D 生成方面的突出表现。然而,如果翻开同一篇官方技术博客中附带的完整大表,同台竞技的还有三家国产同行:DeepSeek、Kimi 与智谱 GLM。一旦把国产友商加回坐标系,排名立刻生变:Automation Bench 的头把交椅被 DeepSeek 新款的 54.8 分夺走,美团以 51.8 分屈居第二;另一项第一则被 Kimi 的 86.3 分摘得。
更为坦诚的是官方表格的角标说明:带星号的分数来源于各家已发布的公开报告,不带星号的则是美团团队自行测试的结果。博主评价这种对比策略道:“所以准确的说法是对标国际四强四项第一,放进国产同行两项让贤,还有个反向细节,完整表格里有两项他真是全场第一,反而没被选进宣传图,所以这不是造假,这是发布会数学,数法决定排名。”抛开营销包装,模型自身的真实代际跨越依然显著:与美团自家的 LongCat-2.0 相比,2.5 版本的终端基准得分直接从 3 分暴涨至 38.5 分,深度软件工程评测更是从 9.7 分跃升至 64.6 分,完成了极为扎实的底层性能进化。
- 模型规模:总参数量 1.6 万亿,采用 MoE 架构,单 Token 激活参数约 480 亿。 - 研发周期:去年 8 月发初代 Flash(5600亿参数直接开源)→ 6 月 30 日发 2.0(5万卡国产集群全流程训推,7月开源权重)→ 9 月 25 日发 2.5 预览版 → 5 周后正式版上线。 - 榜单表现: - Browse Comp:91.9 分。 - Automation Bench:51.8 分(落后于 DeepSeek 新款的 54.8 分)。 - 自家代际提升:终端基准从 3 分提升至 38.5 分;深度软件工程从 9.7 分跃升至 64.6 分。
---
[02:00](https://www.bilibili.com/video/BV1sW4w6UEfE?t=120s) 失败轨迹重训与 5 万卡国产算力工程栈
在训练方法论上,美团官方技术博客中有一句极具分量的话揭示了其强化学习的核心秘密:“将真实 agent 的失败轨迹转化为可复现可验证的训练任务。”用通俗的话来解释,就是当模型在执行复杂任务干活失败后,系统不会直接抛弃这些数据,而是将失败过程的原貌重新打包成一道针对性的新题目,逼迫模型反复推演并重新做对。围绕这一思路,工程落地层面执行了三项极具针对性的严苛策略:
```mermaid flowchart TD accTitle: LongCat 2.5 训练与推理工程管线 accDescr: 展示模型数据校验、防作弊机制、原生多模态 Token 化以及国产集群底层适配的完整技术流程。
subgraph DataEngine["数据与任务工程"] A["GitHub 真实代码任务"] --> B["先失败后通过的测试校验"] C["环境沙盒化防御"] --> D["断网 / 清除历史 / 清除缓存"] B & D --> E["失败轨迹打包再学习"] end
subgraph Multimodal["原生图文统一架构"] F["多模态输入 (图/文)"] --> G["图片离散化为多层级词表"] G --> H["统一 Token 空间 (主干无须区分图文)"] end
subgraph Hardware["5万卡国产算力拓扑优化"] I["单卡显存不足 80G"] --> J["超节点重构并行策略<br/>通信收敛至高带宽域"] J --> K["W4A4 重量级量化<br/>(吞吐比 INT8 提升超40%)"] K --> L["训推比特级数值一致性"] end
DataEngine --> Multimodal --> Hardware ```
首先,训练数据均取材于 GitHub 的真实代码任务,且每一道试题都强制配套“先失败后通过”的回归测试校验,以此在数据源头杜绝题目本身存在逻辑错误;其次是极其决绝的防作弊隔离机制,训练环境直接物理断网,并全面清除版本历史与文件缓存,彻底斩断模型利用上下文遗留信息投机取巧走捷径的可能,逼迫其真正掌握解题推理逻辑;第三是原生视觉能力的底层统一,模型将图片信号离散化为多层级词表,将视觉与文本深度对齐为同一种 Token 格式。主干网络从底层不需要区分输入的是图像还是文字,因此能够原生具备看懂软件 UI 界面直接写前端代码、完成复杂 3D 生成以及创意设计的能力,官方为此一口气释出了从实时流体模拟到 3D 文物展等 8 个端到端演示。
在底层的物理硬件上,美团补全了 2.0 阶段未曾详述的工程深水区细节。支撑这套全流程训推体系的是一个 5 万卡规模的国产算力集群。由于所采用的国产训练卡单卡显存不足 80GB,显存资源远比英伟达主流旗舰训练卡更为吃紧。面对瓶颈,美团的工程团队并没有止步于“租卡把代码跑通”,而是根据国产芯片的超节点拓扑结构彻底重构了并行通信策略,竭力将海量的高频通信压制在超节点内部的高带宽物理域内。在推理阶段,团队部署了激进的重量级量化技术,将权重(Weight)和激活(Activation)双双压缩至 4 比特(W4A4),直接使推理吞吐量相较于 INT8 基线拉升了 40% 以上。此外,美团还啃下了一项冷门但极为硬核的工程骨头——“训推数值一致性”,实现训练环境与推理环境在逐个 Token 输出时维持比特级的精准一致,标志着其对整套国产算力工程站进行了脱胎换骨式的深度拓扑与工程打磨。
---
[03:40](https://www.bilibili.com/video/BV1sW4w6UEfE?t=220s) 外卖价格战进军 AI,以及不可忽视的“三盆冷水”
在商业化接口与生态兼容性上,LongCat-2.5 采用了极为务实的双格式策略:官方 API 接口原生同时兼容 OpenAI 与 Anthropic 规范。这意味着开发者在使用 Claude Code 等基于 Anthropic 协议构建的流行编码工具时,甚至无需重构调用逻辑,只需在配置里替换一个 Base URL 地址即可无缝迁移。官方文档中也顺水推舟,将一整排主流开发者开发套件的接入指南悉数码齐。
在价格战策略上,美团将本地生活业务的打法直接复制到了大模型赛道,上线了极具进攻性的限时折扣:输入 100 万 Token 仅收 2 元人民币,命中 Prompt 缓存时单价低至 4 分钱,输出 100 万 Token 价格则定为 8 分。两块钱的价格,形象地说“不过是一份外卖配送费的零头”,却能在美团这里买下整整一百万字的上下文输入空间。与此同时,平台还设置了类似外卖抢红包的促销玩法,每天在四个固定整点开放抢购限时 Token 资源包。
尽管声量浩大、工程亮眼,但博主也毫不留情地给出了三盆理性客观的“冷水”: - **权重并未真正开源**:与 2.0 发布一周内火速开源不同,当前 GitHub 和 Hugging Face 页面仅挂着“敬请期待”(Coming soon)的占位符,官方对于 2.5 版本究竟会不会开源、何时开源没有任何明确承诺。 - **榜单排名的口径美化**:正如前文拆解,所谓横扫同行的“四项第一”是精细挑选对比样本后的“发布会数学”,一旦置于国产模型群雄逐鹿的真实环境中,部分项目已让位于竞品。 - **代码硬仗与长上下文依旧存在短板**:LongCat-2.5 的终端基准测试成绩依然落后 Claude Opus 整整 15 分,在软件开发深水区并未真正翻盘。海外技术社区与论坛的实际测试也出现了差评反馈,吐槽其对复杂代码的分析粒度不够细致,且在长对话上下文推进至 20 万 Token 左右时,模型开始出现逻辑原地打转、语义退化的现象。
博主在最后总结时将观察视角拉向更宏大的行业维度。虽然模型在极限编程上依然有待磨砺,但横向审视其成长速度,依然令人无法轻视:“把镜头拉远,15个月前,这家公司没有万亿模型,今天,他用5万张国产卡训出1.6万亿,输入100万字两块钱,外卖公司的AI竞赛门票,攥住了。”
- 接口与工具生态:兼容 OpenAI 和 Anthropic 接口格式,Claude Code 工具可直接更换 API 端点使用。 - 极速折扣价格: - 输入:2 元 / 100 万 Token; - 缓存命中:0.04 元 / 100 万 Token; - 输出:0.08 元 / 100 万 Token; - 运营玩法:每日四个整点提供限时抢购的优惠 Token 包。 - 真实局限反思:开源承诺缺失;终端基准测试仍落后 Claude Opus 达 15 分;20 万 Token 长上下文后容易出现打转与分析粒度粗糙的现象。
## Notable quotes > [00:00](https://www.bilibili.com/video/BV1sW4w6UEfE?t=0s) 这不是造假,这是发布会数学,数法决定排名。 — AI技术投降派
## Mentioned 美团, LongCat-2.5, LongCat-2.0, LongCat Flash, OpenAI, GPT, Anthropic, Claude, Claude Opus, Claude Code, DeepSeek, Kimi, 智谱 GLM, GitHub, Hugging Face
[Source](https://www.bilibili.com/video/BV1sW4w6UEfE)