OpenAI推生活基准LifeVal刷分80 真实网站实测成功率仅6.5%
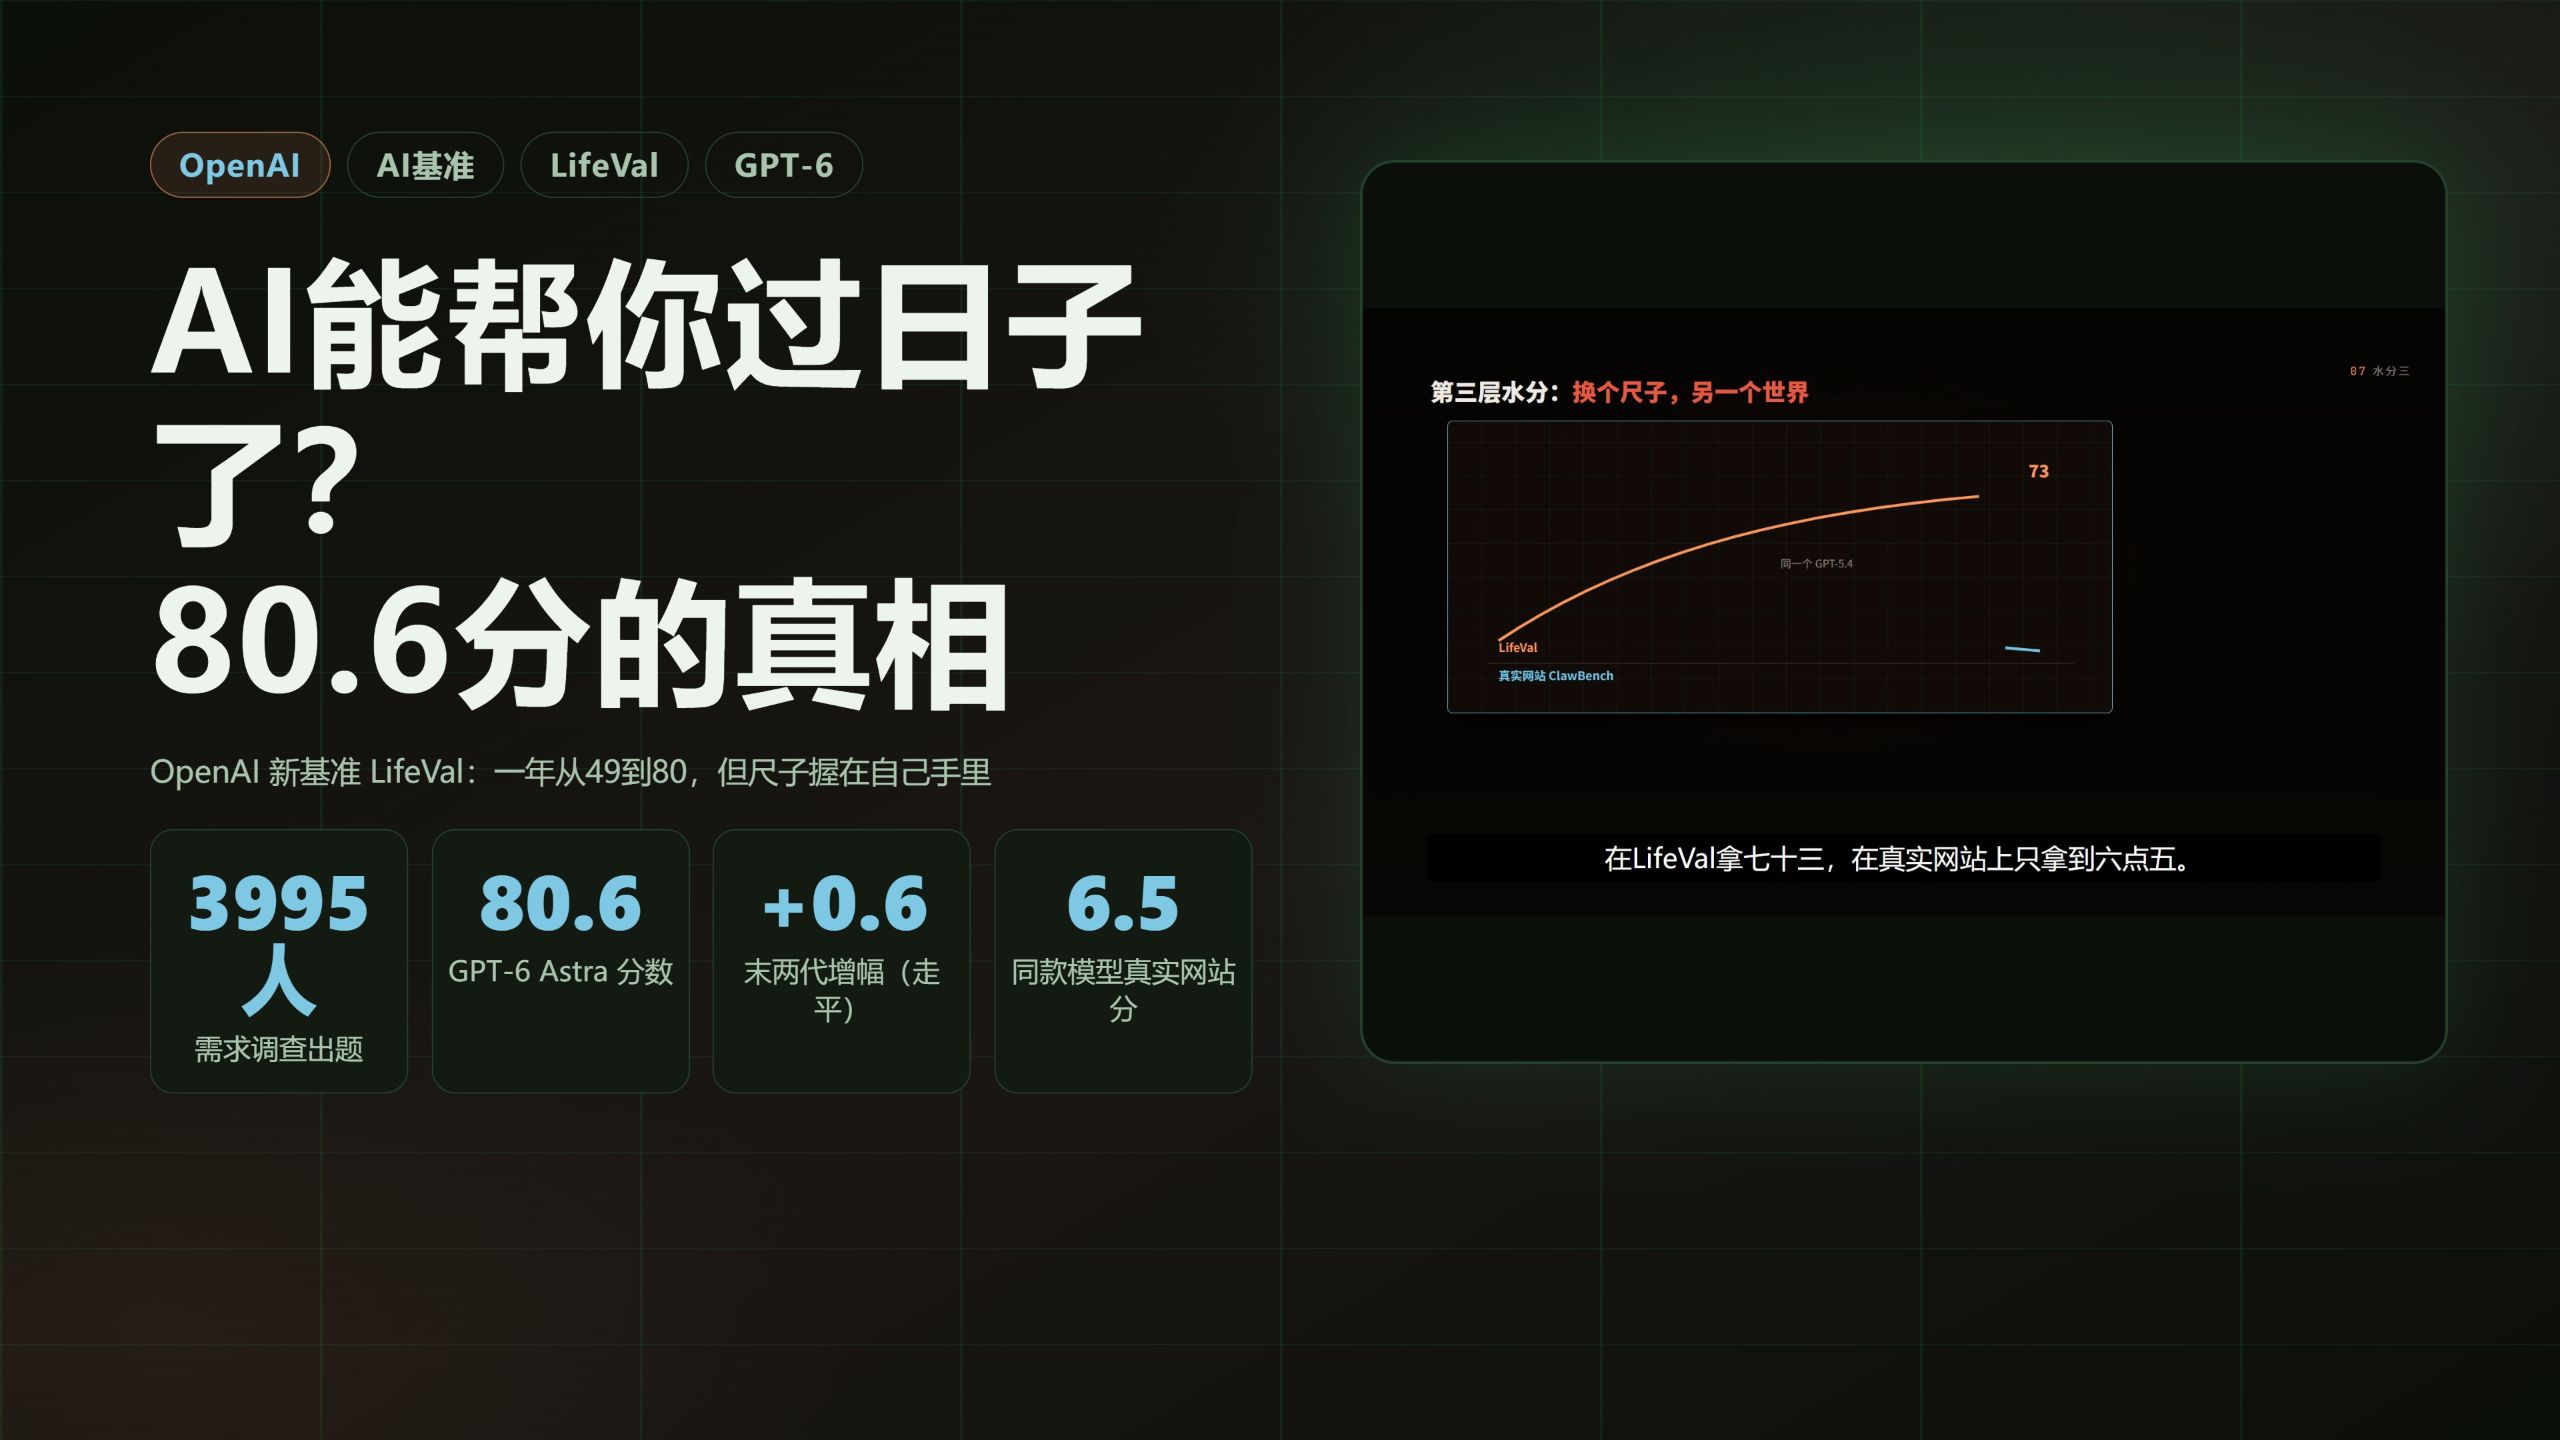
AI技术投降派
官方80.6分仅代表未披露细则的部分步骤奖励均值,在真实网站上模型办成日常事务的概率仍是个位数。
AI-assisted summary of AI能帮你过日子了?openAI发布AI智能生活新基准 — original source. Check the original for full context.
Source published:
Key ideas
- OpenAI 推出全新基准 LifeVal,依托国家时间统计、3995 人真实需求调查与约 100 位领域行家出题,全面评估 AI 解决照护、政务、财务等七大日常生活任务的能力。 (0:00)
- 官方旗舰模型 GPT-6 Astra 获得 80.6 分,但该分数并非任务办成率,而是基于部分分计算的“未加权平均奖励”,且末两代模型提升仅 0.6 分,进步曲线明显放缓。 (2:43)
- LifeVal 存在严重的自评封闭性与落地断层:任务数量、判卷标准等核心细节未披露,且在真实网站环境中同代模型的任务办成率仅为 6.5%。 (3:57)
- 生活任务基准得分 80.6 与同期发布的专家级长任务基准 GDPx 得分 12% 需对照审视,客观呈现出 AI 在日常琐事与高壁垒复杂任务上的真实能力落差。 (5:49)
Detailed notes
## Background 该视频由 Bilibili UP 主“AI技术投降派”于 2026 年 11 月 3 日发布。视频围绕 OpenAI 刚刚推出的生活场景新基准 LifeVal 展开,结合简介详细拆解了这套宣称测 AI“能不能帮你过日子”的基准从何而来、官方跑分 80.6 背后的三层水分,以及其在现实世界中的真正价值与读法。
## TL;DR 视频深入剖析了 OpenAI 旨在测试日常事务处理能力的 LifeVal 基准,高度肯定了其通过时间统计、近四千人问卷调查及百名行家命题的“需求端”构建逻辑。随后,主讲人尖锐拆解了 80.6 高分背后的三层水分:它是按步骤给分的部分奖励均值而非端到端办成率;评测细节与代码均未开源且清一色自测自评,存在“既当裁判又当选手”的封闭性;换到真实网站测试后同代模型成功率断崖式跌至 6.5%。最后,主讲人指出 LifeVal 的 80.6 需与专家级长任务 GDPx 的 12% 对照来看,警惕过度营销,必须等到题目公开和第三方上榜才能算真正交出答卷。
## Atmosphere & style 全片充斥着理性、辛辣且极具穿透力的技术批判风格,既不盲目唱衰也不随波逐流跟风吹捧。主讲人以冷静克制的语调层层剥茧,用概率乘法、真实网站对照实验等硬核数据对官方公关数字无情“脱水”,现场感如同一场技术审计。在泼完冷水后,叙述又重回对真实需求的诚恳探讨,在批判与认可之间保持了清醒而犀利的思辨张力。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1Em4M64ER4?t=0s) OpenAI 推出全新基准 LifeVal,依托国家时间统计、3995 人真实需求调查与约 100 位领域行家出题,全面评估 AI 解决照护、政务、财务等七大日常生活任务的能力。 - [02:43](https://www.bilibili.com/video/BV1Em4M64ER4?t=163s) 官方旗舰模型 GPT-6 Astra 获得 80.6 分,但该分数并非任务办成率,而是基于部分分计算的“未加权平均奖励”,且末两代模型提升仅 0.6 分,进步曲线明显放缓。 - [03:57](https://www.bilibili.com/video/BV1Em4M64ER4?t=237s) LifeVal 存在严重的自评封闭性与落地断层:任务数量、判卷标准等核心细节未披露,且在真实网站环境中同代模型的任务办成率仅为 6.5%。 - [05:49](https://www.bilibili.com/video/BV1Em4M64ER4?t=349s) 生活任务基准得分 80.6 与同期发布的专家级长任务基准 GDPx 得分 12% 需对照审视,客观呈现出 AI 在日常琐事与高壁垒复杂任务上的真实能力落差。
## Key takeaways - [00:05](https://www.bilibili.com/video/BV1Em4M64ER4?t=5s) LifeVal 转变了以往偏向代码与数学的评测思路,首次把国家级时间使用统计与数千名大众的现实诉求作为基准的出题来源。 - [00:39](https://www.bilibili.com/video/BV1Em4M64ER4?t=39s) 基准任务构建采用三层递进方式:结合时间使用数据(ATUS/MTUS)、3995 人代表性问卷筛选,以及约 100 位真人行业专家的实操命题。 - [01:42](https://www.bilibili.com/video/BV1Em4M64ER4?t=102s) 题目涵盖照护、健康、教育、家务行政、个人财务、购物与政务服务等七大生活领域,并嵌入真实住址、预算等个性化约束。 - [02:15](https://www.bilibili.com/video/BV1Em4M64ER4?t=135s) 该评估体系传承自斯坦福 BEHAVIOR-1K 与 OpenAI 自身的工作基准 GDPval,是需求导向方法论向生活场景的延伸。 - [02:43](https://www.bilibili.com/video/BV1Em4M64ER4?t=163s) 虽然官方公布的模型跑分在一年内从 49.3 跃升至 80.6,但末两代模型仅微涨 0.6 分,技术迭代曲线呈现走平趋势。 - [03:14](https://www.bilibili.com/video/BV1Em4M64ER4?t=194s) 80.6 分属于步骤评分均值(未加权平均奖励),绝不等于任务办成率;在多步流程中,单步的高准确率端到端复合后整体成功率会大幅衰减。 - [03:57](https://www.bilibili.com/video/BV1Em4M64ER4?t=237s) 基准透明度存疑,任务总数、打分裁判机制、奖励公式及人类基线等关键信息均未公开,榜单亦仅包含 OpenAI 内部模型。 - [04:32](https://www.bilibili.com/video/BV1Em4M64ER4?t=272s) OpenAI 长期使用 LifeVal 驱动模型优化,造成基准“既是训练靶子又是度量尺子”的闭环测试风险。 - [04:55](https://www.bilibili.com/video/BV1Em4M64ER4?t=295s) 在真实网络环境中模型表现遭遇滑铁卢:LifeVal 获 73 分的模型在真实网站执行日常事务的二元办成率仅为 6.5%。 - [05:28](https://www.bilibili.com/video/BV1Em4M64ER4?t=328s) 生活决策存在严重的不可逆风险(如选错医保或误操作支付),但 LifeVal 目前未按任务的潜在危害程度建立分级加权机制。 - [05:49](https://www.bilibili.com/video/BV1Em4M64ER4?t=349s) 转向生活场景具有业务必然性,ChatGPT 日常调用中非办公消息占比已突破 70%,大众诉求已转向打理日常生活。 - [06:12](https://www.bilibili.com/video/BV1Em4M64ER4?t=372s) 结合同期专家任务基准 GDPx 仅 12% 的表现来看,当下的客观认知应是:生活辅助能力显著上升,但高难度长流程依然受限。 - [06:33](https://www.bilibili.com/video/BV1Em4M64ER4?t=393s) 只有在题目全面开源、引入外部盲测裁判并允许第三方竞品同台比拼后,LifeVal 的跑分才具备真正的行业说服力。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1Em4M64ER4?t=0s) LifeVal 基准出炉:测 AI 能不能帮你“过日子”
OpenAI 发布了一套名为 LifeVal 的全新基准。不同于以往卷代码、卷数学题的测试逻辑,LifeVal 专注于评估一件事:AI 到底能不能帮普通人过日子。为了不让题目沦为专家拍脑袋编造的空中楼阁,OpenAI 采用了一套三层递进的任务构建体系:第一层是调阅美国时间使用调查(ATUS)及跨国的多国时间使用研究(MTUS),从统计学层面摸清普通人一天的时间分配;第二层是针对吃饭、睡觉等 AI 无法替代的生活场景做过滤,向 3995 人发放代表性问卷,摸排大众最迫切希望 AI 接手的琐事;第三层则是邀请约 100 名真人领域行家亲手命题,要求出题人必须具备对应领域的深厚经验(例如财务规划任务的出题人必须有多年与专业理财顾问打交道的实操背景)。出题时,每个任务都嵌入了真实的个人背景变量——具体地址、现实预算、孩子特征,并由出题人亲手制定严格的成功标准。正如 OpenAI 研究员所强调的:“你得能证明你懂,或者你真的知道正确答案长什么样。”
```mermaid flowchart TD accTitle: LifeVal 基准任务构建流程 accDescr: 展示从国家时间统计、大众意愿筛选到百名专家深度出题并落入七大生活领域的构建流程
subgraph Input ["任务来源三层递进"] A["国家时间统计<br>(ATUS / MTUS 摸底日常)"] --> B["3995 人真实需求调查<br>(筛选最想让 AI 帮的忙)"] B --> C["约 100 位领域行家命题<br>(带个人背景与成功标准)"] end
subgraph Domains ["覆盖七大日常生活领域"] C --> D1["照护与健康"] C --> D2["家务行政与政府服务"] C --> D3["教育、购物与个人财务"] end ```
这种出题思路构建出了极具烟火气的七大任务领域:照护、健康、教育、家务行政、个人财务、购物以及获取政府服务。具体的测试案例不再是传统题库的味道,而是真实生活的柴米油盐: - 搬家后为孩子挑选并注册一所合适的幼儿园(GPT-6 Astra 得分 93.1); - 洪水暴雨来临之前协助社区组织调度志愿者(得分 98.0); - 帮家人挑选新居,一路推进直至把地契放进县记录系统的在线购物车(得分 100.0); - 远程陪伴年迈的奶奶观看一场球赛(得分 96.3); - 为刚确诊糖尿病的父母制定第一周的营养餐食与照护计划(得分 90.4)。
这套研究方法论并非无源之水,其谱系可以追溯到斯坦福大学两年前针对机器人具身智能的研究(BEHAVIOR-1K 调研了 1461 人的家务诉求),以及 OpenAI 去年推出的工作场景基准 GDPval。LifeVal 是这套“从需求端倒推题目”的方法论第二次被完整复制到生活任务中。在官方披露的模型代际演进曲线上,OpenAI 列出了旗下五代模型的跑分变化:GPT-5.2 为 49.3,GPT-5.4 跃升至 73.0,GPT-5.5 达到 77.4,GPT-5.6 为 80.0,而最新的旗舰 GPT-6 Astra 仅拿到了 80.6。尽管在 X(Twitter)上有热评惊呼“一年内从 49 分飙升至 80 分简直太疯狂”,但最末两代模型之间仅仅提升了 0.6 分,整体进步曲线已经在明显走平。
---
[03:14](https://www.bilibili.com/video/BV1Em4M64ER4?t=194s) 三层水分拆解:不是办成率、自制裁判与换尺见光死
官方给出的 80.6 分看似亮眼,但层层拆解后会发现其中包含大量统计与机制上的水分。
第一层水分在于指标定义:80.6 并不是普通人理解的“任务办成率”(Task Completion Rate),其官方学名是“未加权平均奖励”(Unweighted Average Reward)。它是根据模型在各个步骤上满足评分标准的程度给出的部分分(Partial Credit)均值。能做对流程中的前几步,与把整件事彻底办成是两码事。作为横向对照,在操作系统基准 2.0(OSWorld 2.0)测试中,同一个模型拿到的部分分达到 54.8,但最终的二元绝对办成率只有 20.6%。从基础概率逻辑来看,如果一个涉及十个连续动作的真实生活流程,模型每一步的执行可靠性都是 95%,其端到端完整走通的概率(0.95 的 10 次方)实际上只剩下约 60%。官方页面上标榜的六个 100 分,也只是从多轮测试中挑选出的最佳录制成绩,绝非日常平均表现。因此,绝不能把 80.6 误读为“交给 AI 十件事能帮你办成八件”。
第二层水分在于评测的封闭性与自我裁判。关于 LifeVal 的核心技术细节,官方几乎全未披露: - 测试任务的总套数未公开; - 奖励函数的具体计算公式未公开; - 判卷者身份(究竟是人工逐条核验还是调用大模型做 Judge)未公开; - 测试是在真实开放的网络环境还是受控沙盒模拟环境中运行未公开; - 防训练数据污染的隔离机制未公开; - 人类专家在相同任务下的基准表现未提供; - 评测数据集与测试代码均未开源。
更关键的是,排行榜上的五个测试对象清一色全为 OpenAI 自家模型,完全看不到 Claude、Gemini 或主流开源模型的影子。OpenAI 坦承在过去一年里始终使用 LifeVal 来指导和驱动自研模型的迭代改进,这意味着它既当选手又当裁判,LifeVal 既是靶子又是自制尺子。面对公开基准可能遭受的训练集污染问题,主讲人尖锐地指出其两难困局:“公开的基准败在太公开,封闭的基准风险在太封闭。”
第三层水分来自“换个尺子看世界”。一旦把模型拉出沙箱放到真实网络中,成绩便会遭遇断崖式暴跌。有独立研究人员曾在 153 个真实消费与政务网站上测试同代模型(GPT-5.4),结果在 LifeVal 上斩获 73 分的 GPT-5.4,在真实网站上的任务成功率只有 6.5%。之所以有云泥之别,是因为真实网站测试采用非黑即白的二元办成率,且必须经历并拦截最后那一记不可逆的“点击提交”。以日常挑选医疗保险为例,有研究采用真实保险理赔数据实测,发现表现最好的免费模型只有 57% 的概率选出接近最优的医保方案,平均导致用户每年多掏 800 多美元的冤枉钱。办错不同生活事务的代价具有极强的不对称性——生成一份平庸的晚餐菜谱几乎没有危害,但点错一次支付按钮或选错医保就是严重的不可逆损失,而当前的 LifeVal 完全没有按照“可逆性”对任务风险进行分级加权。
---
[05:49](https://www.bilibili.com/video/BV1Em4M64ER4?t=349s) 真实价值与清醒读法:生活任务 80.6 对比专家任务 12
在褪去营销光环与数据水分后,LifeVal 依然有其不可抹杀的开创性意义。它的真正突破在于“出题方向全面转向需求端”。回顾过往的学术界与工业界基准,题目往往来源于算法专家主观认定的技术难题(例如复杂奥数、冷门编程竞赛),或者是数据标注员凭空编写的虚拟指令。LifeVal 首次把国家级的时间使用统计与近 4000 名普通人的日常真实困扰当作题目来源。
这一转向背后有坚实的业务数据支撑:在 ChatGPT 的全球日常调用中,与工作无关的非办公消息占比已从最初的 53% 持续攀升至 70% 以上,大众正在大规模尝试用 AI 打理现实生活。恰好在同一天,另有研究团队发布了一套面向长流程、高壁垒复杂任务的专家级基准 GDPx,当时全行业表现最好的模型得分仅有 12% 左右。主讲人指出,生活任务上的 80.6 与专家长任务上的 12 必须并置观察,两个坐标拼在一起,才勾勒出当今大模型认知的真实水位线。
对待 LifeVal 这份基准,应当秉持极其清醒的“折扣读法”:一方面为顶尖实验室开始严肃研究“人类真正需要什么”鼓掌,另一方面必须牢记它的分数只是步骤奖励的均值而非办成概率,更要警惕评测自闭环带来的偏见。正如主讲人总结的最诚实的理解方式:“过日子的能力一年翻了一倍多;真实网站上把事办成的比例还是个位数。”唯有等到 OpenAI 彻底公开题目全貌、引入独立第三方进行双盲打分、并允许外部竞品模型同台竞技的那一天,这个跑分才真正值得作为技术成熟的标志写进新品发布会。
## Notable quotes > [05:49](https://www.bilibili.com/video/BV1Em4M64ER4?t=349s) 过日子的能力一年翻了一倍多;真实网站上把事办成的比例还是个位数。 — AI技术投降派
> [03:14](https://www.bilibili.com/video/BV1Em4M64ER4?t=194s) 公开的基准败在太公开,封闭的基准风险在太封闭。 — AI技术投降派
## Mentioned OpenAI, LifeVal, GPT-6 Astra, GPT-5.2, GPT-5.4, GPT-5.5, GPT-5.6, ChatGPT, ATUS, MTUS, BEHAVIOR-1K, GDPval, OSWorld 2.0, GDPx, Claude, Gemini, 斯坦福大学, X
## Video description 昨天 OpenAI 发了个新基准 LifeVal,不测代码不测数学,测 AI 能不能帮你过日子:任务清单先查两份国家级时间使用统计,再调查 3995 人最想被帮什么忙,最后约 100 个领域行家亲手出题。官方成绩 GPT-6 Astra 拿了 80.6。这个数字我们拆三层。
先看做对的:题目从需求端长出来。幼儿园注册、洪水前组织志愿者、把地契放进县记录购物车、陪奶奶看球、给糖尿病父母做第一周餐食计划——这些不是模拟题库的味道,是过日子本身。方法论也有谱系:斯坦福 BEHAVIOR-1K 用过(1461 人)、OpenAI 自己的 GDPval 用过(工作版),这是同一套方法第二次搬进生活场景。
再拆水分。第一层:80.6 不是办成率,是"未加权平均奖励"——按满足评分标准的程度给分再平均。隔壁操作系统基准 2.0 上同一个模型部分分 54.8、二元办成率只有 20.6;十步流程每步可靠性 95%,端到端只剩约 60%。官方那六个 100% 是最佳录制成绩。第二层:尺子是自己的。任务总数、奖励公式、谁判卷、真实还是模拟环境、防污染措施、人类基线——全部没公布;榜单五个模型全是 OpenAI 自家,而且过去一年一直用它驱动模型改进,既是靶子又是尺子。对照代码基准:因为公开被训练数据污染,OpenAI 今年二月自己弃用了——公开的败在太公开,封闭的风险在太封闭。第三层:换个尺子另一个世界。同一个 GPT-5.4 在 LifeVal 拿 73,在 153 个真实网站的日常事务上只有 6.5——真实网站版按办成没办成判分,还拦住了最后那下提交。比保险这件事,真实理赔数据实测最好的免费模型只有 57% 接近最优、平均每年多花 836 美元。
官方曲线一年从 49.3 爬到 80.6(X 热评"一年从 49 到 80 太疯"),但末两代只差 0.6,曲线在走平。泼完冷水说回价值:第一次有头部实验室把"人们真正想要什么"做成题目来源——ChatGPT 里非工作消息占比已从 53% 涨到七成以上。同天还有个专家级长任务基准 GDPx 最好成绩只有 12%:生活任务 80.6、专家任务 12,两个数字放一起才是当下 AI 的真实位置。最诚实的读法两句都记住:过日子的能力一年翻了一倍多;真实网站上把事办成的比例还是个位数。等题目公开、外人打分、第三方上榜那天,这个数字才值得写进发布会。
00:05 新基准:测AI能不能帮你过日子 00:39 怎么搭的:统计+调查+百名行家出题 01:42 七大领域与真实任务便利贴 02:43 官方曲线:一年+31但末两代只+0.6 03:14 水分一:80.6不是办成率 03:57 水分二:尺子是自己的,六项全未披露 04:55 水分三:真实网站上同一个模型只有6.5 05:49 做对的事:需求端出题与80.6 vs 12 06:33 读法:等公开那天再写进发布会
官方页:openai.com/index/lifeval
[Source](https://www.bilibili.com/video/BV1Em4M64ER4)