腾讯采纳DeepSeek查表架构推混元Flash 降本20倍打擂同业
AI技术投降派
混元Hy4 Flash将单任务成本压至两毛钱的核心在于吸纳外部开源架构与强化学习砍半输出,但代码工程能力缩水与开源承诺跳票暴露了廉价API的工业妥协。
AI-assisted summary of 五毛钱的AI怎么造的?腾讯Hy4 flash深拆 — original source. Check the original for full context.
Source published:
Key ideas
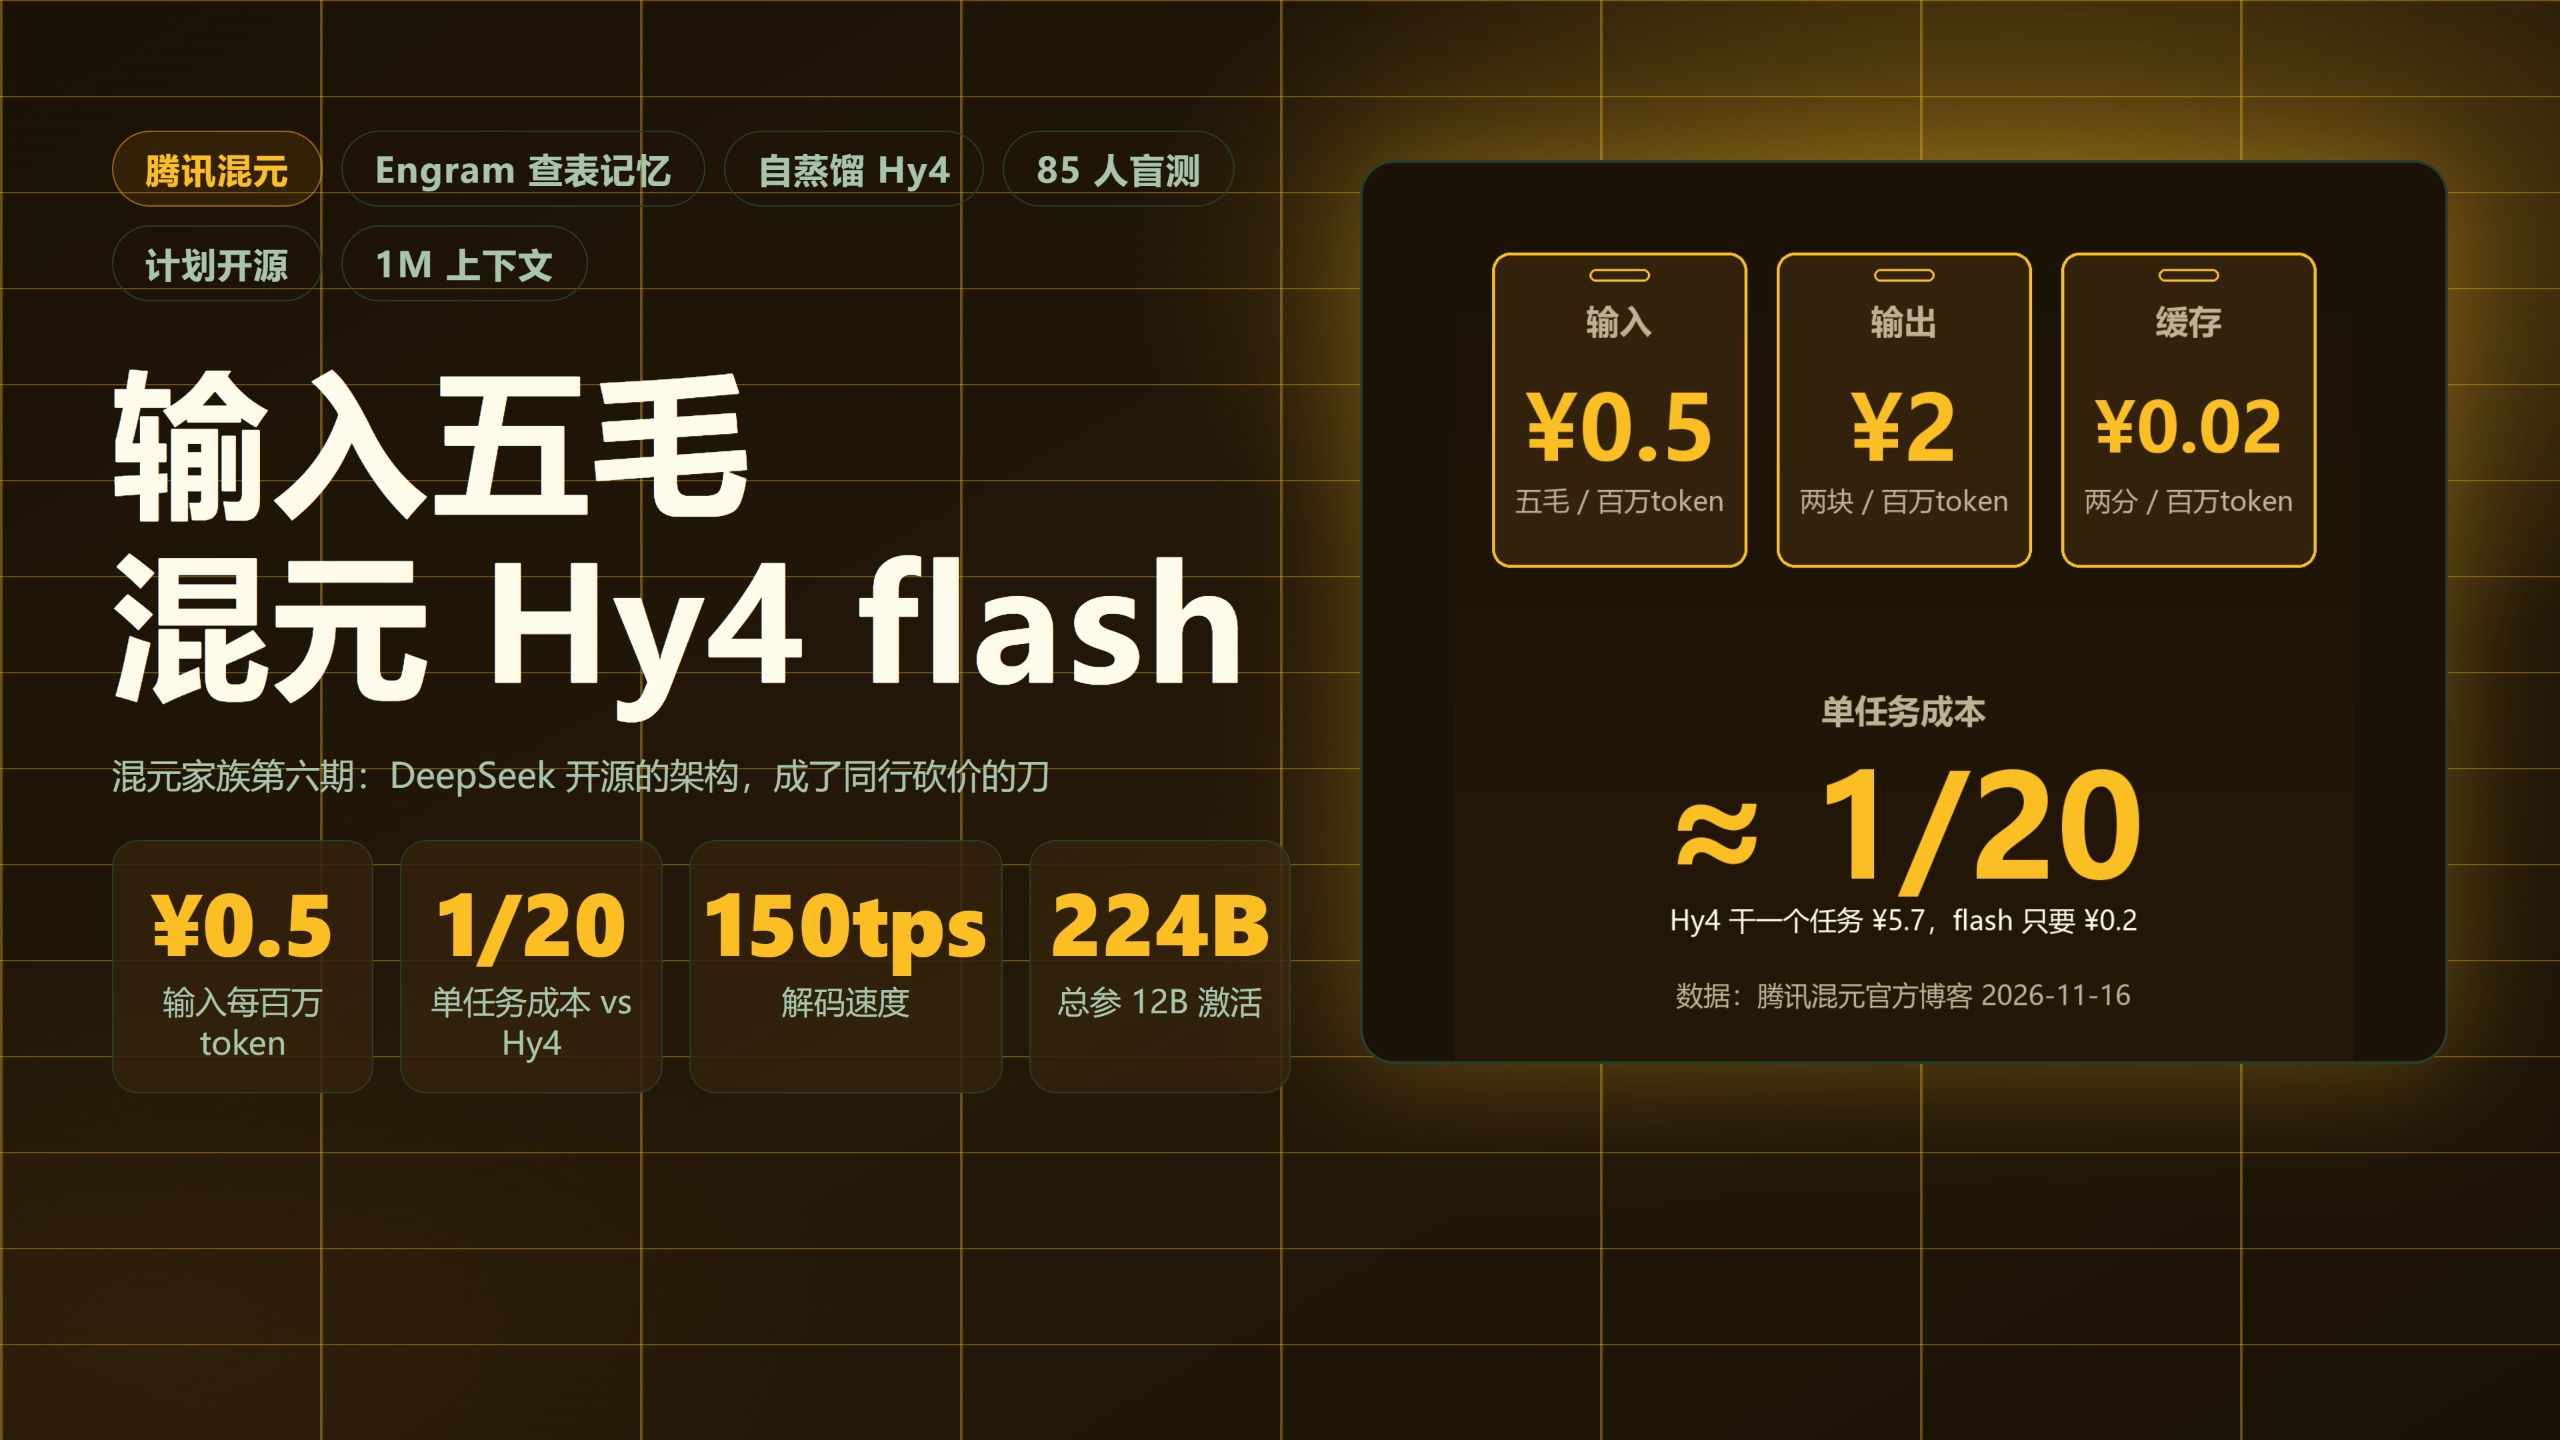
- 腾讯发布混元 Hy4 Flash 模型,总参数 224B(激活 12B),以输入 ¥0.5/M tokens、输出 ¥2.0/M tokens 的激进定价刷新国内同行 Flash 档底价。 (0:00)
- Hy4 Flash 架构吸纳了 DeepSeek 开源的 64B Engram 查表记忆设计,将多轮对话中的 KV Cache 显存占用直接压缩至旗舰版 Hy4 的六分之一。 (1:38)
- 通过架构改造、自蒸馏、RL 缩减输出长度及推理优化四道工序,Hy4 Flash 将单任务推理成本从 ¥5.7 砍至 ¥0.2,实现了 20 倍的降幅。 (3:44)
- 在内部 85 人盲测中,Hy4 Flash 耗时(6.7 分钟)与单任务成本(¥0.26)表现最优,但整体满意度得分(2.79)略低于 DeepSeek Flash(3.09)与 Claude Haiku(2.81)。 (5:07)
- 评测指出该模型存在明显短板:长文本“大海捞针”检索成功率偏低,长程代码能力缩水,且 224B 总权重即使在 4-bit 量化下仍需 110GB 显存,本地部署门槛极高。 (7:43)
Detailed notes
## Background 本内容由 Bilibili 频道“AI技术投降派”于 2026 年 11 月 17 日发布。视频深入拆解了腾讯混元刚上线的 Hy4 Flash 模型,揭秘其输入每百万 Token 五毛、输出两块的超低定价背后,如何通过借鉴 DeepSeek 开源的 Engram 查表记忆及四道工程流水线,将单任务推理成本砍到两毛钱。
## TL;DR 视频详细复盘了腾讯混元 Hy4 Flash 的技术底牌与成本账本:模型采用 224B 总参挂载 64B Engram 静态记忆参数的设计,直接将 KV Cache 压缩至旗舰版的六分之一。结合 770B 旗舰自蒸馏、强化学习削减废话以及底层推理加速四道工序,成功让单任务成本从 5.7 元骤降至 0.2 元。同时,节目深入剖析了内部 85 人盲测与王者荣耀等全家桶业务的落地表现,并客观指出了其长文本大海捞针翻车、对比竞品挑高峰期口径、开源承诺跳票以及本地部署至少需 110GB 显存的四处短板。
## Atmosphere & style 全片充斥着硬核、克制且一针见血的工业工程分析风格,主讲人语调冷静犀利,擅长在官方华丽的宣传数据背后抽丝剥茧算细账。叙事节奏紧凑扎实,既有对腾讯巧妙吸收开源利刃将成本做成架构的由衷肯定,又有毫无留情泼出“四盆冷水”的清醒审视,给人一种坐在大厂架构师白板前复盘真实技术代价的硬核临场感。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1dRsz6NE1H?t=0s) 腾讯发布混元 Hy4 Flash 模型,总参数 224B(激活 12B),以输入 ¥0.5/M tokens、输出 ¥2.0/M tokens 的激进定价刷新国内同行 Flash 档底价。 - [01:38](https://www.bilibili.com/video/BV1dRsz6NE1H?t=98s) Hy4 Flash 架构吸纳了 DeepSeek 开源的 64B Engram 查表记忆设计,将多轮对话中的 KV Cache 显存占用直接压缩至旗舰版 Hy4 的六分之一。 - [03:44](https://www.bilibili.com/video/BV1dRsz6NE1H?t=224s) 通过架构改造、自蒸馏、RL 缩减输出长度及推理优化四道工序,Hy4 Flash 将单任务推理成本从 ¥5.7 砍至 ¥0.2,实现了 20 倍的降幅。 - [05:07](https://www.bilibili.com/video/BV1dRsz6NE1H?t=307s) 在内部 85 人盲测中,Hy4 Flash 耗时(6.7 分钟)与单任务成本(¥0.26)表现最优,但整体满意度得分(2.79)略低于 DeepSeek Flash(3.09)与 Claude Haiku(2.81)。 - [07:43](https://www.bilibili.com/video/BV1dRsz6NE1H?t=463s) 评测指出该模型存在明显短板:长文本“大海捞针”检索成功率偏低,长程代码能力缩水,且 224B 总权重即使在 4-bit 量化下仍需 110GB 显存,本地部署门槛极高。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1dRsz6NE1H?t=0s) 腾讯混元在 Hy4 正式版上线 12 天后迅速推出主打性价比的 Hy4 Flash,直接将轻量模型的价格竞争推向白热化。 - [00:44](https://www.bilibili.com/video/BV1dRsz6NE1H?t=44s) Hy4 Flash 输入标价折合约 7 美分/M tokens,比国际一线大厂 Claude 与 OpenAI 最便宜档位再低三成,并在国内显著压制智谱、阿里和字节跳动的同级产品。 - [01:38](https://www.bilibili.com/video/BV1dRsz6NE1H?t=98s) 低价核心源于 DeepSeek 开源的 Engram 查表机制:以 64B 静态字典储存客观知识,规避动态矩阵计算,大幅缩减 KV Cache 开销。 - [03:44](https://www.bilibili.com/video/BV1dRsz6NE1H?t=224s) 单任务成本实现 20 倍降幅(¥5.7 降至 ¥0.2),远超单价 9 至 12 倍的降幅,根本原因在于强化学习砍半了输出长度且推理速度超过 150 token/s。 - [05:07](https://www.bilibili.com/video/BV1dRsz6NE1H?t=307s) 85 人真实盲测数据显示,Hy4 Flash 综合满意度(2.79)微弱落后于 Claude Haiku(2.81),但单任务成本仅为 Haiku 的十八分之一,展现出极高性价比。 - [05:07](https://www.bilibili.com/video/BV1dRsz6NE1H?t=307s) 独立评测机构 Plotly 认证 Hy4 Flash 为测过最便宜的 A 级模型,但揭露其在 1M 上下文的大海捞针测试中仅答对 2/5,深层长文本信息定位存在软肋。 - [06:33](https://www.bilibili.com/video/BV1dRsz6NE1H?t=393s) 王者荣耀团队披露的实测数据显示模型降低了 40% 至 60% 的 Token 消耗,但因回答精简,工具调用轮次反而增加了 50%。 - [06:33](https://www.bilibili.com/video/BV1dRsz6NE1H?t=393s) 微信支付、企业微信及腾讯 QQ 业务的端到端落地数据,证明了轻量模型在真实业务管道中的降本提速价值,迅速回应了开发者对初代响应慢的抱怨。 - [07:43](https://www.bilibili.com/video/BV1dRsz6NE1H?t=463s) 能力边界明确受限:官方将其定位为略优于 Hy4 Preview,在长程工程代码榜单(如 Terminal Bench 4.0)上的得分不及旗舰版的一半,无法胜任复杂开发工程。 - [07:43](https://www.bilibili.com/video/BV1dRsz6NE1H?t=463s) 对比宣传存在口径策略,所谓八倍价差取自竞品白天高峰期高价,且 Work Index 盲测题库来自腾讯内部日常业务,天然偏向自家技术甜区。 - [07:43](https://www.bilibili.com/video/BV1dRsz6NE1H?t=463s) 旗舰版 Hy4 权重开源已跳票 13 天,导致 Flash 版本的“计划开源”承诺受到社区质疑,海外开发者社区对其 API 降价的兴趣明显钝化。 - [07:43](https://www.bilibili.com/video/BV1dRsz6NE1H?t=463s) 尽管运行激活参数仅 12B,但 224B 的总参数量使得本地私有化部署至少需要 110GB 显存,消费级显卡无法单卡承载。 - [09:25](https://www.bilibili.com/video/BV1dRsz6NE1H?t=565s) 混元密集的产品线迭代展示了极强的工程执行力,Hy4 Flash 的本质启示在于将成本控制直接转化为深层架构优势,而非单纯依靠商业价格战。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1dRsz6NE1H?t=0s) 五毛两块的价签:同行 Flash 档全被卷下去
在上一期拆解腾讯混元 Hy4 正式版的结尾,曾留过一个悬念:官方此前预告过一款主打极致性价比与速度的 Hy4 Flash 到底何时上线?答案仅隔了 12 天,就在 11 月 16 日正式揭晓。腾讯混元发布了 Hy4 Flash,官方对其定位极其干脆直接:“迄今为止最高性价比的 Hy 模型”。从基础硬件规格来看,模型总参数为 2240 亿(224B),其中包含 640 亿(64B)专用的 Engram 参数;激活参数仅为 120 亿(12B),具备原生多模态能力与 100 万(1M)的长上下文窗口。作为混元家族深拆的第六期,这次不讲如何技术登顶,专门讲怎么把成本打穿。
```mermaid flowchart LR accTitle: 模型参数与价格构成 accDescr: 展示Hy4 Flash的参数规格与腾讯云TokenHub定价对比
subgraph Parameters["Hy4 Flash 参数结构"] direction TB Total["总参数 224B"] --> Engram["Engram 知识参数 64B"] Total --> Active["动态激活 12B"] Total --> Context["上下文 1M / 原生多模态"] end
subgraph Pricing["腾讯云 TokenHub 标价"] direction TB In["输入: ¥0.5 / M tokens"] Out["输出: ¥2.0 / M tokens"] Hit["缓存命中: ¥0.02 / M tokens"] end ```
价格标签这次没有任何遮掩,腾讯云 TokenHub 上直接明码标价:输入每百万 Token 仅需 0.5 元(五毛),输出每百万 Token 为 2 元,命中上下文缓存仅需 2 分钱。与自家的旗舰大哥混元 Hy4(输入 6 元、输出 18 元、缓存 0.3 元)相比,输入成本降到了十二分之一,输出降到九分之一,缓存成本更是砍到了十五分之一。
把五毛钱的输入价放进国内同行动态价目表横向对比,杀伤力立现:智谱 GLM Flash 档输入 0.8 元、输出 2.8 元;字节跳动豆包 Light 档与阿里通义千问 Flash 档也都是输入 0.8 元、输出 2.7 元;MiniMax 价格稍高,为输入 1 元、输出 4 元;即使是 DeepSeek 的错峰价也是 1 元与 4 元。在专门卷廉价的 Flash 赛道上,Hy4 Flash 依靠极低单价把同行整体卷了下去,就连总参数比它大一圈的智谱同级产品也要贵出六成。换算成美元放到国际视角,其输入折合约 7 美分,而 OpenAI 和 Anthropic 的 Claude 旗下最便宜的一档输入至少都在 10 美分,Hy4 Flash 直接在国际大厂的“地板价”上再削去了三成。此外,在 11 月 30 日中午前官方还加码了五折促销(输入 0.25 元、输出 1 元),OpenRouter 与内部协作平台 WorkBuddy 也同步上线了折扣与免费体验额度。值得玩味的一个细节是,TokenHub 本质上是腾讯云的模型货架,上面赫然陈列着 DeepSeek、Kimi 等竞品,“自家便宜货摆进去,旁边全是对手的价钱,多少有点指着货架打擂台的意思”。
---
[01:38](https://www.bilibili.com/video/BV1dRsz6NE1H?t=98s) 64B Engram:DeepSeek 开源的查表记忆,怎么成了腾讯的刀
便宜绝非来自补贴流血,真正的秘密藏在 640 亿的“Engram 参数”里。Engram 是一个源自神经科学的词汇,中文通常译作“记忆痕迹”,意指信息或记忆在大脑神经元结构中留下的物理印记。在深度学习工程中,该思路对应着今年 1 月 DeepSeek 以 Apache 开源协议发布的同名论文与代码仓库(斩获 4800 颗 Star)。DeepSeek 在论文中直指经典 Transformer 架构的致命软肋:模型记忆知识必须依靠动态矩阵计算,想要提取一个客观事实,整组权重就必须完整过一遍神经网络,严重欠缺一个如同字典一样能够常数时间直接查表(Lookup)的原语。Engram 的核心构想就是为大语言模型外挂一本静态记忆字典,查表耗时极短,查出的静态记忆再与正在计算的前向隐状态进行融合。
腾讯没有闭门造车,而是把 DeepSeek 开源的这把利刃直接拿来进行模块化改造,挂载到了 Flash 模型上。这 640 亿参数平时完全不参与复杂的逻辑推理与“思考”,专职储存静态知识,随时等待系统索引查表。这种设计带来的直接质变,是让模型的 KV Cache 显存占用直接被压缩至 Hy4 的六分之一。KV Cache 通俗来说就是模型在多轮对话中写下的草稿纸,对话轮数越多、篇幅越长,草稿纸就堆得越高,是长文本和在线高并发场景下最主要的显存与算力杀手。草稿纸从厚厚的六本瞬间变成薄薄的一本,“DeepSeek 开源的架构成了同行砍价的刀,开源世界就是这样,刀铸出来是共享的,就看谁用得狠”。
```mermaid flowchart TD accTitle: Engram 机制与流水线成本压缩 accDescr: 解释Engram查表机制如何协同四道工序大幅压缩单任务推理成本
subgraph DeepSeek_Engram["Engram 查表机制"] direction TB Dict["64B 静态记忆字典 (不参与动态思考)"] Query["长数时间查表"] --> Dict Dict --> Merge["与 Transformer 隐状态快速融合"] Merge --> KVSave["KV Cache 压至 Hy4 的 1/6"] end
subgraph Four_Stages["四道工序流水线"] direction TB S1["1. 架构: 混合注意力 + 新型 MoE + Engram"] S2["2. 自蒸馏: 770B 旗舰老师带 224B 学生"] S3["3. 强化学习: 端到端长任务输出长度砍半"] S4["4. 推理优化: Mega Kernel 算子 + 4bit + DFLY"] S1 --> S2 --> S3 --> S4 end
KVSave --> S1 S4 --> CostDrop["单任务成本降至 1/20 (¥5.7 -> ¥0.2)"] ```
---
[03:44](https://www.bilibili.com/video/BV1dRsz6NE1H?t=224s) 四道工序省钱流水线:一根成本柱被砍到 1/20
Engram 的引入仅仅是腾讯混元省钱流水线上的第一环。官方博客详细拆解了将单任务成本砍至二十分之一的完整工业化四道工序:
1. **第一道·架构创新**:混合注意力机制、新型混合专家架构(MoE)与 Engram 深度组合,率先将 KV Cache 草稿纸的开销砍去六分之五; 2. **第二道·自模型蒸馏**:让 224B 的 Flash 拜自家 770B 的全尺寸旗舰模型 Hy4 为师,直接从大哥身上萃取高阶认知能力,避免冷启动的重头学习开销; 3. **第三道·强化学习对齐**:通过 RL 专门训练模型在回答时“少说废话”,在完成端到端任务的前提下,输出文本长度直接斩断一半——在 Token 计费体系下,“话少就是省钱”; 4. **第四道·底层推理加速**:采用 Mega Kernel 深度融合算子、4 比特量化以及 DFLY 解码加速方案,将整体解码速度拉升到每秒 150 个 Token 以上。
四道工序层层削减,最终呈现出惊人的财务对账单:完成同一个标准任务,旗舰版 Hy4 需要消耗 5.7 元,而 Hy4 Flash 仅仅需要 0.2 元(两毛)。官方在文字口径中保守表述为“成本二十分之一”,而在配图图表上展示的降幅甚至达到了夸张的 24.5 倍。这其中隐藏着一个耐人寻味的工程细节:单价仅下降了 9 到 12 倍,但单任务总成本却实打实地下跌了 20 倍。这中间翻倍的差值,源于模型干活更加干脆利索,“草稿纸小,话又短,同一个任务吃的 Token 就少。便宜有三个层次:降单价、省着用、还有跑得快”。
---
[05:07](https://www.bilibili.com/video/BV1dRsz6NE1H?t=307s) 85 人盲测真相:满意度第一另有其人
单纯宣称价格便宜并不能证明工程能力,混元官方在发布中亮出了一组 85 位内部员工参与的真实盲测数据。测试覆盖了内部平台 WorkBuddy 的 27 个大类、共计 259 个日常工作任务,由 4 款主流轻量模型正面同台打擂:
| 模型名称 | 四分制满意度 | 运行耗时(分钟) | 单任务成本(元) | |:--- |:--- |:--- |:--- | | **DeepSeek Flash** | **3.09**(第一) | 7.8 | 0.38 | | **Claude Haiku** | 2.81 | 6.8 | 4.70 | | **Hy4 Flash** | 2.79 | **6.7**(全场最短) | **0.26**(全场最低) | | **智谱 GLM Flash** | 2.53(垫底) | 8.2 | 0.42 |
在官方宣传通稿中,腾讯着重强调“满意度接近 Claude Haiku”。“这话精确成立,差 0.02”,然而翻看完整数据表就会发现,满意度全场拔得头筹的实际上是 DeepSeek Flash(3.09)。Hy4 Flash 真正拿下第一的核心指标是速度和开销:平均运行耗时仅 6.7 分钟,比 Claude Haiku 还快 0.1 分钟;成本低至 0.26 元,而完成完全相同任务的 Claude Haiku 则需耗费 4.7 元。“满意度差 0.02,价格差 18 倍,这就是‘接近’这个词的含金量——他是性价比冠军,全能那顶帽子另有其主”。
独立数据科学评测机构 Plotly 随后给出了第三方测试旁证:在 43 道评测题中 Hy4 Flash 正确解答了 39 道,单次测试花费仅 0.13 美元,Plotly 给出的原话认证是“测过的最便宜的 A 级模型”。但 Plotly 的测试也迅速抓到了它的死穴:在 5 道针大海捞针(Needle In A Haystack)的隐藏信息检索题中,宣称具备 100 万上下文能力的 Hy4 Flash 仅仅答对了 2 道,而旗舰版 Hy4 则答对了 4 道。百万长文本下的深层信息定位出现严重滑铁卢,这个硬伤被清晰记录在案。
---
[06:33](https://www.bilibili.com/video/BV1dRsz6NE1H?t=393s) 全家桶证言墙:王者荣耀诚实披露工具调用反多五成
混元这次宣发带有一种非常鲜明的“腾讯特色”:拉出了庞大的内部工业生态背书,展示了整整八条核心产品线负责人的实测证言。全家桶内部业务直接化身为第一批极端负载压测场:
- **王者荣耀团队**:用它辅助排查代码 Bug,在代码根因定位精度上与 DeepSeek 完全打平,综合 Token 消耗下降了 40% 到 60%。证言里非常坦诚地披露了一个关键变量:“工具调用次数反而多了五成”。虽然模型单次回答字数精简了,但在复杂逻辑调用上发起的轮次变多了,官方对这一长一消的实际开销并没有刻意隐瞒; - **微信支付团队**:在扫码与代码检测场景下,扫描耗时缩减 37%,Token 消耗压低 46%; - **企业微信团队**:端到端输出速度大幅提升 88%; - **腾讯 QQ 团队**:在评论流高负载过滤中,慢请求处理耗时缩短了将近 40%。
这种全员站台不同于PPT式的样板间宣传,从游戏底层、金融支付,一直贯穿到企业级办公和国民社交场景,腾讯是在自家的广袤试验田里彻底跑通后才对外发声。虽然缺少标杆性外部客户背书,但内测业务展现出真实的落地张力。这其中还有一个颇有戏剧性的时间线闭环:在 Hy4 Flash 发布前整整三天,技术社区 V2EX 上还有程序员在发帖吐槽“混元 Hy4 因为免费,所以只能捏着鼻子忍受它的奇慢无比”;三天之后,以 150 Token/s 为卖点的 Flash 旋即上线,“直接回应了这条抱怨”。
---
[07:43](https://www.bilibili.com/video/BV1dRsz6NE1H?t=463s) 四盆冷水:能力边界、口径之巧、开源前科与本地门槛
在一片叫好声背后,评测按惯例泼出了四盆极具针对性的“冷水”:
- **第一盆水·能力边界**:官方在白皮书用词极为谨慎,明文写道综合能力只是“略优于 Hy4 Preview”,而非完整的 Hy4 正式版。在长程工程代码榜单上,差距呈现断崖式下跌:在 Terminal Bench 4.0 评测中,Hy4 得分为 44.4,Flash 仅得 19.2;在 Program Bench 上,两者的差距是 30 分对 16 分。长程复杂软件工程能力的缩水是底层参数规模带来的结构性局限,因此官方才在文档中清晰地画地为牢:日常轻量任务用 Flash,长程软件工程必须切回 Hy4,“这话本身就是份说明书”; - **第二盆水·对比口径的心思**:宣传页中所谓“比竞品便宜八分之一”的宣传,抓取的是 DeepSeek 在白天的高峰期最高档定价,如果换算成 DeepSeek 的错峰价格,差距立刻缩小一半;而盲测依托的 Work Index 题库,出题人和阅卷人清一色都是腾讯内部员工,虽然数据本身不造假,但题目分布不可避免会朝自家模型的技术甜区倾斜; - **第三盆水·开源历史前科**:在混元 Hy4 正式版面世当天,官方曾高调承诺将在“未来几天内”向全社区开放完整权重。然而整整 13 天过去,Hugging Face 的腾讯主页上挂着的依然只有 8 月底更新的 Preview 版本。这使得发布会上标注的 Hy4 Flash“计划开源”四个大字被打上了问号,只能暂时存疑观望; - **第四盆水·本地私有化门槛**:虽然 12B 的动态激活参数听上去非常轻巧,但在端侧进行本地私有化部署时,整个 224B 的巨量物理权重依然必须完完整整塞进显存中。即使经过深度 4-bit 量化压制,显存占用也是 110GB 起步,这彻底宣判了消费级单卡用户的死刑。
海外开发者社区的反响也极为真实地印证了这种心理落差。早先 Hy4 Preview 发布时,曾凭借激进的技术指标在 Hacker News 上收获高达 387 分的现象级热帖;而这一次 Hy4 Flash 讨论热度最高的帖子仅有惨淡的 6 分。这反映出开源开发者社区对大厂又一次推出的便宜 API 感到钝化,“社区对 API 便宜的兴趣,远小于对权重开源的兴趣”。
回顾混元在过去两个月内的节奏,从 10 月中旬起,混元团队以平均每周推出两个新模型的恐怖频率狂飙突进:从记忆增强、同声传译、长视频理解、文档解析,一路推到基座世界模型与实时音视频,战线全面拉开,其高频工程迭代的能力毋庸置疑。在拆解的尾声,主讲人总结道:上期我们曾说过,“知道自己缺在哪儿,比宣称登顶更值得盯”;而这一期关于 Hy4 Flash 的工程实践可以再加上一句——“把便宜做成架构,比把便宜做成促销更值得盯”。
## Notable quotes > [07:43](https://www.bilibili.com/video/BV1dRsz6NE1H?t=463s) 把便宜做成架构,比把便宜做成促销更值得盯
> [03:44](https://www.bilibili.com/video/BV1dRsz6NE1H?t=224s) 便宜有三个层次:降单价、省着用、还有跑得快
> [07:43](https://www.bilibili.com/video/BV1dRsz6NE1H?t=463s) 社区对 API 便宜的兴趣,远小于对权重开源的兴趣
> [07:43](https://www.bilibili.com/video/BV1dRsz6NE1H?t=463s) 知道自己缺在哪儿,比宣称登顶更值得盯
## Mentioned 腾讯混元, Hy4 Flash, 混元 Hy4, DeepSeek, Engram, TokenHub, 智谱 GLM Flash, 豆包 Light, 通义千问 Flash, MiniMax, OpenAI, Anthropic, Claude Haiku, OpenRouter, WorkBuddy, Kimi, Plotly, 王者荣耀, 微信支付, 企业微信, 腾讯 QQ, V2EX, Hugging Face, Hacker News
## Video description 输入每百万token五毛,输出两块——腾讯混元 Hy4 flash,官方称之为“迄今为止最高性价比的 Hy 模型”。价格标签人人看得见,这期拆的是便宜背后的工程账本:224B 总参里藏着 64B "Engram 参数”,这个词来自神经科学“记忆痕迹”,架构源头是 DeepSeek 今年一月开源的查表记忆论文。开源世界里,刀铸出来是共享的,就看谁用得狠。 一根 ¥5.7 的成本柱,四道工序依次砍下去:架构(KV cache 压到 Hy4 的 1/6)→ 自蒸馏(770B 大哥当老师)→ 强化学习(输出长度砍半)→ 推理优化(150tps 解码),最后剩两毛。单价只降 9 到 12 倍,单任务成本却降了 20 倍,中间的差值是它活干得更利索。 85 人盲测的完整表格里藏着一个官方没细说的细节:满意度第一的其实是 DeepSeek(3.09),Hy4 flash 是 2.79,差 Haiku 仅 0.02。但 Haiku 干同样的活要 4 块 7,18 倍价差。独立评测机构 Plotly 给了它“测过的最便宜 A 级模型”认证,也抓到了 1M 上下文模型在大海捞针上翻车的短板。四盆冷水照例奉上:效果只是“略优于 preview”、对比口径用的是对手忙时价、Hy4 正式版开源承诺已跳票 13 天、224B 权重本地部署要 110GB 显存起步。 混元家族第六期。旗舰定天花板,flash 定电费。 00:05 上期观察点兑现:十二天的答案 00:44 五毛两块的价签:同行 flash 档全被卷下去 01:38 64B Engram:DeepSeek 开源的查表记忆,怎么成了腾讯的刀 03:44 四道工序省钱流水线:一根成本柱被砍到 1/20 05:07 85 人盲测真相:满意度第一另有其人 06:33 全家桶证言墙:王者荣耀诚实披露工具调用反多五成 07:43 四盆冷水:preview 之言、口径之巧、开源前科、本地门槛 09:25 旗舰定天花板,flash 定电费
[Source](https://www.bilibili.com/video/BV1dRsz6NE1H)