阿里巴巴推旗舰Qwen4-Max 靠查表降本58%迎战国际巨头
AI技术投降派
新模型不再单卷智商极限,而是通过3280亿参数查表字典与超低激活率将推理成本腰斩,但其商业成色仍取决于第三方评测追赶与后续27B开源落地。
AI-assisted summary of 阿里巴巴发布新一代旗舰 Qwen4-Max — original source. Check the original for full context.
Source published:
Key ideas
- 阿里巴巴正式发布新一代旗舰模型 Qwen4-Max,总参数达 2.4 万亿,但每字仅激活 710 亿参数(约 3%),相比上一代激活参数削减约四分之一,预训练全过程未出现损失尖峰。 (0:00)
- 模型创新性引入 3280 亿参数的第二层 N-gram 词组嵌入查表组件,通过查表代替部分推理计算,结合 3:1 混合注意力机制大幅降低显存开销。 (1:40)
- 通过 Token 精简、API 降价 16.7% 以及 Prompt 缓存命中价直降至 0.5 元/百万 Token(仅原输入价 5%),综合办公单任务成本降低 58%。 (2:44)
- 商业落地上主打“持续交付”工作流并开源配套插件,但 Max 本身保持闭源,且在第三方实测中暴露出首字延迟高及部分编程基准落后等短板,社区正密切等待 27B 等中小尺寸版本开源。 (5:43)
Detailed notes
## Background 该视频由 Bilibili UP 主“AI技术投降派”于 2026 年 11 月 17 日发布。视频聚焦阿里巴巴新发布的旗舰大模型 Qwen4-Max,抛开枯燥的参数表,通过“一座楼、一本字典、一张账单”的比喻,通俗解读该模型的底层架构升级、降本逻辑与落地表现。
## TL;DR Qwen4-Max 拥有 2.4 万亿总参数,但通过引入 3280 亿参数的免计算词组查表字典以及混合注意力机制,实现了每输出一个字仅激活 710 亿参数(约 3%),且预训练损失曲线无异常尖峰。依托精简的 Token 消耗、降幅约 16.7% 的 API 单价以及腰斩至 0.5 元的缓存命中价,该模型将单任务办公成本大幅压缩 58%,并推出了边交初稿边迭代的“持续交付”工作流。尽管在尽调研读、医疗影像与工业数控等真实场景表现亮眼,但视频也客观指出了它在第三方机构测试中测速滞后、终端与专项编程基准落后于竞品顶尖水平等短板,强调其核心优势在于极致省钱与务实算账,而社区也正在静候其 27B 等中小尺寸开源版本的到来。
## Atmosphere & style 全片充斥着工程师视角的极客幽默与冷静克制,彻底摒弃了常见的新品吹捧套路,语言风格通俗犀利且极具画面感。UP 主用“思考贵、查表便宜”、“整栋楼亮 3% 的灯”等精妙比喻将晦涩架构讲得深入浅出,随后又毫不留情地连续倒出“三盆冷水”,直面独立评测的惨淡跑分。整体节奏紧凑轻快、客观不护短,传达出一种在喧嚣 AI 军备竞赛中“不卷虚假智商、专卷算力精打细算”的清醒与务实。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1LXsz6qEfM?t=0s) 阿里巴巴正式发布新一代旗舰模型 Qwen4-Max,总参数达 2.4 万亿,但每字仅激活 710 亿参数(约 3%),相比上一代激活参数削减约四分之一,预训练全过程未出现损失尖峰。 - [01:40](https://www.bilibili.com/video/BV1LXsz6qEfM?t=100s) 模型创新性引入 3280 亿参数的第二层 N-gram 词组嵌入查表组件,通过查表代替部分推理计算,结合 3:1 混合注意力机制大幅降低显存开销。 - [02:44](https://www.bilibili.com/video/BV1LXsz6qEfM?t=164s) 通过 Token 精简、API 降价 16.7% 以及 Prompt 缓存命中价直降至 0.5 元/百万 Token(仅原输入价 5%),综合办公单任务成本降低 58%。 - [05:43](https://www.bilibili.com/video/BV1LXsz6qEfM?t=343s) 商业落地上主打“持续交付”工作流并开源配套插件,但 Max 本身保持闭源,且在第三方实测中暴露出首字延迟高及部分编程基准落后等短板,社区正密切等待 27B 等中小尺寸版本开源。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1LXsz6qEfM?t=0s) Qwen4-Max 官方定位为“全天候 AI 新同事”,曾匿名试岗四天后官宣,综合办公基准单任务成本从 26.58 元降至 11.16 元,降幅达 58%。 - [00:49](https://www.bilibili.com/video/BV1LXsz6qEfM?t=49s) 总参数规模为 2.4 万亿,单字激活参数由上一代的 950 亿压减至 710 亿,知识、代码等四大基座任务激活量全部为同台最低。 - [01:40](https://www.bilibili.com/video/BV1LXsz6qEfM?t=100s) 在第二层引入 3280 亿参数的 N-gram 词组嵌入查表字典,不参与推理矩阵计算,以低成本查表代替昂贵的深度思考计算。 - [02:18](https://www.bilibili.com/video/BV1LXsz6qEfM?t=138s) 网络架构采用 3 层门控增量网络搭配 1 层稀疏注意力的混合机制,结合四分支残差流,实现了 2.4 万亿训练全程的“零尖峰”损失曲线。 - [02:44](https://www.bilibili.com/video/BV1LXsz6qEfM?t=164s) 在自建综合办公基准 Work360 提升至 52.69 分,真人盲测 Agent Arena 升至全球第 14 名(中国模型首位),前端编程盲测排全球第六。 - [03:42](https://www.bilibili.com/video/BV1LXsz6qEfM?t=222s) 降本策略由三层刀法构成:终端基准 Token 消耗减半、API 输入输出单价直降六分之一、Prompt 缓存命中单价直降 66.7% 至 0.5 元/百万 Token。 - [03:42](https://www.bilibili.com/video/BV1LXsz6qEfM?t=222s) 国际比价中,输出单价约为 Gemini 氢版的六成、Claude 旗舰的两成出头,缓存价格达到国际并列最低档。 - [04:38](https://www.bilibili.com/video/BV1LXsz6qEfM?t=278s) 落地验证涵盖 198 份底稿自动生成 86 页带溯源尽调报告、单对话读取 1433 张影像精准诊断,以及工业数控编程工时由 475 分钟压至 24 分钟。 - [04:38](https://www.bilibili.com/video/BV1LXsz6qEfM?t=278s) 推行“持续交付”机制,改长程任务开盲盒为逐步交出可用版本并支持中途调整,其配套智能体插件已以 Apache 协议开源。 - [05:43](https://www.bilibili.com/video/BV1LXsz6qEfM?t=343s) 第三方机构 Artificial Analysis 评测仅给出 43 分,指出其部分测试单任务花费达 3.27 美元且首字延迟长达两分半。 - [05:43](https://www.bilibili.com/video/BV1LXsz6qEfM?t=343s) Terminal Bench 基准(48.5 分)与特定编程测试(31 分)仍显著落后于行业顶尖旗舰(分别为 67.2 分与 65 分)。 - [06:50](https://www.bilibili.com/video/BV1LXsz6qEfM?t=410s) 旗舰 Max 维持闭源商用,开源生态的真正看点转向中小尺寸版本,第三方榜单已现 27B 早期身影,预计未来两个月内陆续开源。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1LXsz6qEfM?t=0s) 楼与字典:2.4 万亿参数的稀疏进化与零尖峰曲线
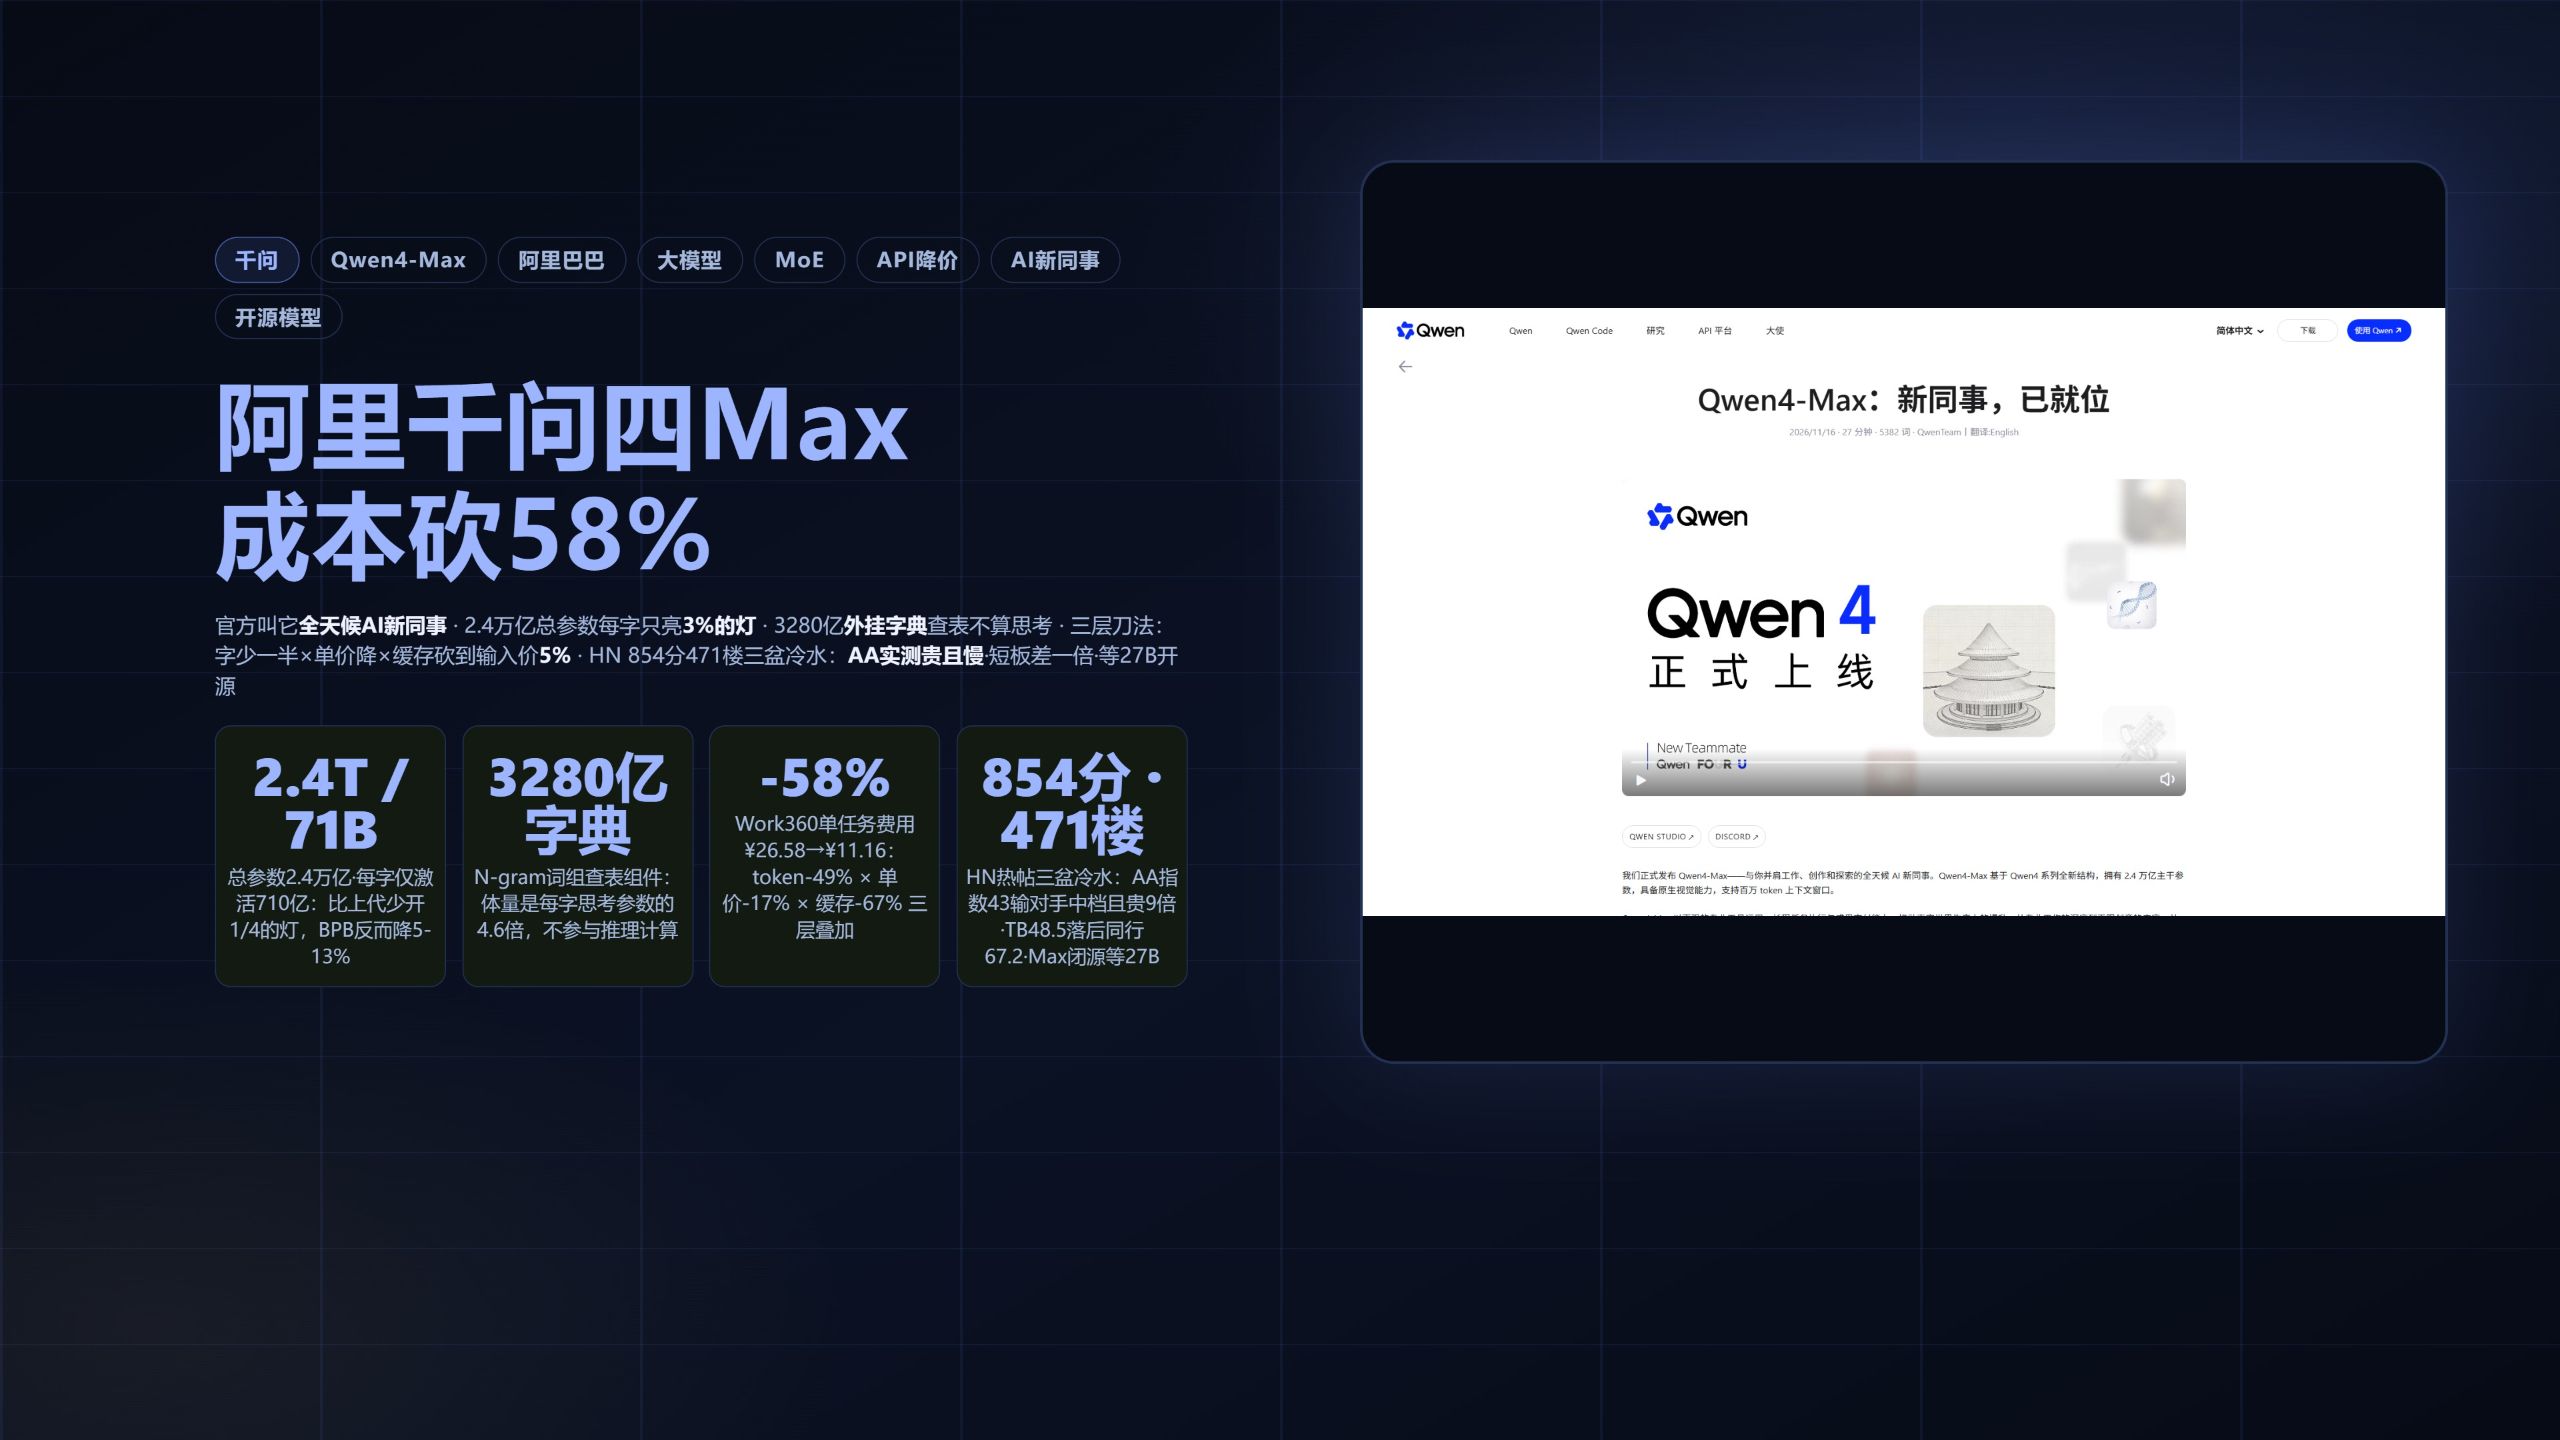
阿里巴巴正式发布新一代旗舰模型 Qwen4-Max(通义千问 4-Max),官方定位为“全天候 AI 新同事”。在正式官宣前还有一个插曲:它提前五天顶着化名挂在自家编程工具中匿名试岗,被网友实测了四天才正式亮明身份。要认识这位“新同事”,最直观的方式就是看账单——同一套办公基准任务,上一代平均花费 26.58 元,而这一代降至 11.16 元,成本直接砍掉 58%,且综合性能明显上涨。
剖析其底层架构,Qwen4-Max 原生支持视觉与百万 Token 上下文,总参数量达 2.4 万亿,但模型每输出一个字仅激活其中的 710 亿参数。把模型比作一栋超级大楼,它每输出一个字,整栋楼仅点亮约 3% 的灯。对比上一代同为 2.4 万亿总参数的基座,每字激活参数从 950 亿降至 710 亿,砍掉了近四分之一。在官方与 5 个主流大模型基座的同台对比中,其知识、代码、问答、理工四项激活参数全部最低,比上一代低了 5% 到 13%。
这一代架构最独特的创新是引入了高达 3280 亿参数的查表组件——即 N-gram 词组嵌入(Phrase Embeddings)。该组件被安装在模型的第二层,工作逻辑如同查字典:遇到特定词汇时,先结合局部前文查表,直接把高频搭配的现成表示拼接进来。关键在于查表不属于深度思考,这 3280 亿参数完全不参与推理矩阵计算,相当于系统附赠的容量。这本“字典”的体量是每字思考参数的 4.6 倍;正如评测中所总结的:“连大模型都想通了一件事,思考贵,查表便宜。”
在注意力与网络结构上,Qwen4-Max 进行了两处重要升级:其一是混合注意力机制,每四层结构中有三层采用门控增量网络,将历史上下文压缩为固定状态以大幅节省显存,仅保留一层稀疏注意力用于按块快速检索长上下文;其二是残差流从单条通道扩建为四条并行分支,配合动态门控进行读写。这套架构带来了极高的训练稳定性,在 2.4 万亿规模的预训练全程中,模型的损失曲线没有出现过一次异常尖峰(Spike)。
```mermaid flowchart TD accTitle: Qwen4-Max 混合稀疏计算与查表架构 accDescr: 展示输入 Token 如何经过词组嵌入查表与多分支注意力混合网络完成低成本推理
subgraph InputStage["输入与静态查表"] IN["输入 Token 流"] --> PE["第二层词组嵌入 (N-gram 字典)<br/>3280 亿参数 (仅查表,不耗推理计算)"] end
subgraph CoreMoE["动态推理大楼 (总参 2.4 万亿 / 仅激活 710 亿)"] PE --> Gating["动态门控读写与残差分支 (4 条并行通道)"] Gating --> GIN["3 层门控增量网络<br/>(状态压缩,极致省内存)"] Gating --> SA["1 层稀疏注意力<br/>(分块快检长上下文)"] end
GIN --> OUT["高效输出 (每字激活 3% 参数)"] SA --> OUT ```
- **总参数规模**:2.4 万亿(2.4T),每字仅激活 710 亿(71B),激活比例仅约 3%。 - **激活参数降幅**:相比上一代 950 亿激活参数削减约 25.3%,对比其他基座在四大核心任务上降低 5% 至 13%。 - **词组嵌入字典**:第二层集成 3280 亿参数查表组件,体量达单字激活思考参数的 4.6 倍。 - **混合注意力比例**:门控增量层与稀疏注意力层比例为 3:1。
---
[02:44](https://www.bilibili.com/video/BV1LXsz6qEfM?t=164s) 官方成绩单与三层成本刀法
在基准评测方面,官方自报的数据涵盖了多项日常任务与专业开发基准。在阿里巴巴自建、涵盖 26 个行业与 721 个细分交付场景的综合办公基准 Work360 中,得分从上一代的 47.74 提升至 52.69;终端操作基准 Terminal Bench 从 38.9 提升到 48.5,且在得分上涨的同时字数消耗减少了一半。在纯真人盲测的智能体竞技场(Agent Arena)中,Qwen4-Max 从第 39 名跃升至第 14 名,居中国模型首位;前端编程盲测排在全球第六名,刷新了中国大模型的历史成绩。此外,其在软件工程基准 SWE-bench 取得 75.7 分,生物谜题取得 85 分。官方口径公布的 16 项主流测试中共有 4 项位列第一,这也坦承了模型并非全维度碾压对手。
单任务成本之所以能压缩 58%,来自官方精细设计的“三层刀法”: 1. **第一层:字数变精炼**。终端基准测试中的 Token 消耗量直接降了将近一半,模型输出精练,没有冗长废话。 2. **第二层:API 单价调降**。百万 Token 输入价格从 12 元降至 10 元,输出价格从 36 元降至 30 元,单价降幅为六分之一(约 16.7%)。 3. **第三层:上下文缓存(Cache)暴降**。Prompt 缓存命中单价从 1.5 元直接切至 0.5 元,仅为原输入基准价的 5%。
在国际定价维度,百万 Token 输入 1.5 美元、输出 4.5 美元,输出单价约为谷歌 Gemini 氢版(Flash)的六成、Claude 旗舰级模型的两成出头,缓存命中价则与 Google 处于国际并列最低档位。
| 计费与消耗维度 | 调整前 / 竞品参考 | Qwen4-Max 现行数据 | 降幅与优势 | |:--- |:--- |:--- |:--- | | **终端基准 Token 消耗** | 基准 100% 消耗 | 消耗减少约 50% | 思考更精简,账单天然腰斩 | | **API 输入单价(每百万 Token)** | 12 元人民币 | 10 元人民币(约 $1.5) | 价格直降 16.7% | | **API 输出单价(每百万 Token)** | 36 元人民币 | 30 元人民币(约 $4.5) | 达 Claude 旗舰约 20%、Gemini 氢版约 60% | | **缓存命中单价(每百万 Token)** | 1.5 元人民币 | 0.5 元人民币 | 直降 66.7%,仅占输入单价的 5% | | **单任务综合办公账单** | 26.58 元人民币 | 11.16 元人民币 | 综合成本总体降低 58% |
---
[04:38](https://www.bilibili.com/video/BV1LXsz6qEfM?t=278s) 落地实战与“持续交付”工作流
在企业端实际应用与长文本吞吐中,官方挑了三个严苛落地案例:其一是投行场景下阅读 198 份凌乱的原始底稿,最终整理并输出为结构规整、多达 86 页的尽职调查报告,且每条结论都附带精确的底稿出处;其二是医疗场景,在单次对话中完整读取多达 1433 张原始影像切片,对病灶的定位判定与主管医生的实际诊断完全一致,给出的处置意见与当天的临床医嘱条目一一对应;其三是工业汽车制造场景,将汽车精密零件加工的数控编程耗时从原本的 475 分钟大幅压缩至 24 分钟,削减了 95% 的工时,且已在产线投入真实生产。
与此同时,Qwen4-Max 引入了被称为“持续交付”的智能体新习惯。以往模型执行长时间、复杂任务时往往是“蒙头做完才交卷”,过程不透明;而这代模型演进为“先交出一版能用的初稿,再在此基础上逐步迭代”。用户在交互过程中随时能够查看当前进度,可以随时喊停,也可以动态调整任务方向。配合该特性的智能体插件已经以 Apache 协议开源,支持用户本地部署体验,让以往如同“开盲盒”的长程 AI 任务变成了全程可视的“看直播”。
---
[05:43](https://www.bilibili.com/video/BV1LXsz6qEfM?t=343s) 社区实测的三盆冷水与 27B 开源期待
在科技社区 Hacker News 上,Qwen4-Max 的发布帖收获了 854 分与 471 条讨论,但在热烈反响之外,评测者也迅速泼下了“三盆冷水”:
第一盆冷水是第三方的独立评测毫不留情面。第三方评测机构 Artificial Analysis 仅给该模型打出了 43 分,不仅输给了部分同台竞技的对手中档型号,而且单任务花费达到了 3.27 美元,对比竞品的 0.36 美元贵了将近 9 倍;实测输出速率仅为每秒五十几个 Token,首字延迟(TTFT)甚至需要等待两分半之久,在速度榜单上排名靠后(不过该测试可能混入了早期的预览版数据,仅供趋势参考)。
第二盆冷水是部分测试基准存在明确短板。在终端基准 Terminal Bench 上,Qwen4-Max 取得的 48.5 分虽然高于上一代,但行业同代顶尖旗舰已达到 67.2 分;在某项专项编程基准上,Qwen4-Max 仅获得 31 分,而竞品旗舰能达到 65 分,性能落差接近一倍。
第三盆冷水在于开源策略的悬念。Qwen4-Max 本身依然是闭源商业模型,社区开发者几乎全在追问中小尺寸模型(特别是 27B 版本)的开源排期。目前第三方模型榜单上已经开始出现 27B 的早期测试记录,官方口径表示同技术路线的中小尺寸版本将陆续开源,按照阿里上一代的开源迭代节奏,预计两个月之内便能见分晓。
整代 Qwen4-Max 的核心叙事不在于单纯的纸面智商碾压,而在于极致的“省”——少开四分之一的灯、配备厚字典查表、大幅调低输入输出与缓存单价;在行业卷模型智商的节点上,选择在落地成本与交付体验上算细账。正如总结所言:“所有人都在卷谁更聪明的时候,他在卷每一分钱花在哪。至于成色如何,别急着站队,等 27B 开源,等第三方榜单更新,账会越算越清楚。”
## Notable quotes > [00:00](https://www.bilibili.com/video/BV1LXsz6qEfM?t=0s) 连大模型都想通了一件事,思考贵,查表便宜。
## Mentioned 阿里巴巴, Qwen4-Max, 通义千问, Google, Gemini, Claude, Hacker News, Artificial Analysis, SWE-bench, Work360, Terminal Bench, Agent Arena, Apache
## Video description 11月16日,阿里巴巴发布新一代旗舰 Qwen4-Max,官方管它叫“全天候 AI 新同事”。这期不背参数表,用一座楼、一本字典、一张账单讲清楚它。 00:05 开场:一张账单认识新同事 00:49 楼:2.4万亿总参只亮3%的灯 01:40 字典:3280亿查表组件 02:18 架构补遗与零尖峰曲线 02:44 成绩单(官方口径) 03:42 三层刀法算总账 04:38 落地案例与持续交付 05:43 三盆冷水 06:50 收尾:等27B 先上楼。总参数2.4万亿,每说一个字只激活710亿,整栋楼亮3%的灯。跟上一代同为2.4T,激活从950亿砍到710亿,官方拿五个大模型基座同台对比,知识、代码、问答、理工四项它全部最低。楼旁边立着一本3280亿的字典:N-gram词组嵌入,装在第二层,根据局部上下文查表、把高频搭配的现成表示直接贴进来。查表不算思考,不参与推理计算,等于白送的容量,体量是每字思考参数的4.6倍。连大模型都想通了一件事:思考贵,查表便宜。 成本砍58%是三层刀法叠出来的:终端基准token消耗少一半、输入输出单价降六分之一、缓存命中价从一块五砍到五毛只剩输入价的5%。放到国际牌桌上,输出价约谷歌氢版六成、Claude旗舰两成出头,缓存价并列全场最低档。落地案例挑了三个硬的:198份乱底稿读成86页尽调报告、单次对话读1433张影像与医生诊断一致、汽车加工编程475分钟压到24分钟。还有新习惯“持续交付”:先交一版能用的再迭代,配套插件已开源。 冷水照泼:HN 854分471楼,第三方实测43分输对手中档还贵9倍慢一截;终端基准48.5落后同行67.2,一项编程基准差一倍;Max本身闭源,评论区都在等27B——第三方榜单已现27B早期身影,官方说中小尺寸陆续开源。基准多为官方自报,AA数据可能含预览版实测,看个方向就好。 Blog:qwen.ai/blog?id=qwen4-max API:qianwenai.com/models/qwen4-max
[Source](https://www.bilibili.com/video/BV1LXsz6qEfM)