百度李彦宏称文心大模型日调用多靠轻量模型 AGI实现或需逾十年
硅谷101
大模型价格战将加速企业端渗透,百度正通过强大闭源底座裁剪低成本小模型以解决真实商业场景的降本增效问题。
AI-assisted summary of 对话百度李彦宏(下):不可避免的价格战、更大的AI企业端机会、以及AGI信仰【硅谷101】 — original source. Check the original for full context.
Source published:
Detailed notes
## Background 该内容由Bilibili平台的“硅谷101”频道于2024年07月08日发布,是采访百度创始人李彦宏的下期视频。视频简介指出,本期主要探讨了中国大模型市场早期爆发价格战的本质、大模型如何赋能B端市场带来新增长、AGI的到来时机以及Scaling Law路线的正确性,旨在为观众带来关于商业落地与科技巨头布局的新思考。
## TL;DR 在本次采访中,李彦宏深入分析了中国大模型价格战的必然性,认为极低门槛能加速技术渗透,而最终胜出取决于技术与效率。他指出生成式AI重构了IT四层技术栈,并预言大模型将在中国B端市场产生颠覆性价值,百度也正通过大模型裁剪出高性价比的中小模型来满足实际商业场景。对于前沿趋势,他坚信AI时代的B端重构是业态增强,并预测实现真正的AGI仍需十年甚至更长时间,强调业界应更关注真实的市场降本增效需求而非盲目堆叠参数。
## Atmosphere & style 这场访谈呈现出一种极其务实、直接且充满技术理性思辨的氛围。李彦宏的作答坦诚而直白,既有面对外界对大模型盈利与价格战质疑时的坦然与笃定,又带着一种深耕行业多年的技术乐观主义与商业清醒。主持人与对谈者的提问直击痛点,引出新旧时代案例的对比,整体节奏紧凑、逻辑严密,让听众能切身感受到中国顶尖科技巨头在AI狂热浪潮下,对商业落地、算力账本以及远期AGI信仰的冷静审视与深刻洞察。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1Xi421Y7ka?t=0s) 李彦宏认为大模型价格战爆发得比想象中早,但极低甚至免费的门槛能极大降低开发成本,激发开发者积极性并加速大模型在各行业的渗透。 - [00:00](https://www.bilibili.com/video/BV1Xi421Y7ka?t=0s) 大模型的技术天花板目前尚未见顶,在当前各家大模型能力拉不开绝对差距时,拼价格是市场必然,但长远来看,决定胜负的依旧是技术实力与成本控制力。 - [00:00](https://www.bilibili.com/video/BV1Xi421Y7ka?t=0s) 李彦宏以“百度网盘”当年的无限空间免费大战为例,指出不理性的烧钱竞争最终会回归理性,只有拥有更好技术和更低成本的公司才能走到最后。 - [04:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=299s) 生成式 AI 将传统的 IT 三层技术栈重构为芯片层、框架层、模型层和应用层这四层技术栈。 - [04:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=299s) 李彦宏预测在芯片、框架和模型层,每一层未来只会诞生 2 到 3 个大型玩家,而应用层则会诞生数以百万计的应用以及 3 到 5 个超级应用。 - [09:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=599s) 相比于互联网对 B 端不明显的改造,大模型在 B 端具有颠覆性的增强价值,能在小说创作、法律辅助、电商数字人直播以及招聘等现有业态中实现真正的降本增效。 - [09:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=599s) 中国过去 SaaS 支出占比低是因为许多 B 端需求被大型电商等平台型巨头直接满足了,而在 AI 时代,大模型作为现有业态的增强,将在中国 B 端市场迎来比互联网时代更大的需求。 - [09:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=599s) 由于不同场景对响应速度和成本要求各异,百度自 2023 年 10 月文心 4.0 发布以来的主要精力,是利用强大的基础模型去裁剪、蒸馏出不同量级的轻量级小模型。 - [09:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=599s) 在实际商业场景中,调用量最大的绝对不是参数最庞大的基础模型,而是经过精调(SFT)和行业数据灌注、具备更高推理效率和更低成本的中小模型。 - [19:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=1199s) 基础模型迭代速度因 Scaling Law 遭质疑而稍微放缓,对应用开发者来说反而是好事,能提供一个相对稳定的 Base 避免频繁重写代码。 - [19:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=1199s) 李彦宏认为智能体(Agent)的反思和进化能力等创新,已经在一定程度上与单纯的参数堆叠实现了解耦,未来在 Transformer 架构上会叠加更多创新。 - [19:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=1199s) 真正的 AGI 意味着机器在任何场景下都能具备人所具备的能力。以百度投入 11 年的无人驾驶在专用场景仍难完美容错为例,实现 AGI 仍需要 10 年到 20 年甚至更长时间。 - [19:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=1199s) 业界应该更关注真实的市场需求与商业场景中真实的 ROI(投资回报率),一味拼命去追求能考过高中数学的更强模型,若无法解决降本增效则会走弯路、浪费资源。 - [19:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=1199s) 在中小模型和模型蒸馏的行业趋势下,闭源模型由于拥有最强大的基础大模型底座,在蒸馏出高竞争力的小模型方面依然保有巨大优势。
## Detailed walkthrough 以下是根据您提供的视频转录文本整理的详细、忠实的走访与内容解析:
[00:00](https://www.bilibili.com/video/BV1Xi421Y7ka?t=0s) 采访背景与中国大模型价格战的爆发
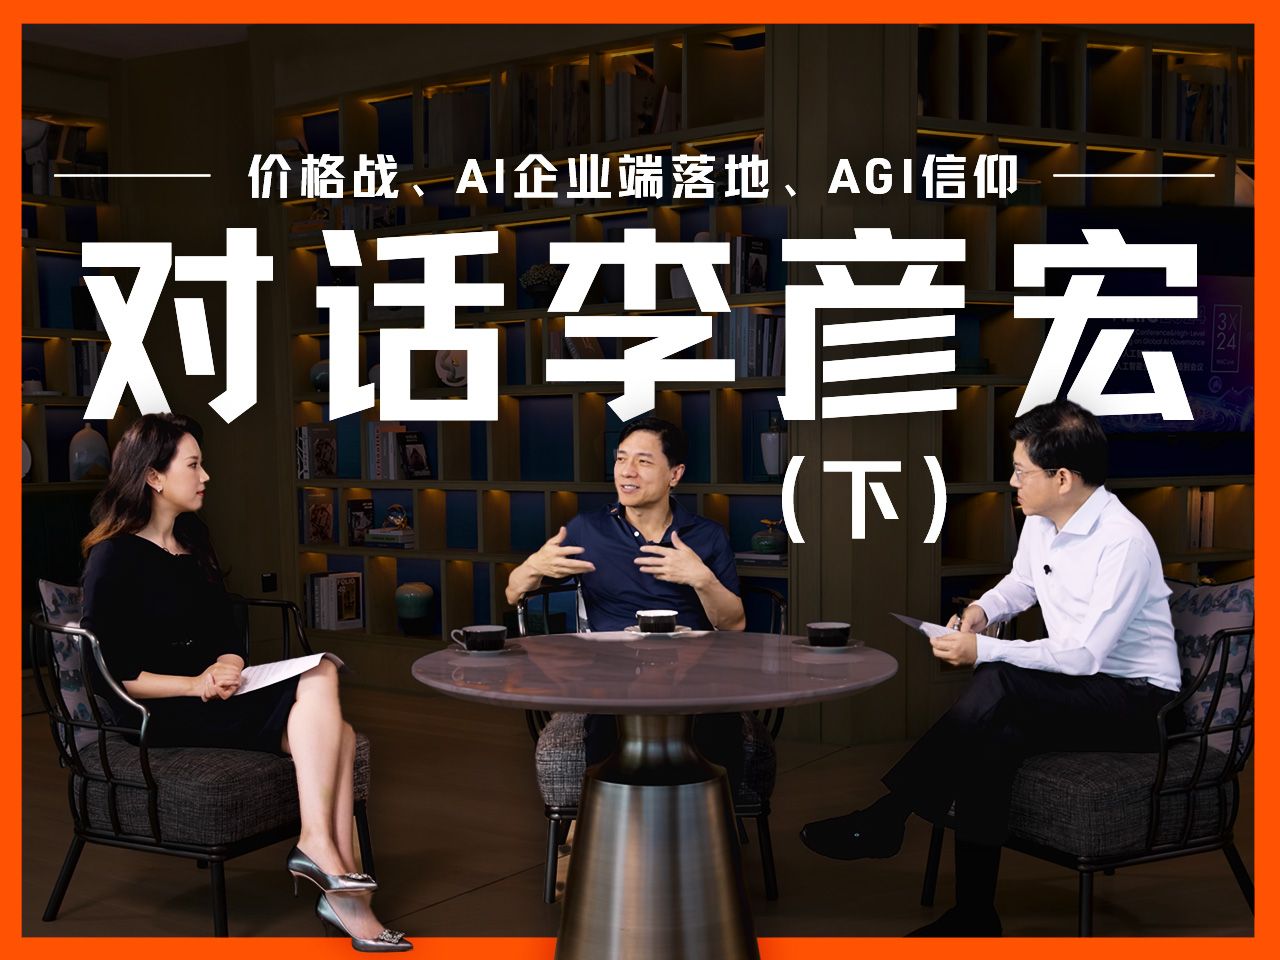
在《硅谷101》主持人陈倩与《第一财经》总编辑杨宇东对百度创始人、董事长兼 CEO 李彦宏的采访中,双方探讨了中国大模型市场、AI 商业化落地、AGI(通用人工智能)以及 Scaling Law(尺度定律)等核心议题。陈倩在开场中提到,李彦宏的回答非常坦诚、直接,虽然部分观点具有讨论性,但对于理解中国市场企业家的商业落地思考和巨头布局极具参考价值。这是李彦宏在 2024 年首次接受媒体采访。
采访的第一个重磅话题聚焦于中国大模型市场“价格战”的爆发。外界普遍疑惑,为什么在生成式 AI 爆发仅一年半的时间里,中国市场就迅速进入了类似于当年互联网时期的价格战阶段。李彦宏坦言,价格战的来临确实比他想象的还要早,且价格被压到了“几乎不可思议的这种低的地步”。但他认为这并非坏事,因为极低甚至免费的门槛能极大地激发开发者在大模型基础上开发各种应用的积极性,从而加速大模型向各行各业的渗透。
针对“大模型公司靠什么赚钱”的质疑,李彦宏展现了技术乐观主义。他指出,大模型的技术天花板非常高,目前行业对模型能力仍有诸多不满意,未来仍需要顶尖人才、庞大算力和海量数据来训练下一代、甚至下下一代模型。在当前各家模型能力拉不开绝对差距时,拼价格是必然的;但长远来看,市场会回归理性,最终比拼的是谁的技术更好、谁能为客户创造真正的价值。他以“百度网盘”当年的竞争为例,指出当年各家不理性地赠送 10T、100T 甚至宣称“无限空间永久免费”,但一两年后纷纷退出,正是因为百度拥有更好的技术和更低的存储成本。因此,技术和效率才是决定谁能走到最后的关键。
- **核心观点**:价格战能加速大模型在各行各业的渗透,降低开发门槛。 - **历史案例**:百度网盘当年的“免费空间大战”,最终凭借技术和成本控制力胜出。 - **盈利逻辑**:现阶段模型能力尚未见顶,未来技术领先、能产生实际价值的公司才能持续收费。
[04:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=299s) 市场竞争格局与 AI 时代的四层技术栈
当被问及这场价格战会持续多久、谁会成为最终赢家时,李彦宏表示很难给出一个具体的时间表。由于参与者既有创业公司,也有资金雄厚的互联网平台巨头,理论上“烧钱”可以持续很长时间。但他强调,烧钱不是本质,优胜劣汰的本质依然是技术和效率。
关于中国市场是否会呈现“赢家通吃”(Winner-takes-all)的局面,李彦宏从 IT 技术栈变革的角度给出了他的观察。他认为,生成式 AI 将传统的 IT 三层技术栈(芯片层、操作系统层、应用层)重构为了四层: 1. **芯片层** 2. **框架层**(深度学习框架) 3. **模型层** 4. **应用层**
李彦宏预测,在芯片层、框架层和模型层,每一层可能都会诞生至少两到三个大型玩家。而在应用层,则会出现数以百万级甚至千万级的应用,并逐步诞生 3 到 5 个“超级应用”(Super Apps)。在模型层,由于最终比拼的是效率,如果某家模型的效率不够高,开发者就会转向更划算的其他模型。陈倩对此表示赞同,并提到 Anthropic 的相关负责人也曾表达过类似观点,即国际市场最终可能也只会剩下四个左右的大模型。
[09:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=599s) AI to B 在中国的落地与中小模型的崛起
在上一波互联网浪潮中,中国的 to C(消费者端)超级应用风生水起,但 to B(企业端)的 SaaS(软件即服务)却未能成功爆发。数据显示,2022 年美国 IT 产业中 SaaS 支出占比为 7.2%,而中国仅为 2.6%。李彦宏认为,互联网对 B 端的改造其实“一般般”,很多时候只是完成了信息化或数据化的过程,技术简单且增益不明显。但大模型不同,它在 B 端能产生实实在在的颠覆性价值,例如辅助小说创作、法律原创(帮助律师提升效率),以及在能源、电力、智能制造等领域的应用。
李彦宏特别提到了汽车行业,目前国内很多电动车的车载对话系统都在调用文心大模型,对于百度来说,这就是典型的 to B 应用(通过 OEM 车厂集成后服务于终端消费者)。针对制造业企业家关于“通用大模型与垂直大模型关系”的困惑,李彦宏分享了百度的探索过程。起初,百度致力于将基础模型做得无比强大,希望实现“通用人工智能”。但后来发现,不同场景对响应速度和准确性的要求截然不同:有些场景可以容忍两分钟的延迟以换取绝对准确,而有些场景(如车载交互)则要求一秒内必须给出反馈。
为了满足这种对响应速度和成本的极致要求,百度自 2023 年 10 月发布文心 4.0 以来,主要精力便放在了“根据最强大的模型去裁剪各种体量的小模型”上,推出了十亿、百亿、千亿等不同量级的模型。这些小模型通过精调(SFT)和行业数据灌注,在特定垂直场景中能达到与大模型相当的效果,且推理成本更低、响应速度更快。李彦宏透露,目前百度每天高达 5 亿次的调用量中,调用量最大的绝对不是最强大的模型,而是这些轻量级模型。近期发布的文心 4.0 Turbo 也是在保证效果的同时,大幅提升了响应速度并降低了成本。
- **SaaS 历史差异**:中国过去许多 B 端需求被大型平台直接满足了(例如电商平台为商家提供工具),而美国商家更倾向于独立建站。 - **AI 时代的转变**:AI 并非凭空创造新业态,而是对现有业态的“增强”(Enhancement),这使得 B 端需求在中国会比互联网时代大得多。 - **商业成功案例**: - **小说创作与法律辅助**:显著提升专业人员的生产效率。 - **电商数字人直播**:利用大模型生成包含详实科研数据的直播话术,在售卖营养品等专业产品时,效果甚至优于真人主播。 - **招聘场景**:大模型能精准理解雇主意图与求职者简历的匹配度,省去了 HR 逐份筛选和盲目面试的大量成本。
[19:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=1199s) 对 Scaling Law 的信仰、AGI 的定义与商业算账
随着 GPT-5 的一再延迟发布,硅谷及全球科技界对 Scaling Law(尺度定律)产生了怀疑,包括 Yann LeCun 和 Yoshua Bengio 等巨头也对盲目追求大参数消耗社会资源的路线提出警告。对此,李彦宏表示他并不担心。他认为,基础模型迭代速度稍微放缓对应用开发者来说反而是好事,因为这提供了一个相对稳定的 Base,避免了开发者每天因模型更新而重写代码的窘境。
李彦宏指出,在 Scaling Law 之外,智能体(Agent)的反思能力和进化能力等创新已经与单纯的参数堆叠(Decouple)产生了一定程度的解耦。未来在 Transformer 大模型之上,还会叠加出更多无法想象的创新。
对于 AGI(通用人工智能)的实现标准,李彦宏认为目前大模型虽然通过了图灵测试,但真正的 AGI 意味着“机器在任何场景下都能具备人所具备的能力”。他以百度投入了 11 年的无人驾驶为例,指出即使在专用场景下,AI 依然难以做到完美容错,因此实现真正的 AGI 还需要“十年以上,也许二十年,甚至更长时间”。他幽默地调侃道:“如果连十年都没有的话,太容易了,就不叫信仰了。”
在采访的尾声,陈倩分享了一笔关于 AI 投资回报率(ROI)的账目: - 全球在 AI 芯片上的支出约为 4000 亿美元,相当于 1.1 万亿美元的数据中心支出。 - 若要求 25% 的投资资本回报率(ROIC),企业需要产生 1.4 万亿美元的成本节省(相当于全球技术工人工资的 5%)。 - 或者,若假设利润率为 50%,则需要 AI 创造 2.8 万亿美元的收入(相当于全球 GDP 的 2%)。 - 高盛预测,生成式 AI 将在 10 年内推动全球 GDP 增长 7%(约 7 万亿美元),并将生产率提高 1.5 个百分点。
李彦宏强调,相比于盲目追求“能考过高中数学高考”的名义上更强大的大模型,业界应该更关注真实的市场需求(例如一个卖车销售需要什么样的话术来劝说客户)。如果无法解决实际商业场景中的降本增效问题,拼命往前跑只会走弯路、浪费资源。在中小模型和模型蒸馏的趋势下,闭源模型凭借强大的基础模型底座,在蒸馏出高竞争力的小模型方面依然保有巨大优势。
## Notable quotes > [00:00](https://www.bilibili.com/video/BV1Xi421Y7ka?t=0s) 几乎不可思议的这种低的地步 — 李彦宏
> [00:00](https://www.bilibili.com/video/BV1Xi421Y7ka?t=0s) 无线空间永久免费 — 部分网盘公司
> [09:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=599s) 根据最强大的模型去裁剪各种体量的小模型 — 李彦宏
> [09:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=599s) 一般般 — 李彦宏
> [09:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=599s) 增强
> [19:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=1199s) 机器在任何场景下都能具备人所具备的能力 — 李彦宏
> [19:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=1199s) 十年以上,也许二十年,甚至更长时间 — 李彦宏
> [19:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=1199s) 如果连十年都没有的话,太容易了,就不叫信仰了 — 李彦宏
> [19:59](https://www.bilibili.com/video/BV1Xi421Y7ka?t=1199s) 能考过高中数学高考 — 李彦宏
## Mentioned 硅谷101, 陈倩, 第一财经, 杨宇东, 百度, 李彦宏, 百度网盘, Anthropic, 文心大模型, 文心 4.0, 文心 4.0 Turbo, GPT-5, Yann LeCun, Yoshua Bengio, 高盛, Transformer
[Source](https://www.bilibili.com/video/BV1Xi421Y7ka)