前Meta总监田渊栋联合创办AI实验室RSI获融6.5亿美元
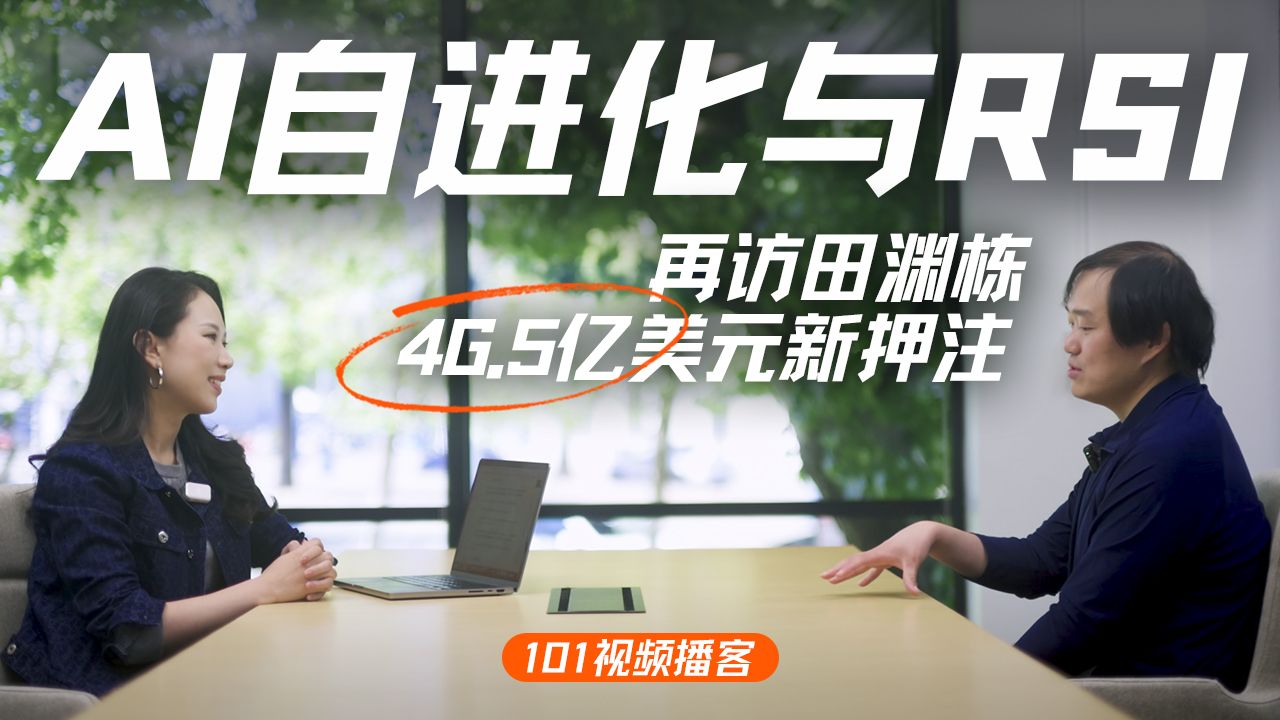
硅谷101
大厂因臃肿同质化在AI自进化研发中落后,其频繁裁员与数据蒸馏逼迫员工在未来三到五年内向独特性自我升级。
AI-assisted summary of 再访田渊栋:46.5亿美金估值的RSI,与AI自进化|Neolabs特辑【101视频播客】 — original source. Check the original for full context.
Source published:
Detailed notes
## Background 该视频播客由Bilibili渠道“硅谷101”于2026年6月5日发布。视频简介指出,由于AI正以惊人速度加速自身开发进程(即递归自我改进),Meta前FAIR研究总监田渊栋重回旧金山,带着官宣估值46.5亿美元的新实验室Recursive Superintelligence (RSI) 押注“用AI实现AI自进化”的赛道,并深入探讨了前沿模型厮杀、大厂员工被加速“蒸馏”的职业变局及普通人的破局之道。
## TL;DR 本期节目是与RSI联合创始人田渊栋的深度对话。田渊栋详细介绍了RSI集结了Richard Socher、Alexis Dosovitskiy等8位顶尖AI学者的豪华创始团队,以及大厂臃肿导致“团队小型化”的行业趋势;阐述了RSI通过AI自动化科研实现“递归自我提升”的核心愿景,并揭秘了潜在推理(Latent Reasoning)与顿悟(Grokking)的数学奥秘;最后,他深入剖析了Google、Meta、XAI等大厂的组织架构与资本叙事困境,并针对AI引发的失业潮,生动地建议普通人要从“鱼进化成鸟”,寻找自身独特的不可替代价值。
## Atmosphere & style 整个专访洋溢着一种理性、前沿且务实的极客科技氛围。主持人与田渊栋的对话如行云流水,在层层追问中充满了顶级学者间的思想碰撞,既有对宏大技术愿景的激情畅想,又有着落脚于商业模式与算力效率的清醒脚踏实地。听到田渊栋用“水干了的鱼缸”和“四维生物”来比喻当下大厂员工被蒸馏、裁员的残酷现实时,能感受到一种扑面而来的时代紧迫感;而最后实地探访旧金山办公室时,混坐办公的扁平文化与乒乓球桌的闲适,又让这种紧迫感轻巧地落回了一种充满活力的硅谷创业创新节奏中。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1DY7C6nEWM?t=0s) 前Meta基础AI研究团队研究总监田渊栋联合创立新AI实验室Recursive Superintelligence(RSI),公司在无产品阶段即获得6.5亿美元融资,估值达46.5亿美元。 - [00:00](https://www.bilibili.com/video/BV1DY7C6nEWM?t=0s) 大公司因组织臃肿、沟通成本高导致模型迭代慢,这使得大模型研发正走向团队小型化、敏捷化、少摩擦的趋势。 - [00:00](https://www.bilibili.com/video/BV1DY7C6nEWM?t=0s) RSI的8位联合创始人背景高度互补且多具创业经验,核心成员包括Richard Socher、熊蔡明、Tim Rocktäschel等AI业界顶尖人才。 - [14:59](https://www.bilibili.com/video/BV1DY7C6nEWM?t=899s) RSI的核心愿景是实现“递归自我提升”(Recursive Self-Improvement),即利用AI自动化高难度科研并自动发现新洞察,突破人类生理瓶颈以加速科学发现。 - [14:59](https://www.bilibili.com/video/BV1DY7C6nEWM?t=899s) 未来的AI评估将从高层次、虚幻的中间指标(Benchmark)转向完全的“结果导向”(Result-driven),即看最终产出的系统能否完美运行。 - [14:59](https://www.bilibili.com/video/BV1DY7C6nEWM?t=899s) 在AI自主修改代码和权重的递归系统里,可解释性(Interpretability)对AI安全评估以及提高成千上万张显卡的算力效率至关重要。 - [24:59](https://www.bilibili.com/video/BV1DY7C6nEWM?t=1499s) 田渊栋将继续在RSI推进连续“潜在空间”推理(Latent Reasoning)的研究,他认为语言更多是解释而非思考过程,Latent Reasoning在存储高维信息和并行推演上的效率远高于语言Token。 - [24:59](https://www.bilibili.com/video/BV1DY7C6nEWM?t=1499s) 田渊栋关于“顿悟”(Grokking)的研究表明,在结构化数据输入时,可以通过数学上的能量函数描述神经网络从死记硬背突然跃迁到泛化的底层机制。 - [34:59](https://www.bilibili.com/video/BV1DY7C6nEWM?t=2099s) RSI的商业化思考聚焦于高价值的底层范式,包括提高推理效率并商业化配方、科研自动化服务以及将技术应用拓展至物理、化学等AI for Science领域。 - [54:59](https://www.bilibili.com/video/BV1DY7C6nEWM?t=3299s) 大厂内部存在决策自上而下、盲目追逐热点导致产品“同质化”的问题;小实验室则依靠独特的“研究品味”绕开昂贵的算力堆叠,极度聚焦于独特方向。 - [01:05:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=3915s) 大模型领域未来的竞争可能会在技术触及上限后演变成价格战,同时由于大部分人写的代码质量有限,Coding赛道的数据飞轮能否真正转起来仍是未知数。 - [01:10:45](https://www.bilibili.com/video/BV1DY7C6nEWM?t=4245s) 下一个行业大趋势(The Next Big Thing)将是AI Research(AI用于科学研究),其自动化带来的投资回报率(ROI)将是天文数字。 - [01:10:45](https://www.bilibili.com/video/BV1DY7C6nEWM?t=4245s) 头部大模型公司一旦进入资本叙事、必须追求营收和资产负债表时,其商业逻辑和产品策略可能会与早期的纯研究实验室(Research Lab)产生脱节。 - [01:15:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=4515s) 前沿大模型之争最终演变成了组织架构之争,如XAI因高层施压、内部缺乏反驳(Push back)机制导致模型不达预期,暴露了落后生产关系与先进生产力之间的矛盾。 - [01:01:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=3675s) AI Agent的能力已达到资深工程师水平,随着大厂持续裁员,“大家迟早全部都要失业”正在加速到来,人们频繁跳槽被裁将成为常态。 - [01:20:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=4815s) 面对AI时代的个体困境,人们不能再做大机器上的螺丝钉,而是要像“鱼进化成鸟”一样成为四维生物,寻找自身独一无二的价值并成为行走的数据源。
## Detailed walkthrough 以下是该视频播客采访(第一部分)的详细内容 walkthrough:
### [00:00](https://www.bilibili.com/video/BV1DY7C6nEWM?t=0s) RSI 的诞生与顶级创始团队的集结 在去年从 Meta 基础 AI 研究实验室(FAIR)离职后,前研究总监田渊栋历经半年的沉淀,于近期正式官宣了他的新动向——与其他七位顶级 AI 研究员共同创立了新的 AI 研究公司 **Recursive Super Intelligence(简称 RSI)**。这家新公司在没有任何产品问世的前提下,便斩获了 **6.5 亿美元的融资,估值高达 46.5 亿美元**,引发了资本市场与科技界的瞩目。田渊栋透露,半年前接受采访时其实去向已大致敲定。在离职后的 10 月初至 10 月底,他的手机几乎处于被“打爆”的状态,消息多到根本无法回复。当时包括 Anthropic、XAI、Amazon、Apple、Microsoft 在内的多家巨头和明星团队都曾向他抛出橄榄枝,但他最终选择加入 RSI,核心原因在于他看到了大模型研发中“团队小型化、速度变快、摩擦变少”的必然趋势。
田渊栋指出,大公司由于组织架构臃肿、沟通成本极高,CEO 的战略意图传达到底层需要耗费大量时间去对齐,这导致大团队的迭代速度远远落后于敏捷的小团队。这也是近期许多大厂频繁进行组织架构重组(reorg)、裁员和调整战略的根本原因。在 Meta 工作了近 11 年的田渊栋对此深有体会,因此决定换一种生活方式。在众多邀请中,RSI 吸引他的不仅是因为机会巨大,还因为团队中有他熟识的旧友。例如联合创始人 Tim Rocktäschel 曾是他在 Meta 伦敦工作时的同事,两人在强化学习(Reinforcement Learning)领域非常熟悉。
RSI 拥有 **8 位联合创始人(Co-founders)**,这一配置在创业公司中颇为罕见。田渊栋解释说,这 8 位成员的专业背景高度互补,且都是极其聪明的顶尖人才,因此合作起来非常省心、民主,碰撞出了很多思想火花。这 8 位核心成员包括: - **Richard Socher(CEO)**:曾创立 Metamind 并被 Salesforce 收购,后担任 Salesforce 首席科学家 4 年,随后创立了已实现盈利的搜索引擎 U.com。 - **熊蔡明**:曾与 Richard 共同创立 Metamind,在 Salesforce 工作十余年,曾任 Salesforce Research 的高级副总裁(Senior VP)。 - **Tim Rocktäschel**:前 Meta 研究员,后在 Google DeepMind 担任 Project Gemini(Gen 1, 2, 3)的 Lead,并领导了 Agent Openness 团队。他在学术界和工业界口碑极佳,Google Venture 在对其进行背景调查后给出了极高评分,对 RSI 本轮融资贡献巨大。 - **Jeff Clune**:长期深耕 Agent Openness 领域,其团队近期撰写的关于“AI Scientist V2”的文章已被《Nature》收录,学术影响力深远。 - **Josh Tobin**:OpenAI 早期员工,曾创立公司并被收购,后回到 OpenAI 担任 Agent Science Lead,在工程和 Agent 领域拥有丰富经验。 - **Alexis (Alexey) Dosovitskiy**:十多年前便与田渊栋在强化学习游戏《Doom》(毁灭战士)的比赛中相识(当时田渊栋获第一赛道冠军,Alexis 获第二赛道冠军)。他是奠基性论文《An Image is Worth 16x16 Words》(Vision Transformer,简称 ViT)的第一作者,首次将 Transformer 引入计算机视觉领域,后曾加入 AI for Science 创业公司。 - **石天林(Tim Shi)**:前 Cresta 的 CTO,在 Cresta 创立并发展多年后,因对 RSI 的愿景产生极大兴趣,毅然辞去 CTO 职务加入。 - **田渊栋**:在团队中主要负责 Modeling(建模、训练、后训练)以及部分 Agentic Harness 的工程与前沿研究结合工作。
---
### [14:59](https://www.bilibili.com/video/BV1DY7C6nEWM?t=899s) 什么是递归自我提升(Recursive Self-Improvement)? RSI 的核心愿景是实现 **“递归自我提升”(Recursive Self-Improvement)**,即利用 AI 来优化 AI 自身,让 AI 像滚雪球一样自我迭代、变得更强。其官方网站上的口号是 "Maximizing the scientific discovery rate"(最大化科学发现的速度),旨在通过自动化科研来加速人类社会的进步。田渊栋指出,目前主流的前沿大模型(如 OpenAI、Anthropic、Google 的产品)依然极度依赖人类研究员来设计模型、收集数据、进行大规模训练和人工标注对齐。然而,人类的生理极限(需要睡觉、吃饭、精力有限)已经成为了 AI 演进的瓶颈。RSI 的第一步是让 AI 代替人类进行繁重、重复的科研劳动,第二步则是让 AI 自动去发现新的洞察和重要信息。
针对“AI 究竟是实现了真正的能力提升,还是仅仅在评估指标(Benchmark)上过度拟合(Overfitting)”的疑问,田渊栋表示,他们的目标是让 AI 的能力实现本质跨越——从目前只能做本科生水平的工作,提升到能做硕士、博士甚至资深研究员才能做的高难度科研。他坦言,刷榜(Benchmark)只是手段,且指标往往是高层次、虚幻的。随着 AI 的发展,未来的评估将从中间状态的 Benchmark 转向完全的“结果导向”(Result-driven)。例如在 AI 写代码时,不再纠结于中间的模块设计是否符合某种标准,而是看最终产出的系统能否完美运行并被用户喜爱。
在这种高度自主、甚至 AI 自己修改代码和权重的递归系统里,**“可解释性”(Interpretability)** 变得比以往任何时候都更加重要。田渊栋阐述了两个核心原因: 1. **安全(Safety)**:RSI 致力于构建“安全的人工超级智能”(Safe Super Intelligence)。只有理解模型的内部机制,才能在模型自主运行和探索时,及时评估其是否越界、是否产生威胁,从而在“超出人类预想”与“失去控制”之间划清界限。 2. **算力效率**:进行递归自我提升需要消耗成千上万张显卡的巨大算力。如果缺乏可解释性,研究员只能等模型完全训练完才能评估好坏,效率极低;而有了可解释性,就可以将评估步骤前置,极大提升预算和算力效率。
---
### [24:59](https://www.bilibili.com/video/BV1DY7C6nEWM?t=1499s) 探索 Latent Reasoning 与“顿悟”的数学奥秘 在技术路线上,田渊栋提到了他之前在 Meta 备受关注的工作 **Coconut**。该研究主张让 AI 在连续的“潜在空间”中进行推理(Latent Reasoning)。他明确表示,未来在 RSI 他会继续推进这一方向的研究,并将其作为公司的“独门秘籍”(Secret Source)进行黑盒化或选择性发表。
田渊栋对当前主流的 **思维链(Chain of Thought, CoT)** 路线表达了独特见解。他认为 CoT 非常实用且效果显著,但并非终极方案。人类在思考深奥问题时,往往不需要语言作为媒介,而是依赖图像、直觉或某种“说不清道不明”的思路,最后才将结果转化为语言进行解释。因此,语言更多是一种“解释”而非“思考的过程”。在原理上,**Latent Reasoning 的效率远高于语言**: - 语言的 Token 信息量是离散且有限的,必须一步步写出来。 - Latent Token(潜在 Token)可以同时存储多个不同的思路和高维信息,并在潜在空间中并行推演,最终直接输出正确路径。 - 这种机制在处理复杂的图搜索等问题时表现出极大优势,有传言称 Anthropic 的某些新模型便采用了类似的 Latent Space 架构(如 Loop Transformer)。
此外,田渊栋还分享了他关于 **“顿悟”(Grokking)** 的研究。这一研究旨在揭示神经网络如何从“死记硬背”(Memorization)突然跃迁到“泛化”(Generalization)的底层机制。他解释说,在结构化数据输入时,可以通过一个数学上的“能量函数”来描述这一过程:当数据量不足时,能量函数的最小值对应的是“记忆解”;而当数据量达到临界点(在特定设计下,若总数据量为 $m^2$,则临界点大约在 $m \log m$ 数量级,略高于线性但远小于总数)时,能量函数的结构会发生突变,指向“泛化解”。理解这一过程,将有助于大幅提升神经网络的训练效率。
---
### [34:59](https://www.bilibili.com/video/BV1DY7C6nEWM?t=2099s) 商业化思考与 AI 实验室的格局演变 尽管 RSI 的愿景宏大,但田渊栋强调,这是一个非常“接地气”且注重商业落地的团队,超过半数的成员拥有创业经验。他们内部经常实际地讨论“这个东西怎么赚钱”、“如何产生商业效益”。在商业化方向上,RSI 有几个清晰的思考: - **提高推理效率**:通过自我提升算法训练出推理速度极快、效率极高的模型,并将其 Recipe(配方)进行商业化。 - **科研自动化服务**:对人类的科研思维方式进行建模,让 AI 承担高难度的科研工作,直接转化为商业价值。 - **AI for Science**:将技术应用拓展至物理、化学、临床生物学等领域,帮助药企或材料公司寻找新材料、超导解决方案或核聚变方案。
对于为什么不直接做一个容易变现的 2B 企业服务或消费端产品,田渊栋给出了深刻的行业洞察。他指出,过去三年里,很多为特定垂直领域做定制化模型的创业公司,都面临着“今天做出来的产品,下个月就被底层大模型升级直接碾压和取代”的巨大痛点。因此,RSI 必须把目光放得更长远,专注于**“自我进化、自我提升”这一底层范式**。只要这个范式不变,公司的立足点就永远成立。
在行业竞争方面,面对 DeepMind 的 AlphaFold、AlphaEvolved 等强劲对手,田渊栋认为小公司的优势在于**极度聚焦(Focus)**。大公司虽然有几万名员工,但科研自动化可能只是其上百个项目中的一个,资源分散,且员工的激励机制不同;而 RSI 会将 100% 的精力和融到的 6.5 亿美元资金全部砸在“自我提升”这一个方向上。
针对当前各大 AI 实验室(New Labs)的版图,田渊栋也分享了他的看法: - **Ilya Sutskever 的 SSI (Safe Super Intelligence)**:由于极度保密,外界很难知道其内部进展。虽然融了很多钱,但可能不会去走类似 GPT 或 Claude 那种拼算力规模的传统路线,而是可能在探索某种能极大提高训练效率的新范式。 - **Yann LeCun 的 AMI Lab(世界模型)**:探索的是完全不同的非语言路线,特别是在视频和图像的世界模型上,并尝试与机器人(Robotics)结合。但田渊栋个人认为,语言的上限比视觉更高,因为语言可以自指、无限嵌套并定义新概念,而视觉像素的组合相对固定。 - **David Silver 的 Inneffable Intelligence**:更倾向于完全不依赖大模型,试图在无人类先验知识的情况下,纯粹通过强化学习(类似于 AlphaZero 的模式)在开放领域实现突破。但田渊栋认为,围棋有明确的胜负评估函数,而开放领域没有,这需要极其恐怖且目前难以满足的算力。相比之下,RSI 更加务实,“如果大模型厉害,我们肯定会用大模型”。
最后,田渊栋赞同“Pre-training(预训练)的上限决定了 RL(强化学习)的上限”这一观点。强化学习的作用是把模型原本排在第 200 位的答案提到第 1 位,前提是模型在预训练阶段已经涌现出了正确的“种子”和推理模式。如果预训练底子不好,强化学习再怎么压榨也无济于事。因此,如何通过合成数据(Synthetic Data)和连续学习(Continual Learning)来优化预训练,依然是行业的核心课题。
以下是根据您提供的视频转录文本第二部分( 至结尾)整理的详细、忠实的走访与对话实录。
---
[54:59](https://www.bilibili.com/video/BV1DY7C6nEWM?t=3299s) 新兴实验室(New Lab)的生存法则与大厂的同质化困境
在探讨新兴 AI 实验室(New Lab)的宏观发展时,袁栋指出,这些实验室面临的核心挑战在于“如何在资源有限的环境下,高效地产生研究成果并推动技术进步”。许多 New Lab 的成员此前来自资源极其丰富的大厂,习惯了动辄花费数百万甚至数十亿美元去跑实验,而这些成本过去都由大厂买单。对于新成立、需要依赖融资生存的小实验室而言,必须思考如何让学习和迭代过程变得更有效率,而不是盲目迷信传统的 Scaling Law(尺度定律)。如果研究人员脑子里只有堆砌计算资源的 Scaling Law,在小团队中很难成功,必须对问题有更深层的理解,依靠独特的“研究品味”(Research Taste)去绕开昂贵的算力堆叠。
谈及小实验室与 Google、OpenAI 等大厂的关系,袁栋认为目前两者主要处于“平行发展”的状态。大厂如今存在一个显著的趋势——“同质化”。因为大厂的决策往往是自上而下的,高层和 CEO 倾向于追逐热点,看到别人做什么做得好,就会要求团队也去做。这种环境和舆论压力逼迫大厂员工去卷 Coding Agent 等热门方向,导致大家做出来的东西大同小异。相比之下,小公司为了快速产生效益,自然会选择大公司暂时没有精力顾及的独特方向。
- **历史的规律**:这种平行发展在历史上屡见不鲜。例如 Anthropic 在早期(去年或前年)行业都在刷 AIME 等数学(Math)榜单时,默默选择主攻 Coding(代码能力),甚至在发布模型时都不放数学的性能指标。当大家发现 Coding 确实能带来极佳的商业模式和变现能力时,所有大厂才一拥而上。 - **大厂的效率问题**:即使大厂看到机会并用无限的资金和资源压顶,小公司也未必会被轻易盖过。大厂的效率往往存在问题,例如 Google 即使由高管亲自挂帅成立 Strike Team 去追赶 Coding,其产品依然带有大公司的各种毛病。而此时,成功的小公司已经积累了足够的资金和市场杠杆。
---
[01:01:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=3675s) 抢人大战与 New Lab 的选人标准
在招人方面,袁栋透露 RSI(Recursive Super Intelligence)目前非常受欢迎,收到了大量简历。大厂和小厂在招人上吸引的是完全不同 Mindset(心态)的人。大厂(如 OpenAI、Meta)通过极高的薪资、福利和股票吸引那些技术能力强、但其能力对大厂现有业务有即时用处的人;而小厂吸引的则是那些看重愿景、方向,并希望在未来产生巨大影响力的人。由于这种“自我筛选”(Self Selection)机制的存在,双方并不会产生直接的恶性抢人竞争。
- **RSI 的人才画像**:倾向于招收经验丰富且极其 Hands-on(动手能力强)的人。在 AI 空间瞬息万变的今天,经验、品味和方向感至关重要,同时他们必须愿意亲自动手把事情做成。对于毕业生则是 Case by Case,只有极其优秀、在业界已有知名工作成果的毕业生才会被考虑。 - **团队规模**:RSI 目前团队规模在 25 人左右,未来希望根据市场变化逐步扩大到 40 人左右。 - **就业版图的剧变**:袁栋重申了他半年前的观点——“大家迟早全部都要失业”。随着 Meta、Amazon 等大厂持续裁员,这一天正在加速到来。现在的 AI Agent 能力已经达到了大厂 Level 4(应届毕业生)甚至 Level 5(资深工程师)的水平,能够替代大量基础的工程工作。
---
[01:05:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=3915s) 行业巨头解析:Anthropic 的崛起与 Coding 赛道的变数
针对 Andrej Karpathy 加入 Anthropic 这一行业热点,袁栋表示这证明了“自我提升/自动研究”(Self-improvement / Auto Research)方向已成为业界公认的主流。Karpathy 此前在 Twitter 上直播自己做 Auto Research 的过程并开源了图像和报告,影响力极大。他加入 Anthropic 明确表示将专注于预训练和 Auto Research,这让整个行业对该路线的信心大增。
尽管 Anthropic 的 Claude 3.5 Sonnet 势头极猛,但袁栋认为 Coding 赛道的格局仍存在变数。他个人在使用 Claude 时也会遇到幻觉问题(例如模型会很快为错误道歉,但无法在提问前主动避免错误)。OpenAI 的 Codex 并不比 Claude 差太多,只要 OpenAI 想追,其技术和产品能力完全能追上去;Google 也在由高管亲自挂帅全力追赶;开源领域的 DeepSeek-Coder 表现也相当不错(虽然需要预热一万个 Token 才会变聪明)。
- **价格战的隐忧**:对于普通用户而言,模型能力达到一定上限、够用即可。一旦大家的技术都触及这个上限,竞争最终可能会演变成价格战。 - **数据飞轮的疑问**:虽然有观点认为先发者能通过数据飞轮越跑越快,但袁栋质疑,大部分人写的代码其实并不怎么样,真正重要的代码都是少数大神写出来的,因此这个数据飞轮能否真正转起来仍是未知数。 - **关于 Anthropic 的 Opus 3.5**:对于传闻中因“太强而不敢发布”的说法,袁栋不予置评。他指出,将推理链结果放入预训练或中训练(Pre-training / Mid-training)是大家都在做的常规操作,Opus 的强大可能源于模型架构、训练优化器或 Recipe(配方)上的独特创新。
---
[01:10:45](https://www.bilibili.com/video/BV1DY7C6nEWM?t=4245s) 下一个大趋势:AI Research 与大厂的资本叙事困境
在 Coding 之后,袁栋预测“下一个大事件”(The Next Big Thing)将是 **AI Research**(AI 用于科学研究)。Coding 之所以能火,是因为写代码的 ROI(投资回报率)极高,能替代高薪程序员。而大模型人才比程序员更贵,如果能将 AI Research 自动化,其 ROI 将是天文数字(例如发现新药、新材料或训练模型的新方法)。
谈到 OpenAI 与 Anthropic 的长期竞争,袁栋认为两家公司一旦有了可观的 Revenue(营收),就会不可避免地掉入资本市场的叙事逻辑中。
> “一旦你开始有 Revenue 了,我希望有更多人……你有很多 Revenue,但是你还是资本,你靠财很高,怎么办?会不会有这个问题?他们都要上市了嘛,要不然就是削减你的 Cost(成本),为什么把 Sora 关了?要不然你就再多挣点钱。它一定要进入这个叙事之后,那么这个逻辑就可能和以前的一个 Research Lab 的逻辑不一样了。Research Lab 的逻辑就是说我要证明自己很厉害,我做了一个新东西出来,你看没人做过吧,很厉害,超级 Impressive。但是一旦它掉进了资本上的一个……上市要做资本叙事、要做 Revenue、要做资产负债表的时候,你就会回到了之前的商业模式。”
---
[01:15:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=4515s) 谷歌、Meta 与 XAI 的组织架构之争
对于 Google,袁栋依然保持敬意,认为其内部有非常厉害的人才,只要领导层重视,Gemini 3 之后的后续版本依然有追赶的机会。
对于前东家 Meta,袁栋披露自己仍持有大量 Meta 股票。他评价 Llama 3(Meta's Llama 3)的理解和多模态回答表现不错,虽然相比 Gemini 1.5 Pro 仍有差距。他不认为 Meta 放弃了争夺最强通用模型的野心,Meta 的策略依然是先训练一个强大的通用模型,再针对特定场景进行微调。大模型领域没有永远的赢家,大家都在“犬牙交错”地往前走,拼的是谁在细节上做得更扎实、更努力。
针对 Meta 裁员的同时强制蒸馏员工数据(利用员工工作数据训练 AI 模型以替代外包)的争议,袁栋坦言这确实会让员工产生“练好神功就被踢走”的对立情绪,甚至可能导致员工在数据中“埋雷”或消极怠工。但从公司利益出发,这属于无可厚非的雇佣条款,且正成为大趋势。
对于马斯克的 XAI,袁栋透露其面临的困境与 Llama 4 类似:老板(马斯克)施加了极大的压力,希望事情快速发生,但组织内部缺乏能够 Push back(反驳)高层不切实际要求的人。员工为了顺从压力做出妥协,导致最终交付的模型不达预期,进而引发组织大地震。这本质上是“先进生产力与落后生产关系之间的矛盾”,前沿大模型之争最终演变成了组织架构之争。
---
[01:20:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=4815s) 鱼要进化成鸟:在 AI 时代寻找个人意义
面对 AI 带来的失业潮,袁栋用了一个生动的比喻来形容当前的就业困境:
> “下一天有句话嘛,就是说有人把水弄干了。把水弄干的鱼不在这里……有些鱼把水弄干了,弄干之后呢,其实其他的鱼不停地在跳,但是不停地在跳的时候呢,你会发现水总的来说是越来越少的。所以你永远找不到,你最后一定要变成一个四维生物你才能活下来。所以鱼要进化成鸟,长出翅膀来才能够生存下去。”
袁栋认为,在未来 3 到 5 年内,频繁跳槽却反复被裁将成为常态。人们必须从“大机器上的螺丝钉”转变为寻找自身独一无二的价值。每个人都要成为一个“行走的数据源”,去探索只有自己愿意探索的领域,并将新数据分享出来。
作为科幻小说爱好者,袁栋笑称现在的 AI 发展太快,让他产生了紧迫感,“如果再不写的话,我的 Idea 就没了,因为已经实现了”。
---
[01:28:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=5295s) RSI 办公室实地探访
在访谈的最后,主持人陈倩参观了 RSI 位于旧金山市区(City)的办公室。袁栋介绍,团队在两个多月前搬入这里。硅谷如今许多新的 AI 实验室都选择设在旧金山市区而非南湾,主要是因为这里的人才密度极高,方便初创公司之间交流。
- **工作模式**:RSI 目前有 25 人,其中三分之二在旧金山,三分之一在伦敦。公司实行混合办公,员工一般一周来办公室三天。 - **办公环境与文化**:办公室拥有极佳的大玻璃窗采光。这里没有专属的老板办公室,袁栋和员工都混坐在一起以方便沟通。公司极力避免无意义的开会,提倡“有话直说、直接反馈”的 Technical(技术导向)和实干文化。 - **休闲设施**:办公室里配有一张乒乓球桌。当被问及是否会像 Andrej Karpathy 的团队那样在办公室里装桑拿房时,袁栋笑称“我们现在有乒乓球桌,桑拿房可能还没那么高级”。
## Notable quotes > [00:00](https://www.bilibili.com/video/BV1DY7C6nEWM?t=0s) 团队小型化、速度变快、摩擦变少 — 田渊栋
> [14:59](https://www.bilibili.com/video/BV1DY7C6nEWM?t=899s) Maximizing the scientific discovery rate
> [34:59](https://www.bilibili.com/video/BV1DY7C6nEWM?t=2099s) 预训练的上限决定了 RL(强化学习)的上限
> [01:01:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=3675s) 大家迟早全部都要失业 — 田渊栋
> [01:10:45](https://www.bilibili.com/video/BV1DY7C6nEWM?t=4245s) 一旦你开始有 Revenue 了,我希望有更多人……你有很多 Revenue,但是你还是资本,你靠财很高,怎么办?会不会有这个问题?他们都要上市了嘛,要不然就是削减你的 Cost(成本),为什么把 Sora 关了?要不然你就再多挣点钱。它一定要进入这个叙事之后,那么这个逻辑就可能和以前的一个 Research Lab 的逻辑不一样了。Research Lab 的逻辑就是说我要证明自己很厉害,我做了一个新东西出来,你看没人做过吧,很厉害,超级 Impressive。但是一旦它掉进了资本上的一个……上市要做资本叙事、要做 Revenue、要做资产负债表的时候,你就会回到了之前的商业模式。 — 田渊栋
> [01:15:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=4515s) 练好神功就被踢走
> [01:15:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=4515s) 先进生产力与落后生产关系之间的矛盾
> [01:20:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=4815s) 下一天有句话嘛,就是说有人把水弄干了。把水弄干的鱼不在这里……有些鱼把水弄干了,弄干之后呢,其实其他的鱼不停地在跳,但是不停地在跳的时候呢,你会发现水总的来说是越来越少的。所以你永远找不到,你最后一定要变成一个四维生物你才能活下来。所以鱼要进化成鸟,长出翅膀来才能够生存下去。 — 田渊栋
> [01:20:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=4815s) 大机器上的螺丝钉 — 田渊栋
> [01:20:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=4815s) 行走的数据源 — 田渊栋
> [01:20:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=4815s) 如果再不写的话,我的 Idea 就没了,因为已经实现了 — 田渊栋
> [01:28:15](https://www.bilibili.com/video/BV1DY7C6nEWM?t=5295s) 我们现在有乒乓球桌,桑拿房可能还没那么高级 — 田渊栋
## Mentioned 田渊栋, Meta, FAIR, 硅谷101, Anthropic, Recursive Superintelligence, RSI, XAI, Amazon, Apple, Microsoft, Tim Rocktäschel, Richard Socher, Metamind, Salesforce, U.com, 熊蔡明, Salesforce Research, Google DeepMind, Project Gemini, Google Venture, Jeff Clune, Nature, Josh Tobin, OpenAI, Alexis Dosovitskiy, Vision Transformer, ViT, 石天林, Cresta, Coconut, Loop Transformer, AlphaFold, AlphaEvolved, Ilya Sutskever, SSI, Yann LeCun, AMI Lab, David Silver, Inneffable Intelligence, AlphaZero, Google, Andrej Karpathy, Claude 3.5 Sonnet, Codex, DeepSeek-Coder, Opus 3.5, Sora, Gemini 3, Llama 3, Gemini 1.5 Pro, Llama 4, 马斯克, 陈倩
[Source](https://www.bilibili.com/video/BV1DY7C6nEWM)