> "As an investor, the task I was assigned by the researchers were to find a very powerful AI compute other than NVIDIA, because they predict that in 10 years, there will be a very big model coming out, larger than 500B parameters... We needed a different hardware to make sure the model can scale."
> — 周楠(前 Qualcomm Ventures 合伙人 / Cerebras 早期投资人)
> "I spoke to Sam in the middle of 2025, and he said for the first time, 'We've been trying so hard just to keep up with demand, we now see the importance of fast inference.' That produced a set of trials... and we were so much faster than the competition."
> — Angela Yeung(Cerebras 产品资深副总裁)
> [05:00](https://www.bilibili.com/video/BV1UZu46UErq?t=300s) As an investor, the task I was assigned by the researchers were to find a very powerful AI compute other than NVIDIA, because they predict that in 10 years, there will be a very big model coming out, larger than 500B parameters... We needed a different hardware to make sure the model can scale. — 周楠
> [25:00](https://www.bilibili.com/video/BV1UZu46UErq?t=1500s) I spoke to Sam in the middle of 2025, and he said for the first time, 'We've been trying so hard just to keep up with demand, we now see the importance of fast inference.' That produced a set of trials... and we were so much faster than the competition. — Angela Yeung
[0:00] Greg Diamos: 这就像是一套创造智能的食谱(recipe for intelligence)。
[5:00] 周楠: As an investor, the task I was assigned by the researchers were to find a very powerful AI compute other than NVIDIA, because they predict that in 10 years, there will be a very big model coming out, larger than 500B parameters... We needed a different hardware to make sure the model can scale.
[15:00] 第一代可能只卖了十几台,第二代卖了几百台
[25:00] Angela Yeung: I spoke to Sam in the middle of 2025, and he said for the first time, 'We've been trying so hard just to keep up with demand, we now see the importance of fast inference.' That produced a set of trials... and we were so much faster than the competition.
Original transcript
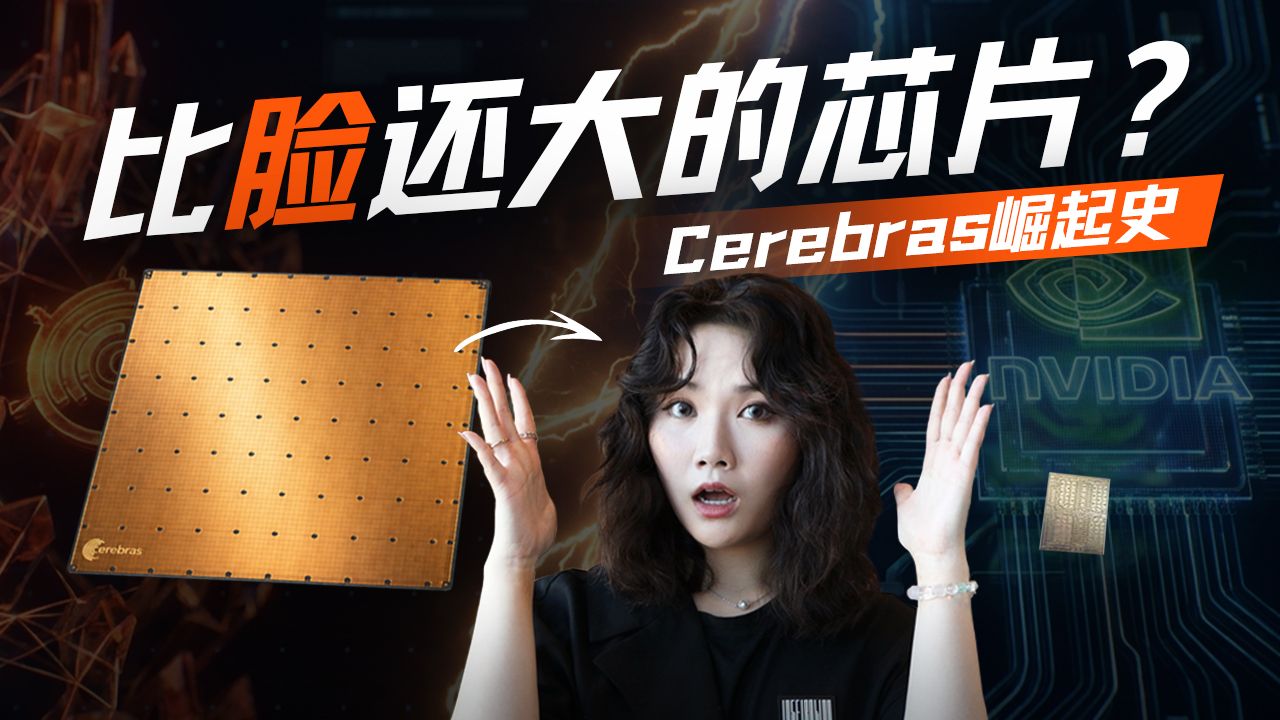
[0:00] 十年前这是一家没人看好的公司。从成立第一天,他就只想做一种从来没有被造出来过的芯片。他试图挑战英伟达的霸主地位,却在成立之初屡屡碰壁,多次濒临倒闭。十年磨一剑,今年5月他终于上市了,市值一度接近千亿美元。CEO说我们愿意和每一家Hyperscaler合作。提升AI推理速度除了英伟达我们有新采访了3brush的早期投资人和最早证明3brush产品可以落地的研究人员我们还和3brush内部负责产品的高管讨论了近两年来3brush的转型和IPO之后的动作那穿起这些蛛丝马迹之后啊 我自己呢也很惊讶地发现要理解Cerebus上市的辉煌我们需要回到十年前回到一块白板一个快要倒闭的创业公司一段几乎没有人相信的物理学杜居还有一个拥有当时全球最大语言模型的AI实验室如何在一个不可能的时间节点成为了这个故事里最关键的那一页这是Cerebus的故事2014年,文达离开斯坦福AI实验室,加入百度。受到Google Brink启发,百度投入了3亿美元,成立了位于硅谷的AI实验室。他们最主要的目的是,让深度学习发挥商业价值。而对于当时的互联网公司来说,这大部分都是物理层面的应用。自动驾驶,机器人,语音识别。to roadmap to deep learningbecause AI is finally workingit was originally demonstrated forvision, like image recognitionbut then after Andrew moved over toBidu, we were looking at this and sayinglet's do something that has product impactlet's do something that people would actually usethat's why we were starting with speech因为讲语有更多用户比像画面搜索的用户。这是Greg De Amos,他在独家采访当中告诉我们硅谷101,吴恩达当时为百度带去了一批顶尖的AI研究员,而Greg就是其中之一。在此之前,Greg在英伟达做了多年的Kuda软件架构,而当年的Kuda还是一个无人问津的内部项目。当时,Kuda是个玩笑,没有人用它。端到端的语音识别模型允许人们点击麦克风标志对搜索引擎说话他们还训练了世界上最初的几个深度神经网络下一步的计划是训练语言模型我们在用语言和测试的模式和测试的模式。我们有最大的Cuda的Cuda系统。在世界上的世界上,基本上那是很蠢蜜百度团队研究的语言模型在当年是全球最大的,拥有三亿参数,训练这个模型需要三个月的时间。在这个过程中,他们发现了一个规律,模型越大,数据越多,算力越强,模型就越聪明。而这个提升是可以预测的,是线性的,这个规律被称为scaling law。在几年后,这个经过验证的结果被百度团队发表在了一篇论文里,叫做Deep Learning Scaling is Predictable Empirically.优优独播剧场——YoYo Television Series ExclusiveDaryl Moday后来将这个发现带去了OpenAI,成为了GPT的核心逻辑。 sometimes the way I thought of it when I first saw it was it's a recipe for intelligence. I can't believe there's a recipe for intelligence. Like imagine you saw that. Like, you know, I was raised in the era of computer science, you know, requires a lot of work. You know, all the games are hard won. Certain problems are just off limits, like things related to intelligence.语言,语言,语言, were really, really difficult.这个是一样它就活了,它是很简单但问题也随之而来如果Skilling Law是对的那么要训练将来真正有用的模型所需要的算力将是现有的GPU集群完全无法提供的量级百度的研究员们意识到他们需要一种新的硬件在百度团队发现Scaling Law的同一年,有五位硅谷工程师决定离开AMD。在此之前,他们在一家叫做C-Micro的微服务器公司共事,2012年被AMD以3.34亿美元收购。这五个人的名字是Andrew Fultman,Gary Lauterbach,Michael James,Shan Lee,JP Fricker。其中Andrew和Gary是C-Micro的联创。写下了他们的愿望他们希望硅谷的计算机历史博物馆有一天
[5:00] 会出现他们的名字从第一天起Cerebus的目标就是造一个为AI而生的硬件在2015年,和鞠躬的,和鞠躬,和鞠躬,和鞠躬,和鞠躬,他们看到的上海的影响那么是有新问题的问题, 让它们的AI上问,从中的核心中the processor would be different.我们来说我们可以建立一个更好的机器 for that problem我们知道最初的AI训练靠CPU和GPU搭配CPU是总指挥负责调度任务GPU则像一座巨大的工厂里面有成千上万个小工位可以进行大规模并行计算但AI训练远不止一次计算参数、梯度、激活值全得在显存缓存计算单元和GPU间来回倒腾一旦模型大到单卡塞不下就得切成几块分给多卡让它们互相配合所以真正拖慢AI的很多时候是数据在不同芯片不同内存不同机器之间来回移动的过程许多芯片公司解决这个问题的思路是把GPU拼成一个集群再花大量工程解决他们之间怎么沟通的问题多的计算单元内存和互联放在一整片晶圆上成为晶圆级引擎普通芯片的制造是在一张晶圆上同时印出几百个小芯片然后切开一块一块单独使用但3Brush是把整张晶圆做成一个巨大的AI处理器这片晶圆的面积是最大GPU的58倍很多原本需要跨GPU跨服务器跨网络完成的数据移动现在都可以在晶圆内部完成 whereas with a traditional GPU architecture, you would have HBM, which is kept separate,你能把你做的任何时间有需要交换中的记忆和记忆体会很久它叫做MemoryBandwidth2016年3月,Cerebras正式成立,由Benchmark领头Ceries A融资2700万美元。说到这里我们不得不感叹Android的原件在2015年底Cerebus决定压住晶圆机引擎的时候Transformer架构甚至都还没有出现而今天这套以大模型为核心的AI产业也还远远没有成精当时深度学习当然已经在爆发因为达也已经开始把GPU推向数据中心和神经网络训练但主流路线仍然是把GPU拼成越来越大的集群Cerebrus的不同之处在于他从一开始就问了一个更加底层的问题如果AI会成为一种全新的计算负载那能不能为他重新设计一台机器呢有投资人回忆2015年底与Andrew见面的时候发现他当时有ES Lite列出了深度学习面临的七个核心问题而这些问题本质上都指向同一件事训练时间太长这也是上一章结尾我们提到的这是投资人周南,2016年他加入百度AI实验室成为了Greg的同事他的第一个人物就是寻找一种为深度学习打造的计算方案as an investor the task i was assigned by the researchers were to find a very powerful ai compute other than nvidia because they predict that in five to ten years actually more i guess realistically probably in ten years there will be a very big model coming out larger than 500 parameter model and it will be like a wikipedia type of model they all say okay we need a differentto make sure that the model can scale, can iterate faster, because GPU back then was not the optimized structure for deep learning.其实那个时候啊挑战通用GPU的尝试呢还不少谷歌呢已经在内部使用TPU这是一种所谓的ASIC是专门为了积蓄学习力的矩阵计算而设计的英特尔收购了深度学习硬件创业公司Nirvana英国的Graphcore在做IPUGrock HibanaSambanova这些硬件公司呢基本都是在这个阶段成立的他们沿着不同的方向
[10:00] 想试图重新设计AI芯片Cerebrus的方案在这之中是最激进的那是一种的那种的那种是这些建筑的能够活吗能够活动的建筑能够活动吗所以这个想法很奇怪但是整个人的工作我重新的工作了我变成了一个很科学的工作但是第一个人的理想是所以我们把这些危险断了很多小部分的问题。成功呢在芯片行业Tapot意味着把设计交给工厂生产一次失败就可能意味着几千万美元的额外成本和几个月的时间损失第三如果晶圆上有一部分区域坏掉系统能不能识别绕开并且继续运行呢第四,真实的AI工作负载能不能被编译器映射到这样一套全新的架构上?第五,它能不能接入客户已经在使用的机器学习框架,而不是要求所有人从零开始重写代码?竞调过程当中的一个关键转折点是在Greg见到Cerebrus团队之后。其实在Scating Law的初步发现以后,Greg已经建了大概20多家大大小小的做芯片的初创公司。小意基本上就是说我们要做比英伟达更好的GPU一开始Corebus对他来说也是这20多家当中平平无奇的一家直到有一天Greg来到了Corebus的办公室我一旦就在社会上的工作室然后他有这个研究竟的研究竟说:「我发现了解更多的 processors」他有很多工程,他们带出这些大工程,抓住一人那一刻他意识到Cerebrus不是一个山寨版的英伟达他们在做一件完全不同的事情那就是造一块大到前所未有的芯片如果Cerebrus真的能造出来这样一块芯片就会解决百度团队的核心问题速度周南告诉我们团队将Cerebrus的编辑器接入了百度字眼的三亿参数语言模型在Cerebrus的模拟器上跑了一遍测试得到了不错的结果要知道当时Cerebrus还没有真正出货的产品他们只有一张实验室里的晶圆模型和一台模拟器四周后周南得出了他的结论是的,这个建筑会有效其他的技术风险当然依旧存在,但周南认为他们都是可以被解决的。在这里我们可以展开讲讲Cerebus是如何解决良率这个问题的在台积电5纳米工艺下每平方毫米大约会出现0.001个缺陷听起来很小是吧但Cerebrus的WSE3芯片面积是46225平方毫米算一下这样一来在一整片晶圆上就大约会有46个缺陷在一块传统芯片上如果没有容错设计这46个缺陷里任何一个都足以让整块芯片报废Cerebrus的解法包括两个设计第一把核心做到极小传统GPU的一个计算核心特别大因为达H100的一个SM核心大约6平方毫米一旦缺陷落在上面
[15:00] 这6平方毫米就全废了而Cerebrus把每个核心缩小到了0.05平方毫米大约是H100核心的1%这意味着同样一个缺陷砸在H100上要损失6平方毫米但砸在Cerebrus上只会损失0.05平方毫米仅仅是把核心做小这一点就让3Brush的芯片在面对缺陷时的容错能力是传统GPU的百倍量级第二招是冗余加智能路由Cerebrus在整片晶圆上多放了大约1%到1.5%的备用核心平时这些核心是关闭的闲置着芯片上还内置了一套可以动态重新配置的片上网络制造测试阶段,系统可以识别哪些区域有缺陷,然后把这些坏掉的核心屏蔽掉,通过片上网络绕开它们,把工作负载映射到正常区域。从软件的角度看整片晶圆始终是一块完美无缺的芯片,那46个缺陷被悄悄的隐藏掉了。这个思路其实不是Cerebra自己发明的,内存芯片厂商和GPU厂商几十年来都在用冗余核心来处理缺陷。因为达的H100需要132个核心工作,但芯片上实际造了144个,允许最多12个是坏的。Cerebras真正的创新是把这个冗余的逻辑从一块小芯片放大到了整整一张晶圆的尺度,用几十万个微小核心加成一套能在整片晶圆上动态绕帐的路由网络,把一个70年无解的良品率难题变成了一个可以管理的工程问题。在禁调之后,百度共同领投了Cerebrus的Series C其实在做出投资决定之前,中南还见到了Andrew本人创始人的个人魅力也是说服投资人的重要原因之一。他是一个很好的故事。他很胜,他有这个想法和信心。10年前,我做了这个批评,我已经在4个月份了,我每天都在电话上花了两个时间,问他所有人,每一段时间的事情所以他答应了非常好你能看到他有很重要的研究他知道全面的问题当时Cerebrus的团队有70多名PhD其中大部分人都在Cmicro共事过最后Greg告诉我们就算Cerebrus找不到客户他也相信这个产品是有价值的它是会继续成为NVIDIA,AMD,Intel,甚至他们能找到客户。所以我说,这就是一个重要问题,所以我们来订阅一下,我们来订阅一下,我们来订阅一下。虽然有中南这样的投资人选择相信3brush,但那段时间3brush实际上举步维艰。从2016年成立到2019年中旬,3brush完全隐身,没有产品,没有客户公告,没有新闻稿,这个在外界严厉神秘莫测的硬件公司,内部却一度非常危险。都要汇报同一个坏消息芯片还是不能用三年也就是将近三亿美元都花在一个没人见过的产品上他们要解决的问题呢不只是芯片本身一张晶圆级的芯片功耗高达25000瓦大约是一个普通家庭年用电量的两倍多集中在一块餐盘大小的面积上这意味着他们还需要重新发明散热系统重新设计供电结构重新设计与服务器机架的接口拜拜2019年夏天,3Brush终于让第一代WSE成功量产,并开始正常工作。那天,几位工程师坐在Losotos市中心一间临时搭建的办公室里,盯着电脑屏幕,看着这个过去被认为不可能的系统,真的跑起来,半小时没人说话。2019年8月Cerebrus终于走出了隐身模式他们在Hallships大会上发布了WSE1全球第一款晶元级芯片WSE1的规格在当时看起来近乎荒诞面积超过4.5万平方毫米,是当时最大GPU的56.7倍,40万个AI计算核心,18GB的片上SRAM内存,相比之下因为达同期GPU的片上内存只有几十兆字节。从具体产品上看,Corebus会整体交付一台完整的系统CS1,就是这台冰箱大小的机器,把芯片、散热、供电接口全部整合在一起,查点数据中心的机柜就可以直接使用。
[20:00] 2.72亿美元的一轮融资正式成为独角兽但问题来了,谁会第一个使用它呢?商业AI客户在2019年还没有形成规模,大家也都在使用英伟达,市场上没人看好Cerebrus。我们解决了它。我们遇到这个困难的问题,我们没有人 cared了 nobody it was like you know the first gen we might have sold a dozen the second gen we probably sold 300 and now we're still going to sell tens of thousands in the third gen we had a two or three year period where we were ahead of the market完全没有人意义,我们是连速的。Cerebrus的第一批真正的客户来自于一个意想不到的地方美国能源部旗下的国家实验室阿贡国家实验室用Cerebrus的系统分析新冠病毒的变异序列后来这个实验协助获得了2022年的Gordon Bell特别奖那是高性能计算领域最重要的奖项之一Lawrence Livermore国家实验室用它来跑核聚变模拟国家能源技术实验室测试的结果呢是Cerebra系统比实验室自己的超级计算机快了大约500倍这些客户用真实严肃的科学任务证明了这个技术可以落地2021年WSE2发布升级至7纳米制程计算核心增至85万晶体管数量达到2.6万亿2022年Cerebus用一台CS2在单台机器上训练了参数量高达200亿的模型创下了当时的记录这年美国计算机历史博物馆为Cerebus的WSE2揭幕了一个永久展览题为The Biggest Chip in the World世界上最大的芯片距离2015年五位创始人在白板上立下那个想要被写进计算机算力历史的目标过去了整整七年2021年11月Cerebrus完成Series F融资估值40亿美元2026年5月Cerebrus IPO估值950亿美元5年间估值涨了将近25倍其中一半的功劳都归功于一个客户他在三年时间里把Cerebrus从一家只有政府实验室客户的公司也但也是这个客户让Cerebrus的第一次上市计划彻底泡汤G42是阿布扎比的一家AI科技集团,与阿联酋政府深度关联,同时是微软的战略合作伙伴。2023年,G42和Cerebrus宣布了一个名为Counter Galaxy的合作,基于Cerebrus的系统建造一个大规模超算网络,最大的一台超级计算机算力达到4个Exaflops,合同规模超过10亿美元。其实我自己也是通过这个项目认识Cerebras的2023年的夏天是我接触科技报道的第一年在3Bus位于Santa Clara的数据中心里我亲眼见到了这台6.5英尺高的超级计算机它在白色的机箱里有序的运作着平静的白噪音闪烁的蓝光对我来说也是一个十分难忘的场景Android当时告诉我建造这台以WSC为内核的超级计算机只花了十天Cerebrus和G42的合作是于2021年,通过Condor Galaxy G42想做一个阿拉伯语版的Chad GPT技术确认性不足,作为DCTEK hardware company,你真的需要一个大客人,能够充施的系统,赚钱真正的钱,建设到技术的技术。所以G42给Cerebras那样。我觉得这帮助Cerebras帮助Cerebras真正的货币。这是非常重要的。870万美元,G42占比超过83%。2024年上半年,G42的占比进一步升至87%。直到2024年9月,Cerebus向纳斯达克提交了S1招股书准备上市美国外国投资委员会CIFIUS在看到3BUS的大批营收来自阿联酋客户G42之后,几乎立即启动了国家安全审查。最后3BUS在无法获得CIFIUS放行的情况下,主动撤回了S1申请。G42持有的股份被转换为无投票权股份,双方关系重新定性。最终CIFIUS在2025年3月31日正式给Cerebus上市放行虽然撤回了S1,但这段时间的等待并没有白费2025年里Cerebrus完成了两轮大规模私募融资2025年9月的Series G融资11亿美元估值81亿美元2026年
[25:00] 年2月的Series EACH融资10亿美元估值230亿美元在等待上市的这段时间里Cerebrus用私募市场完成了再一轮资本化-end-2025年12月24日的平安夜本应是安静的一天但那一天发生了两件事,改变了整个AI芯片产业的格局第一件事是英伟达和Grog签署合同,达成了200亿美元规模的技术授权和资产交易。Grog是Cerebrus在推理芯片市场最直接的竞争对手,他做的是LPU语言处理单元,专门为固定大小的模型设计,追求极致的确定性和低延迟。我一直在想Groq的感受,因为我一直在想,如果NVIDIA真的想要,他们可以做同样的事。第二件事就是Cerebrus与OpenAI宣布合作。他们签署的合同总价值同样超过200亿美元。OpenAI承诺部署750MW的Cerebrus计算能力,用于OpenAI的推理业务,最大可扩展至2030年的两级瓦。这是全球历史上规模最大的AI推理部署合同大家捋一捋这个时间线Cerebrus是英伟达的挑战者而就在英伟达吃下Grog的同一天OpenAI选择把最大的推理计算合同给了Cerebrus其实这个合作也并不令人惊讶Sam Ultman是Cerebrus最早期的投资人之一而两家公司团队从2017年起就频繁交流他们都相信一点随着模型规模扩大硬件架构和模型需求迟早会会合I think I spoke to Sam in sort of middle of the summer in 25 and he said for the first time we've been trying so hard just to keep up with demand we now see the importance of fast inference that produced a set of trials and some testing that was done and we were so much faster than the competition it felt really good.我们来说我们来说我们来说我们来说我们来说我们现在明白了于是OpenAI和Cerebrus在感恩节前夜签了Termsheet,在四周后的平安夜签了Master Agreement,一个200亿美元以上的交易能在四周内完成其实是很罕见的。这个合同落地的速度也超出了预期。那在讲述OpenAI的合作的时候我们经常提到的一个关键词是推理在最开始几张我们关注的是Scaling Law,是模型的训练,这也是2024年之前Cerebrus和大部分硬件公司都在关注的方向。训练是建造模型,你把海量的数据喂给一个神经网络,让它学会了语言的规律,世界的知识,这是一个巨大的一次性的计算过程。GPU非常适合做训练,是因为矩阵乘法是高度可以并行化的,你可以把几千块GPU连起来同时计算。但训练完成AI被我们用上的时候,发生的就是推理这个过程。那从硬件角度看,推理是一个非常特殊的计算过程。但原模型生成回答的时候不是一次性把整段话吐出来,而是生成第一个词才能知道第二个词该是什么。生成了第二个词才能继续生成第三个词。也就是说推理有很强的串行性。但推理的时候尤其是生成答案的DECOD阶段模型必须沿着时间顺序往前走每生成一个Token都要进行一次模型计算都要在模型权重缓存和计算单元之间搬动大量的数据所以在推理时代关键词是速度模型能不能足够快地读到数据足够快地生成下一个Token这个时候我们才能看到cerebrus的
[30:00] WSE 和 GPU 相比所产生的优势和在辨论中,它是全面对于辨论。所以我们的技术,我们的技术,在辨论中,和辨论中,是在辨论中,是什么能够的很高的辨论,和最高的高效率,高的高效率,辨论中,在辨论中,的辨论中。换句话说,Cerebrus原本想解决的是AI训练过程当中的数据搬运问题,但当AI进入推理时代之后,反而更加的利好Cerebrus。你想想你每次和AI对话调用Agent的时候,是不是希望速度快一点,更快一点。推理也从一个辅助性的需求变成了AI基础设施的核心那我也问了AngelaCerebrus为什么选择从训练市场转而关注AI推理市场呢?所以我们开始在研究中,因为在2016年,,很多公司 were focused上研究的研究。现在,它是不同的。我们有极限的研究,从 OpenAI,从 Anthropik,从很多开放开的研究,从开放开的研究中,那是可以用的研究中,从一个研究中的研究中,我们是非常好的。但我们看到 how quickly the inference market was expanding,比较高的GPU是,我们知道有很好的机会来使用所有的多公司使用 Inference去增加在 ways thatthey weren't able to do before当然啊推理市场的需求呢也改变了3brush的产品形态之前啊就像我们讲的G42这个例子里面3brush卖的是超级计算机但现在呢他开始把自己的硬件能力包装成云服务客户通过API发送请求3brush在后端完成模型推理把结果返还给客户那Angela告诉我们啊他们已经把整个产品做成OpenAI API兼容如果一家公司已经在用OpenAI或者其他的兼容接口整套代码换成3brush的API key就可以把请求送到3brush后端在推理服务上3brush目前平均可以看到每秒超过2000个token的输出速度相比之下很多传统方案可能是每秒200到300个token只要大家用过agent工作流就会知道这样速度的提升会让使用体验大幅优化更有意思的是速度更快的时候也会创造出全新的工作场景这里我们来看几个例子有一家Cerebus的合作伙伴做了这样一个功能,当程序员把鼠标悬停在一段代码上,系统可以立刻显示这段代码在整个项目里被哪些地方调用,依赖关系是什么,那这个功能呢,本质上需要模型快速读懂代码上下文,再生成一个完整的调用图。它就不再像一个查询工具,而更像是IDE里自带的一部分。另一个例子是实施教育想象你需要让AI给你解释一个复杂的概念,AI一边在虚拟黑板上画图一边回答用户的追问,那用户可以直接圈出图上的某一部分,让AI再讲一遍。如果AI要停顿很久这就只是一个普通教学视频加聊天框但是啊如果AI能够立刻回应他就变成了一个真正的老师可以实时对话第三个例子是AI科学家,由Cerebras的合作伙伴在做一个面向药物研发的AI科学家,想象一下在一个新药物研发的会议里,团队正在讨论一个假设,这个AI员工可以在会议进行的同时,实时查找竞争对手研究,检索论文测试假设,然后直接参与讨论。这些都是实际上的经验的经验是否有机会,但他们是否有机会, 但他们是有机会,像是Cerebris。这就是推理时代最重要的变化Agent 直接进入实施交互场景代码教育科研克服语音助手这些应用的共同点都是互动而互动的本质就在于速度这也解释了为什么3brush会在2026年这个时间点,引来它的IPO窗口。在宣布和OpenAI合作后不久,3brush又在2026年3月宣布与AWS合作。CEO Andrew Feltman在采访中解释了这个合作的逻辑,并且宣布将会和所有的Hyperscaler合作,除了应伟达。"What is the essence of the inference problem?" And it's comprised of two parts. It's comprised of a part called processing the prompt. And then there's a second part, which is generating the answer.所以你 process你发出了解答案 called the first part pre-fill and the second part decode. And it turns out they have some very different
[35:00] ...compute characteristics. And so we thought to ourselves that there are machines that are better than us. at this pre-fill. It is a paralyzable problem. It has fundamentally different characteristics. than the decode, which is a strictly sequential problem. And so we took this observation and we went to AWS and said, we can use your tranium part. to do the pre-fill, and we'll use our big chip to do the decode, and what we will get is this extraordinary solution. And it turned out to be really well-received, and we're now engaged in that process of using other people's part for part of the problem and our part for another part of the problem, sort of with all members of the community. Other hyperscalers? That aren't the... that aren't in video. So everybody but them. - Thanks. We will continue to talk about Cerebrus IPO's story before, I want to take a minute to explain Cerebrus the 10 years of the product. The first product is the "芯片". In 2019, Cerebrus released the first of the first-time晶圆-Gi-inx WSE-1. This is the first one of the first-time晶圆晶晶, the size of the GPU is 56.7x. But we said that Cerebrus is not a machine that is a machine. This is Cerebrus's second product, the system. WSE1 was installed in CS1 system. It's a device that can be put in the information in the AI-based计算机. 2021 Cerebrus released the second WSE2. In 2012, Cerebrus used 16-台 CS2 to be installed in Andromeda's super-sized计算机. The 1350,000,000 AI-based核心,超过 1 EXAFLOP AI-based AI-based计算力, 耗500,000W,远低于同级别的 GPU-based. This shows the many-dimensional systems can be built in the way of the GPU-based system. This shows the ability to build a new system, which is a new system that can be built in the current system. 2024年3brush发布第三代WSE3,这是当时最大GPU H100的57倍。 这就是3brush的前三层产品:芯片系统和超级计算机集群。 最后一层就是我们上一章的时候提到的云端推理业务了。 In 2024, Cerebrus was released in Cerebrus Inference. The client didn't buy a CS system, but the API was directly used to use the service. Since this, Cerebrus has become a company of a company, and has become a company of a company. In the 4th of September, Cerebrus has again introduced S1. On the 5th of September, it is now on the 5th of September. And I remember that the day before IPO, The pricing per share, according to Banker, is around $120 to $160-ish per share. And I was like, wow, $160. That's already kind of over 25x of the return compared to the CBC price. I was like, oh, this is already a big home run. But on the IPO day, when I was just sitting behind the NASDAQ trading desk, I saw that number just going up. faster. From $200 per share to $300 per share to $380 per share, I was like, wow, this is the craziest IP demand I've ever witnessed in my entire career. The IPO is about taking this to the next level and really allowing us to scale. In order for us to grow with how fast the market is growing, we have huge investments to make in our data centers, in our manufacturing, in our product roadmap, and of course, in our entire software stack in order to make this product everything that it is. 但可想而知,上市并不是Cerebrus故事的终点。上市后,Cerebrus其实面临着更多的挑战。 First, let's look at the supply chain. The entire product of Cerebus is the entire product of the OpenAI promise. It is all built in the 5nmAh. The Cerebus is the only one in the world's 3nmAh. 那么3BUS在未来能拿到多少市场份额,会不会取决于它能在台积电拿到多少产能呢? Andrew在Outlaws博客上没有直接回答这个问题,他承认台积电当然是3BUS供应链里极其重要的一环,但他也说到3BUS有几个意外的优势,比如说它避开了当下AI芯片行业最紧张的三个供应瓶颈, is.
[40:00] 这三个竞争激烈的供应链瓶颈Cerebrus的产品都用不到第二是激烈的竞争格局英伟达现在和Grog合作有了自己的推理优化技术Broadcom在帮各大云厂商设计定制ASIC谷歌的TPU亚马逊的Trainium都在做推理一批新的推理芯片创业公司也正在融资对此呢Angela是这样回答我们的I feel very confident about Cerebrus' outlook because of our full stack capabilities that I've mentioned and our ability to innovate at every level, no matter what's needed, in order to continue to meet the market where it's going.由竞争带来的第三个风险,是重要客户OpenAI充满变数的战略走向。就在6月,OpenAI和Broadcom发布了OpenAI的第一颗字眼推理芯片Halapeno,这是一个专门为语言模型推理设计的ASIC,也就是专用芯片。那OpenAI说Halapeno是它长期全战AI基础设施策略的一部分,首例当然这并不意味着OpenAI会立刻放弃Cerebus因为OpenAI的算力需求太大了,但3Bus必须证明,它能够提供的推理速度是长期并且不可替代的产品。6月24日Cerebrus发布了上市后的第一份财报股价下跌15%甚至一度跌破IPO发行价表面上看这份财报并不差第一季度收入甚至高于华尔街预期但Cerebrus给出的第二季度指引中调整后毛利率只有36%到38%低于第一季度的47%也就是说收入增长留下的利润空间正在被压缩对于一家上市公司来说呢市场看到的是一个现实问题包括数据中心电力冷却等在内的成本会不会吃掉技术优势对此Andrew是这样回应的去保持 demand,那会有一个优优优独播剧场的创业,10或15点。但市场会不会买单就是另一回事了。那投资人对于Cerebrus长期稳定盈利的关注呢,其实也是这个故事最有意思的地方。他不是一个英伟达挑战者上市的爽文Cerebras的一波三折其实在很大程度上是对AI时代基础设施需求变迁的回应当我们对模型的需求从规模变成推理从能力变成速度我们到底需要什么样的计算机呢英伟达的答案是GPU集群OpenAI在字研ASICGroC选择了LPU而Cerebras给出的答案是一整片晶圆十年前它是硅谷疯子而今天这个餐盘一样大小的芯片就在数据中心里面服务着一系列重要的客户这个曾经的科幻电影变成了可以登陆纳斯达克的现实,真实到资本市场开始用毛利率来审判它,这或许才是一个硬科技公司真正进入主流世界的时刻。好了,以上就是3Bus崛起的故事,我是硅谷101的一文,大家不要忘记关注我们,不要错过来自硅谷的一线分享。大家的点赞转发和留言是我们做好深度科技和商业内容的最佳动力,那我们就下期再见啦。拜拜拜拜