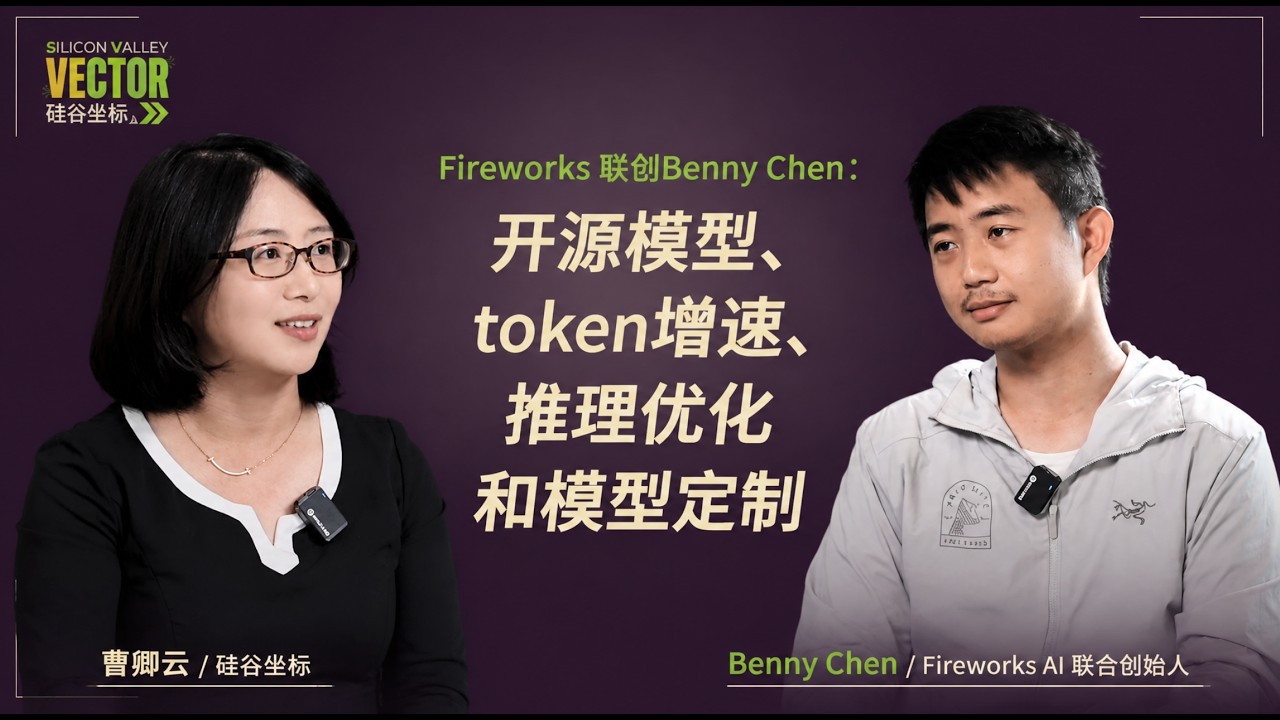
Fireworks陈宇飞:开源模型日消耗达50万亿Token 超越OpenAI与谷歌API
Silicon Valley Vector 硅谷坐标
开源模型追平闭源将削弱前沿实验室的议价能力,并将AI产业价值加速向底层基础设施层转移。
AI-assisted summary of Silicon Valley Coordinates x Fireworks Co-founder Benny Chen: Open-Source Models, Token Growth, I... — original source. Check the original for full context.
Source published:
Detailed notes
## Background 本内容由 YouTube 频道《硅谷坐标 Silicon Valley Vector》于 2026 年 8 月 15 日发布。根据页面介绍,本期节目为主持人曹卿云与刚完成新一轮融资、估值达 17.5 亿美元的 Fireworks 联合创始人 Benny Chen(陈宇飞)的深度对话,探讨了开源模型、token 增速、推理优化以及企业定制模型等前沿议题。
## TL;DR 对谈深入探讨了开源与闭源大模型的终局格局,认为开源模型正凭借极高性价比在企业级应用端快速追赶,其每日 Token 消耗量已突破 40 至 50 万亿。针对企业落地,Benny 指出缺乏严谨的 Eval(评估体系)是 PoC 无法走向生产环境的核心瓶颈,并详述了 Fireworks 依靠“推理优化”与“模型定制”两门生意的技术壁垒与商业模式。此外,对话还解析了闭源厂商的 ARR 真实增速、大厂 AI 资本支出(CapEx)的反向算账逻辑以及算力供给等关键挑战。
## Atmosphere & style 整场对话气氛理性、务实且充满极客硬核干货。主持人与嘉宾之间的互动节奏明快,Benny 结合其在 Meta 的工程背景与 Fireworks 的一线创业洞察,以极具说服力的真实数据和行业隐喻(如将开源闭源比作安卓与苹果)拆解复杂的技术与商业博弈。听众不仅能感受到来自硅谷前沿技术浪潮的蓬勃活力,也能体会到面对算力瓶颈与大厂竞争时,创业者冷静清醒的战略定力。
## Key takeaways - [00:00](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=0s) 开源模型追赶速度超预期,未来商业格局呈现“闭源似苹果拿走高利润,开源似安卓占据巨大底座流量”的分化态势。 - [03:00](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=180s) 开源并不完全依赖闭源蒸馏,随着评估集数据量扩大和获取成本下降,开源自身亦能实现持续演进。 - [07:00](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=420s) 评估闭源 Lab 的 ARR 需注意其实际记账方式与云厂商分成,未来随着云厂分成增加,闭源 Lab 的实际 GAAP 收入可能不如账面亮眼。 - [07:55](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=475s) 垂直类 AI SaaS 的核心竞争力在于精细化评估与特定场景积累,通用前沿模型全盘覆盖的 ROI 极低。 - [10:18](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=618s) Fireworks 平台日均处理开源 Token 达 40-50 万亿,规模已超部分主流闭源厂商的 B2B API 消耗量。 - [10:18](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=618s) Coding 与 Deep Research 是当前最大的 Token 消耗赛道,且多数垂直领域的业务逻辑本质上正被转化为编程与 RL 训练框架。 - [16:40](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=1000s) 北美市场对中国优质开源模型(如 Kimi、GLM、DeepSeek、Qwen 等)接受度极高,呈现明显的模型轮换与流量转移效应。 - [24:11](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=1451s) 企业从概念验证(PoC)走向实际生产的主要瓶颈在于缺乏严谨的 Eval(评估体系),导致大量的效果判断仍停留在粗糙的感觉阶段。 - [27:00](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=1620s) 推理优化属于劳动密集型工作,通过多模型路由(前沿模型作为执行者 + 开源模型作为建议者)能在降低成本的同时提升任务完成度。 - [30:50](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=1850s) 硬件优化的本质在于算力与内存带宽的比例能否吸引开发者和模型端进行深度适配与过拟合,而非单一硬件指标。 - [34:52](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=2092s) 定制 RL(强化学习)训练耗时耗钱的关键在于环境稳定性与消除奖励黑客行为,实操中只需要上千个高质量环境即可派生出海量评估数据。 - [36:20](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=2180s) Fireworks 采用“二房东”定位与推理流量分成的商业模式,不盲目持有重资产 GPU,而是将平台收益与客户模型上线后的真实流量深度绑定。 - [40:29](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=2429s) 即便未来的 AI 能够实现自动化自我改进(RSI),实验室内的算法也无法凭空感知真实企业场景与客户需求,这依然是垂直领域的防线。 - [41:39](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=2499s) 科技巨头加大 AI 资本支出(CapEx)的核心动力是防范错失浪潮的生存危机(ROC),而非短期 ROI;开源追平削弱了模型层溢价,反而对底层 Infra 基础设施形成利好。
## Detailed walkthrough ### [00:00](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=0s) 开源 vs 闭源的终局格局与“蒸馏”争议
对谈在对开源与闭源大模型未来格局的判断中展开。Benny Chen 指出,Fireworks 团队绝大多数成员来自 Meta,有着深厚的开源软件基因(如开发或使用 PyTorch),因此天然相信开源最终会在重要的软件层追赶上来,正如过去操作系统和数据库的历史演变一样。虽然他一直坚信开源会 Catch up,但今年开源模型的演进速度依然远超预期(例如 DeepSeek V3/R1 系列、Kimi k1.5、GLM-4、Qwen 2.5、Muse 以及 Meta 计划开源的 Spark 等),性价比极高。对于闭源厂商而言,尽管短期内营收增长迅猛,但开源的逼近速度极快。
谈及许多开源模型依靠对闭源 SOTA 模型进行“蒸馏”(Distillation)来保持领先的现象,Benny 认为蒸馏并不是长期可持续的路径。闭源厂商之前被抽离出思考过程(Thinking tokens)主要是由于 API 端安全防护有漏洞,但这些技术漏洞很容易被修复。不过,开源的成功并不完全依赖蒸馏,只要开源社区拥有足够大的 Evaluation(评估集)数据量、清晰的数据清洗流程以及逐渐下降的数据获取成本,不靠蒸馏也能做出极佳的模型。从商业心理来看,闭源厂商可能会像苹果(Apple)手机一样,凭借用户心智(“No one gets fired for buying IBM”)和高端品牌溢价锁住对价格不敏感的大客户并拿走行业大部分利润;而开源模型则会像安卓(Android)一样占据绝大多数的实际运行量(Run rate),两者并不冲突。
- **团队背景**:Fireworks 核心团队多出自 Meta,具备 PyTorch 等深度开源软件背景。 - **提及开源模型**:Kimi 3、DeepSeek V4 Flash、Muse、Meta Spark、Nemotron 等。 - **开源 vs 闭源隐喻**:闭源类似 Apple/IBM,拿走高利润与不敏感客户;开源类似 Android,占据巨大的底座 Token 消耗量。
---
[00:07](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=7s) 闭源 SOTA 模型的 ARR 增速与法律垂类 SaaS 的 Alpha
讨论转入闭源 SOTA 厂商(如 OpenAI、Anthropic)的 ARR(年度可重复订阅收入)增速及其话语权。Benny 提醒,分析闭源厂商的 ARR 时需要关注其记账方式(Accounting)与下游云厂商的分成(Revenue Share)。很多闭源 Lab 宣传的 ARR 可能是 100% 的 Gross Revenue,但未来给云厂商的分成比例可能会越来越大,导致实际的 GAAP Revenue 并没有账面 ARR 看起来那么夸张。上市后闭源厂商在分成上的话语权可能会削弱。
在垂直类模型(Vertical Specific Agent)与通用 SOTA 模型的竞争上,Benny 坚定站在垂直类这一边。像 Harvey 这样的法律 Agent,或者 Doximity(北美最大的医师 AI 助手)以及 Hidi(北美以外最大的 Medical Scribe/Search 公司),都在 Fireworks 平台上训练和 Fine-tune 自己的领域专属模型。将一个垂直领域做深做透需要极其巨大的测试量和极其精细的 Evaluation(评估),前沿实验室(Frontier Labs)如果试图把所有细分行业都做一遍,成本极高且 ROI(投资回报率)极低。每个垂直领域的细化工作和特定评估标准,正是这些 Vertical SaaS 公司的 Alpha 所在。
- **Harvey**:知名法律 AI Agent,基于平台做精细化 Evaluation 与定制。 - **Doximity**:北美最大医生用 ChatGPT 竞品,主打 Deep Research 确保医疗 Reference 无误。 - **Hidi**:北美以外最大的 Medical Scribe 与医疗搜索公司,在 Fireworks 平台上频繁 Finetune。
---
[00:10](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=10s) Fireworks 平台的 Token 流量流向与应用赛道拆解
谈及 Fireworks 自身的业务体量,Benny 透露了最新完成融资时的公开数据:Fireworks 平台每天处理的开源模型 Token 消耗量已达 40 到 50 万亿(40-50 T tokens/day)。这一数据已经超过了 Gemini 和 OpenAI 公开的 B2B API Token 消耗量,证明开源模型在企业级应用端的落地规模极为庞大。
至于平台上的 Token 流向,最大的应用赛道是 **Coding(编程)**,其次是 **Deep Research(深度研究)** 和 **Medical(医疗)**、**Co-work(协同工作)**。Benny 阐述了一个非常反直觉的现象:几乎所有垂直行业的特定问题,本质上都被转换成了 Coding 问题。例如以往大家认为的 PowerPoint 和 Excel 操作,只要将其转化为调用 API 或工具的编程逻辑,就能直接复用现有的 Coding Agent 工具链和 RL(强化学习)训练框架。
此外,针对未来增长迅猛但当前 Token 消耗尚小的方向,Benny 特别提到了文科生需求与 Co-work 场景(如 Slide 生成、文档写作、Video Gen 等)。许多工程人员倾向于把数学榜单刷得很高,但真正服务广大非技术人员的重文本(Text-heavy)与多模态需求才是巨大的潜在市场。同时,他提到一年半前的 Computer Use Agent 概念目前相对收窄,绝大多数工作出于成本(Cut cost)考虑又回归到了纯文本模式,但随着视觉语言模型(VLM)价格的进一步便宜,Computer Use 依旧很有前景。
- **Token 消耗量**:Fireworks 达到 40~50 T tokens/日,超过 Gemini 和 OpenAI 的 B2B API 总量。 - **核心赛道分类**:Coding 与 Deep Research 占据绝对大头,绝大部分垂直 SaaS 被重新定义为 Coding/RL 靶子。 - **财务数据对比**:Fireworks 营收从去年 1,000 万美元(10M)增长至 1 亿美元(100M/1B 语境),而 Anthropic 的 Revenue 已达数十亿美元规模(~70B 语境描述)。
---
[00:16](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=16s) 北美客户开源模型偏好与 Coding 的渗透率
在开源模型的选择偏好上,北美客户对于中国出海或开源的模型表现出极高的接受度。Benny 指出,国内的几家头部厂商——**Kimi (Moonshot)**、**GLM (智谱)**、**MiniMax**、**DeepSeek** 以及 **Qwen (通义千问)**(按 2026 年 8 月当下节点,Kimi 的流量相对最大)几乎轮流占据榜首。这主要取决于谁刚刚发布(Launch)了最新的模型,新模型上线就会带走一波流量,呈现明显的轮换效应。北美本土方面,Meta 的 Llama/Muse 系列、Google 的 Gemma 以及 Snowflake 的 Nemotron 也占据一定份额。
关于 Coding 在企业端的渗透率,Benny 坦言目前整体渗透率仍然偏低。尽管 Twitter 等社交平台上充斥着“开源模型配合 OpenCode 永远用不完”的段子,但实际上 Claude Code 和 OpenAI Codex 等闭源商业产品的 ARR 依然远高于开源模型。针对这个市场,Fireworks 推出了 Fireworks Nexus 方案,希望通过 Go-to-Market(GTM)推行将开源 Coding 模型带入更多企业内部。
- **北美热门开源模型**:中国开源五强(Kimi、GLM、MiniMax、DeepSeek、Qwen)+ 北美开源(Nemotron、Gemma、Llama/Muse)。 - **市场现状**:Coding 渗透率尚在早期,闭源商业 Coding 工具的 Revenue 仍然显著高于开源模型。
---
[00:18](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=18s) 专属模型洗牌机制与企业开源/闭源选型权衡
当新的强力开源模型上线时,平台上客户之前 Fine-tune 的模型是否会被洗掉?Benny 分析称,去年(2025年)确实有很多客户的微调模型被新上线的基座模型洗掉了,但今年(2026年)被洗掉的越来越少,这是一个非常积极的信号。因为垂直领域 Agent 的目标是把特定业务场景做好,与前沿实验室(Frontier Labs)去攻克“黎曼猜想”或研发新药的交错智能(Jagged Intelligence)方向截然不同。
企业在权衡开源与闭源时,核心考量因素是**信任**(Trust)以及整个 Ecosystem 能否持续支持未来一两年的业务发展。由于开源公司在市场声量(Mineshare)和 GTM 能力上远弱于 OpenAI 等闭源巨头,客户往往需要更长期的沟通。对于部署方式(本地部署 vs 云端部署),目前趋势明显向云端倾斜。因为绝大多数企业无法单独让租用的 GPU 达到饱和(Saturate),而云端的**多租户架构(Multi-Tenancy)**通过聚合需求(Aggregate demand),能为企业带来极高的性价比和 ROI。
- **Jagged Intelligence(交错智能)**:垂直 Agent 专注于特定业务场景的深度优化,不追求全能的 AGI 通用能力。 - **云端部署优势**:Multi-Tenancy 提高 GPU 利用率,降低企业整体运行成本。
---
[00:00](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=0s) 从 PoC 到生产的关键瓶颈:被严重低估的 Eval
谈及企业 AI 项目从概念验证(PoC)走向实际生产(Production)的失败原因,Benny 斩钉截铁地指出:**Eval(评估体系)不清晰**是最大的罪魁祸首。尽管到了 2026 年,依然有大量的企业和工程师在靠“Vibe Check”(感觉好不好)来评估模型效果,哪怕这个项目已经占据了公司很大的 Cost Center。
Benny 强调,现在市场上能做好 Eval 的人才极其匮乏。“很多工程师还担心自己会失业,实际上能做 Eval 的人少之又少。”如果工程师能够帮老板把 Eval 体系建立完善,证明从闭源模型切到开源定制模型能节省数倍的成本,省下来的钱甚至足够支付“三五倍的工资”。未来的 SaaS 公司与传统 SaaS 公司的核心差异,不再是跑通传统的 Unit Test,而是积累并沉淀针对 Agent 的精细化 Eval 数据集。
- **痛点**:缺乏严谨的 Eval 导致大量 PoC 无法落地,或过度依赖昂贵闭源 API。 - **职业建议**:工程师应积极转型做 Eval,这是帮企业完成开源降本增效的核心能力。
---
[00:27](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=27s) 生意一:推理优化的深水区与硬件无量纲数
详细拆解 Fireworks 的第一门核心生意——**推理优化(Inference Optimization)**。Benny 表示,推理优化是一项非常极客且**劳动密集(Labor Intensive)**的工作。模型刚上线时的性能表现与经过一年极化优化后的表现天差地别。优化的重点方向包括: 1. **缩短上线极致优化的周期**:确保新模型一发布就能达到最高性能。 2. **上下文缓存(KV Cache Optimization)**:优化底层的 Supporting Infrastructure 以极致提升缓存命中率。 3. **针对特殊 Workload Pattern 优化**:相较于厂商只需 serve 单一 Base Model,Fireworks 需要 serve 海量的 Customized Model,不同业务流量模式(Traffic Pattern)下的底层优化完全不同。
在与 Harvey 的合作案例中,Fireworks 展示了多模型路由(Routing)与 Harness 编排的威力:前沿模型(如 Claude Opus)作为 Executor,搭配开源模型(如 GLM)作为 Advisor。通过拆解长文本任务,使得前沿模型平均每次任务只需被“请教” 0.83 次,最终任务完成率反而超越了单独使用最强单体模型。
关于硬件配置优化,Benny 引入了一个核心概念——**算力与内存带宽的无量纲数(Ratio of Compute to Memory Bandwidth)**。绝大多数模型在训练之初就是针对英伟达(NVIDIA)或 AMD 的硬件架构 Ratio 进行 overfit(过拟合)的。只要硬件厂商(无论是 ASIC、AMD 还是 Startup)能够提供足够庞大的卡量、完善的软件生态(Ecosystem)以及合理的 Incentive,吸引开发者针对其卡进行 Serving 端的 Overfit,硬件即使 Ratio 奇特也能成功。正如黄仁勋所言,“只要有电,不买英伟达的卡甚至会亏得底儿掉”,因为其极强的变现效率让购卡成本变成了 Cost Neutral。
- **推理路由机制**:Opus (Executor) + GLM (Advisor) 组合,将长文本拆短,平均请教 0.83 次即可实现质量反超。 - **硬件优化本质**:并非单一追求 HBM 或 DRAM 比例,而是生态与算力/带宽 Ratio 能否吸引模型端进行 Overfit。
---
[00:33](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=33s) 生意二:定制模型与 RL 强化学习的打磨
深入探讨 Fireworks 的第二门生意——**定制模型(Customized Models)**。Benny 明确了适合做模型定制的标准界限: - **适合定制**:Vertical SaaS 公司(如 Doximity、Hidi、Harvey),他们面向成千上万的诊所或律所,手握海量精细的 Eval 和真实场景数据。 - **不适合定制**:具体的单个终端企业(单一医院或律所),他们更适合将工作流固化为 Skill、Agent 工具或 Prompt,而不是去 Fine-tune 一个模型。
在企业定制 RL(强化学习)项目中,**最耗时耗钱的部分并非简单的算力,而是环境稳定性(Environment Stability)、数据质量以及防止 Reward Hacking**。在具体数据量需求上,RL 训练其实只需要**上千个高质量环境(Environments)**即可,并不需要天文数字级的数据。因为在 RL 探索过程中,模型会在每个 Step 展开探索(例如生成 128 个 candidate),1000 条环境数据会衍生出 128k 级的实际生成数据,以此教育模型判断对错。模型上线后,随着新基座模型的发布,Fireworks 会协助客户进行快速的 **Rebase(回炉重造)**,只要 Eval 体系是固定的,Rebase 的过程就会非常迅速。
- **RL 数据量需求**:只需要 1,000 个左右高质环境,通过探索扩展可生成 100k+ 级的评价数据。 - **痛点控制**:重点在于监控并消除 Reward Hacking(奖励黑客行为)与确保训练环境的 Stability。
---
[00:36](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=36s) 核心竞争力:与 CSP 云厂的竞合及二房东定位
面对算力重资产公司(如 Nebius、CoreWeave)通过并购软件公司切入推理优化,以及传统云厂商(CSP,如 Azure、AWS、GCP)的夹击,Fireworks 如何维持自身的护城河?Benny 明确表态:Fireworks 绝不会去买重资产 GPU,而是定位为**“二房东”**,专注把软件层(Compute Layer)做深。
Fireworks 与其他厂商的根本区别在于**激励机制(Incentive Alignment)的绑定**: - **NeoCloud / 硬件厂商**:主要卖 Vanilla Base Model,市场竞争极其卷且同质化。 - **咨询公司 / 纯训练框架**:靠收 Training 费用或 Consulting 费用赚钱,客户模型上线后流量大不大与其利益无关。 - **Fireworks**:在 Training 端尽量以极低成本甚至不赚钱的方式帮助客户,真正靠客户模型上线后的 **Inference Traffic(推理流量)分成**赚钱。只有客户的效果好、能赚到钱,Fireworks 才能分到钱。
针对与 CSP 云厂的竞合关系,Benny 透露 Fireworks 与微软 Azure 合作最为紧密,不仅是 Azure 上的 1P 服务(客户可以直接用 Azure Credit 购买 Fireworks 服务),同时也与 AWS 和 GCP 保持合作。Fireworks 的护城河在于提供比 CSP 更好、更完整的 **Developer Lifecycle(开发者全生命周期体验)**,在推理优化的极致性能上始终保持领先。
- **商业模式**:Inference-driven 分成模式,与客户成功(Customer Success)高度绑定。 - **Azure 合作**:作为 Azure 1P 原生服务,支持 Enterprise Credit 直接扣减。
---
[00:40](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=40s) 极终思考:RSI 自动化下的护城河、算力瓶颈与大厂 CapEx 反向算账
如果未来的递归自我改进(Recursive Super Intelligence, RSI)实现了 Kernel 优化、推理优化和 Post-training 的全自动化,Fireworks 的核心竞争力还在吗?Benny 坦然表示,如果 AGI 真能在实验室里把所有活都干好,那所有人确实都没有护城河。但难点在于 **AGI 无法在实验室里凭空猜出真实客户的复杂需求**。理解客户需求、将其转化为具体场景,是 RSI 无法通过自嗨(In-a-lab)获得的能力。
展望未来一两年,Fireworks 面对的最大挑战依然是 **Compute(算力供给)**。如何在市场上以合理的代价获取足够多的算力配额,是决定公司增长上限的关键。
针对当前资本市场对开源模型追平导致的“大厂 AI CapEx(资本支出)ROI 回报率过低、半导体股票回调”的恐慌,Benny 提出了深刻的反向思考: 1. **大厂算账逻辑是 ROC(Missing Out Risk)而非简单 ROI**:对于 Google、Meta 等巨头而言,Over-spend(超前投入)顶多导致这两年账面难看、需要 5 到 10 年去消化资产折旧(Depreciation);但如果因为少投而错过(Miss out)这波 AI 浪潮,则是 **Existential Risk(生存危机)**。 2. **开源追平对 Infrastructure Provider 是巨大利好**:开源模型的崛起削弱了 Model 层(闭源厂商)的议价能力与溢价,在整体 AI 预算不变的前提下,利益必然会向更靠近底层的 Infrastructure 层倾斜。资本市场因为开源追平而打压硬件与 Infra 股票,逻辑上是矛盾且短暂的。
- **核心瓶颈**:未来 1-2 年仍处于严重的 Compute Constraint(算力受限)状态。 - **CapEx 逻辑**:大厂宁可承受折旧压力,也绝不能承担错过 AI 牌桌的毁灭性风险;开源追平本质上极大利好 Infra 基础设施层。
## Notable quotes > [00:00](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=0s) 开源模型则会像安卓(Android)一样占据绝大多数的实际运行量(Run rate)。 — Benny Chen
> [07:00](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=420s) 每个垂直领域的细化工作和特定评估标准,正是这些 Vertical SaaS 公司的 Alpha 所在。 — Benny Chen
> [10:18](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=618s) 几乎所有垂直行业的特定问题,本质上都被转换成了 Coding 问题。 — Benny Chen
> [22:11](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=1331s) 从闭源切到开源定制模型能节省数倍成本,省下来的钱足够支付工程师三五倍的工资。 — Benny Chen
> [30:50](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=1850s) 只要有电,不买英伟达的卡甚至会亏得底儿掉。 — Benny Chen
> [34:52](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=2092s) RL 训练其实只需要上千个高质量环境,并不需要天文数字级的数据。 — Benny Chen
> [36:20](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=2180s) Fireworks 绝不会去买重资产 GPU,而是定位为‘二房东’,专注把软件层做深。 — Benny Chen
> [40:29](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=2429s) AGI 无法在实验室里凭空猜出真实客户的复杂需求。 — Benny Chen
> [41:39](https://www.youtube.com/watch?v=u8MPjmuCkEQ&t=2499s) 大厂宁可承受折旧压力,也绝不能承担错过 AI 牌桌的毁灭性风险。 — Benny Chen
## Mentioned Benny Chen, 陈宇飞, 曹卿云, Fireworks, Fireworks AI, Meta, NVIDIA, Index, TCV, OpenAI, Anthropic, Google, Gemini, Gemma, Microsoft, Azure, AWS, GCP, DeepSeek, DeepSeek V3, DeepSeek R1, DeepSeek V4 Flash, Kimi, Kimi k1.5, Kimi 3, Moonshot, 智谱, GLM, GLM-4, Qwen, Qwen 2.5, MiniMax, Muse, Spark, Meta Spark, Nemotron, Llama, PyTorch, Harvey, Doximity, Hidi, Claude Code, Claude Opus, OpenAI Codex, Fireworks Nexus, Snowflake, Nebius, CoreWeave, Apple, IBM, UCLA
[Source](https://www.youtube.com/watch?v=u8MPjmuCkEQ)