幻方DeepSeek发布极低成本推理模型 引发英伟达大跌并重塑硅谷AI格局
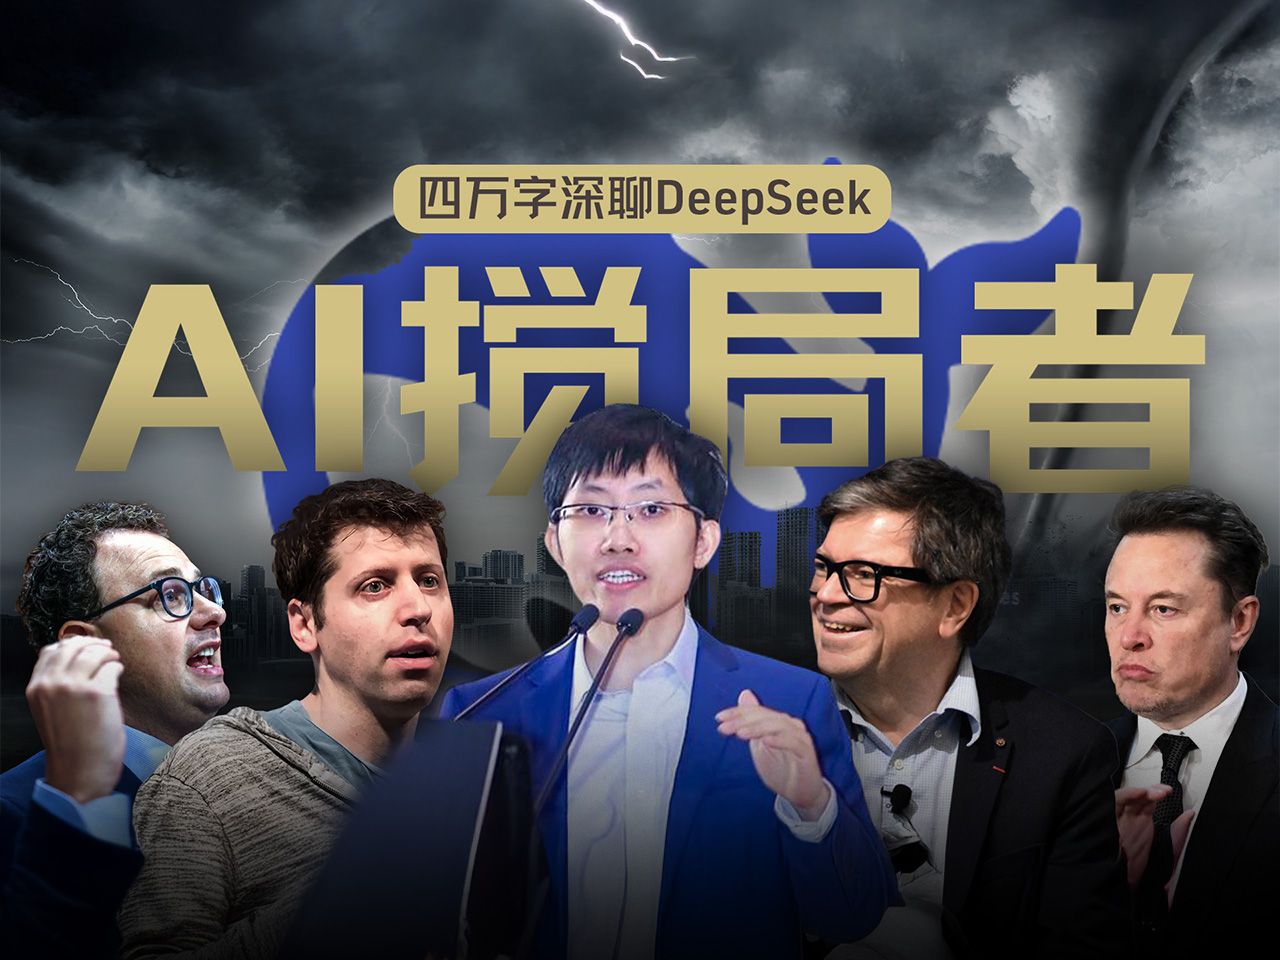
硅谷101
DeepSeek通过极端精细的工程协同与算法优化实现了推理成本的断崖式下跌,正通过颠覆SaaS商业逻辑和CUDA生态壁垒来倒逼全球AI产业链进行利润重构。
AI-assisted summary of 硅谷视角深聊:DeepSeek的颠覆、冲击、争议和误解【硅谷101】 — original source. Check the original for full context.
Source published:
Detailed notes
## Background 该内容由 Bilibili 频道的“硅谷101”于2025年2月11日发布,视频时长超过一个小时。视频简介指出,DeepSeek 以破局者的姿态推出了 V3 和 R1 大模型,在引发全球 AI 界轩然大波的同时也伴随着诸多争议,“硅谷101”团队为此采访了超十位 AI 从业者与投资人,深度探讨其技术创新、成本真相、对开闭源市场的冲击以及背后幻方量化的故事。
## TL;DR 本期节目深度解析了 DeepSeek 凭借 V3 和 R1 模型震撼全球 AI 界的底层逻辑,肯定了其在 MoE 架构、MLA 机制及 GRPO 强化学习算法上的扎实工程创新,并对模型蒸馏和实际研发成本等外界争议进行了理性澄清。内容进一步探讨了这一冲击如何打破英伟达的软件垄断溢价,重塑硅谷巨头竞争格局,以及如何通过断崖式下跌的推理成本为 AI 应用层与端侧 AI 带来颠覆性利好。最后,节目揭秘了母公司幻方量化及创始人梁文峰在业绩回撤与融资受阻的困境下,凭借技术理想主义和本土极客氛围实现极限突围的传奇历程。
## Atmosphere & style 整体基调呈现出一种兼具硅谷前沿敏锐度与理性思辨的深度访谈质感,散发着科技大风暴来临时的紧迫感与兴奋感。叙事风格专业而扎实,通过多位业内嘉宾的观点交锋与生动比喻(如将 MoE 比作餐厅厨师),将复杂的底层代码与宏观的资本市场有机结合。在探寻技术真相的冷静克制中,又隐隐流露出对这支平均年龄仅28岁的本土天才团队纯粹极客精神的敬佩与激赞,情绪弧线从最初面对全球市值蒸发时的震撼,最终落脚于对跨界突围者坚守技术理想主义的温情致敬。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV17fNeeFEwZ?t=0s) DeepSeek 推出 V3、R1 等大模型,以极低成本实现了不输于 OpenAI o1 的推理性能,对大模型发展范式和 GPU 算力市场造成潜在颠覆性冲击。 - [00:00](https://www.bilibili.com/video/BV17fNeeFEwZ?t=0s) DeepSeek V3 沿用并优化了混合专家结构(MoE)的负载均衡以及多头潜在注意力机制(MLA),大幅减少了 KV Cache 占用并提升了运行效率。 - [00:00](https://www.bilibili.com/video/BV17fNeeFEwZ?t=0s) DeepSeek 的工程成功核心在于软硬件工程师极度精细的协同配合,在严格的资源限制下将工程协同做到了极致。 - [09:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=599s) 推理模型 R1-Zero 在训练中采用了 GRPO 算法,去掉了传统 PPO 的“评论家”模块,纯粹借助强化学习在无监督数据下实现了模型的自我推理与反思能力。 - [09:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=599s) 纯强化学习训练出的 R1-Zero 可读性较差,DeepSeek 团队随后引入少量监督微调(SFT)数据进行重新训练,从而诞生了兼顾推理能力与良好可读性的 R1 模型。 - [14:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=899s) 关于 DeepSeek 使用 OpenAI 的 API 数据进行“黑盒蒸馏”以及数据盗窃的指责在业界存在争议,但从法律上坐实侵权极其困难,且 OpenAI 自身也面临双标调侃。 - [14:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=899s) 外界广泛流传的 557 万美元训练成本仅指单次成功训练的硬件租赁理论值,未包含数月试错研发的巨额人力和算力卡支出。 - [14:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=899s) 相比单次训练成本,行业更应关注 DeepSeek 断崖式下跌的推理成本(Inference Cost),其极高的稀疏度使得每次运行仅需激活约 1% 的参数。 - [14:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=899s) DeepSeek 在网络安全方面暴露了关键数据库泄露的漏洞,引发了外界对其作为年轻团队是否有能力服务全球用户的担忧。 - [24:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=1499s) DeepSeek 登顶全球多地应用榜单,逼得 OpenAI 迅速发布 o3-mini 和 Deep Research 进行技术与定价层面的强硬反击。 - [24:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=1499s) DeepSeek 相比 Meta 的 Llama 更加真诚和彻底地开源了顶尖模型和详尽的技术报告,极大地振奋了全球开源社区。 - [34:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=2099s) 一二级市场达成长期共识:算力成本降低会刺激开源社区疯狂复现与应用生态繁荣,长期看依然会推高英伟达 GPU 的总消耗量。 - [44:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=2699s) 媒体报道的“DeepSeek 绕过 CUDA”属于不准确的误读,其本质是在英伟达低级汇编语言 PTX 层做极致的定制化优化,依然属于 CUDA 生态内部的深层探索。 - [48:15](https://www.bilibili.com/video/BV17fNeeFEwZ?t=2895s) DeepSeek 采用的 FP8 策略降低了对英伟达顶级芯片和 CUDA 软件生态的深度绑定,短期利好 AMD 及大厂自研 ASIC/TPU 芯片,将压缩英伟达的垄断溢价。 - [51:50](https://www.bilibili.com/video/BV17fNeeFEwZ?t=3110s) 模型推理成本的暴跌为 AI 应用层带来利润变革,使得 Character AI 等高调用频次的陪伴型 AI 以及高算力黑洞的 AI Agent 走向有利可图的商业化。 - [54:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=3299s) 端侧 AI 小模型的能力飞跃使编辑成本几乎归零,正在颠覆经典的“硬件+订阅”的 SaaS 商业逻辑。 - [54:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=3299s) 大模型效果趋同下,面面俱到的“横向”AI 创业公司正面临资本重新评估,而深耕细分领域、积累独特数据的“纵向”AI 企业更易建立护城河。 - [01:01:30](https://www.bilibili.com/video/BV17fNeeFEwZ?t=3690s) DeepSeek 背靠幻方量化,其创始人梁文峰是一位坚持自研算力平台、即使面临量化业绩回撤和舆论压力也坚决不减少 AI 投入的技术理想主义者。 - [01:07:30](https://www.bilibili.com/video/BV17fNeeFEwZ?t=4050s) DeepSeek 在 2024 年由于开源模式及跨界背景曾遭遇国内 VC 融资冷落,其完全本土起家的天才团队凭借平均 28 岁的极客氛围和对理论最大值的极限追求最终成功。 - [01:13:50](https://www.bilibili.com/video/BV17fNeeFEwZ?t=4430s) DeepSeek 彻底唤醒了硅谷巨头们的紧迫感,严寒昆等业内大牛指出这打破了某些圈子错位的优越感,有力推动了全球 AI 大战的重新盘活。
## Detailed walkthrough 以下是根据您提供的视频转录文本(第一部分)整理的详细、忠实且保留现场质感的深度解读与内容重现:
### [00:00](https://www.bilibili.com/video/BV17fNeeFEwZ?t=0s) DeepSeek 的全球震撼与技术创新共识 2024年12月底,中共幻方量化旗下的人工智能团队发布了拥有6700亿参数的大语言基础模型 DeepSeek V3。紧接着在2025年1月20日,他们开源了基于 V3 的两款推理模型:DeepSeek R1-Lite 和 DeepSeek R1。一周之后,DeepSeek 趁热打铁,推出了开源多模态模型。这一连串的动作震惊了全球 AI 界,其核心在于:DeepSeek 以令人难以置信的极低成本,直接实现了不输于 OpenAI 推理模型 o1 的性能。这代表着对 AI 大模型发展范式的潜在颠覆,不仅直接冲击了 GPU 算力市场,也彻底改变了 AI 初创企业的生态。
在2025年1月底的达沃斯论坛上,媒体长枪短炮聚焦,微软 CEO Satya Nadella 以及 Scale AI 的创始人 Alexandr Wang 的发言直接将 DeepSeek 推到了风口浪尖。他们不得不承认,DeepSeek 是“最主要的智能模型”,其表现甚至优于美国最好的模型。这一舆论发酵直接导致1月27日美股市场中英伟达股价重挫17%,单日蒸发市值5600亿美元,创下美国上市公司单日历史性损失记录。
面对铺天盖地的讨论,硅谷101团队在春节期间组成五人小分队,采访了数十位业内嘉宾,试图从技术、资本、市场等多个维度厘清 DeepSeek 带来的深远影响。尽管产业界对 DeepSeek 仍存在诸多非共识与巨大争议——包括模型蒸馏套壳、数据盗窃指责、成本估算的真实性、算力来源以及安全漏洞等——但硅谷的共识是,这个“又便宜又好”的模型确实有着扎扎实实的工程创新。
为了理清其技术脉络,首先需要区分 DeepSeek 近期发布的三大更新: - **DeepSeek V3**:6700亿参数的大语言基础模型。 - **DeepSeek R1-Lite(R1-Zero)**:使用无监督数据,纯粹借助强化学习(RL)方式在数学和代码等专业问题上微调得到的推理模型。 - **DeepSeek R1**:在 R1-Zero 的基础上,引入带有标签的监督微调(SFT)数据以提高模型综合能力和可读性,最终得到的推理模型。
在基础大模型 V3 的架构上,DeepSeek 延续并优化了其在2024年5月 V2 模型中就已介绍的两项核心架构创新:混合专家结构(MoE)和多头潜在注意力机制(MLA)。DeepSeek 声称 V3 的训练耗时为278.8万个 H800 GPU 小时,若按每 GPU 小时2美元的租赁成本计算,其训练成本总共仅需 557.6 万美元。业内嘉宾指出,V3 的核心亮点完全在于“efficiency”(效率)的提升。
- **MoE 的负载均衡优化**:传统的 MoE 架构在将不同的专家(Expert)分散到不同节点时,容易出现负载不均(load balance)的问题。DeepSeek 在 V3 中对负载均衡进行了极大的优化。 - **MLA 机制**:多头潜在注意力机制(Multi-head Latent Attention)的核心思想是显著减少 KV Cache(键值缓存)的占用,从而大幅度提高架构的运行效率与性能。
为了让非专业读者理解 MoE,硅谷101团队打了个生动的比方:它就像一家餐厅里有一群顶级厨师,每个厨师专攻一道菜。聪明的服务员会根据顾客的点单,动态将任务分配给最擅长的厨师。比如顾客既想吃麻婆豆腐又想吃提拉米苏,服务员就会让川菜师傅和甜点师傅分别去做,而其他厨师可以休息。相比之下,传统架构更像是一个全能型厨师,什么菜都得自己做,消耗的时间和精力自然极高。MoE 通过动态路由机制,每次只激活部分专家,从而在6700亿的总参数中,让 DeepSeek V3 每次运行只需激活370亿参数。
虽然 MoE 并非 DeepSeek 原创(Google 等大厂早有研究),但由于 DeepSeek 团队面临着极其严格的资源限制("they did have pretty strict resource limitations"),他们被迫在工程协同上做到了极致。嘉宾指出,DeepSeek 的成功在于让“正确的人完成了正确的合作”:软件工程师与硬件工程师紧密配合,盯着网络日志,观察网络通信和延迟,在极度精细的协同下完成了这场“编排完美的舞蹈”。此外,V3 还应用了多 Token 预测(MTP)技术,通过增加注意力模块来预测接下来的多个 Token,进一步提升了训练性能。
---
### [09:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=599s) 强化学习的突破:从 R1-Zero 到 R1 的演进 在 V3 基础模型之上,真正让 DeepSeek 彻底出圈的是其推理模型 R1-Zero 和 R1。推理模型擅长解答写代码、做数学题等有标准答案的问题。在 R1 出现之前,OpenAI 的 o1 是市场上唯一的推理模型。而 DeepSeek 的创新在于,R1 不仅会思考,还会详细列出其“思维链”(CoT)。更重要的是,在 R1-Zero 的训练中,团队采用了无需任何人类反馈的纯强化学习(RL)。
这让人联想到当年的 AlphaGo,它就是通过强化学习完成了从模仿人类到击败人类的超越,在自我对弈中不断优化策略。然而,目前主流大模型的训练仍高度依赖基于人类反馈的强化学习(RLHF),这存在人类偏见、奖励模型泛化能力差等弊端。
DeepSeek 采用了一种名为 GRPO(Group Relative Policy Optimization,群体相对策略优化)的算法。 - **GRPO 算法的本质**:OpenAI 之前使用的是 PPO(近端策略优化)算法,该算法通过一个“Critic”(评论家)模块来衡量行动优劣。而 GRPO 去掉了 Critic 部分,直接优化策略本身,从而大幅节省了算力和内存。 - **业内的不同声音**:有业内人士直言,GRPO 并不是什么高深的新技术,甚至在某种意义上是 PPO 的一种“退化”而非进化。但 DeepSeek 恰恰是用这种看似退化的算法,极其聪明地解决了大规模强化学习中的算力与计算效率问题。
在 R1-Zero 的训练中,由于数学和编程问题有标准答案,DeepSeek 设计了两个简单的奖励函数:一个用来验证答案的正确性,另一个用来确保输出格式规范。模型在没有人类示范的情况下,通过不断的自我试错与奖励激励,自动学会了推理和“反思”的能力。
然而,纯强化学习训练出来的 R1-Zero 也存在明显问题,即“可读性极差”,回答中常常中英文夹杂,甚至出现多种语言混杂。为此,DeepSeek 团队最终还是引入了少量的黄金监督微调(SFT)数据来重新训练,这才诞生了兼具强大推理能力与良好可读性的 DeepSeek R1。这一成功向全世界证明:利用无监督强化学习训练推理模型不仅完全可行,而且可以用极少的算力达成极高的性能。
---
### [14:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=899s) 围绕蒸馏、成本与安全性的巨大争议 伴随着赞誉,DeepSeek 在全球范围内也遭遇了激烈的指责,首当其冲的就是“模型蒸馏”(Distillation)与数据盗窃的争议。
包括《纽约时报》在内的多家媒体报道,OpenAI 发现 DeepSeek 在训练过程中使用了其 API 产生的数据来训练自己的模型。这种“黑盒蒸馏”(Black-box Distillation)在 AI 行业和学术界其实是非常普遍的常规操作——通过向能力更强的模型(如 GPT-4)发送大量查询,获取其输出,再用这些数据去训练较小的模型,从而以极低成本获得接近大模型的性能。
然而,要从法律上坐实 DeepSeek 侵权极其困难。OpenAI 必须提供确凿的 API 使用证据,或者证明两者的模型权重、输出代码高度相似。但 OpenAI 目前处于一个两难境地("Catch-22 situation"):它既想指控 DeepSeek 抄袭,又不愿意公开自己的代码、模型架构和权重。有嘉宾调侃道,这非常具有讽刺意味,因为 OpenAI 过去也曾因使用版权数据训练模型而被起诉,现在它指责 DeepSeek 拿了自己的数据,显得有些“双标”和虚伪。
另一个争议焦点在于那笔“557万美元”的训练成本。硅谷流传甚广的 SemiAnalysis 分析报告指出,这个数字只是“单次成功训练”的硬件租赁理论值,根本没有反映出 DeepSeek 实际的花费。 - **实际硬件支出**:DeepSeek 在硬件上的实际支出远超5亿美元。 - **试错与研发成本**:在最终训练之前,团队花费了数月时间去测试新想法、新架构(如 MLA 机制),这些试错过程中的人力成本和 GPU 损耗才是真正的大头。 - **算力卡源之谜**:外界对 DeepSeek 到底用了什么卡众说纷纭。SemiAnalysis 猜测 DeepSeek 拥有约5万张英伟达 Hopper GPU,包括1万张 H800、1万张 H100 以及额外购买的 H20 芯片。这甚至引发了美国政府收紧 GPU 出口管制的呼声。
不过,投资人 Bill 认为,纠结于单次训练成本是 H100 还是 H800 意义不大,行业真正应该关注的是 **推理成本(Inference Cost)** 的断崖式下跌。 - **极高的稀疏度(Sparsity)**:DeepSeek 在推理时,6700亿参数中只有约350亿到370亿参数被激活(激活率仅为1%左右),远低于其他大模型。 - **订阅制 vs 一次性买卖**:训练成本是一次性支出(One-time cost),而推理成本则是持续不断的订阅式支出(Subscription)。DeepSeek 极低的激活参数量意味着单次推理的时间和计算复杂度大幅缩减,单位 GPU 的算力释放效率倍增。这对于应用层创业者来说,才是真正改变游戏规则(Game-changer)的事情。
此外,网络安全公司 Wiz 在2025年1月底爆出安全漏洞,指出 DeepSeek 将一个关键数据库暴露在公网上,泄露了包括系统日志、用户提示词及 API 密钥在内的超过100万条敏感记录。这引发了外界对这个年轻的“小团队”是否有能力服务全球量级用户的担忧,甚至可能触发监管机构的安全审查。1月27日,DeepSeek 也因遭受大规模恶意网络攻击而一度导致服务中断。
---
### [24:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=1499s) 硅谷大模型巨头的震动与应对 DeepSeek 的横空出世,对硅谷那些自诩领先的闭源与开源大模型公司无异于“一记响亮的耳光”("a slap in the face")。
对于闭源巨头 OpenAI 和 Anthropic 而言,最直接的冲击是技术领先带来的“垄断溢价”面临缩水。根据 Sensor Tower 的数据,2025年1月26日,DeepSeek 登顶美国免费应用榜单第一,并在全球140个市场位居榜首。在日活跃用户(DAU)上,DeepSeek 已达到 ChatGPT 的23%,每日下载量更是完成了超越。
面对定价仅为自己几十分之一的对手,Sam Altman 迅速在社交媒体上做出反击。 - **发布 o3-mini**:1月31日,OpenAI 推出推理模型 o3-mini,并首次向免费用户开放。其定价(输入1.1美元/百万 Token,输出4.4美元/百万 Token)虽比之前的 o1-mini 便宜了63%,但依然远贵于 DeepSeek R1(输入0.14美元,输出0.5美元)。 - **推出 Deep Research**:2月3日,OpenAI 发布 Deep Research,展示其在复杂任务多轮搜索上的超强能力。在 Humanity's Lost Exam 测试中,Deep Research 取得了26.6%的专家级准确率,而 DeepSeek R1 仅为9.4%。OpenAI 试图通过这种“秀肌肉”的方式证明:虽然我贵,但我的模型依然是最好的。
然而,OpenAI 强硬反击的背后是巨大的财务与融资压力。作为行业开拓者,OpenAI 承担了极高的前沿探索成本(即所谓的“专利药”研发成本),而追赶者则能享受“仿制药”的低成本红利。如果推理侧的利润无法弥补训练侧的巨额亏损,其商业模式将难以为继。这也解释了为什么 OpenAI 紧接着开启了新一轮高达400亿美元的融资,试图将估值推向3000亿美元。但在 DeepSeek 冲击下,二级市场上 OpenAI 和 Anthropic 的股权交易已基本停滞,投资人开始重新审视这些巨头的资金消耗速度。
对于 Anthropic 而言,处境更为尴尬。它在 DeepSeek 发布前刚以600亿美元估值融资30亿美元,目前不仅没有推出自己的推理模型,还面临着 API 价格被严重挤压的窘境。其创始人 Dario Amodei 甚至在公开场合呼吁美国政府加强供应链管控,这与 Sam Altman、Yann LeCun 等人对 DeepSeek 技术的客观评价形成了鲜明对比,在社交媒体上招致了不少冷嘲热讽。
在开源阵营,领头羊 Meta 同样感受到了实质性威胁。据报道,DeepSeek R1 发布后,Meta 内部立刻进入紧急状态,成立了四个“战时控制室”(War Rooms)。Meta 原计划在第一季度发布 Llama 4,如果其性能落后于 DeepSeek,Meta 试图通过开源大模型构建生态(类似于当年谷歌开源安卓系统)的战略算盘将会落空。
业内人士指出,DeepSeek 的开源比 Meta 更加彻底和真诚。Meta 过去开源的模型往往落后于其内部最新水平,且伴随诸多大公司内部扯皮带来的限制。而 DeepSeek 不仅开源了行业最顶尖的模型,其技术报告(Technical Report)的详细程度也远超 OpenAI 和 Anthropic,这让全球开源社区大为振奋。
不过,开源模型的商业化变现依然是个巨大的难题。法国开源先锋 Mistral 曾以 MoE 架构轰动一时,如今为了生存,其最先进的模型也走向了闭源。DeepSeek 目前同样面临着算力不足以支撑全球用户访问的窘境(甚至一度暂停注册)。它能否在开源路径上持续保持领先,并从社区的反馈中获得反哺,将是下一步的观察重点。
---
### [34:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=2099s) 算力市场的格局重塑:英伟达的护城河变动 DeepSeek 对英伟达股价的短期重挫虽然惊人,但一二级市场很快在第二种逻辑上达成了共识:**算力成本的降低反而会刺激整个生态的繁荣**。
投资人普遍认为,虽然单次模型训练的算力花费变便宜了,但由于门槛降低,会有更多的玩家入局,催生出庞大的应用生态,开源社区也会疯狂复现和微调相关模型。这种对下一代模型和应用层算力的整体需求,最终依然会推高 GPU 的总消耗量,因此长期来看依然利好英伟达。
然而,英伟达股价没有立刻迎来暴涨,是因为 DeepSeek 的工程创新触及了英伟达最核心的软件护城河——**CUDA 生态**。 - **英伟达的两大壁垒**:一个是硬件层面的芯片互联技术(Infiniband),另一个则是软件层面的 CUDA 调用系统。这让英伟达在与 AMD 等对手竞争时,早已超越了单卡性能的对决,而是整个软件生态的垄断。 - **“绕过 CUDA”的恐慌**:近期大量媒体以“DeepSeek 绕过 CUDA”为题进行报道,再度引发了市场对英伟达软件护城河是否依然坚固的深度质疑。
[44:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=2699s) DeepSeek 真的绕过了 CUDA 吗?
针对媒体上“DeepSeek 绕过 CUDA 实现了高效训练”的广泛报道,多位技术派嘉宾给出了出奇一致的看法:这类新闻标题是不准确的。DeepSeek 并没有完全绕过 CUDA,但英伟达的护城河确实因此松动了一点。
要理解这一点,需要剖析 DeepSeek 的技术路径。DeepSeek 的创新在于:第一,直接在英伟达 GPU 的低级汇编语言 PTX(Parallel Thread Execution)上进行优化;第二,通过对 FP8 计算和存储的支持,加速训练并减少 GPU 显存使用。然而,嘉宾们指出,PTX 依然是英伟达 GPU 架构中的技术,是 CUDA 生态中连接高级语言代码和底层硬件的指令。因此,直接调用 PTX 并在这一层做优化,属于在 CUDA 生态内部的深层探索,而非“绕过”。这种极高难度的工程并非一般小公司所能企及。
此外,虽然 DeepSeek 证明了基于 PTX 优化 GPU 的可行性,但这并不意味着其他团队有能力或动力去效仿。编写 PTX 代码极其复杂、难以维护,且极难移植到不同型号的 GPU 上。短期内,业界没有动力大规模改变算力使用方式,AWS、Azure、Google Cloud 等云厂商也不可能突然放弃对 CUDA 的支持去适配其他方案。
- **英伟达的护城河**:其核心在于整个 CUDA 软件生态的通用性,任何软件都可以无缝调用;而 DeepSeek 的 PTX 极致优化是高度定制化的,换了新模型就需要重新适配。 - **AMD 的短期利好**:AMD 迅速宣布将 DeepSeek V3 集成到其 MI300X GPU 上。如果 DeepSeek 成为未来的行业标准,AMD 将直接受益;但若未来出现其他新模型,重新适配的成本依然高昂。
---
[48:15](https://www.bilibili.com/video/BV17fNeeFEwZ?t=2895s) 算力降本对英伟达垄断地位与市场溢价的冲击
DeepSeek 通过支持 FP8 计算和存储,大幅降低了对英伟达顶级芯片的依赖,这引发了市场对 Groq 等 ASIC 专项芯片、谷歌 TPU 以及亚马逊自研芯片能否打破英伟达垄断的讨论。谷歌在最新财报后预计 2025 年资本支出将飙升至 750 亿美元,其中很大一部分将投向自研 TPU,而其设计方博通(Broadcom)的股价也随之大涨。Meta 等巨头同样在加大对 ASIC 芯片的投入以减少对英伟达的依赖,尤其是在推理端。
技术嘉宾认为,这一趋势“会冲击英伟达的溢价,但不会击垮英伟达的壁垒和护城河”。DeepSeek 的 FP8 策略确实减少了对 CUDA 的深度绑定,给 AMD、谷歌 TPU 乃至华为等竞品带来了巨大机会。面对竞争,英伟达极具战略前瞻性的 CEO 黄仁勋势必会在 CUDA 生态内优化推理端的性能与价格。
- **利润率回归**:英伟达此前超过 90% 的毛利率(Growth Margin)将面临降价压力。一旦英伟达主动降价,凭借其依然领先的生态支持,仍能夺回部分市场份额。 - **“墙”的比喻**:嘉宾形象地比喻道,以前大家都觉得有一堵翻不过去的墙(英伟达的壁垒),现在 DeepSeek 跳过去了,证明了翻墙的可能性,但这堵墙本身并没有变矮,其他人想要翻过去依然困难。
---
[51:50](https://www.bilibili.com/video/BV17fNeeFEwZ?t=3110s) AI 界的“拼多多”:API 价格战与应用层的利润变革
在 DeepSeek 带来的各项突破中,短期内对应用层影响最大的无疑是“模型推理成本的断崖式下跌”。DeepSeek 被业内戏称为“AI 界的拼多多”,其发布的 V2 和 V3 模型直接引爆了行业价格战,甚至逼得字节跳动等大厂不惜赔本将 API 价格打到成本线以下。
对于 AI 应用开发者而言,这场价格战带来了不同的影响。对于原本就定位高端、替代高薪白领工时(如律师、医生、程序员、金融分析师)的 2B 应用来说,降价是“锦上添花”,带来的是利润率的翻倍(量变而非质变),因为这些赛道原本就不惜代价追求极致性能。但对于那些此前需要烧钱补贴、难以推广的场景,降价则是“雪中送炭”,直接让原本亏本的买卖变成了有利可图的好生意。
- **陪伴型 AI 的成本重构**:以 Character AI 为例,其用户单次平均使用时长高达 2 小时(是 ChatGPT 的 17 倍),此前高昂的模型调用成本逼得公司不得不限制时长或疯狂烧钱。DeepSeek 彻底改变了陪聊 AI 的成本结构,使其成为一门好生意。 - **AI Agent(智能体)的救星**:AI Agent 是著名的“算力黑洞”,完成一个任务需要多步骤调用、自我修正甚至多 Agent 协同,API 调用呈指数级增长。DeepSeek 的低成本与高响应速度极大地缓解了这一痛点。
---
[54:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=3299s) 端侧 AI 的兴起与 SaaS 商业逻辑的颠覆
随着 DeepSeek 让端侧部署 AI 小模型的能力突飞猛进,业界普遍预测 2C 领域的设备端 AI 将迎来百花齐放的爆发,如儿童陪玩机器人、硬件会议记录仪等。投资人 Larry 尤其看好端侧 AI 在娱乐类和虚拟人助手(如 Avatar 交互)领域的应用。
端侧 AI 的最大特征是“编辑成本几乎为零”,因为计算资源完全由用户的设备提供,而非云端服务器。这一特征正在颠覆 SaaS 时代经典的“硬件+订阅”捆绑逻辑——即“电动牙刷柄赔钱,牙刷头赚钱”的商业模式(以低价硬件吸引用户,靠高利润的软件订阅服务持续变现)。当端侧 AI 的服务编辑成本归零时,激烈的竞争将使订阅服务难以实质性收费。
- **物联网(IoT)的春天?**:尽管端侧 AI 跨越式发展,但业界对物联网的爆发仍持观望态度。物理世界的硬件发展是线性的,而数据和软件应用的发展是指数级的。此前孙正义在物联网上的折戟也让投资人更加谨慎。 - **横向与纵向 AI 创业的分化**:在前沿大模型效果趋同、进入效率竞争的当下,单纯追求面面俱到的“横向”AI 创业公司(包括许多融资额巨大的明星科学家团队)正面临资本市场的重新评估。投资人 Larry 指出,越是融资多的名人创业,越容易陷入“杀鸡用牛刀”的尴尬境地。相反,深耕细分领域、能提供比传统方案好“十倍百倍”的“纵向”AI 企业,更容易通过积累独特数据建立起真正的护城河。
---
[01:01:30](https://www.bilibili.com/video/BV17fNeeFEwZ?t=3690s) 幻方量化与创始人梁文峰的传奇历程
DeepSeek 并非凭空出世,其背后是低调的中国量化巨头——幻方量化。创始人梁文峰出生于 1985 年,是一位不折不扣的天才。他 14 岁考入浙江大学,硕士阶段专注于计算机视觉研究。在 2008 年全球金融危机及 A 股崩盘背景下,他敏锐地捕捉到量化交易的机会,毕业后没有去互联网大厂,而是躲在成都的廉价出租屋里疯狂编写选股算法。
2015 年,梁文峰与大学好友许静共同创立幻方量化。在 2015 年 A 股大股灾的背景下,幻方凭借出色的算法取得了惊人的超额回报,并在年底一口气成立了 10 只募资产品。此后,幻方的管理规模从 2016 年的 10 亿元一路飙升,在 2021 年突破千亿元大关。
- **对 AI 的执念**:有业内人士评价,“幻方更像是一家做机器学习的人工智能公司,副业是用量化交易挣了钱”。2016 年 AlphaGo 击败李世石后,幻方上线了第一个深度学习模型,并首次使用 GPU 生成交易仓位。到 2017 年底,幻方几乎所有的量化策略都已采用 AI 模型。 - **自研算力平台**:为了解决算力瓶颈,幻方于 2019 年投资 2 亿元研发了深度学习训练平台《萤火一号》(搭载 1100 块 GPU);2021 年又构建了算力提升 18 倍的《萤火二号》,使幻方成为国内少数拥有上万张 A100 GPU 的公司之一。2023 年 5 月,幻方正式将大模型团队独立,成立了 DeepSeek。
---
[01:07:30](https://www.bilibili.com/video/BV17fNeeFEwZ?t=4050s) 融资受阻与技术理想主义的坚守
尽管实力雄厚,DeepSeek 在 2024 年 5 月尝试对外融资时却遭遇了冷落。当时国内 VC 们正深陷 DPI(投入资本分回率)焦虑,不敢投资高风险、高投入的基础大模型。美元基金当时正扎堆竞逐“月之暗面”和“MiniMax”等已经形成行业共识的明星项目;而人民币基金受限于资金期限和风险偏好,更倾向于投资有政府背景的“智谱 AI”或能快速变现的商业应用。
对于 DeepSeek 这种量化背景跨界、且要做开源模型的团队,当时的投资人普遍看不懂其商业模式,梁文峰因此备受冷落。然而,梁文峰是一位“剑走偏锋的技术理想主义者”。早在 2021 年他疯狂囤积数千张英伟达 GPU 时,合作伙伴甚至用“一个发型很糟糕的书呆子”来形容他,没人知道他想干什么。
- **业绩回撤与舆论压力**:2021 年,幻方因 AI 在买卖时点的投资决策失误遭遇历史最大回撤,管理规模从千亿回落至如今的不足 300 亿元。当时许多投资人指责梁文峰因“沉迷 AI”而分散了精力。但即便在最艰难的时刻,梁文峰依然顶住压力,坚决不减少对 AI 的投入,并构建了《萤火二号》。 - **本土天才团队与独特文化**:与有着华尔街或欧洲对冲基金背景的同行不同,幻方和 DeepSeek 是完全本土起家、独自摸索长大的团队。成员大多是清华、北大、北邮、北航等国内顶尖高校的毕业生或博士。梁文峰本人更愿意被看作工程师而非交易员,每天亲自参与写代码、跑代码。
---
[01:13:50](https://www.bilibili.com/video/BV17fNeeFEwZ?t=4430s) 追求极限的极客氛围与硅谷的震动
DeepSeek 团队平均年龄仅 28 岁,许多核心岗位由刚毕业一两年的年轻人担任。公司内部没有 KPI 或 OKR,完全靠员工的自我驱动。这种宽松、纯粹的学术实验室氛围,让人联想到早期 Elias Sutskever 和 Andrej Karpathy 尚未离职时的 OpenAI。
团队成员曾分享过一个攻克核心算子的故事:当时为了提升一个 GPU 使用率不高的官方算子,团队在持怀疑态度的情况下苦闷挣扎了一个月。某天回家路上,一位成员在“凉风袭来”时突然顿悟,最终做出的版本比官方快了 5 倍,普遍情况下快 25%,直接节省了四分之一的 GPU 时间。这种对“理论最大值”和 1% 极限的追求,构成了 DeepSeek 的技术灵魂。新资本合伙人吴炳健曾感慨,DeepSeek 成功的秘诀其实很简单:“因为他们的老板自己读论文,自己写代码,自己做招聘。”
- **硅谷的紧迫感**:DeepSeek 的横空出世打破了硅谷大模型路线日趋同质化的格局,重新盘活了整个 AI 大战。Meta、谷歌、OpenAI 和 Anthropic 的紧迫感被彻底唤醒。扎克伯格在内部员工大会上直言,所有人都要为紧张的一年做好准备。 - **严寒昆的发言**:图灵奖得主严寒昆(Yann LeCun)在 LinkedIn 上指出,硅谷某些圈子存在一种“错位的优越感”,认为小圈子垄断了所有好主意,甚至假设别人的创新是通过作弊获得的。但现实是,只有当全球有才华的人共同分享创新时,科技才能进步得更快。
## Notable quotes > [00:00](https://www.bilibili.com/video/BV17fNeeFEwZ?t=0s) they did have pretty strict resource limitations — 业内嘉宾
> [00:00](https://www.bilibili.com/video/BV17fNeeFEwZ?t=0s) 最主要的智能模型 — Satya Nadella / Alexandr Wang
> [00:00](https://www.bilibili.com/video/BV17fNeeFEwZ?t=0s) 编排完美的舞蹈
> [14:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=899s) Catch-22 situation — 业内嘉宾
> [14:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=899s) Inference Cost — Bill
> [14:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=899s) One-time cost — Bill
> [14:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=899s) Subscription — Bill
> [14:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=899s) Game-changer — Bill
> [24:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=1499s) a slap in the face
> [51:50](https://www.bilibili.com/video/BV17fNeeFEwZ?t=3110s) AI界的拼多多 — 业内人士
> [54:59](https://www.bilibili.com/video/BV17fNeeFEwZ?t=3299s) 杀鸡用牛刀 — Larry
> [01:01:30](https://www.bilibili.com/video/BV17fNeeFEwZ?t=3690s) 幻方更像是一家做机器学习的人工智能公司,副业是用量化交易挣了钱 — 业内人士
> [01:07:30](https://www.bilibili.com/video/BV17fNeeFEwZ?t=4050s) 一个发型很糟糕的书呆子 — 合作伙伴
> [01:13:50](https://www.bilibili.com/video/BV17fNeeFEwZ?t=4430s) 因为他们的老板自己读论文,自己写代码,自己做招聘。 — 吴炳健
> [01:13:50](https://www.bilibili.com/video/BV17fNeeFEwZ?t=4430s) 错位的优越感 — Yann LeCun
## Mentioned DeepSeek, DeepSeek V3, DeepSeek R1-Lite, DeepSeek R1, DeepSeek R1-Zero, 幻方量化, 梁文峰, 许静, OpenAI, o1, o3-mini, Deep Research, Sam Altman, Satya Nadella, 微软, Alexandr Wang, Scale AI, 英伟达, GPU, H800, H100, H20, Hopper, 达沃斯论坛, MoE, MLA, MTP, AlphaGo, RLHF, PPO, GRPO, SFT, CoT, 纽约时报, SemiAnalysis, Bill, Wiz, Anthropic, Dario Amodei, Sensor Tower, ChatGPT, Humanity's Lost Exam, Meta, Llama 4, 扎克伯格, 谷歌, Mistral, AMD, MI300X, PTX, CUDA, Infiniband, Groq, ASIC, TPU, 亚马逊, 博通, 黄仁勋, 字节跳动, Character AI, AI Agent, SaaS, Larry, Avatar, 孙正义, 物联网, 月之暗面, MiniMax, 智谱 AI, 萤火一号, 萤火二号, A100, 清华大学, 北京大学, 北京邮电大学, 北京航空航天大学, 浙江大学, Elias Sutskever, Andrej Karpathy, 吴炳健, 新资本, Yann LeCun, LinkedIn
[Source](https://www.bilibili.com/video/BV17fNeeFEwZ)