谷歌DeepMind开源EmbeddingGemma 2将五模态装进567MB手机内存
AI技术投降派
因为Apache 2.0开源与可拆装架构让多模态向量计算得以沉淀在端侧,未来用户手机里的本地向量索引体积将超越AI模型本身,使坐标取代模型成为真正的核心资产。
AI-assisted summary of 一句话搜照片搜视频 谷歌740M模型手机就能跑 — original source. Check the original for full context.
Source published:
Key ideas
- 谷歌 DeepMind 正式发布轻量级多模态嵌入模型 EmbeddingGemma 2,参数量仅 740M,采用 Apache 2.0 开源协议,可在手机等端侧设备完全离线运行。 (0:00)
- 模型将文本、代码、图片、视频与音频统一映射至单一 768 维向量空间,并支持模块化拆装,提供从纯文本 270M 到全模态 740M 的四档按需部署规格。 (1:59)
- 量化后在 Pixel 手机上运行纯文本模式仅需 191 MB 内存,但在基准测试中多语言文本检索仅微增 0.2 分,真正的提升主要集中在代码检索(提升近 10 分)。 (4:16)
- 实测发现官方语义路由示例存在置信度仅 0.22 的失误,且模型缺乏内置 OCR 能力也不适用于音乐检索,端侧与私有相册等落地需针对性验证。 (4:16)
Detailed notes
## Background 该内容由 B站 UP主“AI技术投降派”于 2026 年 10 月 9 日发布,视频时长 6 分 49 秒。视频围绕谷歌 DeepMind 发布的开源多模态嵌入模型 EmbeddingGemma 2 展开,介绍了其将文字、代码、图片、视频与音频统一映射至 768 维空间的核心架构、端侧运行能力、真实落地场景与存在的性能边界。
## TL;DR EmbeddingGemma 2 是一个仅有 740M 参数、采用 Apache 2.0 协议的多模态嵌入模型,支持在手机等端侧设备离线运行。它采用解耦的“三件套”模块化设计,允许按需拆分为 270M 至 740M 四档规格,并支持套娃维度裁剪以节省存储空间。虽然代码检索能力大幅跃升至 78.68 且 Ollama 已经首发支持,但该模型的纯文本检索能力原地踏步,缺乏内置 OCR,且官方语义路由示例在实测中出现翻车。视频指出该模型正被应用于案卷交叉检索、Immich 私有相册管理及 Mac 本地 MCP 知识库构建,点明了“模型是造坐标的工具,坐标本身才是核心资产”的行业趋势。
## Atmosphere & style 整体基调理性客观、节奏紧凑,呈现出极客风格的技术拆解与冷静审视。UP主在赞叹端侧轻量化设计与开源协议转变的同时,毫不避讳地“浇下三盆冷水”,直击官方测试翻车现场与能力短板。叙述既有深度的工程架构剖析,又带着接地气的社区视角,给观众一种拨开营销迷雾、探寻技术真实落地分寸的清醒沉浸感。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1PYHD6uExR?t=0s) 谷歌 DeepMind 正式发布轻量级多模态嵌入模型 EmbeddingGemma 2,参数量仅 740M,采用 Apache 2.0 开源协议,可在手机等端侧设备完全离线运行。 - [01:59](https://www.bilibili.com/video/BV1PYHD6uExR?t=119s) 模型将文本、代码、图片、视频与音频统一映射至单一 768 维向量空间,并支持模块化拆装,提供从纯文本 270M 到全模态 740M 的四档按需部署规格。 - [04:16](https://www.bilibili.com/video/BV1PYHD6uExR?t=256s) 量化后在 Pixel 手机上运行纯文本模式仅需 191 MB 内存,但在基准测试中多语言文本检索仅微增 0.2 分,真正的提升主要集中在代码检索(提升近 10 分)。 - [04:16](https://www.bilibili.com/video/BV1PYHD6uExR?t=256s) 实测发现官方语义路由示例存在置信度仅 0.22 的失误,且模型缺乏内置 OCR 能力也不适用于音乐检索,端侧与私有相册等落地需针对性验证。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1PYHD6uExR?t=0s) EmbeddingGemma 2 实现了文字、代码、图片、视频与音频五种模态向统一 768 维高维向量空间的映射,使跨模态语义搜索仅依赖向量几何距离匹配。 - [00:00](https://www.bilibili.com/video/BV1PYHD6uExR?t=0s) 模型配备共享 8K 上下文窗口,单张图片折算约 280 个 Token,视频帧折算约 140 个 Token,音频每秒折算约 25 个 Token。 - [01:59](https://www.bilibili.com/video/BV1PYHD6uExR?t=119s) 架构由 270M 文本塔、170M 视觉编码器与 300M 音频编码器解耦构成,未调用的编码器无需载入内存,可灵活按需组合四档运行规格。 - [01:59](https://www.bilibili.com/video/BV1PYHD6uExR?t=119s) 支持端云协同异构部署:手机端运行 270M 纯文本编码器处理查询词,云端跑 740M 全模态模型为文件建库,两端向量坐标完全互通。 - [01:59](https://www.bilibili.com/video/BV1PYHD6uExR?t=119s) 模型支持套娃维度裁剪至 512、256 或 128 维以节约存储,但截断至 128 维会导致多模态检索性能暴跌 13 分,实测推荐底线为 256 维。 - [03:13](https://www.bilibili.com/video/BV1PYHD6uExR?t=193s) 开源协议转向 Apache 2.0,避免了闭源商业 API 停服导致此前计算生成的海量历史向量资产全部作废的系统性风险。 - [03:13](https://www.bilibili.com/video/BV1PYHD6uExR?t=193s) 端侧性能表现亮眼:Pixel 手机纯文本运行仅占 191 MB 内存,Mac/M 系列芯片单张图片嵌入仅耗时 37.3 毫秒,且 Ollama 发布当天已同步上线支持。 - [04:16](https://www.bilibili.com/video/BV1PYHD6uExR?t=256s) 模型并非全面暴涨,多语言文本检索得分仅从 61.15 微升至 61.36 基本原地踏步,核心性能跃升来自于代码检索(68.76 提升至 78.68)。 - [04:16](https://www.bilibili.com/video/BV1PYHD6uExR?t=256s) 官方语义路由演示在外部实测中翻车,对“取消航班并退款”与“支付”的关联判定置信度仅为 0.22,生产环境路由决策需保持审慎。 - [04:16](https://www.bilibili.com/video/BV1PYHD6uExR?t=256s) 模型存在明确功能边界:无内置 OCR 能力无法精准检索以文本为主的图档,音频编码器不适用音乐匹配,且发布期指标全为官方自报待第三方复测。 - [05:17](https://www.bilibili.com/video/BV1PYHD6uExR?t=317s) 技术正快速渗入真实业务场景,包括法律定损图文交叉检索、Immich 自托管相册接入,以及结合 MCP 构建 macOS 本地常驻知识库层。 - [05:17](https://www.bilibili.com/video/BV1PYHD6uExR?t=317s) AI 模型本质上是生成坐标的计算工具,端侧沉淀下来的向量索引库才是长久资产,未来本地索引体积可能远超模型本体。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1PYHD6uExR?t=0s) 几千张照片里怎么搜一句话:嵌入模型与统一向量空间
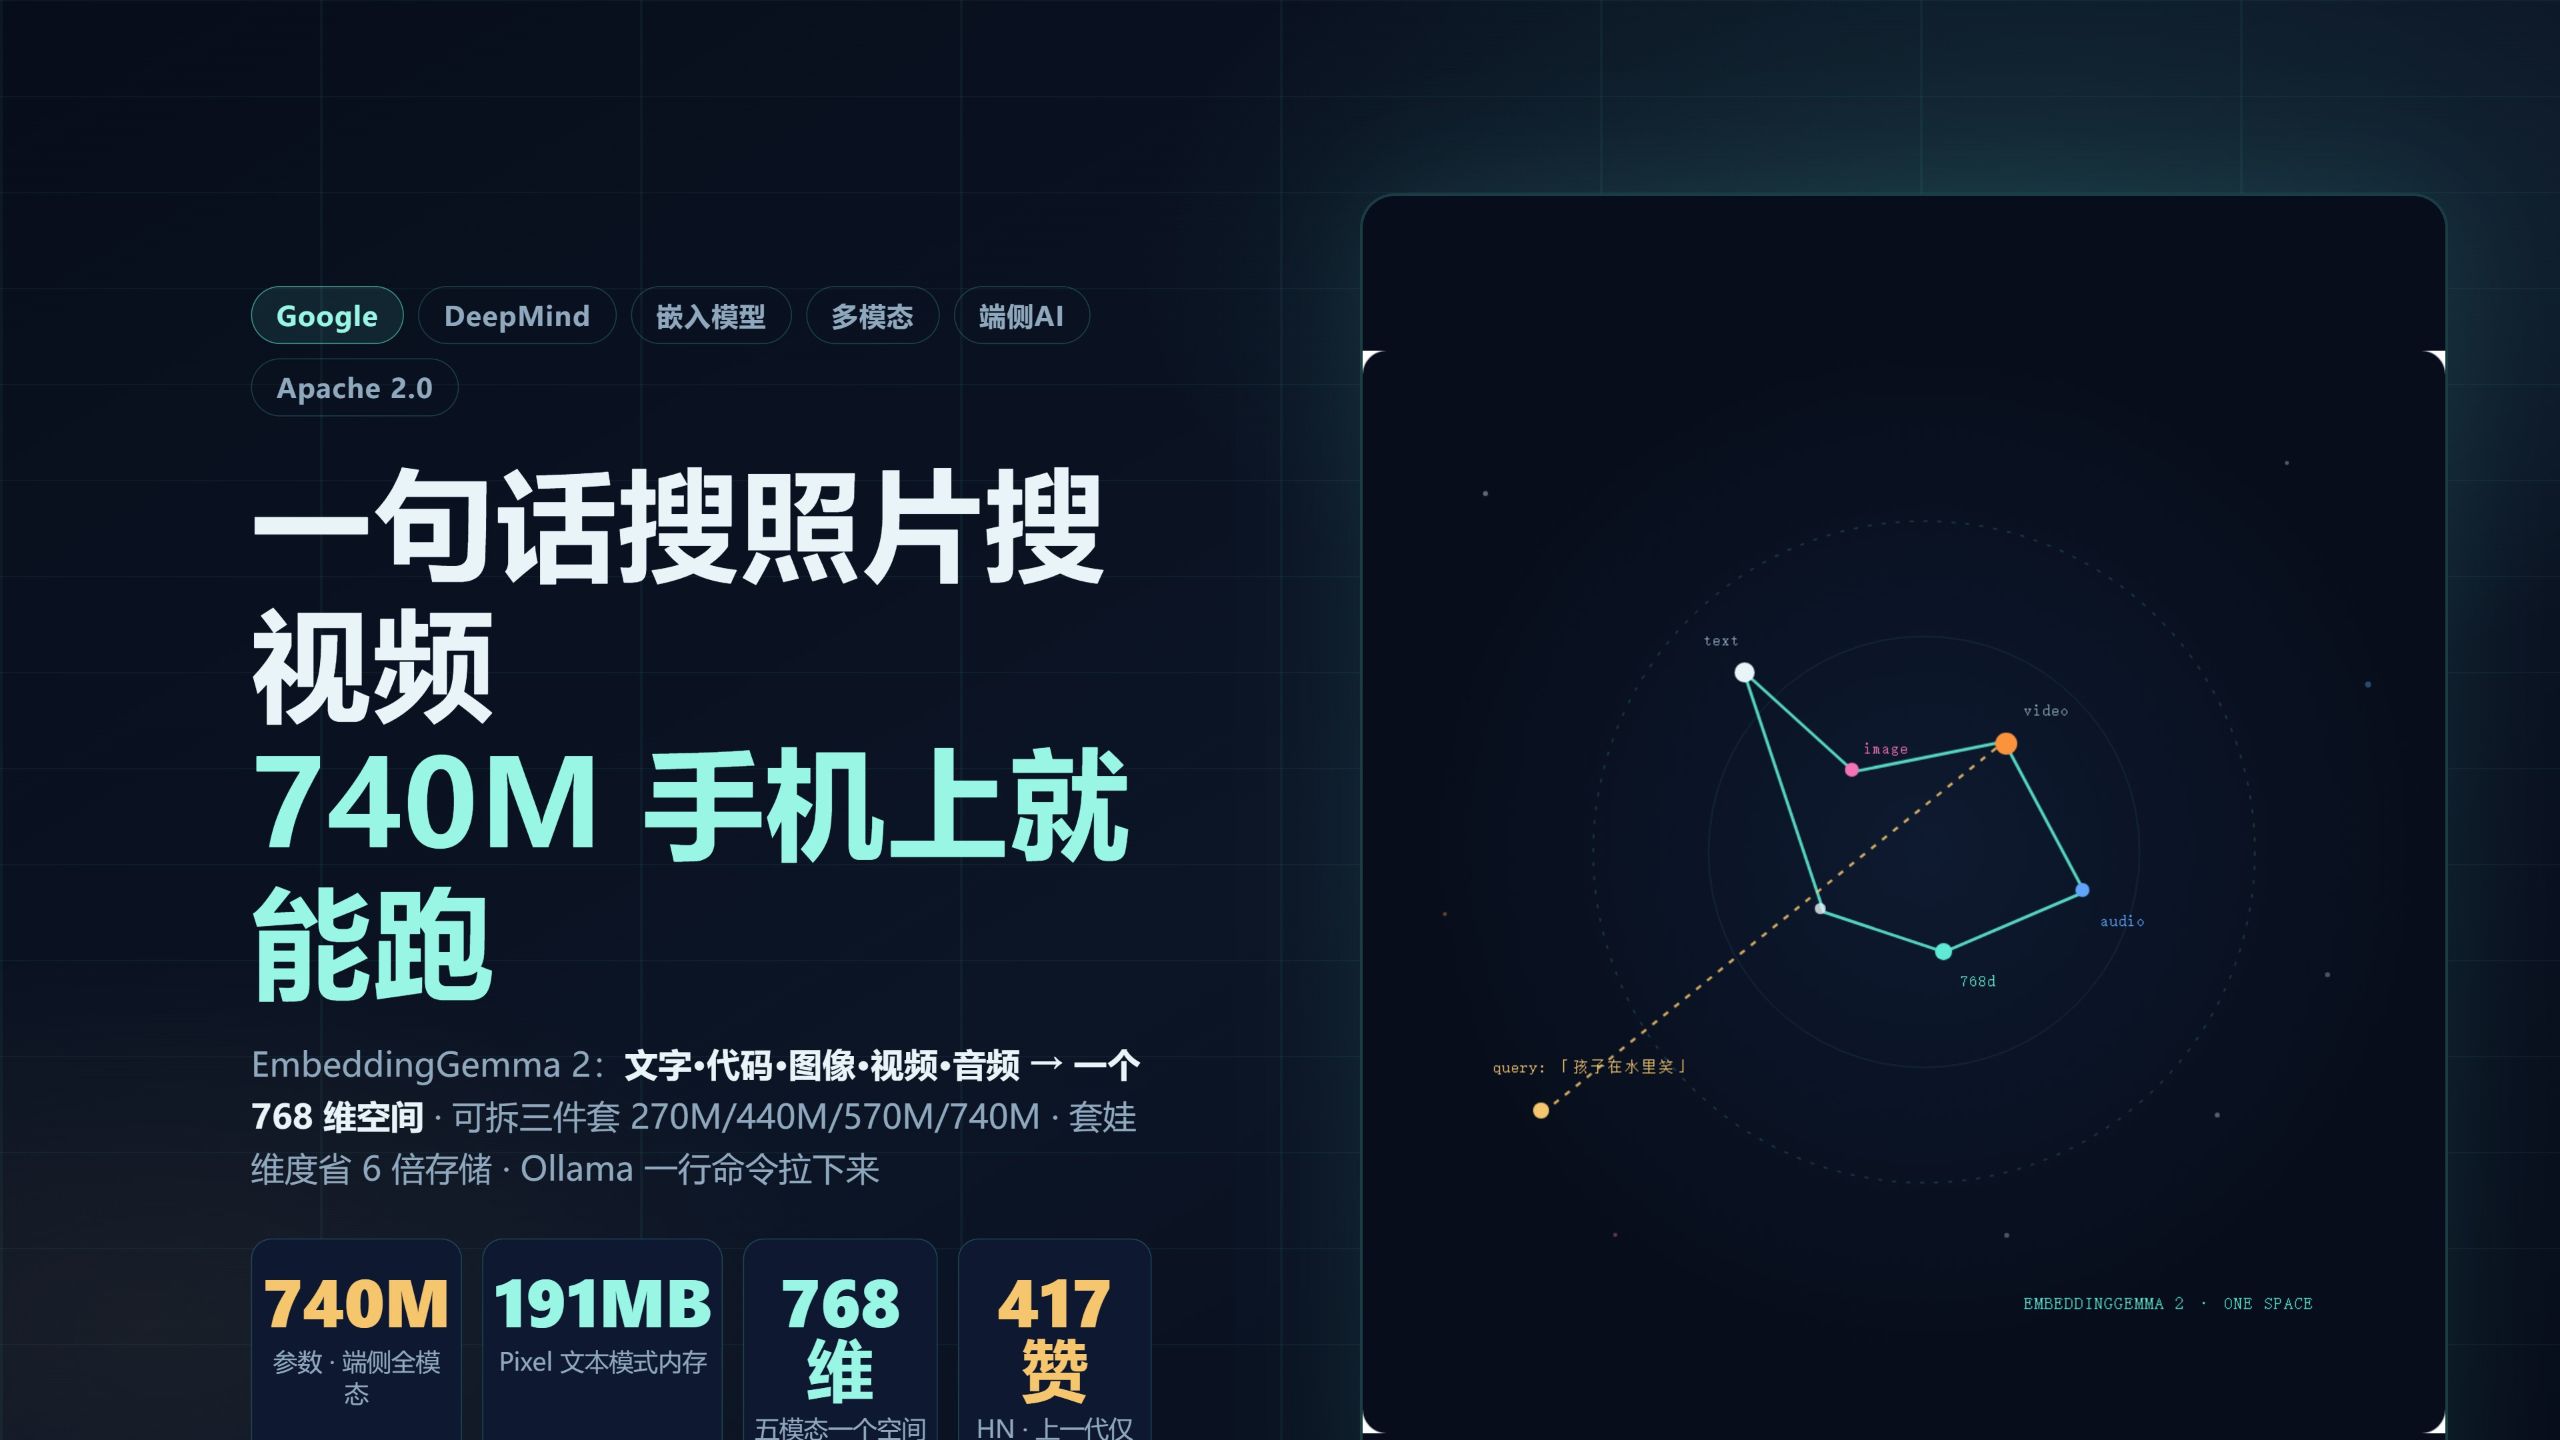
当手机相册里存了几千张照片,想要找出“孩子在水里笑”的那一张,按文件名搜索根本行不通,按拍摄日期漫无目的地翻找又太慢。10月6日,谷歌 DeepMind 给出了全新的解法——发布了多模态嵌入模型 EmbeddingGemma 2。它的核心能力是将文字、拍摄的照片、录制的视频和音频,统统映射到同一张“语义地图”的坐标系中。该模型仅有 7.4 亿参数(740M),不仅能在手机本地顺畅运行,而且采用了 Apache 2.0 开源协议。发布仅仅两天,它在 Hacker News 上便斩获了 417 个赞,相比上一代发布时凄凉的 44 个赞,开发者社区的热度暴涨了近十倍。
嵌入模型(Embedding Model)的本质就是“把万物变成坐标”。无论是输入一段文字、一张照片还是一段音频,模型都会将其压缩成一串高维数字,即“向量”。在这一向量空间里,语义相近的内容,坐标距离就挨得极近。例如,“狗接飞盘”这四个字与一张小狗跃起接飞盘的照片,在语义地图中就是彼此挨着的邻居。因此,搜索不再依赖死板的关键词精准匹配,而是直接计算向量之间的几何距离。用户输入一句话,模型将其转化为坐标,并去数据库地图里搜寻距离最近的相片。这也正是为什么用户不需要给相册打上任何预设标签,直接用“孩子在水里笑”就能精准定位照片的原因。
EmbeddingGemma 2 最惊艳的地方在于实现了“五模态、一个空间”。文字与代码通过文本塔处理,图像由视觉编码器抽取特征,视频则按帧抽样处理,音频也有专属的编码器,最终它们全部落入同一个 768 维的向量空间内。此外,模型配备了一个共享的 8K 上下文窗口。各种模态在窗口内折算成 Token 有一套固定的“汇率表”: - 一张图片约占用 280 个 Token - 一帧视频约占用 140 个 Token - 一秒音频约占用 25 个 Token
单个 8K 窗口最多可容纳 29 张图片、58 帧视频,或者约 5 分半钟的音频。
```mermaid flowchart TD accTitle: EmbeddingGemma 2 Multi-modal Unified Vector Space accDescr: Various modalities mapped into a single 768-dimensional vector space via different encoders within an 8K token context window.
subgraph Inputs["多模态输入"] T["文本 / 代码"] I["图像 (~280 Tokens/张)"] V["视频抽帧 (~140 Tokens/帧)"] A["音频 (~25 Tokens/秒)"] end
subgraph Architecture["模块化编码架构 (共享 8K 窗口)"] TE["文本塔 (270M)"] VE["视觉编码器 (170M)"] AE["音频编码器 (300M)"] end
subgraph Space["统一语义空间"] VEC["768 维统一向量坐标空间<br/>(支持套娃截短至 256/128 维)"] end
T --> TE I --> VE V --> VE A --> AE
TE --> VEC VE --> VEC AE --> VEC ```
---
[01:59](https://www.bilibili.com/video/BV1PYHD6uExR?t=119s) 三件套可拆装架构与套娃维度
EmbeddingGemma 2 在工程设计上采用了极具灵活性的“三件套”模块化方案。其全量模型虽然拥有 7.4 亿参数,但内部完全解耦:纯文本模型占 2.7 亿(270M)参数,视觉编码器占 1.7 亿(170M)参数,音频编码器占 3 亿(300M)参数。这意味着开发者可以根据实际场景“拆着装”,不需要的模块绝不白白占用内存。模型因此衍生出了灵活的四档运行规格: 1. **270M**:纯文本模式 2. **440M**:文本 + 视觉模式 3. **570M**:文本 + 音频模式 4. **740M**:全模态完整模式
该架构催生了一种极为精妙的端云协同机制:查询端与文档端可以异构搭配运行。用户的手机可以仅部署极轻量的 270M 纯文本端,用来将输入的搜索词转化为向量;而服务端的私有存储或云端则跑着全量 740M 模型为海量图片、视频构建索引。两边生成的向量处在完全相同的坐标系中,可以直接无缝比对距离。
为了进一步节省存储与算力,EmbeddingGemma 2 还引入了套娃维度(Matryoshka Representation Learning)。其原生输出虽然是标准的 768 维,但允许按需截短至 512 维、256 维甚至 128 维。如果直接截到 128 维,向量数据库的存储成本最高可节省 6 倍。然而,官方披露的评测数据也揭示了残酷的代价:在截断至 128 维后,多模态检索性能评分直接从 59 分暴跌至 45.7 分,整整“崩了 13 分”。因此在实际的多模态部署中,256 维是不可退让的性能底线。
---
[03:13](https://www.bilibili.com/video/BV1PYHD6uExR?t=193s) 开发者为什么兴奋:开源协议、极低显存与落地生态
开发者社区对 EmbeddingGemma 2 的强烈反响主要源于三方面突破:
第一是许可证的彻底转向。上一代模型采用的是备受争议的 Gemma 专有许可证,社区普遍吐槽其并非真正意义上的开源。这一次谷歌直接开放了 Apache 2.0 协议。知名开发者 Simon Willison 对此评价道,嵌入模型是最不该依赖闭源商业托管服务的类型;一旦云厂商未来停止维护某个托管模型,企业此前耗费巨资计算出的数百万条向量便会瞬间作废,更换新模型必须将所有历史文档全部重算一遍。开放权重赋予了开发者一条可以随时掌控、自主撤退的技术底线。
第二是令人惊艳的端侧性能账本。经过量化处理后,在 Google Pixel 手机上运行纯文本模式仅需占用 191 MB 内存,全模态模式也只需要 567 MB。在苹果高端芯片(如 M5 Pro / Mac 芯片环境)上,单张图片的嵌入推理仅耗时 37.3 毫秒;若配合前端近似近邻检索(ANN),单次查询响应时间能直接压到个位数毫秒级。
第三是生态卡位的巧妙。目前多模态排行榜上的第一梯队大多被 80 亿(8B)参数量级的庞然大物所占据。EmbeddingGemma 2 根本不与这些巨无霸拼绝对总分,而是用只有对方十分之一的轻巧参数量,换取了能直接塞进手机内存跑全模态的实用能力。同时工具链跟进极其迅速,Ollama 在发布当天便同步上线了四档变体,最小的纯文本模型下载体积仅有 378 MB,一行命令即可拉取运行。
---
[04:16](https://www.bilibili.com/video/BV1PYHD6uExR?t=256s) 冷水三盆:文本原地踏步、路由翻车与能力边界
尽管光环耀眼,但也必须浇上三盆冷水以正视其短板:
首先,文本检索能力基本停滞不前。在多语言检索基准测试中,其得分仅从上一代的 61.15 微调至 61.36,区区 0.2 分的微弱提升约等于原地踏步。这一代模型在检索指标上真正的巨大飞跃其实是在代码检索——从 68.76 飙升至 78.68,足足涨了将近 10 分,这才是官方宣传中反复突出的底气。
其次,官方演示的语义路由功能在实测中当场翻车。有开发者在本地复现官方文档中的示例时发现,输入“取消航班并退款”这句话进行语义分类,模型竟然判定其与“支付”毫无关联,给出的置信度仅仅只有 0.22。连官方文档内的基础示例都无法稳定跑通,意味着在生产环境中使用该模型做语义路由决策仍需极为审慎。
最后是明确的功能边界与第三方验证缺失: - **无内置 OCR 能力**:如果图片主要依赖文字排版传达含义,纯依靠该模型检索会力不从心。 - **音乐检索不适用**:音频编码器偏向常规环境声音与语音,音乐特征匹配仍需选用其他专用方案。 - **数据尚未经第三方复测**:发布初期的各项性能与基准测试数据全部来自谷歌官方报告,开发者在正式上线业务前务必使用自有业务数据集进行独立验证。
---
[05:17](https://www.bilibili.com/video/BV1PYHD6uExR?t=317s) 它真正改变什么:落地场景与“坐标即资产”
尽管存在局限,EmbeddingGemma 2 已经在多个真实应用场景中展现出巨大价值: - **法律与保险定损**:有律师在技术论坛探讨借助其检索庞大案卷,只需输入一条自然语言,即可同时找出“卡特里娜飓风发生前完好的屋顶”与“飓风过境后损坏的屋顶”,并同步关联对应的证人证言笔录与现场勘验照片。 - **本地私有相册管理**:广受欢迎的自托管相册开源项目 Immich,其社区开发者已经在积极请求将其集成接入,以替换现有的外部依赖。 - **本地个人知识库构建**:已有开发者基于其搭建了 macOS 本地知识层。模型常驻系统内存,本地新保存的各种文件会自动生成向量并存入数据库,配合 Model Context Protocol(MCP)接口,用户可以直接让 ChatGPT 调用并全文检索自己的电脑。社区讨论中有人留下了一句颇具画面感的评论:“我要跟 Spotlight 说再见了。”
视频最后留出了一个深刻的行业洞察:在不久的将来,用户手机本地存储的向量索引体积,很有可能会远远超过跑这些索引的 AI 模型本体。“模型只是制造坐标的工具,坐标本身才是用户与系统沉淀下来的真正资产。”正如 DeepMind 研究负责人所总结的那样——智能的未来并不只依赖更大规模的暴力堆砌,也依赖优雅而高效的表征方式。EmbeddingGemma 2 正是这一理念在端侧的一次重要落地。
## Notable quotes > [00:00](https://www.bilibili.com/video/BV1PYHD6uExR?t=0s) 把万物变成坐标
> [00:00](https://www.bilibili.com/video/BV1PYHD6uExR?t=0s) 五模态、一个空间
> [01:59](https://www.bilibili.com/video/BV1PYHD6uExR?t=119s) 拆着装
> [01:59](https://www.bilibili.com/video/BV1PYHD6uExR?t=119s) 崩了 13 分
> [03:13](https://www.bilibili.com/video/BV1PYHD6uExR?t=193s) 嵌入模型是最不该依赖闭源商业托管服务的类型 — Simon Willison
> [04:16](https://www.bilibili.com/video/BV1PYHD6uExR?t=256s) 冷水三盆
> [05:17](https://www.bilibili.com/video/BV1PYHD6uExR?t=317s) 我要跟 Spotlight 说再见了
> [05:17](https://www.bilibili.com/video/BV1PYHD6uExR?t=317s) 以后你手机里的向量索引,可能比跑它的 AI 模型还大。模型是造坐标的工具,坐标本身才是资产
> [05:17](https://www.bilibili.com/video/BV1PYHD6uExR?t=317s) 智能的未来并不只依赖更大规模的暴力堆砌,也依赖优雅而高效的表征方式
## Mentioned Google DeepMind, EmbeddingGemma 2, Gemma, Hacker News, Apache 2.0, Matryoshka Representation Learning, Simon Willison, Google Pixel, Mac, Ollama, Immich, Model Context Protocol (MCP), ChatGPT, Spotlight
## Video description 10月6日,谷歌 DeepMind 发布 EmbeddingGemma 2:一个把文字、代码、图片、视频、音频全部映射到同一个 768 维向量空间的嵌入模型。740M 参数,手机上就能跑,Apache 2.0 完全开源,Ollama 一行命令拉下来。
它能干什么?用"孩子在水里笑"这句话,搜到你相册里那张照片;用一段文字,定位一段视频的时刻;全程本地运行,断网可用,照片不用上传。
这期视频讲透六件事:
一,嵌入模型是什么。万物变成坐标,语义相近就是坐标相近,搜索变成比距离。
二,架构。三件套可以拆着装:纯文本 270M,加视觉 440M,加音频 570M,全模态 740M,用不到的编码器不进内存。手机 270M 编查询,服务器 740M 编文档,向量直接互通。
三,为什么开发者兴奋。上一代 Gemma 许可证被吐槽一年,这代直接 Apache 2.0;Pixel 上 191MB 内存跑文本模式;Hacker News 417 赞,是上一代的近十倍。
四,诚实账本。文本能力原地踏步(61.15 到 61.36),真正涨的是代码检索(68.76 到 78.68);官方语义路由示例被人实测翻车,置信度只有 0.22;所有性能数字都是谷歌自报。
五,边界。没有 OCR,音乐检索不适用,第三方复测还没有。
六,真实场景。律师拿它搜案卷照片,自托管相册 Immich 社区求接入,Mac 本地知识层配 MCP 让 ChatGPT 直接查你的电脑。
一句话总结:以后你手机里的向量索引,可能比跑它的 AI 模型还大。模型是造坐标的工具,坐标本身才是资产。
00:05 几千张照片里,怎么搜那一句话 00:48 嵌入是什么:万物变坐标 01:59 三件套架构与套娃维度 03:13 开发者为什么兴奋:三件事 04:16 冷水三盆:翻车与边界 05:17 它真正改变什么:三个场景
[Source](https://www.bilibili.com/video/BV1PYHD6uExR)