Odyssey推出世界模型Odyssey-3 凭20小时数据跑通复杂路况闭环驾驶
AI技术投降派
冻结通用物理底座并以少量示教数据适配硬件的架构正在开启物理AI的GPT时刻,终结了具身设备必须从零收集海量数据训练的旧范式。
AI-assisted summary of 学物理的AI来了:20小时数据,真实道路闭环驾驶 — original source. Check the original for full context.
Source published:
Key ideas
- Odyssey 发布基础世界模型 Odyssey-3:世界模型首家独角兽 Odyssey 推出新底座,区别于单纯渲染素材的视频生成器,该模型作为“学习型动力系统”,专门模拟可施加动作交互的三维物理环境。 (0:00)
- 物理与环境基准跑分领先:在考察物理规律的 Physics-IQ 评测中,Odyssey-3 Pro 斩获已报告最高分 66.1 分;在 WorldMark 官方自测中拿下四个类别中的三个第一,但第一人称真实场景落后于 Lyra 2.0。 (1:53)
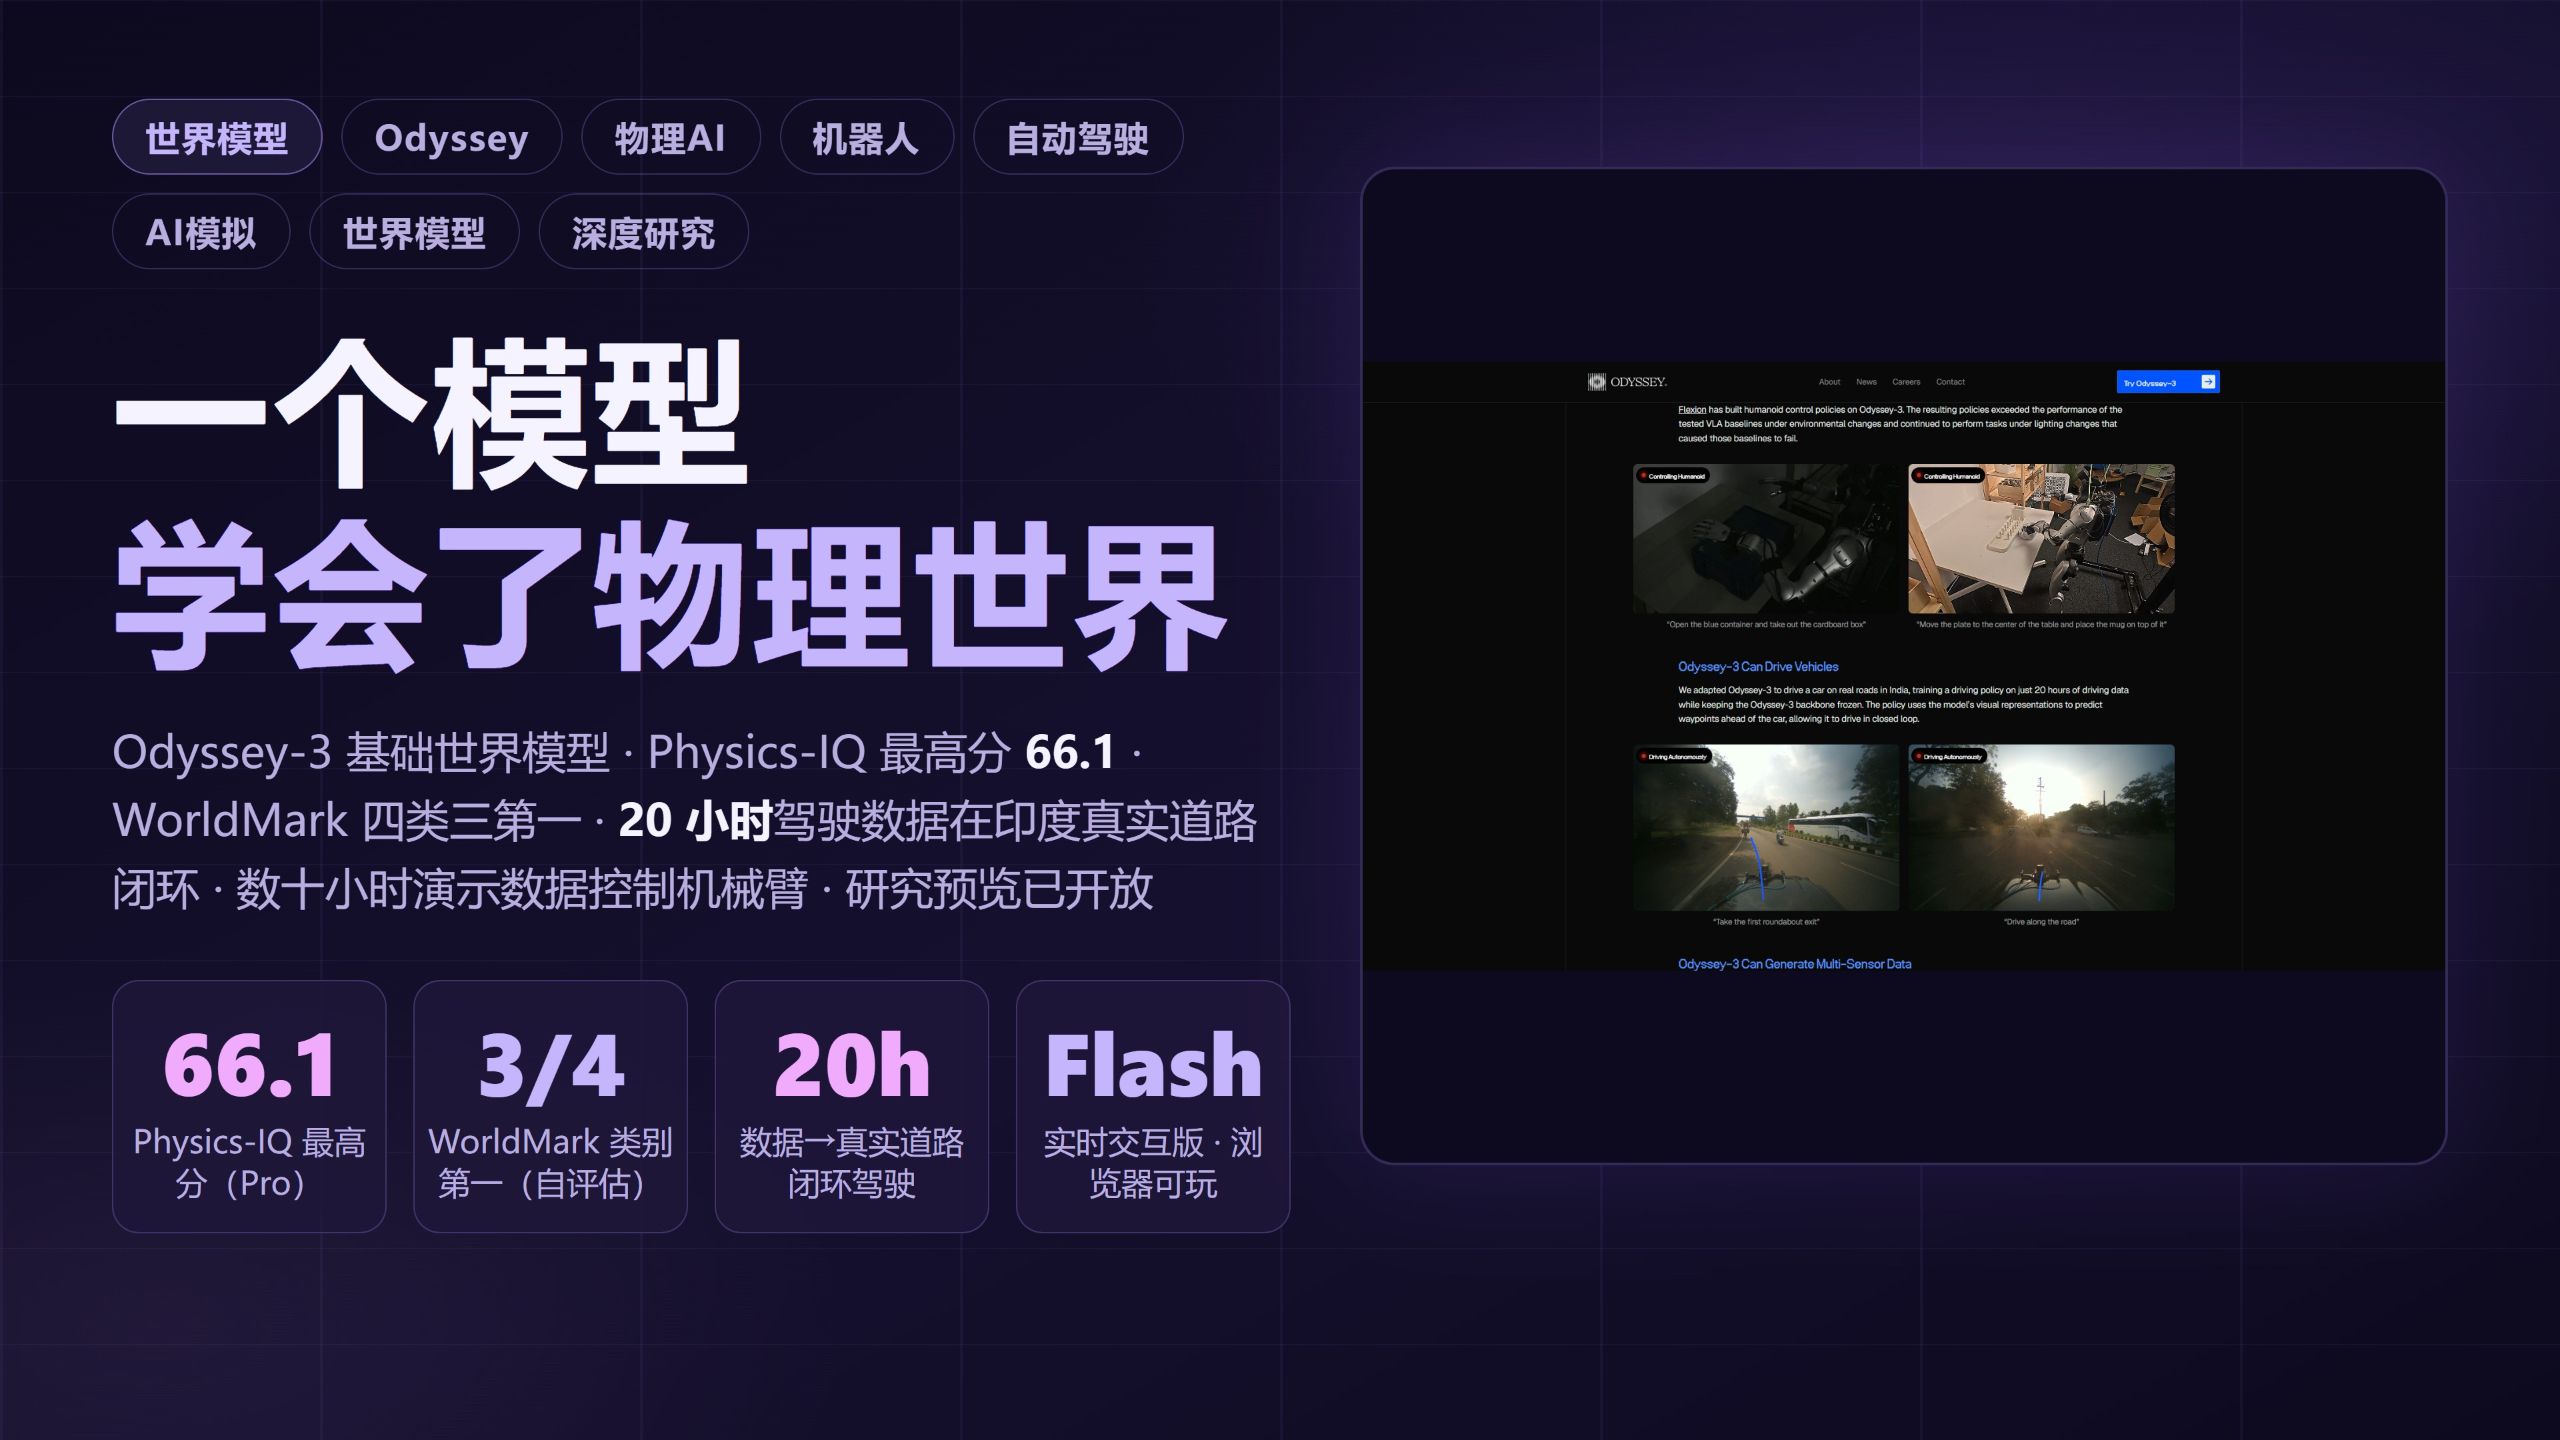
- 20 小时数据实现真实道路闭环驾驶:在冻结基础模型主干的前提下,仅用 20 小时印度道路驾驶数据预测路径点即可跑通闭环自动驾驶,且微调 100 步即可实现三路车载环视视角联合生成。 (3:07)
- 实体机器人展现物理自纠错与高鲁棒性:数十小时演示数据训练的机械臂具备未示教的抓空重试等自愈能力;合作方 Flexion 的人形机器人在光照突变扰动下仍平稳作业,超越传统 VLA 基准。 (3:07)
- 物理 AI 迈向通用底座范式:行业正转向“大基础主干 + 小动作解码器”,但目前在线预览版分辨率仅 832×480,工业级高可靠性落地仍需时间验证。 (4:55)
Detailed notes
## Background 该视频由B站UP主“AI技术投降派”于2026年10月9日发布。视频围绕世界模型赛道独角兽 Odyssey 推出的基础世界模型 Odyssey-3 展开,结合官方发布与跑分数据,深度拆解其与视频生成器的本质区别、基准评测成绩、真机部署表现以及物理 AI 面临的行业拐点。
## TL;DR 视频系统解析了基础世界模型 Odyssey-3 的技术突破与应用价值。该模型通过扩散 Transformer、自回归扩展与蒸馏技术,不仅在物理评测 Physics-IQ 与 WorldMark 中斩获顶尖成绩,还展现出极强的通用表征能力,仅凭几十小时甚至20小时的数据便完成了机械臂自纠错操作、人形机器人抗光照扰动以及印度复杂道路的闭环自动驾驶。博主认为这标志着物理 AI 迎来了类似大语言模型“GPT时刻”的底座范式迁移,但同时也理性指出了基准自测与实时预览分辨率受限等现实差距。
## Atmosphere & style 整期视频节奏明快、条理分明,博主操着技术极客特有的干练语调,带着强烈的兴奋感将晦涩的动力系统与蒸馏架构拆解得通俗易懂。叙事风格硬核而敏锐,在为20小时闭环驾驶等技术震撼喝彩的同时,又保持着清醒的批判性,主动挑出榜单落后项与自测局限。观感既像是一场前沿技术的硬核拆解会,又带着见证具身智能底层范式巨变的激昂与真实感。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1nkps6cEbs?t=0s) Odyssey 发布基础世界模型 Odyssey-3:世界模型首家独角兽 Odyssey 推出新底座,区别于单纯渲染素材的视频生成器,该模型作为“学习型动力系统”,专门模拟可施加动作交互的三维物理环境。 - [01:53](https://www.bilibili.com/video/BV1nkps6cEbs?t=113s) 物理与环境基准跑分领先:在考察物理规律的 Physics-IQ 评测中,Odyssey-3 Pro 斩获已报告最高分 66.1 分;在 WorldMark 官方自测中拿下四个类别中的三个第一,但第一人称真实场景落后于 Lyra 2.0。 - [03:07](https://www.bilibili.com/video/BV1nkps6cEbs?t=187s) 20 小时数据实现真实道路闭环驾驶:在冻结基础模型主干的前提下,仅用 20 小时印度道路驾驶数据预测路径点即可跑通闭环自动驾驶,且微调 100 步即可实现三路车载环视视角联合生成。 - [03:07](https://www.bilibili.com/video/BV1nkps6cEbs?t=187s) 实体机器人展现物理自纠错与高鲁棒性:数十小时演示数据训练的机械臂具备未示教的抓空重试等自愈能力;合作方 Flexion 的人形机器人在光照突变扰动下仍平稳作业,超越传统 VLA 基准。 - [04:55](https://www.bilibili.com/video/BV1nkps6cEbs?t=295s) 物理 AI 迈向通用底座范式:行业正转向“大基础主干 + 小动作解码器”,但目前在线预览版分辨率仅 832×480,工业级高可靠性落地仍需时间验证。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1nkps6cEbs?t=0s) 世界模型与视频生成模型的本质差异在于“可行动的物理环境模拟”,能够响应动作并在三维空间中按物理法则演化,而非仅仅渲染逼真像素。 - [00:00](https://www.bilibili.com/video/BV1nkps6cEbs?t=0s) Odyssey-3 采用“扩散 Transformer 基础生成 + 教师强制因果掩码自回归扩展 + 对抗蒸馏少步推理”的三阶段技术管线。 - [00:00](https://www.bilibili.com/video/BV1nkps6cEbs?t=0s) 蒸馏后的少步版本 Odyssey-3 Flash 实现了浏览器端的实时运行,支持多视角环境导航及自由镜头移动。 - [01:53](https://www.bilibili.com/video/BV1nkps6cEbs?t=113s) Physics-IQ 物理基准评测涵盖流体力学、光学与热力学等多项机制,Odyssey-3 Pro 依靠“8 选 1”采样策略跑出 66.1 分的已报告最高成绩。 - [01:53](https://www.bilibili.com/video/BV1nkps6cEbs?t=113s) 官方客观披露了跑分渐进过程:基础提示词下仅 51.8 分,经过提示词增强与采样策略优化后才显著提升至 66.1 分。 - [01:53](https://www.bilibili.com/video/BV1nkps6cEbs?t=113s) WorldMark 评测中斩获三项头名,但该结果为官方自测,且在最硬核的第一人称真实场景中仅获 80.6 分,位列第三并落后于 Lyra 2.0。 - [03:07](https://www.bilibili.com/video/BV1nkps6cEbs?t=187s) 机械臂在数十小时数据训练后展现出自发涌现的物理自愈行为,如抓空后重新调整夹爪姿态、掉落物品自主捡回等。 - [03:07](https://www.bilibili.com/video/BV1nkps6cEbs?t=187s) 面对环境光照剧烈变化等视觉分布偏移扰动,基于 Odyssey-3 策略的人形机器人稳定性显著超越传统 VLA 基线方案。 - [03:07](https://www.bilibili.com/video/BV1nkps6cEbs?t=187s) 在复杂混乱的印度开放道路上,团队保持大模型主干完全冻结,仅利用其视觉表征预测路径点,即以 20 小时数据实现闭环驾驶。 - [03:07](https://www.bilibili.com/video/BV1nkps6cEbs?t=187s) 多视角泛化能力突出,接入三路车载摄像头微调训练 100 步即可联合生成协同的多机位驾驶视频序列。 - [04:14](https://www.bilibili.com/video/BV1nkps6cEbs?t=254s) 训练数据由带动作标注的互联网视频、对齐手柄键鼠输入的游戏录像以及带字幕的刚体仿真数据三大核心构成。 - [04:14](https://www.bilibili.com/video/BV1nkps6cEbs?t=254s) 商业与工程路线上确立了“大基础模型主干 + 小动作解码器”架构,具身硬件厂商无需从头训练庞大网络,只需适配轻量解码器。 - [04:55](https://www.bilibili.com/video/BV1nkps6cEbs?t=295s) 通用物理基础模型的出现正在重构具身智能研发范式,其发展形态与自然语言模型当年的 GPT 跃迁时刻高度相似。 - [04:55](https://www.bilibili.com/video/BV1nkps6cEbs?t=295s) 目前开放的研究预览版分辨率仅 832×480,且在物理长程因果一致性与确定性上距离严苛生产环境仍有显著差距。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1nkps6cEbs?t=0s) 一个模型,学会了物理世界与交互本质
世界模型赛道迎来了里程碑式的事件。10月8日,曾深耕自动驾驶技术长达十年的创业团队、同时也是世界模型赛道首家估值跻身独角兽的 Odyssey 公司,正式推出了其基础世界模型 Odyssey-3,并将其标榜为迄今为止最强大的版本。本次发布会核心拿出了三个极具冲击力的数据:在物理基准评测 Physics-IQ 中斩获已报告最高分 66.1 分;在世界模型基准评测 WorldMark 的四个类别中横扫三个第一;更震撼的是,仅借助区区 20 小时的驾驶数据,就在交通极其复杂的印度真实道路环境下跑通了闭环自动驾驶。
很多业内人士常将世界模型与 Sora 这类视频生成模型混淆,但两者的本质迥异:视频生成模型的核心是“渲染素材”,生成的画面固然极其逼真惊艳,却缺乏行动交互能力;而世界模型的目标是“模拟一个可行动的物理环境”。在世界模型中,“你往东走,世界就往东展开;你碰到一个杯子,杯子就会依照物理规律倒下”。Odyssey-3 在技术层面被定义为一个“学习型动力系统”(learned dynamical system),专门用于预测物体如何在三维空间中运动、发生交互,以及环境局势如何随时间推移而真实演化。
为了实现这一目标,Odyssey-3 的技术架构采用了清晰的三步走策略:
```mermaid flowchart TD accTitle: Odyssey-3 三阶段技术实现管线 accDescr: 展现模型从多步视频扩散Transformer,到因果掩码自回归扩展,再到分布匹配与对抗蒸馏得到实时版本的过程。 subgraph S1["第一阶段:基础生成"] A["多步视频扩散 Transformer<br/>(Diffusion Transformer)"] --> B["时间解析提示 + 控制引导"] end subgraph S2["第二阶段:自回归扩展"] B --> C["教师强制 (Teacher Forcing)<br/>+ 因果掩码 (Causal Masking)"] C --> D["自回归扩展:接续历史观测预测未来"] end subgraph S3["第三阶段:高效蒸馏部署"] D --> E["分布匹配 + 对抗蒸馏"] E --> F["少步实时版本:Odyssey-3 Flash<br/>(浏览器直接交互 / 多视角导航)"] end ```
- **第一阶段**:构建多步视频扩散 Transformer(Diffusion Transformer),结合时间解析(time-resolved)的提示词与控制信号来引导世界的动态展开。 - **第二阶段**:引入教师强制(teacher forcing)与因果掩码(causal masking),将模型扩展为具有自回归特性的架构,使其能够基于过往的物理观测结果无缝接续预测未来的世界状态。 - **第三阶段**:在后训练阶段采用分布匹配(distribution matching)与对抗蒸馏(adversarial distillation),压缩生成步数,最终交付名为 Odyssey-3 Flash 的少步实时运行版本。用户可以在浏览器中直接体验该版本,且支持第一人称、第三人称环境导航,并允许自由且独立地移动镜头视角。
[01:53](https://www.bilibili.com/video/BV1nkps6cEbs?t=113s) 两份成绩单:Physics-IQ 66.1 与 WorldMark 三类第一
评估 Odyssey-3 的能力需要客观审视两份关键跑分成绩单。第一份是专门考察物理规律理解的 Physics-IQ,该基准由 Ananke Labs 与 Google DeepMind 联合推出,核心任务是让模型无缝续写真实的物理实验视频,深度考察流体动力学、光学、固体力学、电磁学以及热力学等复杂物理机制。在该榜单上,Odyssey-3 Pro 取得了 66.1 分的成绩,大幅压过了第二名的 Black Forest Labs(FLUX.1/FLUX 系列)以及英伟达的 Cosmos 系列模型。值得肯定的是,官方非常坦诚地披露了不同推理配置下的渐进性能表现:在未经优化的基础提示词下,Odyssey-3 仅有 51.8 分;经过提示词增强后提升至 61.6 分;只有开启“8 选 1”采样策略(Best-of-8 sampling)的 Pro 版,最终才冲上了 66.1 的峰值。
第二份基准是 WorldMark,主要评估模型的指令遵循度、视觉渲染质量以及对世界状态的记忆持久性。在官方测试的四个大类中,Odyssey-3 斩获了三项头名: - **第一人称风格化(First-person Stylized)**:得分 77.2,排名第一。 - **第三人称真实(Third-person Realistic)**:得分 79.0,排名第一。 - **第三人称风格化(Third-person Stylized)**:得分 76.3,排名第一。
不过针对 WorldMark 的战绩,博主明确指出了两处需要清醒客观看待的细节:首先,该评测是由 Odyssey 官方团队自行跑通评测脚本得出的自测结果;其次,在最硬核的“第一人称真实(First-person Realistic)”类别中,Odyssey-3 仅拿到 80.6 分排在第三位,明显落后于 Lyra 2.0 所斩获的 84.4 分。
[03:07](https://www.bilibili.com/video/BV1nkps6cEbs?t=187s) 上真机器:机械臂自纠错、人形机器人与20小时道路闭环
相较于纯视觉基准,Odyssey-3 在物理硬件系统上的实机演示展现出了更具说服力的通用控制潜力。
在工业与机械臂操作中,系统仅仅投喂了数十个小时的机器人演示数据进行训练,机械臂便能稳定执行“将麦片倒入碗中”以及“把螺丝盒精准关紧”等精细长程动作。最让人惊喜的是其具备未在训练集中出现过的自纠错与自愈行为(recovery behaviors):如果机械爪意外抓空,它会主动重新调整夹爪的开合姿态;如果抓取的物体不慎掉落在了非预期的奇怪角落,它能够自主识别并重新捡回,展现出了真正的物理鲁棒性。
在人形机器人领域,合作方 Flexion 利用 Odyssey-3 构建控制策略。在面对环境扰动的压力测试中,其鲁棒性直接超越了基线视觉-语言-动作(VLA)模型。在演示中,当现场光照条件突然剧烈变化时,传统的 VLA 基线方案由于视觉分布偏移直接失效瘫痪,而基于 Odyssey-3 策略的人形机器人依然能不受干扰地平稳完成既定任务。
整场发布中最夸张的应用在于真实道路驾驶。在路况极其混乱繁杂的印度真实开放道路上,团队仅灌入 20 小时的驾驶数据训练控制策略。在此过程中,**Odyssey-3 的庞大基础模型主干保持完全冻结(frozen backbone)**,策略网络直接借用其富含物理规律的深层视觉表征来预测自车前方的运动路径点(waypoints),成功实现了复杂的闭环自主驾驶,不仅能灵活变道穿梭,甚至还能从路网环岛的第一个出口丝滑驶出。多视角泛化方面同样惊艳:系统直接接入自动驾驶常用的三路车载环视摄像头,仅仅微调训练 100 个 step,模型便能立刻联合生成三个不同视角的协同驾驶视频序列。
训练出这一通用物理核心的数据配方主要由三大源头交织构成: - **海量互联网视频**:全部配有时间轴精细对齐的事件级动作标注(time-localized annotations)。 - **大规模游戏录像**:深度对齐了精准的手柄或键盘控制输入流(controller inputs)。 - **带字幕描述的刚体物理模拟环境数据**:提供严谨可控的力学真值。
用博主的大白话翻译,这套数据组合拳的本质就是“让模型在同一个表征空间里,既看懂了世界本身长什么样,又彻底搞清了输入某种动作后世界会产生何种连锁物理反应”。在商业版图上,Odyssey 迄今已斩获约 3.1 亿美元累计融资,是世界模型赛道名副其实的独角兽领跑者。此次技术路线彻底明晰为**“大基础模型主干 + 小动作解码器(Foundation Model + Action Decoders)”**——基础物理世界模型主干冻结不动,下游各家具身智能与机器人厂商只需基于通用底座训练自身硬件的小解码器即可。此外,官方提及未来也有切入无人机控制的合作意向,不过目前暂未放出实机演示。
[04:55](https://www.bilibili.com/video/BV1nkps6cEbs?t=295s) 物理 AI 的 GPT 时刻与现实局限
从技术范式的演进来看,Odyssey-3 标志着“物理 AI(Physical AI)的基础模型时刻”已经悄然来临。以往具身智能的死穴在于每一台全新的机器人、每一款不同的机械结构,都必须在真实物理世界里从头收集天文数字般的真实数据来重新灌注训练;而现在的逻辑被彻底改写为:由一个通晓通用物理规律的庞大基础底座承载世界常识,下游硬件只要投喂几十个小时的少量示教数据,就能快速让新身体适配新环境。这种技术重构的路径与形态,与当年自然语言大模型经历从专用小模型走向 GPT-3 通用底座的跃迁完全是“同一个形状”。
但博主也特别提醒技术同行保持冷静与克制:首先,WorldMark 的榜单分数存在官方自测的水分;其次,目前开放的研究预览版实时分辨率仅有 832×480,画质相对有限;世界模型要想真正步入严苛的工业级与消费级生产环境,在可靠性、确定性以及超长程因果一致性上依然有很长的路要走。对这一技术感兴趣的用户可直接访问其官方演示体验网址 `experience.odyssey.systems` 在浏览器中亲自上手操作。视频最后,博主呼吁观众一键三连,并在评论区探讨世界模型究竟会率先在自动驾驶、机械臂还是人形机器人上迎来真正的规模化产业落地。
## Notable quotes > [00:00](https://www.bilibili.com/video/BV1nkps6cEbs?t=0s) 你往东走,世界就往东展开;你碰到一个杯子,杯子就会依照物理规律倒下 — AI技术投降派
> [00:00](https://www.bilibili.com/video/BV1nkps6cEbs?t=0s) 仅借助区区 20 小时的驾驶数据,就在交通极其复杂的印度真实道路环境下跑通了闭环自动驾驶 — AI技术投降派
> [03:07](https://www.bilibili.com/video/BV1nkps6cEbs?t=187s) 如果机械爪意外抓空,它会主动重新调整夹爪的开合姿态;如果抓取的物体不慎掉落在了非预期的奇怪角落,它能够自主识别并重新捡回 — AI技术投降派
> [03:07](https://www.bilibili.com/video/BV1nkps6cEbs?t=187s) Odyssey-3 的庞大基础模型主干保持完全冻结(frozen backbone),策略网络直接借用其富含物理规律的深层视觉表征来预测自车前方的运动路径点 — AI技术投降派
> [03:07](https://www.bilibili.com/video/BV1nkps6cEbs?t=187s) 让模型在同一个表征空间里,既看懂了世界本身长什么样,又彻底搞清了输入某种动作后世界会产生何种连锁物理反应 — AI技术投降派
> [03:07](https://www.bilibili.com/video/BV1nkps6cEbs?t=187s) 大基础模型主干 + 小动作解码器(Foundation Model + Action Decoders) — AI技术投降派
> [04:55](https://www.bilibili.com/video/BV1nkps6cEbs?t=295s) 由一个通晓通用物理规律的庞大基础底座承载世界常识,下游硬件只要投喂几十个小时的少量示教数据,就能快速让新身体适配新环境 — AI技术投降派
> [04:55](https://www.bilibili.com/video/BV1nkps6cEbs?t=295s) 这种技术重构的路径与形态,与当年自然语言大模型经历从专用小模型走向 GPT-3 通用底座的跃迁完全是“同一个形状” — AI技术投降派
## Mentioned Odyssey, Odyssey-3, Odyssey-3 Pro, Odyssey-3 Flash, Physics-IQ, WorldMark, Ananke Labs, Google DeepMind, Black Forest Labs, FLUX.1, 英伟达 Cosmos, Lyra 2.0, Flexion, Sora, GPT-3
## Video description 世界模型赛道出了个大新闻。十月八号,造了十年自动驾驶的团队、赛道首家独角兽 Odyssey 公司,发布基础世界模型 Odyssey-3。它不是视频生成器,是模拟环境:你往东走世界往东展开,碰倒杯子,杯子按物理规律倒下。Physics-IQ 物理基准拿到六十六点一的最高分;WorldMark 四个类别三个第一;最夸张的是只用二十小时驾驶数据,就在印度真实道路上实现了闭环驾驶。研究预览已开放,浏览器直接玩。这期拆开讲清楚。
00:05 一个模型,学会了物理世界 00:50 世界模型和视频生成器的根本区别 01:53 两份成绩单:Physics-IQ 66.1 与 WorldMark 三第一 03:07 上真机器:机械臂自纠错、人形、20小时闭环驾驶 04:14 训练数据三源与独角兽背景 04:55 我的判断:物理 AI 的 GPT 时刻形状
成绩单要分两份看。Physics-IQ 是 Anates Labs 和 DeepMind 的基准,让模型续写真实物理实验,考流体、光学、力学、磁学、热力学,Odyssey-3 Pro 拿六十六点一,已报告最高分,压过 FLUX 3 和英伟达 Cosmos3。WorldMark 四类三第一,但要诚实说明两点:这是官方自评估;第一人称真实类别它排第三,输给 Lyra 2.0。
物理系统演示最有说服力。机械臂只用数十小时演示数据,就能倒麦片进碗、关螺丝盒,还会演示里没有的恢复行为,抓空了重调夹爪,东西掉了捡回来。合作方 Flexion 用它建人形控制策略,灯光一变 VLA 基线失效,它照常干活。驾驶那段,主干冻结,用模型视觉表征预测路径点,环岛第一个出口说走就走。还有个细节,接三个车载摄像头,训练一百步就能三视角联合生成。
我的判断,这是物理 AI 的一次基础模型时刻。以前每台机器人要海量真实数据从头训练,现在一个学会通用物理的主干,几十小时数据适配新身体,和语言模型的 GPT 时刻是同一个形状。清醒的部分:基准有自评成分,实时预览只有 832×480,离生产可靠性还有距离。感兴趣的现在就去 experience.odyssey.systems 亲自玩。三连关注,评论区聊聊世界模型会先落地在哪台机器上。
官方公告:odyssey.systems/meet-odyssey-3
[Source](https://www.bilibili.com/video/BV1nkps6cEbs)