开发者用纯C打造蜂鸟引擎 消费级电脑运行2.8万亿参数模型
AI技术投降派
通过引入权重即时编译与显存内存硬盘三层流水线调度,Colibri 引擎彻底打破了千亿参数模型对昂贵企业级显卡集群的依赖,让消费级硬件在本地完整运行顶级 MoE 大模型成为现实。
AI-assisted summary of 硬盘就是你的机房:37.7k星纯C引擎跑万亿模型 — original source. Check the original for full context.
Source published:
Key ideas
- 纯 C 语言开源推理引擎 Colibri 斩获 37.7k 星,主打零外部依赖,由单人在 25GB 内存笔记本上独立写出,首次实现消费级硬件免显卡运行 744B 到 2.8T 参数的前沿 MoE 大模型。 (0:00)
- 核心机制提出“权重的 JIT”调度,构建显存、内存与硬盘三层流水线,配合统计学习型热存与前向一层预测预取,使专家预取命中率达到 71.6%,单 Token 内绝不重复读取相同专家。 (1:33)
- 全面支持包括 Kimi K3、GLM-5.2/5.3、DeepSeek-V4 Flash 在内的 9 个模型家族,全系均无需 GPU,仅需 32GB 内存与 1.6TB 硬盘即可调动 2.8 万亿参数巨兽。 (2:24)
- 团队恪守“慢但正确(slow but correct)”的忠实性铁律,拒绝砍精度和魔改路由,逐 Token 对齐参考实现,并完整实现 MLA 将 KV 状态开销压缩 57 倍。 (3:11)
- 构建了覆盖 0.05 至 6.8 tok/s 的平滑速度谱系,支持双 NVMe 并发提速 37.5% 与 Vulkan 老卡利旧,推动“硬盘即机房”的主权推理范式。 (4:50)
Detailed notes
## Background 该视频由 Bilibili 频道“AI技术投降派”于 2026 年 10 月 10 日发布。简介介绍了在 GitHub 上斩获 37.7k 星的纯 C 语言零依赖开源项目 Colibri(蜂鸟)——作者在单台 12 核/25GB 内存笔记本上独立开发,通过“权重的 JIT”动态调度思路,让 744B 至 2.8T 的巨型 MoE 模型能够完全脱离昂贵显卡并在消费级硬件上运转,倡导“你的硬盘就是你的机房”的主权推理理念。
## TL;DR Colibri 将 MoE 模型的显存瓶颈从“全量装不下”重塑为“数据流调度好”,构建了显存、内存与固态硬盘的三层统一存储流水线,依托学习型热存、一层感知预取和单 Token 读取去重实现按需即时读取。该引擎覆盖从入门级 OLMoE 到 2.8 万亿参数 Kimi K3 等九大模型家族,且全程无需独立显卡即可平民化运行。在恪守“宁慢勿错”的忠实性铁律下,项目严格对齐原版前向计算与 MLA 注意力压缩,并兼顾 Vulkan 兼容陈旧老卡、双 NVMe 并发和局域网分布式集群。从 25GB 笔记本冷启动的 0.05 tok/s 到顶配多卡常驻的 6.8 tok/s,它证明了硬件预算只决定吐字快慢,普通用户同样拥有完整运行万亿顶级模型的算力主权。
## Atmosphere & style 视频洋溢着纯粹的极客浪漫与扎实的硬核工程底色,将“一人、一机、数千次提交”的孤勇开发背景与抽丝剥茧的技术解构完美结合。讲述者态度冷静而诚恳,不仅毫不避讳 0.05 tok/s 的冷启动龟速,更坦然展示投机解码回退等失败数据,透着一种“慢但正确”的工程求真底气。整段叙事在打破巨头云端算力垄断的技术突围感中,融入了用蜂鸟微小口粮喂饱数万亿参数巨人的诗意与振奋。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1tKhR61Err?t=0s) 纯 C 语言开源推理引擎 Colibri 斩获 37.7k 星,主打零外部依赖,由单人在 25GB 内存笔记本上独立写出,首次实现消费级硬件免显卡运行 744B 到 2.8T 参数的前沿 MoE 大模型。 - [01:33](https://www.bilibili.com/video/BV1tKhR61Err?t=93s) 核心机制提出“权重的 JIT”调度,构建显存、内存与硬盘三层流水线,配合统计学习型热存与前向一层预测预取,使专家预取命中率达到 71.6%,单 Token 内绝不重复读取相同专家。 - [02:24](https://www.bilibili.com/video/BV1tKhR61Err?t=144s) 全面支持包括 Kimi K3、GLM-5.2/5.3、DeepSeek-V4 Flash 在内的 9 个模型家族,全系均无需 GPU,仅需 32GB 内存与 1.6TB 硬盘即可调动 2.8 万亿参数巨兽。 - [03:11](https://www.bilibili.com/video/BV1tKhR61Err?t=191s) 团队恪守“慢但正确(slow but correct)”的忠实性铁律,拒绝砍精度和魔改路由,逐 Token 对齐参考实现,并完整实现 MLA 将 KV 状态开销压缩 57 倍。 - [04:50](https://www.bilibili.com/video/BV1tKhR61Err?t=290s) 构建了覆盖 0.05 至 6.8 tok/s 的平滑速度谱系,支持双 NVMe 并发提速 37.5% 与 Vulkan 老卡利旧,推动“硬盘即机房”的主权推理范式。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1tKhR61Err?t=0s) Colibri 由个人开发者在 12 核 CPU / 25GB 内存笔记本上独立开发,使用纯 C 语言且零外部依赖,GitHub 斩获 37.7k 颗星。 - [00:43](https://www.bilibili.com/video/BV1tKhR61Err?t=43s) 针对 MoE 架构单词仅激活少数专家的特性(如 GLM-5.2 仅激活约 40B),Colibri 提出“权重 JIT”机制,将硬件“装不下”转变为数据流“调度好”。 - [01:33](https://www.bilibili.com/video/BV1tKhR61Err?t=93s) 统一存储层级将显存、系统内存与固态硬盘整合为三级流水线,按专家调用频率分别管理热专家、温专家与冷专家的生命周期与淘汰。 - [01:33](https://www.bilibili.com/video/BV1tKhR61Err?t=93s) 引入学习型热存持久化专家访问偏好,并基于路由转移统计规律设计前向一层预取,测试命中率达到 71.6%,单 Token 计算周期内绝不重复读盘。 - [02:24](https://www.bilibili.com/video/BV1tKhR61Err?t=144s) 覆盖 9 个主流模型家族,每个家族代码严格封装于独立 C 文件中;从小至 8GB 内存跑 OLMoE,大到 32GB 内存跑 2.8T 的 Kimi K3 均可运行。 - [02:24](https://www.bilibili.com/video/BV1tKhR61Err?t=144s) 模型矩阵全部无需独立显卡运行,推理性能的核心瓶颈彻底从 GPU 算力转变为硬盘的物理读写带宽。 - [03:11](https://www.bilibili.com/video/BV1tKhR61Err?t=191s) 坚持“内存不足可以慢,但精度和路由语义一个字不能变”原则,逐 Token 对齐官方参考实现,冷启动速度虽仅 0.05-0.1 tok/s 但保证绝对准确。 - [03:11](https://www.bilibili.com/video/BV1tKhR61Err?t=191s) 严格遵循架构原生规范实现 MLA 机制,将每个 Token 的 KV 状态浮点数从 30,000 余个压缩至 576 个,实现 57 倍压缩且不偷工减料。 - [04:01](https://www.bilibili.com/video/BV1tKhR61Err?t=241s) 内置 Vulkan 图形后端,使官方驱动停止维护的老旧显卡(如 AMD RX 580)也能参与计算分担。 - [04:01](https://www.bilibili.com/video/BV1tKhR61Err?t=241s) 支持双 NVMe 并发流式读取提速约 37.5%,并提供跨机器分摊读取压力的开箱即用局域网集群模式。 - [04:01](https://www.bilibili.com/video/BV1tKhR61Err?t=241s) 展现高度工程诚实度,如实记录多 Token 投机预测失败场景——在特定接受率区间,回退开销会导致端到端速度倒退 30%。 - [04:50](https://www.bilibili.com/video/BV1tKhR61Err?t=290s) 形成 0.05 到 6.8 tok/s 的平坦性能谱系,硬件预算仅决定性能档位,不再剥夺用户运行顶级大模型的资格。 - [04:50](https://www.bilibili.com/video/BV1tKhR61Err?t=290s) 自带专家激活热图 Web 仪表盘、OpenAI 标准兼容 API,以及精简至 6 个命令的 CLI 运维工具。 - [05:40](https://www.bilibili.com/video/BV1tKhR61Err?t=340s) 提出“主权推理”方向,打破顶级模型对昂贵云端集群的依赖,用蜂鸟式的微小硬件口粮喂饱数万亿参数的数字巨人。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1tKhR61Err?t=0s) 在家跑两万八千亿参数:Colibri 的诞生与核心逻辑
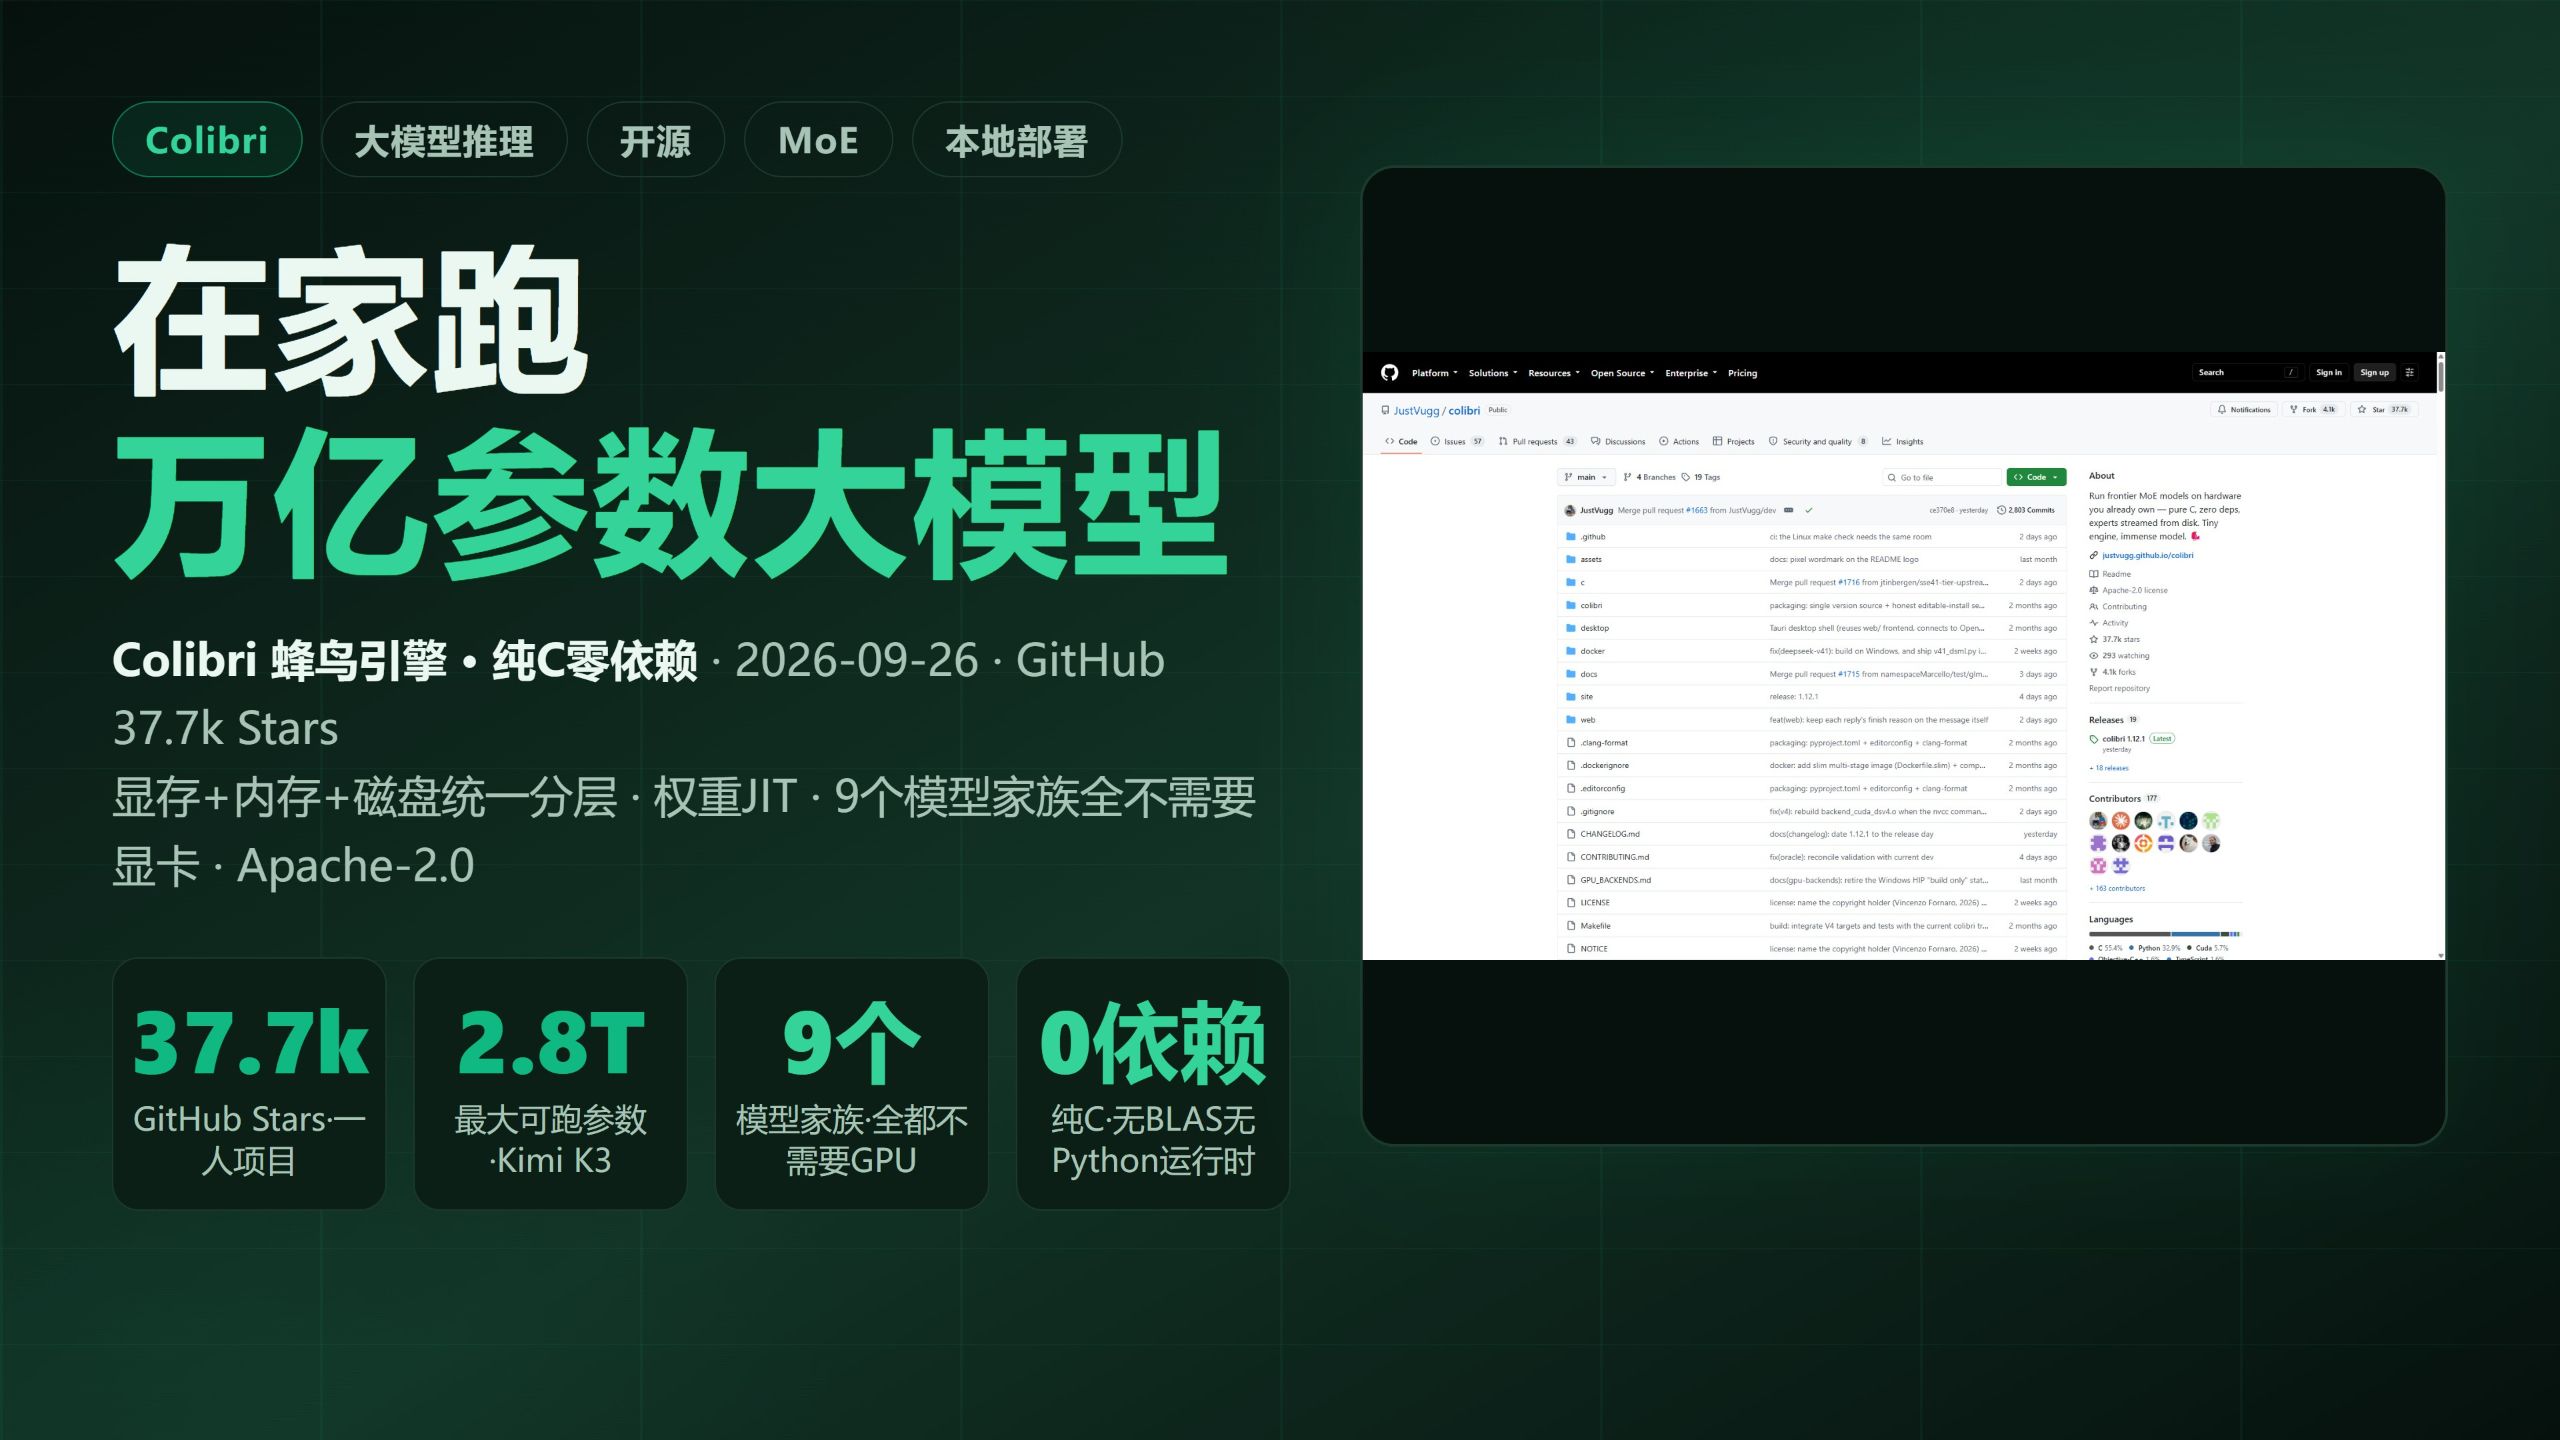
在普通用户的家用电脑上,跑一个总参数量高达 28,000 亿(2.8T)的庞然大物,这在以前几乎是天方夜谭。但在开源社区里,一个名为 Colibri(蜂鸟)的 GitHub 仓库把它变成了现实。这个项目斩获了 37.7k 颗星,采用纯 C 语言编写,实现了真正的零依赖——它既不需要繁琐臃肿的 Python 运行时环境,也不依赖任何外部数学计算库,用户直接下载编译后就能开箱即用。Colibri 的核心诉求非常纯粹:让 744B 到 2.8T 参数的前沿顶级大模型,能够平民化地跑在玩家手头现有的消费级硬件上。最富戏剧性的是它的出身背景——整个项目竟然是由作者一个人,在自己那台仅有 12 核 CPU 和 25GB 内存的普通笔记本电脑上独立一行行敲出来的。
之所以能做到这一点,在于作者重新审视了当前旗舰大模型的运行瓶颈。新一代前沿模型几乎全部倒向了混合专家架构(MoE),虽然整体参数量动辄成百上千亿甚至数万亿,但每个 token 生成时实际被激活的专家只占其中极小一部分。以 GLM-5.2 为例,生成每个词实际唤醒的参数量仅在 400 亿(40B)左右。然而,传统的推理引擎设计哲学是“全量吞吐”,必须一口气把整个模型的全部权重一次性塞进显存。面对几千亿到数万亿参数的模型,如果没有价值数十万甚至上百万元的企业级显卡集群,传统引擎连启动都做不到。
Colibri 换了一套全新的工程类比思维:编译领域的即时编译(JIT,Just-In-Time)从不会傻傻地把整个程序全量编译完毕才运行,而是执行到哪个函数才动态编译哪个函数。推理引擎同样可以按此逻辑重构:模型推理用到哪一个专家网络,引擎才即时从硬盘把它加载读取到内存中。项目将这种机制定义为“权重的即时编译”(Weight JIT)。通过这一层思维转换,硬件资源“装不下”的死局,顺理成章地被转化成了数据流“调度好”的工程管理问题。
```mermaid flowchart TD accTitle: Colibri 权重的 JIT 调度与存储层级 accDescr: 展示显存、内存、磁盘三层存储层级与路由预取机制
subgraph MemoryHierarchy ["统一存储层级与淘汰策略"] VRAM["显存 (VRAM)<br/>热专家 (Hot Experts)"] RAM["系统内存 (RAM)<br/>温专家 (Warm Experts) + 学习型热存"] NVMe["磁盘 (NVMe/SSD)<br/>冷专家 (Cold Experts) 绝不重复读取"] VRAM <-->|"淘汰 / 搬运"| RAM RAM <-->|"LRU / 预取"| NVMe end
subgraph RouterEngine ["MoE 专家路由决策"] Token["当前 Token"] --> Router["MoE 路由选择"] Router -->|"前向一层预取 (命中率 ~71.6%)"| RAM Router -->|"即时激活 (~40B)"| VRAM end ```
[01:33](https://www.bilibili.com/video/BV1tKhR61Err?t=93s) 三层流水线与三个调度设计
为了让权重 JIT 顺畅流转,Colibri 将显存、系统内存与硬盘三级存储抽象成了一个统一的层级结构(Unified Hierarchy)。整套存储流水线按照专家激活的活跃度分层驻留: - **热专家(Hot Experts)**:驻留在读写带宽最高的显存中; - **温专家(Warm Experts)**:存放在系统内存中,随时准备被调度; - **冷专家(Cold Experts)**:平日安睡在固态硬盘上,只有被点名时才触发读取。
每一层介质都维护着自己独立的生命周期与淘汰策略。在具体的调度架构中,有三个关键设计起到了决定性作用:
- **学习型热存**:除了常规的 LRU(最近最少使用)淘汰算法外,引擎增加了一个能记录用户使用习惯的机制。它会把长期交互中的专家激活偏好持久化保存在一个本地文件里,推理时直接把那些最常用的核心专家钉死在内存中,大幅削减冷启动震荡。 - **一层感知预取**:作者在实践中发现 MoE 路由并不是完全随机的,其转移规律具备极强的统计可预测性。引擎设计了前向看一层的预测预取逻辑,直接在后台提前拉取下一个可能用到的专家权重,实际测试中提前猜中的概率高达 71.6%(七成半左右)。 - **单 Token 专家读取去重**:在一个 token 生成的整个计算流水线里,任何一个被激活的专家只要被读入过一次,就绝对不会在同一个 token 周期内从硬盘重复读取第二遍。
这套调度机制当然不是毫无代价的——由于大量依赖总线和硬盘的 I/O 搬运,它的运行速度必然会受到硬件带宽的物理压制。但它换来的成果是划时代的:一台只有 25GB 内存的轻薄笔记本,终于破天荒地能把 700B+ 的超级模型稳稳当当地跑起来了。
[02:24](https://www.bilibili.com/video/BV1tKhR61Err?t=144s) 九个模型家族:全都不需要独立显卡
在模型支持矩阵上,Colibri 目前已经覆盖了 9 个主流模型家族,工程实现极为干净利落——每个家族代码严格收敛在一个独立的 C 文件中。它的跨度极其庞大:
- **入门级极小 MoE**:以 OLMoE 为代表,仅需要 7GB 磁盘空间加上 8GB 内存即可点亮运行; - **超大规模旗舰**:支持到参数量高达 2.8 万亿(2.8T)的 Kimi K3,仅需要 1.6TB 磁盘空间和 32GB 内存起步便能运转; - **中间层主力矩阵**:全面覆盖了 GLM-5.2、GLM-5.3 以及原生带视觉多模态能力的 GLM-5.3 Flash;多达 975B 参数的 Inkling;DeepSeek-V4 的两个 Flash 衍生版本;以及 Qwen(千问)的两代核心 MoE 架构。
在整个适配支持表格里,最震撼人心的核心说明只有一句话:“这些模型没有一个需要显卡(GPU)”。拥有一块高性能显卡固然能够利用显存换取更快的吐字速度,但没有显卡同样能完整运行。推理性能的瓶颈彻底从 GPU 算力转变为硬盘的物理读写速度:在高速 NVMe 固态硬盘配合暖缓存的状态下,可以做到每秒吐出几个词(tokens/s);哪怕换成慢速低端硬盘,也能稳定维持在每秒零点几个词的产出。
[03:11](https://www.bilibili.com/video/BV1tKhR61Err?t=191s) 慢但对:严苛的忠实性硬规矩
业界的许多极端显存压缩或低配置量化方案,为了跑出漂亮的跑分,往往会悄悄魔改前向计算:通过极端砍精度、暴力裁剪注意力头或者近似路由算法来硬凑速度,导致模型吐出来的数值偏差极大、智商严重受损。Colibri 在工程上立下了一条铁律:**“内存不足可以慢,但模型的精度和路由语义一个字都不能变。”**
为了保证绝对的忠实性,Colibri 的前向计算是直接对照原版官方参考实现,进行逐个 token 的数学校验与对齐,确保计算出的 Logits 和激活流与原模型分毫不差。在作者那台用来编写主力代码的 25GB 内存开发机上,运行超大模型冷启动阶段的吐字速度只有 0.05 到 0.1 tok/s,相当于一两分钟才出一个词。但作者在官方文档里非常坦然地写下了一句评价:"slow but correct"(慢,但正确)。
此外,项目在注意力机制处理上也展现了扎实的底层工程功底。它严格遵循模型的原始设计,实现了 MLA(Multi-head Latent Attention)机制,将注意力中的键值(KV)状态体积压缩了整整 57 倍——把每个 token 的 KV 存储开销从 30,000 多个浮点数骤降到 576 个。这是完全遵循原版架构规范的高效实现,绝非偷工减料地砍功能。
[04:01](https://www.bilibili.com/video/BV1tKhR61Err?t=241s) 硬件杂食与诚实的工程测试
Colibri 对运行环境表现出了近乎“杂食”的包容度。它一共内置了四套针对不同计算平台的硬件后端,其中通过 Vulkan 打造的通用图形接口后端,专门用来“收留”那些早被原厂驱动抛弃的陈旧老卡。例如一代神卡 AMD Radeon RX 580,即便官方驱动早已停止更新维护,在 Colibri 的 Vulkan 引擎下依然能够正常参与计算分担。
在硬盘层面,引擎支持多块 NVMe 固态硬盘构建并发流式读取通道。实测数据显示,两块 NVMe 组成阵列并发读取,能将整体推理速度直接拉升将近 37.5%(近四成)。如果用户家里有多台闲置的老旧电脑,Colibri 还支持开箱即用的本地局域网集群模式:通过一个 Coordinator(协调节点)指挥若干 Worker(计算节点),跨机器分摊硬盘读取和权重调度压力。
在投机解码(Speculative Decoding)的设计上,作者的态度展现了极高的工程诚实度。项目引入了多 token 预测机制,理论上每一步可以投机预测 2 到 3 个 token。然而作者并没有报喜不报忧,而是如实将算法失效的反面数据完整记录在开发文档中:测试表明在某个特定接受率区间内,投机失败导致的回退开销,反而会让整体端到端推理速度倒退 30%(慢三成)。这种主动将“翻车”数据与失败边界公之于众的做法,远比商业宣传中吹嘘的基准跑分更为真实可靠。
[04:50](https://www.bilibili.com/video/BV1tKhR61Err?t=290s) 速度谱系与“主权推理”的新大陆
面对不同配置,Colibri 给出了一条极其直观的性能速度谱系。随着玩家投入的硬件配置不同,性能表现展现出平滑的梯度:
| 硬件配置方案 | 运行状态 | 推理速度 (tokens/s) | |:--- |:--- |:--- | | 顶级配置:6 × NVIDIA RTX 5090 | 权重全量常驻显存 | 5.8 – 6.8 tok/s | | 大内存无显卡:128GB 内存纯 CPU 台式机 | 暖缓存状态 | ~1.8 tok/s | | 单卡笔记本:单张 RTX 5070 Ti 移动版 | 显存 + 内存混合调度 | 1.07 tok/s 左右(一个词出头) | | 原生开发机:12 核 CPU / 25GB 内存轻薄本 | 纯依赖硬盘流式调度冷启动 | 0.05 – 0.1 tok/s 起步 |
从 0.05 到 6.8 tok/s,这条速度谱系清晰地表明:你的硬件预算仅仅决定了你落在这条性能谱系的哪一个具体切片上,但无论在哪一个档位,你都拥有把模型完整跑起来的权力。
围绕推理引擎,项目的周边生态也搭建得异常完备: - 自带 Web 网页仪表盘,能够实时动态渲染专家激活热图(Expert Heatmap)以及底层性能耗时剖析; - 原生内置兼容 OpenAI 标准的 API 接口,方便无缝接入各种前端客户端; - 配备极简的桌面命令行外壳工具,核心命令仅有精炼的六个:聊天(Chat)、起服务(Serve)、开网页(Web)、规划硬件配置(Plan)、硬件体检(Audit)以及参数调优(Tune)。
在解释为什么给引擎取名为 Colibri(蜂鸟)时,作者在文档中留下了一段极具诗意的注脚:自然界里的蜂鸟体重只有区区几克,却拥有极强的能量悬停能力,一天能够不知疲倦地穿梭探访上千朵花朵。这个引擎正是如此——它用蜂鸟般的微小系统口粮,成功喂饱了 700B 乃至数万亿参数的数字巨人。
一个人、一台老旧笔记本、2,800 次 GitHub 代码提交,换来了 37.7k 颗星的认可。这种探索代表了未来 AI 的一个全新演进方向——“主权推理”(Sovereign Inference)。顶级的大模型不应该永远只被锁在少数科技巨头昂贵的云端机房里,通过精妙的调度架构,“你的硬盘就是你的机房”。显存装不下是上一代算力的老问题,而在存储流水线里把数据调度好,才是平民运行巨型模型的新答案。
## Notable quotes > [00:43](https://www.bilibili.com/video/BV1tKhR61Err?t=43s) 权重的JIT:编译器从不编译整个程序,它也只用哪个专家读哪个 — AI技术投降派
> [00:43](https://www.bilibili.com/video/BV1tKhR61Err?t=43s) 硬件资源“装不下”的死局,顺理成章地被转化成了数据流“调度好”的工程管理问题。 — AI技术投降派
> [01:33](https://www.bilibili.com/video/BV1tKhR61Err?t=93s) 显存放热专家/内存放温的/磁盘放冷的 — AI技术投降派
> [02:24](https://www.bilibili.com/video/BV1tKhR61Err?t=144s) 这些模型没有一个需要显卡(GPU) — AI技术投降派
> [03:11](https://www.bilibili.com/video/BV1tKhR61Err?t=191s) 内存不足可以慢,但模型的精度和路由语义一个字都不能变。 — AI技术投降派
> [03:11](https://www.bilibili.com/video/BV1tKhR61Err?t=191s) slow but correct — Colibri 文档
> [04:01](https://www.bilibili.com/video/BV1tKhR61Err?t=241s) Vulkan收留被厂商抛弃的RX 580 — AI技术投降派
> [04:50](https://www.bilibili.com/video/BV1tKhR61Err?t=290s) 你的硬件预算仅仅决定了你落在这条性能谱系的哪一个具体切片上,但无论在哪一个档位,你都拥有把模型完整跑起来的权力。 — AI技术投降派
> [05:40](https://www.bilibili.com/video/BV1tKhR61Err?t=340s) 用蜂鸟式的口粮,喂饱700多B的巨人。 — AI技术投降派
> [05:40](https://www.bilibili.com/video/BV1tKhR61Err?t=340s) 你的硬盘就是你的机房。 — AI技术投降派
> [05:40](https://www.bilibili.com/video/BV1tKhR61Err?t=340s) 显存装不下是上一代算力的老问题,而在存储流水线里把数据调度好,才是平民运行巨型模型的新答案。 — AI技术投降派
## Mentioned Colibri (蜂鸟), JustVugg, GitHub, GLM-5.2, GLM-5.3, GLM-5.3 Flash, OLMoE, Kimi K3, Inkling, DeepSeek-V4, Qwen, Vulkan, AMD Radeon RX 580, NVIDIA RTX 5090, NVIDIA RTX 5070 Ti, OpenAI, Apache-2.0, AI技术投降派
## Video description 在自己家的电脑上跑一个两万八千亿参数的模型——GitHub 项目 Colibri(蜂鸟)真把这事做成了。37.7k星,纯C语言,零依赖,下载即用,让744B到2.8T的前沿模型跑在你手头的硬件上。最夸张的是出身:一个人在自己的12核/25GB内存笔记本上写出来的。
▶ 核心思路"权重的JIT":编译器从不编译整个程序,它也只用哪个专家读哪个——MoE每个词只激活一小部分(GLM-5.2只唤醒~40B),装不下从此变成调度好 ▶ 三层流水线:显存放热专家/内存放温的/磁盘放冷的,学习型热存+一层预取(命中71.6%)+绝不读第二遍 ▶ 九个模型家族全不需要GPU:小到OLMoE 7GB磁盘8GB内存,大到Kimi K3 2.8T参数1.6TB磁盘32GB内存;GLM-5.2/5.3、Inkling 975B、DeepSeek V4两代Flash、Qwen两代都在列 ▶ 忠实性硬规矩:内存不足可以慢,但精度和路由语义一个字不能变——对参考实现逐token校验;25GB开发机冷启动0.05-0.1 tok/s,文档原话"slow but correct";MLA压缩KV状态57倍 ▶ 硬件杂食:Vulkan收留被厂商抛弃的RX 580;双NVMe提速37.5%;本地集群模式分摊读取;投机解码连失败数据都如实写进文档 ▶ 速度谱系0.05→6.8 tok/s:6×RTX 5090全常驻5.8-6.8;128GB纯CPU暖态1.8;单张5070 Ti约1.07——硬件预算决定你在哪一段,但每一段都能跑
蜂鸟只有几克重却能悬停一天访千朵花——用蜂鸟式的口粮,喂饱700多B的巨人。这个方向叫主权推理:你的硬盘就是你的机房。
仓库:github.com/JustVugg/colibri(Apache-2.0,v1.12.1)
时间轴: 00:00 在家跑两万八千亿参数的模型 00:43 问题与思路:从装不下到调度好 01:33 三层流水线与三个调度设计 02:24 九个模型家族:全都不需要GPU 03:11 慢但对:忠实性硬规矩 04:01 硬件杂食:Vulkan收留RX 580 04:50 速度谱系:0.05到6.8 05:40 总结:蜂鸟口粮喂巨人
[Source](https://www.bilibili.com/video/BV1tKhR61Err)