Hugging Face开源1.2B基因注释模型Carbon-A
AI技术投降派
通过将NLP模型直接平移至基因组学,Carbon-A以单碱基分辨率通吃六大真核类群,将全球基因注释产能直接拉高两个数量级并暴露出传统参考注释中的大量既有错误。
AI-assisted summary of 基因测序便宜注释贵?AI大模型一个打六个类群 — original source. Check the original for full context.
Source published:
Key ideas
- Hugging Face 生物团队开源 1.2B 参数基因注释模型 Carbon-A 及覆盖 22,617 个物种的数据库,将 NLP 序列分类平移至 DNA 预测,以 MIT 协议开放。 (0:00)
- Carbon-A 采用不重叠 6-mer 分词与 98,304 bp 上下文,单一模型通吃真核生物六大类群,在 42 个基准基因组上宏平均核苷酸 F1 达到 0.944,击败 AUGUSTUS 和 Helixer 等基线。 (0:00)
- 该模型扫过 48,167 个基因组组装并产出 5.66 亿个候选编码位点,合作测序在猫、仓鼠等物种中验证了 239 个参考注释此前遗漏的真实基因。 (3:31)
- Carbon-A 精准卡位在 AlphaFold 之前负责定位序列,但目前不建模可变剪接异构体、不覆盖细菌与病毒,且转录 RNA 证据尚未经质谱证实完全翻译为蛋白。 (5:54)
Detailed notes
## Background 该视频由 Bilibili UP 主“AI技术投降派”于 2026 年 10 月 11 日发布。视频简介指出,当前基因测序虽已极度廉价但基因注释依然停留在半手工阶段,Hugging Face 生物团队因此开源了 1.2B 参数的基因注释模型 Carbon-A 以及覆盖超 2.2 万个物种的注释数据库,通过 NLP 技术平移实现真核生物六大类群的单碱基分辨率注释。
## TL;DR 视频深入解析了 Hugging Face 最新开源的基因注释模型 Carbon-A 及其对应的超大型数据库。该模型将 DNA 序列视为文本,借助 6-mer 分词与双链分类头架构,以单一模型攻克了真核生物六大类群的编码区预测难题,并在评测中超越多个经典基线。团队依托该模型扫过 4.8 万个组装产出 5.66 亿候选位点,并借助 Iso-Seq 测序展开严谨的四层证据闭环验证,证实人类既有注释漏掉了部分真实基因。最后,作者指出了其作为 AlphaFold 上游关键工具的战略意义,同时客观列举了不支持可变剪接、不涵盖细菌病毒等现实局限,肯定了其边界清晰的负责任开源姿态。
## Atmosphere & style 视频整体呈现出一种硬核极客式的冷静与严谨,讲解节奏紧凑且充满思辨色彩。解说风格既有对“NLP 平移生物学”工程巧思的由衷赞赏,又时刻保持着科技博主应有的克制,绝不盲目吹嘘颠覆生命科学。行文在“惊叹模型比人类老师更稳”的高光时刻与“泼冷水指出未能建模转录异构体”的理性反思之间张弛有度,带给观众一种兼具学术专业度与工业落地现实感的通透观感。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1c6ps6aEkD?t=0s) Hugging Face 生物团队开源 1.2B 参数基因注释模型 Carbon-A 及覆盖 22,617 个物种的数据库,将 NLP 序列分类平移至 DNA 预测,以 MIT 协议开放。 - [00:00](https://www.bilibili.com/video/BV1c6ps6aEkD?t=0s) Carbon-A 采用不重叠 6-mer 分词与 98,304 bp 上下文,单一模型通吃真核生物六大类群,在 42 个基准基因组上宏平均核苷酸 F1 达到 0.944,击败 AUGUSTUS 和 Helixer 等基线。 - [03:31](https://www.bilibili.com/video/BV1c6ps6aEkD?t=211s) 该模型扫过 48,167 个基因组组装并产出 5.66 亿个候选编码位点,合作测序在猫、仓鼠等物种中验证了 239 个参考注释此前遗漏的真实基因。 - [05:54](https://www.bilibili.com/video/BV1c6ps6aEkD?t=354s) Carbon-A 精准卡位在 AlphaFold 之前负责定位序列,但目前不建模可变剪接异构体、不覆盖细菌与病毒,且转录 RNA 证据尚未经质谱证实完全翻译为蛋白。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1c6ps6aEkD?t=0s) 测序成本已大幅下降至几天几千元,但传统基因注释仍严重依赖转录数据、已知蛋白比对与人工策展,导致大多数已测序物种的基因位置未知。 - [00:00](https://www.bilibili.com/video/BV1c6ps6aEkD?t=0s) Carbon-A 将 NLP 的 Token 分类范式直接平移至 DNA 序列,正反链各设独立分类头,实现对每个碱基编码/非编码的二分类判断与单碱基分辨率。 - [00:00](https://www.bilibili.com/video/BV1c6ps6aEkD?t=0s) 模型支持 98,304 bp 长上下文并采用不重叠 6-mer 分词,基于 NCBI RefSeq 训练且针对真菌与原生生物进行了专门的领域增强采样。 - [00:00](https://www.bilibili.com/video/BV1c6ps6aEkD?t=0s) Carbon-A 打破了以往专用模型在跨物种门类时的性能暴跌,单一权重即可覆盖哺乳类、脊椎、无脊椎、植物、真菌和原生生物六大真核类群。 - [00:00](https://www.bilibili.com/video/BV1c6ps6aEkD?t=0s) 在分布外测试中,面对遗传密码非标准且无近亲数据的嗜热四膜虫,Carbon-A 的 F1 仍达 0.960,展现了较强的泛化能力。 - [00:00](https://www.bilibili.com/video/BV1c6ps6aEkD?t=0s) 评测指标上限受到旧参考注释自身错误的制约,当使用修正后的 2026 版猪基因组组装测试时得分反升,体现出“学生比老师更稳”的修正效应。 - [03:31](https://www.bilibili.com/video/BV1c6ps6aEkD?t=211s) Carbon 注释数据库处理了约 27 万亿个碱基对,生成了 5.66 亿个候选蛋白编码位点(CDS),物种门类与序列规模均成倍放大。 - [03:31](https://www.bilibili.com/video/BV1c6ps6aEkD?t=211s) 数据库内预测严格遵循四层生物学证据链(模型预测 → RNA 转录 → 蛋白翻译 → 明确功能),目前处于走完“两层半”的阶段。 - [03:31](https://www.bilibili.com/video/BV1c6ps6aEkD?t=211s) 与 UCSD 等机构开展的 Iso-Seq 长读长测序表明完整 CDS 支持率达 62%,并发现了 239 个权威参考注释漏标的真实转录基因。 - [05:54](https://www.bilibili.com/video/BV1c6ps6aEkD?t=354s) 从产业链卡位来看,Carbon-A 位于 AlphaFold 的前一步;只有先精准定位染色体上的起止坐标,蛋白质结构预测才有序列可折。 - [05:54](https://www.bilibili.com/video/BV1c6ps6aEkD?t=354s) 大量非模式生物中蕴藏着抗癌基因或毒液肽等天然药物宝库,低成本从头注释为这些冷门物种的数据挖掘打开了通道。 - [05:54](https://www.bilibili.com/video/BV1c6ps6aEkD?t=354s) Carbon-A 存在明确局限:未建模可变剪接异构体、不覆盖细菌与病毒、本地长染色体推理消耗大,且候选 RNA 并不等同于具有功能的活性蛋白。 - [05:54](https://www.bilibili.com/video/BV1c6ps6aEkD?t=354s) 该开源工作遵循清晰的生物安全边界,明确“只标注天然基因位置而不设计 DNA 或预测毒性功能”,治理策略与开放姿态极具参考价值。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1c6ps6aEkD?t=0s) 基因测序便宜但注释极贵:Carbon-A 的 NLP 平移解法
全基因组测序在今天已经便宜且快速到超乎想象——测完一个物种只需花费几千元人民币、耗时几天。然而,测序仅仅相当于“把书印出来”,后续的基因注释(Annotation)才是真正的“读书”。哪一页是有效基因?哪一段负责编码蛋白?外显子(Exon)和内含子(Intron)分别坐落在哪里?这一道关键的注释工序,目前在学术界与工业界依然停留在半手工状态:依赖昂贵的转录组数据、比对已知蛋白、借由近缘物种进行“举一反三”的同源推断,最后还必须依靠领域专家耗费数月逐条进行人工策展(Curation)。
这种困境让 Hugging Face 联合创始人兼首席科学官 Thomas Wolf 说了一句大实话:“对大多数已经测序的物种,没有人知道基因在哪。”针对这一核心痛点,Hugging Face 生物团队正式开源了基因注释模型 Carbon-A(1.2B 参数),并同步公开了一个覆盖 22,000 多个物种的超大型注释数据库。
```mermaid flowchart LR accTitle: Carbon-A 模型架构与输入输出流程 accDescr: DNA序列切为6-mer tokens经由98k上下文Transformer,双分类头输出单碱基编码概率
subgraph IN["输入处理"] A["DNA 序列"] --> B["不重叠 6-mer 分词"] end subgraph MODEL["Carbon-A 1.2B (Transformers)"] B --> C["98,304 bp 长上下文编码器"] end subgraph OUT["双链分类头"] C --> D["正链分类头: 单碱基编码判定"] C --> E["反链分类头: 单碱基编码判定"] end ```
从方法论上看,这本质上是一次纯粹的自然语言处理(NLP)技术向生物信息学的平移: - **模型任务与架构**:采用标准的 Token 分类任务,原生基于 Transformers 框架加载。输入一段 DNA 序列,直接输出每一个碱基是否属于蛋白编码区(CDS)的二分类判断。 - **正反链双分类头**:DNA 具有双链特性,模型在正链和反链上各设一个独立的分类头,预测精度直达单碱基分辨率。 - **超长上下文与分词**:模型支持高达 98,304 bp 的长上下文窗口;分词方案采用不重叠的 6-mer(即 6 个碱基切为一个 Token)。 - **统一多类群泛化**:过去的方法往往要么一个物种训练一个专用模型,要么仅在模式生物(如小鼠、果蝇)上表现尚可,一旦跨物种门类性能便大幅跳水。Carbon-A 仅用单一模型、一套权重,通吃了真核生物六大类群:哺乳类、其他脊椎动物、无脊椎动物、植物、真菌与原生生物。 - **数据增强与开源许可**:训练语料基于 NCBI RefSeq 参考注释,并针对真菌和原生生物进行了专门的领域增强采样,因为这两个类群在现有的生命之树上注释缺失最为严重。模型技术报告、训练数据、模型卡均完全公开,遵循宽松的 MIT 开源协议。
在 42 个基准基因组上的宏平均核苷酸 F1 达到了 0.944,在核苷酸、外显子和基因三个评价维度上全线击败了 7 种基线模型,包括经典的 AUGUSTUS、Helixer,以及深度学习模型 SegmentNT 和 NTv3。而在分布外(OOD)泛化测试中,即使面对采用非标准遗传密码、且训练集中毫无近亲数据的嗜热四膜虫(*Tetrahymena thermophila*),其 F1 依然高达 0.960。
更耐人寻味的细节在于该指标的“天花板反转”:团队发现评测指标可能已经饱和,原因竟是上限被“参考注释自身的既有错误”卡死了。在猪基因组的训练快照中,团队使用的是 2017 年的参考组装,NCBI 官方后续确认该版本“已知存在大量错误”;但当拿 2026 年修正后的新版猪基因组组装来评测 Carbon-A 时,模型的得分反而显著提升——“学生比老师还稳”,原有的评分标准反被模型挑出了毛病。与此同时,官方也在技术报告中坦率承认,评测用的基准基因组面板在先前的预训练中已被用过,并非严格意义上的全流程留出测试集(Hold-out set)。
[03:31](https://www.bilibili.com/video/BV1c6ps6aEkD?t=211s) 从 5.66 亿候选位点到严密的四层生物学证据链
基于 Carbon-A 这个“注释放大器”,Hugging Face 同步推出了 Carbon 注释数据库。单一模型一口气扫过了 48,167 个基因组组装,横跨 22,617 个物种,处理了约 27 万亿个碱基对(27 Tbp),直接产出了 5.66 亿个预测蛋白编码位点(CDS)。相较于原有的训练语料,该数据库覆盖的物种门类扩大了 11 倍,序列规模扩大了 9 倍。数据库中的每条预测记录均完整附带组装链接、染色体基因组坐标、重建的 CDS 编码序列、翻译出的蛋白质序列以及模型置信度评分。目前该项目仅完成了 GenBank 目标的一半,计划三周后释放下一批,最终目标是将 GenBank 全部真核生物注释一遍,并同步至欧洲分子生物学实验室(EMBL)。
官方特别强调了严谨的用词规范:这 5.66 亿个是“候选”编码位点,属于模型的大规模工程化批量生成。过去注释一个新物种往往需要领域专家数月的心血,如今这套管线将真核生物的基因注释产能硬生生拉高了两个数量级。针对这些预测候选的真实性,团队与合作机构给出了教科书级别的四层证据闭环验证:
```mermaid flowchart TD accTitle: 基因预测四层验证链状态 accDescr: 展示从模型预测到生物学功能验证的四层状态,目前已走完两层半
L1["第一层:模型计算预测 (已完成)<br/>Carbon-A 产出 5.66 亿候选编码位点"] L2["第二层:RNA 转录证据 (已验证)<br/>PacBio Iso-Seq 长读长全长转录组测序"] L3["第三层:蛋白质翻译 (未证实)<br/>核糖体分析 (Ribo-seq) + 质谱分析"] L4["第四层:生物学功能 (未证实)<br/>分子生物学实验验证药物/代谢功能"]
L1 --> L2 L2 -.-> L3 L3 -.-> L4 ```
1. **第一层:模型纯计算预测**。由 Carbon-A 从 DNA 原始碱基中定位潜在区域。 2. **第二层:转录组 RNA 证据实测**。团队与 ActiveSite 以及加利福尼亚大学圣迭戈分校(UCSD)合作,利用 PacBio 的 Iso-Seq 长读长测序技术,对猫、叙利亚仓鼠、鸡和拟南芥开展了全长转录组测序验证。结果令人振奋: - Carbon-A 预测的完整编码区,获得了约 62% 的全长转录 RNA 数据直接支持,表现与高规格的参考注释持平,显著优于现有的其他从头预测(*de novo*)工具。 - Thomas Wolf 公布了一项关键发现:测序实测验证了 239 个基因的 RNA 存在,而这 239 个基因在人类现存的权威参考注释中完全缺失。这表明模型在特定区域并没有胡乱虚构,反而是人类现存的参考注释漏掉了关键真实基因。 3. **第三层:蛋白质翻译水平证据(尚未证实)**。RNA 的存在只证明了该区间确实发生转录且外显子剪接结构成立,但并不代表其必然在细胞内翻译成具象蛋白质。团队明确表态,下一步将借助核糖体分析(Ribo-seq)与蛋白质质谱分析(Mass Spectrometry)进一步锁死这一层。 4. **第四层:明确的生物学功能(尚未证实)**。即使被翻译出来,也不代表该蛋白具有生物表型或生化功能。
从预测到转录、到翻译、再到功能,整条科学链条目前走完了“两层半”,技术报告对每一层的认知边界与未解环节划分得一清二楚。
[05:54](https://www.bilibili.com/video/BV1c6ps6aEkD?t=354s) AI 进军生命科学的捷径、冷水与开源姿态
通过拆解 Carbon-A 的落地,视频总结了针对这一工作的三个核心判断与深度思考:
第一,**NLP 基础设施的平移是 AI 切入生命科学成本最低的一条路径**。团队没有重新发明工具链,仅仅是把自然语言的上下文换成了 DNA 碱基序列。“Transformers 还是那个 Transformers,Token 分类还是那个 Token 分类。”在整个生物医药大模型生态中,Carbon-A 实际上精准卡位在 AlphaFold 的前一步——蛋白质结构预测模型纵然神奇,前提也必须有人先挑出正确的氨基酸序列;如果连基因在染色体上的起止坐标都不知道,就无从谈起结构预测。正如 Thomas Wolf 在发布中所描绘的愿景:大象鲜少患癌,部分原因在于其基因组中拥有大量抗癌基因(如 p53)的额外多重拷贝;风靡全球的降糖减重药物 GLP-1 激动剂,最初也是从希拉毒蜥(Gila monster)的毒液肽中受到启发而研发。那些被主流模式生物遗漏的冷门物种基因,本身就是一座尚未开启的巨大天然药物宝库。
第二,**泼几盆必须面对的“冷水”**: - **不建模可变剪接**:模型只负责预测编码区占位,无法识别可变剪接异构体(Alternative Splicing Isoforms),分不清一个基因在不同条件下的多种剪切变体。 - **类群覆盖存在明确死角**:细菌和病毒原核系统明确不在模型的训练和泛化范围内,因此该工具对研发抗生素或进行噬菌体研究的学者无法直接适用。 - **RNA 不等于功能蛋白**:数据库中 5.66 亿个候选位点里,最终能被生物学实锤具有生命活性的比例仍是未知数。 - **工程瓶颈**:当前数据库仅覆盖了 GenBank 的一半数据;若在本地使用 CPU 跑长染色体推理,速度非常缓慢且面临巨大的内存消耗。
第三,**负责任的开源姿态本身就是值得行业学习的新闻**。Thomas Wolf 专门阐释了开源 Carbon-A 的伦理安全逻辑:该模型“不设计任何未知 DNA、不预测未知基因的病原毒性功能,仅仅是标定天然序列中已经存在的基因位置”。基因定位工具的生物安全门槛与生成类(*de novo* 设计)工具有着本质区别。研发团队首先将模型的能力边界划得清清楚楚,在此基础之上再决定开源的力度,这种严谨克制的治理思路比模型技术本身更值得行业借鉴。
从“对大多数物种而言,没有人知道基因在哪”,到如今凭借 12 亿参数模型与 5.66 亿候选位点将知识黑盒压缩为一个标准的工程学问题,AI 正在为生物学的数据底座换上全新引擎。
## Notable quotes > [00:00](https://www.bilibili.com/video/BV1c6ps6aEkD?t=0s) 对大多数已测序物种,没有人知道基因在哪 — Thomas Wolf
> [00:00](https://www.bilibili.com/video/BV1c6ps6aEkD?t=0s) 学生比老师还稳
> [03:31](https://www.bilibili.com/video/BV1c6ps6aEkD?t=211s) 候选,不是实锤
> [03:31](https://www.bilibili.com/video/BV1c6ps6aEkD?t=211s) 是注释漏了,不是模型错了 — Thomas Wolf
> [05:54](https://www.bilibili.com/video/BV1c6ps6aEkD?t=354s) 没换工具链换了对象,NLP 方法论平移可能是 AI 进生命科学成本最低的路
> [05:54](https://www.bilibili.com/video/BV1c6ps6aEkD?t=354s) 结构预测再神也得先知道折哪段序列
> [05:54](https://www.bilibili.com/video/BV1c6ps6aEkD?t=354s) 大象抑癌基因、毒蜥毒液肽变 GLP-1,被模式物种漏掉的基因就是还没打开的药库
> [05:54](https://www.bilibili.com/video/BV1c6ps6aEkD?t=354s) 不设计 DNA、不预测基因功能,只标注基因位置 — Thomas Wolf
> [05:54](https://www.bilibili.com/video/BV1c6ps6aEkD?t=354s) 把能力边界讲清楚再决定开放力度,这个做法比能力本身更值得学
## Mentioned Carbon-A, Carbon-A-1.2B, Hugging Face, Thomas Wolf, Georgia Channing, ActiveSite, UCSD, NCBI RefSeq, GenBank, EMBL, AUGUSTUS, Helixer, SegmentNT, NTv3, AlphaFold, Transformers, PacBio Iso-Seq, 四膜虫, GLP-1
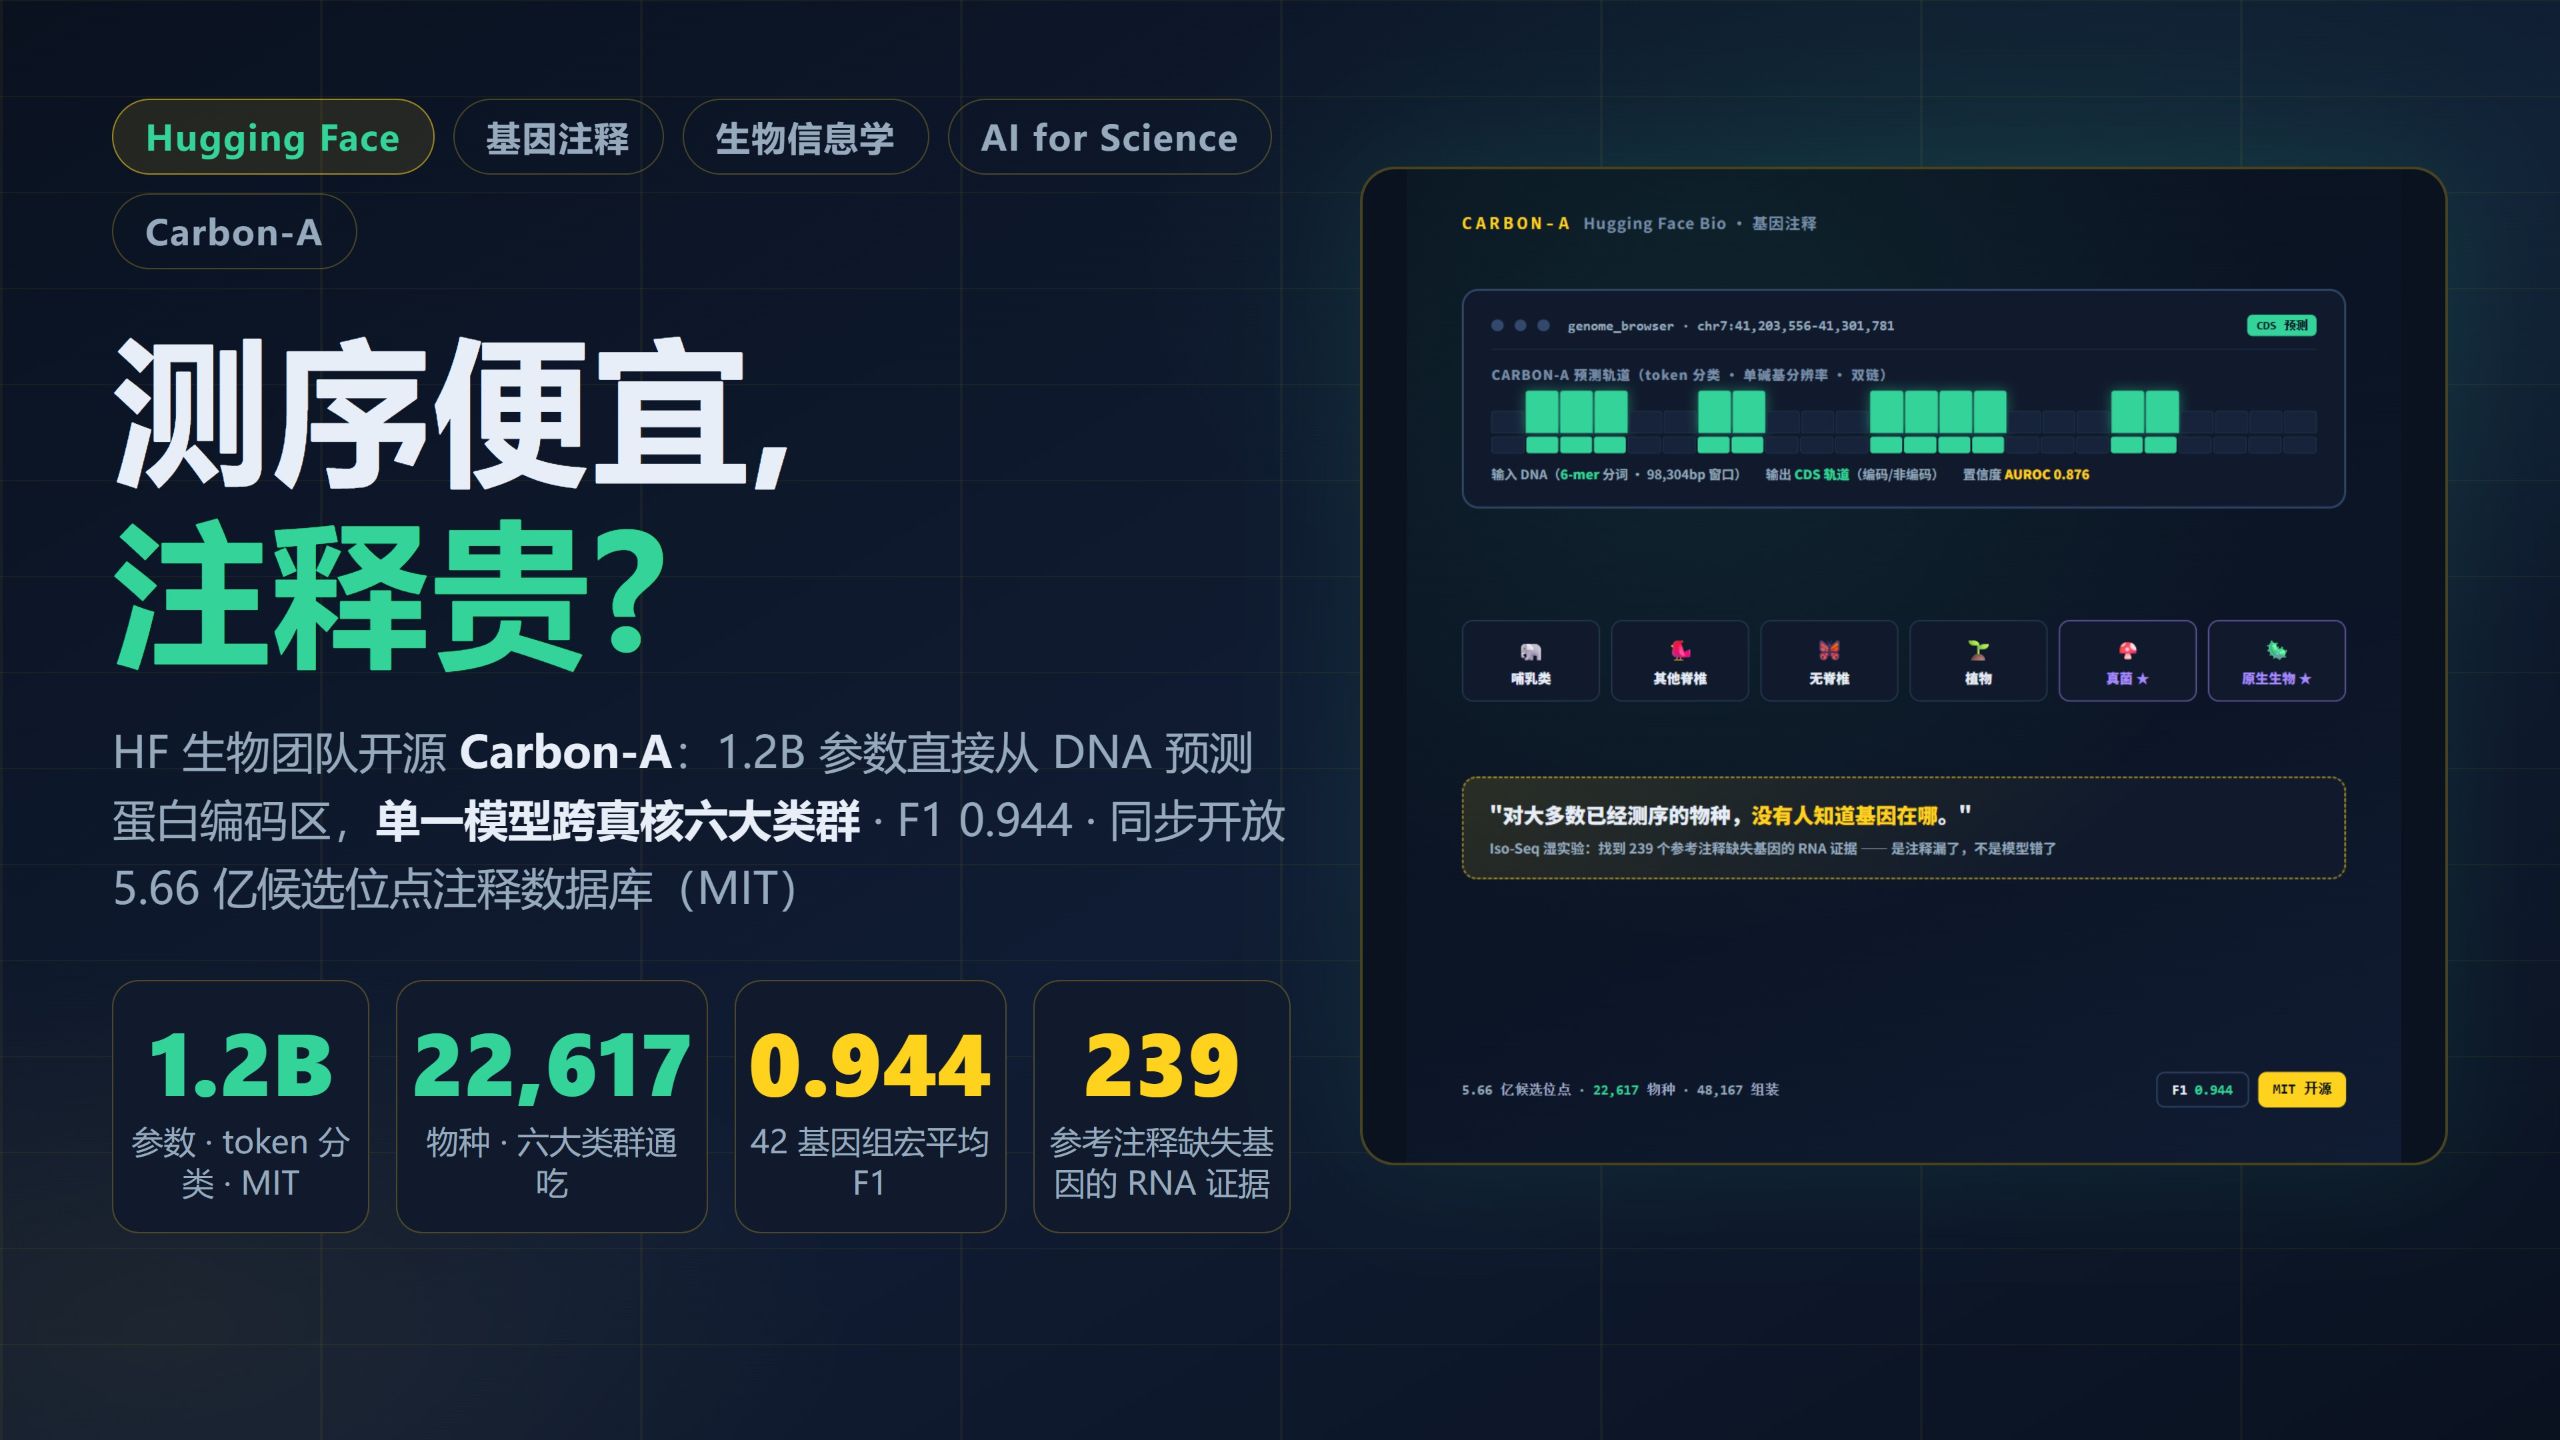
## Video description 视频简介: 基因测序便宜到超乎想象,一个物种几千块几天搞定;但注释还停在半手工——靠转录数据、已知蛋白、近缘物种举一反三加专家策展。Hugging Face 联合创始人 Thomas Wolf 说了句大实话:对大多数已测序物种,没有人知道基因在哪。发布当天(10 月 8 日),HF 生物团队开源了答案:Carbon-A,1.2B 参数基因注释模型,外加覆盖 22,617 个物种的注释数据库。
方法论是 NLP 的平移:token 分类、6-mer 分词、transformers 原生加载——输入 DNA 序列,输出每个碱基"编码/非编码"的判断,正反链各一个分类头,单碱基分辨率,98,304bp 上下文。关键在覆盖面:单一模型跨真核六大类群(哺乳类、脊椎、无脊椎、植物、真菌、原生生物),真菌和原生生物还做了专门增强——因为它们在生命之树上最缺注释。MIT 协议。
成绩:42 个基准基因组宏平均核苷酸 F1 0.944,超 AUGUSTUS、Helixer、SegmentNT、NTv3 等七种基线;分布外测试四膜虫(非标准遗传密码)F1 0.960。最妙的细节:指标可能已饱和——上限卡在参考注释自身的错误上(NCBI 确认训练快照里 2017 猪组装"已知有很多错误"),拿 2026 新猪组装测反而得分更高,学生比老师稳。官方也诚实交代:评测面板在训练中被用过,不是严格留出集。
数据库是放大器的产物:一个模型扫过 48,167 个组装,5.66 亿候选编码位点,类群是训练语料的 11 倍、序列 9 倍,每条带坐标、CDS、翻译蛋白和置信度。注意措辞:候选,不是实锤。
验证走四层证据:模型预测 → Iso-Seq RNA 证据(与 ActiveSite、UCSD 合作测了猫、仓鼠、鸡、拟南芥;完整 CDS 支持率约 0.62;Thomas Wolf 宣布找到 239 个参考注释缺失基因的 RNA 证据——是注释漏了,不是模型错了)→ 翻译成蛋白(未证,下一步核糖体分析+质谱)→ 功能(未证)。每层边界写得清清楚楚。
三个判断:①没换工具链换了对象,NLP 方法论平移可能是 AI 进生命科学成本最低的路,而且它站在 AlphaFold 前一步——结构预测再神也得先知道折哪段序列;大象抑癌基因、毒蜥毒液肽变 GLP-1,被模式物种漏掉的基因就是还没打开的药库;②冷水:不建模可变异构体、细菌病毒明确不在范围、RNA 不等于蛋白、GenBank 才覆盖一半、CPU 推理慢;③开源姿态本身就是新闻——"不设计 DNA、不预测基因功能,只标注基因位置",把能力边界讲清楚再决定开放力度,这个做法比能力本身更值得学。
参考:huggingface.co/blog/HuggingFaceBio/carbon-annotator-genbank-genome-annotation · HuggingFaceBio/Carbon-A-1.2B · Thomas Wolf / Georgia Channing 发布帖(2026-10-08)
[Source](https://www.bilibili.com/video/BV1c6ps6aEkD)