多智能体系统生产部署频陷黑盒 链路可观测性成AI工程准入硬指标
AI大模型-阿水
智能体业务落地频繁崩溃的主因并非提示词或模型能力缺陷,而是非确定性执行使系统沦为黑盒,构建涵盖链路追踪与差分回放的可观测体系是保障工业级可用的关键工程路径。
AI-assisted summary of 为什么说可观测性是 2026 年 Agent 岗最容易被忽视的加分项? — original source. Check the original for full context.
Source published:
Key ideas
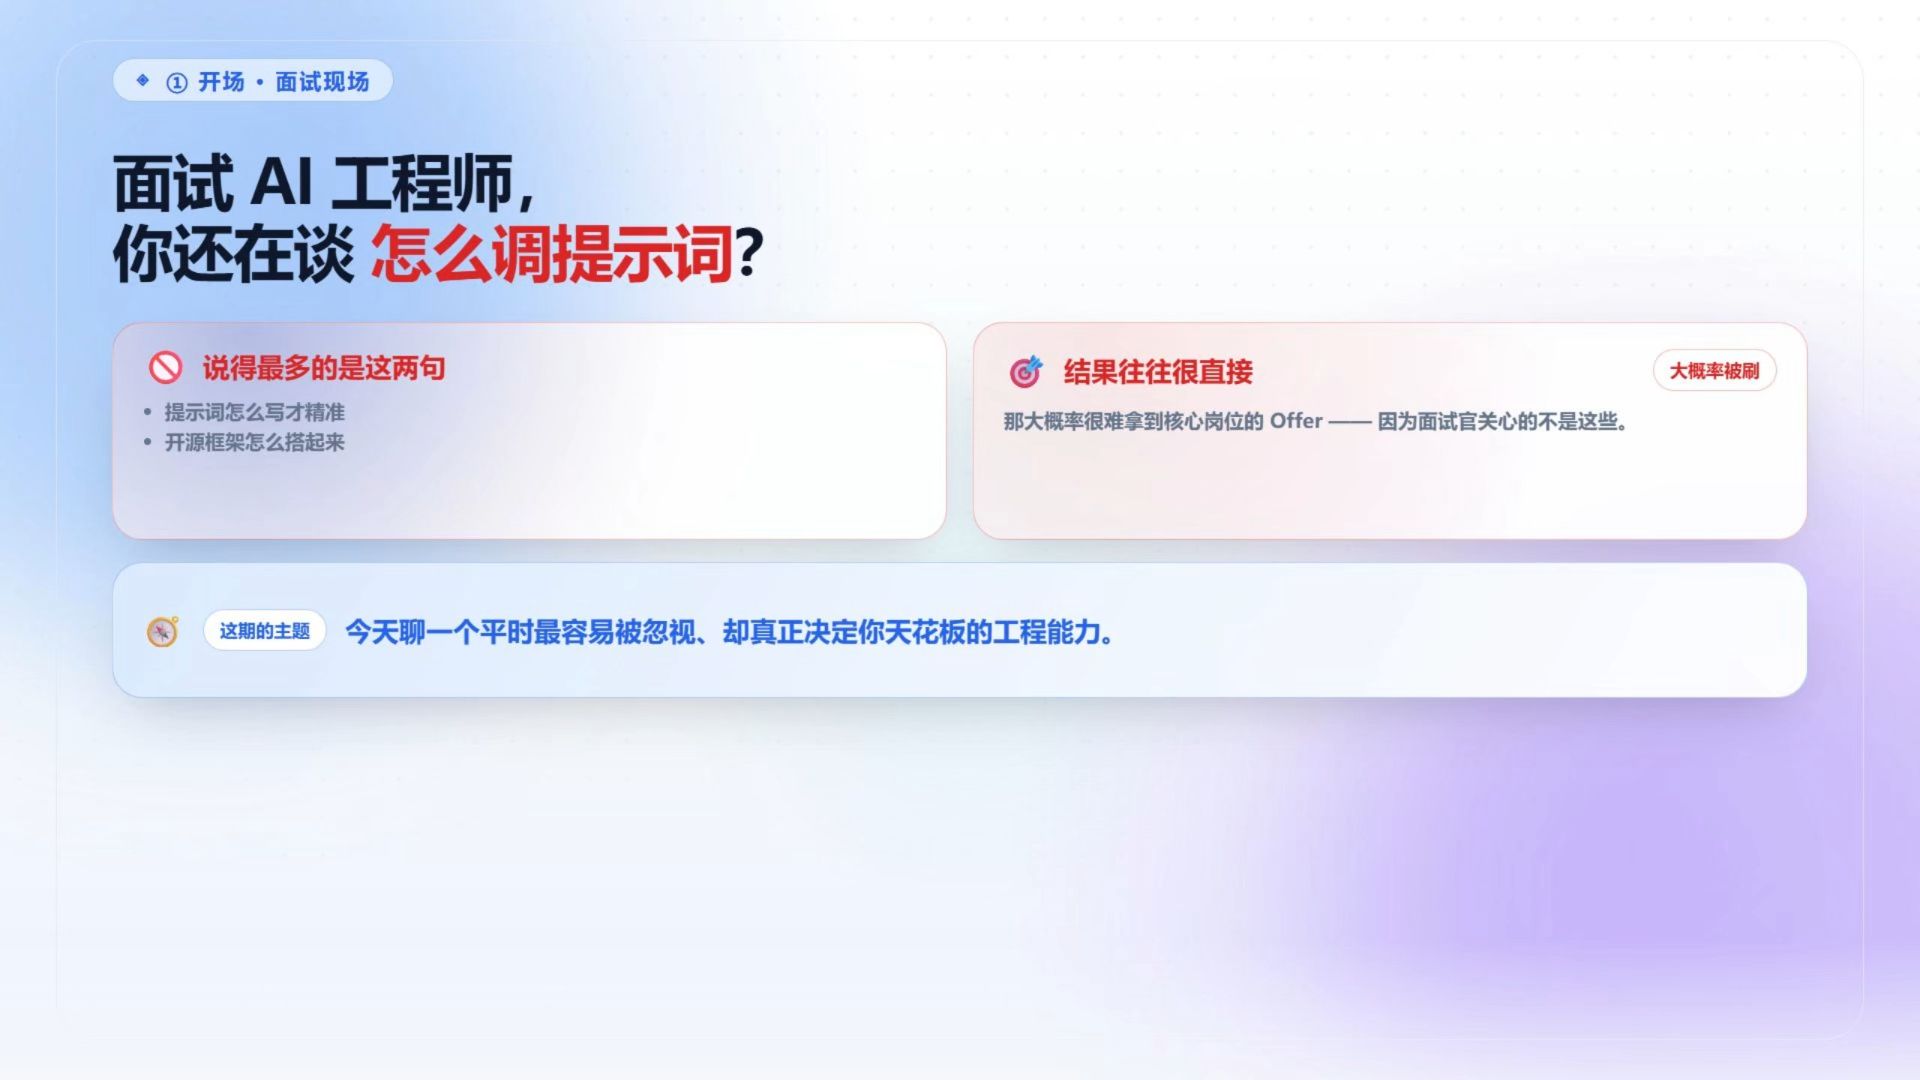
- Agent 岗位的面试重点已从编写提示词与调用开源框架,转向解决多智能体生产系统死循环、链路崩溃与成本失控的工程排障能力。 (0:00)
- 工业级 Agent 可观测性不能直接套用传统微服务的指标、日志与链路追踪三要素,必须从任务轨迹执行图、成本延迟剖析、精准根因归因与在线评估护栏四个新维度重构。 (0:46)
- 针对非确定性执行与长流程存储成本痛点,业界成熟方案采用 OpenTelemetry 语义透传链路标识,并结合差分快照与 Mock 回放实现现场调试。 (3:40)
- 通过全量基础指标与异常触发深度评估的自适应分层机制,团队可将脱敏后的线上故障链路转化为自动化离线回归测试集,防止系统能力退化。 (3:40)
Detailed notes
## Background 本视频由 UP 主“AI大模型-阿水”于 2026 年 9 月 29 日发布在 Bilibili 平台。视频简介中提供了视频 Agent 学习资料、大模型学习路线、实战案例集、电子书以及问题解答的获取链接。
## TL;DR 随着 AI 业务落地要求升级,Agent 岗位面试重点已从单纯编写 Prompt 和调用框架,转向解决生产环境中多智能体系统跑飞、死循环及成本失控等“黑盒”问题的工程实战能力。由于大模型具有天然的非确定性,传统微服务监控无法直接复用,必须从任务轨迹与执行图、成本与延迟剖析、精准根因归因、在线评估与规则护栏四个全新维度重构可观测性体系。针对非确定性路径、计算存储开销与隐私平衡、多跳长流程状态回溯三大落地难点,业界普遍采用基于 OpenTelemetry 的无侵入采集、差分快照与 Mock 隔离重放,以及分层采样与离线回归闭环等成熟方案。掌握这套可观测性工程体系,是确保复杂智能体网络高可用、低成本运转并展现架构深度的关键分水岭。
## Atmosphere & style 整支视频呈现出浓厚的工业级技术实战与职场点拨氛围,语调专业、冷静且一针见血。讲述者以面试官考察视角和生产环境痛点切入,层层剖析从“跑通 Demo”到“工业级落地”的认知落差,充满干货感与工程严谨性。听众在观看过程中会感受到一种从直面“系统黑盒失控”的紧迫感,逐步过渡到掌握标准化架构与闭环方法论后的清晰与笃定。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1g3aG6KEuP?t=0s) Agent 岗位的面试重点已从编写提示词与调用开源框架,转向解决多智能体生产系统死循环、链路崩溃与成本失控的工程排障能力。 - [00:46](https://www.bilibili.com/video/BV1g3aG6KEuP?t=46s) 工业级 Agent 可观测性不能直接套用传统微服务的指标、日志与链路追踪三要素,必须从任务轨迹执行图、成本延迟剖析、精准根因归因与在线评估护栏四个新维度重构。 - [03:40](https://www.bilibili.com/video/BV1g3aG6KEuP?t=220s) 针对非确定性执行与长流程存储成本痛点,业界成熟方案采用 OpenTelemetry 语义透传链路标识,并结合差分快照与 Mock 回放实现现场调试。 - [03:40](https://www.bilibili.com/video/BV1g3aG6KEuP?t=220s) 通过全量基础指标与异常触发深度评估的自适应分层机制,团队可将脱敏后的线上故障链路转化为自动化离线回归测试集,防止系统能力退化。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1g3aG6KEuP?t=0s) Agent 面试风向发生根本转变,面试官核心考察候选人在多智能体系统跑飞、死循环或成本失控时的生产级排障工程能力。 - [00:00](https://www.bilibili.com/video/BV1g3aG6KEuP?t=0s) Agent 生产环境频频翻车的主因并非模型智商不足,而是动态路由、自主规划与协同网络拉长了任务链,使系统进入状态空间倍增的运行时黑盒状态。 - [00:00](https://www.bilibili.com/video/BV1g3aG6KEuP?t=0s) 业务方对 Agent 的验收标准已从惊艳的 Demo 演示,升级为确定性响应时间、可控算力成本与故障清晰可查的工业化硬性指标。 - [00:46](https://www.bilibili.com/video/BV1g3aG6KEuP?t=46s) 大模型的天然非确定性导致传统微服务三位一体监控体系失效,必须针对智能体架构定制全新的可观测性维度。 - [00:46](https://www.bilibili.com/video/BV1g3aG6KEuP?t=46s) 任务轨迹跟踪需将底层 API、向量检索、工具调用以及多 Agent 状态机跳转动态串联为执行依赖图,使自主决策透明化。 - [00:46](https://www.bilibili.com/video/BV1g3aG6KEuP?t=46s) 成本与延迟剖析必须细分常规生成与深度思考推理消耗,监控多轮交互导致的上下文窗口膨胀及首字生成延迟(TTFT)。 - [00:46](https://www.bilibili.com/video/BV1g3aG6KEuP?t=46s) 根因归因系统需能精确定位长流程崩溃是源自 RAG 检索漂移噪声、前序智能体的幻觉级联,还是长期记忆中的过期经验。 - [00:46](https://www.bilibili.com/video/BV1g3aG6KEuP?t=46s) 在线评估护栏需要部署轻量化实时校验以评估真实性与工具匹配度,并将用户点赞、点踩与改写反馈转化为持续优化资产。 - [02:37](https://www.bilibili.com/video/BV1g3aG6KEuP?t=157s) 智能体可观测性落地面临非确定性执行路径导致固定链路模板失效、全量日志存储开销与 PII 隐私合规冲突两大核心阻碍。 - [02:37](https://www.bilibili.com/video/BV1g3aG6KEuP?t=157s) 多跳长流程在不中断生产的前提下捕获状态快照难度极高,极度依赖类似时间旅行(Time Travel)的现场隔离与重放调试机制。 - [03:40](https://www.bilibili.com/video/BV1g3aG6KEuP?t=220s) 业界标准采集方案基于 OpenTelemetry 语义规范,利用上下文传递机制在异步调用中无侵入透传 Trace ID、Session ID 与角色状态。 - [03:40](https://www.bilibili.com/video/BV1g3aG6KEuP?t=220s) 采用差分快照仅持久化状态变动增量可大幅削减存储,并通过锁定 Mock 外部工具返回数据实现精准节点的隔离重放调试。 - [03:40](https://www.bilibili.com/video/BV1g3aG6KEuP?t=220s) 分层采样策略对全量流量只做轻量指标监控,仅对报错或耗时异常的会话触发高阶深度评估,平衡了系统开销与质量把控。 - [03:40](https://www.bilibili.com/video/BV1g3aG6KEuP?t=220s) 将生产捕获的典型失败链路自动化清洗脱敏并沉淀为离线回归测试集,是防止后续提示词优化或微调导致能力退化的关键防线。 - [03:40](https://www.bilibili.com/video/BV1g3aG6KEuP?t=220s) 构建原型 Demo 门槛相对较低,但在企业级业务中保障多智能体网络的高可用、确定性与低成本,其核心工程深度主要集中在可观测性体系。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1g3aG6KEuP?t=0s) Agent 面试风向转变与业务落地的黑盒困境
在当前的 AI 工程师面试中,如果求职者依然把重心放在“如何编写提示词(Prompt)”或者“如何调用开源框架”,往往很难拿到核心业务岗位的 Offer。如今面试官最核心的考察点在于:当多智能体系统(Multi-Agent System)在真实生产业务中“跑飞”、死循环,或是算力与 Token 成本瞬间失控时,候选人是否具备快速定位并排除故障的实战工程能力。很多习惯了跑 Demo 的开发者在面对此类生产级实战拷问时往往措手不及。
很多在本地环境运行良好的 Agent 流程,一旦部署到实际业务场景便频繁“翻车”。多数人习惯性将其归咎为提示词调优不足或基础大模型智商不够,但深层原因在于现代 Agent 系统架构往往融合了复杂的动态路由、自主规划机制以及多智能体协同网络。随着任务执行链条不断拉长,系统的状态空间呈成倍级数级扩大。在缺乏全面观测手段的情况下,整个智能体系统在运行时如同一个完全黑盒,不仅在无形中持续空耗算力,而且一旦某个环节崩溃,工程师根本无从下手排查。业务方对 Agent 的考核标准,已经从最初“偶尔惊艳的 Demo 演示”,彻底升级为对“确定的响应时间、可控的算力成本以及清晰可查的故障链路”的严苛工业要求。
---
[00:46](https://www.bilibili.com/video/BV1g3aG6KEuP?t=46s) 智能体可观测性的四大全新监控维度
传统微服务架构中基于指标(Metrics)、日志(Logging)与链路追踪(Tracing)的三位一体监控体系,无法直接平移到 Agent 架构中。其核心差异在于:传统软件系统由确定性的代码逻辑构成,而大模型系统具有天然的非确定性(Non-deterministic)。要实现工业级智能体监控,必须从四个全新的维度进行重构:
```mermaid flowchart TD accTitle: Agent 可观测性四大核心维度 accDescr: 展示任务轨迹跟踪、成本响应剖析、精准根因归因与在线评估护栏四个层面的交互逻辑
subgraph TraceGraph ["1. 任务轨迹与执行图"] A["底层调用 / 向量检索 / 工具执行"] --> B["多 Agent 消息流转与状态机跳转"] B --> C["动态执行图 (清晰展现决策过程)"] end
subgraph CostLatency ["2. 成本与延迟剖析"] D["区分常规生成 vs 深度思考消耗"] E["上下文窗口膨胀追踪与首字延迟优化"] end
subgraph RootCause ["3. 精准根因归因"] F{"任务失败 / 工具调用异常"} F --> G1["知识库检索漂移噪声"] F --> G2["前序 Agent 幻觉级联反应"] F --> G3["长期记忆载入过期经验"] end
subgraph OnlineEval ["4. 在线评估与规则护栏"] H["轻量级在线打分 (真实性/工具准确率)"] I["用户反馈捕获 (点赞/点踩/修改)"] H & I --> J["持续优化数据资产"] end
C -.-> F CostLatency -.-> C RootCause -.-> OnlineEval ```
- **任务轨迹跟踪与执行图(Trace & Execution Graph)**:不仅要捕获底层的大模型 API 调用、向量检索(Vector Retrieval)和外部工具执行,更要将多个智能体之间的消息通信、子任务派生分支以及状态机的跳转逻辑,动态拼装成一张完整的执行依赖图,使整个自主决策过程完全透明可见。 - **成本与响应速度剖析(Cost & Latency Profiling)**:针对具备深度思考推理(Reasoning Tokens)的模型,必须精准切分常规输出消耗与思考推理消耗。随着多轮交互深入,上下文窗口(Context Window)持续膨胀,不仅导致 API 账单激增,还会严重拉长首字生成延迟(TTFT)。通过精细化剖析,可以准确定位具体是哪一步规划策略引入了不必要的冗余上下文。 - **精准根因归因(Root Cause Attribution)**:当长流程任务崩溃或选错工具时,系统需要准确判定底层病因:究竟是 RAG 检索阶段检索漂移引入了噪声,还是前序智能体输出幻觉引发了下游决策的级联反应,亦或是长期记忆模块中加载了过期的错误经验。 - **在线评估与规则护栏(Online Evaluation & Guardrails)**:不能仅寄希望于静态离线测试集。系统需要部署轻量级的在线评测逻辑与规则护栏,实时校验输出真实性与工具匹配度,并将真实用户的点赞、点踩、改写等行为实时回流,转化为系统持续迭代的数据基础。
---
[02:37](https://www.bilibili.com/video/BV1g3aG6KEuP?t=157s) Agent 可观测性的三大技术落地难点
尽管可观测性的价值显著,但在实际工程落地过程中,技术团队通常会面临三大核心阻碍:
- **非确定性的执行路径**:面对完全相同的用户输入,智能体在不同时间片内自主拆解生成的子任务树(Sub-task Tree)与执行路径可能大相径庭,这使得传统监控中依赖固定链路模板进行横向对比分析的手段彻底失效。 - **计算开销与数据隐私的平衡**:如果对长流程中的每一步长文本提示词、工具调用入参与出参、记忆快照进行全量无差别持久化,将带来极其沉重的存储与传输成本;同时,业务数据中普遍包含个人身份信息(PII)及敏感商业机密,系统必须支持毫秒级的实时脱敏过滤。 - **多跳长流程的状态回溯难度**:一个完整的业务任务往往横跨数十个交互步骤,在生产环境系统不中断的前提下,如何高效捕获状态快照,甚至实现类似“时间旅行(Time Travel Debugging)”般的故障现场隔离与重放调试,对团队的系统工程底蕴提出了极高要求。
---
[03:40](https://www.bilibili.com/video/BV1g3aG6KEuP?t=220s) 业界成熟落地实践:从无侵入采集到自动化闭环
针对上述三大工程痛点,业界当前成熟的系统级解决方案主要依托一套标准化的采集、调试与自适应评估闭环体系:
在底层采集层面,业界普遍采用基于开放遥测(OpenTelemetry)的语义规范来统一多智能体数据模型。通过上下文传递机制(Context Propagation),在多协程并发与异步调用链路中,自动且无侵入地透传链路标识(Trace ID)、会话标识(Session ID)、当前智能体角色身份以及状态版本号,彻底打通跨 Agent 的全链路追踪。
针对高昂的存储成本与复杂的复现难题,团队应采用“差分快照策略(Differential Snapshot)”,仅持久化每次状态流转中发生变动的增量数据,从而大幅削减日志与快照存储体积。在定位排查时,可基于捕获的历史快照构建模拟回放机制:将外部真实工具的返回数据进行 Mock 锁定,仅针对抛出异常节点的 Prompt 模板或模型版本进行隔离重放调试,成倍提升定位与调优效率。
```mermaid flowchart LR accTitle: 分层采样与离线回归闭环架构 accDescr: 展示从全量轻量采集到自适应深度评估,再到脱敏沉淀离线回归集的完整链路
subgraph Layer1 ["数据分层分流"] Req["线上全量请求"] --> Met["轻量全量指标采集<br/>(耗时 / Token消耗 / 工具成功率)"] Req --> Filter{"异常判定<br/>(报错/长耗时/成本突增)"} end
subgraph Layer2 ["深度评估与处理"] Filter -- "命中断言/异常" --> DeepEval["自适应深度评估<br/>(内容真实性 / 规划合理性)"] Filter -- "正常流量" --> Pass["常规归档"] end
subgraph Layer3 ["离线闭环"] DeepEval --> Mask["自动化数据清洗与脱敏"] Mask --> RegTest["沉淀为离线自动化回归测试集"] RegTest -. "防止能力退化".-> Opt["Prompt/模型迭代验证"] end ```
在评估与闭环体系构建上,最行之有效的路径是“分层采样与自适应评估”机制: - **全量基础监控**:对生产环境中 100% 的流量统一采集响应延迟、Token 消耗量以及工具调用成功率等基础指标; - **自适应深度评估**:针对执行抛错、耗时突破阈值水位或消耗突增的异常会话,自动触发高阶深度评估逻辑,实现工程开销与质量控制的最优平衡; - **闭环资产沉淀**:将生产线捕获的典型失败链路进行自动化数据脱敏与清洗,直接导入到离线回归测试用例集中,形成自动化回归防线,从根本上防止后续 Agent 提示词迭代或模型微调时出现系统“能力退化(Regression)”。
搭建一个原型 Demo 门槛并不高,但要确保复杂的智能体网络在企业业务线中长久保持高可用、确定性响应与低成本运转,“大部分工程深度其实都在可观测性体系里”。掌握这套工程体系,才是架构师在面对复杂系统设计时拿出高可信度方案的真正技术分水岭。
## Notable quotes > [00:00](https://www.bilibili.com/video/BV1g3aG6KEuP?t=0s) 当多智能体系统在真实生产业务中“跑飞”、死循环,或是算力与 Token 成本瞬间失控时,候选人是否具备快速定位并排除故障的实战工程能力
> [00:00](https://www.bilibili.com/video/BV1g3aG6KEuP?t=0s) 业务方对 Agent 的考核标准,已经从最初“偶尔惊艳的 Demo 演示”,彻底升级为对“确定的响应时间、可控的算力成本以及清晰可查的故障链路”的严苛工业要求
> [00:46](https://www.bilibili.com/video/BV1g3aG6KEuP?t=46s) 传统微服务架构中基于指标(Metrics)、日志(Logging)与链路追踪(Tracing)的三位一体监控体系,无法直接平移到 Agent 架构中
> [00:46](https://www.bilibili.com/video/BV1g3aG6KEuP?t=46s) 针对具备深度思考推理(Reasoning Tokens)的模型,必须精准切分常规输出消耗与思考推理消耗
> [02:37](https://www.bilibili.com/video/BV1g3aG6KEuP?t=157s) 面对完全相同的用户输入,智能体在不同时间片内自主拆解生成的子任务树与执行路径可能大相径庭,这使得传统监控中依赖固定链路模板进行横向对比分析的手段彻底失效
> [03:40](https://www.bilibili.com/video/BV1g3aG6KEuP?t=220s) 在底层采集层面,业界普遍采用基于开放遥测(OpenTelemetry)的语义规范来统一多智能体数据模型
> [03:40](https://www.bilibili.com/video/BV1g3aG6KEuP?t=220s) 针对高昂的存储成本与复杂的复现难题,团队应采用“差分快照策略”,仅持久化每次状态流转中发生变动的增量数据
> [03:40](https://www.bilibili.com/video/BV1g3aG6KEuP?t=220s) 将生产线捕获的典型失败链路进行自动化数据脱敏与清洗,直接导入到离线回归测试用例集中,形成自动化回归防线,从根本上防止后续 Agent 提示词迭代或模型微调时出现系统“能力退化”
> [03:40](https://www.bilibili.com/video/BV1g3aG6KEuP?t=220s) 大部分工程深度其实都在可观测性体系里
## Mentioned Agent, Multi-Agent System, OpenTelemetry, RAG, Prompt, Token, Context Window, TTFT, Reasoning Tokens
## Video description 视频Agent学习籽料、大模型学习路线、、实战案例集、电子书+问题解答👉https://www.bilibili.com/read/cv52978347/?spm_id_from=333.1387.0.0&jump_opus=1自取哦
[Source](https://www.bilibili.com/video/BV1g3aG6KEuP)