亚马逊查晟称软硬件割裂保护英伟达护城河
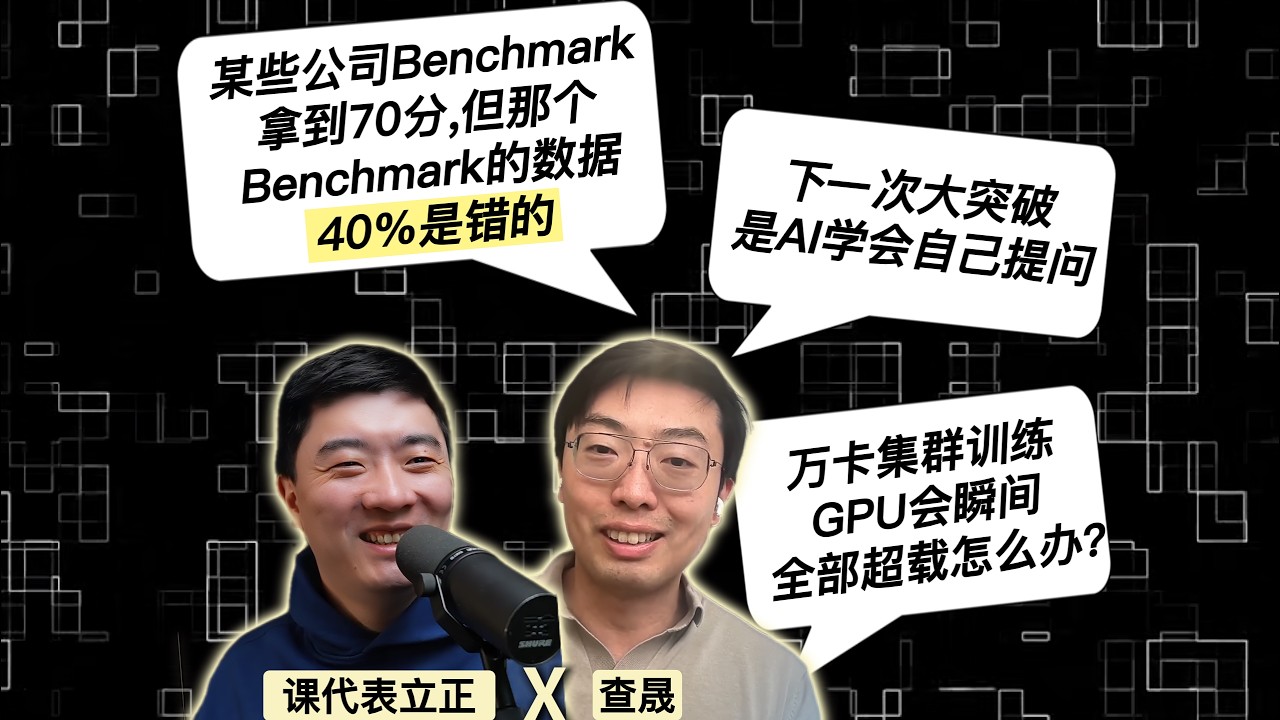
课代表立正
大模型预训练正面临数据污染与超算电力瓶颈的工程挑战,而未来三到五年内AI若实现自主学习将彻底瓦解传统职业生涯规划并冲击宏观经济调控机制。
AI-assisted summary of 亚马逊AGI查晟:大模型训练的一线实践;训练AI有多难,人才和科学精神有多重要? — original source. Check the original for full context.
Source published:
Detailed notes
## Background 该视频由 YouTube 频道“课代表立正”于 2026 年 3 月 4 日发布。视频简介指出,本期节目邀请了 Amazon AGI 资深经理查晟,他将结合自身与顶级大牛共事及第一线前沿模型研发的经历,深度剖析大模型训练在技术路线、实验方法、基础设施、人才密度及未来趋势等维度的真实工程挑战与行业真相。
## TL;DR 访谈深入探讨了大模型训练作为经验科学的内核,指出追求 50% 失败率的实验最能带来信息增量,并强调了私有评估集在防范行业数据欺诈中的关键性。同时,查晟揭示了超算底座在电力和硬件损耗上面临的严峻考验,以及既懂底层硬件又懂高层模型的稀缺人才瓶颈。面对未来,AI 的自主学习与自我改进(Self-Improvement)将在三到五年内迎来突破,这不仅会彻底瓦解传统的职业生涯规划,也将让生产力彻底脱离劳动力,迫使普通人以更具反脆弱性的心态直面科技海啸。
## Atmosphere & style 这场对谈散发着一种冷峻、硬核且极具科学思辨色彩的专业氛围。主持人与嘉宾的互动拒绝空谈,直面错综复杂的工程细节,在对 DeepSeek 等行业黑马与硅谷巨头的模式碰撞中,展现出一种大厂一线践行者的冷静与笃定。随着话题从枯燥的算子优化、垃圾数据洗选,延伸至机器自主提问对人类宏观经济的无情反噬,以及物理世界原子控制天花板的精彩辩论,节目的情感弧线从最初的技术理性逐渐走向对人类个体命运的深刻忧思,带给观众一种既震撼、清醒又带有强烈危机感的沉浸式技术洗礼。
## Key takeaways - [00:00](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=0s) 在大模型研究中,成功率在50%左右的混沌方向能带来最大的信息增量,比起追求高成功率的渐进式研究能更有效地加快迭代速度。 - [00:26](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=26s) NVIDIA 的核心护城河在于其底层编译器与深度学习框架之间厚重的定制化软件层,这导致非 CUDA 生态因缺乏软件共享而难以打破垄断。 - [00:47](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=47s) 针对数据厂商通过改写公开测试集制造的隐蔽数据欺诈(刷榜),大模型公司必须构建绝对不向外透露的内部私有评估基准进行防范。 - [03:00](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=180s) 大模型基础训练逻辑虽纯粹,但属于极度依赖经验科学的系统工程,全行业赖以预测成本的尺度定律(Scaling Laws)并无坚实理论基础,且常遭遇模型不 scale 的负面陷阱。 - [09:00](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=540s) 大模型分布式训练在反向传播(backward)阶段会导致 GPU 高度同步抽取海量电量,超出数据中心额定功率的设计盲区常导致节点大面积崩溃。 - [09:00](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=540s) 在大规模超算集群中,由于硬件损坏频繁,除了显性报错外,还会高频出现不报错但给出错误计算结果的“隐性数据损坏”。 - [11:16](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=676s) 分布式训练极度缺乏能同时精通模型底层逻辑、算子融合(Kernel 优化)以及网络通信架构的复合型稀缺工程人才。 - [17:07](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=1027s) 用语言模型清洗自身数据存在“左脚踩右脚”的内生闭环争议,但基于文本“鉴赏和理解难度”远小于“生成难度”的不对称性,自我蒸馏在工程上确实能大幅提升数据质量。 - [21:00](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=1260s) 硬核测试集 'Humanity's Last Exam' 的官方标准答案本身存在高达 40% 多错误,若模型测出高分反而暴露了其通过数据泄露死记硬背小抄的事实。 - [21:00](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=1260s) 将科研作为 KPI 工具会导致研究员纵容数据污染以刷高 benchmark 得分,损害科学精神,导致产品面向真实用户时现出原形。 - [31:40](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=1900s) 亚马逊预训练团队采用 Cost-to-Accuracy(相同准确率下节约的计算资源)作为季度衡量标准,并将成果进行打包汇报,从而保护了无法直接体现数据收益但极为关键的深度学习基础理论研究。 - [39:24](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=2364s) 未来的重大技术颠覆点在于 AI 的自主学习与自我改进(Self-Improvement),一旦模型能自主生成奖励信号,将彻底摆脱对人类设计环境的依赖,使学习成本降低百倍。 - [44:34](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=2674s) 高水平 AI 正在瓦解传统的职业生涯(Career)路线,初级岗位(entry level)被严重卡死,且压力正向更高级别岗位蔓延。 - [48:18](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=2898s) AI 时代使资本可以直接作用于结果,人类智能被商品化,且全行业资金转向非劳动密集型的 AI 产业,导致传统的宏观经济调控工具面临失效。 - [48:18](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=2898s) 物理世界存在“原子控制天花板”,相比于数字世界的精确与可扩展性,人类对传感器、控制器等复杂物理环境的控制远未达到完美的程度,这使得涉及原子的物理工作(如托育)短期内不易被轻易消灭。
## Detailed walkthrough ### [00:00](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=0s) 信息增量:为什么“成功率一半一半”的研究最有效率
在进行大模型相关的科学研究时,如果一个项目的成功率过高或过低,团队其实往往已经具备了极强的先验知识(prior),提前知道了它“大概会成”或者“大概不成”。这种实验在本质上是渐进式(incremental)的,更多是在确认和巩固已有的经验、直觉或偏见(bias)。
相反,如果一个方向的成功率正好在“一半一半”的混沌状态,则意味着团队对该领域的了解还非常有限。在科学研究中,恰恰是这种未知能带来最大的信息增量(information gain)。无论实验最后是成功还是失败,它都能反馈极具价值的信息,从而大幅加快试错与迭代的速度。这种方法论打破了追求“90%成功率”的传统考核直觉,能让团队在更短的时间内覆盖并探索一片更广阔的技术空间。
---
[00:26](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=26s) 硬件护城河的阵痛:跨硬件编译层的软件割裂
芯片巨头 NVIDIA 至今依然在拼尽全力推进和保护其庞大的技术护城河。谈及其他硬件厂商是否能对其构成明显威胁时,核心的难点并不在于硬件本身。不同的硬件厂家把芯片造出来,其实仅仅完成了整个系统工程中极小的一部分。
从最上层的深度学习框架,到底层的编译器(compiler),再到最基础的硬件架构,中间横亘着极其厚重的一层。这层专门针对各自硬件定制的编译器,成了各大厂商之间难以逾越的鸿沟。目前行业内各个硬件厂家的“软件共享”(software sharing)严重不足,每家都在各自的生态里闭门造车,这也是非 CUDA 生态很难真正打破垄断的系统级原因。
---
[00:47](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=47s) 隐蔽的数据欺诈:不可泄露的私有测试集
在模型训练的商业合作中,经常会有数据厂商宣称自己拥有一份“非常强大、能让模型能力大幅提升”的数据。然而在实际操作中,这类厂商很可能只是猜测了客户公司会使用的公开测试集(benchmark),然后将这些测试集的数据通过语意改写(paraphrase)的方式塞进训练集里。
这种做法虽然在表面上没有产生文本的完全精准匹配(exact match),但本质上已经造成了严重的数据泄露(leakage)。模型如果只去测那些被污染的公开 benchmark,得分当然会看起来非常惊人。为了防范这种行业内的“刷榜”套路,大模型公司必须具备高水准的“研究诚信”(research integrity),最核心的应对手段就是构建一套属于公司内部、绝对不能向外透露的“秘密评估基准”(secret evaluation benchmark)。
---
[01:14](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=74s) 亚马逊第一批大模型开拓者的独白
查晟目前在 Amazon AGI 团队担任高级经理(senior manager)。在加入该团队之前,他曾身处知名学者 Alex Smola 的组里负责深度学习框架的研发。在框架领域深耕一段时间后,他作为第一线核心成员,深度参与了亚马逊第一代大模型的开发全过程,并亲历了早期那些宝贵的失败经验。
从那时起,查晟的职业生涯便始终锚定在大模型领域,且技术路线一直偏向极具挑战性的预训练(pre-training)阶段。他曾直接在李沐(沐哥)的团队下工作,如今依然在深度参与亚马逊现有前沿大模型(Frontier models)的训练。这段从早期失败中摸索出来的技术沉淀,为他后续把控 Frontier 模型的正确演进路线奠定了坚实的基础。
---
[02:00](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=120s) 中美模型训练的围城:海量资源为何难出顶尖大模型
当大模型训练的神秘面纱被揭开,业界常有一种极端的舆论对比:一方面,像中国的 DeepSeek 据传仅用了 1% 的成本就训练出了极其优秀的模型,KIMI、MiniMax 等国内公司也纷纷拿出了高水平的产出;另一方面,像亚马逊、微软、Meta 这样坐拥海量资源与顶尖人才的硅谷巨头,在亲手搞出属于自己的顶尖模型时却显得异常艰难。
针对这种“看起来既难又不难”的怪象,大模型的基础训练逻辑其实非常纯粹,目前业界基本都采用“预测下一个字符”(next-token prediction)的方式,让模型在庞大的文本语料中寻找压缩海量信息的机会。随后,再通过中期训练和后训练(post-training)等额外步骤,将这些压缩的信息转化为对具体任务有用的能力。想要训练出像 DeepSeek 那样优秀的模型,整个系统工程链条上的每一个环环相扣的细节都必须全部做对。只要有一个地方掉链子,正向的迭代循环就无法运转。
---
[03:00](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=180s) 经验科学的隐形坑:被神话与被误读的 Scaling Laws
大模型训练在本质上是一门经验科学,这意味着传统的机器学习基本功必须做得极其扎实。在研究迭代的过程中,由于模型规模庞大,每一次实验的成本都极高。为了应对这种成本挑战,全行业的实验室目前都在高度依赖“尺度定律”(scaling laws)——即通过拟合数据量与模型表现的 XY 轴曲线关系,试图用小规模的实验去精准预测大规模训练时的效果,从而节省成本。
然而,scaling laws 至少到目前为止只是一个经验规律,并没有坚实的理论基础。虽然概念听起来很简单,但在实际操作中,各家实验室在切分实验空间、理解各种因子协同作用(factor interaction)时,做法很快就会产生分歧(diverge)。最让人头疼的是大模型的涌现特性(emergent properties):有时候小规模表现平平,大规模会“piu~”地一下突然冒出惊人能力;但同样高频出现的还有负面陷阱——模型在推到某个特定规模时突然跌落曲线(fall off scaling laws),彻底不 scale 了。几乎每个头部的实验室都必须亲自踩过这个大坑,建立起极其严苛的纪律(discipline),学会在小规模实验中盯防除了 loss 之外的其他核心变量趋势。
- **经验科学的论文弊病**:过去学术界存在“过度概括结论”(over-generalize)的倾向。研究员在一个特定设置(setting)下发现某个想法有效或无效,就会在论文里宣称该 idea 普适,读者必须拿捏精妙的“研究品味”(research taste),仔细审视其实验的具体 setting。 - **实验数据的真实度**:虽然学术界存在挑好结果展示(cherry pick)的现象,但总的来说,论文中的原始实验数据依然是相对可信的,极少有直接造假。
---
[09:00](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=540s) 超算底座的考验: backward 瞬间的电流海啸与硬件损耗
大模型的大规模分布式训练绝对不是简单的服务器堆叠,它对基础设施(infra)团队的靠谱程度有着近乎变态的要求。由于目前行业普遍采用同步优化(synchronous optimization),在训练的反向传播(backward)阶段,所有的 GPU 会在同一时间爆发出海量的计算需求。
这种高度同步的计算激增(compute surge)会导致整个集群的 GPU 在同一秒钟疯狂抽取巨大的电量。如果数据中心在设计之初没有准备足够大的电力缓冲(buffer),就会遭遇诡异的硬件崩溃。在计算峰值时,GPU 实际抽取的电量甚至会超过显卡上标定的额定功率,很多数据中心的设计人员根本对此一无所知。其结果就是在大模型训练到 backward 的刹那,节点(node)经常会因为瞬间电量不足而直接大面积挂掉。
- **沉默的数据腐败**:当集群规模上升到一定程度后,GPU 的损坏成了家常便饭。除了显存银行(memory bank)损坏等显性报错外,还会频繁出现“隐性数据损坏”(silent data corruption)——硬件不报错,但是给出了完全错误的计算数字。 - **超算与云计算的基因差异**:亚马逊虽然拥有 AWS 多年的深厚积累,但在面对超算(HPC)时依然需要经历痛苦的学习过程。传统的云服务核心思路是“规模化零售少量的计算”,而超算则是一种性质完全不同的、极其独特的 workload 场景。
---
[11:16](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=676s) 分布式并行的极限优化:寻找既懂硬件又懂模型的稀缺人才
在基础设施稳定、容错机制(fault tolerance)做好的前提下,分布式训练的性能与通信效率成了决定成败的胜负手。模型如何进行切块并行计算、切块后数据的通信发生在什么级别的网络上(是走 GPU 之间的 NVLink,还是走机器之间的网络连接),其延迟(latency)和带宽有着天壤之别。
为了让 GPU 尽可能保持忙碌(busy)、减少昂贵的访存开销,业界最常用的手法就是“算子融合”(kernel fusion)。例如,在计算完一个矩阵乘法(Matrix multiplication)后,紧接着要过一个激活函数(如 Tanh 或 Sigmoid)。常规做法需要把中间结果先写回显存、再读回来计算,这会带来多余的访存。如果在矩阵乘法的结尾(epilogue)直接加上激活函数的计算步骤,就能完美省去一次访存,极大提升计算性能。然而,全行业能做这种优化的人凤毛麟角。他必须同时精通模型、懂得修改底层计算逻辑、深谙硬件架构,并且还要秒懂网络通信。
- **大厂与小团队的组织对撞**:像 Google 这样底蕴深厚的大厂,长期投资的基础设施和编译器(compiler)极为强大,通常会将这些角色拆分开来。但传统大厂也饱受组织架构割裂的困扰,项目往往被分给不同的 director,各自拉起小团队,容易陷入话语权政治(scope politics)、互相拖后腿和拆台的内耗中。 - **DeepSeek 模式的传闻**:在 DeepSeek 这样的精干团队中,做模型、做系统架构和做数据的人往往互相对彼此的工作极其了解,合作毫无交流壁垒(overhead),全员保持极高的人才密度(talent density),在快速迭代中一旦发现错误就能立马调头做对。
---
[15:07](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=907s) 垃圾数据的过滤:从微波炉的“嗡嗡声”说起
在大模型的预训练和后训练阶段,数据团队对“好常识”和“好品味”的把控至关重要。只要数据清洗的人愿意花心思,聪明的团队总能用工程化的方式迭代出一版高质量的数据。
AI2(艾伦人工智能研究所)曾分享过一个极具代表性的趣味案例:在海外贴吧 Reddit 上有一个名为 “microwave gang”(微波炉帮)的奇葩社区,里面的网民不干别的,所有的回帖都在用纯文本去模拟微波炉运行的噪音。打开帖子,满眼都是密密麻麻的“MMMMM……”字符,中间还偶尔突兀地蹦出一个“ding~”。这种文本如果被海量扫进训练集,对于模型而言完全是一个莫名其妙的独立领域(domain),会在训练时直接导致 loss 瞬间爆炸。互联网上充斥着大量这类为了搜索引擎优化(SEO)而存在的垃圾文本,必须被无情地过滤掉。
---
[17:07](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=1027s) 合成数据的悖论:用语言模型洗数据的“左脚踩右脚”辩论
针对动辄万亿(trillion)级别的信息洪流,人工肉眼审查显然是不现实的,行业普遍在用语言模型(LLM)去清洗和筛选数据,甚至直接用合成数据(synthetic data)来喂养新模型。但这在业内引发了一场巨大的方法论辩论:用语言模型去评估和清洗语言模型,在信息增量的角度上听起来像是一种缺乏外部输入(exogenous)的内生(endogenous)闭环,这真的能奏效吗?
从宏观层面上看,这种“左脚踩右脚”确实没有引入新的绝对信息,但它在工程上具有强烈的现实意义。文本生成的难度实际上远远大于对文本好坏的“鉴赏和理解难度”——这中间存在一种美妙的“不对称性”(asymmetry)。就像猴子打字机一样,26个字母的组合空间虽然涵盖了莎士比亚的所有作品,但关键在于如何把好东西“找出来”。模型自己写的东西可能一团糟,但它自己其实具备甄别好坏的能力,洗数据的本质就是把稀疏的优质数据通过过滤提升权重。
- **自我蒸馏与情感测试的段子**:最近许多关于自我蒸馏(self-distillation)的研究表明,模型的“奖励端”(reward side)往往比“生成端”(generation side)拥有更多的信息。通过这种不对称性,模型可以实现自我调和与开悟。主持人幽默地调侃道:“这感觉就像女生跟男生谈恋爱的时候,设置一些奇怪的 test 那种……回答对了,说明你小子有潜力。” - **数据人才的背景**:真正能把数据质量把控好的人,其专业训练背景反而没那么死板。他们不一定非得是传统的 data scientist,但必须极具常识、喜欢享受找问题的过程。在实际业务中,跟这类脏活累活打交道的,多数是深入一线的 NLP(自然语言处理)或机器学习方向的博士。
---
[21:00](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=1260s) 评测指标的谎言:走光的“小抄”与被玩弄的 Benchmark
在模型研发的所有环节中,评估(evaluation)高居核心地位。如果某家友商在发布模型前把 evaluation 做对了,他们是绝对不会把一个糟糕的模型放出来的。然而,许多刚跨界做大语言模型的人存在一个巨大的认知误区,认为在预训练阶段“过拟合(overfit)或者数据泄露(leakage)没那么要紧”,觉得知识本来就是靠死记硬背。
这种错误的直觉会直接带偏整个研发团队的迭代方向。一旦训练数据中混入了测试集的“小抄”,优化出来的模型就会严重偏向记忆(memorize)而非真正的压缩和理解。此时,公开的 benchmark 就会彻底失真,无法指示模型的真实能力。更恶劣的行业乱象在于,一些数据厂商为了卖数据,会故意把公开 benchmark 里的题目进行语意改写后混进数据商品中。如果大模型公司没有自己一套“永远不对外披露的私有评测集”,就会在不知不觉中被蒙骗。
- **小抄竟然是错的**:查晟爆料了一个令人啼笑皆非的行业典型反例——著名的硬核测试集 "Humanity's Last Exam"(人类最后的考试)。这个评测集由于题目极难,其本身给出的官方标准答案里竟然有高达 40% 多都是错的。查晟犀利地调侃道:“你要是给我刷出个 70% 的高分来,那你肯定是通过数据泄露见过错误答案。老师一改卷子,发现怎么错的都一样嘛。” - **KPI 对科学精神的摧残**:当市面上的 benchmark 沦为各大实验室的营销(marketing)工具,科研团队就面临着严重的扭曲。上面的硬性指标压下来,科学家为了赶 deadline,只能放弃精细的数据筛选,纵容数据污染去刷高分。主持人痛斥这本质上是“KPI 衡量 versus 科学精神的 PK”,用偷懒和量化的方式去管理科研,最终只会损害科研精神,导致产品推向用户时现出原形。查晟建议商家:“至少在内部开发的时候不要去 overfit benchmark,之后 marketing 的时候你再 overfit 说吧。”
---
[30:00](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=1800s) 亚马逊团队的破局之道:如何用信息增量设计团队激励
为了在狂躁的行业风气中保持定力,查晟分享了他目前带领的亚马逊预训练研究团队在激励机制(incentive)上的独特设计。在convince(说服)团队成员保持科学严谨、坚决不搞 benchmark 过拟合、坚持清洗干净数据的基础上,如何在一个无边无际的预训练空间里下注(make bets),成了一个巨大的课题。
查晟的团队在日常研发中,允许并鼓励所有的 researcher 在各自擅长的专业领域里自由迭代,使用前文提到的“最大化信息增量”的方法去探索最前沿的技术。团队不以短期的公开指标论英雄,而是看每个人学到了多少新认知。每个季度,团队会集中申请一批极为庞大的计算资源,进行一次实战演练式的尺度放大(scale up)。在跨越了 $10^{23}$ 次方 FLOPs 的计算规模门槛后,各种推理(reasoning)的评测集上就能开始看到非零的有效数字。通过这种定期的大规模实战,团队可以集中检验各个方向的设计在规模化后的真实表现。
[31:40](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=1900s) 以 Cost-to-Accuracy 衡量研究进度与算力分配的现实
在模型训练的实际管理中,团队拥有一套明确的阶段性量化指标。具体而言,每个季度团队都会对比上一个季度的数据,评估在将模型训练到同样准确率(accuracy)的情况下,究竟能够节约多少计算资源(compute)。这种被称为 "cost-to-accuracy bar" 的方式,成为了衡量训练研究进度的核心标准。这一内幕让访谈者感到有些意外,因为在外界看来,这样的顶尖研究团队理应拥有无限的算力支持,而现实中似乎也需要紧巴巴地精打细算。
实际上,不论在哪个大厂,即便是像 OpenAI 这样的顶尖机构,算力分配都是一个普遍的难点。因为生产环境(production)和托管服务(hosting)本身就需要消耗海量的计算资源。不过,团队平时在中小规模实验上的算力依然是充足的,每个人跑几台机器进行快速迭代完全没有问题。只有当真正需要大到 scale up 的时候,才会去申请更多机器。为了帮缺乏直观概念的观众“可视化”大模型训练的数据量,嘉宾指出,真正大规模训练时可能需要将一整个数据中心(data center)的算力打包成一个 job 来跑,而训练所消耗的文本量动辄达到几十个 trillion 的 token,光是纯文本数据就有几百个 terabytes。
- 衡量指标:Cost-to-Accuracy 比率,即在保持相同准确率的前提下对比季度间计算资源的节省程度。 - 数据与算力规模:中小规模实验仅需每人几台机器,而大规模训练需要调动整个数据中心,消耗几十万亿(trillion)token 的文本,数据量达几百 TB。
---
[33:39](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=2019s) 团队打包汇报的激励机制与个人能力的评估
采用 Cost-to-Accuracy 比率向老板汇报还有一个巨大的管理学优势,那就是能将整个团队的产出阶段性地转化为与核心业务直接相关的、可量化的结果。这在团队内部的激励上起到了关键作用。由于不同的研究方向(如深度学习理论、优化器设计等)其产生收益(gain)的周期各不相同,预期收益也参差不齐。如果把每个人节省了多少算力拆开来单独 justification,不仅难以权衡,还会破坏凝聚力。将整个团队的研究成果“打包”成一个新的recipe(配方)来进行整体衡量,完美地解决了这个问题。
这种打包机制很好地保护了那些“无法直接反映出数据 gain 却能 enable everything else”的基础研究。例如深度学习理论,它可能只是告诉团队某一些初始化(initialization)或者 scaling 应该怎么做,表面上看不出直接的好处,却是所有其他突破的基石。至于如何衡量单个研究员(individual researcher)的水平,主管则需要深入具体的路线。例如对比外面开源或业界通用的优化器(optimizer),看团队自己研发的 optimizer 能往前推多远。访谈者感叹这极其考验管理者的功力,因为这要求主管对每一个技术方向都具备极其深刻的了解,必须从工作本身而不是单纯的结果数据去进行主观判断。嘉宾则谦虚地表示,这对自己而言也是个难得的学习机会,促使他必须有能力深入探索每一个垂直领域。
---
[36:01](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=2161s) 基础设施人才的短缺与 NVIDIA 的生态护城河
在谈到对当前技术路线与后辈的建议时,嘉宾特别希望还在学校的 PhD 们能够多接受一些工程训练,甚至去做一些“不 scale 的事情”。比如高性能计算中常见的优化技术、通信模式(communication pattern)等。在当前“实现(throughput)赶不上想法(idea)生成速度”的行业背景下,实现的工程能力已经成为了显著的瓶颈。目前行业在 Kernel 优化、分布式模型训练设计以及网络通信(networking communication)层面上,人才都极为紧缺。访谈者调侃这听起来又是“利好 NVIDIA”,本质上还是算力不够或者算力利用率不高。
针对 NVIDIA 的竞争格局,嘉宾认为 NVIDIA 极其勤奋,正在通过各种方式保护并扩大自己的护城河。例如他们推出的 Tile Language,允许开发者用更高层的语言去写 Kernel,正好填补了 Triton 编译器在最近两代 GPU 上效果不够好的一些特征差距(feature gap)。相比之下,其他硬件厂家虽然硬件造出来了,但从深度学习框架到编译器(compiler)再到硬件的中间那一层“针对自己硬件的编译器”,由于存在诸多私有协议(proprietary),导致业界缺乏有效的开源或软件共享策略。访谈者指出,去 compete 一个已经成为行业标准的生态,第 2 名到第 100 名加起来都很难搞定。更何况 NVIDIA 自己甚至已经开始用 AI Agent 来写 Kernel,其 CUDA 库的迭代速度呈指数级加快,几乎是“最卷、人才最集中、资金最集中、leadership vision 最好”的公司,其生态护城河远比想象中还要大。
- 稀缺技术领域:Kernel 优化、分布式训练设计、网络通信层高性能模式实现。 - NVIDIA 技术动态:推出 Tile Language 填补 Triton 编译器在最新 GPU 上的 feature gap,并已开始利用 Agent 编写自身的 kernel。
---
[39:24](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=2364s) 下一个技术颠覆点:AI 的自主学习与自我改进(Self-Improvement)
谈及未来的技术趋势,嘉宾用之前提到的“填表/数据库”进行了具象化的拆解。目前诸如 Frontier Labs 等顶尖实验室,依然在通过“劳动密集型”的方式去完善和填补大模型这张大表。拥有大量用户的厂家会通过用户的 prompt 去挖掘好玩的意图(intent),作为收集数据的信号。然而,这种模式的瓶颈依然在人:每当要覆盖一个新的领域(domain),必须由人类去寻找意图,在 post-training 阶段找到对应的环境(environment)和奖励(reward),用代码 program 出来,再通过训练塞回模型里。
> "如果模型它会自己去找新的environment,去找新的reward...那么他的学习就会不再依赖于人。"
真正的Disruption(颠覆)在于,一旦模型能够自主生成 reward function 或其他奖励信号,形式上就会非常接近开放式环境下的 Alpha Zero。当模型解锁了持续学习(continue learning)和自主寻找信号的能力,填表的成本可能会瞬间降低 10 倍、100 倍甚至降到基本没有。任何现在必须靠人做的任务,模型可能一两天之内就能学会,甚至它自己还会主动提问。访谈者深有同感,表示目前让 AI 写视频脚本的瓶颈就在于人类是否能问出正确的问题,如果 AI 能够自己出题、“自主提问”,那将产生质的飞跃。嘉宾比较不保守地预测,这一颠覆性技术有 70% 的概率在未来三到五年内得到解决。届时,模型一旦部署到机器人上,人类可以马上教会它新的场景与任务,且它学完之后“以后就一直会了”。
---
[44:34](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=2674s) 传统职业规划的消亡与生产力脱离劳动力的宏观困局
技术的指数级跃迁必然反噬人类的社会结构。访谈者提到在一档节目中看到关于中国传统道德文明的讨论,即古人其实一直清醒地意识到“什么样的智慧是不应该有的”,无限的知识很可能给人类带来的是一个 bane(祸害)。嘉宾也分享了自己在 LinkedIn 上的观察:从 2024 年、2025 年开始,很多刚毕业的学生来咨询职业问题,普遍反映初级岗位(entry level job)极其难找,且这种压力正在往更高级别(job level)的岗位蔓延。这直接从根本上否定了传统所谓的 Career(职业生涯)路线。访谈者补充道,Career 这个词本身就是工业革命为了规制人类而创造出来的假象,乔布斯也曾表达过完全一样的观点。
当 Career 不复存在,普通人将面临如何继续参与经济活动的残酷现实。对此,嘉宾高度赞赏了访谈者(课代表)做独立自媒体、在公司之外寻找并创造价值的做法。访谈者坦言,自己早在 2023 年提出这些建议时曾被痛骂“贩卖焦虑”,但现实的残酷之处在于“并不 care 我们的 feeling 到底是怎么样的”。从宏观经济学来看,以往美联储调整利率主要看通胀和就业率,但现在的资金流向全都是非劳动密集型的 AI 产业。这种生产力发展彻底脱离劳动力的现象,导致传统的调控工具直接失灵。
- 传统概念的消亡:传统 Career 路线正在被高水平 AI 瓦解,入口级的 entry level 岗位被严重卡死。 - 宏观经济失灵:资金大量流向资本密集(而非劳动密集)的 AI 产业,导致美联储通过利率调控就业与通胀的传统传导机制面临失效。
---
[48:18](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=2898s) 资本对结果的直接作用与物理世界的原子天花板
在经济学模型中,劳动力(labor)和资本(capital)本身是一种 trade off。访谈者指出,十几年前克鲁格曼(Krugman)就在《纽约时报》上撰文讨论过政策过于 favor capital 的倾向。在 AI 时代到来前,资本想要达成任何目标都必须通过人作为介质。例如 Blue Origin 砸了那么多钱却追不上 SpaceX,是因为马斯克懂得如何管理科学家、让人爆发智能。但在未来,当人类的智能被商品化(commoditize)之后,资本将可以直接作用于结果,这对于打工人而言是一个极其糟糕的信号。即使民众希望通过政策确保基本福利,但在激烈的国际竞争和国际压力下,各个国家和企业为了不落后,依然会把所有资源和电力优先喂给 AI,而不是用来提升人类个体的生活标准。
不过,访谈者对个体的命运虽然非常不乐观,对宏观却持有一种独特的相对乐观态度,因为他认为大多数人的工作(如 daycare 的托育老师照顾小孩)并不会像知识工作者(knowledge worker)那样轻易被 AI 消灭。针对“仿生机器人会不会快速替代这类物理工作”的问题,访谈者与嘉宾展开了精彩的辩论。访谈者认为,物理世界存在一个巨大的“原子控制天花板”。制造机器人的算法虽然 ready 了,但传感器(sensor)和控制器的复杂度高得难以想象。
> "把火箭发射到月球上是一个简单问题,它不是一个complex问题...但是你拿铁拉花,甚至你拿一个杯子,它是一个complex问题。"
正如人类化学可以轻易合成钻石却无法完美合成蓝宝石、能批量生产可乐却无法复制含有几千种化合物的红酒一样,人类目前对原子的控制远远没有达到数字世界(digital world)那种精确和 Scalable 的程度。在数字世界里,人们可以盖一座一千亿层的楼,但在地球上却盖不出一座一千层的建筑。嘉宾虽然理解这一关于物理天花板的视角,但依然坚持认为,一旦 AI 解决了持续学习的问题,物理空间(space)的探索只是时间问题。访谈最后,访谈者感叹在机器面前,人类多年积累下来的智能显得极其渺小与单薄。在这个充满巨大不确定性的时代,嘉宾给出了一套“反脆弱”的终极建议:现在正是take risk的时候,大家应该更加积极勇敢地去直面风险。
## Notable quotes > [39:24](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=2364s) 如果模型它会自己去找新的environment,去找新的reward...那么他的学习就会不再依赖于人。 — 查晟
> [48:18](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=2898s) 把火箭发射到月球上是一个简单问题,它不是一个complex问题...但是你拿铁拉花,甚至你拿一个杯子,它是一个complex问题。 — 课代表
> [21:00](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=1260s) 你要是给我刷出个 70% 的高分来,那你肯定是通过数据泄露见过错误答案。老师一改卷子,发现怎么错的都一样嘛。 — 查晟
> [21:00](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=1260s) 至少在内部开发的时候不要去 overfit benchmark,之后 marketing 的时候你再 overfit 说吧。 — 查晟
> [17:07](https://www.youtube.com/watch?v=Uh0F_suae5Q&t=1027s) 这感觉就像女生跟男生谈恋爱的时候,设置一些奇怪的 test 那种……回答对了,说明你小子有潜力。 — 课代表
## Mentioned Amazon AGI, Alex Smola, 李沐, DeepSeek, KIMI, MiniMax, NVIDIA, CUDA, AI2, Reddit, Humanity's Last Exam, OpenAI, Tile Language, Triton, Alpha Zero, LinkedIn, Blue Origin, SpaceX, 克鲁格曼, 纽约时报
[Source](https://www.youtube.com/watch?v=Uh0F_suae5Q)