开源决策模型Laya叫板TypeSafe 11天揽近3万星
AI技术投降派
大模型负责生成而小模型专攻决策正在成为降本共识,将低延迟判定任务从生成式模型中剥离是企业压缩AI成本最关键的一环。
AI-assisted summary of Laya - 面向结构化决策的开源模型 — original source. Check the original for full context.
Source published:
Key ideas
- 开源决策模型 Laya 采用非自回归编码器单次前向传播架构,单次推理仅需 33 毫秒(批量摊薄至 7 毫秒),无幻觉风险且免去 JSON 解析。 (0:00)
- 面对商业竞品 Jev 的包装压制,独立开发者 Nandakishor 凭借全面开源与更优性能回击,项目 11 天内收获超 2.8 万颗 GitHub Star。 (2:46)
- 实测对比显示 Laya 较 Jev 提速 6 至 7.8 倍且校准误差降低 3 倍,但在 Banking77 等 77 类别的高基数场景下准确率大幅落后(0.425 对 0.870)。 (4:05)
- 作者在 README 中坦诚公开长达百行的失败模式,直言未经微调的基础模型零样本准确率仅 0.362,接近纯随机猜测。 (5:14)
Detailed notes
## Background 该视频由 UP 主“AI技术投降派”于2026年10月14日发布在 Bilibili 平台。简介介绍了独立开发者 Nandakishor 在研究构想被商业前沿实验室包装成“突破”并重新发布后,没有陷入骂战,而是将项目重组成更快、更准、完全开源的决策引擎 Laya,并在短短11天内狂揽2.87万颗 GitHub Star 的反击故事。
## TL;DR 视频深入剖析了面向结构化决策的开源引擎 Laya 的架构设计与行业价值。Laya 将快思考(System 1)从慢思考(System 2)生成式大模型中剥离,摒弃逐 token 自回归解码,通过编码器单次前向传播在33毫秒内直接输出选择、打分与严格校准的概率,从根本上杜绝了幻觉与文本解析成本。主讲人详细对比了 Laya 相对于商业闭源竞品 Jev 在速度和校准度上的碾压优势及其在高基数分类上的短板,并重点解读了其坦诚公布的一百行模型缺陷与失败模式。最后总结指出,决策与生成的解耦是企业落地 AI 降本的关键路径,但也提醒开发者该基底模型在投入生产前必须依赖业务微调与闭环验证。
## Atmosphere & style 全片洋溢着极客浪漫主义与开源力量对抗资本叙事的昂扬快感,主讲人语调干脆利落、立场鲜明,对独立开发者的坚韧抱有强烈的共情。叙事结构极富戏剧张力,从成果被大厂剽窃的憋屈开场,迅速拉升至靠极致性能打脸竞品的酣畅淋漓,随后又以极度克制、冷静的工程师视角逐条剖析缺陷大泼冷水。整体观感既有为开源原创者扬眉吐气的痛快,又兼具硬核技术拆解的严谨与理性。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1uoad6sEit?t=0s) 开源决策模型 Laya 采用非自回归编码器单次前向传播架构,单次推理仅需 33 毫秒(批量摊薄至 7 毫秒),无幻觉风险且免去 JSON 解析。 - [02:46](https://www.bilibili.com/video/BV1uoad6sEit?t=166s) 面对商业竞品 Jev 的包装压制,独立开发者 Nandakishor 凭借全面开源与更优性能回击,项目 11 天内收获超 2.8 万颗 GitHub Star。 - [04:05](https://www.bilibili.com/video/BV1uoad6sEit?t=245s) 实测对比显示 Laya 较 Jev 提速 6 至 7.8 倍且校准误差降低 3 倍,但在 Banking77 等 77 类别的高基数场景下准确率大幅落后(0.425 对 0.870)。 - [05:14](https://www.bilibili.com/video/BV1uoad6sEit?t=314s) 作者在 README 中坦诚公开长达百行的失败模式,直言未经微调的基础模型零样本准确率仅 0.362,接近纯随机猜测。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1uoad6sEit?t=0s) 架构解耦成为共识:传统 LLM(System 2)长于生成但慢且昂贵,工单路由、内容审核等纯决策任务应交由非自回归的轻量模型(System 1)处理以大幅降本。 - [00:42](https://www.bilibili.com/video/BV1uoad6sEit?t=42s) Laya 将决策抽象为三种类型化原语:choice(离散选择)、score(序数打分)以及 bool(输出校准真实概率的是非题)。 - [01:51](https://www.bilibili.com/video/BV1uoad6sEit?t=111s) 采用 420M 参数的 ModernBERT-large 英文版与 320M 参数的多语言版双检查点,并通过前置 Router 实现百种语言的自动流量分发。 - [01:51](https://www.bilibili.com/video/BV1uoad6sEit?t=111s) 引入 RLCD 训练方案,直接对 Logarithmic 等严格适当评分规则进行强化学习优化,确保模型输出的置信度具备真实的统计校准意义。 - [01:51](https://www.bilibili.com/video/BV1uoad6sEit?t=111s) 周边工程生态覆盖完善,提供 HTTP 服务端、MCP 插件、LangChain/LlamaIndex 集成以及基于 Wasm/TypeScript 的浏览器端推理套件。 - [02:46](https://www.bilibili.com/video/BV1uoad6sEit?t=166s) 独立开发者的原创建模方案曾无人问津,面对大厂前沿实验室的闭源同类产品,以更高性能与全面开源赢得了开源社区的信任票。 - [04:05](https://www.bilibili.com/video/BV1uoad6sEit?t=245s) 与商业闭源竞品 Jev 相比,Laya 兼具毫秒级低延迟与 Apache 2.0 免费自托管优势,且消除了 Jev 在 16% 样本上置信度归零的严重失真缺陷。 - [04:05](https://www.bilibili.com/video/BV1uoad6sEit?t=245s) 受限于候选标签在输入端共享固定 Token 预算的机制,Laya 在面对极端多标签的高基数分类任务时表现显著劣化。 - [05:14](https://www.bilibili.com/video/BV1uoad6sEit?t=314s) README 设立了详尽的“诚实限制”章节并附带复现 Issue,坦诚披露了基础模型零样本性能脆弱、布尔词标签强偏见等严重缺陷。 - [05:14](https://www.bilibili.com/video/BV1uoad6sEit?t=314s) 模型存在显著的否定句理解漏洞(如将‘不想注销’以极高置信度误判为‘想注销’)以及高达 3.6 Logits 的候选项排列位置偏差。 - [06:39](https://www.bilibili.com/video/BV1uoad6sEit?t=399s) 决策类任务是工业级 AI 吞吐量最庞大的一环,将其从生成模型中剥离出来是企业端实施推理降本最核心的切入点。 - [06:39](https://www.bilibili.com/video/BV1uoad6sEit?t=399s) 切忌盲从 Star 数量直接裸装上线,开发者在生产落地前必须基于私有业务数据完成垂直微调与闭环回归验证。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1uoad6sEit?t=0s) 开场:System 1 与 System 2 的架构分工
一个独立开发者在一年前将自己的研究构想写成论文并完全开源,却几乎无人问津。到了2026年9月,一家前沿商业实验室发布了几乎一模一样的产品,并将其包装宣传为一项“突破性进展”。面对这种被掠夺成果的局面,该开发者没有陷入网络骂战,而是重新迭代了自己的项目,使其变得比商业竞品更快、更准、更开放,随后将其推上了 GitHub。短短11天内,该项目便收获了28,700颗星。这个开源项目名为 Laya。
从本质来看,Laya 是一个非自回归的 System 1 决策引擎。借用丹尼尔·卡尼曼的认知双系统理论:人脑中存在快思考(System 1)与慢思考(System 2)。当前主流的大语言模型(LLM)是典型的 System 2——采用自回归生成、逐 token 输出,过程缓慢且成本高昂。然而,现实业务场景中的海量任务根本不需要模型进行长篇大论的文本生成,而仅仅需要纯粹的决策:一封客户邮件该分发给哪个部门、一个工单的紧急程度究竟有多高、一条用户留言是否暗示了流失风险。主讲人指出:“为一个三选一的判断调用一个生成式大模型,就像用卡车送外卖。”
Laya 的核心逻辑完全抛弃了文本生成,依靠编码器(Encoder)的一次前向传播(Forward Pass)直接输出最终答案,单次推理仅需33毫秒。由于不输出任何自然语言文本,开发者不需要编写脆弱的正则去解析 JSON,系统层面也从根本上杜绝了产生幻觉的可能。
```mermaid flowchart TD accTitle: Laya vs Generative LLM Decision Flow accDescr: Comparison between standard LLM autoregressive generation and Laya single forward pass. subgraph LLM["传统生成式大模型 (System 2)"] A1["输入文本"] --> A2["逐 Token 自回归解码 (数百毫秒)"] A2 --> A3["长文本 / JSON 解析"] A3 --> A4["易幻觉 / 解析失败风险"] end
subgraph LAYA["Laya 决策引擎 (System 1)"] B1["输入文档 + 结构化问题"] --> B2["编码器单次前向传播 (33ms)"] B2 --> B3["直接输出类型化原语"] B3 --> B4["零幻觉 / 免解析 / 校准概率"] end ```
Laya 将现实中的复杂决策归纳为三种类型化原语: - **choice(选择题)**:适用于部门工单路由、用户意图多分类等离散选择。 - **score(序数打分)**:适用于评估任务紧急程度、安全伤害等级等打分场景。 - **bool(是非题)**:返回严格校准后的真实概率,专用于钓鱼检测、垃圾信息过滤、用户流失预警等二分类判定。 - 在单次 API 调用中,用户可以传入一份文档同时向其抛出任意多个决策问题;在批量处理模式下,单题耗时可平摊压缩至仅需7毫秒。
---
[01:51](https://www.bilibili.com/video/BV1uoad6sEit?t=111s) 架构实现、RLCD 训练与生态配套
在架构设计上,Laya 由三个核心检查点(Checkpoints)与一个前置路由器(Router)共同构成: 1. **Laya 英文版**:基于 ModernBERT-large 编码器打造,参数量为4.2亿(420M)。 2. **Laya Multilingual(多语言版)**:参数量为3.2亿(320M),原生支持100多种语言,推理速度相较英文大版本直接翻倍。 3. **Laya Decisions**:经过专项任务精细微调的衍生版本。 4. **Router(路由器)**:常驻前端根据输入请求动态分流模型,例如一旦检测到印地语或西班牙语文本,路由器会自动将流量切换至多语言模型处理。
Laya 概率输出的高保真度源于其独特的训练方案——RLCD(Reinforcement Learning from Consistent Decisions / 基于适当评分规则的强化学习)。传统的分类置信度往往是模型未校准的盲目自信,而 Laya 在训练中直接利用强化学习对“严格适当评分规则”(Strictly Proper Scoring Rules,如 Logarithmic Score、Spherical Score 等)进行定向优化。这类评分规则在数学理论上能证明:只有当模型输出的预测概率完全契合客观真实概率时,其获得的数学期望奖励才会达到最大化。因此,Laya 吐出的置信度是经过严格统计校准的真概率。
在工程生态落地方面,项目提供了完备的周边工具链:开箱即用的 HTTP 服务端、MCP(Model Context Protocol)服务器插件、对 LangChain、LlamaIndex、Bespoke AI 的生态集成支持、ONNX 运行时量化加速方案,甚至还推出了可直接在浏览器客户端内运行的 TypeScript / Wasm 版本。
---
[02:46](https://www.bilibili.com/video/BV1uoad6sEit?t=166s) 独立开发者的反击:被“重新发明”的一年
这段开源历程充满了戏剧性。回溯时间线,早在2025年3月,印度独立开发者 Nandakishor 就撰写并发布了学术论文,提出利用 PPO 强化学习训练序列表示并直接输出校准决策概率的构想;他同步开源了完整的模型权重、训练数据集以及配套的 Python 软件包,并将成果发布在 Reddit 的 LocalLLaMA 本地模型技术社区。但在当时,这个构想基本没有激起任何水花。2025年9月,他又坚持发布了第二篇进阶论文。
转折发生在2026年9月。一家名为 TypeSafe AI 的商业化初创公司高调推出了商业产品 Jev。值得注意的是,该公司的联合创始人之一正是 ChatGPT 的联合发明人 Diogo Almeida。Jev 的底层逻辑同样是非自回归决策模型,商业 API 定价为每百万 Token 4.2美分。其对外宣传口径全网宣称为“AI领域的全新突破”,然而既没有公开学术论文,也没有开源底层权重代码。
这一事件对 Nandakishor 造成了巨大的心理冲击。他在技术文章中坦言,看到铺天盖地的宣传时自己“既感到被验证,又深感挫败”:自己付出了数个月的汗水、努力与无数个不眠之夜,而一家资金雄厚的前沿实验室只需将同样的核心思路重新包装一遍,就能轻易收割所有聚光灯与行业荣耀。
主讲人强调,Nandakishor 的选择令人敬佩:“他的处理方式是与其一直心怀怨恨,不如做出更好的版本来。”他将愤怒转化为生产力,彻底重构出更快、更强、且坚持完全开放的 Laya。在没有任何公关资源推广的情况下,11天斩获28,700颗 GitHub Stars,全球开源开发者用手中的 Star 为真正的原创者投出了信任票。
---
[04:05](https://www.bilibili.com/video/BV1uoad6sEit?t=245s) 硬核数字对决:赢的坦白,输的也认
在与商业闭源模型 Jev 的横向对比中,作者保持了极其严谨的科学态度(标明 Jev 的数据来源于第三方公开已发表的基准报告,Laya 仓库并未直接闭环实测过 Jev 的线上接口):
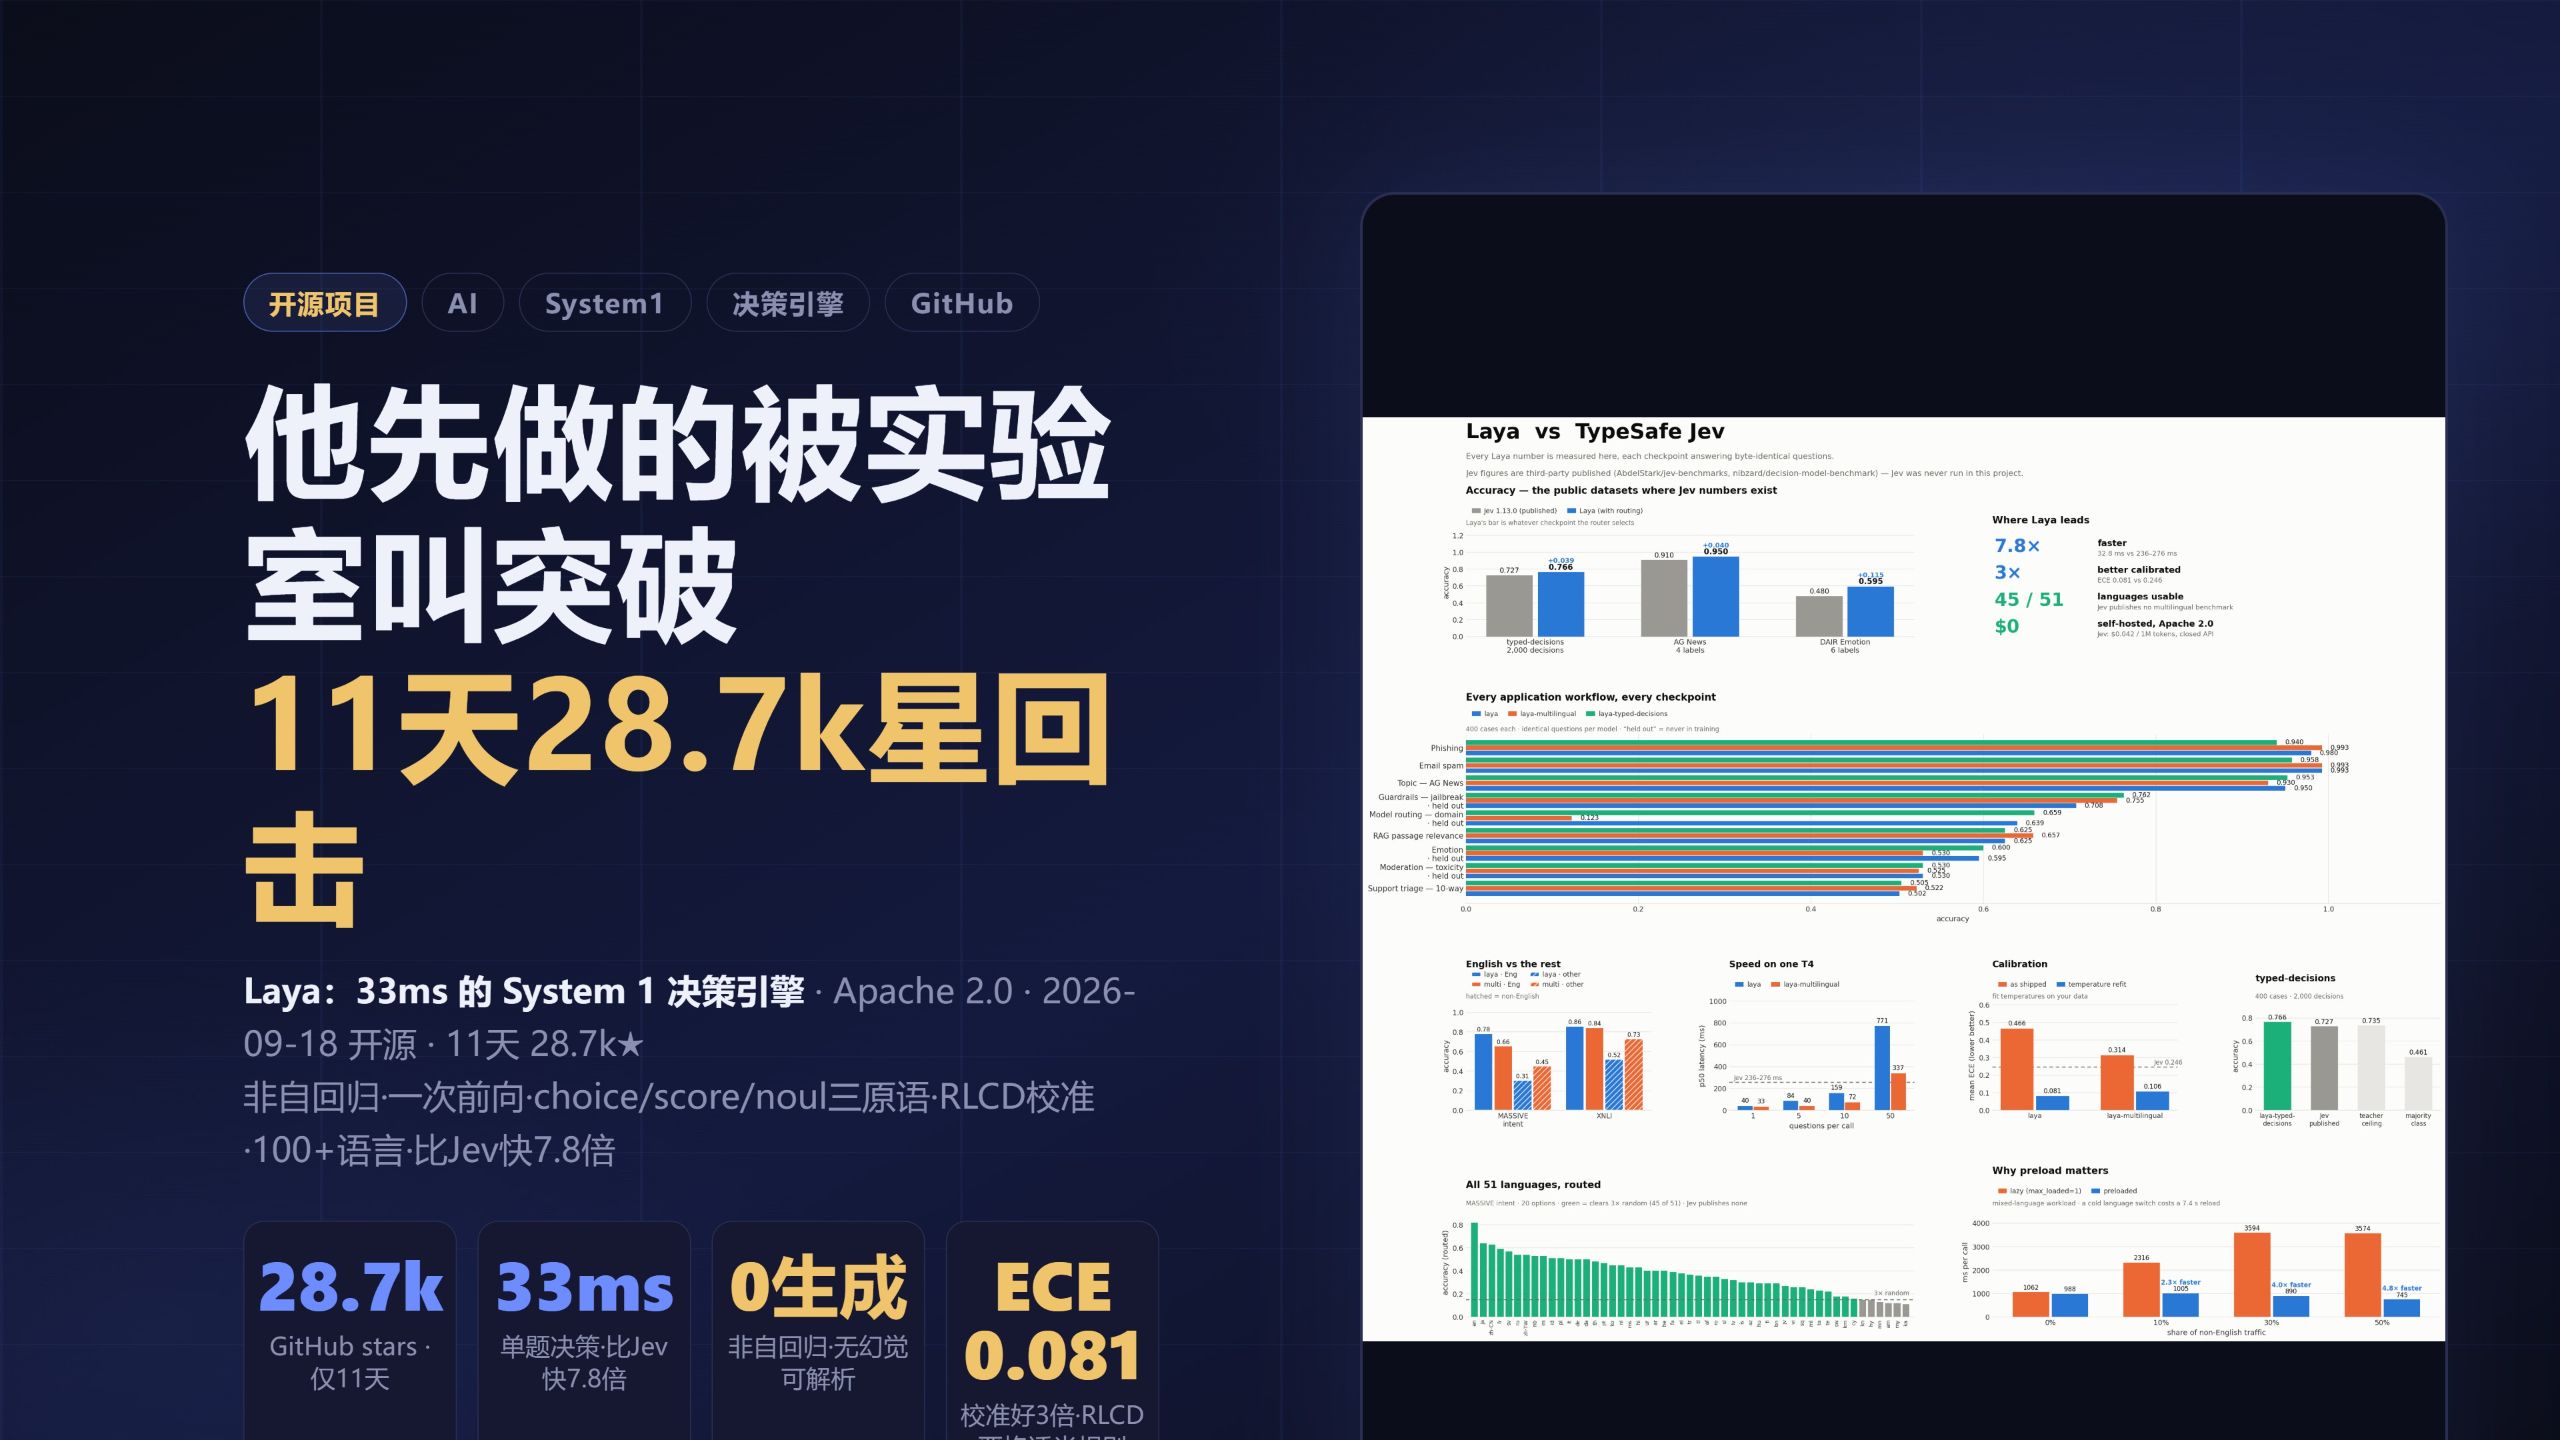
| 评估维度 | Laya(开源项目) | Jev(TypeSafe AI 商业闭源) | 胜负与说明 | |:--- |:--- |:--- |:--- | | **单题推理延迟** | **33 ms** | 236 ms - 276 ms(中位数) | **Laya 快 6-7.8 倍**(编码器极速前向传播) | | **概率校准度 (ECE)** | **0.081** (温度拟合后) | 0.246 | **Laya 校准度好 3 倍**;Jev 在 16% 的测试样本上把绝对“0概率”分配给了正确答案,会导致置信度路由直接崩溃 | | **许可与部署成本** | **Apache 2.0 协议**,零授权费私有化部署 | 闭源商业云 API,每百万 Token 收取 4.2 美分 | **Laya 胜出**,企业私有化部署数据安全性与成本极优 | | **微调准确率 (Type Decisions)** | **0.766 (76.6%)** | 0.727 (72.7%) | **Laya 胜出**,高出近 3.9 个百分点 | | **高基数分类 (Banking77)** | 0.425 (42.5%) | **0.870 (87.0%)** | **Jev 大幅领先**;面对 77 个标签的高基数场景,Laya 处于显著劣势 |
Laya 在 README 中直言不讳地承认了自身的致命软肋:在面对多达77个分类标签的极端高基数任务(如经典金融意图数据集 Banking77)时,Jev 凭借充裕的计算资源与长序列容量拿下了 0.870 的高分,而 Laya 骤跌到了 0.425。其根本根源在于 Laya 的设计机制:所有候选选项在输入层必须共享固定的 Token 预算窗口,一旦堆叠了77个选项,平摊下来每个选项只能分到3到4个 Token 的表征容量,文本语义被极度挤压截断,导致模型在密集类别之间根本无法建立有效的特征区分。
---
[05:14](https://www.bilibili.com/video/BV1uoad6sEit?t=314s) “诚实限制”:写满一百行的失败模式文档
这份项目的 README 中最令主讲人赞赏的内容,是那份长达百行的“诚实限制”(Honest Limitations)章节。主讲人感叹:“在一个连评测都要挑着发的行业里,把自家模型的失败模式写成100行文档,这个行为本身就是最强的可信度声明。”该章节毫无保留地列举了模型的核心缺陷,且每一条都附带了对应的 GitHub Issue 追踪链接与代码复现方法:
1. **基础检查点零样本性能极差**:Laya 的零样本(Zero-shot)准确率仅为 0.362,而纯随机乱猜的基线是 0.318,直接无脑猜测试集多数类标签的基线都能达到 0.461。这意味着“裸装裸用还不如无脑猜多数”。官方向开发者明确定性:Laya 绝不是通用的零样本开箱即用决策引擎,而是一个需要垂直微调的“超轻量基底”。 2. **对布尔值标签存在强烈的先验偏见**:在定义分类选项时,如果生硬使用诸如 `True` / `False` 这样的布尔词汇,模型极易产生盲从偏差,忽略输入文本的真实逻辑,直接机械化地跟着标签字面倾向走。 3. **否定句逻辑推理脆弱(否定不安全)**:官方给出了复现样例,测试人员输入了5条明确表示“不想/不要注销账号”的否定句文本,英文版模型全部误判为“用户想要注销账号”,甚至在其中一个测试用例上给出了高达 0.9998 的极度自信置信度。 4. **严重的选项位置偏差(Position Bias)**:测试表明,如果向模型提供5个字面文本完全一模一样的候选项,仅仅由于它们在输入序列中的排列顺序先后不同,最终输出的 Logits 数值竟能产生上下多达 3.6 的巨大断层偏差。为此,官方专门暴露了控制选项遍历顺序的参数,强制开发者必须在生产环境中轮循打乱顺序取平均值(Round-Robin)来对冲系统误差。 5. **多语言版本对首选打分项视而不见**:在多语言检查点下调用 `score`(序数打分)原语时,底层架构存在已知缺陷,无论输入何种语言,模型都基本无法识别并直接跳过序列中的第一个打分选项。
---
[06:39](https://www.bilibili.com/video/BV1uoad6sEit?t=399s) 行业判断与实操建议
基于 Laya 的破圈事件,主讲人给出了三点深入的行业趋势判断:
第一,**System 1 与 System 2 的解耦分工,正在成为企业落地 AI 架构的行业共识。** 当前业界热议的成本战、模型推理语义缓存优化以及基于图(Graph)的代码地图,底层都在解决同一个终极痛点:“贵的能力只留给需要它的地方。”诸如流量分发路由、合规内容审核、业务严重度分级以及风险防控,这类决策任务占据了工业级 AI 应用调用量的最大宗份额。主讲人指出:“决策类任务是AI应用力量最大的部分,路由、审核、分级、风控,把它们从生成式模型手里拿走,是整个降本链条里最粗的一环。”而 Laya 彻底击碎了神话,证明了这套能力不需要百卡大算力实验室,仅仅基于 ModernBERT 结合针对性的强化学习方案就能高效搞定。
第二,**开源对大厂资本叙事完成了一次教科书式的漂亮回击。** 面对成果被掠夺,开发者 Nandakishor 放弃了发推对骂或组织公关舆论战,而是选择把憋屈转化为生产力,用碾压对手的推理速度、更优的统计概率校准以及 Apache 2.0 协议的无保留开源,直接交由全球社区公开投票。11天内激增的近3万颗 Star 比任何声明都更有力量。这也为所有在细分垂直领域深耕的独立研究员开辟了一条明路:当你的灵感被资本和前沿大厂“重新发明”并抢夺定义权时,手里最致命的武器,就是赶在他们之前把更加开放、好用的那一版做到极致并交予社区。
第三,**必须理性泼冷水,不要盲从 GitHub Star 狂欢。** 官方文档已经反复告诫开发者:未经特定业务微调的裸模型性能几乎等同于随机乱掷骰子,上线前必须依赖微调;横向对比 Jev 的亮眼跑分源自不同统计口径的公开报告,并非完全同等条件下的受控实测;而其固有存在的位置偏差漏洞和否定句语义陷阱,决定了在真正接入生产系统前,企业必须严格在自己的私有业务数据集上建立闭环回归验证。“他给的工具够你做验证,但验证这步没人能替你省。”
在体验门槛上,Laya 的上手非常轻量,仅需 `pip install laya`,三行代码即可跑通本地决策;项目方配套提供了在线 Google Colab 实验脚本、Web 端交互 Demo 以及适配国内语境的中文职场决策评测基准。主讲人最后总结了整个架构重构的核心铁律:“带走一句话,大模型负责想,小模型负责断,把决策从生成里拆出来,是这轮降本战争里最划算的一笔拆分。”
## Notable quotes > [00:00](https://www.bilibili.com/video/BV1uoad6sEit?t=0s) 为一个三选一的判断调用一个生成式大模型,就像用卡车送外卖。 — 主讲人
> [06:39](https://www.bilibili.com/video/BV1uoad6sEit?t=399s) 大模型负责想,小模型负责断,把决策从生成里拆出来,是这轮降本战争里最划算的一笔拆分。 — 主讲人
> [05:14](https://www.bilibili.com/video/BV1uoad6sEit?t=314s) 在一个连评测都要挑着发的行业里,把自家模型的失败模式写成100行文档,这个行为本身就是最强的可信度声明。 — 主讲人
## Mentioned Laya, Jev, Nandakishor, TypeSafe AI, Diogo Almeida, Daniel Kahneman, ModernBERT, Banking77, LocalLLaMA, Reddit, GitHub, LangChain, LlamaIndex, Bespoke AI, ONNX
## Video description 一个独立开发者,一年前把自己的想法写成了论文、开了源,没人理。今年九月,一家前沿实验室发布了几乎同样的东西,宣传语是"突破"。他没去吵架,而是把自己的版本做到更快、更准、更开放,扔上 GitHub——十一天,两万八千七百颗星。这个项目叫 Laya。
Laya 是什么:非自回归的 System 1 决策引擎。卡尼曼框架里,大语言模型是典型的 System 2——生成文本、逐 token 输出、慢而贵;但现实里大量任务只需要决策:这封邮件该哪个部门处理?工单多紧急?这条留言是不是流失风险?为三选一的判断调用生成式大模型,像用卡车送外卖。Laya 用编码器一次前向传播直接出答案:三十三毫秒,不生成任何文本——没有输出要解析,没有幻觉可发生。三种类型化原语:choice 选择题、score 序数打分、noul 是非题返回校准概率。一份文档一次调用问任意多个问题,批量摊到每题七毫秒。三个检查点加 Router,一百多种语言自动切换。训练用 RLCD——强化学习直接对严格适当评分规则优化,概率是校准过的。
故事线:二零二五年三月,Nandakishor 发布论文加开源权重数据集,发在 Reddit——基本没水花。二零二六年九月,TypeSafe AI 发布 Jev——创始人之一是 ChatGPT 联合发明人 Diogo Almeida——非自回归决策模型,宣传口径全新突破,没有论文没有开源。作者写:既感到被验证,又深感挫败。处理方式:与其怨恨,不如做出更好的版本。
数字对比(Jev 为第三方已发表数字):快七点八倍;校准 ECE 好三倍——Jev 在百分之十六样本上给正确答案零概率;Apache 2.0 零成本自托管。但 Jev 赢的地方 README 也直说:Banking77 七十七个标签的高基数场景,Laya 零点四二五对零点八七零。
最值钱的是"诚实限制"一节:基础检查点零样本接近随机(零点三六二对随机零点三一八)——裸装裸用不如无脑猜多数,零点七六六全靠微调;布尔词标签会被跟着走;"取消账号"的否定句全部误判;位置偏差——相同文本的选项按位置 logits 差三点六。每条带 issue 链接和复现方法。把自家模型的失败模式写成一百行文档,这个行为本身就是最强的可信度声明。
我的判断:System 1 和 System 2 的分工正在成为架构共识——决策类任务量最大,从生成式模型手里拿走是降本链条最粗的一环,Laya 证明这事不需要大实验室;这是开源对资本叙事的教科书级回击——把挫败变成更快更好更开放,让社区投票;冷水:裸模型必须微调,对 Jev 的对比是不同口径公开数据,上生产前必须在自己数据上验证。
00:05 开场:回击的故事 00:42 System 2 生成,System 1 决策 01:51 架构:三检查点与 RLCD 02:46 故事:被"重新发明"的一年 04:05 数字对比:赢的说,输的也说 05:14 诚实限制:一百行失败模式文档 06:39 三点判断 08:16 收尾
安装:pip install laya · 源码:github.com/NandhaKishorM/laya(Apache 2.0)· 有中文社区基准
觉得有用的话点个关注,每天一个值得拆的开源项目。
[Source](https://www.bilibili.com/video/BV1uoad6sEit)