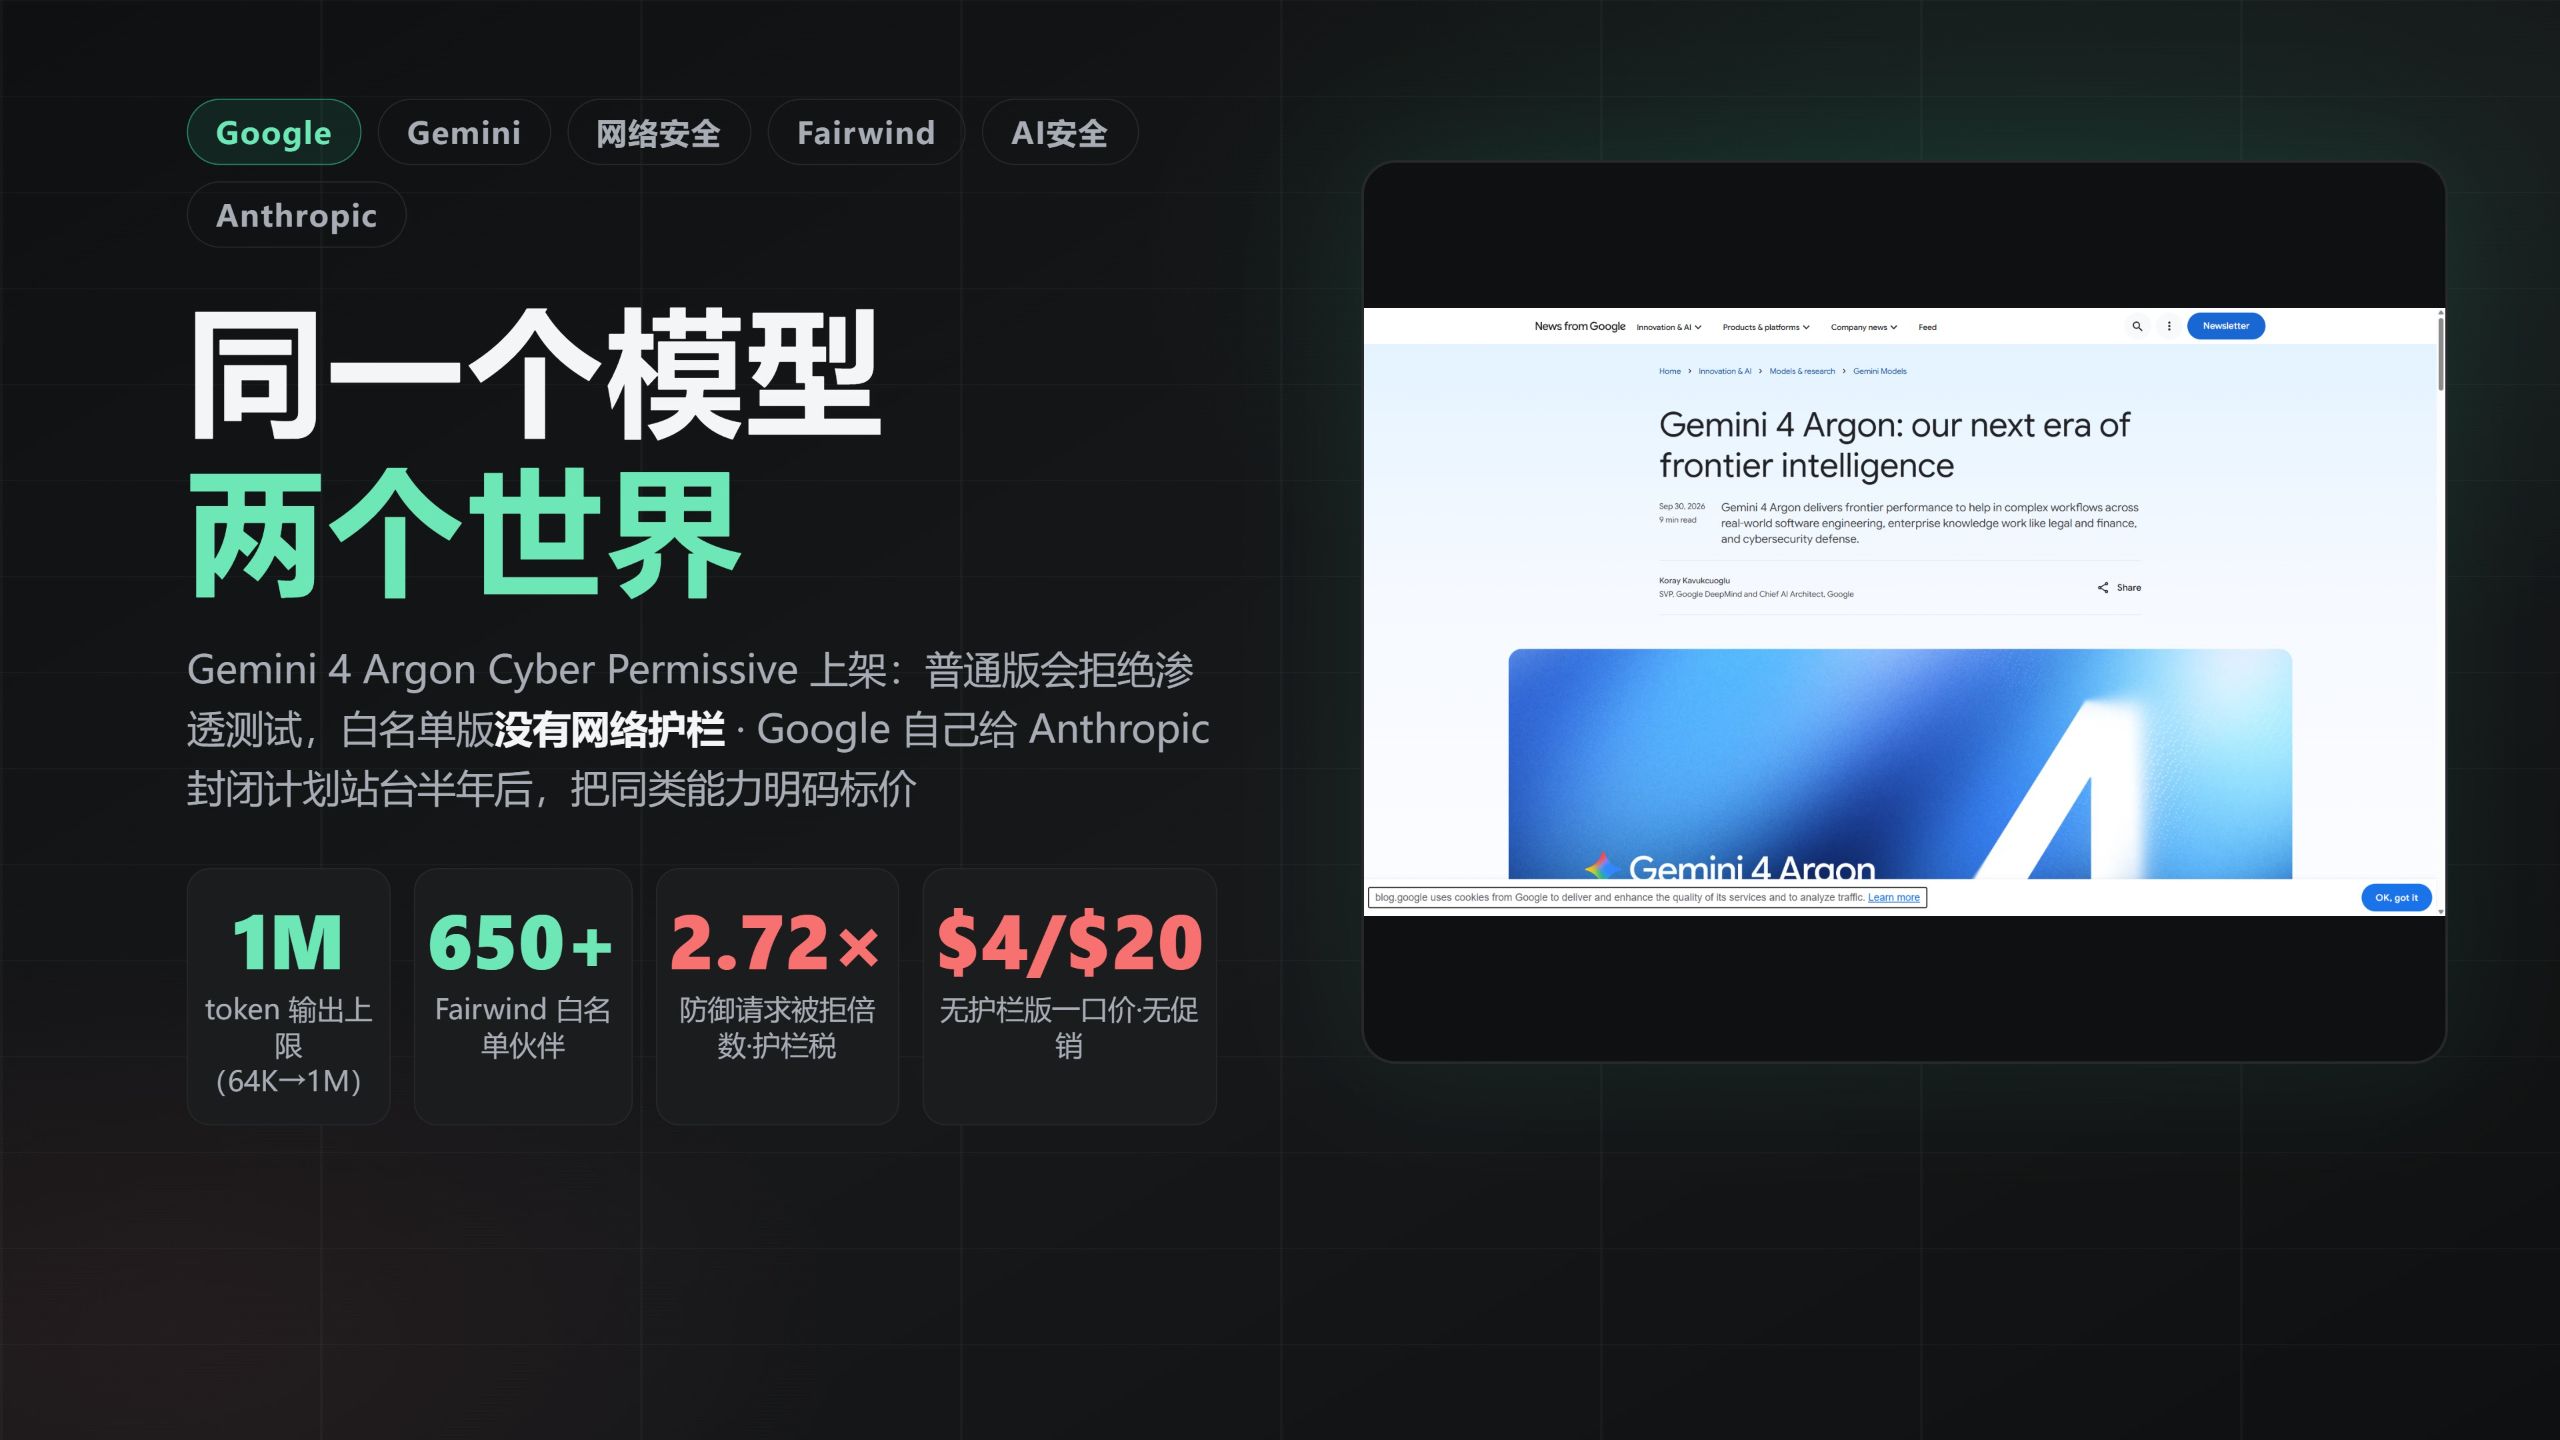
谷歌上架无护栏版Gemini 4大模型 仅对白名单机构明码标价开售
AI技术投降派
大模型安全护栏反而让合规防御者面临数倍的请求被拒率,促使科技巨头从普遍加装过滤规则转向通过准入审查高价售卖无护栏特权。
AI-assisted summary of 同一个AI模型 你买到的是会被拒绝的版本 — original source. Check the original for full context.
Source published:
Key ideas
- 谷歌在 Vertex AI 上架 Gemini 4 Argon Cyber Permissive(网络宽松版),对白名单内机构剥除安全护栏,并以每百万 Token 输入 4 美元、输出 20 美元的价格商用。 (0:00)
- 第三方数据显示安全领域存在“护栏税”悖论:带有防御性质的合规测试请求,被标准版大模型拦截拒绝的概率是中性请求的 2.72 倍。 (1:26)
- 开源大模型攻防能力仅落后顶级前沿模型 4 到 7 个月,攻击者可直接离线运行绕过厂商审核,导致安全机制往往只惩罚了合规防御者。 (2:03)
- Anthropic 将满分安全模型 Claude Mythos 扣留半年仅供 12 家伙伴使用,虽然协助发现上万漏洞,但安全瓶颈已迅速从“找漏洞”转向人力“修漏洞”。 (3:41)
Detailed notes
## Background 本内容由 Bilibili 频道“AI技术投降派”于 2026 年 10 月 15 日发布。视频简介指出,谷歌近期上架了移除安全护栏的 Gemini 4 Argon 网络宽松版,仅对通过 Fairwind 白名单审核的 650 多家机构开放,以此展开对 AI 安全“护栏税”、防御者困境以及谷歌与 Anthropic 在高危模型分发策略上戏剧性反差的深入探讨。
## TL;DR 视频聚焦于谷歌最新推出的无护栏商业模型 Gemini 4 Argon Cyber Permissive,揭示了同一模型针对普通用户与白名单机构的双轨分发机制。主讲人指出,传统护栏导致合规防御者的请求被拒率高达中性请求的 2.72 倍,而无拘无束的攻击者却能利用本地开源模型进行机器级攻防。通过横向对比 Anthropic 对满分模型 Claude Mythos 的严苛封控,内容揭露了谷歌在为对手站台仅半年后便将同类高危能力明码标价商用的商业讽刺,并引发关于由谁来定义 AI“可信”的行业反思。
## Atmosphere & style 主讲人的叙事冷静而犀利,充满理性的技术洞察与强烈的行业讽刺感。视频节奏紧凑且信息密度极高,借助详实的数据对比和实战案例,将大厂在安全合规掩护下的商业算盘剥离得淋漓尽致。观感上既带有一种目睹网络安全攻防进入“机器速度”时代的紧迫感,又留给观众对“护栏究竟在保护谁”这一现实荒诞的深层思索。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1CzJ66qE2G?t=0s) 谷歌在 Vertex AI 上架 Gemini 4 Argon Cyber Permissive(网络宽松版),对白名单内机构剥除安全护栏,并以每百万 Token 输入 4 美元、输出 20 美元的价格商用。 - [01:26](https://www.bilibili.com/video/BV1CzJ66qE2G?t=86s) 第三方数据显示安全领域存在“护栏税”悖论:带有防御性质的合规测试请求,被标准版大模型拦截拒绝的概率是中性请求的 2.72 倍。 - [02:03](https://www.bilibili.com/video/BV1CzJ66qE2G?t=123s) 开源大模型攻防能力仅落后顶级前沿模型 4 到 7 个月,攻击者可直接离线运行绕过厂商审核,导致安全机制往往只惩罚了合规防御者。 - [03:41](https://www.bilibili.com/video/BV1CzJ66qE2G?t=221s) Anthropic 将满分安全模型 Claude Mythos 扣留半年仅供 12 家伙伴使用,虽然协助发现上万漏洞,但安全瓶颈已迅速从“找漏洞”转向人力“修漏洞”。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1CzJ66qE2G?t=0s) 谷歌推出 Gemini 4 Argon 网络宽松版,同一套模型权重针对普通开发者与白名单用户实施双重标准,重新定义前沿 AI 分发模式。 - [00:36](https://www.bilibili.com/video/BV1CzJ66qE2G?t=36s) Gemini 4 Argon 将单次推理输出 Token 上限由上一代的 6.4 万激增 16 倍至 100 万,旨在支持在单一思考轨迹内端到端解决复杂难题。 - [00:36](https://www.bilibili.com/video/BV1CzJ66qE2G?t=36s) DeepMind 在模型卡中罕见公开自揭短处:虽然 DeepSWE 达到 77.9%,但在真实终端任务基准(57.4%)上大幅落后竞品近 10 个百分点。 - [01:26](https://www.bilibili.com/video/BV1CzJ66qE2G?t=86s) 云安全团队 Wiz 使用无护栏版模型在实战中精准挖出多家医院医疗软件的严重零日漏洞,证明了高危攻防能力在正向防御中的价值。 - [02:03](https://www.bilibili.com/video/BV1CzJ66qE2G?t=123s) 大模型“护栏税”阻碍合规防御,合规渗透测试请求被拒率达中性请求的 2.72 倍,防御者越透明越容易被模型机制拦截。 - [02:03](https://www.bilibili.com/video/BV1CzJ66qE2G?t=123s) 攻击者利用落后仅 4-7 个月的开源模型在本地无限制调用,使闭源厂商建立的模型安全护栏在现实攻防中面临失衡挑战。 - [02:49](https://www.bilibili.com/video/BV1CzJ66qE2G?t=169s) 谷歌推行 Fairwind 计划建立门禁系统,限定四类实体并要求背景调查和 MFA 权限管控,通过后方可购买昂贵的宽松版 API。 - [03:41](https://www.bilibili.com/video/BV1CzJ66qE2G?t=221s) Anthropic 的 Claude Mythos 在专家攻防测试中达 73% 并贯穿 30 步靶场,官方选择全面扣留模型并仅限 12 家顶级机构闭门协作。 - [03:41](https://www.bilibili.com/video/BV1CzJ66qE2G?t=221s) Project Glasswing 运行数据显示网络安全瓶颈转移:模型短时间内挖出万余高危漏洞,但人工团队最终仅完成 75 个漏洞的代码修复。 - [05:00](https://www.bilibili.com/video/BV1CzJ66qE2G?t=300s) 谷歌在 4 月作为分发方为 Anthropic 封闭计划站台,半年后却避开第三方独立预审,将自家的同类无护栏能力推向公有云商业变现。 - [05:42](https://www.bilibili.com/video/BV1CzJ66qE2G?t=342s) 国内外 AI 安全产业形成鲜明分歧:国内主流专注于“加护栏”合规,而硅谷前沿实验室正在转向“给审查通过者拆护栏”的白名单特许制。 - [05:42](https://www.bilibili.com/video/BV1CzJ66qE2G?t=342s) 随着漏洞挖掘全面进入机器速度时代,大模型能力的危险性使得“由谁来定义与审查可信”成为核心治理命题。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1CzJ66qE2G?t=0s) 一个模型两个世界:Gemini 4 Argon 与一百万 Token 的输出
10月13日,谷歌在自家货架上架了一款名字很长的新模型——Gemini 4 Argon Cyber Permissive(网络宽松版)。它的出现打破了以往 AI 发布的常规逻辑:同样的底层 Argon 权重,普通开发者调用时会被严格的安全策略约束,一旦发送渗透测试相关的请求就会直接被拒;而进入白名单的机构拿到的,却是一个完全剥除网络安全护栏的版本。“同一个模型,两个世界。”这道一边砌墙、一边给特定人群发钥匙的“安全门”,正在重新定义前沿 AI 的分发规则。
回顾模型本身,谷歌在9月30日推出 Gemini 4 Argon 时,官方给出的定位主要聚焦在三件事:真实世界的编码能力、企业级知识工作,以及网络防御。最能体现其架构野心的核心参数是上下文输出上限——从上一代模型的 64,000 个 token 直接飙升了 16 倍,一口气拉到 100 万 token。根据官方的说法,这样激进的输出窗口是为了“让模型在一条思考轨迹里把难题一次想完”。在评测表现上,DeepMind 的官方模型卡显示,Gemini 4 Argon 在长周期软件工程基准测试 DeepSWE 中斩获了 77.9%,自封为新一代第一。
耐人寻味的是,谷歌在模型卡中罕见地坦诚,甚至有些自揭短处:他们不仅展示赢下的指标,还把惨败的项目原原本本写在同一张对比表里。在终端任务(SWE-bench 等真实终端环境)测试中,该模型得分仅为 57.4%,落后竞争对手将近整整十个百分点。这种将战绩胜负并列公开的做法,在卷上天的大模型营销战中显得尤为突出。
- **核心参数飞跃**:单次推理输出 token 上限由 64,000 提升 16 倍至 1,000,000(1M token)。 - **基准测试表现**:长周期软件工程基准 DeepSWE 达 77.9%(宣称位列新一代第一);终端任务为 57.4%,落后竞品近 10 个百分点。
---
[01:26](https://www.bilibili.com/video/BV1CzJ66qE2G?t=86s) 医院漏洞实战与“护栏税”悖论:谁被挡在了门外?
在网络安全领域,Argon 的能力绝非停留在 PPT 上。谷歌此前收购的云安全公司 Wiz 曾带着该模型跑了一项“善意扫描计划”。结果,它在全球多家医院正在实际使用的医疗软件中,精准挖出了一个可能导致敏感个人医疗数据外泄的严重高危漏洞。针对这次战果,谷歌官方给出的原话非常犀利:“之前的前沿模型都漏掉了,它找到了,这就是没有护栏的能力用在正路上的样子。”
```mermaid flowchart TD accTitle: 护栏税与防御者困境 accDescr: 对比网络安全防御者与黑客在调用大模型时的截然不同处境
subgraph Defense ["防御者 (站在门内)"] D1["发出授权渗透/防御请求"] --> D2{"厂商安全护栏审查"} D2 -->|"含安全关键词 (被拒率高 2.72 倍)"| D3["请求被拒 / 业务受阻"] D2 -->|"需耗费成本证明资质"| D4["合规放行"] end
subgraph Attack ["攻击者 (站在门外)"] A1["利用本地开源模型"] --> A2["能力仅落后 4-7 个月"] A2 --> A3["无护栏限制 / 免排队审查"] A3 --> A4["肆意自动化挖掘与攻击"] end ```
然而,极具讽刺意味的现实在于——普通开发者能买到的标准版 Argon,是被重重护栏死死锁住的。根据 Google Cloud 的官方文档说明,标准版模型会自动拦截并阻止渗透测试和漏洞利用这类攻击性任务;即便安全人员是在帮企业做完全合规的授权测试,模型也会毫不客气地拒绝执行。这就引出了安全圈著名的“护栏税(guardrail tax)”难题。第三方研究(引自 Scale AI 相关统计)指出,带有安全关键词的防御性测试请求,被模型拒绝拦截的概率是中性请求的 2.72 倍。换言之,防御者越是老老实实声明“我是合规授权测试”,就越容易触发警报被模型踢出门外。
相比之下,黑客与恶意攻击者根本不需要说服任何人,也完全不用排队去过大厂的审核。目前的开源大模型在网络安全攻防能力上,仅仅落后顶级闭源前沿模型 4 到 7 个月;攻击者可以直接把开源模型拉到本地离线运行,没有任何护栏束缚。正如主讲人指出的残酷现实:“这就是护栏的悖论,它惩罚的往往是站在门里边的那个人。”
---
[02:49](https://www.bilibili.com/video/BV1CzJ66qE2G?t=169s) Fairwind 白名单与 Anthropic 的“玻璃翼”对照
为了化解防御者被自家护栏卡死的尴尬,谷歌给出的解决方案是修一扇带密码锁的门——启动“Fairwind 计划”。该计划于 9 月 2 日启动,目前已有 650 多家合作伙伴获得通行证。不过这道门的准入门槛极高,严格限定在四类实体之内: 1. 政府机构与国家级网络安全单位; 2. 关键基础设施运维方(涵盖医疗、电信、能源、金融系统); 3. 核心科技平台; 4. 从事纯防御性研究的学术实验室。
申请加入 Fairwind 的机构必须接受严格的背景调查,包括调取安全历史档案与道德运营记录;使用权限时,还被强制要求部署多因素认证(MFA)及细颗粒度的访问控制体系。10 月 13 日,网络宽松版正式上线 Vertex AI,官方中文文档注明只有进入白名单的用户才可调用。在价格上,谷歌完全没有把它当成普惠工具:每百万 token 输入 4 美元、输出 20 美元,不参与任何折扣促销,是一口价的硬通货。
| 维度 | 谷歌 Gemini 4 Argon Cyber Permissive | Anthropic Claude Mythos (Glasswing / CVP) | |:--- |:--- |:--- | | **测试战绩** | DeepSWE 77.9%,医疗软件中挖出前代模型均漏掉的高危漏洞 | Cyber-benchmark 100% 打满,UK AISI 专家攻防题达 73%,贯穿 30+ 步靶场 | | **放行模式** | Fairwind 许可清单审核放行,Vertex AI 商业上架 ($4 / $20 每百万 Token) | 成立 Project Glasswing,仅限 12 家创始伙伴闭门使用,半年后转三层放行 (CVP) | | **行业协作规模** | 650+ 家伙伴 (涵盖关键基础设施、政府与高校) | 创始 12 家 (含 AWS、苹果、微软、谷歌),4 个月内验证超 129,000 个漏洞 | | **防御成果与痛点** | 善意扫描医疗软件零日漏洞 | 火狐单个版本修复 271 个漏洞;发现 10,000+ 高危,但仅披露 530 个、修复 75 个 |
如果横向对比行业对手,Anthropic 的做法则更加决绝。今年 4 月,Anthropic 训练出了在网络安全能力上全面拉满的模型 Claude Mythos。在漏洞评测基准 Sidebench(Cyber-benchmark)上,Mythos 直接拿下了 100% 满分,逼得官方公开宣称“这个基准已经没有区分度了”。英国人工智能安全研究所(UK AISI)对其进行了独立验证:Mythos 在专家级攻防赛题中成功率达到 73%,并且创纪录地成为了史上首个端到端自动化打穿包含 30 多个复杂步骤企业渗透靶场的 AI 模型。
面对如此可怕的大杀器,Anthropic 做出了近七年来顶级实验室罕见的决定:全面扣留,不公开发布。他们转而发起了名为“Project Glasswing(玻璃翼计划)”的绝密项目,只把模型提供给全球 12 家创始合作伙伴,其中就包括 AWS、苹果、微软,甚至还有谷歌自己。
这套机制运转半年后,交出的账本令人震惊:12 家伙伴利用 Mythos 挖出并上报了一万多个高危漏洞,火狐浏览器仅在某单一版本更新中就因此修补了 271 个漏洞。但与此同时,安全的瓶颈发生了转移——在爆出的海量隐患中,官方最终只来得及正式披露 530 个漏洞,真正完成代码修复的仅有 75 个。“瓶颈已经从找漏洞变成了修漏洞。”到了 10 月 6 日,Anthropic 才进一步完善制度,推出分为三层放行的“网络安全验证计划(CVP)”,据其官方口径,该体系在 4 个月内已辅助验证了超过 129,000 个潜在漏洞。
---
[05:00](https://www.bilibili.com/video/BV1CzJ66qE2G?t=300s) 站台半年后自家开卖:加护栏还是拆护栏?
在这场 AI 安全的竞速背后,浮现出了一幕极富戏剧性与讽刺意味的商业折叠。时间拨回 4 月 7 日,在 Anthropic 的发布会上,谷歌安全工程副总裁 Heather Adkins 亲自到场站台并公开表示:“很高兴通过 Vertex AI 给参与者提供 Mythos。”然而,据 Politico 在 10 月 2 日的爆料,谷歌在最初发布相关高危能力模型时,根本没有主动提交给英国安全研究所(UK AISI)做预部署独立测试,而是早早就把无护栏的模型特权交给了自家收购的 Wiz 使用。到了 10 月 13 日,谷歌更是直接在云上以每百万 token 最高 20 美元的价格,把无护栏的 Cyber Permissive 版推向商用。
一边给老对手 Anthropic 的封闭克制计划当分发伙伴,一边把同类极具破坏潜力的能力做成了自家明码标价的云端商品——“安全叙事和商业节奏在同一个秋天撞在了一起”。
主讲人强调,国内外的网络安全产业在此刻呈现出了两种截然相反的演进路线:国内安全产业过去几年的绝对主旋律是“加护栏”,各种针对大模型的合规过滤、安全护栏产品一批批排队通过测评;而硅谷前沿实验室探索的方向,却是怎样建立严密的白名单审查体系,然后“给审查通过的人拆护栏”。如今,攻防对抗的演进早已从人类的操作速度全面转向了机器速度,国产模型在漏洞挖掘基准上的表现也开始被海外媒体频繁拿来与 Mythos 对标。视频的最后,主讲人抛出了一个引人深思的核心议题:
> “当一个模型危险到需要白名单,‘可信’两个字由谁来定义?”
## Notable quotes > [01:26](https://www.bilibili.com/video/BV1CzJ66qE2G?t=86s) 这就是护栏的悖论,它惩罚的往往是站在门里边的那个人。 — AI技术投降派
> [02:49](https://www.bilibili.com/video/BV1CzJ66qE2G?t=169s) 瓶颈已经从找漏洞变成了修漏洞。 — AI技术投降派
## Mentioned 谷歌, Gemini 4 Argon, Gemini 4 Argon Cyber Permissive, Fairwind, Wiz, Anthropic, Claude Mythos, Project Glasswing, DeepMind, Google Cloud, Vertex AI, Scale AI, UK AISI, Politico, Heather Adkins, AWS, 苹果, 微软, 火狐
## Video description 十月十三日,谷歌把 Gemini 4 Argon 的"网络宽松版"上了架。同一套权重:普通开发者拿到的版本,会拒绝渗透测试请求;Fairwind 白名单里的人(四类资格,现有 650 多家伙伴)拿到的,是没有网络安全护栏的版本。一边给你装门,一边给审查过的人发钥匙。这期把这个门怎么修起来的讲清楚:1M token 输出上限和官方自报的败局、Wiz 拿它在医院软件里挖出前沿模型都漏掉的漏洞、"护栏税"为什么惩罚的是防御者(防御请求被拒率是中性请求的 2.72 倍,攻击者用开源模型根本不排队)、还有对照线:Anthropic 今年四月把漏洞基准打满 100% 的 Mythos 扣着不发,只给十二家伙伴用,半年后收敛成三层放行。最有戏剧性的是,谷歌自己就在那十二家里,四月份还在给 Anthropic 的封闭计划站台,十月份就把同类能力明码标价(每百万 token 输入四美元输出二十美元,不参加促销)。当 AI 危险到需要白名单,"可信"两个字由谁来定义?评论区聊聊你的答案。
00:05 同一个模型,两个世界 00:36 模型本身:一百万 token 输出与官方自报的败局 01:26 实战证据:Wiz 医院漏洞与标准版的拒绝 02:03 护栏的悖论:拦住的往往是防御者 02:49 白名单:Fairwind 通行证怎么审 03:41 对照:Anthropic 扣着 Mythos 不放 05:00 讽刺时刻:站台半年后自家开卖 05:42 两种答案:加护栏与拆护栏
事实口径:官方发布博客、DeepMind 模型卡(含"无法排除达到网络安全关键能力水平"原文)、Google Cloud 中文文档、Fairwind 官方页、Anthropic Glasswing 首月报告与 CVP 公告、英国 AISI 独立评测、Politico 报道;"护栏税"2.72 倍来自 winfunc 引用的 Scale AI 统计(第三方研究,片中已标注)。关注我,每周追一期 AI 圈值得讲的事。
[Source](https://www.bilibili.com/video/BV1CzJ66qE2G)