长文档RAG漏答诱发重构 工程师弃用机械分块转投Agent闭环
AI大模型-阿水
长文档问答失真并非模型推理不足,而是机械切分与向量检索无法拼合分散证据,须转向父子块、混合重排及智能体自审闭环才能解决。
AI-assisted summary of 为什么你的 RAG 在长文档上总是答不全? — original source. Check the original for full context.
Source published:
Key ideas
- 长文档 RAG 答不全的根源在于需求错位:用户期望的是通读归纳与全貌梳理,而传统架构仅执行局部的相似切片召回,单靠盲目增大 Top-K 还会导致噪声激增和推理成本上升。 (0:00)
- 由于稠密向量压缩会抹平细粒度要素,语义相似度高并不等于证据齐全,抽象问题与散落的具体证据之间存在严重的语义不对称。 (2:00)
- 解决漏答需实施底层工程重构,结合文档层级结构分块、父子块自动合并检索、混合检索(稠密向量+BM25+ColBERT/Rerank)以及多子问题拆解查询。 (2:00)
- 跨章节宏观场景可引入 GraphRAG 辅助定位,但关键数据仍须回归原文校对;同时引入 Agentic RAG 建立自查缺口与定向补查机制,并结合长上下文与 Context Caching 实现高效协同。 (5:00)
Detailed notes
## Background 该内容由创作者“AI大模型-阿水”于 2026 年 10 月 15 日发布在哔哩哔哩(Bilibili)平台。视频简介主要提供了视频 Agent 学习资料、大模型学习路线、实战案例集以及电子书问答资源的获取链接。
## TL;DR 视频深入剖析了长文档 RAG 场景下回答总是出现遗漏的底层原因,指出核心矛盾在于用户需要的全局总结与传统系统依赖的局部语义检索之间存在错位。机械切分会导致事实与限定条款物理割裂,而语义相似度打分无法完全覆盖分散证据与抽象提问,还会遭遇长上下文“迷失在中间”的问题。为此,系统梳理了基于文档结构的智能分块、父子块检索、混合检索重排与查询拆解等工程重构方法,并介绍了引入 GraphRAG 与 Agentic 迭代核对机制来建立完整的查缺补漏闭环。
## Atmosphere & style 整体基调严谨务实且极具工程实战感,展现出深耕大模型落地一线的技术推演风格。讲解语言条理清晰、直指痛点,通过大量生动的业务场景反例破除盲目增大 Top-K 等调优误区,带给观众一种由浅入深、层层解构技术黑盒的沉浸式排查体验。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1JepC6EESn?t=0s) 长文档 RAG 答不全的根源在于需求错位:用户期望的是通读归纳与全貌梳理,而传统架构仅执行局部的相似切片召回,单靠盲目增大 Top-K 还会导致噪声激增和推理成本上升。 - [02:00](https://www.bilibili.com/video/BV1JepC6EESn?t=120s) 由于稠密向量压缩会抹平细粒度要素,语义相似度高并不等于证据齐全,抽象问题与散落的具体证据之间存在严重的语义不对称。 - [02:00](https://www.bilibili.com/video/BV1JepC6EESn?t=120s) 解决漏答需实施底层工程重构,结合文档层级结构分块、父子块自动合并检索、混合检索(稠密向量+BM25+ColBERT/Rerank)以及多子问题拆解查询。 - [05:00](https://www.bilibili.com/video/BV1JepC6EESn?t=300s) 跨章节宏观场景可引入 GraphRAG 辅助定位,但关键数据仍须回归原文校对;同时引入 Agentic RAG 建立自查缺口与定向补查机制,并结合长上下文与 Context Caching 实现高效协同。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1JepC6EESn?t=0s) 传统 RAG 与长文档问答存在根本需求错位:用户需要完整归纳与逻辑梳理,系统却只做了局部语义片段的抓取并作答。 - [00:00](https://www.bilibili.com/video/BV1JepC6EESn?t=0s) 机械的固定字数分块容易割裂事实与其限定条件,导致模型丢失关键的例外或顺延条款。 - [00:00](https://www.bilibili.com/video/BV1JepC6EESn?t=0s) 长文档证据往往分散在不同章节,受限于默认的 Top-K 截断,排在后面的关键事实根本无法进入模型上下文。 - [00:00](https://www.bilibili.com/video/BV1JepC6EESn?t=0s) 盲目增大 Top-K 无法解决答不全问题,反而会引入大量无关噪声并大幅推高上下文推理成本。 - [02:00](https://www.bilibili.com/video/BV1JepC6EESn?t=120s) 语义相似不等于证据齐全,稠密向量高度压缩文本后往往会遗漏年份、数据等细粒度关键要素。 - [02:00](https://www.bilibili.com/video/BV1JepC6EESn?t=120s) 高度抽象的用户问题与分散在各部门章节的具体证据之间存在语义不对称,直接检索容易错失关键细节。 - [02:00](https://www.bilibili.com/video/BV1JepC6EESn?t=120s) 即使证据全部喂入模型,长文本下的“迷失在中间”(Lost in the Middle)现象和跨段多跳推理不足仍会导致信息被忽略。 - [02:00](https://www.bilibili.com/video/BV1JepC6EESn?t=120s) 切分策略应基于文档结构组织逻辑单元,并采用“小块定位、大块阅读”的父子块检索架构。 - [02:00](https://www.bilibili.com/video/BV1JepC6EESn?t=120s) 结合稠密向量、BM25 关键词与 ColBERT 等晚期交互模型进行混合检索及重排,能大幅提升召回稳定性。 - [02:00](https://www.bilibili.com/video/BV1JepC6EESn?t=120s) 复合型问题需通过查询拆解为多维度子问题分别检索,再合并证据以捞出底层碎片化信息。 - [05:00](https://www.bilibili.com/video/BV1JepC6EESn?t=300s) GraphRAG 适于通过实体关系和社区摘要穿透大范围内容,但必须回归原文校对以防预生成摘要失真。 - [05:00](https://www.bilibili.com/video/BV1JepC6EESn?t=300s) Agentic RAG 将静态流水线改造为动态闭环,通过首轮阅读分析证据缺口并自主发起定向补充召回。 - [05:00](https://www.bilibili.com/video/BV1JepC6EESn?t=300s) 在生成答案前按用户问题逐项核对证据是否存在冲突或空白,是规避多轮检索原地打转的关键。 - [05:00](https://www.bilibili.com/video/BV1JepC6EESn?t=300s) 上下文缓存(Context Caching)仅是针对长文本的降本提速手段,并不能自动解决模型的注意力遗漏缺陷。 - [05:00](https://www.bilibili.com/video/BV1JepC6EESn?t=300s) 排查 RAG 漏答需按切分层(是否拆坏)、检索层(是否找齐)、综合层(是否吃透)三关卡进行系统化诊断与修复。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1JepC6EESn?t=0s) 长文档 RAG 答不全的核心矛盾与切分陷阱
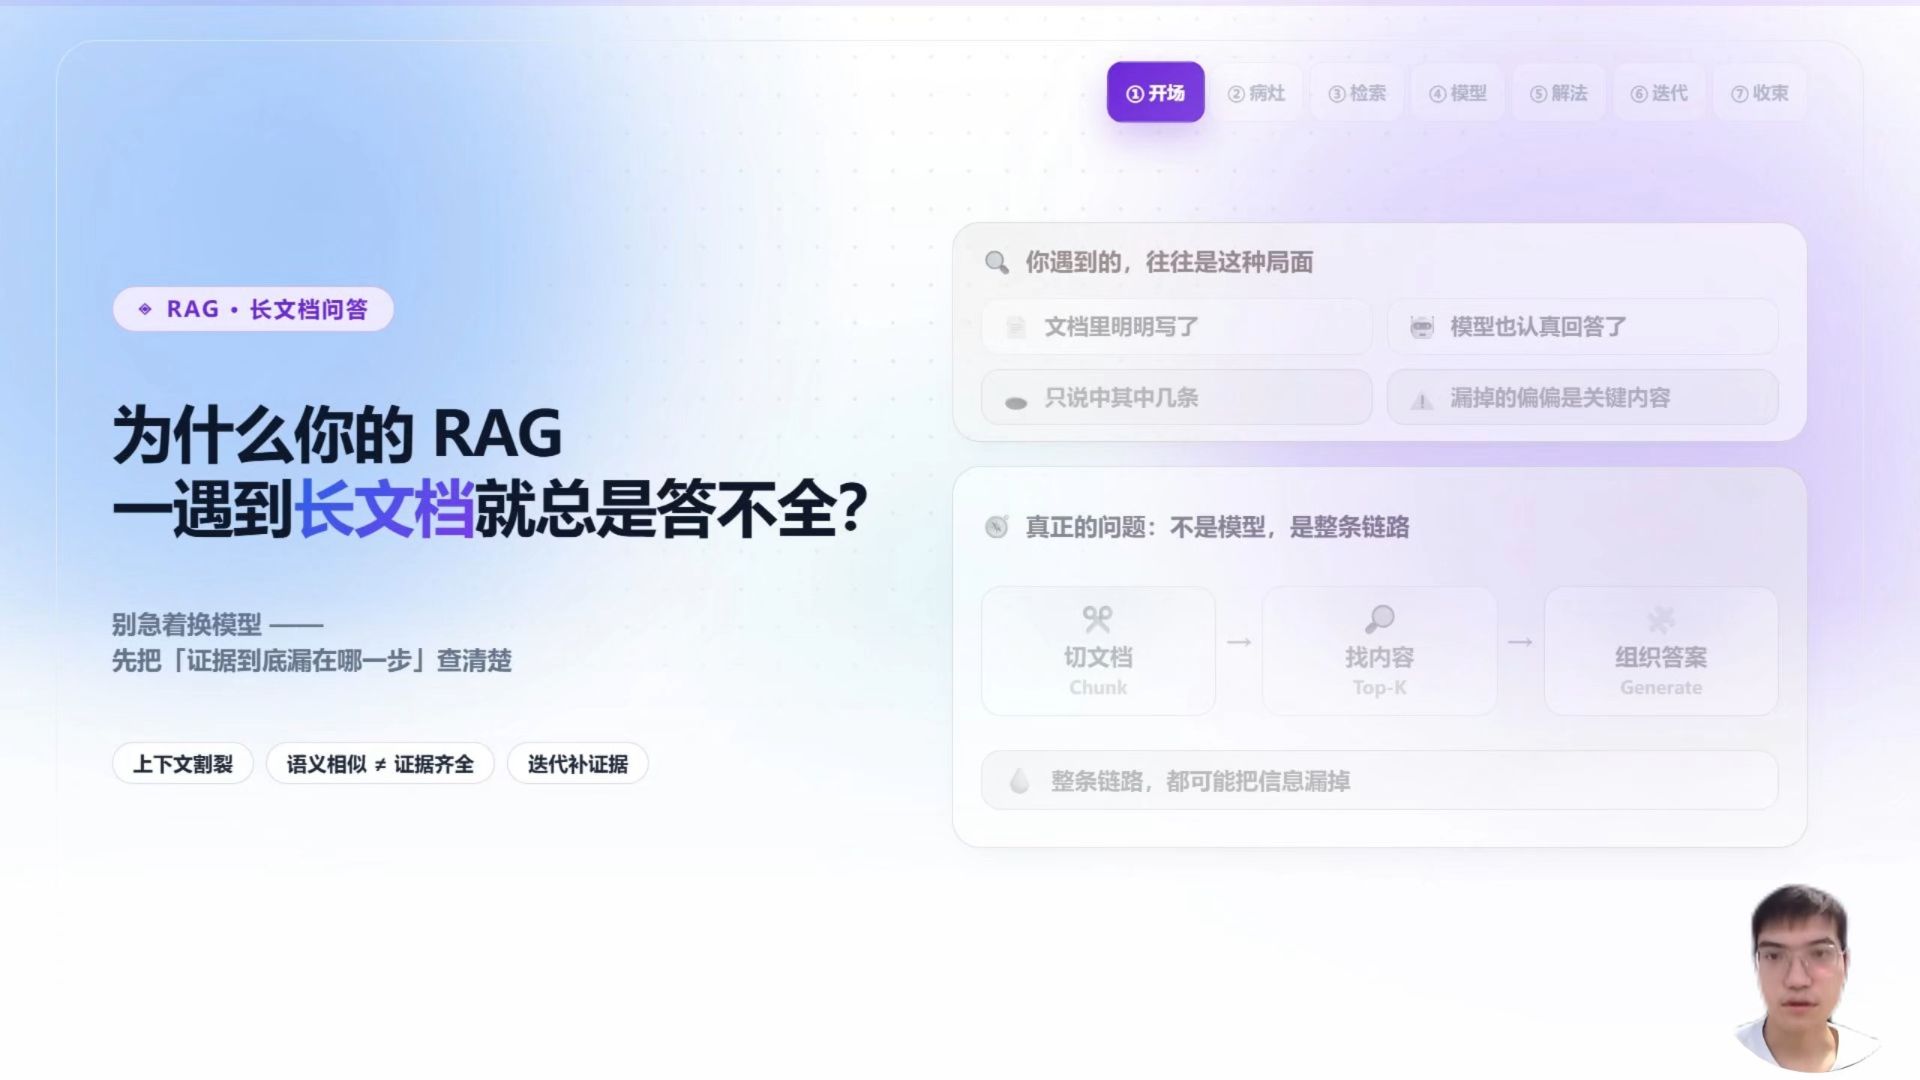
在长文档问答场景下,许多人常遇到一种困扰:明明相关内容在原文里写得清清楚楚,模型回答得也很流畅认真,但核对后却发现它只答中了其中几条,漏掉的还偏偏是核心事实。出现这种情况,“很多时候不是模型不够聪明,而是从切文档、找内容到组织答案,整条链路都可能丢信息”。
要解决这个问题,首先需要厘清核心矛盾所在。用户面对长文档提问时,本质上想要的是一份完整的归纳和综合梳理——比如包含哪些要点、各点之间的逻辑关系如何、是否存在特殊例外。但传统 RAG(检索增强生成)的处理逻辑完全不同,它做的是先根据用户的提问检索出几段语义相似的文本块,然后再将这些片段扔给大模型作答。这就导致了需求与实现之间的错位:“用户要的是通读和总结,系统做的却更像找到几处相关内容读完作答”。
这种局限从第一步的文本切分(Chunking)就埋下了隐患。由于长文档无法整篇直接塞入检索库,通常必须切分成一个个文本块(Chunk),并在提问时检索出相关度最高的 Top-K 个块。这种机制在回答单点的事实性问题时非常有效(例如查询合同的生效日期),但一旦面对综合性、跨段落的提问(例如询问合同对双方分别有哪些义务),就会暴露出两大根本缺陷:
1. **答案本身被切断(上下文割裂)**:如果采用固定字数机械切分,一个完整事实与其限定条件极易被拆散到不同的块中。例如原文前一句写“供应商应在30天内交付”,后一句紧接着补充“但遇到审批延迟可以顺延”。如果两句话被切开,检索模块可能只命中了前半句,模型无论推理能力再强,也会丢失关键的顺延例外条款。 2. **证据分布过于分散**:长文档中的同一个核心主题,往往分布在不同章节中,比如开头谈目标、中间写具体执行、结尾提潜在风险与策略调整。若系统默认只检索相关度最高的 3 到 5 个块,排在后面的关键事实根本无法进入模型的上下文窗口。这并不是模型归纳能力不足,而是它压根没有看到这些信息。
如果盲目通过调大 Top-K 来解决,并不能真正搞定问题。虽然召回的块变多了,但无关的噪声也会同步激增,同时挤占模型的上下文窗口并推高推理成本。因此,长文档答不全绝不是单靠一句“多召回一点”就能解决的。
```mermaid flowchart TD accTitle: 传统 RAG 在长文档切分与检索中的信息丢失路径 accDescr: 展示长文档经固定切分后导致事实割裂与分散证据被过滤的过程
subgraph Chunking["文本切分阶段"] Doc["长文档原文"] --> Split["机械固定字数切块"] Split --> C1["Chunk A: 主干事实 (交付期限)"] Split --> C2["Chunk B: 例外条件 (审批延期)"] Split --> C3["Chunk C: 结尾调整与风险"] end
subgraph Retrieval["检索匹配阶段"] Query["用户综合问题"] --> TopK["相似度计算 (取 Top-K)"] C1 --> TopK C2 -.->|"相似度较低 (被截断遗漏)"| Missed["未进入模型上下文"] C3 -.->|"排在靠后 (被截断遗漏)"| Missed end
subgraph Generation["生成阶段"] TopK --> LLM["大语言模型"] LLM --> Answer["片面/残缺的答复"] end ```
---
[02:00](https://www.bilibili.com/video/BV1JepC6EESn?t=120s) 语义不对称、中间迷失与工程切分重构
除了文本切分带来的物理割裂,系统的相似度判定机制也是导致漏答的重灾区。常见做法是将问题和文本块都转化为稠密向量(Embedding),再基于余弦相似度等算法去搜寻最近邻。向量本身是对原始文本的高度压缩表示,一段几百字的文本块里往往交织着时间、人物、具体执行条件、例外规则和关键数据;在一个统一的低维向量空间中,不可能让所有的细粒度要素都同样突出。
这就导致了两个核心难点: - **语义相似不等于证据齐全**:当用户提问非常具体(例如“哪一年提出了调整,调整前后分别是什么”)时,语义上极为相似的段落可能恰恰缺少准确的年份,而真正写有关键年份的段落其相似度打分却未必能挤进前列。“别把语义相似直接等同于回答问题的证据齐全,这是检索里很容易混淆的两件事”。 - **问题与文档的语义不对称(Asymmetry)**:用户的提问往往高度概括,例如“这家公司三年的战略是什么?”,而原文中的战略细节从不整齐地堆叠在“三年战略”这个小标题下,而是散落在各部门的年度目标、具体产品路线以及高管讲话记录中。用一句高度抽象的问题做单次相似度检索,系统大概率只能找到包含“战略”字眼的表面段落,而错失具体落地的实际证据。
即便突破重重阻碍将相关文本块全部送入大模型,模型也不一定能答全。输入长度急剧膨胀后,模型对不同位置的信息感知并不均衡,学术界常讨论的“迷失在中间”(Lost in the Middle)现象表明,夹在长上下文中间地带的关键事实极易被模型直接忽视。此外,长文档理解往往涉及跨段落的“多跳推理”(Multi-hop Reasoning)——需要先定位基础规则,再找出后续的补充修订,最后判定当前执行的最终版本。传统的“单次检索 + 单次生成”架构缺乏多轮追问和查漏补缺的验证机制,最终导致单段看都正确、整体拼凑却漏洞百出。
针对这些问题,工程落地上需要从底层切分和检索策略进行彻底重构: - **基于文档结构的智能分块**:摒弃机械的固定字符切分,结合标题、章节层级、正文段落、表格结构以及 PDF 版式语义来组织切块边界,优先确保一个事实及其限定前提处于同一个逻辑单元内。 - **父子块检索(自动合并检索)**:在索引和切分时采用层级设计,“检索时用较小的子块,提高定位精度;找到以后,给模型提供它所属的较大父块,甚至相关章节”,实现“小块负责找得准,大块负责读得全”,同时注意父块不可无限蔓延以控制无关噪声。 - **混合检索与重排(Hybrid Search & Rerank)**:不要将筹码全部压在稠密向量上。稠密向量擅长捕获泛化语义;BM25 算法擅长精准命中专有名词、产品编号和行业术语;ColBERT 等晚期交互(Late Interaction)模型则能进行更细腻的细粒度匹配。将三者结合并引入重排(Reranker),能显著提升召回的可靠度。 - **查询扩展与拆解(Query Expansion / Decomposition)**:面对“三年战略是什么”这类复合问题,不能直接用原句检索,而应将其拆解为“第一年的目标是什么”、“第二年有哪些业务变化”、“第三年的战略重点是什么”,分别发起检索后再合并证据,把原本沉在底部的碎片化内容捞出来。
---
[05:00](https://www.bilibili.com/video/BV1JepC6EESn?t=300s) 知识图谱、Agentic 迭代核对与长上下文协同
对于需要跨章节、跨多文档进行全局归纳的高难度场景,进阶架构可以引入 GraphRAG(基于知识图谱的检索增强生成)。其典型做法是在入库阶段提取文档中的实体与关系,将其组织成图谱网络,并根据实体社群预先生成层次化的社区摘要(Community Summaries)。当遇到宏观概括型问题时,系统不再局限于匹配局部的零散文本块,而是顺着图谱中的实体关系与社区摘要快速穿透大范围的内容。
但是,知识图谱绝非万灵药:如果前期实体抽取有误、关系挂载错误,或者预生成的摘要本身遗漏了关键限制条件,最终生成的答案同样会发生漂移或失真。“更稳的用法是让图谱帮助定位和组织信息,最后仍然回到原文核对关键事实,尤其是数字、时间和例外条款,不要只凭一段预生成摘要就下结论”。
进一步的演进形态是引入 Agentic RAG(智能体化 RAG),将检索从单一的静态流水线改造为动态的闭环迭代过程: 1. **首轮检索与缺口分析**:模型先进行第一轮检索并阅读材料,根据回答目标自查还缺少哪些证据链条(例如发现缺了某一年的财报数据,或某处政策例外存在冲突)。 2. **定向追问与补充召回**:根据当前的信息真空,由模型自主生成下一轮针对性极强的检索 Query,实现定向查缺补漏,而不是漫无目的地盲目堆砌检索轮次。 3. **逐项核对与证据自审**:“这里真正重要的是怎么判断已经找全了,可以先从用户问题里列出待回答项,再逐项检查有没有对应证据,证据有没有冲突,哪些只能推测不能确定”。在正式生成答案前明确缺口,才能从根本上规避多轮检索只是在原地打转的尴尬。
针对长上下文(Long-Context)模型的崛起,直接将长文档整篇灌入模型虽然看似省事,但也伴随着巨大的输入 Token 成本、显著的响应延迟以及无法根除的中间注意力遗漏风险。较为实际的落地策略是“长上下文与检索配合”:对于单篇长度可控、需要高频提问的核心文档,可配合使用上下文缓存(Context Caching)技术,锁住重复的前缀文档,从而大幅降低计算成本与延迟;而对于海量、低频或高频动态更新的内容,依然以检索为主干。需要明确的是,上下文缓存纯粹是推理性能与费用层面的优化手段,并不能自动补足模型在阅读长文本时自身发生的信息遗漏。
```mermaid flowchart TD accTitle: 长文档 RAG 答不全的排查与优化闭环 accDescr: 展现从切分排查、检索排查到上下文综合排查的三层闭环链路
subgraph Checkpoint1["1. 切分层排查:证据是否被拆坏?"] P1{"事实与限定<br/>是否割裂?"} P1 -->|"是"| S1["结构化分块 + 父子块检索 (Auto-merging)"] end
subgraph Checkpoint2["2. 检索层排查:分散证据是否找齐?"] P2{"是否存在语义不对称<br/>或细粒度缺失?"} P2 -->|"是"| S2["混合检索 + 查询拆解 + GraphRAG 拓扑定位"] end
subgraph Checkpoint3["3. 综合层排查:证据进入上下文后能否吃透?"] P3{"长文本注意力衰减<br/>或跨段推理不足?"} P3 -->|"是"| S3["Agentic 迭代检索 + 待回答项核对 + 长上下文缓存协同"] end
Checkpoint1 --> Checkpoint2 Checkpoint2 --> Checkpoint3 ```
归结起来,长文档 RAG 答不全的问题,本质上必须顺着整条链路依次排查三个核心关卡: - **切分层**:核心证据有没有在分块时被粗暴拆坏? - **检索层**:分散在各章节的关联证据有没有被完整找齐? - **综合层**:证据进入模型上下文之后,模型有没有真正吸收并做出正确的逻辑综合?
“所以答不全不是一个单独的模型问题,也不是把 Top-K 调大就能处理好的问题,真正要做的是让系统从‘找到几段像答案的话’,升级成‘识别问题需要哪些信息,把证据找齐全再逐项回答’”。只有把故障点精准锁定在具体环节上,后续的工程优化才不再是碰运气调参,而是有的放矢地完成整条技术链路的系统性修复。
## Notable quotes > [02:00](https://www.bilibili.com/video/BV1JepC6EESn?t=120s) 别把语义相似直接等同于回答问题的证据齐全,这是检索里很容易混淆的两件事
> [00:00](https://www.bilibili.com/video/BV1JepC6EESn?t=0s) 用户要的是通读和总结,系统做的却更像找到几处相关内容读完作答
> [00:00](https://www.bilibili.com/video/BV1JepC6EESn?t=0s) 很多时候不是模型不够聪明,而是从切文档、找内容到组织答案,整条链路都可能丢信息
> [02:00](https://www.bilibili.com/video/BV1JepC6EESn?t=120s) 检索时用较小的子块,提高定位精度;找到以后,给模型提供它所属的较大父块,甚至相关章节
> [05:00](https://www.bilibili.com/video/BV1JepC6EESn?t=300s) 更稳的用法是让图谱帮助定位和组织信息,最后仍然回到原文核对关键事实,尤其是数字、时间和例外条款,不要只凭一段预生成摘要就下结论
## Mentioned RAG, Top-K, BM25, ColBERT, GraphRAG, Agentic RAG, Context Caching
## Video description 视频Agent学习籽料、大模型学习路线、、实战案例集、电子书+问题解答👉https://www.bilibili.com/read/cv52978347/?spm_id_from=333.1387.0.0&jump_opus=1自取哦
[Source](https://www.bilibili.com/video/BV1JepC6EESn)