全球五大 AI 模型挑战物理机测全线翻车
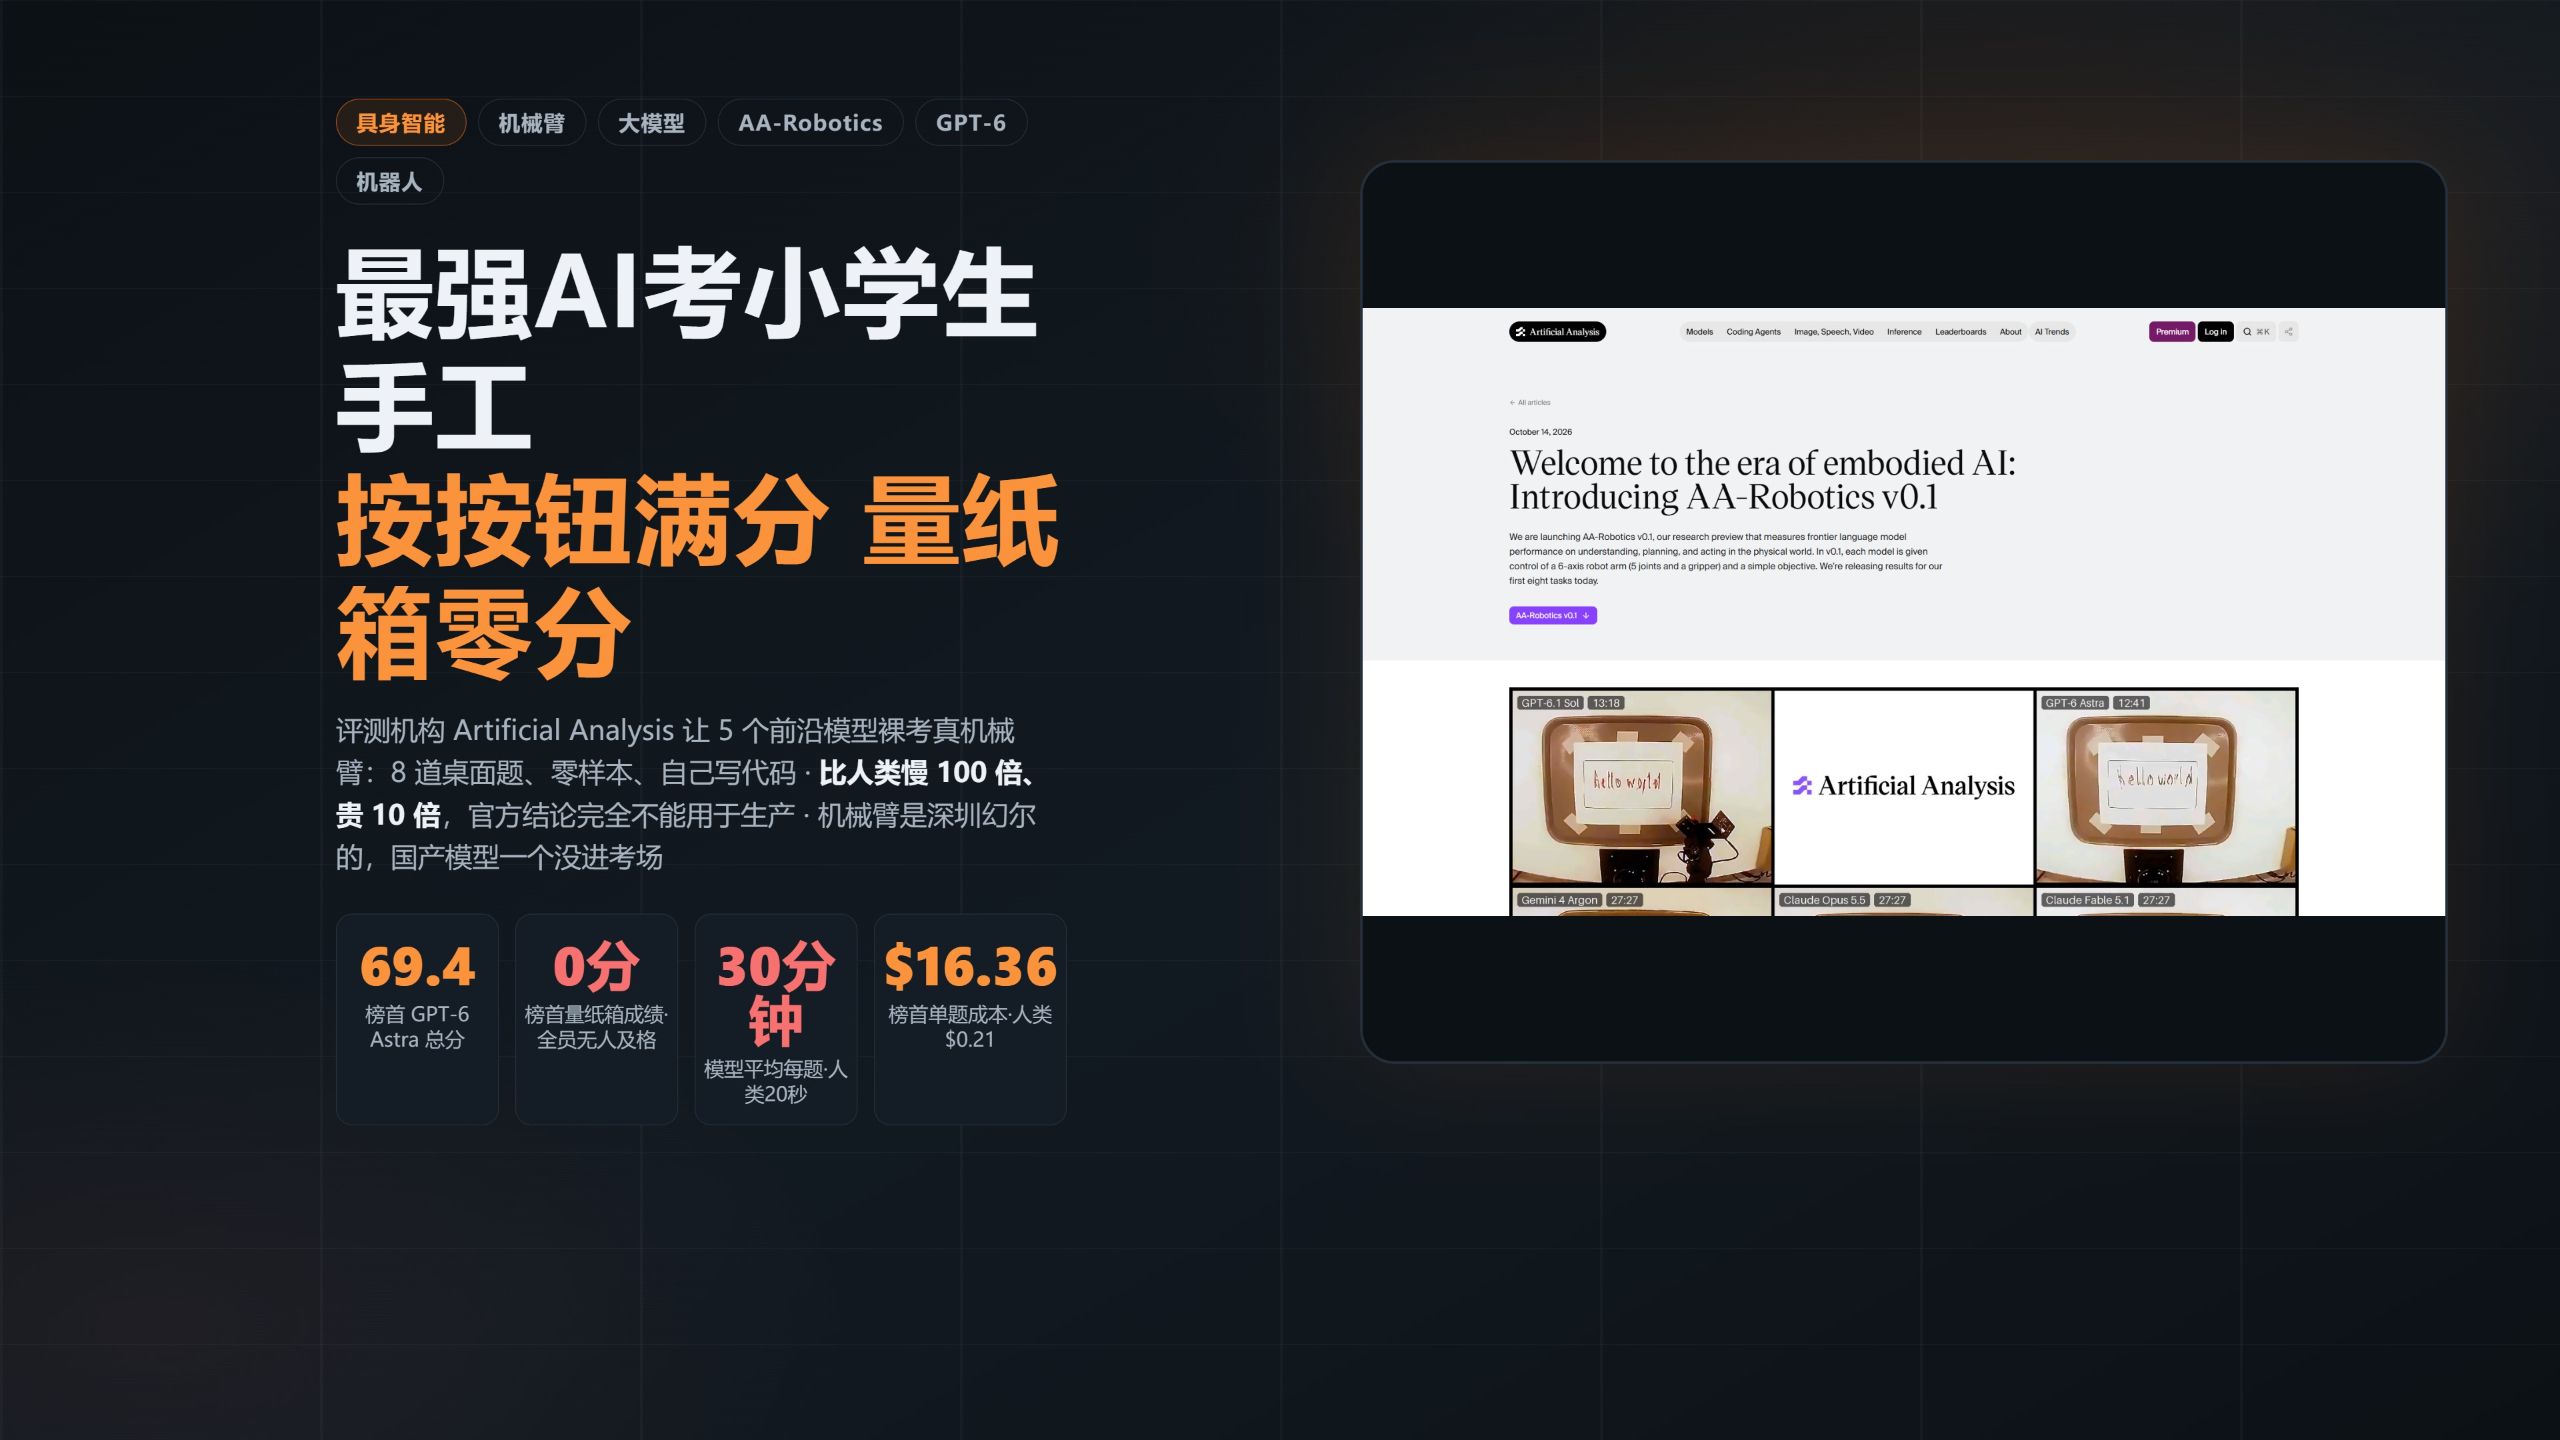
AI技术投降派
由于视觉输入成本高昂且空间推理能力严重不足,全球最强 AI 模型在六轴机械臂物理测试中比人类慢百倍且造价高出数十倍,现阶段完全无法投入实际生产。
AI-assisted summary of 最强AI的物理考试:各大AI大模型大比拼 — original source. Check the original for full context.
Source published:
Key ideas
- Artificial Analysis 推出 AA-Robotics 真机基准,让全球顶尖大模型在无图纸、无运动学参数的零样本条件下,仅凭 4 个摄像头操控 280 美元的机械臂完成桌面手工任务。 (0:00)
- 测试展现出夸张的两极分化:全员在按按钮任务上获满分,但在用尺子测量纸箱三向尺寸的任务上全员不及格,榜首 GPT-6 Astra 直接挂零。 (1:30)
- 实测经济与时间账本极其扎心:模型单题平均耗时 31 至 52 分钟(人类仅需 20 秒),成本是人类的 10 到 78 倍,且 70% 的资金消耗在反复调取摄像头视觉画面上。 (2:43)
- 模型在物理操作中呈现严重的‘想多动少’特征,全流程机械臂实际运动时间仅占 6%,Gemini 甚至需要先盯视思考 21 分钟才执行首个动作。 (3:39)
- 硬件采用深圳制造,但国内大模型在此次全球首发基准中全员缺席,暴露出火热融资与实际物理场景裸考之间的脱节。 (4:15)
Detailed notes
## Background 该内容由 Bilibili 频道“AI技术投降派”于 2026 年 10 月 15 日发布。视频聚焦评测机构 Artificial Analysis 最新上线的 AA-Robotics 真机基准测试,记录了全球五大顶尖 AI 大模型在无图纸、无参数的“裸考”状态下,自主操控一台 280 美元的六轴机械臂完成八道桌面手工题的全过程与惨烈结果。
## TL;DR 评测机构搭建真实桌面并采用深圳幻尔的 NexArm 机械臂,让顶尖大模型仅凭多路摄像头与基础提示编写代码进行零样本物理操作。测试结果呈现极端两极分化:模型在按按钮等简单任务上全员满分,但面对用尺子量纸箱等精细测量题则全军覆没,GPT-6 Astra 甚至挂零,GPT-6.1 Sol 还因过度精修导致积木塔倒塌。成本与时间账目更加严峻,AI 做单道题平均耗时半小时、成本高达人类的数倍至数十倍,且 94% 的时间都耗在视觉推理而非实际运动上。作者由此对照学术界的乐观、媒体的泼冷水以及国内具身智能火热融资但模型缺席的现状,探讨这究竟是技术的天花板还是爆发前夜。
## Atmosphere & style 视频整体呈现出一种冷静客观、反讽幽默且极具穿透力的科技评述风格。解说以平实接地气的语调将顶尖大模型在虚拟世界无所不能与在物理世界被小学生手工题难倒的反差拉满,叙事节奏紧凑扎实。面对昂贵的账单与滑稽的翻车标本,观众在感受到科技荒诞感的同时,也能强烈体会到关于具身智能落地真相的冷静沉思与行业警醒。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1a2JC68E1R?t=0s) Artificial Analysis 推出 AA-Robotics 真机基准,让全球顶尖大模型在无图纸、无运动学参数的零样本条件下,仅凭 4 个摄像头操控 280 美元的机械臂完成桌面手工任务。 - [01:30](https://www.bilibili.com/video/BV1a2JC68E1R?t=90s) 测试展现出夸张的两极分化:全员在按按钮任务上获满分,但在用尺子测量纸箱三向尺寸的任务上全员不及格,榜首 GPT-6 Astra 直接挂零。 - [02:43](https://www.bilibili.com/video/BV1a2JC68E1R?t=163s) 实测经济与时间账本极其扎心:模型单题平均耗时 31 至 52 分钟(人类仅需 20 秒),成本是人类的 10 到 78 倍,且 70% 的资金消耗在反复调取摄像头视觉画面上。 - [03:39](https://www.bilibili.com/video/BV1a2JC68E1R?t=219s) 模型在物理操作中呈现严重的‘想多动少’特征,全流程机械臂实际运动时间仅占 6%,Gemini 甚至需要先盯视思考 21 分钟才执行首个动作。 - [04:15](https://www.bilibili.com/video/BV1a2JC68E1R?t=255s) 硬件采用深圳制造,但国内大模型在此次全球首发基准中全员缺席,暴露出火热融资与实际物理场景裸考之间的脱节。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1a2JC68E1R?t=0s) AA-Robotics 测试构建了极度苛刻的物理‘裸考’环境,模型仅凭产品名和一句话接口说明,完全自主生成代码驱动机械臂。 - [00:38](https://www.bilibili.com/video/BV1a2JC68E1R?t=38s) 测试硬件采用深圳幻尔科技售价 280 美元的 NexArm 六轴机械臂,搭配 3 个固定视角与 1 个手腕视角摄像头进行闭环感知。 - [01:30](https://www.bilibili.com/video/BV1a2JC68E1R?t=90s) 八道桌面测试题涵盖控制精度、空间推理和随机应变能力,包括按按钮、倒饮料、搭积木塔及纸箱尺寸测量等小学手工级任务。 - [02:05](https://www.bilibili.com/video/BV1a2JC68E1R?t=125s) 大模型在物理世界表现严重两极分化:能写物理引擎的代码模型,却无法使用物理尺子完成误差 2mm 以内的纸箱测量。 - [02:05](https://www.bilibili.com/video/BV1a2JC68E1R?t=125s) 综合榜单中 GPT-6 Astra 以 69.4 分位列第一,GPT-6.1 Sol 得 64.6 分居次,Gemini 4 Argon 获 55.3 分,Claude 系列垫底。 - [02:43](https://www.bilibili.com/video/BV1a2JC68E1R?t=163s) 顶尖模型的性能边际成本极其昂贵,Astra 比 Sol 总分仅高出 4.8 分,但单题成本高出 8 倍,每提升 1 分需多花超 3 美元。 - [02:43](https://www.bilibili.com/video/BV1a2JC68E1R?t=163s) 多路视觉反馈调用极其昂贵,模型在反复观察环境与重试过程中,视觉 Token 开销占到总成本的 70%。 - [02:43](https://www.bilibili.com/video/BV1a2JC68E1R?t=163s) 评测官方给出‘比人类慢 100 倍、贵 10 倍、完全不能用于生产’的冰冷结论,打破了具身智能短期商用的过热预期。 - [03:39](https://www.bilibili.com/video/BV1a2JC68E1R?t=219s) 具身智能目前面临严重的算力与执行瓶颈,全流程 94% 的时间消耗在场景理解与代码规划上,真实物理运动仅占 6%。 - [03:39](https://www.bilibili.com/video/BV1a2JC68E1R?t=219s) GPT-6.1 Sol 搭积木塔任务展现了‘物理世界不容完美主义’的翻车案例:达到及格线后试图继续精修微调,直接碰翻塔身挂零。 - [04:15](https://www.bilibili.com/video/BV1a2JC68E1R?t=255s) 具身智能行业舆论呈现剧烈撕裂:伯克利学者宣称已上产线,MIT 科技评论断言短期难以改变生活,而真机基准揭示了悬殊的人机差距。 - [04:15](https://www.bilibili.com/video/BV1a2JC68E1R?t=255s) 国内具身智能赛道融资与政策口号火爆,但面对公开真机评测时国模缺席,引发该领域究竟处于‘突破前夜’还是‘天花板’的行业反思。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1a2JC68E1R?t=0s) 考场规则:六轴机械臂与零样本“裸考”
评测机构 Artificial Analysis 打造了一场极具戏剧性的真机测试。他们摆出一张真实的测试桌,放上一台由深圳幻尔科技制造的 NexArm 六轴机械臂(具有 5 个关节加 1 个夹爪,官网售价仅 280 美元),让全球顶尖的大模型前来进行物理世界的“裸考”。2026 年 10 月 14 日上线的基准测试名为 AA-Robotics(目前为研究预览版),其考核规则严苛到近乎苛刻:模型没有图纸,没有运动学参数,甚至没有动作示范和人工干预,全程处于零样本状态。模型拿到的提示只有极其简陋的一句话接口说明以及该设备的产品名称。
在这场测试中,模型必须依赖桌面上布置的四个摄像头来理解环境——其中三个为外部固定机位,一个绑在机械臂的手腕上。模型需要在独立的容器中自主编写代码并运行代码,通过最基础的接口直接向机械臂发送关节运动指令。在操作完成后,模型需要自行提交并交卷。现场的人类裁判会依照预设的严格标准对最终状态进行评分,单项满分为 100 分,若只完成一部分则按进度折算给分。评测机构指出,这种测试真实还原了模型直接驱动物理硬件的能力边界。
```mermaid flowchart TD accTitle: AA-Robotics 真机裸考架构图 accDescr: 大模型通过四个摄像头画面理解物理场景并在容器内生成代码控制六轴机械臂
subgraph Inputs["感知与环境输入"] C1["固定机位摄像头 ×3"] C2["手腕挂载摄像头 ×1"] P["基础提示<br>(接口说明 + 产品名)"] end
subgraph ModelAction["模型推理与执行环境"] LLM["前沿大模型<br>(GPT-6 / Gemini / Claude)"] Sandbox["代码容器<br>(自主编写并运行控制代码)"] end
subgraph RealWorld["物理硬件与评估"] Arm["幻尔 NexArm 六轴机械臂<br>(5关节 + 1夹爪)"] Judge["人类裁判打分<br>(满分100分,按完成度给分)"] end
C1 --> LLM C2 --> LLM P --> LLM LLM --> Sandbox Sandbox -->|"发送关节指令"| Arm Arm -->|"最终物理状态"| Judge ```
- 核心硬件:深圳幻尔科技(Hiwonder)NexArm 六轴机械臂(5 个自由度关节 + 1 个夹爪),官方售价 280 美元。 - 视觉配置:共 4 个摄像头(3 个固定视角 + 1 个腕部视角)。 - 交互限制:零样本(zero-shot)、无 CAD 图纸、无正逆运动学参数,全靠视觉反馈自主写代码执行。
---
[01:30](https://www.bilibili.com/video/BV1a2JC68E1R?t=90s) 八道小学生手工题与两极分化的成绩单
考卷一共包含八道题目,表面上看全都是如同小学生手工劳动课一样的基础任务:按下红色按钮、把鳄鱼玩具放进指定的长方形区域、把饮料倒进杯子且不洒出来、将四块积木收纳进盒中并扣上盖子、完成形状配对、用马克笔写下一句“Hello World”、用泡沫积木搭建最高的塔,以及最后一道高难度的测量题——用尺子量出纸箱的长宽高,要求每个维度的误差必须控制在 2 毫米以内。出题方明确表示,这八道题核心考察大模型的三项复合能力:“控制精度、空间推理、还有随机应变”。
最终的成绩单呈现出极其夸张的两极分化。在最基础的简单动作上,模型展现了近乎完美的执行力,按红按钮和放鳄鱼玩具这两道题,参评的五个模型全部拿下了 100 分满分。然而一到给纸箱量尺寸这种涉及精细空间度量与工具使用的题目,画风突变,全员彻底翻车:五个模型无一及格,最好成绩仅仅只有 17 分,榜首模型 GPT-6 Astra 甚至在该项直接挂了 0 分。综合八道题的总分排名为: 1. GPT-6 Astra:69.4 分(位居榜首) 2. GPT-6.1 Sol:64.6 分(位列第二) 3. Gemini 4 Argon:55.3 分(位列第三) 4. 两个不同版本的 Claude 模型则处于垫底位置。
现实的反差充满讽刺意味:那些在虚拟世界里能从零编写完整物理引擎的顶尖模型,回到真实的物理世界后,却被一把普通的尺子死死难住。
- 考察题目:按红按钮、放鳄鱼玩具、倒饮料不洒、四块积木收纳扣盖、形状配对、马克笔写 Hello World、泡沫积木搭最高塔、量纸箱三向尺寸(误差 ≤ 2mm)。 - 极端两极成绩:红按钮与鳄鱼放置全员满分;纸箱测量全员不及格(最高 17 分,第一名 Astra 拿 0 分)。
---
[02:43](https://www.bilibili.com/video/BV1a2JC68E1R?t=163s) 扎心的成本与时间账:慢百倍、贵十倍、动6%
抛开分数不谈,真正刺痛具身智能落地预期的,是时间与经济成本这两项硬核账本。人类完成这类桌面任务平均仅需 20 秒,按美国平均时薪折算,单次操作成本仅约 0.21 美元。而大模型表现最出色的两极却付出了极其昂贵的代价: - 性价比最佳的 GPT-6.1 Sol,单道题的成本为 1.93 美元; - 成绩排在第一的 GPT-6 Astra,单道题开销飙升至 16.36 美元。
Astra 与 Sol 的成本相差了 8 倍之多,但换来的总分差距仅有 4.8 分,相当于 Astra 为了每多拿 1 分,就要额外烧掉 3 美元以上。更值得注意的是,这些高昂开销中,有 70% 的资金完全消耗在视觉输入上——模型在不断调用多路摄像头画面进行重试与确认,“看一遍贵一遍”。
在时间维度上,AI 与人类的差距更为悬殊。参评的五个模型中有四个平均耗时在 31 分钟左右,而最慢的 Gemini 4 Argon 平均做一道题竟然要花 52 分钟。官方在评测报告中给出了极其冷峻的评判:“比人类慢差不多100倍, 贵10倍, 完全不能用于生产。”
| 评估维度 | 人类基线 | 最优性价比模型 (GPT-6.1 Sol) | 榜首模型 (GPT-6 Astra) | 最慢模型 (Gemini 4 Argon) | |:--- |:--- |:--- |:--- |:--- | | **平均耗时** | 约 20 秒 | 约 31 分钟 | 约 31 分钟 | 约 52 分钟 | | **单题成本** | 0.21 美元 | 1.93 美元(人类的近 10 倍) | 16.36 美元(人类的近 78 倍) | 高成本运行 | | **综合总分** | 满分基线 | 64.6 分 | 69.4 分 | 55.3 分 | | **执行特征** | 敏捷、即时反馈 | 出现过度精修翻车 | 视觉输入费用占 7 成 | 先看 21 分钟才做首个动作 |
时间拆解更是揭示了当前大模型在驱动物理实体时的致命软肋。Gemini 平均需要盯视桌面并推理整整 21 分钟,才会发出机械臂的第一个动作指令。在全流程长达 400 多分钟的测试运行中,机械臂实际产生机械运动的时间仅占总时长的 6%,剩下的 94% 全都耗费在场景理解、空间计算与代码规划的等待中。
测试中还留下了一个极具代表性的翻车标本:GPT-6.1 Sol 在泡沫积木搭塔项目中,花了 17 分钟已经稳稳把塔身搭建到了及格线。但模型在后续的推理中认为自己还可以挑战更高的高度,试图继续精修微调,结果机械爪直接碰翻了塔身,导致整道题目最终以 0 分收场。解说对此调侃道:“完美主义在物理世界里是会翻车的。”
---
[04:15](https://www.bilibili.com/video/BV1a2JC68E1R?t=255s) 行业的撕裂声音与具身智能的前夜
在同一个月内,关于具身智能的前景,学术界、工业界与产业评论爆发了三种截然不同的声音: 1. **学术乐观派**:9 月中旬,加州大学伯克利分校的机器人学教授 Ken Goldberg 发表长文探讨 GP-CotA 等前沿方向,公开宣称智能体机器人代表着第三条技术路线,并且类似的端到端与大模型方案已经开始走向实际产线。 2. **媒体怀疑派**:10 月初,《麻省理工科技评论》(MIT Technology Review)公开发表文章泼冷水,明确断言机器人领域的所谓突破在短期内根本改变不了普通人的日常生活。 3. **基准实测派**:AA-Robotics 评测机构拿出的这一份详实惨烈的实测冷数据,以“慢 100 倍、贵 10 倍”的残酷事实戳破了宣传泡沫。
从中文视角来看,这一场比拼还蕴藏着一层值得深思的行业现实。考场上所使用的六轴机械臂来自中国深圳的幻尔科技,展现了国内硬件供应链在全球极客与开发社区中的高普及度。然而令人尴尬的是,在这次全球首发评测的榜单之中,没有任何一家国产大模型的身影。今年上半年国内具身智能赛道的累计融资额高达数百亿元,具身智能更是被直接写入了地方与国家层面的相关规划,行业内“量产元年”的呼声震天响,但面对这样一场公开、公平的真实物理“裸考”,却没有国产模型现身交卷。
面对这一现状,出题机构 Artificial Analysis 意味深长地留下一句预测:“我们预计这一切会很快改变”。节目最后留给行业与观众一个开放式的深思:当全球最强的大模型在物理世界里做一道小学级别的手工题都要耗费整整半小时,按红按钮可以拿满分但量纸箱却挂零,究竟有哪家工厂敢让它们直接进厂?今天这耗时半小时的笨拙表现,究竟是物理世界的天花板,还是正如当年视觉领域的 ImageNet 前夜?
- 行业认知撕裂:伯克利教授宣称“第三路线已上产线” vs MIT 科技评论断言“短期改变不了生活” vs AA 基准实测“比人慢百倍”。 - 产业反差:硬件由中国深圳制造提供,但资本火热、高喊量产元年的国内大模型企业在此次基准首发中集体缺席。
## Notable quotes > [02:43](https://www.bilibili.com/video/BV1a2JC68E1R?t=163s) 完美主义在物理世界里是会翻车的。 — AI技术投降派
## Mentioned Artificial Analysis, AA-Robotics, 深圳幻尔科技, NexArm, GPT-6 Astra, GPT-6.1 Sol, Gemini 4 Argon, Claude, Ken Goldberg, 加州大学伯克利分校, 麻省理工科技评论, ImageNet
## Video description 评测机构 Artificial Analysis 干了件有意思的事:搭一张真桌子,摆上一台六轴机械臂(深圳幻尔的 NexArm,官网 280 美元),让世界上最强的五个大模型裸考八道桌面题。规则很苛刻:只给一句接口说明和产品名,不给图纸不给运动学参数,模型靠四个摄像头自己看桌面、自己写代码发关节指令,全程零样本。考题从按红按钮一路排到给纸箱量尺寸,听着都像小学生手工。结果特别真实:按按钮人人满分,量纸箱全员翻车(榜首 GPT-6 Astra 直接 0 分),GPT-6.1 Sol 花 17 分钟把塔搭到通过标准,然后继续精修,把塔弄倒了。钱和时间更扎心:模型平均一道题 30 分钟、人类 20 秒;榜首单题成本 16.36 美元、人类合 0.21 美元,贵的钱七成烧在反复看摄像头上。官方结论很直白:完全不能用于生产。但这背后还有更大的图景:同一个月,伯克利教授宣称智能体机器人是第三条路线,MIT 科技评论说机器人突破短期改变不了生活。今天这三十分钟,是具身智能的前夜还是天花板?评论区聊聊。
00:05 开场:最强模型 vs 小学生手工题 00:38 考场规则:裸考真机械臂 01:30 八道题都是什么 02:05 成绩单:按按钮满分 量纸箱零分 02:43 钱和时间:慢一百倍 贵十倍 03:39 时间去哪了:思考90% 动6% 04:15 同一个月的三种声音 + 中文视角 05:09 留给你:前夜还是天花板
数据口径:AA-Robotics v0.1 官方报告(2026-10-14);"贵10倍"指性价比最好的 GPT-6.1 Sol 对人类基线,榜首 Astra 约为人类的 78 倍,片中有区分。中文信息差:本基准发布不到一天,中文媒体尚无系统报道。关注我,每周追一期 AI 圈值得讲的事。
[Source](https://www.bilibili.com/video/BV1a2JC68E1R)