中国电信1.2B模型TeleOCR登顶文档解析四榜 跑分击败GPT-5.2
AI技术投降派
文档解析无需大模型的庞大通识参数,TeleOCR通过几何感知与结构解耦直击通用模型的表格软肋,证明1.2B垂类架构即可将工业级解析门槛压至消费级硬件。
AI-assisted summary of 1.2B小模型打赢GPT:文档解析4榜第一 — original source. Check the original for full context.
Source published:
Key ideas
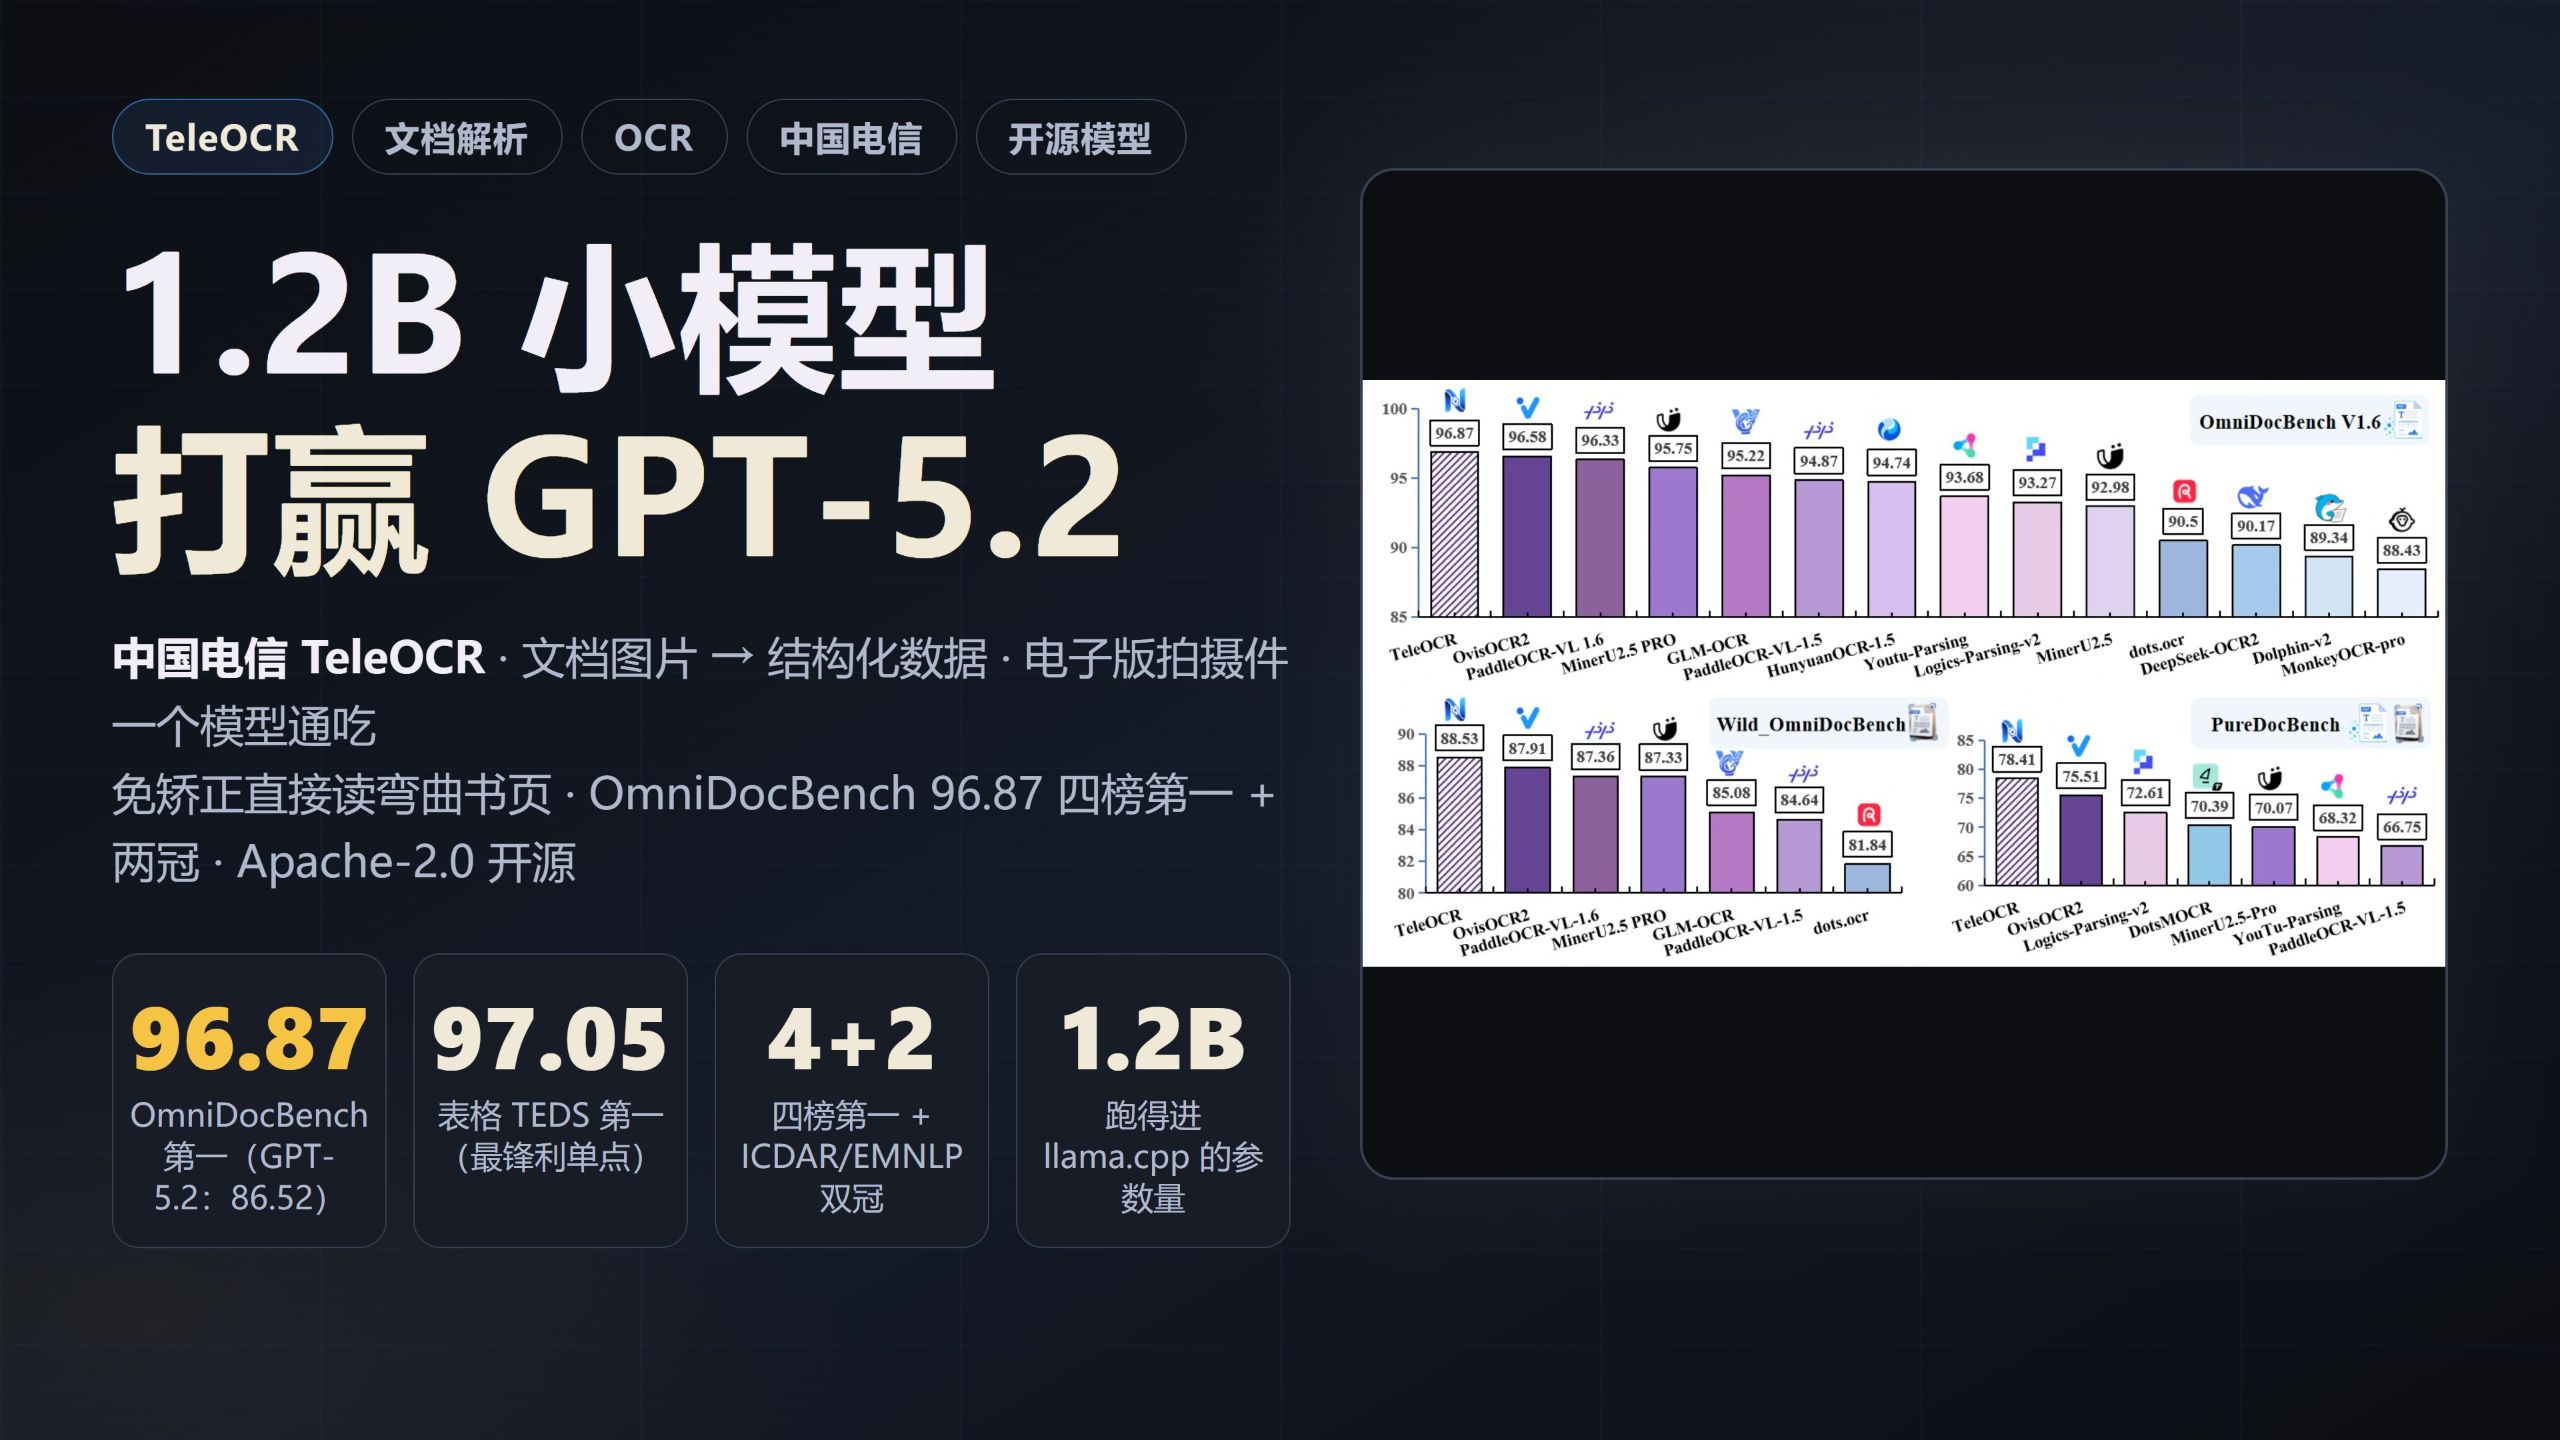
- 中国电信TeleAI推出1.2B轻量级文档解析模型TeleOCR,在权威评测OmniDocBench以96.87分夺冠,超越了GPT-5.2(86.52)和Qwen3-VL(89.78)等两百多B参数的通用大模型。 (0:00)
- TeleOCR在OmniDocBench、Wild_OmniDocBench复杂场景及PureDocBench退化文档等四个榜单拿下第一,并获得ICDAR 2026与EMNLP 2026两项挑战赛冠军。 (0:36)
- 打破传统拍照派“几何矫正→版面分析→识别”的误差级联流水线,TeleOCR内置形变感知学习,直接对弯曲书页输出正确版面结构,无需独立矫正模型。 (1:47)
- 轻量化使端侧部署门槛骤降:原生兼容Transformers,社区两周内补齐GGUF、llama.cpp及多档量化(MXFP8/INT8/MXFP4),并在昇腾910B完成落地。 (3:44)
Detailed notes
## Background 该视频由BilibiliUP主“AI技术投降派”于2026年10月17日发布。视频简介重点介绍了中国电信TeleAI出品的1.2B轻量级文档解析模型TeleOCR,展示其在OmniDocBench等评测中超越GPT-5.2与200B+通用大模型的战绩,以及其“不矫正直接读”、解耦结构与开源生态等核心亮点。
## TL;DR 视频深入解读了仅有1.2B参数量的国产开源文档解析模型TeleOCR如何实现“以小博大”,在OmniDocBench及ICDAR等权威评测中力压多款通用大模型与大厂竞品斩获四榜第一。与传统拍照文档需繁琐几何矫正的流水线不同,TeleOCR凭借内置形变感知实现“不矫正直接读”,统一了电子版与拍摄件处理。模型底层依托多节点共识投票(MCV)、OTSL内容-结构解耦学习以及图生图自验证三大核心技术柱,尤其在攻克通用大模型软肋的表格场景上表现亮眼。此外,极小的体积让其迅速适配llama.cpp并被量化部署到消费级硬件,证明了垂直专用模型在任务深度理解下的巨大优势。
## Atmosphere & style 全片节奏紧凑、语言犀利硬核,带有鲜明的技术拆解与“以弱胜强”的爽感叙事。解说语气自信笃定,开篇便用亮眼的跑分差距直击痛点,随后的原理解构抽丝剥茧、层层递进,既有对技术创新的赞赏,也有对行业竞争格局的冷静洞察。整场听下来如同观看一场技术维度的精准狙击战,务实、通透且极具说服力。
## Bulletin - [00:00](https://www.bilibili.com/video/BV123Hh6QE7T?t=0s) 中国电信TeleAI推出1.2B轻量级文档解析模型TeleOCR,在权威评测OmniDocBench以96.87分夺冠,超越了GPT-5.2(86.52)和Qwen3-VL(89.78)等两百多B参数的通用大模型。 - [00:36](https://www.bilibili.com/video/BV123Hh6QE7T?t=36s) TeleOCR在OmniDocBench、Wild_OmniDocBench复杂场景及PureDocBench退化文档等四个榜单拿下第一,并获得ICDAR 2026与EMNLP 2026两项挑战赛冠军。 - [01:47](https://www.bilibili.com/video/BV123Hh6QE7T?t=107s) 打破传统拍照派“几何矫正→版面分析→识别”的误差级联流水线,TeleOCR内置形变感知学习,直接对弯曲书页输出正确版面结构,无需独立矫正模型。 - [03:44](https://www.bilibili.com/video/BV123Hh6QE7T?t=224s) 轻量化使端侧部署门槛骤降:原生兼容Transformers,社区两周内补齐GGUF、llama.cpp及多档量化(MXFP8/INT8/MXFP4),并在昇腾910B完成落地。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV123Hh6QE7T?t=0s) TeleOCR以1.2B极小参数量在文档解析权威榜单OmniDocBench上取得96.87分,力压数百B量级的通用大模型。 - [00:36](https://www.bilibili.com/video/BV123Hh6QE7T?t=36s) 在表格解析维度表现优异,表格项TEDS获得97.05分位列第一,直击通用大模型的关键软肋。 - [00:36](https://www.bilibili.com/video/BV123Hh6QE7T?t=36s) 横扫复杂场景与退化文档评测,在PureDocBench真实退化档领先第二名约十个百分点。 - [00:36](https://www.bilibili.com/video/BV123Hh6QE7T?t=36s) 在竞赛中接连击败MinerU 2.5 Pro、PaddleOCR-VL 1.6等国内大厂主力文档解析团队方案。 - [01:47](https://www.bilibili.com/video/BV123Hh6QE7T?t=107s) 提出“不矫正直接读”的全新范式,通过形变感知学习实现电子版与拍摄件解析框架的统一。 - [02:39](https://www.bilibili.com/video/BV123Hh6QE7T?t=159s) 采用多节点共识投票(MCV)机制,利用解析共识自动构建训练数据,有效规避高昂的人工标注成本。 - [02:39](https://www.bilibili.com/video/BV123Hh6QE7T?t=159s) 实施内容与结构解耦学习,通过OTSL结构语言先搭骨架再填内容,是表格与公式高精度识别的核心支撑。 - [02:39](https://www.bilibili.com/video/BV123Hh6QE7T?t=159s) 引入图生图自验证闭环,将解析结果重渲染回图像并与原图比对,实现数据的自我检查与自动修正。 - [02:39](https://www.bilibili.com/video/BV123Hh6QE7T?t=159s) 借助曲率引导采样与四阶段渐进训练等机制,专项强化小模型对图像几何与版面结构的敏感度。 - [03:44](https://www.bilibili.com/video/BV123Hh6QE7T?t=224s) 模型依赖极低,仅需3个pip包即可原生加载,并迅速获得开源社区对llama.cpp和多种量化格式的生态支持。 - [03:44](https://www.bilibili.com/video/BV123Hh6QE7T?t=224s) 项目前身为8月发布的NaviDC-OCR,9月更名为TeleOCR并正式归入中国电信星辰品牌。 - [04:37](https://www.bilibili.com/video/BV123Hh6QE7T?t=277s) 垂类模型再次证明无需通用大模型通识:几何感知、结构语法与高质量数据足以在消费级硬件上重塑本地文档流水线。 - [04:37](https://www.bilibili.com/video/BV123Hh6QE7T?t=277s) 文档解析赛道比拼到最后的核心竞争力,在于对垂类具体任务与痛点的极致解构与理解。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV123Hh6QE7T?t=0s) 开场介绍与惊艳战绩
节目开场直接切入核心:一张文档图片——无论是手机随手拍的,还是从软件导出的电子版——只要丢进模型里,就能立刻还你结构化数据。做这件事的模型名叫 TeleOCR,由中国电信 TeleAI 出品,参数量只有微小的 1.2B。正如解说所评价的:“别嫌它小,在文档解析最权威的评测 OmniDocBench 上,它 96.87 分排第一,GPT-5.2 是 86.52,两百多B的 Qwen3-VL 是 89.78,1.2B 赢了所有通用大模型。”
随后,解说详细列举了 TeleOCR 拿下的豪华战绩:在 OmniDocBench v1.6 电子文档综合评测中以 96.87 分夺得第一,其中表格项 TEDS 更是取得了 97.05 分的头名;在复杂真实场景的 Wild_OmniDocBench 中拿下 88.53 分的第一;在 PureDocBench 退化文档三档评测中,干净档(86.90 分)和真实退化档(70.85 分)双双夺冠,比第二名高出大约十个百分点。此外,它在比赛层面还斩获了 ICDAR 2026 科技图像挖掘挑战赛的全部指标第一,以及 EMNLP 2026 Dr.DocBench 挑战赛的 67.96 分,直接压过了 MinerU 2.5 Pro 的 62.26 分和 PaddleOCR-VL 1.6 的 55.11 分。
这份竞争对手的名单涵盖了国内文档解析领域的顶尖“集团军”:包括上海 AI Lab 的 MinerU、百度的 PaddleOCR-VL、智谱的 GLM-OCR、腾讯的混元OCR,以及 DeepSeek-OCR。电信的 TeleOCR 不仅硬生生挤了进去,还直接站上了头排。
---
[01:47](https://www.bilibili.com/video/BV123Hh6QE7T?t=107s) 场景定位与不矫正直接读的创新思路
在场景定位上,TeleOCR 与传统模型有着本质的区别。文档解析历来分为两派:电子派主要处理导出的 PDF,而拍照派则负责处理手机拍摄的照片。拍照派最让人头疼的环节莫过于几何矫正。面对书页弯曲、透视变形等问题,传统流水线通常采用“先做几何矫正,再做版面分析,最后做识别”的繁琐步骤,导致每一环的误差不断向下传导。
而 TeleOCR 的选择堪称大胆:不矫正,直接读。模型内置了形变感知学习能力,在 DocUNet 和 DIR-300 这两个公开的去扭曲数据集上,能够对弯曲书页直接输出正确的版面结构,完全不需要专门的矫正模型做预处理。正如解说所总结的:“一个框架统一电子版和拍摄件,这是他论文标题里的承诺,也是他在做别的模型不做的事。”
```mermaid flowchart TD subgraph Traditional ["传统流水线"] A["拍照/弯曲文档"] --> B["几何矫正模型"] B --> C["版面分析"] C --> D["文字识别"] end subgraph TeleOCR ["TeleOCR 框架"] E["拍照/弯曲文档或电子版"] --> F["形变感知学习模型"] F --> G["直接输出正确版面与结构"] end
style Traditional fill:#f9f,stroke:#333,stroke-width:2px style TeleOCR fill:#bbf,stroke:#333,stroke-width:2px
accTitle: OCR Workflow Comparison accDescr: Comparison between traditional multi-step OCR pipeline with geometric correction and TeleOCR single-framework approach. ```
---
[02:39](https://www.bilibili.com/video/BV123Hh6QE7T?t=159s) 核心技术剖析与生态爆发
TeleOCR 之所以能够实现这样的突破,背后依托于六个关键技术点,其中最具代表性的有三个: * **多节点共识投票(MCV)**:让多个解析节点对同一份文档各自解析并进行投票,共识部分自动变成训练数据。由于人工标注文档结构又贵又慢,这个巧妙的办法成功绕开了标注瓶颈。 * **内容与结构解耦学习**:表格的结构采用一套名为 OTSL 的结构语言来拼装,换行和单元格边界都是专门的 token。先把骨架搭好,再把内容填进去,公式也显式地进行了语法建模。表格项之所以能拿到 97.05 的 TEDS 高分,这个解耦设计就是直接原因。 * **图生图自验证**:把解析结果重新渲染回图像,与原图进行比对、自我检查并自动修正数据。
至于剩下的几何感知建模、曲率引导采样以及四阶段渐进训练,则都在为同一个宏伟目标服务——让模型对形状和结构产生深刻的“感觉”。
这种轻量化设计带来了丰厚的回报。安装它只需要三个 pip 包,并且能够通过 Transformers 原生加载。发布短短一个多月,开源社区就已经高度活跃,GGUF 转换和 llama.cpp 支持迅速到位,从 MXFP8、INT8 到 MXFP4 的量化版本一应俱全,甚至还有开发者分享了在华为昇腾 910B 芯片上的部署经验。在 Hugging Face 主仓库上,它已经收获了三万多次下载和一千二百多个赞。
谈及身世背景,它最初于 8 月 17 日发布模型和技术报告时原名为 NaviDC-OCR,随后在 9 月 10 日正式更名为 TeleOCR,归入中国电信的“星辰”品牌旗下,后续的所有迭代都将沿用这个新名字。虽然在 GitHub 上只有三百来颗星,体量依然很小,但模型卡上的评测成绩却是实打实的。
---
[04:37](https://www.bilibili.com/video/BV123Hh6QE7T?t=277s) 行业判断与总结
结合整个项目的技术特征与市场表现,解说给出了极具分量的三句判断: * **“第一,垂类再次证明足够小。文档解析不需要200B的通识,需要的是几何感知、结构语法和干净数据。1.2B装得下,还跑得动 llama.cpp,本地文档流水线的门槛被他打到了消费级硬件。”** * **“第二,表格是他最锋利的单点,而表格恰恰是所有通用大模型解析文档的集体软肋,这个选点极准。”** * **“第三,那份评测表本质上是国产大厂文档解析的集团军点名,运营商背景的团队做到四榜第一,这个赛道拼到最后,拼的是对任务的理解。”**
## Notable quotes > [04:37](https://www.bilibili.com/video/BV123Hh6QE7T?t=277s) 文档解析不需要200B的通识,需要的是几何感知、结构语法和干净数据。 — 解说
## Mentioned TeleOCR, 中国电信, TeleAI, OmniDocBench, GPT-5.2, Qwen3-VL, Wild_OmniDocBench, PureDocBench, ICDAR 2026, EMNLP 2026, MinerU, PaddleOCR-VL, GLM-OCR, 混元OCR, DeepSeek-OCR, DocUNet, DIR-300, MCV, OTSL, Transformers, GGUF, llama.cpp, 华为昇腾 910B, NaviDC-OCR
## Video description 一张文档图片,手机拍的也好,导出的电子版也好,丢进去,还你结构化数据。做这件事的模型叫TeleOCR,中国电信TeleAI出品,只有1.2B参数。别嫌它小:OmniDocBench文档解析评测96.87分第一,GPT-5.2是86.52,两百多B的Qwen3-VL是89.78——一点二B,赢了所有通用大模型。
▸ 战绩四榜第一+两冠:OmniDocBench v1.6综合96.87第一(表格项TEDS 97.05也是第一);Wild_OmniDocBench复杂场景88.53第一;PureDocBench退化文档双档第一(干净86.90/真实退化70.85,超第二名约十个点);ICDAR 2026 Sci-ImageMiner挑战赛全部指标第一;EMNLP 2026 Dr.DocBench挑战赛67.96分,压过MinerU 2.5 Pro的62.26和PaddleOCR-VL 1.6的55.11。对手名单就是国产文档解析集团军:MinerU(上海AI Lab)、PaddleOCR-VL(百度)、GLM-OCR(智谱)、混元OCR(腾讯)、DeepSeek-OCR——电信的TeleOCR挤进去还站上头排。
▸ 最大区别在场景定位:不矫正,直接读。传统拍照派流水线"几何矫正→版面分析→识别"误差逐级下传;TeleOCR内置形变感知学习,在DocUNet和DIR300两个去扭曲数据集上对弯曲书页直接输出正确版面结构,不需要专门的矫正模型。一个框架统一电子版和拍摄件,这是它论文标题里的承诺。
▸ 六个技术点三根柱子:①MCV多节点共识投票——多个解析节点各自解析再投票,共识自动变训练数据,绕开人工标注瓶颈;②内容-结构解耦——表格用OTSL结构语言拼骨架(换行/单元格边界都是专门token)内容后填,公式显式建模语法,表格97.05的直接原因;③图生图自验证——解析结果渲染回图像与原图比对,自我检查自动修数据。另外三件(几何感知建模/曲率引导采样/四阶段渐进训练)服务同一目标:让模型对形状和结构有感觉。
▸ 轻是有回报的:pip装3个包transformers原生加载;发布两周社区即出GGUF+llama.cpp支持;MXFP8/INT8/MXFP4量化版齐了;升腾910B部署经验有人分享。HF主仓3.3万下载1.27k赞。身世:原名NaviDC-OCR(8月17日发布),9月10日更名TeleOCR归入电信星辰品牌。
▸ 判断三句:①垂类再次证明足够小——几何感知+结构语法+干净数据,1.2B装得下还跑进llama.cpp,本地文档流水线门槛被打到消费级硬件;②表格是它最锋利的单点,而表格恰是所有通用大模型的集体软肋,选点极准;③那份评测表是国产大厂文档解析集团军点名,运营商背景团队做到四榜第一——这赛道拼到最后拼的是对任务的理解。
收尾:文档解析不需要200B的通识。1.2B装得下,消费级硬件跑得动。
来源:huggingface.co/XingChen-AGI/TeleOCR · arXiv 2608.12898 · github.com/caipeng328/TeleOCR · teleai.com.cn/docparse
——时间轴—— 00:00 开场:1.2B打赢GPT-5.2 00:36 战绩:四榜第一+两冠,对手是集团军 01:47 场景:不矫正直接读弯曲书页 02:39 技术:三根柱子(MCV/OTSL解耦/自验证) 03:44 生态:轻的回报+身世更名 04:37 判断:三句话 05:22 收尾
[Source](https://www.bilibili.com/video/BV123Hh6QE7T)