DeepSeek发布Flash更新降本两成 763B参数实为统计口径切换
AI技术投降派
新模型跑分大涨与参数扩容传闻实为评测特化与披露口径替换,其真正突破在于精简输出降低两成调用成本,并协同低价搜索接口完成了Agent开发的基础设施闭环。
AI-assisted summary of DeepSeek重大更新,参数更强,追平opus — original source. Check the original for full context.
Source published:
Key ideas
- DeepSeek 发布新检查点 V4.1 Flash 1017,并在 Terminal Bench 4.0 上自报得分从 31.2 提升至 42.3,但较 Claude Opus 5.5 的 64.8 仍存在 22 分差距。 (0:00)
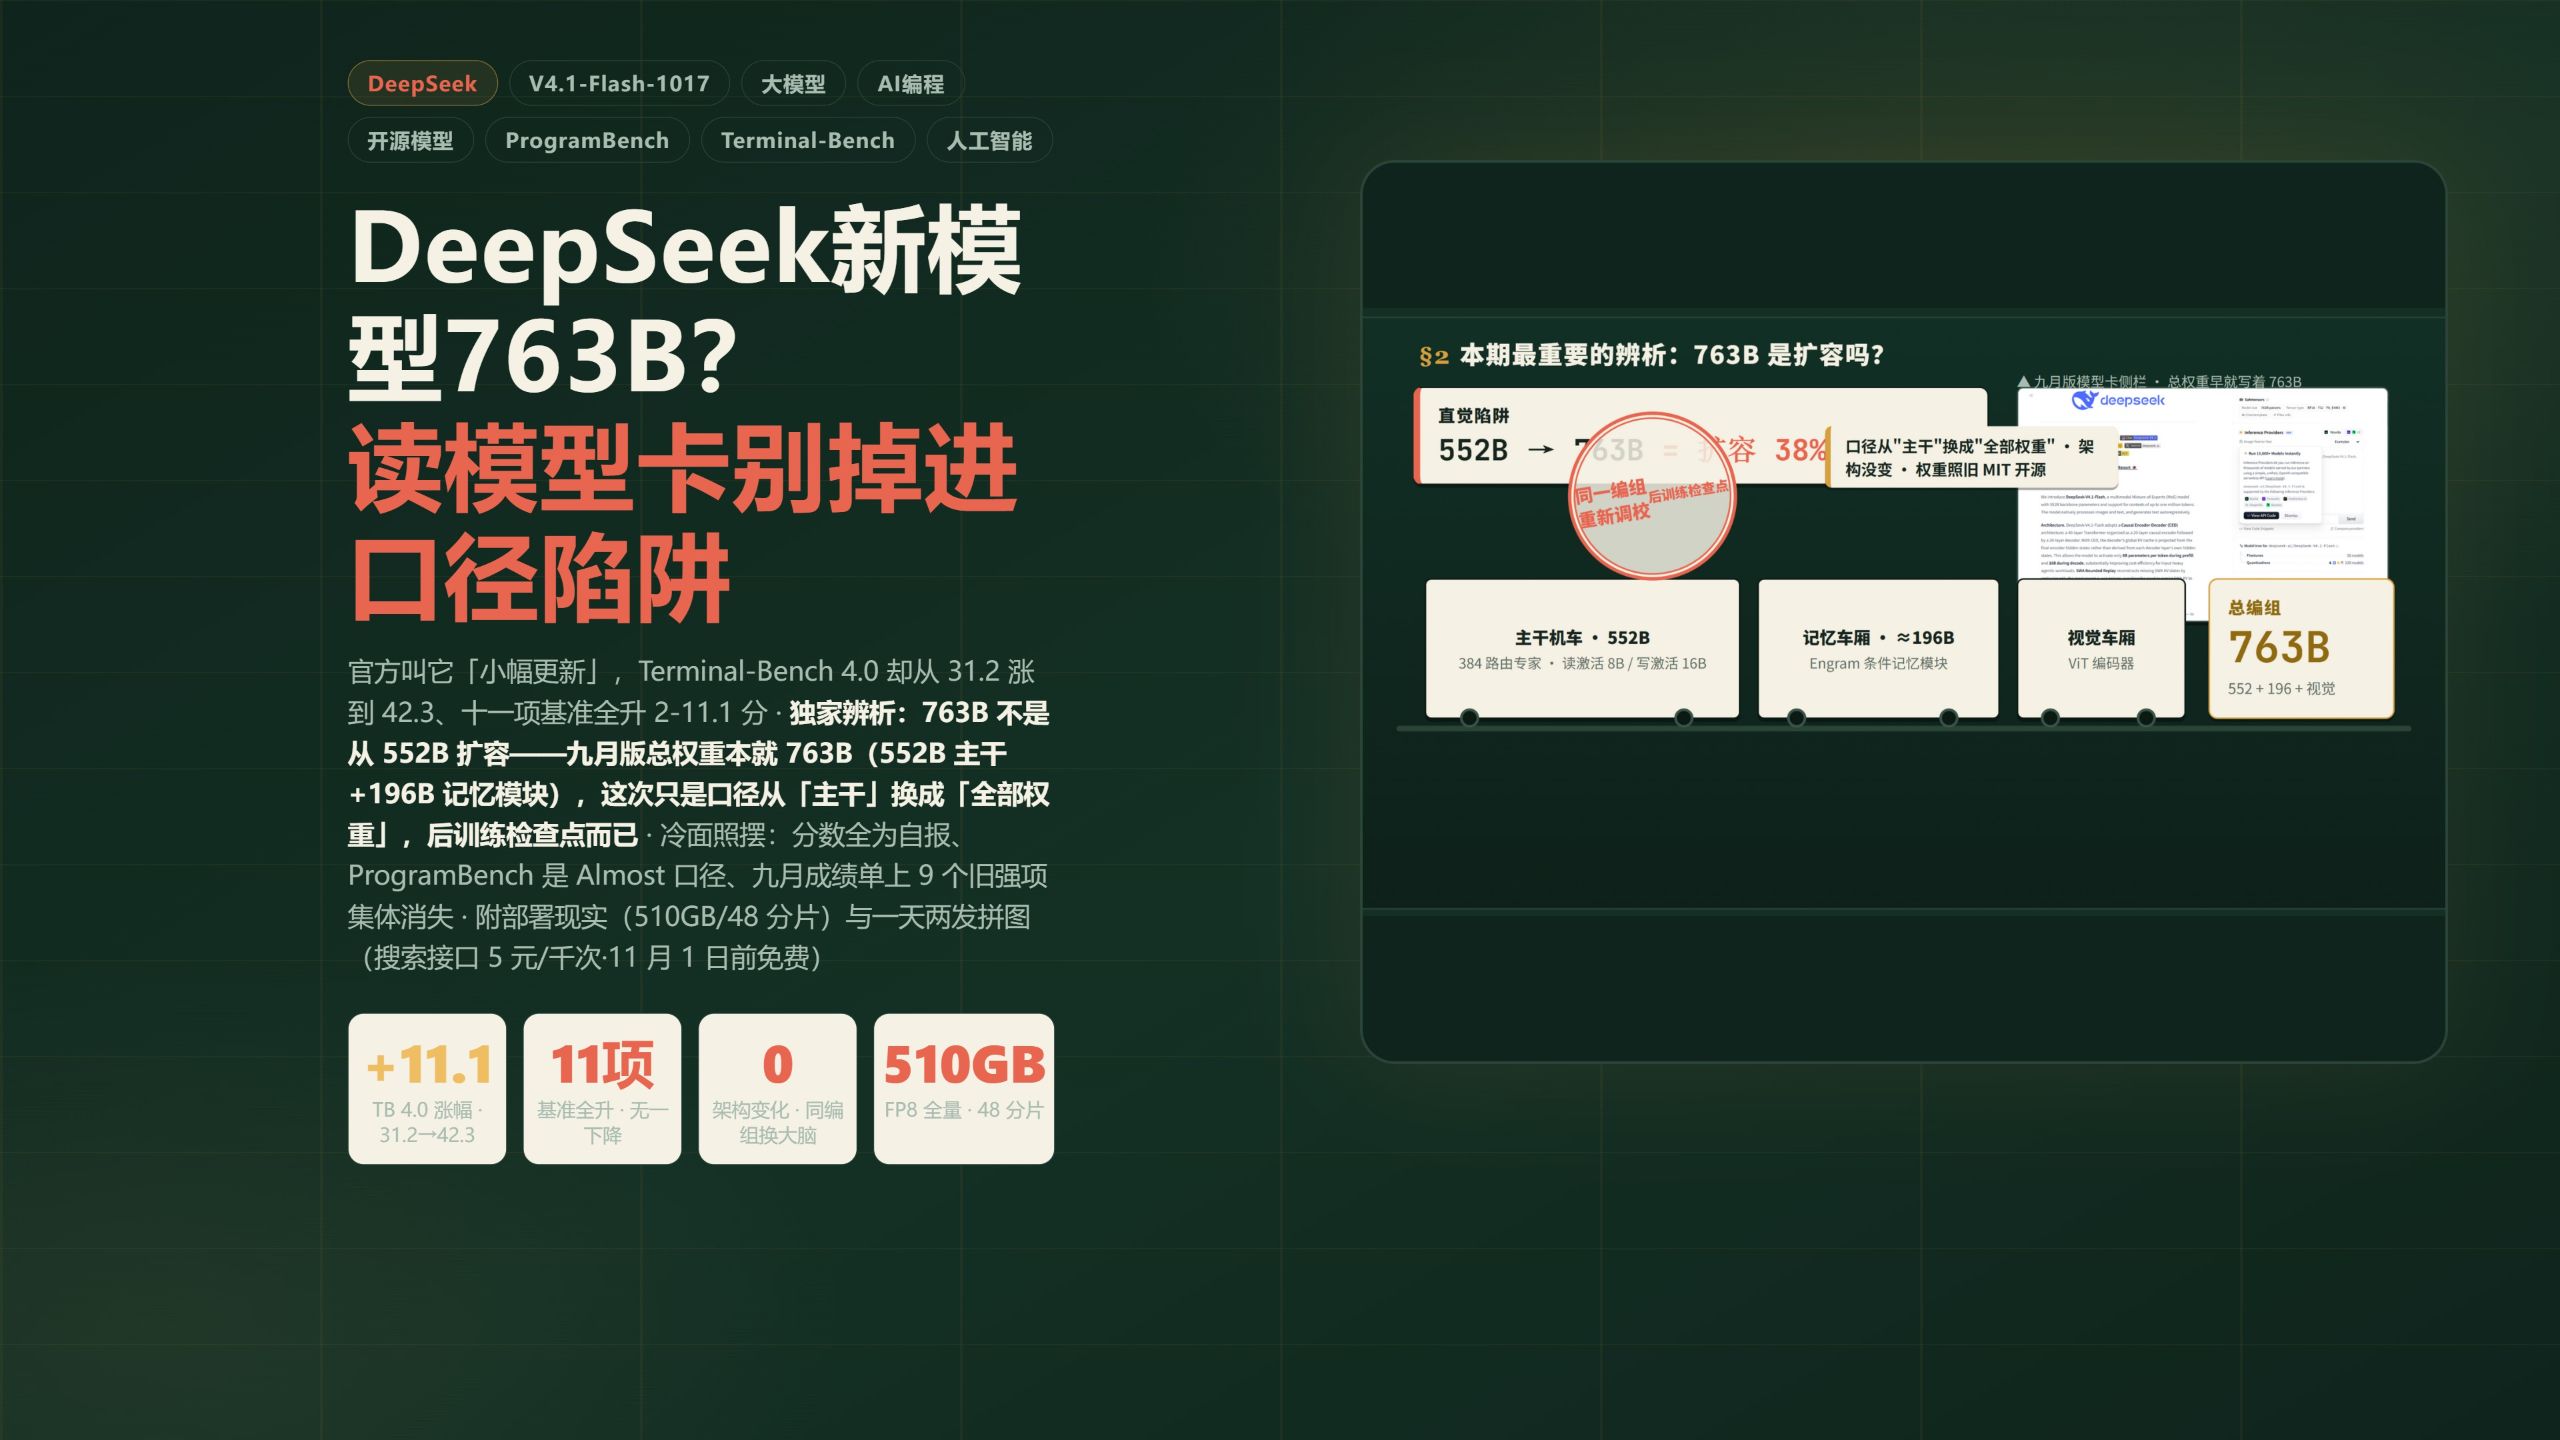
- 所谓“参数从 552B 扩张至 763B”实为公布口径变化,全模型此前即为 763B 权重(含主干、记忆模块与视觉编码器),底层架构并未重构。 (1:28)
- 新版模型在实际任务中输出 Token 量精简约 2.5 倍,调用成本节省 20%,单任务耗时从 16.8 秒降至 7.4 秒。 (3:40)
- 本地部署门槛极高,64GB 顶配 Mac 运行 2-bit 量化仅有数 Token/s 速度,官方云端 API 配合自研搜索接口成为性价比最高的 Agent 开发选型。 (3:40)
Detailed notes
## Background 该视频由B站UP主“AI技术投降派”于2026年10月18日发布在Bilibili平台。视频原简介未提供额外补充说明,主题聚焦于DeepSeek最新发布的模型更新、参数真实情况以及其在行业内的基准对标。
## TL;DR 视频深度解析了DeepSeek新上线的V4.1 Flash 1017模型,其在Terminal Bench等基准测试中大幅跃升,并展示出强大的端到端编程能力。作者澄清了社区关于“参数从552B扩容至763B”的认知偏差,指出这仅是官方将主干网络改为全模型权重的公布口径调整,且提醒观众注意官方自测跑分水分与部分传统基准隐退的现象。最后,作者结合实测指出了新模型在API调用中Token减少2.5倍、成本下降20%的工程优势,以及高硬件门槛下使用官方云端API和配套搜索接口构建Agent生态的现实路径。
## Atmosphere & style 视频整体呈现出一种技术硬核、清醒且略带讽刺幽默的解构风格。UP主叙事节奏紧凑敏锐,既有对技术参数与跑分细节的抽丝剥茧,也有面对宣发狂欢时的冷水审视,金句频出。观众在观看过程中能清晰感受到从“为惊艳跑分振奋”到“识破口径套路后的理性反思”,最终落脚到务实的工程与成本权衡,极具实战说服力。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1ZCng6LEkz?t=0s) DeepSeek 发布新检查点 V4.1 Flash 1017,并在 Terminal Bench 4.0 上自报得分从 31.2 提升至 42.3,但较 Claude Opus 5.5 的 64.8 仍存在 22 分差距。 - [01:28](https://www.bilibili.com/video/BV1ZCng6LEkz?t=88s) 所谓“参数从 552B 扩张至 763B”实为公布口径变化,全模型此前即为 763B 权重(含主干、记忆模块与视觉编码器),底层架构并未重构。 - [03:40](https://www.bilibili.com/video/BV1ZCng6LEkz?t=220s) 新版模型在实际任务中输出 Token 量精简约 2.5 倍,调用成本节省 20%,单任务耗时从 16.8 秒降至 7.4 秒。 - [03:40](https://www.bilibili.com/video/BV1ZCng6LEkz?t=220s) 本地部署门槛极高,64GB 顶配 Mac 运行 2-bit 量化仅有数 Token/s 速度,官方云端 API 配合自研搜索接口成为性价比最高的 Agent 开发选型。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1ZCng6LEkz?t=0s) DeepSeek 在同一天内密集上线自研搜索接口与 V4.1 Flash 1017 模型,定位为针对 9 月版本的小幅强化学习更新。 - [00:00](https://www.bilibili.com/video/BV1ZCng6LEkz?t=0s) 新模型在 Terminal Bench 4.0、Program Bench 及 Deep SWE 等编程与智能体评测中全线上涨,展示出端到端完整软件生成的工程化能力。 - [01:28](https://www.bilibili.com/video/BV1ZCng6LEkz?t=88s) 参数从 552B 变成 763B 属于认知偏差,官方仅将对外宣传统计口径从主干网络扩展到了全模型权重,底层仍遵循 MIT 开源协议。 - [01:28](https://www.bilibili.com/video/BV1ZCng6LEkz?t=88s) 榜单高分目前均为官方自测自报,发布时尚无第三方权威机构复现,数据可信度仍需时间检验。 - [01:28](https://www.bilibili.com/video/BV1ZCng6LEkz?t=88s) 部分跑分采用了相对宽松的评测标准,且 9 月曾展示的 Codeforces、GPQA 等 9 项传统强项测试本次集体缺席,通用推理能力是否存在退化尚存疑。 - [03:40](https://www.bilibili.com/video/BV1ZCng6LEkz?t=220s) 新版本显著精简了 Token 生成长度,单任务推理时间由 16.8 秒腰斩至 7.4 秒,综合调用开销降低约 20%。 - [03:40](https://www.bilibili.com/video/BV1ZCng6LEkz?t=220s) 云端 API 保持极具杀伤力的定价,错峰期输入仅 0.15 元/百万 Token、输出 0.60 元/百万 Token,性价比优势突出。 - [03:40](https://www.bilibili.com/video/BV1ZCng6LEkz?t=220s) 端侧量化部署体验欠佳,3-bit 易陷入死循环,高配 Mac 运行 2-bit 速度极慢,普通开发者短期内难以本地跑通。 - [03:40](https://www.bilibili.com/video/BV1ZCng6LEkz?t=220s) 低调用成本的模型叠加千次 5 元的自研搜索接口,标志着面向 Agent 应用的基础设施拼图已基本齐备。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1ZCng6LEkz?t=0s) 性能跃升与“小幅更新”背后的基准测试
10月17日,DeepSeek在一天内密集释放了两项核心动作:上午刚刚开放自研搜索接口,下午便直接上线了代号直白的新模型——V4.1 Flash 1017。虽然官方口径表现得极为低调,宣称“这是对九月那版的一次小幅更新”,但各大权威测试榜单上的成绩却十分惊人。在衡量终端环境真实任务处理能力的 Terminal Bench 4.0 中,该模型一口气从 31.2 暴涨至 42.3,单项直接提升了 11.1 分,引得 Hugging Face 联合创始人在社交平台发帖调侃管这叫所谓的“小幅更新”,相关话题在 Hacker News 拿下 700 多分、Reddit 斩获 900 多赞。
```mermaid flowchart TD accTitle: DeepSeek 核心基准成绩提升对比 accDescr: 展示 Terminal Bench 4.0、Program Bench 以及 Deep SWE 三大核心评测项目的版本得分变化。
subgraph TB ["Terminal Bench 4.0 (智能体终端)"] TB_Old["9月版: 31.2"] --> TB_New["1017版: 42.3 (+11.1)"] end
subgraph PB ["Program Bench (从零软件重建)"] PB_Old["9月版: 20.3"] --> PB_New["1017版: 29.1 (+8.8)"] end
subgraph SWE ["Deep SWE (真实仓库工程)"] SWE_Old["9月版: 74.2"] --> SWE_New["1017版: 77.0 (+2.8)"] end ```
根据官方披露的数据,本次公布的 11 项基准测试成绩出现全线上涨,各维度涨幅在 2 分到 11.1 分不等。核心的三大指标呈现出极高维度的特化进阶: - **Terminal Bench 4.0**:评估智能体在命令行与终端环境执行真实任务的能力,成绩由 31.2 分跃升至 42.3 分。 - **Program Bench**:测验从零开始重建整个软件的能力,得分由 20.3 拔高到 29.1。 - **Deep SWE**:针对长任务及真实代码仓库工程的评测,分数从 74.2 提升至 77。
这套能力依赖于引入自我反馈机制的强化学习训练方法。官方在演示中展现了从独立游戏到 3D 建模等端到端完整项目的生成过程,被中文社区形象地冠以“许愿式编程”的称号。需要明确的是,此次所有对比基准均为今年 9 月发布的旧版本,属于同一模型谱系下的自我演进。
---
[01:28](https://www.bilibili.com/video/BV1ZCng6LEkz?t=88s) 参数真假扩容辨析与官方跑分的水分审视
针对社区中“模型参数由 5520 亿大幅扩张至 7630 亿”的热门传言,视频明确指出该解读存在认知偏差。对比 9 月发布时的官方模型卡侧边栏可以发现,当时标注的 Model Size 就已经是 763B Params。这 7630 亿的总权重自始至终由三部分组成:约 5520 亿的主干网络、约 1960 亿的记忆模块,外加视觉编码器。9 月宣传页面所写的 552B 仅指主干网络参数,此次 763B 的说法纯粹是官方将公布口径从主干替换为了全模型权重。其底层架构并未重构,本质上属于同一列车重新微调后产生的新后训练检查点(Checkpoint),开源协议依旧遵循 MIT。
在面对亮眼的分数时,同样需要保持足够的理性审视。视频作者强调:“开源是自由,不等于免费午餐”,并拆解了跑分背后必须注意的三大细节: - **缺乏第三方背书**:所有数据均为官方自测自报,发布尚不足 24 小时,暂无权威独立机构的复现与验证。 - **评测口径的宽松度**:在 Terminal Bench 4.0 上,42.3 的成绩虽然超越了 GPT-5.6SO 和 GLM-5.3,但距离 Claude Opus 5.5 的 64.8 仍有整整 22 分的鸿沟;在 Program Bench 中拿下的 29.1 分使用的是“Almost”标准(只要 9×5 的测试项通过即算及格),若换用业界最严苛的“Fully”全通口径,9 月版模型曾录得仅 0.5% 的极低通过率;Deep SWE 的 77 分,则必须把 Meta 自报 79 分的 Muse Wonder 排除在外才能暂列首位。 - **传统强项测试的离奇隐退**:9 月成绩单上曾经亮眼的 9 个基准项目——包括 Codeforces、Terminal Bench 2.1、GPQA、Cyber Gym 等,在本次战报中集体缺席。智能体方向的针对性特化是否导致了通用与传统推理能力的退化,官方对此未作说明,目前仍需标记为存疑与待观察状态。
---
[03:40](https://www.bilibili.com/video/BV1ZCng6LEkz?t=220s) 落地成本账、端侧门槛与 Agent 生态闭环
相较于基准得分,本次更新最具现实意义的突破在于工程效率与调用成本的优化。官方承诺“缩短任务执行时间与输出长度”。独立实测结果印证了这一改进:在处理相同任务时,新模型的 Token 输出量比旧版精简了 2.5 倍,综合调用成本节省约 20%。完成单个典型任务仅需 7.4 秒,耗费不足 2 美分;而老版本则需要耗时 16.8 秒,耗时翻倍且成本高出半美分。此外,模型的推理力度在调整至一档后,终于达到了实际工业可用的稳定状态。
```mermaid flowchart LR accTitle: DeepSeek Flash 性能与使用场景分流 accDescr: 对比 API 端的高性价比与本地部署的高硬件门槛,展示普通用户的最佳实践路径。
subgraph CloudAPI ["云端 API 路线 (推荐选型)"] API_Name["DeepSeek Flash"] API_Cost["错峰价: 输入0.15元 / 输出0.60元 每百万Token"] API_Perf["耗时 7.4秒 / 成本省 20%"] API_Name --> API_Cost --> API_Perf end
subgraph LocalDeploy ["本地量化路线 (门槛苛刻)"] Q4["4-bit: 表现稳定"] Q3["3-bit: 陷入死循环"] Q2["2-bit: 64GB Mac顶配仅几Token/s"] Q4 -.-> Q3 -.-> Q2 end ```
在商用定价与本地部署方面,整体呈现出明显的两极分化格局: - **云端 API 极具竞争力**:接口名维持 DeepSeek Flash 不变,价格同样未作调整。错峰期每百万 Token 的输入价格为 0.15 元,输出为 0.60 元,峰值时段价格翻倍,被官方称作“性能与成本的帕累托改进”。 - **端侧部署对普通硬件极不友好**:模型在 4-bit 量化下表现稳定,但在 3-bit 下极易出现死循环;即便是 64GB 顶配规格的 Mac 运行 2-bit 量化,其推理速度也仅有每秒几个 Token。目前本地开源玩家仍在等待 Unsloth 等社区团队提供专用的优化量化包。因此,对绝大多数开发者和企业而言,调用官方 API 依然是当下最理性的选择。
回顾全盘布局,从 9 月的首发到 10 月的模型精调,DeepSeek 保持了相同的编组与亲民的定价策略。视频作者总结道:“这次大脑版本号直接写日期,这个动作本身就在说话,节奏成了武器。”再结合上午公布的 1000 次调用仅需 5 元(11 月 1 日前限时免费)的自研搜索接口,模型端既快又便宜,联网检索的成本门槛也被彻底打下,面向 Agent 开发所需的基础设施“水电煤”已在一天之内被全盘配齐。按照这种版本迭代的宣发节奏,下一次更新并不需要让行业等待太久。
## Notable quotes > [01:28](https://www.bilibili.com/video/BV1ZCng6LEkz?t=88s) 开源是自由,不等于免费午餐 — AI技术投降派
## Mentioned DeepSeek, V4.1 Flash 1017, DeepSeek Flash, Hugging Face, Hacker News, Reddit, Terminal Bench 4.0, Program Bench, Deep SWE, GPT-5.6SO, GLM-5.3, Claude Opus 5.5, Meta, Muse Wonder, Codeforces, Terminal Bench 2.1, GPQA, Cyber Gym, Unsloth, Mac
[Source](https://www.bilibili.com/video/BV1ZCng6LEkz)