CPython移除方法对象Free List 终结内存ID复用假象
码农高天
方法获取时的ID一致本质上是内存快速释放与重用的巧合,而Python 3.6优化直接调用路径后,官方在3.9版本中果断剔除了已沦为冗余负担的free_list缓存机制。
AI-assisted summary of 【python】关于method的玄学?这id怎么这么难以预测?让我们用科学解释玄学! — original source. Check the original for full context.
Source published:
Key ideas
- 在 Python 中连续获取同一对象的方法并计算 ID,其结果在 Python 3.9 下未加 print 时相同,但插入一行 print 后就会变成两个不同的地址;而在 Python 3.8 下则始终保持一致。 (0:00)
- 每次通过属性访问获取方法时,底层的 descriptor 实际上都会新建一个独立的 PyMethodObject,初始测试 ID 相等本质上是生命周期紧密交替导致的内存复用巧合。 (2:50)
- Python 3.8 针对 method 对象保留了 free_list 内存缓存机制,因而即使插入复杂的 print 扰乱内存,新建方法依然能命中缓存;而 Python 3.9 彻底移除了该机制。 (2:50)
- 移除 free_list 的深层原因在于 Python 3.6 引入了 LOAD_METHOD 与 CALL_METHOD 字节码优化,直接调用方法无需创建临时对象,导致创建 PyMethodObject 的场景极少,保留缓存反成累赘。 (5:00)
Detailed notes
## Background 该视频由 YouTube 频道“码农高天”于 2024 年 2 月 3 日发布。视频灵感源自 B 站粉丝提出的疑问,作者通过精炼后的测试代码,旨在用科学的底层原理剖析 Python 中看似离奇的“玄学”现象,并传达面对玄学不信谣、不传谣的技术态度。
## TL;DR 视频探讨了连续获取对象方法并查看 `id(o.f)` 时,为何在 Python 3.9 中插入一行 `print` 就会导致前后 ID 从一致变为不一致,而在 Python 3.8 中却始终保持相同的现象。高天解释道,方法属性本质上是通过 descriptor 每次动态生成独立的 `PyMethodObject`,初次测试 ID 相同仅是内存释放后恰好复用的巧合,而 `print` 打乱了内存状态;Python 3.8 始终一致则归功于底层针对 method 的 `free_list` 缓存机制。进一步深挖 CPython 源码演进可知,由于 Python 3.6 引入了 `LOAD_METHOD` 字节码优化使得直接调用方法不再需要构建临时对象,`free_list` 功效减弱并成为累赘,最终在 Python 3.9 中被官方彻底移除。
## Atmosphere & style 整体氛围严谨求真且风趣幽默,开篇以开发者在日常 Debug 中“加了一行 print 后 bug 离奇消失”的真实痛点切入,瞬间拉近与观众的距离。高天的讲解层层递进、逻辑清晰,既有对“玄学”现象的生动调侃,又有直面底层 C 源码与字节码硬核剖析的理性克制。整期内容充满探索与解密的智趣感,展现了资深开发者回归科学、追根溯源的技术魅力。
## Bulletin - [00:00](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=0s) 在 Python 中连续获取同一对象的方法并计算 ID,其结果在 Python 3.9 下未加 print 时相同,但插入一行 print 后就会变成两个不同的地址;而在 Python 3.8 下则始终保持一致。 - [02:50](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=170s) 每次通过属性访问获取方法时,底层的 descriptor 实际上都会新建一个独立的 PyMethodObject,初始测试 ID 相等本质上是生命周期紧密交替导致的内存复用巧合。 - [02:50](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=170s) Python 3.8 针对 method 对象保留了 free_list 内存缓存机制,因而即使插入复杂的 print 扰乱内存,新建方法依然能命中缓存;而 Python 3.9 彻底移除了该机制。 - [05:00](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=300s) 移除 free_list 的深层原因在于 Python 3.6 引入了 LOAD_METHOD 与 CALL_METHOD 字节码优化,直接调用方法无需创建临时对象,导致创建 PyMethodObject 的场景极少,保留缓存反成累赘。
## Key takeaways - [00:00](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=0s) 测试代码在连续获取 a = id(o.f) 与 b = id(o.f) 时,插入一行 print(a) 会破坏 ID 的一致性,呈现典型的调试干扰假象。 - [00:00](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=0s) 该现象在不同版本表现不一:Python 3.9 插入 print 后 a 与 b 永远不等,而 Python 3.8 下无论是否打印两者均永远相等。 - [02:50](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=170s) 从底层对象模型来看,访问 o.f 会通过 function descriptor 创建独立的 PyMethodObject,理论上每次生成的对象地址天然不同。 - [02:50](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=170s) 未加 print 时两处 ID 相同完全是巧合:前一个临时对象的内存刚被释放,紧接着创建的后一个对象恰好复用了同一块地址。 - [02:50](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=170s) print 函数内部具有复杂的执行逻辑与多次内存分配回收,插入 print 会打乱底层通用内存分配状态,导致第二个方法对象无法复用原地址。 - [02:50](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=170s) 若显式通过变量引用持有 o.f 阻止其内存被立即释放,再次获取方法对象时 ID 同样会出现不相等。 - [02:50](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=170s) Python 3.8 的 PyMethod_New 实现了 free_list 机制,方法销毁时不向操作系统归还内存而是暂存列表,确保下次创建稳定复用。 - [02:50](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=170s) Python 3.9 核心源码删除了针对 method 对象的 free_list 缓存逻辑,导致其地址复用极易受到外部内存分配干扰。 - [05:00](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=300s) 传统属性访问方式 a = o.f 生成 LOAD_ATTR 字节码,必须完整构建出 PyMethodObject 实体并完成变量赋值。 - [05:00](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=300s) 自 Python 3.6 起,直接调用 o.f() 被优化为 LOAD_METHOD 与 CALL_METHOD,底层借助 _PyObject_GetMethod 快速查找函数与 self 指针入栈。 - [05:00](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=300s) LOAD_METHOD 的优化使得绝大部分常规方法调用完全跳过了实例化临时 PyMethodObject 的步骤,大幅降低了创建开销。 - [05:00](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=300s) 实际生产环境中单独取出方法赋值的场景极罕见,当优化代码(free_list)带来的收益微乎其微时,维护它反而成了系统累赘,因此 Python 3.9 最终将其清理。
## Detailed walkthrough ### [00:00](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=0s) 一个令人困惑的玄学现象:相同的代码为何 ID 一会儿一样、一会儿不一样?
```mermaid flowchart TD accTitle: Python Method ID 玄学对比流程图 accDescr: 展示在 Python 3.8 与 3.9 环境下插入 print 代码前后获取 method ID 的行为差异
subgraph Case1["原始代码 (Python 3.9)"] A1["a = id(o.f)"] --> B1["b = id(o.f)"] B1 --> C1["print(a, b) -> a == b (巧合:内存复用)"] end
subgraph Case2["插入 print(a) (Python 3.9)"] A2["a = id(o.f)"] --> P2["print(a) 打乱内存分配"] P2 --> B2["b = id(o.f)"] B2 --> C2["print(a, b) -> a!= b (地址改变)"] end
subgraph Case3["Python 3.8 环境"] A3["a = id(o.f)"] --> P3["print(a) 或其他复杂操作"] P3 --> B3["b = id(o.f)"] B3 --> C3["print(a, b) -> a == b (free list 保留内存)"] end ```
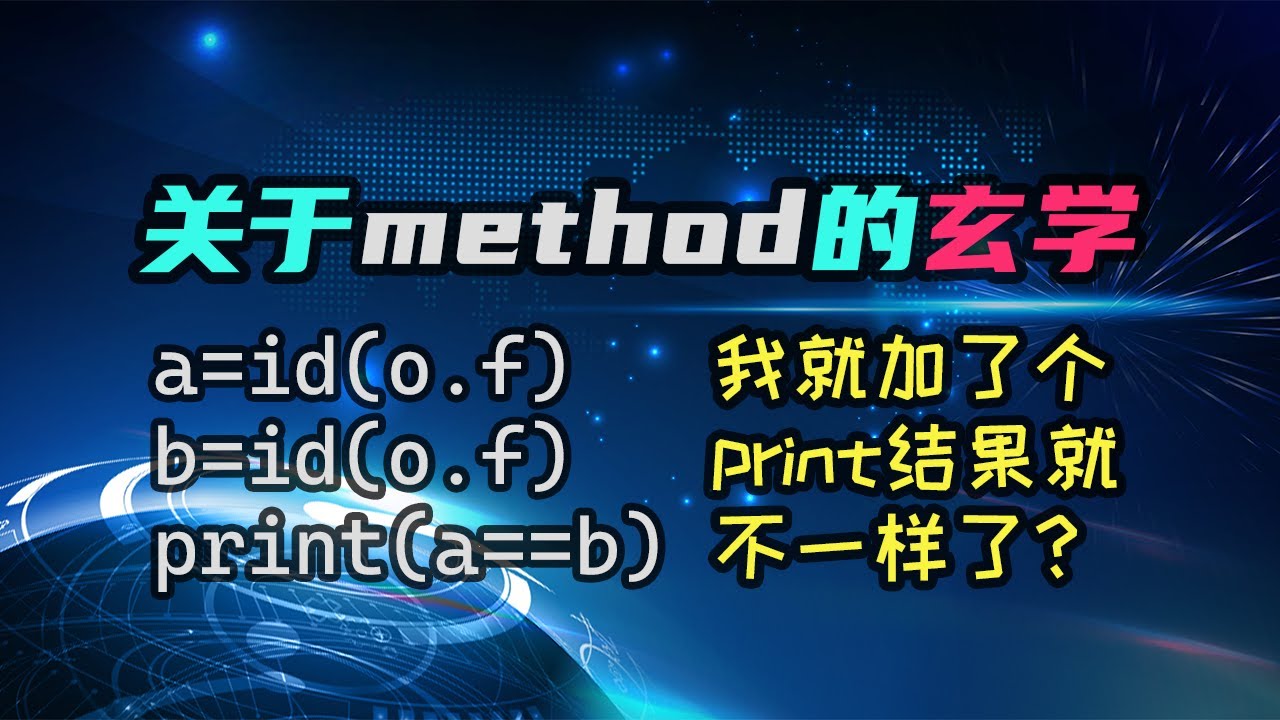
在日常的 Python 编程与调试过程中,开发者往往会遇到一些难以理解的怪异现象。码农高天分享了一个由 B 站粉丝提出的问题,并将其提炼为一段极简的测试代码。代码首先定义了一个包含方法 `f` 的类 `C`,接着实例化出对象 `o`。随后分别令 `a = id(o.f)` 以及 `b = id(o.f)`。面对“`a` 与 `b` 是否相等”这一问题,许多人的第一反应可能是脑中一片空白,而看过此前关于方法底层原理视频的观众则可能会意识到这里暗藏玄机。运行这段基础代码后,结果显示 `a` 和 `b` 是一致的。
然而“玄学”的调试陷阱随即展现:如果在计算完 `a = id(o.f)` 之后立即加入一行 `print(a)`,其余代码保持原封不动,再次运行程序,打印出的 `a` 与 `b` 竟然变成了不同的两个值。码农高天感叹道:“我不知道大家在 debug 的时候有没有过这种经历,这个 bug 我加了一个 print 之后,它就没法复现了,我们今天就来表演一下这个场面。”这种原本一致的 ID 仅仅因为加了一行看似无关的打印语句而变得不一致,很容易让程序员归咎于所谓的玄学。
更离奇的是跨版本的行为差异。在当前使用的 Python 3.9 虚拟环境中,插入 `print(a)` 后 `a` 与 `b` 永远不一致;但如果切换至 Python 3.8 环境,无论运行多少次,`a` 与 `b` 却又永远保持一致。码农高天指出,面对这种“有时候一致、有时候不一致”的现象,视频的目的绝不是停留于表面玄学,而是要回归科学,深入分析解释底层机制到底发生了什么。
- 基础复现代码逻辑: 1. `class C: def f(self): pass` 2. `o = C()` 3. `a = id(o.f)` 4. 插入 `print(a)` 扰乱测试环境 5. `b = id(o.f)` 6. 对比 `a` 与 `b` 的值 - 运行现象对比: - Python 3.9 未加 `print`:`a == b` - Python 3.9 加上 `print(a)`:`a!= b` - Python 3.8 无论是否加 `print(a)`:`a == b`
---
[02:50](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=170s) 回归科学解释:内存巧合、Descriptor 与 Free List 机制
要彻底理解这一现象,必须回到 `o.f` 本质上究竟是什么这一核心问题。在 Python 对象的底层模型中,每一次尝试从对象上获取一个方法时,实际上都会通过函数自带的 descriptor 新建一个 `PyMethodObject`。换而言之,每次访问 `o.f` 时生成的都是两个不同的独立对象,其地址理论上天然就应该不一样。如果理解了这一点,就会发现最开始得出“两处 ID 相等”的结论完全是一个巧合。码农高天直言:“但如果你意识到了这件事儿,你就会发现你刚开始那道题答案是错的,因为在当前这个程序下 A 跟 B 就是相等的,那这里怎么解释呢?就是两个字叫巧合。”
这个巧合的根源在于 Python 底层的内存管理机制。当代码连续执行两次获取操作时,由于第一个 `o.f` 和第二个 `o.f` 的生命周期衔接得足够紧密,第一个 `o.f` 在计算完 `id()` 后生命周期结束并立刻释放了内存,紧接着生成的第二个 `o.f` 恰好重用了刚刚释放的这块内存地址,从而导致两者的 `id()` 输出完全相同。然而,一旦在中间插入 `print(a)`,由于 `print` 函数本身内部的执行逻辑极为复杂,涉及多次内存分配与回收,彻底打乱了原有的内存管理状态,第二个 `o.f` 无法再使用原地址,`a` 与 `b` 的差异便暴露了出来。类似地,若通过 `x = o.f` 建立一个引用并保存,阻止了第一块内存被回收,再次获取时也会观察到 `a` 与 `b` 不相等。
针对 Python 3.8 与 3.9 的表现差异,答案则隐藏在 CPython 源码的演化中。在 Python 3.8 的 `PyMethod_New` 函数源码中,存在一个叫做 `free_list`(空闲列表)的内存缓存机制。当一个 `method` 对象的生命周期结束、原本应当释放内存时,CPython 并不立即向操作系统归还该内存,而是将其暂存在 `free_list` 中保留下来;当下一次需要新建方法对象时,就可以直接复用这块内存,无需重新向系统申请。这种缓存机制极具稳定性,即使中间穿插了执行极为繁杂的 `print` 代码打乱通用内存,后续新建方法依然能精准从 `free_list` 中命中该地址,因而在 Python 3.8 下两个 ID 始终一致。而在 Python 3.9 的 CPython 源码中,这段针对 method 的 `free_list` 逻辑已被彻底移除,导致其内存无法被强制保留,版本之间的差异由此产生。
---
[05:00](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=300s) 追根溯源:为什么 Python 3.9 移除了 Method 的 Free List?
既然 `free_list` 听起来能有效避免频繁申请和释放内存的时间开销,官方为何要在 Python 3.9 中将这段性能优化代码直接删除?码农高天表示,解答这种问题正是深入剖析底层的意义所在,因为“正常人绝对不会跟你讲这么深”。要厘清删除的原因,必须回溯到 Python 3.6 对方法调用机制所做的一项重大优化。
在过去的传统认知中,通过 descriptor 机制访问方法每次都要构建一个新的 `PyMethodObject`,如果每次调用对象方法都要凭空新建一个对象然后再销毁,性能开销确实会显得非常笨拙。面对粉丝关于这一机制是否很蠢的疑惑,码农高天坦率评价道:“答案是蠢。这也就是为什么从 Python 3.6 开始这件事情被优化了。”
```mermaid flowchart LR accTitle: LOAD_ATTR 与 LOAD_METHOD 字节码路径对比 accDescr: 比较常规赋值与直接方法调用在字节码及底层 CPython 逻辑上的差异
subgraph Traditional["普通属性获取: a = o.f"] direction TB T1["LOAD_ATTR 字节码"] --> T2["调用 function descriptor"] T2 --> T3["创建完整的 PyMethodObject"] T3 --> T4["赋值保存至变量 a"] end
subgraph Optimized["直接方法调用: o.f() (Python 3.6+)"] direction TB O1["LOAD_METHOD 字节码"] --> O2["_PyObject_GetMethod 快速查找"] O2 --> O3["将 Descriptor 函数直接推入栈"] O3 --> O4["将 self 对象推入栈"] O4 --> O5["CALL_METHOD 直接绑定调用 (无需临时 Object)"] end ```
通过对比字节码可以清晰看到优化前后的差异: - **普通绑定场景(如 `a = o.f`)**:生成的字节码为 `LOAD_ATTR`。底层必须触发该函数的 descriptor 机制,完整创建出一个 `PyMethodObject` 实体并赋给变量 `a`。 - **直接调用场景(如 `o.f()`)**:从 Python 3.6 起,字节码被优化为了专用的 `LOAD_METHOD` 与 `CALL_METHOD` 组合,替代了以往低效的 `LOAD_ATTR` 加 `CALL_FUNCTION`。
在 `LOAD_METHOD` 的底层 C 源码中,CPython 调用 `_PyObject_GetMethod` 进行高速查找。一旦确认该属性是一个方法,底层便直接将函数的 descriptor(即类中原始定义的 `f` 函数指针)与实例对象 `self` 先后压入求值栈,随后在 `CALL_METHOD` 阶段直接调用该函数并传入 `self`,整个过程完全跳过了创建临时 `PyMethodObject` 的步骤。在实际生产代码中,绝大多数操作都是对方法进行即时调用,将方法单独取出来赋值给变量的用法极为罕见。
正是由于 Python 3.6 引入的这一优化,让绝大部分方法调用都不再需要实例化临时对象,导致在 Python 运行时中真正去执行 `PyMethod_New` 创建新方法对象的场景变得微乎其微。码农高天由此阐释了底层架构演进的权衡之道:“而我们知道任何代码都是有代价的,当你一段优化的代码功效变小的时候,这段优化的代码可能就反而成为了累赘。”由于 `free_list` 的管理和维护本身带有维护成本和内存开销,既然新建 method 的场景已经极少发生,继续保留它便失去了价值。最终,Python 3.9 核心团队果断移除了这段过时的 `free_list` 优化代码,而正是这一清理遗留优化的决策,构成了这期“玄学”现象的底层真相。码农高天在结尾呼吁大家面对玄学问题要用科学眼光深究原因,做到不信谣、不传谣,并提醒观众一键三连以支持深度技术内容的持续输出。
## Notable quotes > [05:00](https://www.youtube.com/watch?v=2GpCIKkEOuw&t=300s) 任何代码都是有代价的,当你一段优化的代码功效变小的时候,这段优化的代码可能就反而成为了累赘。 — 码农高天
## Mentioned Python, CPython, Python 3.6, Python 3.8, Python 3.9, 码农高天, B站
## Video description 这期视频的灵感来自于某个B站粉丝发给我的问题,我精简了一下拿了出来。这期视频的背后有很多用处不是很大,但是蛮有趣的知识点,但是更重要的是传达了我们对玄学的态度——不信谣,不传谣。
[Source](https://www.youtube.com/watch?v=2GpCIKkEOuw)