DeepSeek开源DeepInfer并平级适配昇腾与英伟达
AI技术投降派
DeepSeek补全模型、算子到引擎的三层闭环并首次给予国产芯片第一方同等优先级,但保留了最关键的分布式KV缓存系统且仅支持单一模型。
AI-assisted summary of 从零件到引擎:DeepSeek把看家本领全交了 — original source. Check the original for full context.
Source published:
Key ideas
- DeepSeek 正式开源线上超大规模生产级推理引擎 DeepInfer,首日获超 1.3 万 GitHub Star,补齐了自研模型、底层算子到整套推理引擎的三层全栈闭环。 (0:00)
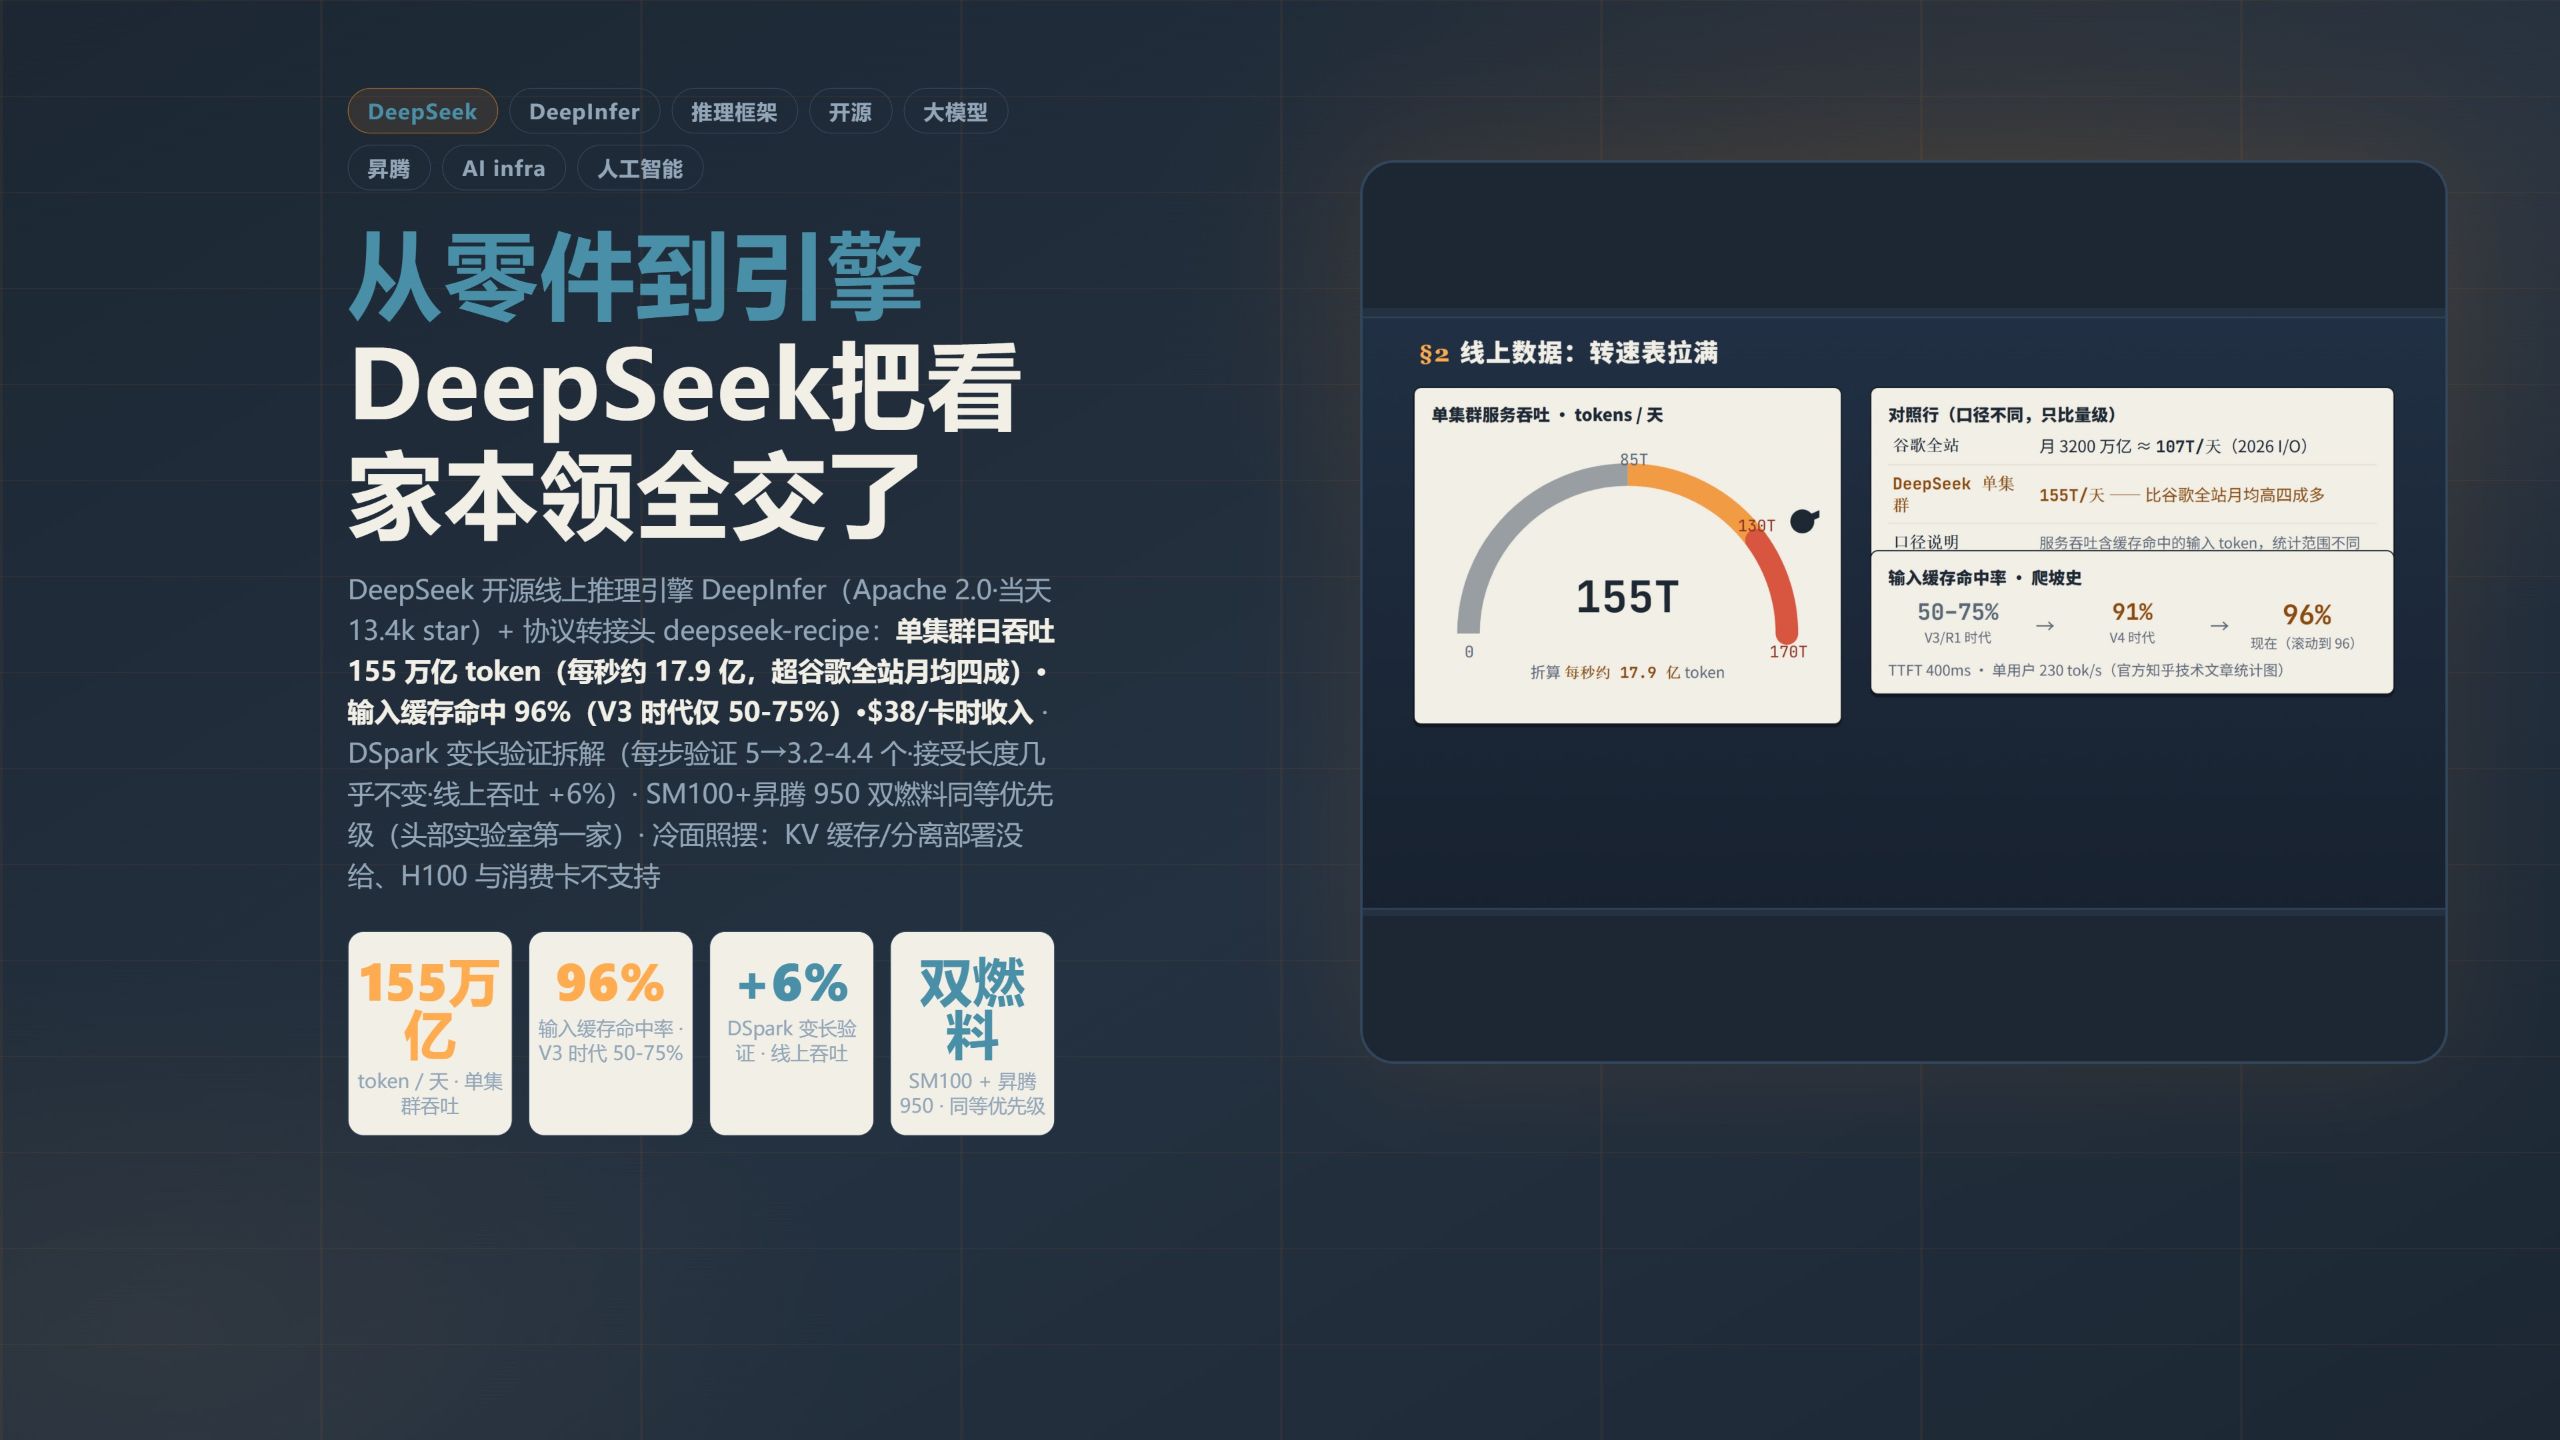
- 官方披露其单集群每日处理 155 万亿 Token(每秒约 17.9 亿),输入缓存平均命中率达 96%,按错峰调用折算单卡每小时收入达 38 美元。 (1:42)
- 推测解码算法 DSpark 引入置信度头与变长验证,单步验证数量从 5 降至 3.2 到 4.4 个,少耗费三成验证算力并换取 6% 的线上整体吞吐提升。 (2:48)
- DeepInfer 硬件适配释放关键信号:首日同等优先级支持英伟达 Blackwell(SM100/CUDA 13)与华为昇腾 950(CANN 9.2),但完全不兼容 H100、H200 及消费级显卡。 (3:53)
Detailed notes
## Background 该内容由创作者“AI技术投降派”于 2026 年 10 月 21 日发布在哔哩哔哩(Bilibili)平台。视频简介指出,DeepSeek 在开源模型与算子之后,正式开源了支撑其真实线上服务的整套推理引擎 DeepInfer 以及协议转接工具 deepseek-recipe,标志着其开源历程从提供零散部件迈向交付整机“发动机”的总装闭环阶段。
## TL;DR DeepInfer 整合了 FlashMLA、DeepGEMM 与 DeepEP 等自研底层算子,构建起涵盖基础推理、推测解码与异步调度的三层推理系统。官方披露其单一生产集群日吞吐量达 155 万亿 Token、输入缓存命中率攀升至 96%,并通过 DSpark 变长推测解码技术动态降低 30% 验证算力以提升吞吐。硬件生态层面,DeepInfer 首发即赋予英伟达 Blackwell(SM100)与华为昇腾 950 完全对等的旗舰优先级,但完全不支持 H100 等旧卡;同时作者冷静指出,开源版本剥离了核心的分布式 KV 缓存等关键基础设施,38 美元的单卡时收也未计入实际运营成本。
## Atmosphere & style 全片充盈着硬核工程师的冷静与克制,在面对社区狂欢时始终保持冷眼审视的客观视角。主讲人语速平稳干练,巧妙借用“吊装发动机”、“变截面涡轮”、“协议转接头”等工业机械隐喻,将深奥的分布式推理架构拆解得通透具象。整场叙事在赞赏国产全栈突破的自豪感与严谨剖析技术局限、商业算账的理性批判之间取得了微妙平衡,给观众带来一场高密度、高信息量的深度工业复盘体验。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1Pdne6xEA6?t=0s) DeepSeek 正式开源线上超大规模生产级推理引擎 DeepInfer,首日获超 1.3 万 GitHub Star,补齐了自研模型、底层算子到整套推理引擎的三层全栈闭环。 - [01:42](https://www.bilibili.com/video/BV1Pdne6xEA6?t=102s) 官方披露其单集群每日处理 155 万亿 Token(每秒约 17.9 亿),输入缓存平均命中率达 96%,按错峰调用折算单卡每小时收入达 38 美元。 - [02:48](https://www.bilibili.com/video/BV1Pdne6xEA6?t=168s) 推测解码算法 DSpark 引入置信度头与变长验证,单步验证数量从 5 降至 3.2 到 4.4 个,少耗费三成验证算力并换取 6% 的线上整体吞吐提升。 - [03:53](https://www.bilibili.com/video/BV1Pdne6xEA6?t=233s) DeepInfer 硬件适配释放关键信号:首日同等优先级支持英伟达 Blackwell(SM100/CUDA 13)与华为昇腾 950(CANN 9.2),但完全不兼容 H100、H200 及消费级显卡。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1Pdne6xEA6?t=0s) DeepSeek 开源 DeepInfer,标志着其开源战略从独立零部件走向整套工业级发动机总成交付。 - [00:15](https://www.bilibili.com/video/BV1Pdne6xEA6?t=15s) DeepInfer 采用 Apache 2.0 协议,早期基于 vLLM 构建并融合 SGLang 与 TensorRT-LLM 思想,涵盖基础推理、推测解码、异步调度与结构化输出。 - [00:38](https://www.bilibili.com/video/BV1Pdne6xEA6?t=38s) 引擎中层实行注意力走数据并行(DP)、MoE 走超宽专家并行(EP),单组并行规模最高支持 128 卡。 - [00:45](https://www.bilibili.com/video/BV1Pdne6xEA6?t=45s) 开源版属于受限核心:仅适配 V4.1 Flash 单一模型,未开放分布式 KV 缓存、PD 分离部署及全局调度,且算子内核较线上慢 5% 到 10%。 - [01:42](https://www.bilibili.com/video/BV1Pdne6xEA6?t=102s) 单集群日吞吐达 155 万亿 Token,比 Google I/O 公布的全站月均日吞吐高出四成多(注:口径包含缓存命中)。 - [02:00](https://www.bilibili.com/video/BV1Pdne6xEA6?t=120s) 线上输入缓存命中率随技术演进从 V3 的 50%~70% 爬坡至当前 96%,首 Token 延迟压至 400 毫秒,单用户生成速率达 230 Token/s。 - [02:30](https://www.bilibili.com/video/BV1Pdne6xEA6?t=150s) 单卡每小时 38 美元按错峰服务收入折算,社区激烈争议点在于其未扣除折旧、电费与机房综合成本。 - [02:48](https://www.bilibili.com/video/BV1Pdne6xEA6?t=168s) DSpark 变长验证改变传统固定验证 5 个 Token 的机制,动态截断至 3.2~4.4 个,以几乎无损的接受长度节省 30% 验证算力。 - [03:25](https://www.bilibili.com/video/BV1Pdne6xEA6?t=205s) DSpark 在低并发下因置信度开销微亏 1.5%,高并发下增益 11%,线上全量系统吞吐整体提升 6%(与论文单用户 85% 加速口径不同)。 - [03:53](https://www.bilibili.com/video/BV1Pdne6xEA6?t=233s) DeepInfer 是首个在发布当天将国产昇腾 950 列为与英伟达 Blackwell 同等优先级一等公民的头部第一方框架。 - [04:35](https://www.bilibili.com/video/BV1Pdne6xEA6?t=275s) 该引擎排他性极强,完全不支持目前市场存量最大的主力数据中心卡 H100、H200 及所有 GeForce 消费卡。 - [04:59](https://www.bilibili.com/video/BV1Pdne6xEA6?t=299s) 同步开源的 deepseek-recipe 是基于 Rust 的协议转接工具,用于将 OpenAI 与 Anthropic API 格式标准化编译为原生 Token 序列。 - [05:34](https://www.bilibili.com/video/BV1Pdne6xEA6?t=334s) 两年间通过 FlashMLA、DeepEP、DuoPipe、3FS、DeepGEMM 及 DSpark 的铺垫,DeepSeek 完成了全球独一份的模型+算子+引擎全栈开源闭环。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1Pdne6xEA6?t=0s) 从零件到总成:DeepInfer 架构与开源保留
10 月 20 日,DeepSeek 再次投下一枚开源重磅炸弹。这次端出来的既不是大模型,也不是底层的独立算子,而是支撑其线上超大规模真实业务运转的整套推理引擎 DeepInfer。项目上线首日狂揽 1.3 万余颗 GitHub Star,官方推特更是用了一句极具气势的总结为发布收尾:“开放的模型,开放的算子,开放的推理。”正如作者所生动比喻的那样:“之前他们开源的都是零件,这一次吊装进场的是整台发动机。”整台引擎提供四大核心功能:基础推理、推测解码、异步调度以及结构化输出。在代码血统上,官方也非常诚实坦白,说明该系统最初主要基于 vLLM 构建,并大量借鉴了 SGLang 与 TensorRT-LLM 的设计思想,采用 Apache 2.0 开源协议。
DeepInfer 在内部装配上清晰划分为三层技术栈。底层是 DeepSeek 团队此前陆续开源的自研高性能算子库,包括 FlashMLA、DeepGEMM 以及负责专家并行的通信库 DeepEP;中层是高度优化的并行策略组合,采用注意力走数据并行(DP)、MoE 走超宽专家并行(EP),单组并行规模最高支持 128 张 GPU;上层则是前面提到的四大推理运行时服务组件。然而,面对开源社区的狂欢,作者给出了十分清醒的警示:“一句话,给的是引擎核心,不是印钞机。”
```mermaid flowchart TD accTitle: DeepInfer 三层架构示意图 accDescr: 展示 DeepInfer 的三层系统架构,包括应用层功能、中间并行策略与底层自研算子库。
subgraph TopLayer["上层:运行时引擎功能"] F1["基础推理"] F2["推测解码 (DSpark)"] F3["异步调度"] F4["结构化输出"] end
subgraph MidLayer["中层:并行策略"] P1["注意力:数据并行 (DP)"] P2["MoE:超宽专家并行 (EP / 最多 128 卡)"] end
subgraph BottomLayer["底层:自研算子库"] O1["FlashMLA"] O2["DeepGEMM"] O3["DeepEP"] end
TopLayer --> MidLayer MidLayer --> BottomLayer ```
- 开源版本目前仅支持 V4.1 Flash 单一模型,并未向下兼容 V3 或其他版本。 - 关键的基础设施耦合层均未对外开放,包括最核心的分布式 KV 缓存系统、预填充(Prefill)与解码(Decode)分离部署机制,以及全局负载均衡调度。 - 开源版本内置算子内核经过评估,性能仍比 DeepSeek 线上内部版本慢 5% 到 10%。
[01:42](https://www.bilibili.com/video/BV1Pdne6xEA6?t=102s) 转速表数据:单集群 155 万亿 Token 与 96% 命中率
官方技术文章中披露的线上生产数据勾勒出了这台引擎的恐怖性能。在 DeepSeek 的单一集群中,每天处理的 Token 总量高达 155 万亿个,折算下来瞬时处理能力约达到每秒 17.9 亿 Token。作为横向对比,谷歌在当年的 I/O 开发者大会上公布的全站月均吞吐量为 3200 万亿 Token,折合每天约 107 万亿。这意味着仅 DeepSeek 这一个集群的日吞吐能力,就比谷歌全站的月均日吞吐量高出了整整四成多。不过作者特别提醒道:“注意口径,这是服务吞吐,含缓存命中的输入 Token,跟谷歌的统计范围也不同,只能比量级。”
在这些庞大数据背后,最关键的效率指标是输入缓存(Prompt Cache)的平均命中率,当前线上已飙升至 96%。这个指标的爬坡历程极为耐人寻味:在 V3 时代,命中率大致在 50% 到 70% 之间摇摆;步入 V4 时代后稳定突破九成出头(约 91%);到了如今配合 DeepInfer 则达到了惊人的 96%。在端到端体验上,首 Token 延迟(TTFT)压到了 400 毫秒,单用户生成速率达到每秒 230 个 Token。此外,文中披露按错峰服务价格折算,每张 GPU 每小时能产生 38 美元的收入,作者犀利指出:“注意是收入不是利润,黑客新闻800多条评论吵的主要就是这个数。”
- 单集群日吞吐达 155 万亿 Token,折合每秒约 17.9 亿 Token。 - 输入缓存平均命中率达 96%(历史走势:V3 时代 50%~70% $\to$ V4 时代 91% 左右 $\to$ 当前 96%)。 - 首 Token 响应延迟为 400ms,单用户文本生成速度达到每秒 230 Token。 - 按错峰调用定价折算,单卡每小时收入为 38 美元(Hacker News 社区争议焦点在于未扣除电力、硬件折旧及网络等成本)。
[02:48](https://www.bilibili.com/video/BV1Pdne6xEA6?t=168s) DSpark 可变截面涡轮:变长推测解码的算力账
DeepInfer 在技术层面最核心的高价值部件,莫过于其推测解码技术 DSpark。推测解码的通用原理是利用轻量级的 MTP(Multi-Token Prediction)小模型一次性猜测预生成 5 个草稿 Token,再由大模型的大脑主干网络进行单次前向并行验证;猜对的直接采纳,猜错的位置推倒重来,由此在保证输出分布完全无损的前提下加速推理。传统的推测解码做法每一步都死板地验证固定的 5 个 Token,而 DSpark 的创新在于引入了“变长验证”:通过给每个草稿 Token 配置一个专属的置信度头,精准预测其被最终接受的概率,再结合系统的全局调度状态动态决定本次究竟提交验证几个 Token。
这项设计的实际测试表现相当微妙。引入置信度头后,系统每一步实际提交验证的 Token 数量从恒定的 5 个大幅下降到 3.2 至 4.4 个,而最终的平均接受长度却几乎没有受到削弱(验证长度下降的同时,接受长度从 3.29 微调到 3.20)。作者对此评价道:“翻译一下,少花约三成验证算力,买到几乎同样的投机收益。”在不同的并发场景下,这项优化表现出截然相反的特性:低并发负载时由于置信度预测带来了轻微额外开销,系统吞吐反而微降了 1.5%;但在高并发吞吐场景下,它能净赚 11% 的吞吐增益,最终折算线上全量真实流量总体提升约 6%。作者特别强调避免概念混淆:“这个6%是系统吞吐,论文里那个85%是同等吞吐下的单用户速度,两个数别混着用。”
- MTP 模块基准预生成 5 个草稿 Token,配合大模型前向并行验证,保证无损分布。 - DSpark 变长验证动态截断验证长度,实际验证数降至 3.2~4.4 个,接受长度维持在 3.20(传统固定验证为 3.29),节省约 30% 验证算力。 - 低并发下系统吞吐亏损 1.5%,高并发下吞吐提升 11%,线上整体吞吐提升 6%。 - 严格区分双重口径:系统级集群总吞吐提升 6%,论文环境在固定吞吐下的单用户响应加速为 85%。
[03:53](https://www.bilibili.com/video/BV1Pdne6xEA6?t=233s) 双旗舰路线:SM100 与昇腾 950 的同等优先级
在底层硬件适配上,DeepInfer 的开源代码释放出了一个极具标志性的行业信号。项目上线第一天就并排提供了两条平级完备的代码路径:英伟达路线直接锚定 Blackwell 架构(SM100 计算能力),要求 CUDA 13 配合 B200 与 GB200 芯片;华为路线则直接适配 CANN 9.2,全力支持最新的昇腾 950 芯片。作者高度评价了这一选择的历史意义:“头部实验室的第一方生产框架,发布当天就把国产芯片当一等公民,这是第一家。”
昇腾 950 芯片于当年 3 月正式推向市场,单卡提供 1.56 PFLOPS 的 FP4 稀疏算力,板载 112GB 自研高带宽显存;而搭载 8192 张卡的 Atlas 950 超节点也计划在第四季度落地进场。针对中美两大旗舰算力平台的并驾齐驱,作者引用了海外技术社区的锐评:“黑客新闻有评论说得直白,等华为开始便宜卖这些卡,对英伟达的下坡路就开始了。”但与此同时,DeepInfer 也呈现出了极为严苛的排他性冷面:框架不仅不支持任何消费级显卡,甚至连市场上保有量最大的主力数据中心显卡 H100 与 H200 也完全不予支持,这也是当前开源社区开发者吐槽最为集中之处。
| 硬件平台 | 软件技术栈要求 | 算力/规格参数 | 架构支持地位 | |:--- |:--- |:--- |:--- | | **英伟达 Blackwell** | CUDA 13,SM100 指令集(B200 / GB200) | 最新 Blackwell 架构计算单元 | 第一方同等优先级支持 | | **华为昇腾 (Ascend)** | CANN 9.2,昇腾 950 芯片 | FP4 算力 1.56 PFLOPS,112GB 自研显存;Atlas 950 规模达 8192 卡 | 第一方同等优先级支持 | | **传统旗舰及消费卡** | H100、H200 及所有 GeForce 消费级显卡 | 市场上保有量巨大的主流 AI 加速芯片 | **完全不支持** |
[04:59](https://www.bilibili.com/video/BV1Pdne6xEA6?t=299s) 协议转接头 deepseek-recipe 与全栈开源闭环
与 DeepInfer 引擎同步发布的还有一个名为 deepseek-recipe 的独立开源组件。这个工具更像是一个高效的协议转换转接头,它的核心定位是向下打通异构生态:将外界广泛使用的 OpenAI Chat Completions、OpenAI Responses 规范以及 Anthropic Messages 协议,无缝统一转译为 DeepSeek 的内部原生对话格式,随后直接编译为输入给模型的 Token 序列。该组件的处理逻辑与 DeepSeek 线上官方 API 保持绝对对齐,底层核心使用 Rust 高性能编写并封装了 Python 绑定,采用更加宽松友好的 MIT 开源许可证。作者给其定性道:“推理,工具执行,HTTP传输都得调用方自己来,它是拼图,不是框架。”
```mermaid flowchart LR accTitle: deepseek-recipe 协议转译流程 accDescr: 展示主流 LLM 外部 API 协议通过 deepseek-recipe 转译为 DeepSeek 原生 Token 的完整链路。
subgraph Inbound["外部协议输入"] O1["OpenAI Chat Completions"] O2["OpenAI Responses"] A1["Anthropic Messages"] end
subgraph Recipe["deepseek-recipe (Rust + Python)"] T1["统一内部对话格式"] T2["对齐官方 API 处理逻辑"] T1 --> T2 end
subgraph Engine["推理系统入口"] TK["模型输入 Tokens"] end
Inbound --> T1 T2 --> TK ```
回溯过去两年的开源路径,DeepSeek 展现出了极其罕见的系统性工程节奏:从最初解决注意力显存瓶颈的 FlashMLA,到打破跨节点专家通信瓶颈的 DeepEP;随后是流水线并行调度工具 DuoPipe 与高性能分布式存储 3FS;再到后来的矩阵乘法库 DeepGEMM 和夏季问世的推测解码算法 DSpark,所有关键模块如同汽车零件一样被依次开源打磨。如今 DeepInfer 的出现,正是把这些零件最终总装成一台完整的工业级发动机交付给业界。结合开源的模型权重与详尽的技术报告,DeepSeek 达成了全球独一份的“模型权重 + 算子实现 + 推理引擎”三层全栈开源闭环。尽管作者最后依然保留了两个冷静审视的视角——核心分布式缓存系统未开放、38 美元仅是营收未计成本,但他断言推理开源的终局方向已经确立,正如 DeepSeek 在发布宣告中所铿锵写就的那样:“开放的模型,开放的算子,开放的推理。”
## Notable quotes > [03:53](https://www.bilibili.com/video/BV1Pdne6xEA6?t=233s) 头部实验室的第一方生产框架,发布当天就把国产芯片当一等公民,这是第一家。 — AI技术投降派
## Mentioned DeepSeek, DeepInfer, deepseek-recipe, DSpark, FlashMLA, DeepGEMM, DeepEP, DuoPipe, 3FS, V4.1 Flash, vLLM, SGLang, TensorRT-LLM, 谷歌, Hacker News, 英伟达, 华为, 昇腾 950, Atlas 950, B200, GB200, H100, H200, CUDA 13, CANN 9.2, OpenAI, Anthropic
## Video description 十月二十日,DeepSeek 又开源了。这回不是模型,不是算子,是撑起它线上服务的整套推理引擎 DeepInfer——开源当天一万三千多颗星,官方收尾一句很有派头:开放的模型,开放的算子,开放的推理。之前开源的都是零件,这次吊装进场的是整台发动机。
它跑出了什么数据?官方技术文章披露:单一集群每天处理一百五十五万亿个 token,折算每秒约十七点九亿——比谷歌全站月均还高四成多(口径不同,只比量级)。输入缓存命中率百分之九十六,爬坡史很能说明问题:V3 时代五到七成,V4 时代九成一,现在九六。首 token 延迟四百毫秒,按错峰价折算每卡每小时收入三十八美元——注意是收入不是利润,黑客新闻八百多条评论吵的就是这个数。
技术上看最值钱的是推测解码这块涡轮:DSpark 变长验证给每个草稿 token 配置信度头,动态决定验几个。效果微妙:每步实际验证从五个降到三点二到四点四个,接受长度几乎不变——少花三成验证算力,买到同样的投机收益。低并发反而亏百分之一点五,高并发赚百分之十一,线上总体提升百分之六(注意:这跟论文里等吞吐下单用户提速百分之八十五是两个口径)。
硬件藏着大信号:开源首日就给 CUDA 13 加 SM100(Blackwell)与 CANN 9.2 加升腾 950 两条完整路径,同等优先级——头部实验室第一方框架发布当天把国产芯片当一等公民,这是第一家。冷面也摆了:开源版只支持 V4.1 Flash 一个模型,KV 缓存、分离部署、负载均衡没给,开源内核比线上慢百分之五到十;H100、H200 和所有消费卡都不支持。同日的 deepseek-recipe 是协议转接头:三种 API 协议统一转换,处理逻辑与官方对齐,但推理、工具、HTTP 都得自备——拼图,不是框架。
判断:两年时间从 FlashMLA 到 DSpark,零件挨个开源,今天交出总成。模型权重加技术报告加推理引擎,三层全栈闭环全世界独一份。两个冷眼:最值钱的缓存系统没在里面;三十八美元是收入,成本账没摊开。
参考:GitHub deepseek-ai/DeepInfer · deployment_qa.md · 知乎官方《DeepSeek V4.1 Flash 大规模推理部署实践》· DSpark 论文(arXiv:2607.05147)· HN 50163277 · Google I/O 2026
时间轴: 00:05 开场:这回开源的不是零件,是引擎 00:38 图纸与真相:三层架构与开源≠完整版 01:42 转速表:155 万亿 token/天与 96% 命中 02:48 DSpark:可变截面涡轮拆解 03:53 双燃料:SM100 与升腾 950 同等优先级 04:59 deepseek-recipe:协议转接头 05:34 收官:从零件到总成
[Source](https://www.bilibili.com/video/BV1Pdne6xEA6)