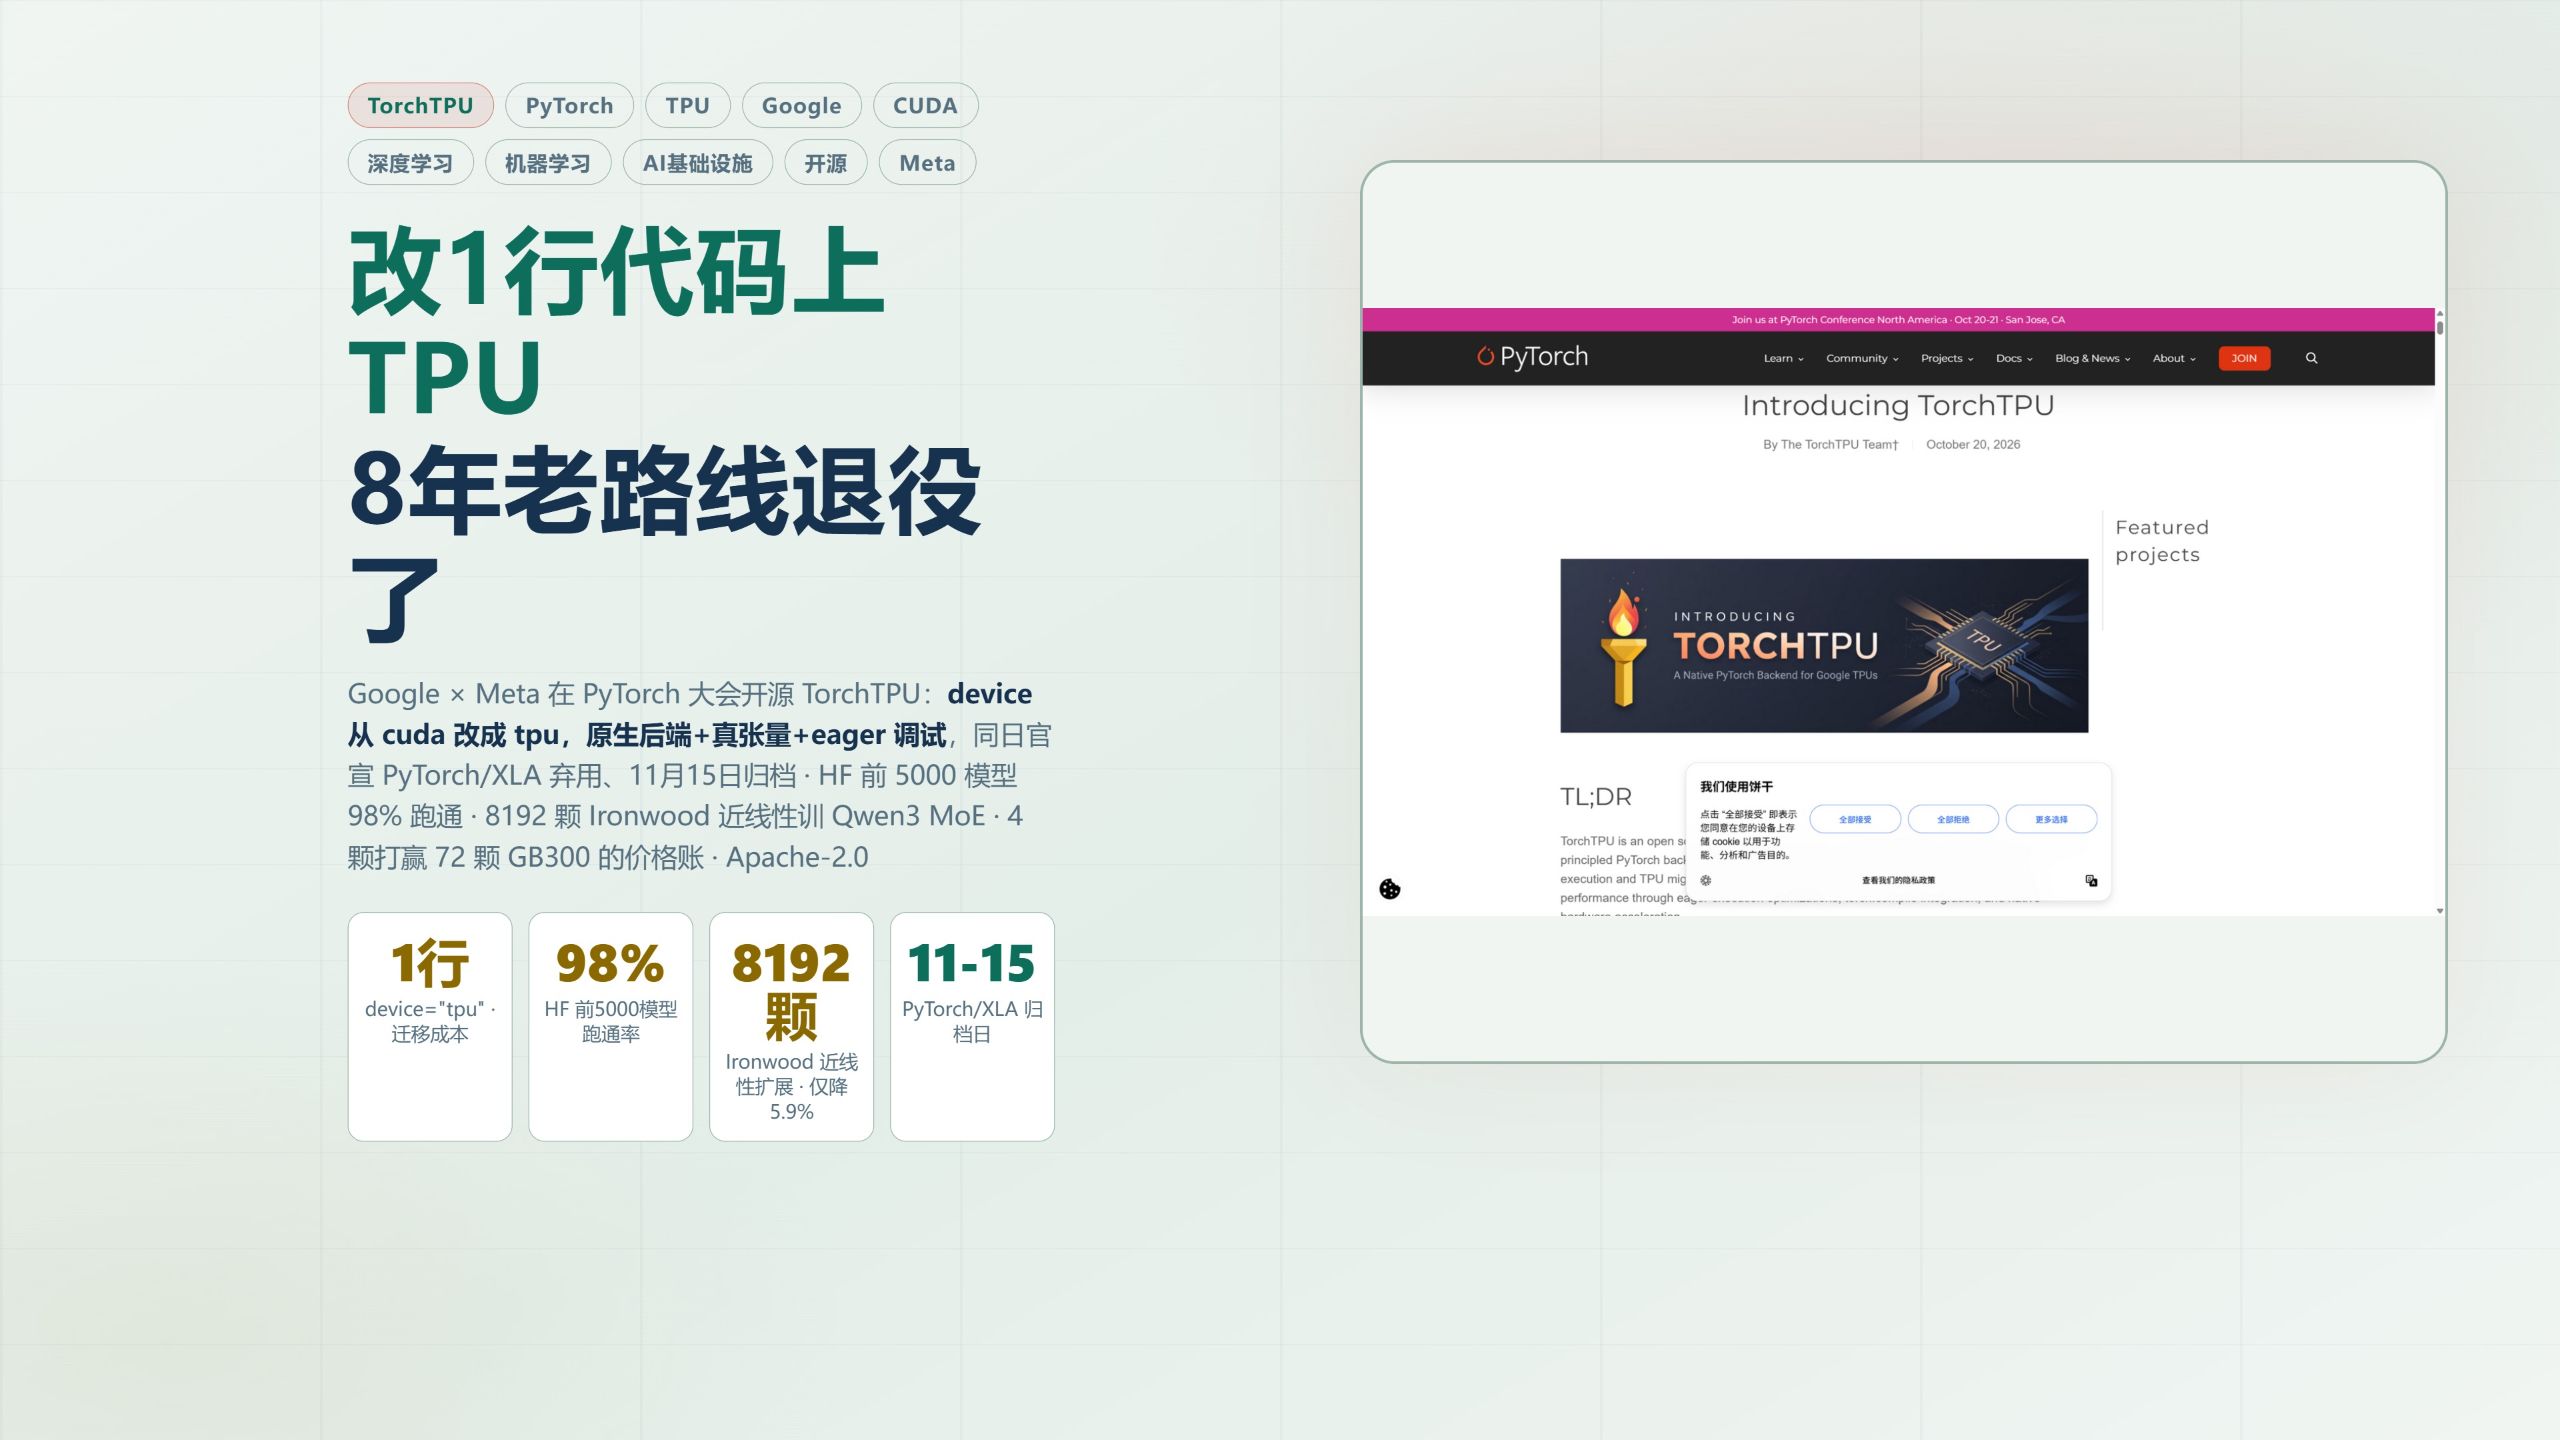
谷歌联手Meta开源TorchTPU 废弃八年旧架构直攻英伟达生态
AI技术投降派
TorchTPU通过极简代码迁移抹平了跨芯片软件摩擦,将AI算力竞争拉回纯粹的性价比对决,但CUDA积淀二十年的底层工程生态仍非一次开源所能轻易撼动。
AI-assisted summary of 改1行代码上TPU,谷歌8年老路线退役了 — original source. Check the original for full context.
Source published:
Key ideas
- Google 联手 Meta 正式开源 TorchTPU 并宣布弃用历经八年的 PyTorch/XLA,老仓库定于 11 月 15 日归档,仅留四周迁移窗口。 (0:00)
- TorchTPU 采用 C++ 原生后端并提供四档执行模式,官方实测 Hugging Face 前 5000 模型有 98% 可跑通、97% 与 GPU 数值对齐,代码迁移通常仅需修改设备与分布式通信两处字符串。 (1:50)
- 在大规模训练实测中,8192 颗 Ironwood TPU 训练 Qwen3 MoE 的单核算力仅下降 5.9%,64 卡规模下 PyTorch 路径吞吐量与 Google 亲儿子 JAX 仅差 6%。 (4:16)
- SemiAnalysis 独立测试显示 4 颗 Ironwood 在推理场景每美元性能胜过 72 颗 GB300 整机,训练场景单位 Token 产出成本比 B200 便宜约 50%。 (5:02)
- 尽管软件迁移摩擦被大幅降低,开发者仍面临获取门槛高(中小团队难买到)、默认利用率仅约 30% 需重写 Pallas 内核,以及追赶 CUDA 二十年生态积累等现实挑战。 (6:01)
Detailed notes
## Background 该内容由 B站 UP 主“AI技术投降派”于 2026 年 10 月 22 日发布。视频简介指出,Google 与 Meta 在 PyTorch 大会上联合开源了 TorchTPU,并正式弃用归档运营八年的 PyTorch/XLA 项目,旨在推倒过去痛点丛生的旧路线,通过极低代码修改成本在 TPU 上架设直连 PyTorch 的新桥梁。
## TL;DR Google 联手 Meta 彻底推翻了深陷无 Eager 模式与反复重编译泥潭的 PyTorch/XLA 架构,推出基于 C++ 原生扩展槽位的 TorchTPU,使开发者仅需修改两处字符串即可迁移。经实测,HuggingFace 前 5000 个模型中有 98% 能稳定跑通,并在 8192 颗 Ironwood 集群训练 Qwen3 MoE 时展现出近线性扩展能力,性能紧咬自家 JAX 框架。随着 AWS 与 Google 相继推动 PyTorch 原生化,AI 芯片竞争逐步演变为每美元 Token 产出的底层性价比比拼。然而,面对 TPU 的租用门槛、Google 项目烂尾的历史顾虑以及 CUDA 二十年软硬件生态的深厚积淀,迁移大桥虽已合龙,工程抉择仍需审慎权衡。
## Atmosphere & style 全片解说语速紧凑、风格硬核且充满工程师式的辛辣幽默,将复杂的编译器转译与巨头商战拆解得生动透彻。叙事从开发者饱受旧架构“八小时无声挂起”折磨的痛点切入,随后以极具冲击力的测试数据展现新桥合龙的技术快感,情绪跌宕起伏。后半段话锋一转泼下“三盆冷水”,冷峻剖析真实算力账本与生态差距,让整场分享既有推倒旧世界的技术快意,又洋溢着资深从业者冷静客观的行业清醒感。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1NMnC6JEag?t=0s) Google 联手 Meta 正式开源 TorchTPU 并宣布弃用历经八年的 PyTorch/XLA,老仓库定于 11 月 15 日归档,仅留四周迁移窗口。 - [01:50](https://www.bilibili.com/video/BV1NMnC6JEag?t=110s) TorchTPU 采用 C++ 原生后端并提供四档执行模式,官方实测 Hugging Face 前 5000 模型有 98% 可跑通、97% 与 GPU 数值对齐,代码迁移通常仅需修改设备与分布式通信两处字符串。 - [04:16](https://www.bilibili.com/video/BV1NMnC6JEag?t=256s) 在大规模训练实测中,8192 颗 Ironwood TPU 训练 Qwen3 MoE 的单核算力仅下降 5.9%,64 卡规模下 PyTorch 路径吞吐量与 Google 亲儿子 JAX 仅差 6%。 - [05:02](https://www.bilibili.com/video/BV1NMnC6JEag?t=302s) SemiAnalysis 独立测试显示 4 颗 Ironwood 在推理场景每美元性能胜过 72 颗 GB300 整机,训练场景单位 Token 产出成本比 B200 便宜约 50%。 - [06:01](https://www.bilibili.com/video/BV1NMnC6JEag?t=361s) 尽管软件迁移摩擦被大幅降低,开发者仍面临获取门槛高(中小团队难买到)、默认利用率仅约 30% 需重写 Pallas 内核,以及追赶 CUDA 二十年生态积累等现实挑战。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1NMnC6JEag?t=0s) 八年路线彻底推倒:Google 官方直面 PyTorch/XLA 缺乏 Eager 模式、改形状触发重编及无声挂起等痛点,正式弃用老旧图捕获与 torchax 折中方案。 - [01:50](https://www.bilibili.com/video/BV1NMnC6JEag?t=110s) 硬件一等公民定位:TorchTPU 使用 C++ 挂载进 PyTorch 原生硬件扩展槽位,使用户直接操作真实 torch.Tensor,彻底告别封装壳子式的 Lazy Tensor。 - [01:50](https://www.bilibili.com/video/BV1NMnC6JEag?t=110s) 四档细分执行模式:新架构同时提供严格 Eager、带越界检查的同步 Eager、延迟与融合模式(比纯 Eager 快 50% 以上)以及整图编译模式,平衡开发排错与峰值性能。 - [03:01](https://www.bilibili.com/video/BV1NMnC6JEag?t=181s) 极低的基础迁移成本:常规脚本仅需将设备改为 tpu、通信后端改为 tpu_dist,主流基础设施如 vLLM、SGLang、TorchTitan 与 Ray 均已完成初步支持。 - [03:01](https://www.bilibili.com/video/BV1NMnC6JEag?t=181s) 峰值性能仍需手工打磨:开箱即用的代码往往只有约 30% MFU,想要拉升至 50% 以上仍需精细重写 Pallas 内核与分片方案,“改一行能跑”并不等同于“跑满硬件”。 - [04:16](https://www.bilibili.com/video/BV1NMnC6JEag?t=256s) 大规模扩展力得到验证:在 2350 亿参数 Qwen3 MoE 训练中,从 1024 扩展至 8192 颗 Ironwood 芯片仅衰减 5.9% 单核算力,展现强悍的近线性扩展特征。 - [04:16](https://www.bilibili.com/video/BV1NMnC6JEag?t=256s) 打破 JAX 框架特权:在 64 颗芯片的同等规模下,PyTorch 吞吐量达到 1828,与 JAX 原生基线的 1937 仅相差 6%,抹平了两大框架在 TPU 上的鸿沟。 - [05:02](https://www.bilibili.com/video/BV1NMnC6JEag?t=302s) AI 框架中立化大势所趋:继 AWS 为 Trainium 推出 Torch Neuron 后,Google 原生支持 TorchTPU,倒逼竞争回到底层芯片的纯粹算力与价格战。 - [05:02](https://www.bilibili.com/video/BV1NMnC6JEag?t=302s) 算力账本逻辑重构:虽然训练芯片单价租金高于 H100,但在计算“每美元产出 Token 数”时,Ironwood 比英伟达 B200 便宜约 50%,推理效费比打赢 GB300 整机。 - [06:01](https://www.bilibili.com/video/BV1NMnC6JEag?t=361s) 云厂商与框架巨头的商业合谋:Google 靠 TPU 出售云算力锁定千亿美元级大客户,Meta 出资深工程师参与核心开发并用业务背书,PyTorch 借此摆脱“CUDA 高级封装”标签。 - [06:52](https://www.bilibili.com/video/BV1NMnC6JEag?t=412s) 获取门槛依然极高:TPU 依然不对外零售裸机,资源高度倾斜于 Anthropic 等头部巨擘,对于普通中小开发者而言依然如同难以触及的 Unobtainium。 - [06:52](https://www.bilibili.com/video/BV1NMnC6JEag?t=412s) 历史公墓记忆引发顾虑:Google 历史上如 Coral 边缘芯片烂尾的砍项目习惯,使部分开发者对官方长期维护投入心存芥蒂,且四周的老架构归档周期极为仓促。 - [07:42](https://www.bilibili.com/video/BV1NMnC6JEag?t=462s) 跨生态桥梁合龙:TorchTPU 磨平了代码跨硬件迁移的一半软件阻力,但 CUDA 积累二十年的工程工具链与社区认知惯性,仍需全行业长期博弈。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1NMnC6JEag?t=0s) 图纸封面:同日双官宣与八年旧路推倒
在 10 月 20 日的 PyTorch 大会上,Google 和 Meta 联手开源了名为 TorchTPU 的全新项目。与此同时,官方还同步发布了另一条重磅通知:历经八年的老项目 PyTorch/XLA 正式弃用,代码仓库将于 11 月 15 日归档。官方以极其罕见的直接姿态向开发者承认,过去在 TPU 上跑 PyTorch 的方案修得不好,如今选择彻底推倒重来。针对这场软硬件生态的大地震,分析师给出了精准的评价:“CUDA 的护城河是真的,但护城河可以架桥。”
回顾旧路,PyTorch/XLA 诞生于 2018 年前后,核心思路是将 PyTorch 程序截取成计算图,再交由 XLA 编译器执行。这套设计给实际工程带来了极其痛苦的使用体验:图捕获必须手动圈定编译区域,张量形状稍微一改就会触发耗时的重新编译;调试时,开发者看到的报错信息隔着一层厚重的编译器,完全丧失了逐行排错的能力。而在 GPU 上习以为常的 Eager 模式在 TPU 上彻底缺席,导致开发调试几乎盲盒化。后来 Google 曾推出过折中方案 torchax,尝试将 PyTorch 塞进 JAX 的运行模式中,但折腾了整整两年,官方博客如今用“硬塞”二字自嘲,正式承认此路不通。
> “一堆没有文档的行为和 bug,训练 8 小时后无声挂起。” —— Reddit 用户对 PyTorch/XLA 的真实吐槽
```mermaid flowchart LR accTitle: PyTorch TPU 架构演进对比 accDescr: 展示从旧版 PyTorch XLA 硬塞模式到新版 TorchTPU 原生后端的演进差异
subgraph Old["旧架构:PyTorch/XLA & torchax"] direction TB O1["PyTorch 代码"] --> O2["手动圈定图捕获 / torchax 硬塞 JAX"] O2 --> O3["XLA 编译器(改形状即重编/无 Eager)"] O3 --> O4["TPU 硬件(调试黑盒)"] end
subgraph New["新架构:TorchTPU"] direction TB N1["PyTorch 代码"] --> N2["C++ 原生后端(扩展槽位一等公民)"] N2 --> N3["四档执行模式(支持纯 Eager 与融合)"] N3 --> N4["StableHLO / XLA"] --> N5["TPU 硬件"] end ```
[01:50](https://www.bilibili.com/video/BV1NMnC6JEag?t=110s) 新桥结构:原生后端、四档执行与前端契约
全新的 TorchTPU 采取了彻底相反的路线——不再将框架硬塞进外部运行时,而是把 TPU 直接打造成 PyTorch 的“一等公民”。新架设的技术桥梁主要包含三大支柱:
1. **原生后端注册机制**:TorchTPU 使用 C++ 编写,直接挂载进 PyTorch 调度器专门预留的硬件扩展槽位中。开发者在运行环境完成 `pip install` 后,只需 `import torch`,TPU 便立刻作为原生设备注册生效。开发者手中操作的张量是真实的 `torch.Tensor`,而非被套上多层壳子的延迟张量(Lazy Tensor)。 2. **细分的四档执行模式**: - *严格 Eager 模式*:默认档位,逐条算子单步执行,提供与 GPU Eager 完全一致的开发体验,支持断点调试与逐行打印排错; - *带越界检查的同步 Eager 模式*:强化调试安全,实时捕获显存与边界异常; - *延迟与融合模式(Defer and Fuse)*:官方独创方案,先将算子攒起来,直到遇到必须物化数据的节点时,才将一整段算子融合成大计算图并编译,官方实测速度比纯 Eager 模式快 50% 以上; - *整图编译模式(`torch.compile`)*:依靠整图全优化压榨 TPU 的峰值算力。 3. **真实的前端契约**:必须承认的是,TorchTPU 底层最终依然调用 XLA 编译器并转译成 StableHLO 再交由硬件执行。但本质区别在于前端体验的重构,开发者面对的是一个规范本分的 PyTorch 接口,而不是一个披着 PyTorch 外皮的别扭图捕获器。
[03:01](https://www.bilibili.com/video/BV1NMnC6JEag?t=181s) 迁移说明与真实生态:改两处字符串后的现实
从工程迁移成本来看,官方号称开发者通常只需要改动两处字符串配置:一是将运行设备由 `cuda` 改为 `tpu`,二是将分布式通信后端从 `nccl` 改为 `tpu_dist`。为了自证这一断言,团队将 Hugging Face 上下载量排名前 5000 的模型全部拉取进行了全量测试,结果表现出惊人的兼容性:在 4917 个模型上实现了端到端运行,98% 能够稳定跑通不发生崩溃;在抽检的模型中,更有 97% 的数值输出与 GPU 上的结果严格对齐。
围绕大模型的基础设施生态也在同步铺开: - **推理与服务框架**:vLLM 与 SGLang 均已上线官方适配插件; - **训练与编排基建**:大模型训练框架 TorchTitan 拥有 Google 维护的专属分支,Ray 原生编排已直接支持,Meta 旗下的推荐系统库 TorchRec 更是直接合并进了上游主线。
然而,社区对此保持着清醒的克制。开源社区的一句锐评一针见血:“宣传语是‘改一行就能跑’,不是‘改一行就能跑到峰值’。”仅仅替换两行代码上机,模型的模型算力利用率(MFU)通常只有 30% 左右;想要将利用率拉升至 50% 以上,开发者依然必须手动改写 Pallas 内核、重新精细设计数据分片方案。脏活累活并没有凭空消失,只是从“改底层框架代码”转移成了“调系统优化配方”。此外,对于庞大的老版本 XLA 用户群而言,代码归档只给出了四周的迁移窗口,不少开发者直言这个时间表未免过于紧迫苛刻。
[04:16](https://www.bilibili.com/video/BV1NMnC6JEag?t=256s) 承重检验:8192 颗芯片近线性扩展与亲儿子对决
针对 TorchTPU 的高并发承载能力,Google 进行了大规模工业级检验。他们使用 TorchTitan 训练链路,在 Ironwood TPU 集群上跑了 2350 亿参数的 Qwen3 MoE 模型。芯片规模从 1024 颗一路扩展到 8192 颗后,单核算力相比千卡规模仅下降了 5.9%,表现出极其强悍的近线性扩展能力,在训练中实现了每步耗时 31 秒即可吞下 26 万条样本。
同篇官方博客中还暗藏了一场耐人寻味的内部正面对决:在 64 颗芯片的同等规模下,运行 PyTorch 路径的实测吞吐量达到了 1828,而 Google 自家享有“亲儿子”待遇的 JAX 吞吐量为 1937,两者性能差距仅有微弱的 6%。这个成绩单传达出的信号非常明确:PyTorch 路径在 TPU 上的效率,已经无限逼近 Google 倾注多年心血的原生编译器与框架,两者已完全具备了同台叫板的实力。
[05:02](https://www.bilibili.com/video/BV1NMnC6JEag?t=302s) 大棋盘与算力账本:框架中立化与每美元性能
把 TorchTPU 放到整个行业的棋盘来看,开源前一天,亚马逊(AWS)刚刚发布了 Torch Neuron,同样为其自研的 Trainium 芯片推出了原生 PyTorch 支持。两大云巨头在定制 AI 硬件上前后脚将 PyTorch 深度原生化,其背后的深层含义不言自明——底层框架层正在被迫走向中立,AI 芯片的竞争彻底退回到了最底层的纯粹性能与价格较量。
根据第三方分析机构 SemiAnalysis 的独立测试,在推理场景下,4 颗 Ironwood 在每美元性能指标上打赢了由 72 颗 GB300 组成的顶级机柜整机。在 Ironwood 上,生成每百万 Token 的成本在六周前是 3.6 美元,随后快速压低至 2.01 美元,对于代理(Agent)类复杂工作负载甚至可进一步压缩至 0.83 美元。虽然训练端的 Ironwood 单芯片租用价格高达每小时 12 美元(裸价比英伟达 H100 贵出近 5 倍),但由于硬件密度和专属吞吐极高,必须算“每美元产出的 Token 数”;按照这一效费比口径核算,Ironwood 比英伟达 B200 便宜约 50%,比 B300 便宜近一倍。
| 芯片 / 集群方案 | 成本/计费逻辑 | 核心性价比对比(每美元 Token 产出) | 适用场景 | |:--- |:--- |:--- |:--- | | **4 颗 Ironwood** | 推理每百万 Token 成本跌至 2.01 美元(代理负载 0.83 美元) | **性能打赢 72 颗 GB300 整机** | 工业级推理与智能体服务 | | **Ironwood(训练集群)** | 租用价单芯片 $12/小时(裸机价为 H100 的 5 倍) | **比 B200 便宜约 50%,比 B300 便宜近 1 倍** | 超大规模分布式训练(如 Qwen3 MoE) | | **NVIDIA B200 / B300 / GB300** | 依托成熟 CUDA 生态,高溢价整机方案 | 算力绝对值顶尖,但单位算力采购与租用成本更高 | 通用大模型训练与全栈研发 |
[06:01](https://www.bilibili.com/video/BV1NMnC6JEag?t=361s) 三方账本与三盆冷水:商业博弈、坟场记忆与十年差距
在这场软硬件重构的盛宴背后,各方势力打着清晰的算盘: - **Google 出钱与算力**:TPU 从来不对外零售裸片,只作为 Google Cloud 上的算力时间售卖。目前 Anthropic 已签署了高达 100 万颗 TPU 的算力协议,交易规模跨入千亿美元量级;Meta 同样签下了数十亿美元的算力采购大单。 - **Meta 出人力与生态标准**:开源项目核心开发名单中坐满了 Meta 的资深工程师。Meta 内部的 TorchRec 推荐系统在 TPU 上测出的性能与 Google 内部的 JAX 基线达成 1:1 持平,相当于用真实业务为 TPU 的 PyTorch 性能背书。 - **PyTorch 确立独立地位**:PyTorch 迫切需要向全行业证明,自己是一个平台级的底层计算调度中心,而不仅仅是 CUDA 的一个高级前端封装。 - **英伟达面临百亿防守**:英伟达手握年入 1900 多亿美元的数据中心基本盘,是整套架构变革试图撬动与挑战的目标。
> “英伟达比任何对手都领先十年,去看看 GB300。” —— Hacker News 元老级评论者的尖锐断言
尽管前景诱人,现场依然被浇下了“三盆冷水”: 1. **获取门槛宛如 Unobtainium**:对普通中小开发者而言,TPU 依旧像科幻片里的虚构矿物“Unobtainium”一样遥不可及。想用只能按需向 Google Cloud 租用昂贵的机器,有资格直接大批量部署的只有 Anthropic 这个量级的巨无霸客户。 2. **Google 挥之不去的项目“公墓”**:社区迅速翻出了 Google 经常砍项目的黑历史。当年号称边缘 TPU 的 Google Coral 开发板曾被寄予厚望,最终难逃烂尾命运。社区甚至有刻薄的讽刺:“你见过跑在 Coral 上的软件吗?没有,但我见过那个项目盖的房子真不错。” 3. **开放接口绝不等同于生态对等**:CUDA 过去二十年积淀下的软硬件护城河——从底层硬件算子内核库、专有硬件性能调试器,到覆盖全面的中间件工具链——绝非一次激进的代码开源就能抹平。
[07:42](https://www.bilibili.com/video/BV1NMnC6JEag?t=462s) 竣工合龙:移平代码摩擦,过不过桥由你定
TorchTPU 的这次开源所带来的实际改变,远比喊出“颠覆英伟达”更贴近工程现实。它真正做到的,是将阻碍跨芯片生态迁移的代码摩擦成本彻底抹掉了一半,让企业在选型硬件时,能够真正越过软件栈鸿沟,直面底层算力的纯粹性价比;至于剩下的那一半护城河,是 CUDA 耗时二十年建立的坚固工程经验与社区惯性,仍然需要整个行业花费数年时间慢慢磨平。
> “Google 上次开源搬运的是 Kubernetes 的方法论,这次搬的是你的 `model.to`。”
对于一线算法与工程人员来说,这一变化的实际映射非常具象:下一次启动新模型项目时,尝试将脚本里 `device` 的那行字符串从 `cuda` 改为 `tpu`,最终算出来的算力财务账本就可能迎来翻天覆地的变化。工程图纸已经公之于众,崭新的大桥也已合龙竣工,桥面上明晃晃地写着“一行代码”,至于要不要迈步过桥,选择权已经交到了每一个工程师的手中。
## Notable quotes > [00:00](https://www.bilibili.com/video/BV1NMnC6JEag?t=0s) CUDA 的护城河是真的,但护城河可以架桥。 — 分析师
> [03:01](https://www.bilibili.com/video/BV1NMnC6JEag?t=181s) 宣传语是‘改一行就能跑’,不是‘改一行就能跑到峰值’。 — 开源社区
> [06:01](https://www.bilibili.com/video/BV1NMnC6JEag?t=361s) 英伟达比任何对手都领先十年,去看看 GB300。 — Hacker News 元老级评论者
## Mentioned Google, Meta, TorchTPU, PyTorch/XLA, torchax, JAX, CUDA, PyTorch, StableHLO, XLA, Hugging Face, vLLM, SGLang, TorchTitan, Ray, TorchRec, Pallas, Ironwood, Qwen3 MoE, 亚马逊 (AWS), Torch Neuron, Trainium, SemiAnalysis, GB300, H100, B200, B300, Anthropic, Google Cloud, Google Coral, Kubernetes
## Video description 10月20日 PyTorch 大会,Google 和 Meta 联手开源了 TorchTPU,同时发了另一条通知:老项目 PyTorch/XLA 正式弃用,仓库11月15日归档。八年路线,一夜翻篇。官方自己承认,过去在 TPU 上跑 PyTorch 的那条路修得不好,现在推倒重修了一条。有分析师给这件事下了个注脚:CUDA 的护城河是真的,但护城河可以架桥。
旧路的痛点用过的都懂:图捕获要手动圈编译区,改一次形状重编译一次,最熬人的是没有 eager 模式,GPU 上习以为常的逐行排错在 TPU 上不存在。有用户的原话是"一堆没有文档的行为和 bug,训练八小时后无声挂起"。折衷方案 torchax 把 PyTorch 硬塞进 JAX 的模式,塞了两年,官方承认不合适。
00:05 图纸封面:同日双官宣 00:47 旧路验收:八年三宗罪 01:50 新桥结构:原生后端+四档执行 03:01 迁移说明:改两处字符串 04:16 承重检验:8192颗近线性 05:02 大棋盘:亚马逊谷歌前后脚 06:01 三方账本:谁出钱谁出框架 06:52 三盆冷水:难得、坟场、十年差距 07:42 竣工合龙:过不过桥你自己定
新桥的迁移成本低到什么程度:device 从 cuda 改成 tpu,分布式后端从 nccl 改成 tpu_dist,就这两处。HuggingFace 前 5000 模型实测 98% 跑通、97% 与 GPU 数值对齐,vLLM/SGLang/TorchTitan/Ray 全家桶配齐。承重检验也过了:8192 颗 Ironwood 训 Qwen3 MoE,单核算力只降 5.9%,与 Google 自家 JAX 差 6%。价格账上,第三方测出 4 颗 Ironwood 在每美元性能打赢 72 颗 GB300 整机。冷水照泼:TPU 对普通人是 unobtanium、Google 有座著名的坟场、CUDA 二十年生态不是一次开源能追平的。至于老 XLA 用户,归档只给四周窗口。
Google 上次开源搬的是 Kubernetes 的方法论,这次搬的是你的 model.to。
仓库:github.com/google-pytorch/torch_tpu 官方博客:pytorch.org/blog/introducing-torchtpu
[Source](https://www.bilibili.com/video/BV1NMnC6JEag)