让AI审计代码:Cloudflare的2.6万星技能
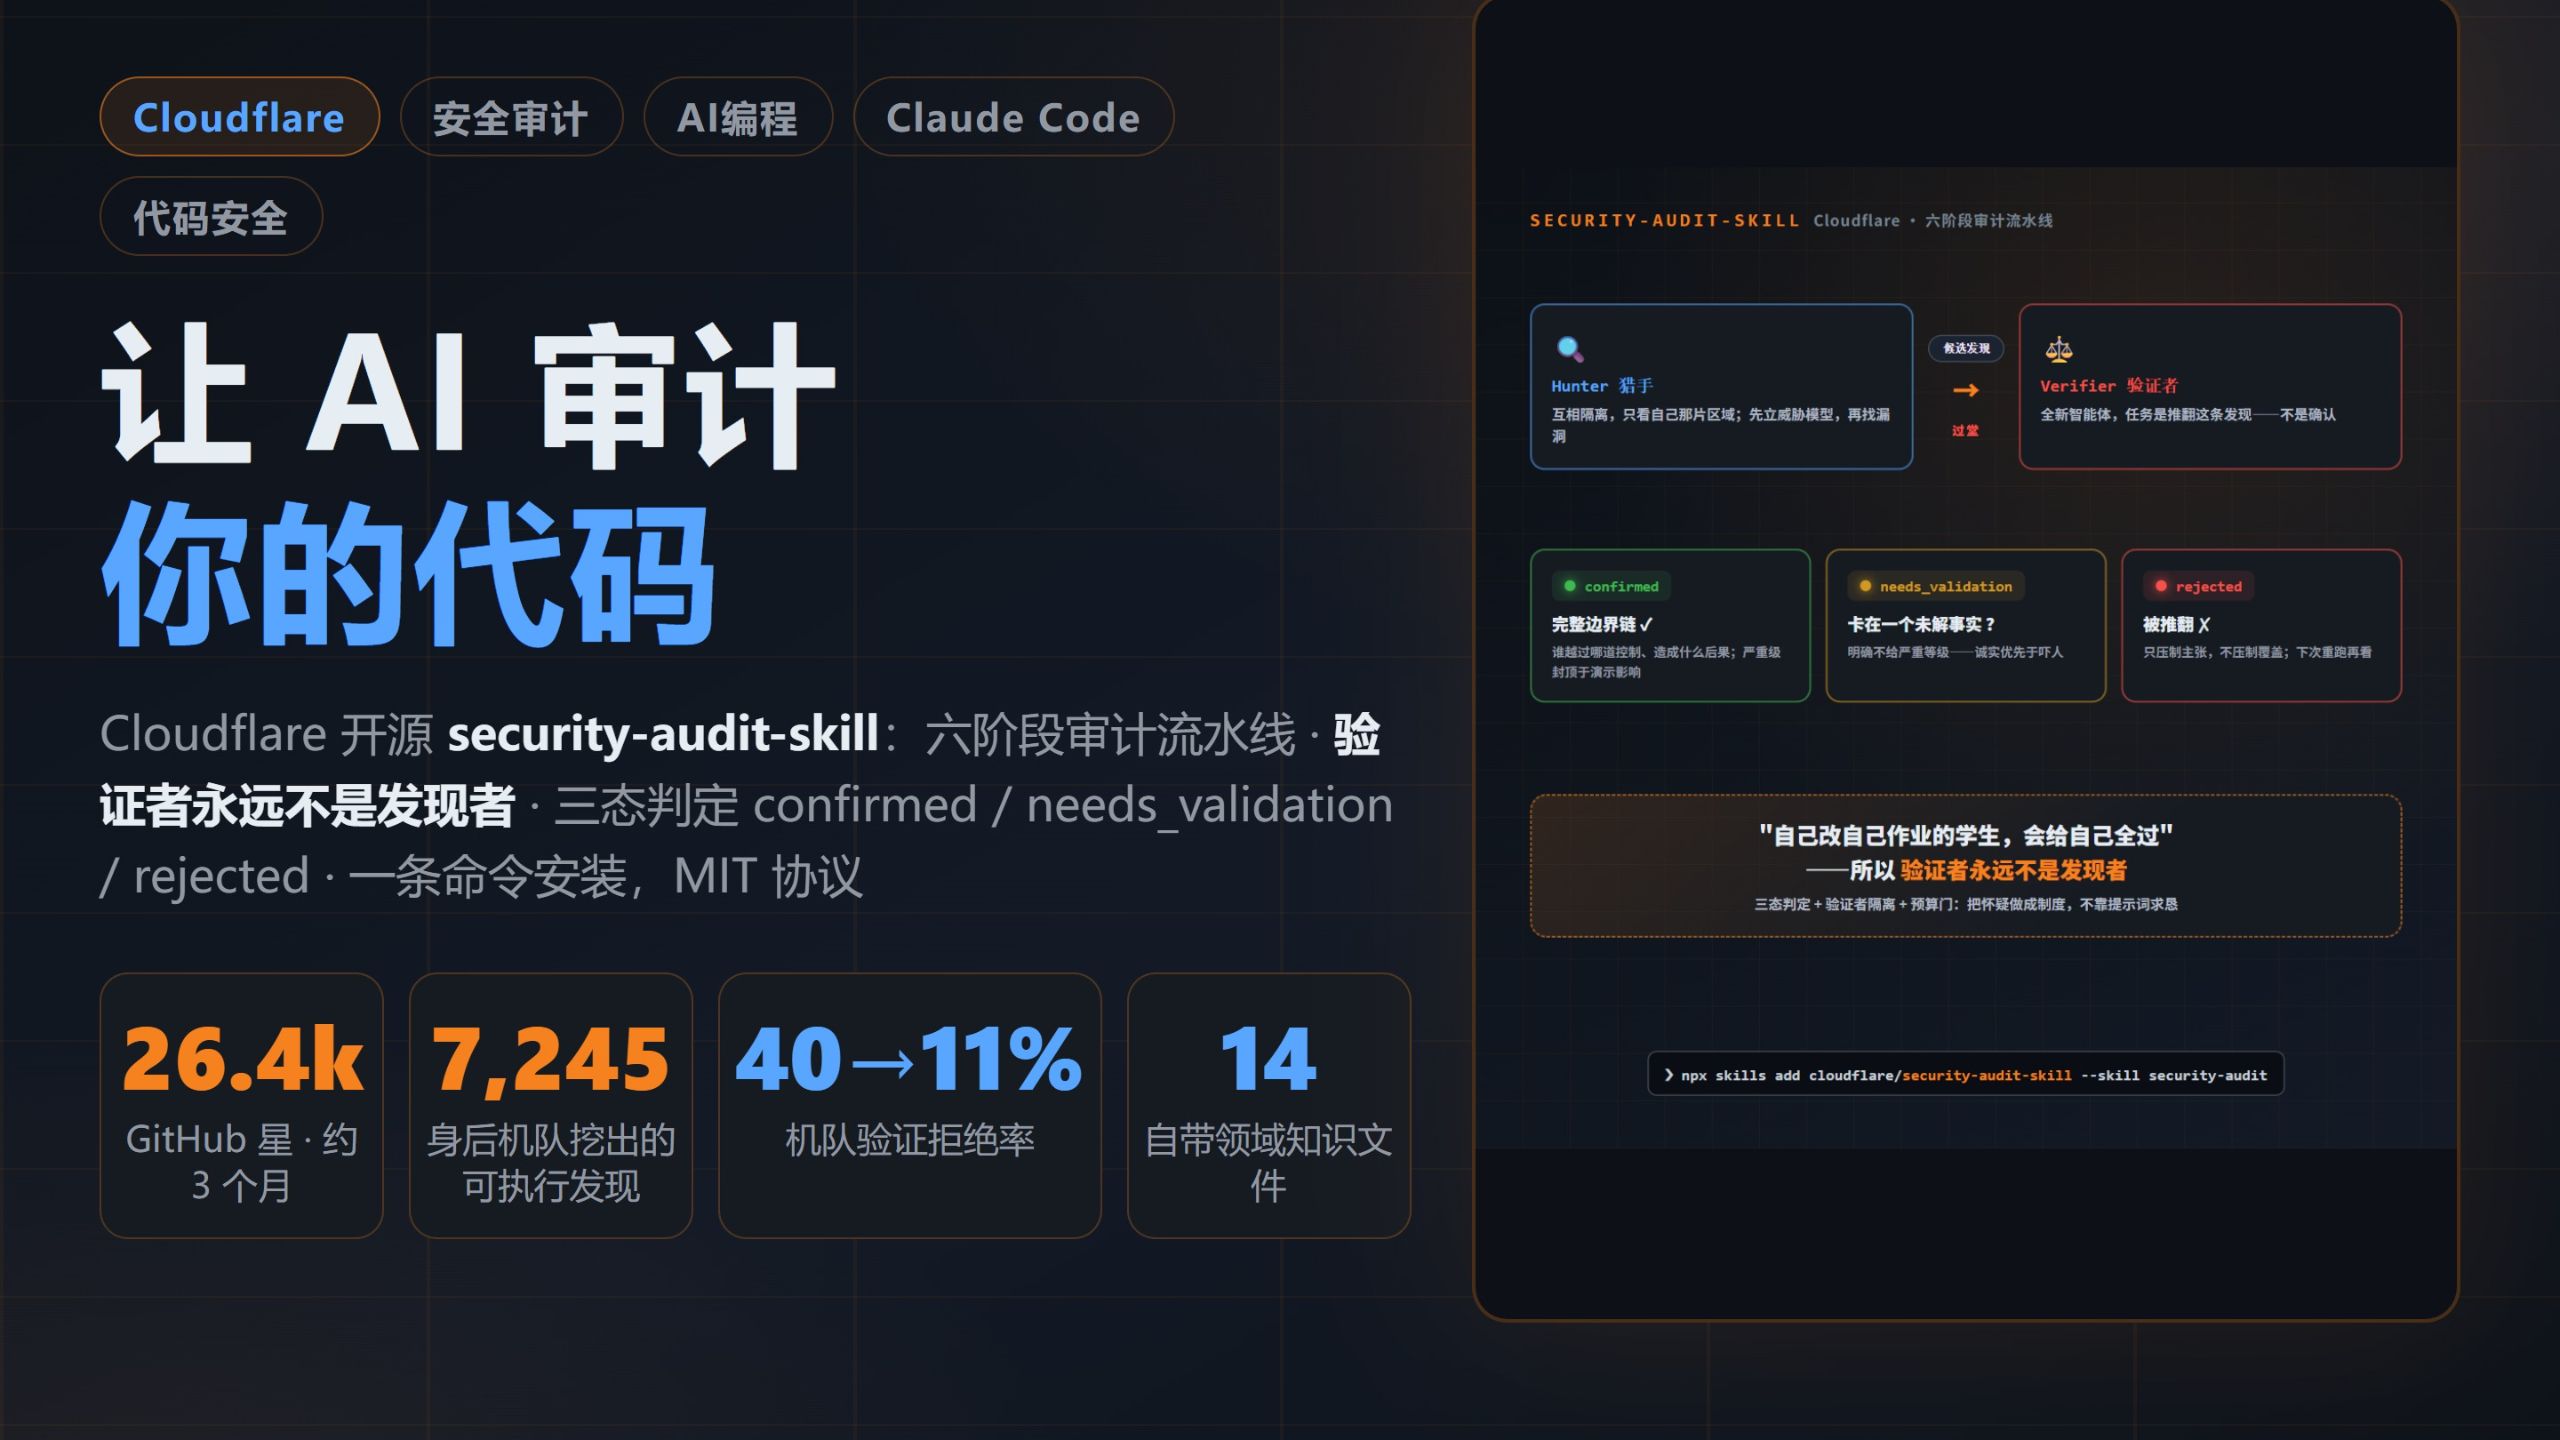
AI技术投降派
AI-assisted summary of 让AI审计代码:Cloudflare的2.6万星技能 — original source. Check the original for full context.
Source published:
Key ideas
- Cloudflare 开源了针对编码智能体的 security-audit-skill 技能包,通过建立六阶段流水线与隔离的对抗性验证机制,从流程底层遏制 AI 代码审计中的高假阳性问题。 (0:00)
- 流水线废除传统的二元判断,引入由 confirmed、needs_validation 与 rejected 构成的三态判定体系,要求确认漏洞必须具备闭合的因果边界链,且严重等级严格封顶于实际演示的影响。 (2:50)
- 该技能包脱胎于 Glasswing 内部项目,后续演化为覆盖 128 个仓库、6 种语言的自动化机队,最终在 20,799 条候选发现中沉淀出 7,245 条可执行漏洞,将验证拒绝率从 40% 压缩至 11%。 (4:22)
- 开源的 450 行技能文件不等同于工业级机队,实际落地高度依赖并行子代理调度与操作系统级沙箱支持;官方明确承认单次运行仅能找到重复运行总漏洞量的大约一半,主张将安全审计构建为持续迭代的加法体系。 (6:05)
Detailed notes
## Background 该视频由哔哩哔哩 UP 主“AI技术投降派”于 2026 年 10 月 23 日发布。视频围绕 Cloudflare 开源并斩获 2.6 万 Star 的安全技能包 security-audit-skill 展开,深入剖析其如何借助对抗性验证与严密流程来遏制 AI 代码审计中的假阳性难题。
## TL;DR 视频系统解析了 Cloudflare 开源的 security-audit-skill 及其六阶段安全审计流水线。该工具通过将审计面切分为覆盖账本、隔离狩猎智能体,并在核心第三阶段引入全新的对抗验证智能体来专门推翻漏洞假设,从流程上杜绝“自己改作业”带来的假阳性。配合严苛的三态判定(confirmed、needs_validation、rejected)与无沙箱不执行等硬性铁律,它成功将验证拒绝率压低至 11%。最后,主讲人结合其前身 Glasswing 机队的实战战绩,警示开发者不要将 450 行技能文件误当做成熟工业机队,并指出安全审计的本质是承认单次局限的“加法数学”。
## Atmosphere & style 全片充盈着冷静、克制而又极其敏锐的硬核工程思辨氛围。主讲人语调沉着、条理清晰,摒弃了对 AI 技术的盲目神化,反而用“自己改作业的学生会给自己全过”等生动比喻直击大模型自省能力的软肋。在列举实战亮眼数据的同时,主讲人毫不客气地适时浇下一盆理性的冷水,既剖析制度化对抗验证的美感,又直面算力环境与工程落地的残酷差距,带给观众极强的警醒感与工业级工程启迪。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1umpx62EcC?t=0s) Cloudflare 开源了针对编码智能体的 security-audit-skill 技能包,通过建立六阶段流水线与隔离的对抗性验证机制,从流程底层遏制 AI 代码审计中的高假阳性问题。 - [02:50](https://www.bilibili.com/video/BV1umpx62EcC?t=170s) 流水线废除传统的二元判断,引入由 confirmed、needs_validation 与 rejected 构成的三态判定体系,要求确认漏洞必须具备闭合的因果边界链,且严重等级严格封顶于实际演示的影响。 - [04:22](https://www.bilibili.com/video/BV1umpx62EcC?t=262s) 该技能包脱胎于 Glasswing 内部项目,后续演化为覆盖 128 个仓库、6 种语言的自动化机队,最终在 20,799 条候选发现中沉淀出 7,245 条可执行漏洞,将验证拒绝率从 40% 压缩至 11%。 - [06:05](https://www.bilibili.com/video/BV1umpx62EcC?t=365s) 开源的 450 行技能文件不等同于工业级机队,实际落地高度依赖并行子代理调度与操作系统级沙箱支持;官方明确承认单次运行仅能找到重复运行总漏洞量的大约一半,主张将安全审计构建为持续迭代的加法体系。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1umpx62EcC?t=0s) AI 安全审计在生产环境受阻的核心症结在于泛滥成灾的假阳性,模型报出的十条线索中常有八条属于幻觉。 - [00:32](https://www.bilibili.com/video/BV1umpx62EcC?t=32s) security-audit-skill 包含主流程和 14 个领域知识文件,将大模型应用安全、供应链及可用性风险单列为一等公民。 - [01:12](https://www.bilibili.com/video/BV1umpx62EcC?t=72s) 审计流水线前两阶段通过第一阶段侦察建立确定性“覆盖账本”,并在第二阶段分派互不干扰的猎手智能体以威胁模型为前提开展定向狩猎。 - [01:45](https://www.bilibili.com/video/BV1umpx62EcC?t=105s) 流水线的核心灵魂是阶段三的对抗性验证,所有候选漏洞交由全新的验证智能体专职推翻,践行“自己改作业的学生会给自己全过”的防偏见哲学。 - [02:50](https://www.bilibili.com/video/BV1umpx62EcC?t=170s) 三态判定体系下,confirmed 状态要求说明谁越过哪道控制造成何种后果的完整边界链,且严重级封顶于实际演示破坏;needs_validation 专门收留卡在单个未决事实上的线索并不计严重级。 - [03:38](https://www.bilibili.com/video/BV1umpx62EcC?t=218s) rejected 状态仅压制本次提出的单条主张,不会将对应代码区域移出覆盖账本,后续全量审计仍会重新覆盖。 - [03:55](https://www.bilibili.com/video/BV1umpx62EcC?t=235s) 系统推行硬性配套铁律:预留验证预算先于向外分派猎手、无 OS 沙箱绝对禁止执行目标代码、快速模式强制自标为“部分审计”。 - [04:22](https://www.bilibili.com/video/BV1umpx62EcC?t=262s) Glasswing 项目的核心认知是安全工作流绝不能绑定单一模型,因为每个模型都透过同一副眼镜看代码,必须依靠模型无关的编排层实现交叉互审。 - [04:58](https://www.bilibili.com/video/BV1umpx62EcC?t=298s) 450 行的原型因单体上下文耗尽与跨仓库推理瓶颈,被重组成由编排器驱动、后端数据库持久化的大规模自动化机队。 - [05:48](https://www.bilibili.com/video/BV1umpx62EcC?t=348s) 机队运行一个月内自发提交了超 25,000 次分析工具申请(愿望单机制),而对传统规则扫描器 Semgrep 的调用次数为零。 - [06:05](https://www.bilibili.com/video/BV1umpx62EcC?t=365s) 该体系最有价值的资产在于将对抗验证做成了流程强制,用制度化的怀疑机制教机器学会说“我不确定”。 - [06:45](https://www.bilibili.com/video/BV1umpx62EcC?t=405s) 开源代码仅为轻量技能原型,缺乏企业级数据库与调度编排器的个人开发者切忌将其视作全自动挖掘零日漏洞的银弹。 - [07:22](https://www.bilibili.com/video/BV1umpx62EcC?t=442s) 官方文档坦言单次运行约只能覆盖重复运行总检出量的一半,强调安全审计应被定义为持续累加的工程数学,而非一次性的终点。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1umpx62EcC?t=0s) 告别假阳性:Cloudflare 开源 security-audit-skill 与六阶段审计流水线
用 AI 挖掘代码漏洞时,安全团队面临的最大敌人并不是模型的智力上限,而是泛滥成灾的“假阳性”。大语言模型往往兴冲冲地跑来报警,声称某处存在命令注入、某处存在越权漏洞,然而人工安全专家逐一复核后却发现,报上来的十条线索里往往有八条纯属幻觉。整个审计流水线迅速被垃圾候选信息彻底淹没,这也正是 AI 代码安全审计长期无法真正落进生产环境的核心症结。针对这一痛点,Cloudflare 于 6 月 18 日开源了一套名为 `security-audit-skill` 的技能包。它的定位非常纯粹:通过一条安装命令,借助 MIT 协议把开发者手头的 Claude Code 这类编码智能体直接改造成专业安全审计员。在发布后的短短三个月内,该项目便狂揽了 26,000 颗 GitHub Star,其背后依托的更是一台真实在 Cloudflare 自家代码库中挖掘出 7,245 条可执行漏洞发现的庞大机队。
这套技能包包含主流程文件与 14 个领域知识文件,相当于给智能体随身配备了一本权威的安全审计教科书。值得注意的是,它把“AI 与大模型应用安全”、“供应链与发布”以及“资源耗尽与可用性”等维度单列成章,让 AI 自身应用的安全风险在体系内成为一等公民,而非次要的附庸。该工具设计了两种工作模式:默认状态下为“咨询模式”,用户咨询具体安全问题时,智能体仅调用内部知识库解答,绝不擅自启动复杂的审计流水线;只有当用户明确下达审计指令或索取审计报告时,它才会切换至“完整审计模式”,在本地生成全套审计产物,严格推进六个阶段:
1. **第一阶段:侦察**。智能体首先全面摸清代码库的整体架构、信任边界以及输入暴露面,最终输出一份详尽的架构说明和一个“覆盖账本”。该账本将待审计面切分成一个个确定性单元,为后续所有审计工序确立统一的坐标系。 2. **第二阶段:覆盖率引导的狩猎**。编排器按照账本单元分派互相隔离的“猎手”智能体。每个猎手只专注审查自己负责的狭小区域,独立撰写工作草稿,上下文互不污染。同时,猎手面临一条不可逾越的硬性规矩——动手前必须先针对该单元建立威胁模型,再顺藤摸瓜寻找漏洞;任何脱离威胁模型的直觉性盲目猜测在此阶段均被判为不合格。 3. **第三阶段:候选验证**。这是整套流水线最关键的灵魂所在。前一阶段捕获的每一条候选发现,都会被移交给一个完全独立的全新“验证智能体”,其唯一任务就是竭尽全力推翻这条漏洞假设。验证者与发现者在流程上实现了彻底隔离。 4. **第四至六阶段:报告与复核**。幸存下来的有效发现会被整理成结构化的 JSON 报告,接受严格的机器校验,再经过一轮独立的记录复核,最终汇聚并输出为一份立场中立、事实确凿的正式安全报告。
```mermaid flowchart TD accTitle: 六阶段对抗性安全审计流水线 accDescr: 展示从侦察建账、隔离狩猎、推翻验证到报告输出的完整安全审计流程。
subgraph Phase1 ["阶段一:侦察建账"] A["分析架构/信任边界/输入面"] --> B["产出覆盖账本<br/>(划定确定性单元)"] end
subgraph Phase2 ["阶段二:隔离狩猎"] B --> C1["猎手智能体 A<br/>(建立威胁模型 A)"] B --> C2["猎手智能体 B<br/>(建立威胁模型 B)"] C1 --> D["产出候选漏洞发现"] C2 --> D end
subgraph Phase3 ["阶段三:对抗验证 (灵魂环节)"] D --> E["全新验证智能体<br/>(目标:全力推翻发现)"] E --> F{"三态判定"} end
subgraph Phase4to6 ["阶段四至六:校验收敛"] F -->|"确认 (confirmed)"| G["结构化 JSON 报告"] G --> H["机器校验 & 独立复核"] H --> I["输出中立审计报告"] end ```
谈及为何要设立严苛的对抗性验证机制,主讲人援引了 Cloudflare 官方博客中的生动比喻:“Cloudflare 在博客里说的直白,自己改自己作业的学生会给自己全过。”
---
[02:50](https://www.bilibili.com/video/BV1umpx62EcC?t=170s) 三态判定与制度化怀疑:不靠求恳提示词的防假阳性铁律
为了从底层遏制假阳性,`security-audit-skill` 在判定语言上彻底打破了传统非真即假的二元对立,创造性地引入了“三态判定”模型,用严密的因果链条取代大模型的脑补:
- **确认态(`confirmed`)**:触发该状态的门槛极其严苛,要求提供一条闭合完整的“边界链”——必须精确说明究竟是谁、越过了哪一道访问控制、最终引发了怎样具体的系统后果,中间缺失任何一环都无法通过。更重要的是,漏洞的严重等级评定完全封顶于验证者实际演示出来的破坏影响,绝不允许依据理论推测进行自我升级。 - **待验证(`needs_validation`)**:专门收纳那些仅仅卡在“一个精确未解决事实”上的存疑线索。比如某个关键部署配置独立于代码仓库之外,智能体现有权限既无法证实也无法证伪,该线索便会被归入此状态,且制度上明确不赋予任何严重等级。 - **驳回(`rejected`)**:专门记录被对抗验证智能体成功推翻的候选发现。值得注意的是,驳回操作只针对本次提出的单条主张进行压制,并不会抹杀该代码区域在覆盖账本中的审计地位;当下一次重新运行全量审计时,这片区域仍会被纳入考察视野。
在判定机制之外,流水线还筑起了多道不可撼动的配套铁律。首先是“预算门”原则:系统在向外分派猎手智能体之前,必须优先预留验证器的调用预算,宁可牺牲前端狩猎的广度,也绝不容许出现缺乏验证的“裸奔”发现。其次是执行隔离原则:如果宿主环境缺乏操作系统级沙箱,智能体严禁擅自执行任何目标代码,所有依赖动态运行验证的线索必须老老实实停留在待验证状态。最后是透明度铁律:智能体若以快速模式跑完流程,产出的文档必须强制自我声明“这是一份部分审计”,永远不得在措辞中暗示已穷尽代码库风险。
主讲人对这套机制的设计哲学给予了高度评价,指出它的核心突破在于机制而非文本话术:“反假阳性,靠的是把怀疑做成制度,提示词一句都没求恳。”
---
[04:22](https://www.bilibili.com/video/BV1umpx62EcC?t=262s) 从 450 行技能到全自动化机队:Glasswing 的演化与实战战绩
`security-audit-skill` 并非凭空诞生的玩具,它的源头可以追溯到 Cloudflare 内部代号为“Glasswing”的先锋实验项目。在该项目中,团队将当时业内顶尖的安全大模型直接调转枪口对准自家代码库,却意外得到了一个颠覆性的认知结论:智能体安全工作流绝不能与任何单一模型进行深度绑定。一方面模型迭代日新月异,另一方面更关键的原因在于,主讲人总结道:“每个模型都透过同一副眼镜看代码。”这意味着单一模型必然存在认知盲区,必须依靠模型无关的编排层,实现让不同模型在“发现”与“验证”环节中展开跨视角的交叉互审。
最初,这套系统的原始形态不过是一份约 450 行代码的基础技能包。但它很快撞上了工程天花板:单体智能体的上下文窗口迅速耗尽崩溃,状态无法持久化,更无法应对复杂的大规模跨仓库跨项目推理。在接下来的 6 周时间里,Cloudflare 团队对架构进行了彻底重构——将六个阶段全面拆解为互不相干的独立智能体,前端由统一的编排器驱动,后端接入数据库支撑状态持久化,最终演化成了一支覆盖 128 个代码仓库、横跨 6 种主流编程语言的大规模自动化审计机队。这支机队交出了一份惊人的实战成绩单:
- **原始发现总数**:抓取了 20,799 条原始候选发现; - **验证与收敛**:共有 12,057 条通过了严苛的对抗验证,在经过全流程的去重与回收整合后,最终沉淀出 7,245 条具有真实修复价值的可执行发现; - **质量跃升指标**:验证阶段的拒绝率从早期的 40% 大幅压低至 11%,而高完整性发现的占比则从 35% 逆势跃升至 58%。
在这组震撼的数据背后,还有两个极具启发性的技术细节。其一是机队内置了独特的“愿望单”机制:运行中的智能体如果发现自己手头缺乏某种趁手的逆向或分析工具,可以主动向系统提交工具申请,仅在一个月内,机队就自发撰写了 25,000 多次工具申请。其二是与传统静态分析工具的对比反差:在整整一个月的实战巡检中,猎手智能体调用传统规则扫描器 Semgrep 的次数竟是惊人的“0 次”。
---
[06:05](https://www.bilibili.com/video/BV1umpx62EcC?t=365s) 三个判断与工程启示:安全审计的加法数学与冷水警示
基于 Cloudflare 从技能原型到工业机队的演进历程,主讲人给出了三个冷峻而深刻的行业研判:
首先,**工程方向完全成立**。这套体系最宝贵的核心资产,在于把对抗性验证固化成了不可跳过的流程强制,相比之下那 14 个领域知识文件反而属于次要的静态资料。无论是三态判定、验证者物理隔离、预算优先分配,还是快速模式下的强制自白,其本质都在攻克同一个 AI 认知难题——如何让大模型坦然且精准地承认“我不确定”。这与此前红队工具“双闸门计划”等技能所采用的机械检查同出一辙,都在践行同一个底层哲学:“怀疑要制度化,不能人格化。”
其次,**必须泼上一盆理性的冷水**。广大开发者切忌将其神化为“装上就能自动挖零日漏洞”的银弹。个人能够跑通该流程的前提,是所使用的智能体运行环境必须支持并行子代理调度,且最好配备操作系统级沙箱;若无沙箱保护,所有涉及动态运行验证的线索最终只能停留在未决的待验证状态。更要认清的是,开源社区放出的 450 行技能文件,与那台产出 7,245 条漏洞发现的生产机队完全是两码事。个人开发者跑快速模式拿到的,只是一份标注清晰的部分审计报告;机队展现出的恐怖战力来源于后方未开源的“数据库加编排器”成熟工业架构。此外,Hacker News 社区也出现了对 Cloudflare 一口气发布过多细碎技能的批评声音,指出过多的离散技能本身反倒会给上层路由机制带来沉重的算力与逻辑负担。
最后,**潜藏在文档中的认知启示最为致命**。在开源项目的 README 中写着这样一句大实话,主讲人特意将其提炼出来:“单次运行大约只能找到重复运行总能找到的漏洞的一半。”
这句看似自我露怯的坦白,恰恰切中了安全攻防的数学本质:它公开承认 AI 永远无法通过单次运行穷尽所有漏洞,但它将安全审计转变为了一种“加法逻辑”——每一次重新运行,都是基于历史覆盖账本对未尽缺口展开定向填补,而不是推倒重来。在安全这件永远没有终点的工作中,承认局限并实施加法积累,才是唯一正确的工程数学。主讲人最后再次强调了那句核心箴言“改自己作业的学生会给自己全过”,并给所有正在尝试用 AI 审计代码的从业者留下了一个发人深省的问题:在你们当前设计的安全流水线里,负责找漏洞的人与负责把关的人,用的是同一个模型吗?
## Notable quotes > [02:50](https://www.bilibili.com/video/BV1umpx62EcC?t=170s) 反假阳性,靠的是把怀疑做成制度,提示词一句都没求恳。 — AI技术投降派
> [00:00](https://www.bilibili.com/video/BV1umpx62EcC?t=0s) 自己改自己作业的学生会给自己全过。 — Cloudflare
> [06:05](https://www.bilibili.com/video/BV1umpx62EcC?t=365s) 单次运行大约只能找到重复运行总能找到的漏洞的一半。 — Cloudflare
> [06:05](https://www.bilibili.com/video/BV1umpx62EcC?t=365s) 怀疑要制度化,不能人格化。 — AI技术投降派
## Mentioned Cloudflare, security-audit-skill, Claude Code, Glasswing, Semgrep, Hacker News, 双闸门计划
## Video description 用 AI 找代码漏洞,最大的敌人是假阳性。模型兴冲冲报十条,人工复核一圈八条是编的。Cloudflare 开源 security-audit-skill:把你的编码智能体变成安全审计员。MIT 协议,一条命令安装,三个月两万六千颗星。 它靠流程防假阳性,不靠提示词求恳。六个阶段:侦察产出覆盖账本,把审计面切成确定性单元;互相隔离的猎手按单元狩猎,动手前先立威胁模型;灵魂在第三阶段——每条候选发现交给一个全新的验证智能体,任务是推翻它。验证者永远不是发现者,Cloudflare 原话:"自己改自己作业的学生,会给自己全过。" 判定不分真假,分三态:confirmed 要完整边界链(谁越过哪道控制、造成什么后果),严重级封顶于实际演示的影响;needs_validation 收卡在"一个精确未解决事实"上的线索,明确不给严重等级;rejected 只压制主张、不压制覆盖,下次重跑再看。配套铁律:验证预算先于猎手预留;无 OS 沙箱不执行任何目标代码;快速模式必须自报"部分审计"。 它的身后是一台真机队。起点 Glasswing 项目把最强安全模型指向自家代码,结论出人意料:不该绑定单一模型——每个模型都透过同一副眼镜看代码。于是做了模型无关的编排层,最初形态就是这 450 行的技能;六周后长成覆盖 128 仓库、六种语言的发现与验证机队:20799 条原始候选,7245 条可执行发现,验证拒绝率从 40% 压到 11%。一个细节:机队里智能体的"愿望单"一个月写了两万五千条申请,而规则扫描器 Semgrep 的调用次数是零。 三个判断:①核心资产是把对抗性验证做成流程强制——怎么让机器学会说"我不确定",这件事被制度化而不是人格化;②冷水——前提是智能体支持并行子代理加 OS 沙箱;450 行技能不等于 7245 条发现的机队(那个没有开源),个人跑快速模式拿到的是明明白白的部分审计;③README 原话"单次运行大约只找到重复运行总能找到的漏洞的一半"——把审计定义成加法,对安全这件没有终点的工作,这是正确的数学。
[Source](https://www.bilibili.com/video/BV1umpx62EcC)