OpenAI发布Decisions接口 砍掉生成环节实现十倍提速与零输出费
AI技术投降派
Decisions API 虽通过单次前向计算直接输出概率实现毫秒级反射与零输出费,但其实测中高达三成的高置信度误判注定其只能作为辅助参考而不可直接授权
AI-assisted summary of 给AI装反射神经?OpenAI开放AI决策工具 — original source. Check the original for full context.
Source published:
Key ideas
- OpenAI 正式发布判别式接口 Decisions API,砍掉文本生成环节,仅通过单次前向计算直接输出判断结果,速度最高可提升十倍。 (0:00)
- Decisions API 计费结构为未缓存输入 0.10 美元/百万 token、缓存 0.01 美元/百万 token,输出完全免费,单次请求最多支持并发 400 个问题并支持图像输入。 (2:40)
- 第三方基准测试显示其底层 Luna 模型存在严重过度自信缺陷:自报置信度大于 99% 时真实正确率仅 68%,高难度题判别力接近抛硬币,重复调用有 10% 概率改判答案。 (4:53)
- AI 应用架构正形成二元分工:Responses 接口充当大脑负责复杂逻辑生成,Decisions 接口充当脊髓处理毫秒级反射决策,但关键业务自动放行前必须先在私有数据上校准置信度。 (5:49)
Detailed notes
## Background 该视频由 Bilibili UP 主“AI技术投降派”于 2026 年 10 月 23 日发布。视频简介介绍了 OpenAI 最新开放的 Decisions API,指出它通过只做一次前向计算、彻底省去文本生成,为 AI Agent 提供“是不是、选哪个、打几分”的高速判别能力,充当整个系统的“反射神经”。
## TL;DR OpenAI 推出全新接口 Decisions API,抛弃传统生成式大模型逐字吐词后提取答案的低效模式,采用判别式架构直接读取内部状态概率,实现输出完全免费且推理提速最高十倍。该接口支持“是不是”、“选哪个”与“打几分”三类标准化决策,底层基于低价档 Luna 模型,并已深度整合进实时语音系统。不过第三方实测也泼了冷水:其置信度严重虚高、对选项顺序敏感且存在答案自相矛盾的问题,开发者应将其定位为毫秒级“脊髓反射”,在用于生产环境前必须结合业务数据谨慎校准。
## Atmosphere & style 全片节奏明快利落,充满了硬核极客的敏锐观察与务实工程思维。主讲人语言生动幽默,善用“直通车与绿皮车”、“大脑与脊髓反射”等鲜明比喻,将枯燥的 API 架构讲得深入浅出。情绪曲线上先扬后抑,在清晰剖析技术红利与商业战局之后,话锋一转直切评测缺陷并理性“泼冷水”,给观众一种专业、清醒且绝不盲目跟风的技术洞察感。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1uDn461EnB?t=0s) OpenAI 正式发布判别式接口 Decisions API,砍掉文本生成环节,仅通过单次前向计算直接输出判断结果,速度最高可提升十倍。 - [02:40](https://www.bilibili.com/video/BV1uDn461EnB?t=160s) Decisions API 计费结构为未缓存输入 0.10 美元/百万 token、缓存 0.01 美元/百万 token,输出完全免费,单次请求最多支持并发 400 个问题并支持图像输入。 - [04:53](https://www.bilibili.com/video/BV1uDn461EnB?t=293s) 第三方基准测试显示其底层 Luna 模型存在严重过度自信缺陷:自报置信度大于 99% 时真实正确率仅 68%,高难度题判别力接近抛硬币,重复调用有 10% 概率改判答案。 - [05:49](https://www.bilibili.com/video/BV1uDn461EnB?t=349s) AI 应用架构正形成二元分工:Responses 接口充当大脑负责复杂逻辑生成,Decisions 接口充当脊髓处理毫秒级反射决策,但关键业务自动放行前必须先在私有数据上校准置信度。
## Key takeaways - [00:05](https://www.bilibili.com/video/BV1uDn461EnB?t=5s) 传统 Agent 将大量时间与 token 消耗在让通用大模型生成长文本后再正则提取判断结果的低效流程上。 - [00:34](https://www.bilibili.com/video/BV1uDn461EnB?t=34s) Decisions API 将决策需求收敛为三类标准化输出:二元判断的概率值、预设候选项及分布概率、两到十个有序等级的加权评分。 - [00:34](https://www.bilibili.com/video/BV1uDn461EnB?t=34s) 接口单次请求最高支持打包 400 个并发问题,并原生支持文本、图片和 JSON 模态输入,适用于视觉验损等复杂场景。 - [01:37](https://www.bilibili.com/video/BV1uDn461EnB?t=97s) 提速的核心在于从自回归的生成式机制转向纯判别式机制,仅做一次前向计算直接读取模型内部状态与概率分布,全程零生成。 - [02:40](https://www.bilibili.com/video/BV1uDn461EnB?t=160s) 输出免费与低廉的输入单价本质上对齐了低阶 Luna 模型,前缀共享超 1024 token 还可触发缓存进一步压低成本。 - [03:25](https://www.bilibili.com/video/BV1uDn461EnB?t=205s) 企业实测效果显著:Sierra 语音客服 P95 延迟压至 280 毫秒以内,Speak 动作预测从 1.4 秒降至 0.13 秒,Datadog 运维风险评分提速达 40 倍。 - [03:25](https://www.bilibili.com/video/BV1uDn461EnB?t=205s) 接入 GPT Realtime 语音后,流式转录与决策毫秒级联动,实现用户话音未落即可触发肢体动画或指令派发。 - [03:53](https://www.bilibili.com/video/BV1uDn461EnB?t=233s) 四年前 OpenAI 曾因押注通用大模型生成能力而下线专用端点,如今重回专用接口主要是受初创公司 TypeSafe Jave 低价决策模型的外部倒逼。 - [03:53](https://www.bilibili.com/video/BV1uDn461EnB?t=233s) 相较于 TypeSafe Jave,Decisions API 当前最重要的护城河在于多模态图像联合判断的原生支持。 - [04:53](https://www.bilibili.com/video/BV1uDn461EnB?t=293s) 第三方实测揭示模型具有严重的后训练后遗症:自报高置信度存在虚高,且对候选项排列顺序敏感,易发生概率漂移。 - [05:49](https://www.bilibili.com/video/BV1uDn461EnB?t=349s) 未来 AI 系统将走向“大脑与脊髓”分工模式,复杂推理交由大模型生成,高频判断由决策端点毫秒级反射,但不能盲目将分数当作权限放行凭证。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1uDn461EnB?t=0s) 不写回复,直接给判断:Decisions API 的三种问题形态
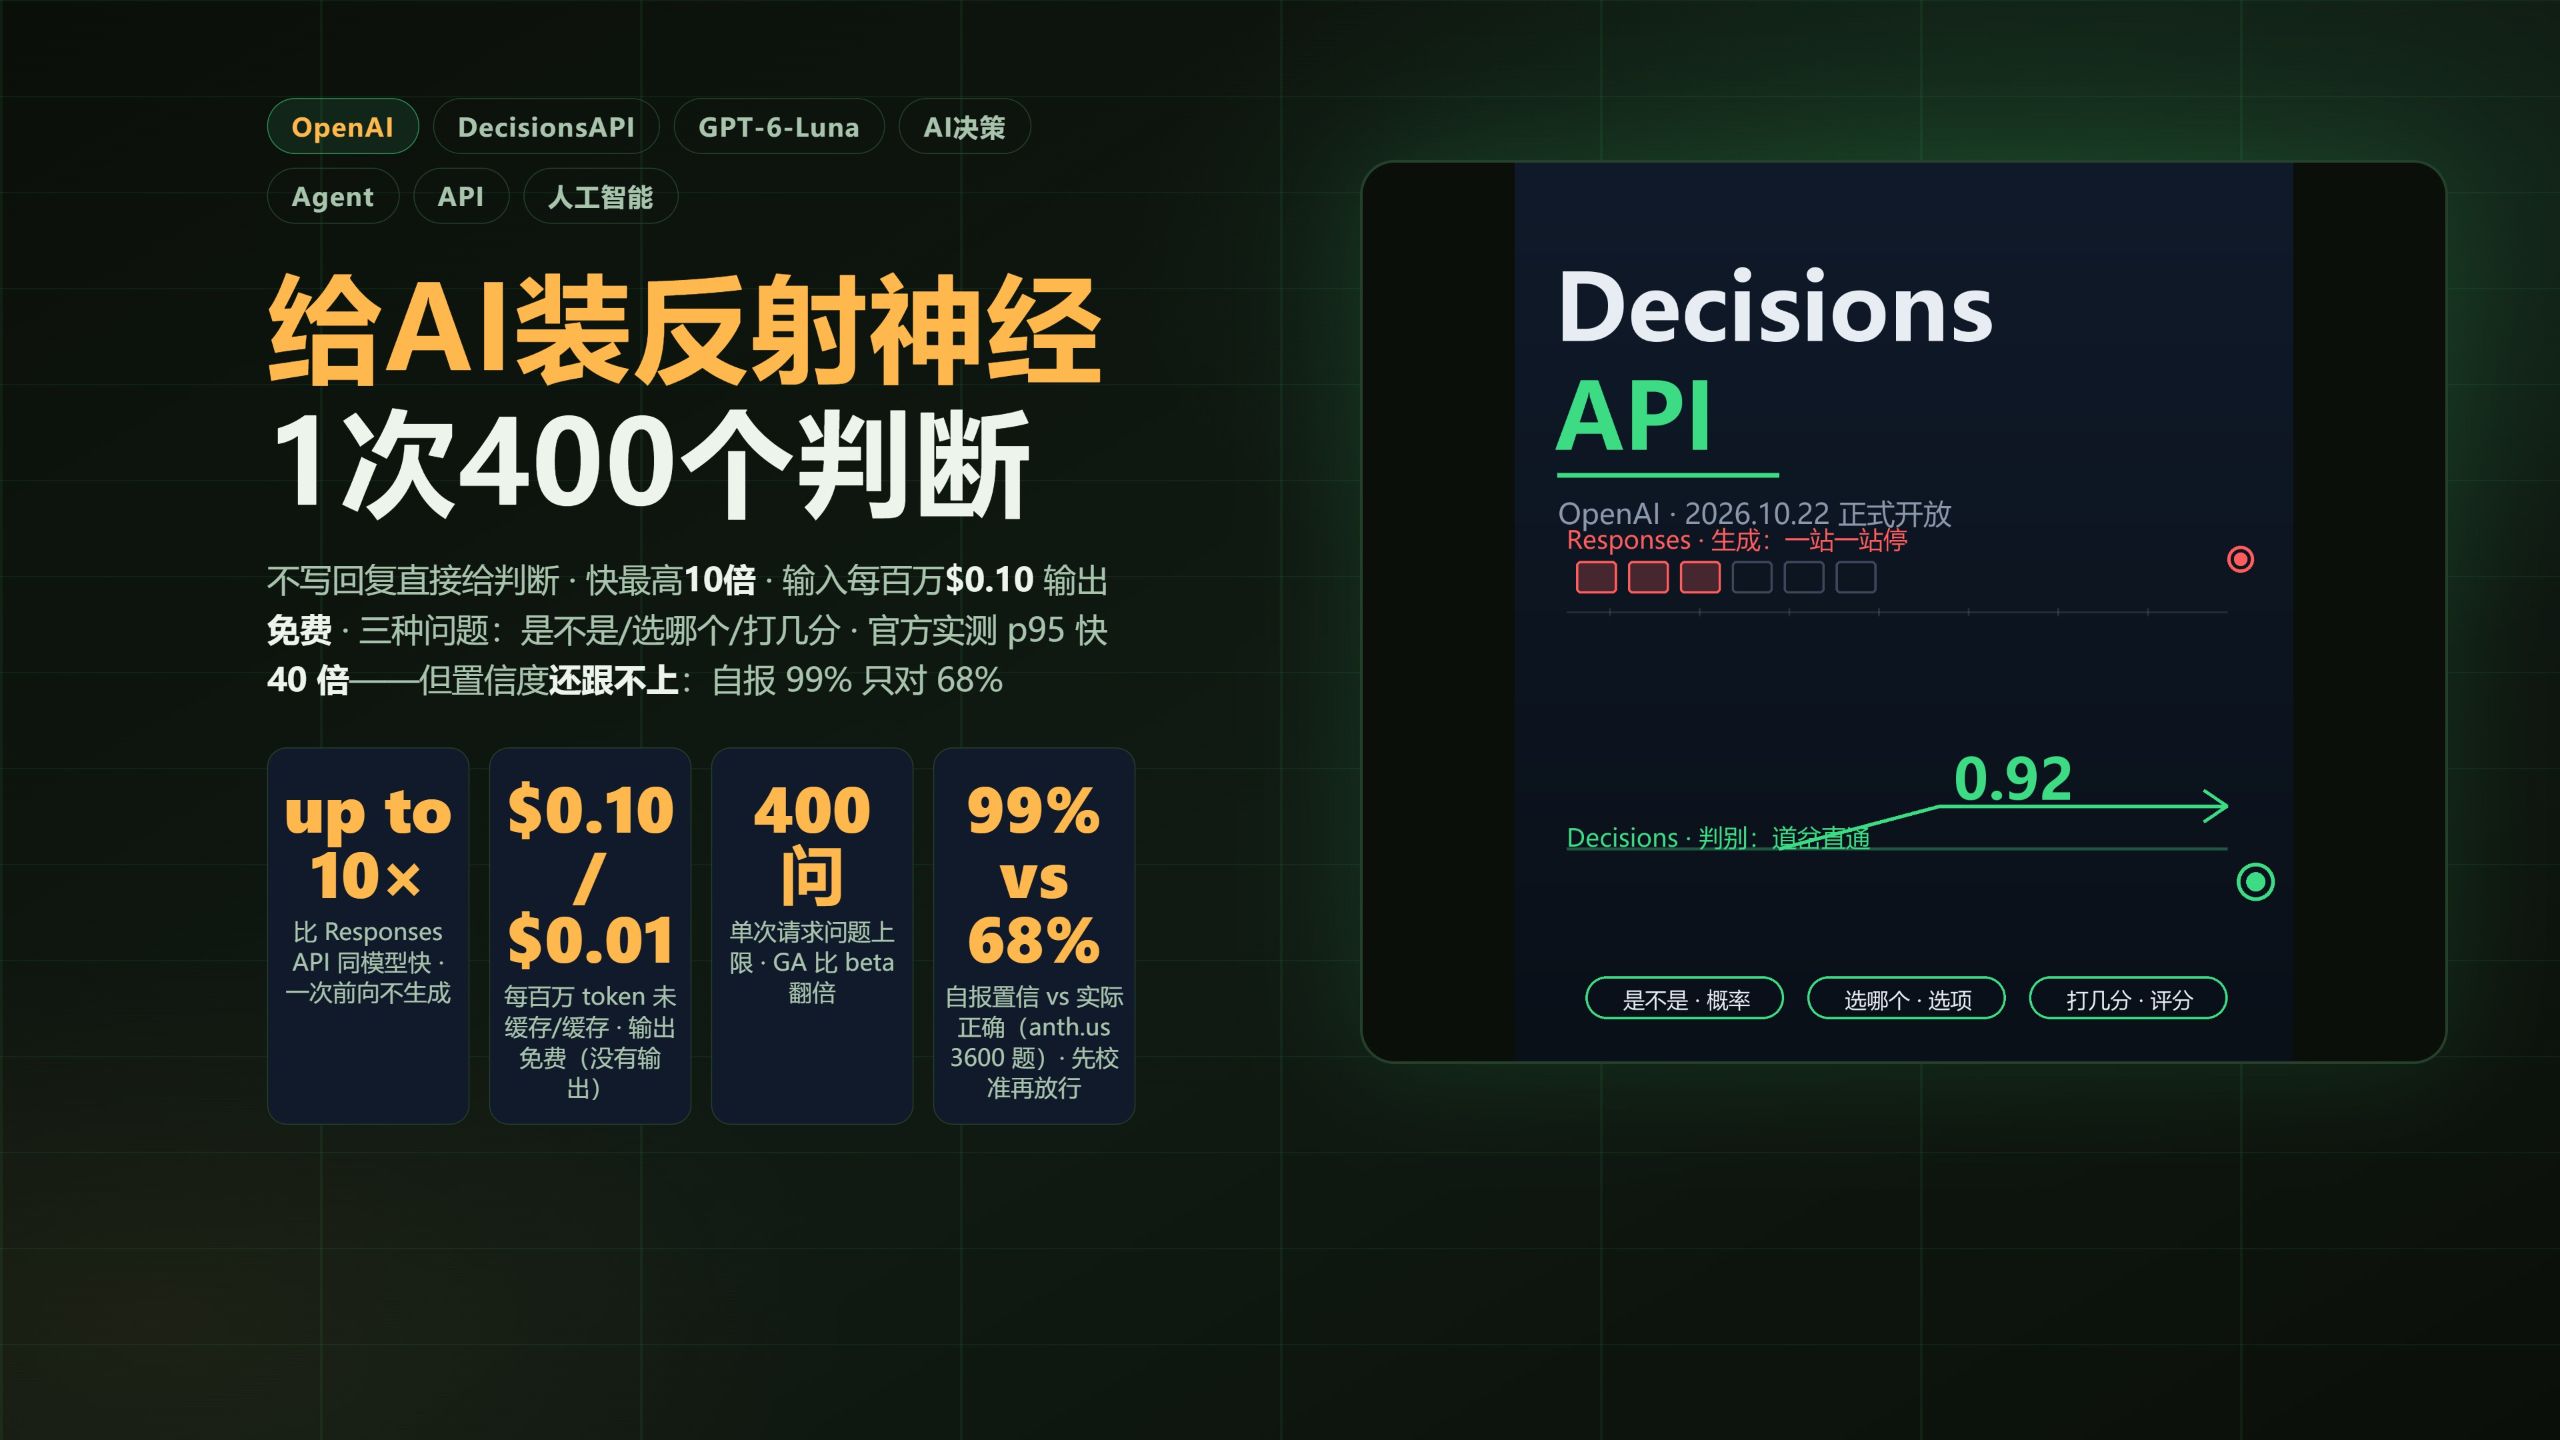
在日常构建和运行 AI Agent 时,真正耗费算力与响应时间的往往不是复杂的高难度推理,而是流程中无休无止的琐碎小判断。比如一条客户消息进线,系统需要判断这到底算不算投诉、应该分流转派给售后组还是计费组、某个工具调用或系统操作是否存在越权风险。过去业界的标准做法,是让通用大模型先生成一段冗长的自然语言解释,工程师再用正则或结构化解析从一堆文字里“抠出”最终答案。这种交互模式不仅速度慢,而且每次生成的大量 token 都在消耗不菲的调用成本。为了终结这种低效折腾,OpenAI 正式推出了全新的接口——Decisions API,其核心设计思路极其干脆:“不写回复,直接给判断。”
Decisions API 把复杂的交互压缩成了三种标准化的问题形态:
1. **“是不是”**:模型直接输出一个 0 到 1 之间的概率值。例如在检测设备状态时提问“这台笔记本有没有物理损坏?”,接口直接返回 `0.92`。 2. **“选哪个”**:调用方输入一组预设的候选项,模型不仅给出选定项,还会返回所有候选项的概率分布以及整体的置信度(Confidence)。例如客服工单该转派至哪个部门,模型选定“计费组”,并附带 `0.93` 的置信度。 3. **“打几分”**:调用方定义两到十个有序等级,模型会计算出一个加权评分,甚至能够精确落在两个档位之间。例如在严重度三档评估中,模型可以给出 `1.1` 分,其内部逻辑反映为“七成像中度,两成像重度”。
在官方的保险索赔演示中,开发者只需上传一张摔坏的笔记本照片外加一段文字描述,就能在一次请求里同时抛出这三类问题,接口会并发返回三路答案。目前该接口单次请求最高支持打包塞入 400 个问题,容量比公测阶段直接翻了一倍;输入模态全面支持文本、图片和 JSON,不过音频暂未开放。
---
[01:37](https://www.bilibili.com/video/BV1uDn461EnB?t=97s) 凭什么快十倍:判别式机制与零输出账单
Decisions API 宣称比普通的大模型生成调用最多快十倍,其背后的技术秘密完全在于“生成式(Generative)”与“判别式(Discriminative)”的路径差异。常规调用大语言模型时,模型像打字机一样必须按自回归逻辑逐字输出 token,答案深埋在吐出的自然语言句式中;而 Decisions API 彻底砍掉了文本生成环节,模型仅执行一次前向计算(Forward Pass),直接从底层内部隐藏状态中读取各个候选项的概率分布,全程一个字都不生成。视频形象地打了个比方:“就像铁路上的两种车:特快列车再快也要一站一站停,道岔信号一扳,直通车直接放行。”
```mermaid flowchart TD accTitle: 生成式调用与判别式决策对比 accDescr: 对比传统大模型自回归文本生成与 Decisions API 内部前向计算直接读取概率的机制路径
subgraph GEN["传统生成式调用(逐字吐词)"] G_In["用户输入 (Prompt)"] --> G_Fwd["模型计算"] G_Fwd --> G_Token1["生成 Token 1"] G_Token1 --> G_Token2["生成 Token 2..."] G_Token2 --> G_Text["完整文本回复"] G_Text --> G_Extract["正则提取答案(慢且费 token)"] end
subgraph DEC["Decisions API(判别式直通)"] D_In["输入 (文本/图片/JSON)"] --> D_Fwd["单次前向计算 (Forward Pass)"] D_Fwd --> D_Logits["读取模型内部状态与概率分布"] D_Logits --> D_Out["直接输出概率/选项/分值(零生成)"] end ```
这种机制反映在计费账单上,展现出了一种近乎原理说明书式的定价策略:未缓存的输入每百万 token 收费 0.10 美元(一毛钱),缓存命中的输入每百万 token 仅收 0.01 美元(一分钱),而输出费用则直接标为 0 美元。之所以能实现输出完全免费,是因为它在机制层面根本就没有生成任何多余文字,自然没有计费对象。这套定价刚好对应了 OpenAI 旗下的低价档“月亮模型”Luna 的输入和缓存价格。当共享输入前缀超过 1024 个 token 时便可触发缓存复用,提问的问题内容本身还不占用这部分缓存。
在各家合作伙伴的真实业务压测中,这种架构带来了立竿见影的提速与降本: - **Sierra 语音客服**:决策延迟 P95 控制在 280 毫秒以内,响应速度提升约 3 倍,单次决策成本直降 90%。 - **Datadog**:利用该接口给 AI 生成的运维命令进行实时风险评分,P95 延迟暴降,速度飙升 40 倍。 - **Speak**:接入语音交互流程后,预测下一步动作的等待时间从过去的 1.4 秒断崖式压缩至 0.13 秒。
与此同时,Decisions API 正式版深度打通了 GPT Realtime / Live 语音系统。交互流程演变为转录文本一边流式输入,后台一边毫秒级触发决策判定。官方用一句话形容这种无缝感:“用户话音未落,决策已经返回。”在实测 Demo 中,虚拟数字人刚听到用户说“我拿到工作了”,后台立刻实时判定并驱动模型做出庆祝的肢体表情与手势;车载助手听到用户念叨“有点冷”,能当场瞬间决断是直接调整空调风速,还是交由后端大模型展开多轮对话。
---
[03:53](https://www.bilibili.com/video/BV1uDn461EnB?t=233s) 专用端点的下线与回归:TypeSafe Jave 的外部施压
将时间轴拉长来看,Decisions API 的问世并非 OpenAI 首次尝试决策类接口。四年前,OpenAI 曾主动关停并下线了旗下早期的“老三样”端点:分类(Classification)、问答(Answers)和搜索(Search)。彼时 OpenAI 的产品哲学极其推崇大一统:“当时的大模型判断是,一个会生成的通用大模型能干所有事,专用端点没有存在的必要。”
然而四年之后,专用端点再度杀回大众视野,只是底层早已脱胎换骨——它不再是早期的简单接口,而是把顶层前沿模型 Luna 剥离了文本生成逻辑,放置在纯判别轨道上高速运转。促使 OpenAI 这次迅速调头的,很大程度上来源于激烈的外部竞争。9 月中旬,初创公司 TypeSafe 推出了业内首个专用的决策模型 Jave,其不仅推理速度极快,每百万 token 的成本更是直接下探到了约 4 美分。在社区引起轰动后,OpenAI 仅仅用了 14 天便火速在开发者日(DevDay)上端出了 Decisions API。这种针锋相对的动作,引得知名技术博主 Simon Willison 在社交媒体上直接公开讽刺它就是“Jave 的克隆版”。
面对竞品的低价与先行优势,OpenAI 目前手中最核心的护城河在于多模态支持。Jave 的官方托管版本目前尚不具备图像解析能力,而 OpenAI 的 Decisions API 能够原生支持图像输入,在涉及视觉验损、图文审核的多模态场景中占据了显著优势。
---
[04:53](https://www.bilibili.com/video/BV1uDn461EnB?t=293s) 泼冷水:置信度虚高与脊髓反射的应用边界
尽管技术架构极具吸引力,但第三方实验室 Artificial Analysis 的实测数据也给过热的预期浇了一盆冷水。在 3600 道推理基准题目的横向评测中,Luna 暴露出了生成式模型转做判别任务时的严重短板:
| 评估维度 | Luna (Decisions API 底座) | TypeSafe Jave | |:--- |:--- |:--- | | **超高置信度准确率** (自报置信度 > 99%) | 仅 68% 正确 | 高达 98.9% 正确 | | **高难度题目判别力** | 置信度与正确率几乎无关联,表现接近抛硬币 | 保持相对稳定的置信度校准 | | **输出稳定性** (相同题目重复调用两次) | 约 10% 的概率会自相矛盾修改答案 | 具备更高的一致性 | | **敏感度缺陷** | 调整候选项排列顺序时,模型概率打分会发生剧烈漂移 | 对选项顺序相对鲁棒 | | **视觉能力支持** | 原生支持图片输入与图文联合决策 | 托管版本暂不支持图像理解 |
这种“过度自信”的硬伤,根源大概率在于其底层的训练范式。大语言模型在经历大量生成式的后训练(Post-training / RLHF)后,往往会习得一种习惯性自信的话术倾向。面对这种系统性偏差,资深从业者提出了严厉的工程警告:“行内人的建议是,把决策分数当参考,别当授权,任何自动放行的阈值都要先在自己的数据上校准过。”
整个 AI 应用架构正在形成明确的二元分工演进:Responses 接口相当于大脑,负责深度推理与复杂逻辑,虽慢但全;Decisions 接口则相当于脊髓神经,专攻毫秒级的快速反射,又快又省。“生成式模型是大脑,决策接口是脊髓,脊髓反射不用等大脑。”从曾经单纯的低成本小模型,到如今被赋予 AI 条件反射中枢的全新职能,开发者切勿轻信纸面跑分。在决定拆换现有的分类器之前,务必先抽取至少一千条自有业务真实数据,实地测试其自报置信度与真实正确率的校准曲线是否吻合,再谨慎决定上线方案。
## Notable quotes > [04:53](https://www.bilibili.com/video/BV1uDn461EnB?t=293s) 生成式模型是大脑,决策接口是脊髓,脊髓反射不用等大脑。
> [04:53](https://www.bilibili.com/video/BV1uDn461EnB?t=293s) 把决策分数当参考,别当授权,任何自动放行的阈值都要先在自己的数据上校准过。
## Mentioned OpenAI, Decisions API, Luna, Sierra, Datadog, Speak, GPT Realtime, TypeSafe, Jave, Simon Willison, Artificial Analysis
## Video description Agent 干活时最磨人的不是难题,是无数小判断:这条消息是不是投诉?该转给哪个组?这个操作危险不危险?过去的做法是请大模型写一段完整回复,再从文字里抠答案。慢,还贵。10月22日,OpenAI 正式开放 Decisions API:不写回复,直接给判断。
它只回答三种问题。是不是:给你一个零到一的概率。选哪个:预设选项里选一个,附上全部概率和置信度。打几分:两到十个等级的加权评分,还能落在两档之间。一张摔坏的笔记本照片加一段描述,一次请求同时问三个问题,三路答案一起返回。单次请求最多四百个问题,输入支持文本、图片和 JSON。
为什么能快最多十倍?秘密在生成和判别的区别:普通调用是一个词一个词往外蹦,答案藏在生成的文字里;Decisions 只做一次前向计算,直接从模型内部状态读出概率,一个字都不生成。就像铁路上的两种车:特快再快也要一站一站停,道岔信号一扳,直通车直接放行。客户实测:Sierra 语音客服决策延迟 p95 不到 280 毫秒,Datadog 快四十倍,Speak 下一步动作从 1.4 秒降到 0.13 秒。
最有意思的是价目表本身就是原理说明书:每百万 token 未缓存输入一毛美元、缓存一分、输出免费——没有生成的文字,就没有输出的账单。这套价格正好是 Luna 模型的输入价加缓存价。一个月前我们讲过这个低价档月亮模型,现在它有了新岗位:给整个 AI 应用当反射神经。
也要泼冷水。第三方实验室三千六百道推理题实测:模型自报置信度超过 99% 的题里只有 68% 是对的;难题上置信判别力接近抛硬币;同一题问两次,一成改答案。行内人的建议:把决策分数当参考,别当授权,先在自己的数据上校准过。
00:05 不写回复,直接给判断 00:34 三种问题:是不是/选哪个/打几分 01:37 凭什么快最多十倍 02:40 价目表就是原理说明书 03:25 接进语音:话音未落,决策已返回 03:53 专用端点:下线与回归 04:53 冷水:置信度还跟不上 05:49 思考归大脑,反射归脊髓
官方文档:developers.openai.com/api/docs/guides/decisions
[Source](https://www.bilibili.com/video/BV1uDn461EnB)