DeepSeek Harness优化预设实测省35%Token 澄清减半传言
AI技术投降派
Token治理的本质是由人类硬性规则收回控费权,若无明确验收标准导致交互轮次翻倍,任何单价降本都毫无意义。
AI-assisted summary of 大肥鱼太能吃:这个插件实测省35%token — original source. Check the original for full context.
Source published:
Key ideas
- 开源项目 dsh-flash-presets 针对 DeepSeek Harness(DSH)推出纯 YAML 预设,通过行为规则与提前压缩在实测中节省约 35% Token,打破了社区流传的“省一半”夸大宣传。 (3:33)
- DSH 默认机制存在严重冗余开销:每轮交互固定开销逾 63KB,其中工具表占用高达 70%,且包含 48 个从未调用的工具;同时压缩阈值过高导致长文本全量重发。 (0:58)
- 该预设通过 13 条行为规则、30% 提前压缩仅留 2 万 Token、截断长工具输出及单一 run_code 入口四招进行控费,目前仅适配 V4.1 Flash 模型。 (2:02)
- 仓库作者坦承反例与样本局限,强调若缺乏明确验收标准可能导致多轮重试反噬成本,并指出治理核心在于把控费主动权交回人类硬性规则。 (4:55)
Detailed notes
## Background 该视频由 Bilibili 频道「AI技术投降派」于 2026 年 10 月 24 日发布。视频简介指出,很多用户在使用 DeepSeek Harness(DSH)上的“大肥鱼”Agent 时面临高昂的 Token 账单,针对社区流传某插件能让其“少吃一半”的传说,本期内容对开源仓库 dsh-flash-presets 进行了逐字对账,揭秘实测降幅与运作机理。
## TL;DR 视频深度拆解了针对 DeepSeek Harness 的开源预设仓库 dsh-flash-presets,指出了 DSH 因全量重发历史、思维链回传和工具表臃肿导致的高昂开销。该项目并非传统代码插件,而是通过 13 条行为规则、提前至 30% 窗口压缩、裁剪工具输出以及收窄为 run_code 单入口四招实现无侵入调控。作者严谨对账后发现,社区宣传的“省 50%”并无依据,真实测试降幅约为 35%,且前提是必须给模型写死验收标准,展示了一种理性克制的 Agent 控本思路。
## Atmosphere & style 视频整体呈现出一种幽默讽刺与极度理性交织的极客对账风格,语言辛辣接地气,将严肃的成本压测比作管教“暴饮暴食的大肥鱼”。UP主化身硬核审计员,带着去魅和打破神话的冷静视角逐行验算开源仓库,既有对夸大宣传的调侃,也有对开源作者坦承样本量不足和主动撤回不实结论的赞赏,观感扎实清醒且富有解构乐趣。
## Bulletin - [03:33](https://www.bilibili.com/video/BV1JvHA6aEh9?t=213s) 开源项目 dsh-flash-presets 针对 DeepSeek Harness(DSH)推出纯 YAML 预设,通过行为规则与提前压缩在实测中节省约 35% Token,打破了社区流传的“省一半”夸大宣传。 - [00:58](https://www.bilibili.com/video/BV1JvHA6aEh9?t=58s) DSH 默认机制存在严重冗余开销:每轮交互固定开销逾 63KB,其中工具表占用高达 70%,且包含 48 个从未调用的工具;同时压缩阈值过高导致长文本全量重发。 - [02:02](https://www.bilibili.com/video/BV1JvHA6aEh9?t=122s) 该预设通过 13 条行为规则、30% 提前压缩仅留 2 万 Token、截断长工具输出及单一 run_code 入口四招进行控费,目前仅适配 V4.1 Flash 模型。 - [04:55](https://www.bilibili.com/video/BV1JvHA6aEh9?t=295s) 仓库作者坦承反例与样本局限,强调若缺乏明确验收标准可能导致多轮重试反噬成本,并指出治理核心在于把控费主动权交回人类硬性规则。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1JvHA6aEh9?t=0s) DeepSeek Harness 上的大肥鱼 Agent 存在严重的高 Token 消耗问题,复杂任务中成本容易飙升。 - [00:58](https://www.bilibili.com/video/BV1JvHA6aEh9?t=58s) DSH 采用每轮全量重发机制,将系统提示词、对话历史、思维链及庞大工具表完整回传,推理强度越高负担越重。 - [00:58](https://www.bilibili.com/video/BV1JvHA6aEh9?t=58s) DSH 交互的固定开销中工具表占七成,其中有 48 个未被调用的工具白白浪费了带宽与上下文空间。 - [00:58](https://www.bilibili.com/video/BV1JvHA6aEh9?t=58s) 系统依赖前缀缓存降本,但一旦修改工具或提示词,缓存命中率会从 97% 骤降至 11%,造成账单灾难。 - [02:02](https://www.bilibili.com/video/BV1JvHA6aEh9?t=122s) dsh-flash-presets 是一款零运行时代码、零依赖的 L5 纯 YAML 预设方案,对宿主代码完全无侵入。 - [02:02](https://www.bilibili.com/video/BV1JvHA6aEh9?t=122s) 预设通过注入 13 条行为纪律(如每阶段只读一次、合并调用、达成即交付等)严格约束 Agent 步数。 - [02:02](https://www.bilibili.com/video/BV1JvHA6aEh9?t=122s) 预设将历史压缩触发阈值从默认高位提前至 30 万 Token(约三成),且压缩后仅保留最近 2 万 Token。 - [02:02](https://www.bilibili.com/video/BV1JvHA6aEh9?t=122s) 对超过 8192 字符的工具输出实行硬截断,仅保留头部 4000 字符与尾部 1000 字符以压缩体积。 - [02:02](https://www.bilibili.com/video/BV1JvHA6aEh9?t=122s) 将工具面收窄为仅暴露 run_code 单入口,将多轮工具往返折叠进内部程序,宣称多文件任务可减至 8 倍轮数。 - [03:33](https://www.bilibili.com/video/BV1JvHA6aEh9?t=213s) 仓库实测对账显示 Token 节省幅度在 34% 至 35% 之间,社区传言的“省 50%”并无出处支持。 - [03:33](https://www.bilibili.com/video/BV1JvHA6aEh9?t=213s) 作者严谨撤回了早期口径不可比的“22倍成本差”结论,并主动披露样本量仅为 2 的局限性。 - [03:33](https://www.bilibili.com/video/BV1JvHA6aEh9?t=213s) 预设存在翻车反例:若无严格死板的验收标准,预设版在连续评分题或超时重试中可能消耗更多 Token。 - [04:55](https://www.bilibili.com/video/BV1JvHA6aEh9?t=295s) 该预设与 tokenslash、faster-compress 等代码插件属于互补生态,而非竞争关系。 - [04:55](https://www.bilibili.com/video/BV1JvHA6aEh9?t=295s) 调优的核心警示在于“单位成本降一半,轮次翻倍,白干”,降本必须建立在不导致轮次失控的前提下。 - [05:53](https://www.bilibili.com/video/BV1JvHA6aEh9?t=353s) 预设的本质是通过人为设定硬性验收标准,把开销控制权从模型自由发挥中收回。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1JvHA6aEh9?t=0s) 能吃的鱼与省一半的传说
在人工智能开源社区里,DeepSeek Harness(简称 DSH)上那条被玩家们戏称为“大肥鱼”的 AI Agent 凭借其强大的能力吸引了众多开发者。之前我们曾用一整期内容拆解过给这条大肥鱼装上灵魂的“六件套”插件,教它如何拥有记忆、管理心情,甚至主动开口说话。然而,真正动手养过这条鱼的开发者,很快就会面临一个非常现实且俗气的问题——它的“饭量”实在是太惊人了。
在实际使用中,大肥鱼的 Token 消耗量经常让开发者们肉疼。有用户在跑自己的小项目时,眼睁睁看着 Token 消耗一路狂飙,从零直接吃到了一个亿;还有人仅仅测试了两天,就花掉了 10 美元。更有开发者做了一组直观的对比:在执行同样的调研任务时,DeepSeek 这边足足花掉了 50 元人民币,而对面使用 Codex 的方案却只花了 4 元人民币。
就在大家为账单发愁的时候,社区里开始流传一个神奇的插件传说,号称能让这条大肥鱼的“伙食费”直接省下一半。“省下一半”这个数字无疑是非常提神的,但它到底是确有其事,还是夸大其词的宣传?本期内容我们就来逐字对账,拆解这个在 GitHub 上由 LarryE135 单人维护、目前拥有 35 颗星、于上个月 22 号创建并持续更新的开源仓库——`dsh-flash-presets`。
> “但真养过这条鱼的都知道另一件事,它能吃。”
---
[00:58](https://www.bilibili.com/video/BV1JvHA6aEh9?t=58s) 解剖:每轮全量重发,工具表占七成
要治大肥鱼的“暴饮暴食”,首先得解剖它的生理结构,搞清楚它为什么这么能吃。DSH 的运行机制非常特殊:在 Agent 交互的每一步中,它都会把系统提示词(System Prompt)、所有的工具定义(Tool Definitions),以及完整的对话历史重新组装一次,然后全量发送给模型。
更要命的是,连之前几轮交互中产生的思维链(Chain of Thought, CoT)也会被原样回传。这意味着随着对话轮数的增加,推理强度越高,后面每一轮的传输负担就会呈指数级加重。有开发者对 DSH 的传输数据进行了逐字节的拆解,发现每一轮交互的固定开销就高达 63,000 多个字节。在这笔巨额的固定开销中,工具表(Tool Table)的体积占了整整七成。而最让人扎心的是,在这份庞大的工具表里,有 48 个从头到尾根本没有被调用过的工具,却白白占用了将近 70% 的工具表体积。
此外,默认配置下的上下文窗口管理也存在严重问题。虽然 DSH 拥有 100 万的上下文窗口,但默认要等到窗口占用涨到大约 68%(即 68 万 Token 左右)时,才会触发第一次历史记录压缩。在此之前,每一轮交互都在全量重发历史数据。虽然 DeepSeek 拥有前缀缓存(Prefix Caching)这一“救命机制”,在命中率高的时候能让输入成本便宜约 20 倍,可一旦中途修改了工具或者更换了系统提示词,缓存命中率就会从 97% 瞬间崩塌到 11%,此时的账单只能用“灾难”来形容。
> “连之前几轮的思维链也原样回传,推理强度越高,后面每一轮就越重。”
---
[02:02](https://www.bilibili.com/video/BV1JvHA6aEh9?t=122s) 省粮说明书:纯 YAML 预设的四招
那么,这个号称能省一半 Token 的插件到底是什么原理?首先需要澄清的是,它并不是一个传统的代码插件。它实现了“零运行时代码”和“零依赖”,整个仓库的核心其实就是一组精心调优的 YAML 预设配置。用户安装后,只需要在自己的配置文件里插上几行,就能在不改动宿主代码和 Agent 预设的前提下完成部署。在插件市场上,它被标注为 L5 级别,官方原话是“不挂载任何插件能力”,这恰恰准确地说明了它的无侵入性。
这套预设主要通过以下“四招”来规范大肥鱼的行为,从而达到省粮的目的:
```mermaid flowchart TD accTitle: dsh-flash-presets 优化策略 accDescr: 展示该预设通过行为规则、提前压缩、裁剪输出和单入口工具四招来减少 Token 消耗的流程。
subgraph Rules["1. 行为规则 (13条纪律)"] R1["每阶段路径只读一次"] R2["独立调用打包合并"] R3["验收通过即交付"] R4["目标控制在20轮内"] end
subgraph Compress["2. 提前压缩"] C1["30% 窗口即触发压缩"] C2["仅保留最近 2万 Token"] end
subgraph Truncate["3. 裁剪工具输出"] T1["超 8192 字符输出截断"] T2["保留头 4000 + 尾 1000 字符"] end
subgraph Tool["4. 单入口工具面"] M1["仅保留 run_code 接口"] M2["多文件任务轮数最多减少 8倍"] end
Rules --> Compress Compress --> Truncate Truncate --> Tool ```
1. **注入 13 条行为规则**:给大肥鱼立规矩。例如,规定一个路径在每个阶段只能读取一次,如果没有变化就不再重读;能打包的独立调用必须放进同一步骤中合并执行;一旦验收标准通过就立刻交付,不再追加随机测试;将交互目标控制在 20 轮以内,如果超过 3 倍轮数(60 轮)就必须停下来重新规划。 2. **大幅提前压缩时机**:不再死等上下文窗口涨到八成,而是提前到三成(约 30 万 Token)时就触发压缩,且压缩后只保留最近的 2 万 Token。 3. **无情裁剪工具输出**:一旦工具输出的结果超过 8192 个字符,预设就会挥起大刀,将其无情地砍成“头部 4000 字符 + 尾部 1000 字符”的缩略版。 4. **收窄工具面为单入口**:将复杂的工具面切成仅保留 `run_code` 作为唯一直接调用的工具,其他工具全部写进程序内部进行调用,从而将多次工具往返折叠进一次交互中。对于多文件任务,官方声称这最多能带来 8 倍的轮数减少。
这套预设一共提供了 V1(稳健)、V2(节省)、V3(默认)三档,且明确指出目前仅对 `V4.1 Flash` 这一档模型有效,作者也坦言不保证在其他模型上能正常使用。
> “整个仓库的核心就是一组 YAML 预设,安装后往配置里插几行,Agent 预设不动宿主代码,插件市场把它标成 L5,原话是‘不挂载任何插件能力’。”
---
[03:33](https://www.bilibili.com/video/BV1JvHA6aEh9?t=213s) 对账:传说 50% vs 实测 35%
现在我们来对账。关于社区里流传的“省一半(50%)”的说法,我们在仓库里进行了全文检索,发现根本“查无出处”。
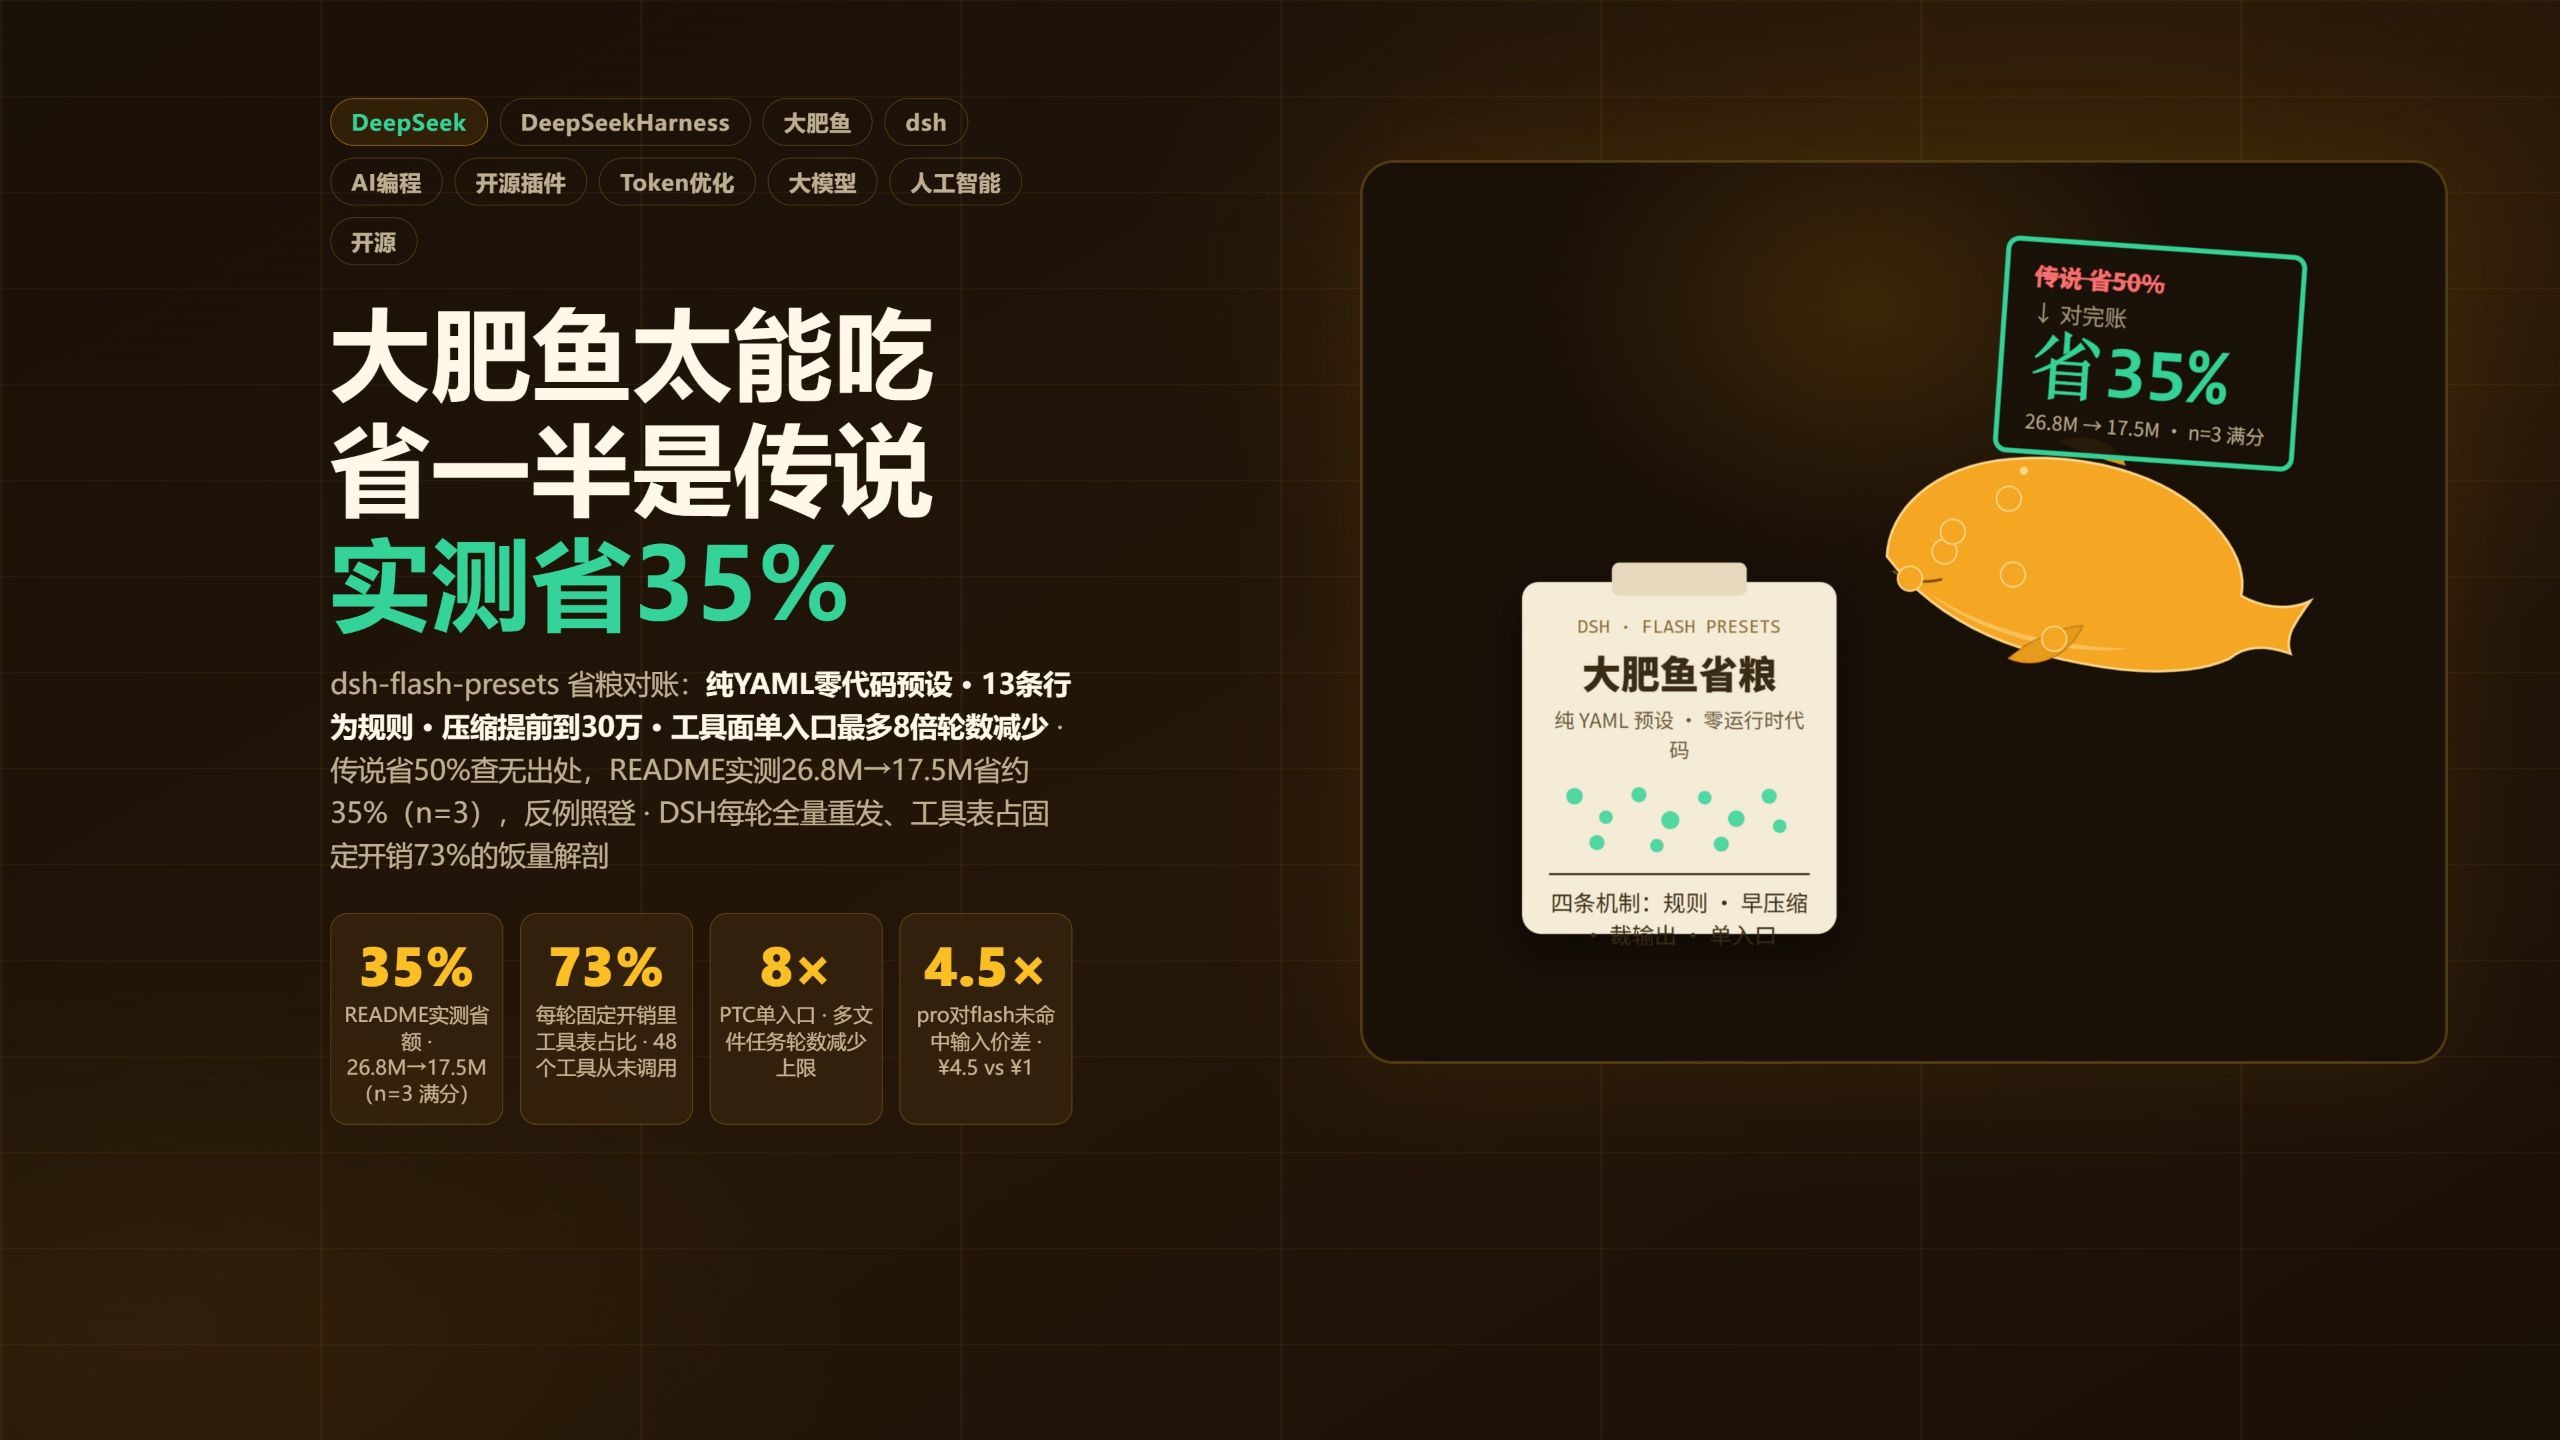
作者 LarryE135 自己在 README 中记录的真实测试数据是这样的:在跑同一道洛谷(Luogu)编程题时,大肥鱼连续三次拿到满分,其计费 Token 从标准模式下的 26.8M 降到了预设模式下的 17.5M,实际节省了大约 **35%**。在另一组受控复现测试中,Token 消耗从 7.03M 降到了 4.64M,节省了大约 34%。对于这些数据,作者表现得非常严谨和诚实,特意在旁边标注了一行字:“样本量 2,不构成显著性证据”。
更有意思的是,这个仓库里还专门保留了一个名为“已撤回的说法”的章节。作者坦承,自己曾宣称标准模式的成本是这套预设模式的 22 倍,但后来经过排查,发现当时做对比的两组测试中,一组用了图形界面(GUI),另一组用了无头模式(Headless),两者的测试口径根本不可比,于是他非常体面地撤回了这一结论。
同时,仓库里也如实记录了预设模式的“翻车”反例: * 在某道特定的题目中,标准模式只花了 200 万左右的 Token 就拿到了满分,而开启了预设版的 DSH 反而花掉了 1700 多万 Token,最后卡在超时重试上。 * 在面对一些连续评分的题目时,预设版跑出来的分数明显低于标准模式,除非开发者在题面里把验收标准写得死死的。
因此,经过客观对账后可以得出结论:这套预设实际能帮你省下的是 **三成左右(约 35%)** 的 Token,而不是传说中的一半。那一半的降幅,不过是社区在传播过程中自行加码的艺术夸张。而且,能省下这三成的前提,永远是你必须给大肥鱼提供极其明确的验收标准。
| 测试模式 | 洛谷题测试消耗 (Token) | 受控复现测试消耗 (Token) | 降幅 | 备注 | |:--- |:--- |:--- |:--- |:--- | | **标准模式** | 26.8M | 7.03M | - | 默认配置,全量重发 | | **预设模式** | 17.5M | 4.64M | **~34% - 35%** | 触发提前压缩与工具裁剪 |
> “作者自己标注:‘样本量 2,不构成显著性证据’。”
---
[04:55](https://www.bilibili.com/video/BV1JvHA6aEh9?t=295s) 生态位与价格:把怎么花钱拿回来
如果把 `dsh-flash-presets` 放回整个 DSH 的插件生态里来看,在“省 Token”这条赛道上它并不孤单。目前社区里活跃着好几款各司其职的省钱工具:
* `Tokenslash`:专门用来裁剪和瘦身工具表; * `Faster Compress`:负责把繁重的上下文压缩工作挪到后台异步执行,避免阻塞交互; * `Cost Meter`:则像一个贴身的记账本,只管帮你算账。
而今天拆解的这款预设,走的是一条“纯配置、不动代码”的路线。它在配置层将行为规则、压缩时机和工具面进行了打包治理,因此它和前面几款插件并不是竞争对手,而是完美的互补关系。
关于这个赛道,另一位插件作者曾说过一句非常清醒、甚至有些冷酷的话:“单位成本降一半,轮次翻倍,白干。” 这道出了 Agent 调优的本质:如果因为限制了 Token 导致模型变笨、交互轮次翻倍,那么省下来的单价根本毫无意义。
我们顺便来看一下目前的计费背景。以 DeepSeek 的 Flash 模型为例,缓存未命中的输入价格是 1 元人民币/100万 Token,而 Pro 模型则是 4.5 元人民币/100万 Token,两者有着 4.5 倍的巨大差价(在非高峰时段的谷时还会有半价优惠)。另外还有一个时效性的彩蛋:目前在 Harness 里使用网页搜索工具的调用是免费的,但官方已经公告将于 11 月 1 日开始正式计费。
归根结底,这种预设路线的本质,是把“怎么花钱”的主动权从模型手里夺回来,重新交还给人类写死的硬性规则。虽然目前它只在几道算法题上证明了自己的有效性,其他更复杂的业务场景还有待验证,但作者这种既有夸大宣传的自我纠正、又有扎实测试的态度,在社区插件里绝对算得上是上乘之作。给大肥鱼装上灵魂让它活过来是一回事,管住它的饭量不让它把钱包吃空,则是另一回事。而后者,往往只能依靠我们把验收标准写死,而不是寄希望于某种魔法。
> “这条赛道里最清醒的一句话来自另一个插件作者:‘单位成本降一半,轮次翻倍,白干。’”
## Notable quotes > [04:55](https://www.bilibili.com/video/BV1JvHA6aEh9?t=295s) 单位成本降一半,轮次翻倍,白干。
## Mentioned DeepSeek Harness, DeepSeek, Codex, LarryE135, dsh-flash-presets, Tokenslash, Faster Compress, Cost Meter, 洛谷, GitHub
## Video description 之前我们拆过给 DeepSeek Harness 上的大肥鱼装灵魂的六件套;这次管点俗的——饭量。有用户的小项目 token 从零吃到一个亿,有人两天花十美元,同样的调研任务这边五十块对面 Codex 四块。最近社区流传一个插件,说能让这条鱼少吃一半。一半很提神,但这期我们把它的账本逐字对了:仓库全文检索,50% 查无出处。
00:05 能吃的鱼与省一半的传说 00:58 解剖:每轮全量重发,工具表占七成 02:02 省粮说明书:纯 YAML 预设的四招 03:33 对账:传说 50% vs 实测 35% 04:55 生态位与价格 05:53 判断:把怎么花钱拿回来
它不是代码插件:零运行时代码零依赖,一组 YAML 预设往配置里插几行,插件市场标 L5「不挂载任何插件能力」。四招:十三条行为规则(一个路径每阶段只读一次、独立调用打包、验收通过即交付、目标二十轮);压缩从八十万提前到三十万触发只留两万;超八千一百九十二字符的工具输出砍成头四千加尾一千;工具面切成 run_code 单入口,多文件任务最多八倍轮数减少。三档 v1/v2/v3,只对 V4.1 Flash 有效。
诚实账本:README 实测同一道洛谷题三次满分,计费 26.8M 降到 17.5M,省约 35%;受控复现省 34%,作者自注「样本量 2,不构成显著性证据」;仓库还设「已撤回的说法」一节(曾称标准模式是它的 22 倍,因口径不可比撤回);反例照登——有一道题标准模式约 2M 满分而预设版花了 17.5M+,连续评分题分数更低除非把验收标准写死。省的是三成上下不是一半,一半是传播加的码;前提永远是给明确的验收标准。生态位上它与 tokenslash(裁工具表)、faster-compress(后台压缩)、cost-meter(记账)互补;赛道里最清醒的一句话:单位成本降一半,轮次翻倍,白干。
仓库:github.com/LarryE135/dsh-flash-presets(35★ · MIT · 单人维护)
[Source](https://www.bilibili.com/video/BV1JvHA6aEh9)