米哈游开源90亿参数游戏AI 0.3秒响应在实时测试击败GPT
AI技术投降派
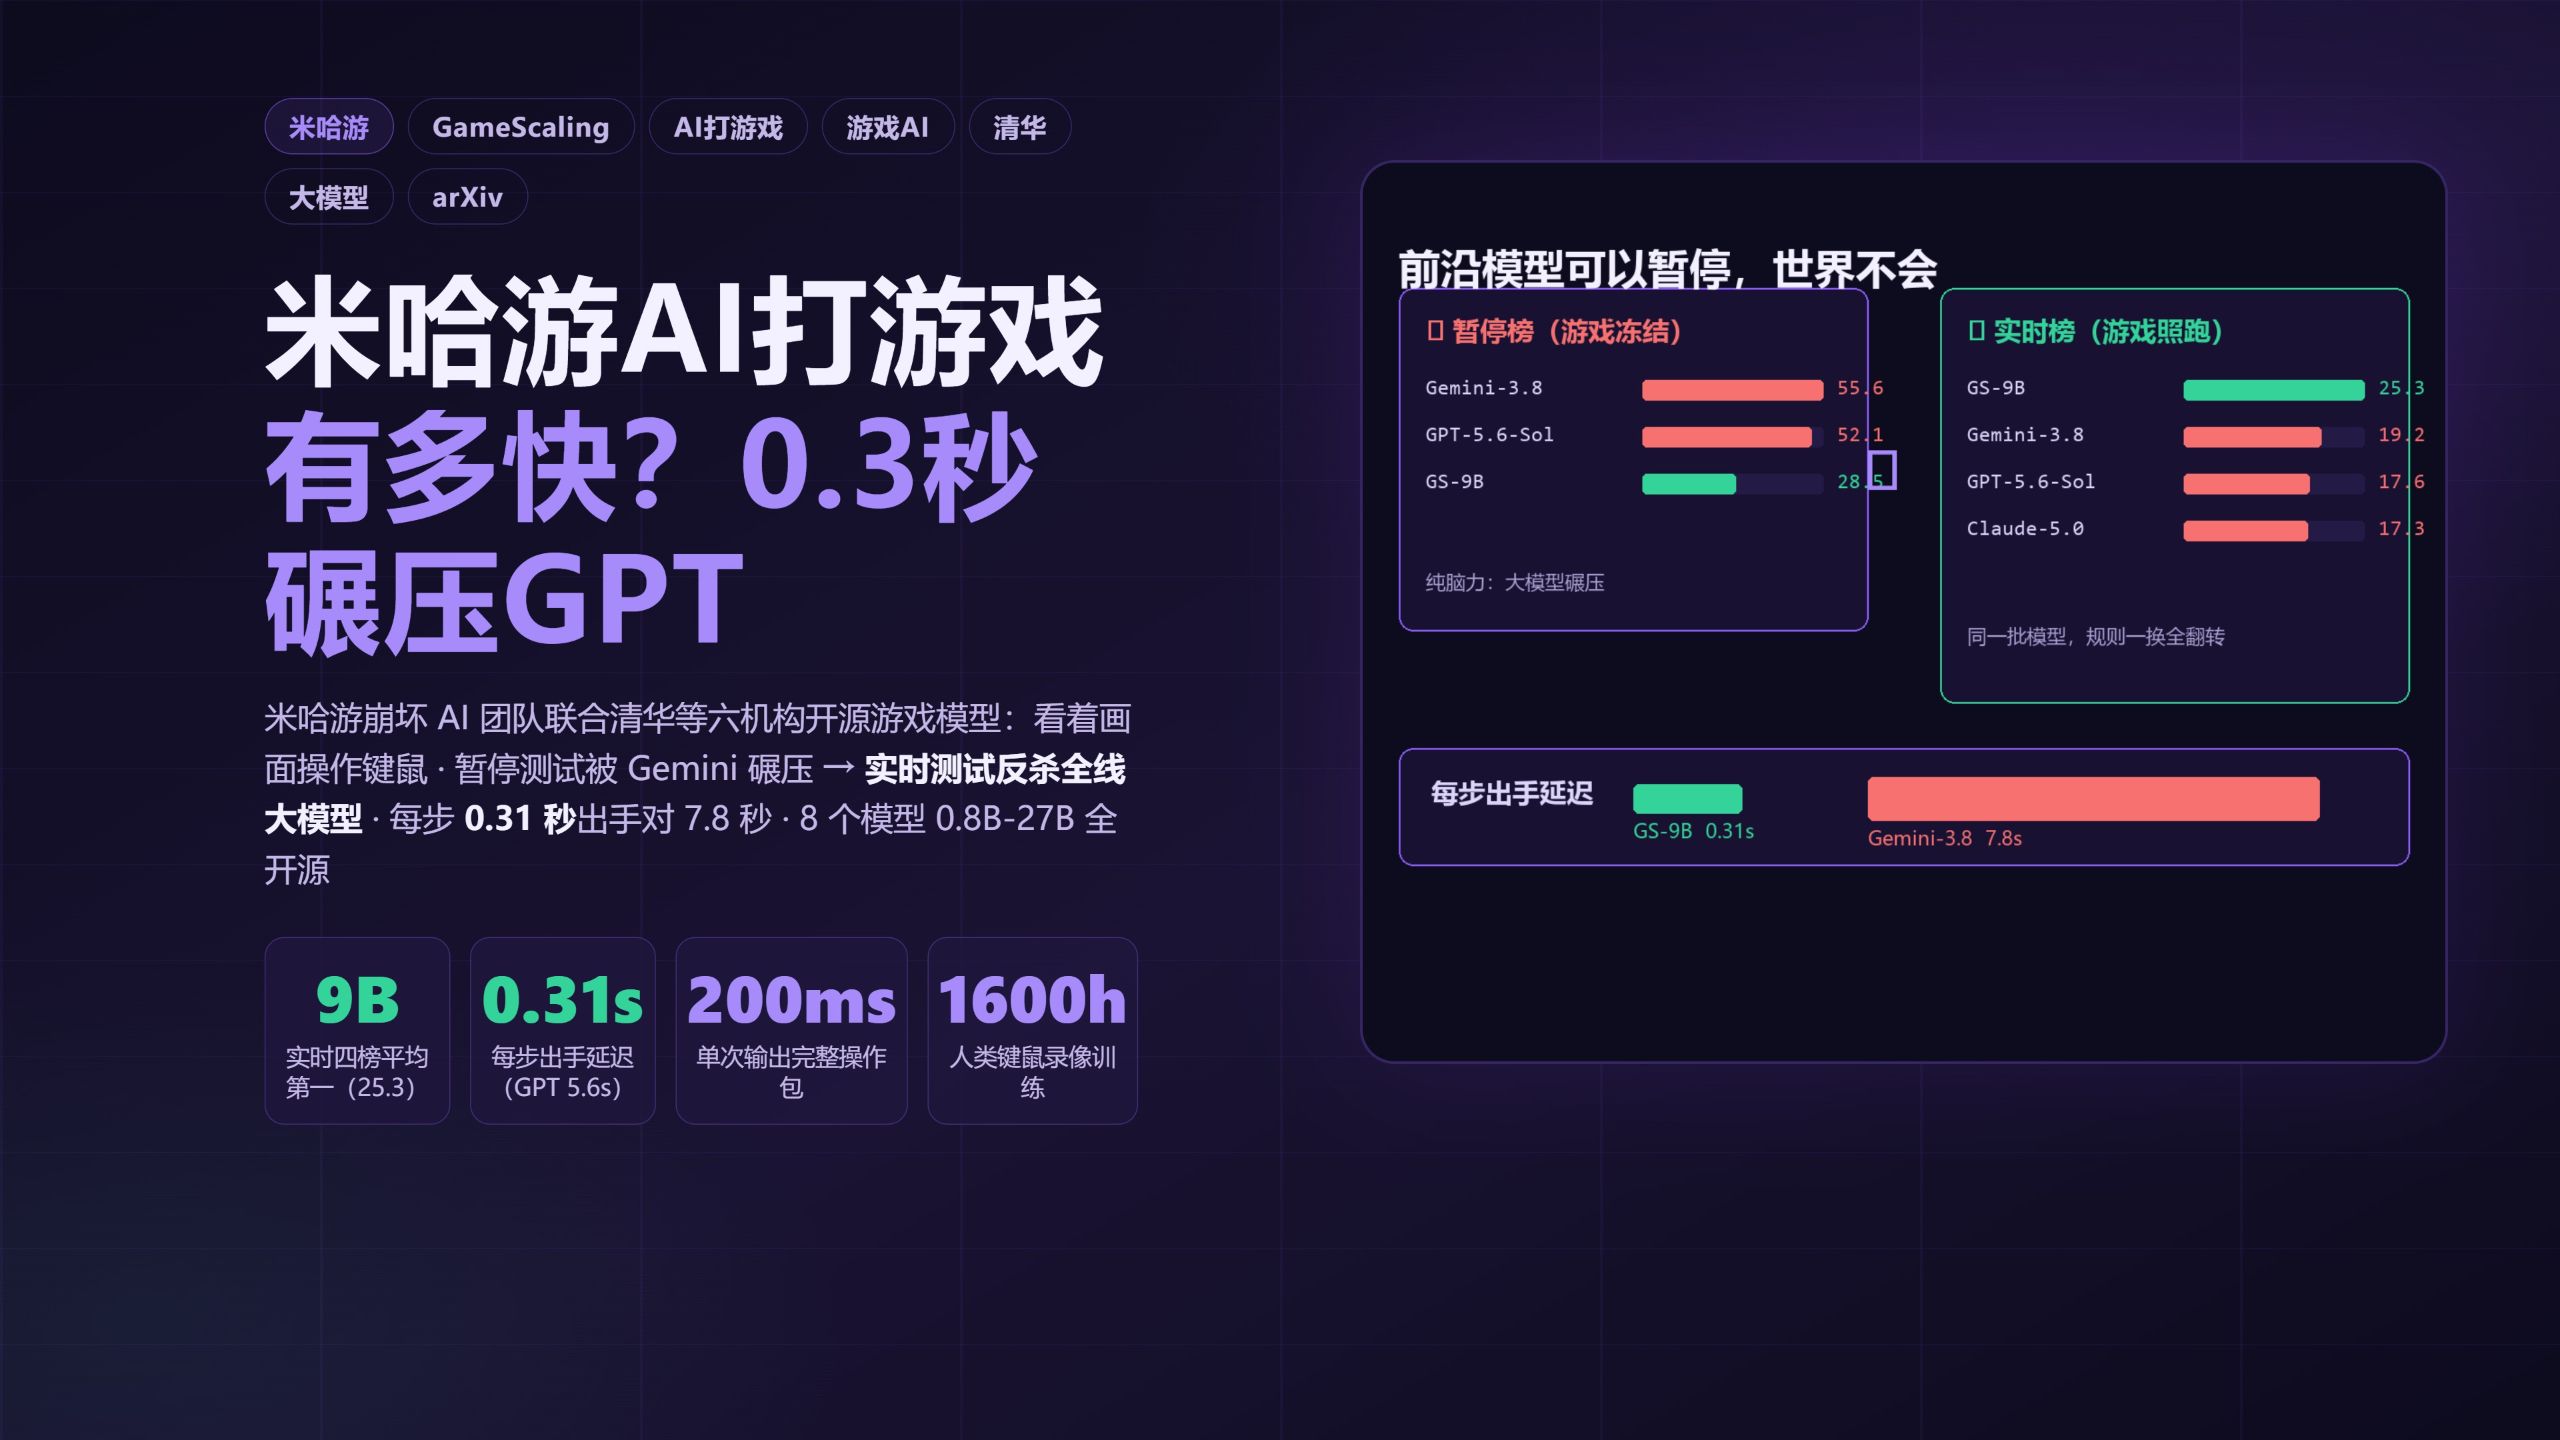
研究表明延迟本身也是核心能力,在无法暂停的实时动态交互中,0.3秒直出动作的小模型比耗时数秒深度推理的前沿大模型表现更优。
AI-assisted summary of 米哈游AI打游戏有多快?0.3秒碾压GPT — original source. Check the original for full context.
Source published:
Key ideas
- 米哈游崩坏AI团队联合清北等多所高校发表论文《GameScaling》,开源基于Qwen底座训练的游戏操作模型,在游戏不暂停的实时评测中,9B小模型以25.3分超越GPT与Gemini等顶级大模型。 (0:00)
- 该模型通过将微操编码为多模态Token,实现每秒读取5帧画面并输出30次键鼠操作,单步出手耗时仅0.31秒,约80%的步数无需多步推理即可依靠本能直接输出。 (0:51)
- 实验揭示了实时交互中的“规模悖论”:27B模型在暂停模式下可达逼近人类水平的62分,但因延迟上升至0.69秒,在实时模式下反而崩溃至16.7分。 (2:38)
- 评测结果存在局限性,小模型的反转仅限于快节奏动作游戏,慢节奏场景下前沿大模型仍领先约20分,且存在本地H200与云端API延迟不对等的测试条件。 (3:43)
Detailed notes
## Background 该视频由 Bilibili 频道“AI技术投降派”于 2026 年 10 月 24 日发布。视频围绕米哈游崩坏 AI 团队联合清华、北大等多所高校发表并开源的“GameScaling”论文展开,介绍了其基于纯模仿学习训练出的 9B 参数游戏模型如何在游戏不暂停的实时对抗中凭借极速响应跑赢 GPT 和 Gemini 等顶级大模型。
## TL;DR 米哈游崩坏 AI 团队与多所顶尖高校联合开源了八个游戏大模型,其中 9B 版本以眼睛每秒 5 帧、手每秒 30 次键鼠操作的高频架构,仅需 0.31 秒即可出手。在测试纯脑力的暂停模式下,Gemini 以 55.6 分大幅领先该模型的 28.5 分;但切换到游戏不冻结的实时模式后,大模型因长达数秒的思考延迟严重失常,9B 小模型反以 25.3 分登顶,呈现出“越大越聪明也越慢”的规模悖论。视频梳理了其 1600 小时公开视频模仿学习的训练细节,并列举了基准自建、本地 H200 对公网 API 等五笔冷静账本,最终指出这项研究将“延迟即能力”推向台前,为具身智能与实时人机交互提供了极具价值的工程跳板。
## Atmosphere & style 视频整体呈现出一种硬核解构与犀利克制并存的技术评论风格。博主开篇以抓人眼球的逆袭反转制造悬念,随后层层剥开模型输入输出包与延迟数据的硬指标,语速紧凑且充满思辨张力。在点燃观众对国产实习生团队创新的兴奋感后,讲述立刻切换至“冷静算账”视角,不偏不倚地剖析测试短板与局限性,在克制理性的工程思维中引发对未来具身智能形态的深度共鸣。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1DVHA62EjU?t=0s) 米哈游崩坏AI团队联合清北等多所高校发表论文《GameScaling》,开源基于Qwen底座训练的游戏操作模型,在游戏不暂停的实时评测中,9B小模型以25.3分超越GPT与Gemini等顶级大模型。 - [00:51](https://www.bilibili.com/video/BV1DVHA62EjU?t=51s) 该模型通过将微操编码为多模态Token,实现每秒读取5帧画面并输出30次键鼠操作,单步出手耗时仅0.31秒,约80%的步数无需多步推理即可依靠本能直接输出。 - [02:38](https://www.bilibili.com/video/BV1DVHA62EjU?t=158s) 实验揭示了实时交互中的“规模悖论”:27B模型在暂停模式下可达逼近人类水平的62分,但因延迟上升至0.69秒,在实时模式下反而崩溃至16.7分。 - [03:43](https://www.bilibili.com/video/BV1DVHA62EjU?t=223s) 评测结果存在局限性,小模型的反转仅限于快节奏动作游戏,慢节奏场景下前沿大模型仍领先约20分,且存在本地H200与云端API延迟不对等的测试条件。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1DVHA62EjU?t=0s) 米哈游崩坏AI团队联合清华、北大、国科大、港大及新国大,以实习生为主导开源了8个端到端会打游戏的小模型权重(基于Apache 2.0协议)。 - [00:51](https://www.bilibili.com/video/BV1DVHA62EjU?t=51s) 9B小模型通过将屏幕作为视觉输入、键鼠操作打包为Token输出,构建了每秒5帧感知与每秒30次操作的高频交互管线。 - [01:08](https://www.bilibili.com/video/BV1DVHA62EjU?t=68s) 模型每次决策输出覆盖未来200毫秒的操作包(含6个33毫秒键位步及鼠标位移),实测约80%步数无需先思考即可凭本能出手。 - [01:33](https://www.bilibili.com/video/BV1DVHA62EjU?t=93s) 在给足30秒思考的暂停模式下,Gemini以55.6分断层领先,9B小模型仅得28.5分,前沿大模型在纯脑力与复杂推理上限上优势明显。 - [01:53](https://www.bilibili.com/video/BV1DVHA62EjU?t=113s) 在游戏不暂停的实时模式中排名发生彻底反转:9B小模型以25.3分登顶,Gemini滑落至19.2分,GPT仅得17.6分。 - [02:14](https://www.bilibili.com/video/BV1DVHA62EjU?t=134s) 反转的核心原因在于决策延迟:前沿大模型单步推理需输出数百Token耗时4至24秒,而9B小模型单步仅输出35个Token且耗时仅0.31秒。 - [02:38](https://www.bilibili.com/video/BV1DVHA62EjU?t=158s) 模型采用纯模仿学习训练,基于通义千问(Qwen)基座与1600小时公开人类游戏键鼠录像进行继续预训练,未采用复杂强化学习。 - [03:02](https://www.bilibili.com/video/BV1DVHA62EjU?t=182s) 训练过程揭示出分阶段规律:底层微操与高阶游戏知识学习解耦,前期通用指标同步上涨,后期仅练过的游戏表现会持续提升。 - [03:16](https://www.bilibili.com/video/BV1DVHA62EjU?t=196s) 交互场景存在“规模悖论”:27B模型在暂停榜逼近人类(62分),但因单步推理延迟增至0.69秒,实时榜得分反而暴跌至16.7分。 - [03:55](https://www.bilibili.com/video/BV1DVHA62EjU?t=235s) 小模型逆袭存在明确边界:在慢节奏和回合制游戏中反转失效,前沿大模型凭借推理能力在慢速场景下仍能保持约20分的领先。 - [04:12](https://www.bilibili.com/video/BV1DVHA62EjU?t=252s) 当前测试存在实验偏差:四个基准有三个为团队自建,且本地H200集群部署与云端API的公网延迟存在不对等比较。 - [04:47](https://www.bilibili.com/video/BV1DVHA62EjU?t=287s) 该论文核心启示在于证明“延迟也是一种核心能力”,现实世界如机器人和自动驾驶均不暂停,端到端Token化键鼠操作为具身智能提供了新跳板。 - [05:08](https://www.bilibili.com/video/BV1DVHA62EjU?t=308s) 未来的AI演进趋势大概率将走向合流:即结合不假思索的低延迟本能操作与应对大局规划的深度思考双系统架构。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1DVHA62EjU?t=0s) 开场悬念与操作机制:眼睛每秒五帧,手每秒三十次
米哈游开始把 AI 拉来“肝游戏”了。10月22日,一篇重磅论文挂上了 arXiv,作者栏来自米哈游崩坏 AI 团队,联合清华大学、北京大学、中国科学院大学、香港大学以及新加坡国立大学;令人瞩目的是,九位作者里有好几位是米哈游的实习生。他们训练出了一批真正会打游戏的模型,能够像真人一样看着屏幕画面、亲自操作键盘鼠标,并且一口气开源了全部八个小模型。
其中一个 90 亿参数(9B)的版本,在一种极其严苛的测试中,平均分直接压过了 GPT、Gemini 等全线顶级大模型。它的特殊之处在于:测试环境中的游戏绝对不会暂停等待模型去深度思考。模型在交互层面展现了惊人的响应架构:它的眼睛是屏幕,每秒读取 5 帧画面;手是键鼠,每秒能输出 30 次操作。关键在于,每次做决策时它吐出的不是单个独立动作,而是一份覆盖未来 200 毫秒的完整“操作包”——包含 6 个键位步(每步 33 毫秒),加上鼠标的位移与滚轮滚动。这些微操指令被编码成专门的 Token,让模型像念台词说话一样将它们直接吐出。在思考机制上,模型可以自由选择“先想后动”或者“直接出手”,而实测数据显示,它有大约八成的步数根本不需要思考,完全做到了看到画面就肌肉记忆般地直接开打。
```mermaid flowchart LR accTitle: 游戏AI输入输出流 accDescr: 展示模型从视觉输入到每秒三十次键鼠操作包的输出管线 subgraph S1["感知层"] A["屏幕画面 (每秒 5 帧)"] end subgraph S2["决策层 (9B 模型)"] B{"思考机制判定"} B -->|"约 20% 步数"| C["先推理后动作"] B -->|"约 80% 步数"| D["不思考直出 Token"] end subgraph S3["执行层 (200ms 操作包)"] E["6 步按键 (每步 33ms)"] F["鼠标位移与滚轮"] end A --> B C --> E D --> E C --> F D --> F ```
[01:33](https://www.bilibili.com/video/BV1DVHA62EjU?t=93s) 核弹数据:暂停榜被碾压,实时榜大翻转
研究团队专门设计了两种截然不同的测试环境。第一种是“暂停模式”,当模型需要决策时游戏画面彻底冻结,足足给模型留出 30 秒慢慢构思,这测验的是模型的纯脑力与复杂推理上限;第二种则是“实时模式”,游戏引擎完全照常运转,你思考的每一秒钟,对手都在移动,子弹都在空中飞。两组测试的结果呈现出戏剧性的反差:
| 测试模式 | Gemini | Game Scaling (9B) | GPT | 说明与特点 | |:--- |:--- |:--- |:--- |:--- | | **暂停模式(冻结30秒)** | **55.6 分**(断层领先) | 28.5 分(惨遭碾压) | 未单独提分数,整体由大模型领跑 | 测验纯推理脑力,大模型凭借多步思考占优 | | **实时模式(游戏不暂停)** | 19.2 分(大幅滑落) | **25.3 分**(逆袭登顶) | 17.6 分(其后为 Claude 等) | 测验手速与反应,前沿大模型因推理延迟被淘汰 |
翻开延迟对比表,这一反转的底层逻辑一目了然:那些行业顶尖的前沿模型每走一步都需要输出几百个 Token 进行复杂推理,单次出手耗时在 4 秒到 24 秒之间;而这套名为 Game Scaling 的小模型,每步仅需输出 35 个 Token,只要 0.31 秒即可出手。针对这一现象,作者在论文中用非常尖锐的语言点破了核心痛点,原话强调:“前沿模型可以暂停,世界不会。”在快节奏的射击与动作对抗游戏里,迟来的聪明根本毫无意义。
[02:38](https://www.bilibili.com/video/BV1DVHA62EjU?t=158s) 训练秘诀与规模悖论:纯模仿与越大越慢
这个模型究竟是如何练就这身肌肉记忆的?它并没有依赖耗时且难以调优的强化学习,而是直接采用了纯模仿学习的思路。团队收集了 1600 小时的人类键鼠录像,全部提取自公开的游戏轨迹数据集,内容广泛覆盖了 80 个不同的游戏世界(从《我的世界》(Minecraft)一直到各类高强度射击游戏)。其基座选用开源的通义千问(Qwen)视觉语言模型,在此基础上直接进行继续预训练。
在遍历测试了 120 种训练配置的过程中,团队总结出两条关键规律: - **阶段性学习规律**:学会键鼠底层微操与理解游戏世界的高阶知识是完全分开的两个阶段。在训练前期,模型在所有测试游戏上的基准分数都在同步上涨;而到了训练后期,唯独只有那些模型实际深度练习过的具体游戏,分数才会继续拔高。 - **规模悖论(越大越聪明,也越大越慢)**:传统的 Scaling Law 依然成立,但引入了一个残酷的反例。团队训练的 270 亿参数(27B)版本,在暂停模式下能拿到逼近人类水准(70 分)的 62 分高分;然而因为体量膨胀,它每走一步需要 0.69 秒,在残酷的实时榜单上得分直接崩溃到了 16.7 分。
此外,研究人员还做了一个有趣的推理实验:在测试时将动作步数上限从 600 步放宽提升到 3000 步,小模型的表现直接从 4.2 分跃升到了 5.9 分,充分证明这类端到端控制模型具有“越让它打、韧性越强”的特质。
[03:43](https://www.bilibili.com/video/BV1DVHA62EjU?t=223s) 冷静账本:欢呼前必须看清的五笔账
在全面审视这一战果时,观众不能只沉浸在“小模型逆袭 GPT”的狂欢中,视频博主列出了五笔必须算清的冷静账本: 1. **纯脑力上的落败**:在不设时间限制的暂停榜上,55.6 对 28.5 的分数落差是实打实的,纯脑力维度的差距摆在台面上,实时榜的逆袭完全是依靠极致的出手速度。 2. **适用场景极其受限**:反转仅存在于快节奏动作对抗中;在慢节奏以及回合制游戏基准测试里,反转立刻失效,前沿大模型的实时得分依然能甩开小模型整整 20 分。 3. **评测基准的主客场偏差**:评测所用的四个基准环境里,有三个是团队自己搭建的内部环境,对手模型的运行测试也全由该团队自行部署运行。 4. **硬件部署的不对等**:Game Scaling 跑在团队本地的高性能 H200 集群上,而 GPT 等前沿模型则是通过云端 API 交互,天然背负了公网传输延迟。对于这一点,论文作者自身也大方承认,并呼吁未来业界的对比环境应当更加透明公平。 5. **项目性质与数据范畴**:该成果大概率是几位米哈游实习生主导的研究探索,并非米哈游对外发布的公司级核心战略,且挂在 arXiv 上的预印本尚未经过严格的同行评议;此外,训练所用数据完全来自公开数据集,并未动用米哈游自家的任何未公开游戏资产。
[04:47](https://www.bilibili.com/video/BV1DVHA62EjU?t=287s) 终局判断:延迟即能力,具身智能的新跳板
这篇论文带来的真正行业启示,在于它把一个长期被主流大模型圈子忽视的关键变量摆到了桌面上:延迟本身就是一种核心能力。正如博主总结的那样:“现实世界从来不会暂停等AI思考机器人和自动驾驶,还有真实的人机交互,全是实时模式。”
当全行业的大模型路线都在狂热追求思维链和极度深度的慢思考时,这项工作从工程上证明了另一条并行的可能性:通过继续预训练把极速响应的本能直接“烧”进模型的骨架里,做到小而快也能克敌制胜。在未来的技术演进中,两条路线大概率会走向合流——在遇到突发威胁与即时操作时做到不假思索的本能反应,在需要长期规划的大局判断时调用深度推理链条。
对于游戏与 AI 工业界而言,这种将键鼠转化为多模态 Token 的端到端操作范式,本身就是通往通用具身智能的一块极佳跳板,而米哈游的实习生们顺手把这块跳板彻底开源了。对于这场技术实验,后续应当重点紧盯三件事:外部第三方团队复测该模型的真实数据、引入强化学习后小模型的性能上限究竟在哪里,以及各家一线游戏厂商是否会真正开始把这类实时模型接入商业游戏。该论文在 arXiv 搜索“GameScaling”即可查阅,所有模型权重已在 Hugging Face 依照 Apache 2.0 协议全量开源。
## Notable quotes > [01:33](https://www.bilibili.com/video/BV1DVHA62EjU?t=93s) 前沿模型可以暂停,世界不会。 — 论文作者
## Mentioned 米哈游, 米哈游崩坏 AI 团队, 清华大学, 北京大学, 中国科学院大学, 香港大学, 新加坡国立大学, Game Scaling, GPT, Gemini, Claude, 通义千问 (Qwen), 我的世界 (Minecraft), Nvidia H200, arXiv, Hugging Face, Apache 2.0
## Video description 米哈游把 AI 拉来肝游戏了。十月二十二号,一篇论文挂上 arXiv:米哈游崩坏 AI 团队联合清华北大、国科大、港大与新加坡国立大学,九位作者里好几位是米哈游实习生。他们训练了一批会打游戏的模型:看着画面,自己操作键盘鼠标,八个小模型全部开源。其中九十亿参数的版本,在"游戏不会暂停等它思考"的实时测试里,四项基准平均分二十五点三,压过了 GPT、Gemini、Claude 全线大模型。凭什么?出手快:前沿模型每步想四到二十四秒,它只要零点三一秒。 00:05 开场:论文与"9B 压过 GPT"的悬念 00:51 机制:眼睛每秒五帧,手每秒三十次 01:33 核弹:暂停榜被碾压,实时榜大翻转 02:38 训练法:一千六百小时录像纯模仿 03:43 冷静账本:五笔账看完再鼓掌 04:47 判断:延迟也是能力 它怎么玩:每秒看五帧画面,每秒三十次操作,每次输出未来两百毫秒的完整操作包——六个键位步每步三十三毫秒,加鼠标位移和滚轮。实测约八成步数不思考直接出手。核弹在两种测试的对比:暂停榜上 Gemini 五十五点六断层领先,九十亿小模型只有二十八点五;切到实时榜,游戏照跑,同一个模型升到二十五点三排第一。训练用一千六百小时公开键鼠录像、八十个游戏世界、一百二十种配置网格,Qwen3.5 底座继续预训练纯模仿。有趣的是规模悖论:二百七十亿暂停模式六十二分逼近人类七十,实时反而崩到十六点七——越大越聪明,也越大越慢。 冷静的部分:暂停榜是真输;慢节奏游戏上反转不成立,前沿模型仍高约二十分;四个基准三个自建自测;部署不对等(自家 H200 对云端 API);实习生研究非公司战略,arXiv 未经同行评议;训练数据来自公开集,没用米哈游自家游戏。我的判断:这篇论文把"延迟也是能力"摆上台面——现实世界从不暂停,机器人、自动驾驶全是实时模式;小而快与深度思考两条路线大概率合流。接下来盯外部复测、加强化学习后的上限、游戏厂商会不会接入。论文 arXiv 搜 GameScaling,权重在 Hugging Face,Apache 2.0。
[Source](https://www.bilibili.com/video/BV1DVHA62EjU)