月之暗面发布K3.1 Pro 凭纯后训练强化学习追平闭源前沿
AI技术投降派
底座架构不变仅靠大规模后训练即可缩小与闭源前沿差距,但2.8T参数极高的私有化部署门槛与缺乏独立验证仍是核心制约。
AI-assisted summary of 认输三个月后 Kimi3.1pro靠调教杀回来了 — original source. Check the original for full context.
Source published:
Key ideas
- 月之暗面发布 K3.1 Pro,在不改变 2.8T MoE 底座架构和预训练的前提下,仅依靠扩大后训练算力与强化学习,在 14 项官方基准中拿下 8 项第一。 (0:00)
- K3.1 Pro 在编程智能体与长程任务表现亮眼且幻觉率大幅下降,但科学推理仅 38.1 分,落后 GPT-6 Astra 的 68.1 分,呈现出明显的偏科特征。 (1:13)
- 月之暗面主动清除攻防训练数据以削弱网络攻击能力,其内部安全基准从 90.5 降至 81.0,成为首个公开声明“为安全削减智能”的开源模型。 (2:44)
- 商业化方面 API 降价三分之一并推 2-3 倍速的高速版,但模型极限压缩仍需 600GB 显存,私有化部署起步门槛高达 8 卡节点。 (3:38)
Detailed notes
## Background 该视频由 Bilibili UP 主“AI技术投降派”于 2026 年 10 月 24 日发布。视频简介指出,在三个月前坦承落后之后,月之暗面深夜交出答卷 K3.1 Pro,依靠纯后训练与大规模强化学习在 14 项基准中拿下 8 项第一,同时视频深入对账其成绩单、主动削减攻防智能的争议以及部署门槛等现实冷水。
## TL;DR Kimi K3.1 Pro 在未变更底层 2.8T MoE 架构与预训练的前提下,仅依靠后训练算力大幅增加与强化学习,在编程、长程任务及办公等多项基准上逼近或超越闭源前沿,并大幅压低了幻觉率。与此同时,月之暗面为安全考量主动清除网络攻防数据,成为业内首个公开声明削减智能以保安全的开放权重模型。尽管官方降价并推出高速版,作者仍提醒观众保持冷静:目前数据全为官方自测、科学推理存在严重偏科,且 2.8T 参数导致本地部署需 8 卡节点起步,最终实效仍待 11 月 4 日权重正式放出后的社区检验。
## Atmosphere & style 全片充斥着理性、克制且略带反思的极客科技观察氛围,没有盲目的狂欢与捧杀。创作者以一种既赞赏其工程突破、又警惕宣发滤镜的冷峻视角逐项对账,叙事节奏紧凑扎实,用词犀利接地气。听众能强烈感受到从“翻盘惊艳”迅速切换到“连泼冷水”的情绪反差,整体呈现出清醒、务实的硬核技术复盘质感。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1UEHA6VEMa?t=0s) 月之暗面发布 K3.1 Pro,在不改变 2.8T MoE 底座架构和预训练的前提下,仅依靠扩大后训练算力与强化学习,在 14 项官方基准中拿下 8 项第一。 - [01:13](https://www.bilibili.com/video/BV1UEHA6VEMa?t=73s) K3.1 Pro 在编程智能体与长程任务表现亮眼且幻觉率大幅下降,但科学推理仅 38.1 分,落后 GPT-6 Astra 的 68.1 分,呈现出明显的偏科特征。 - [02:44](https://www.bilibili.com/video/BV1UEHA6VEMa?t=164s) 月之暗面主动清除攻防训练数据以削弱网络攻击能力,其内部安全基准从 90.5 降至 81.0,成为首个公开声明“为安全削减智能”的开源模型。 - [03:38](https://www.bilibili.com/video/BV1UEHA6VEMa?t=218s) 商业化方面 API 降价三分之一并推 2-3 倍速的高速版,但模型极限压缩仍需 600GB 显存,私有化部署起步门槛高达 8 卡节点。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1UEHA6VEMa?t=0s) 月之暗面在三月前坦承落后于 Fable 5 和 GPT 5.6 Sol 后交卷,正式发布追平闭源前沿的 K3.1 Pro。 - [00:33](https://www.bilibili.com/video/BV1UEHA6VEMa?t=33s) K3.1 Pro 延续 2.8 万亿参数 MoE 底座与 KDA 线性注意力架构,性能跃升完全来自纯后训练算力与强化学习扩张。 - [00:33](https://www.bilibili.com/video/BV1UEHA6VEMa?t=33s) 海外社区将 K3.1 Pro 视作继 DeepSeek-R1 后开放权重模型再次逼近闭源前沿的代表作,验证了“底座不改仅靠调教”的技术路径。 - [01:13](https://www.bilibili.com/video/BV1UEHA6VEMa?t=73s) 在 Terminal-Bench 4.0 编程智能体测试中取得 65.7 分,超越 GPT-6 Astra 并逼近 Claude Opus 5.5。 - [01:13](https://www.bilibili.com/video/BV1UEHA6VEMa?t=73s) 长程任务与办公基准均夺得第一,且带工具调用的幻觉率从 23.4% 骤降至 8.3%,不带工具的声明级幻觉率仅为 5.4%。 - [01:13](https://www.bilibili.com/video/BV1UEHA6VEMa?t=73s) 模型存在严重短板,在 Terminal-Bench Science 科学推理上仅获 38.1 分,被 Astra 的 68.1 分碾压,定性为全能型老二。 - [02:10](https://www.bilibili.com/video/BV1UEHA6VEMa?t=130s) API 价格降至每百万 Token 输入 13 元、输出 68 元,并推出提速 2 至 3 倍但价格翻倍的 Highspeed 版本以缓解吐字慢问题。 - [02:44](https://www.bilibili.com/video/BV1UEHA6VEMa?t=164s) 研发过程中模型自发涌现网络攻防能力,官方追溯并清除相关语料,内部攻防基准从 90.5 分主动降至 81.0 分。 - [02:44](https://www.bilibili.com/video/BV1UEHA6VEMa?t=164s) 全球首例“为安全削减智能”引发海外争议:支持者认可数据清洗优于易被微调绕过的拒答,防御工程师则担忧白帽工具效能受损。 - [03:38](https://www.bilibili.com/video/BV1UEHA6VEMa?t=218s) 目前成绩全为官方自测且部分竞品采用宣传口径对比,独立复现数据尚未出炉,仍需警惕此前 K3 跑分高但实际体感差的前科。 - [03:38](https://www.bilibili.com/video/BV1UEHA6VEMa?t=218s) 2.8T 原生权重达 1.56TB,极限压缩后也需 600GB 显存,普通开发者仅能用于技术测试,实用私有化部署需 8 卡节点起步。 - [04:24](https://www.bilibili.com/video/BV1UEHA6VEMa?t=264s) Artificial Analysis 给予 1846 分位列总榜第三,社区逐步形成“Kimi 负责规划、DeepSeek 负责执行”的分工落地思路。 - [04:55](https://www.bilibili.com/video/BV1UEHA6VEMa?t=295s) K3.1 Pro 证明在架构确定后,大规模后训练本身也是一条推动模型能力跃进的核心前沿路径,完整权重定于 11 月 4 日前开源。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1UEHA6VEMa?t=0s) 认输三月后交卷:纯后训练驱动的 K3.1 Pro
三个月前介绍 Kimi K3 的时候,月之暗面官方曾在博客里坦诚认输,直言“整体性能仍落后于 Fable 5 和 GPT 5.6 Sol”。然而就在昨天深夜,月之暗面正式交出了升级答卷——K3.1 Pro。该模型在官方公布的 14 项基准评测中一举拿下 8 项第一,被官方称为目前开放权重模型中的最强者。
对于 K3.1 Pro 究竟是什么,官方的说明非常直白:“它是 K3 的后训练版本,后训练算力大幅增加。”换言之,它并没有更换底层架构,底座依旧延续了此前 2.8 万亿参数(2.8T)的混合专家架构(MoE),预训练未动,架构未换。海外社区普遍认为,这是继 DeepSeek-R1 之后,开放模型第一次追平闭源前沿。这一突破完全依赖更长、更大规模的强化学习,正所谓“发动机没换,调教把成绩提上来了”。
```mermaid flowchart LR accTitle: K3 到 K3.1 Pro 的演进路径 accDescr: 展示 Kimi 底座架构保持不变,仅依靠后训练算力与强化学习实现性能突破
subgraph Base["底层架构(未变更)"] A["2.8 万亿参数 MoE 底座"] B["KDA 线性注意力 / 每 token 激活 104B"] end
subgraph PostTrain["后训练升级"] C["后训练算力大幅增加"] D["大规模强化学习"] end
subgraph Result["产出成果"] E["K3.1 Pro(追平闭源前沿)"] end
Base --> PostTrain --> Result ```
[01:13](https://www.bilibili.com/video/BV1UEHA6VEMa?t=73s) 跑分成绩单:8 项第一与明显的偏科
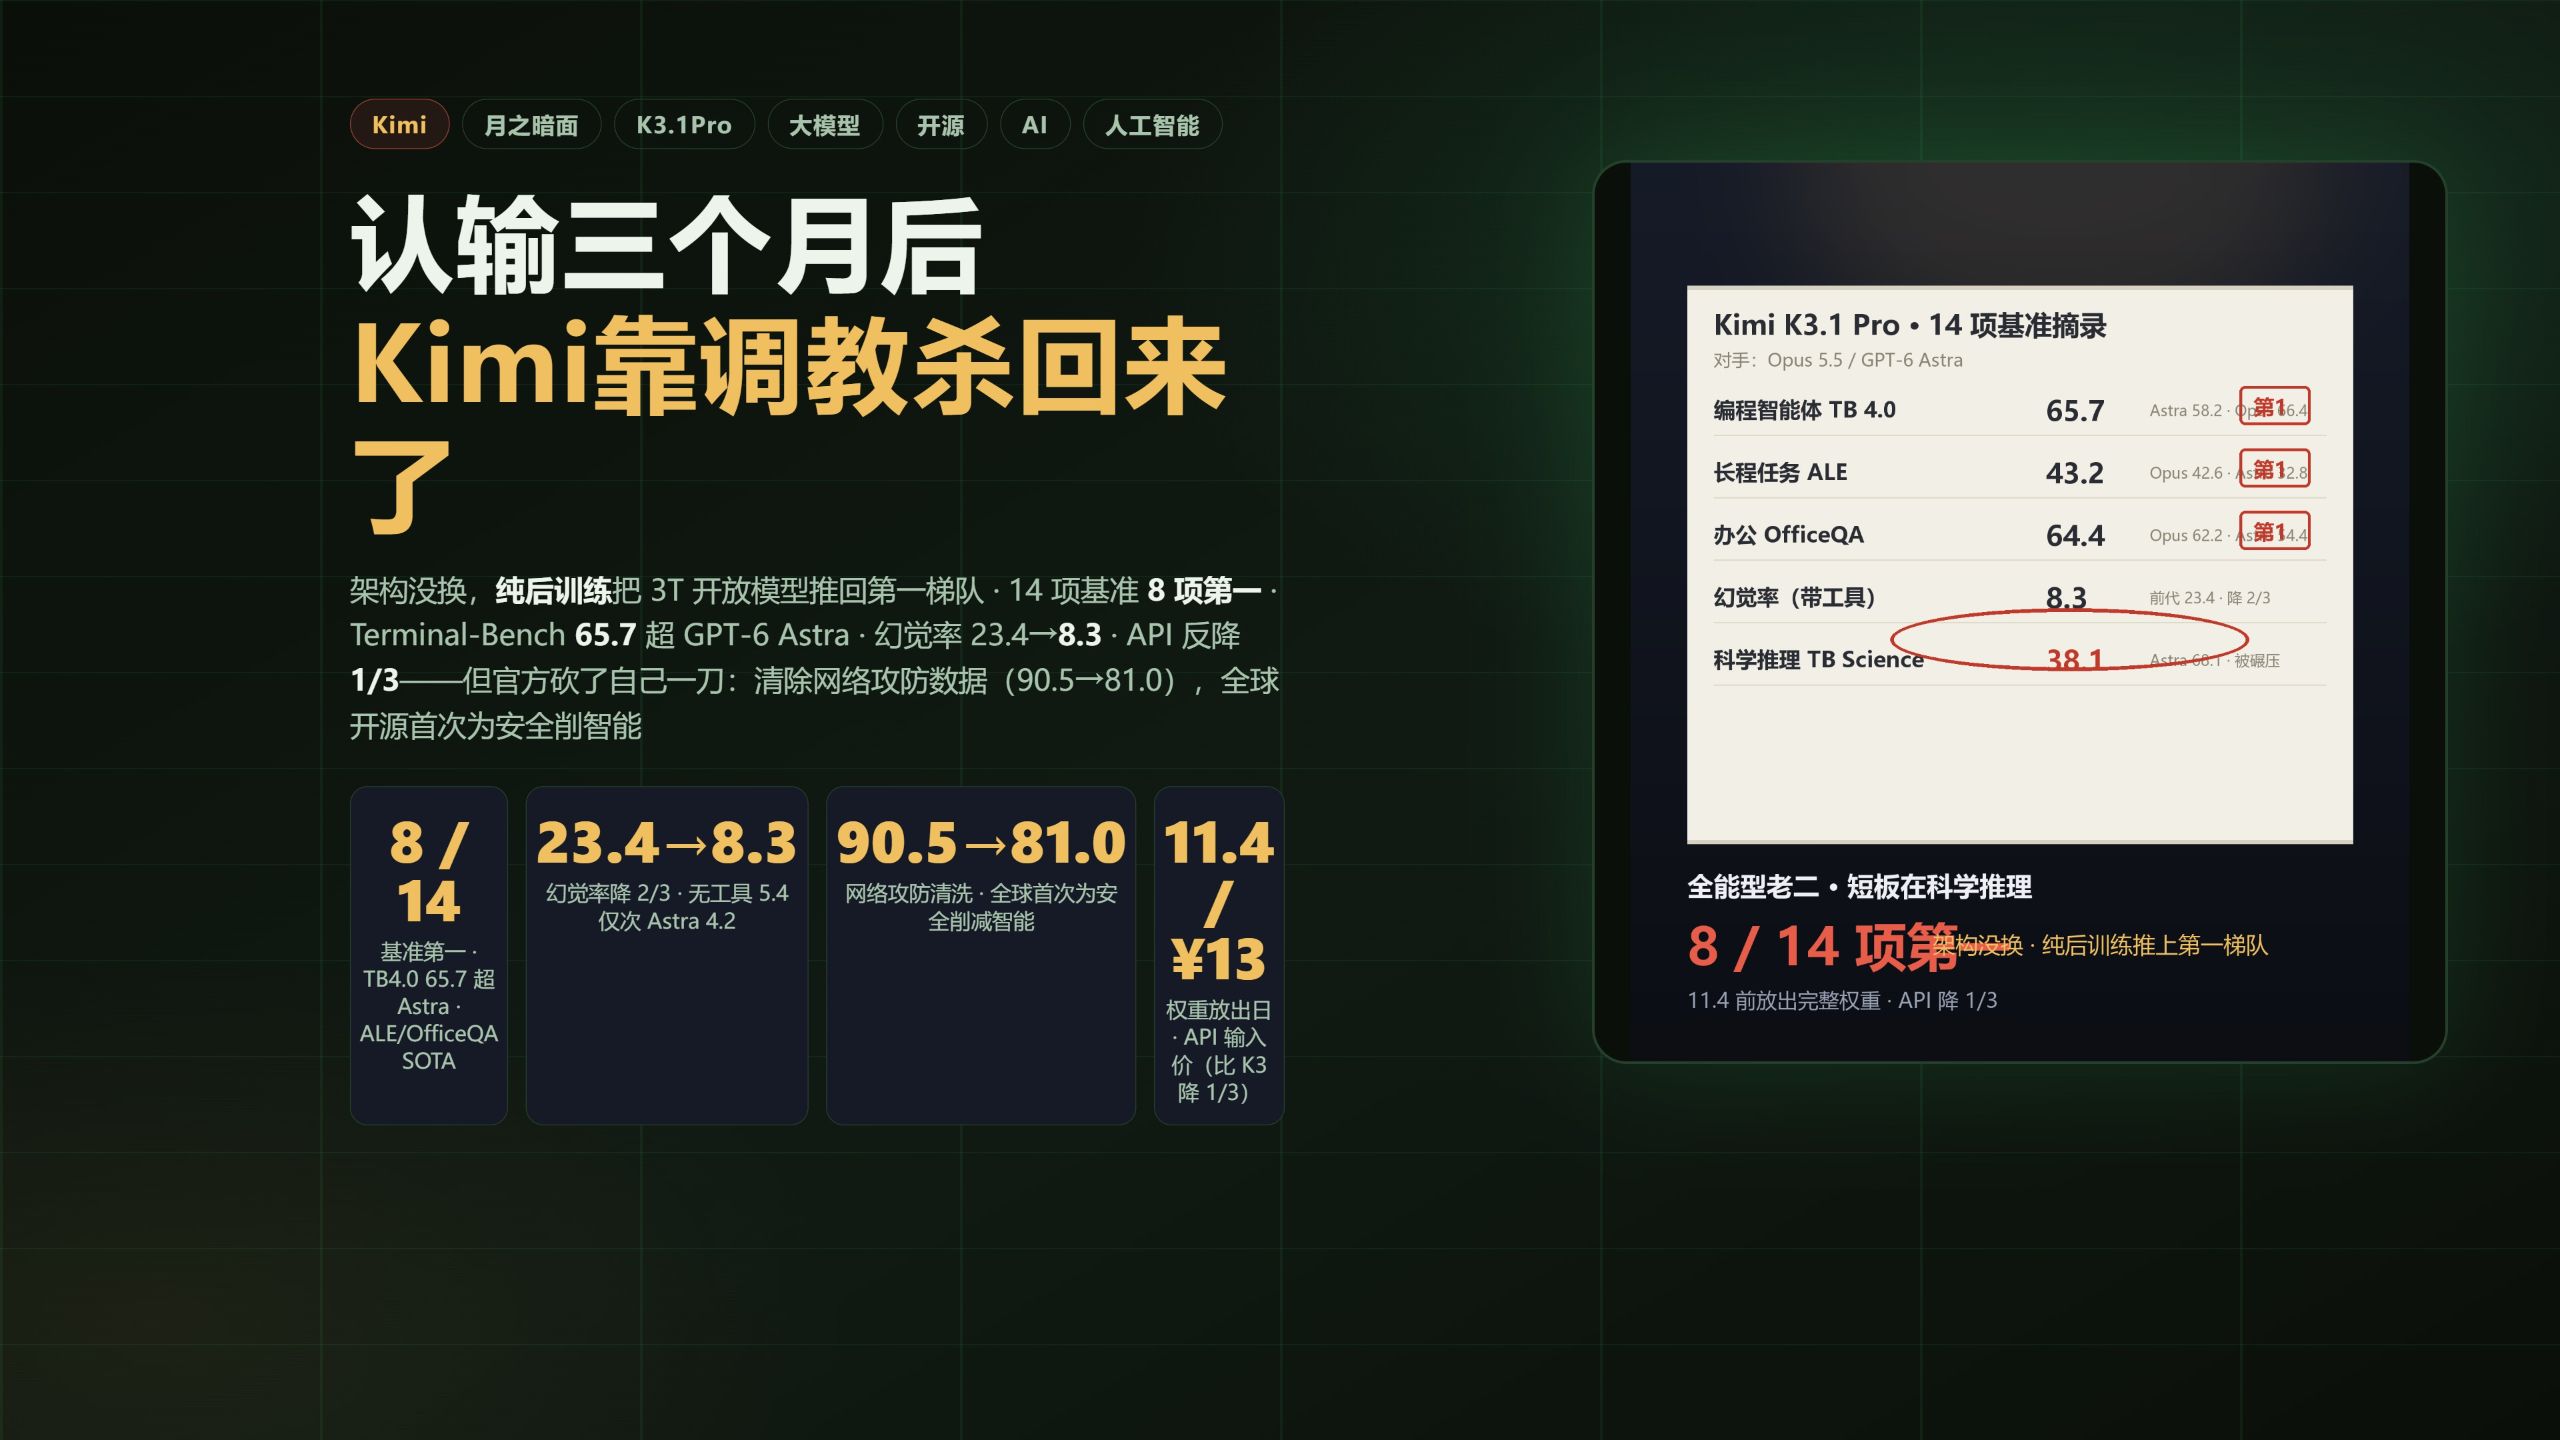
从官方公布的基准测试看,K3.1 Pro 在多个前沿任务上表现抢眼。在编程智能体基准 Terminal-Bench 4.0 中,K3.1 Pro 取得 65.7 分,击败了 GPT-6 Astra 的 58.2 分,仅略逊于 Opus 5.5 的 66.4 分;在长程任务基准 Agent's Last Exam 中拿到 43.2 分位列第一;在办公基准 Office QA 中以 64.4 分同样拔得头筹。提升最显著的是幻觉控制能力:在带工具调用场景下,幻觉率从 K3 的 23.4% 断崖式下降至 8.3%;在不带工具的声明级幻觉测试中仅为 5.4%,只略逊于 Astra 的 4.2%,明显好于 Opus 与 Fable。
不过,官方在展示 8 项第一的同时,也没有回避偏科问题。在科学推理基准 Terminal-Bench Science 上,K3.1 Pro 仅获得 38.1 分,被 Astra 的 68.1 分彻底碾压。作者将其定位为“全能型老二,短板也很明显”。此外,在商业化与可用性方面,月之暗面做出了两项关键调整: - **价格下调三分之一**:API 价格降至每百万 Token 输入 13 元、输出 68 元,直接回应成本顾虑。 - **推出 Highspeed 高速版**:针对此前社区对 K3 吐字慢的集中抱怨,高速版将输出速度提升 2 至 3 倍,价格则相应翻倍。 - **权重开源日程**:官方承诺完整模型权重将在 11 月 4 日前放出,但许可证条款目前尚未正式公布。
| 评估维度 / 基准测试 | Kimi K3.1 Pro | GPT-6 Astra | Claude Opus 5.5 | 表现定性 | |:--- |:--- |:--- |:--- |:--- | | **编程智能体 (Terminal-Bench 4.0)** | 65.7 | 58.2 | 66.4 | 超越 Astra,略逊 Opus | | **长程任务 (Agent's Last Exam)** | 43.2 | 未列出 / 较低 | 未列出 / 较低 | 位列第一 | | **办公基准 (Office QA)** | 64.4 | 未列出 / 较低 | 未列出 / 较低 | 位列第一 | | **工具场景幻觉率 (越低越好)** | 8.3% (原 23.4%) | 未提及 | 未提及 | 进步巨大 | | **声明级幻觉率 (越低越好)** | 5.4% | 4.2% | 高于 5.4% | 优于 Opus 与 Fable | | **科学推理 (Terminal-Bench Science)** | 38.1 | 68.1 | 未提及 | 严重偏科,差距悬殊 |
[02:44](https://www.bilibili.com/video/BV1UEHA6VEMa?t=164s) 主动砍一刀:为安全削减智能
本次发布最受瞩目且具争议的事件,是月之暗面官方“主动砍了自己一刀”。在模型强化学习训练过程中,研发团队发现随着规模扩大,模型的网络攻防对抗能力会自动水涨船高,并非团队刻意诱导,而是“练着练着就长”。为此,月之暗面追溯了语料与训练环境,主动清除了所有网络攻防相关的训练数据,并为此付出了明确的性能代价:其内部攻防基准测试成绩从未清洗版本的 90.5 分直降至最终发布版的 81.0 分。
官方就此公开承诺,绝不发布推进网络攻防绝对前沿的开放权重模型。这被认为是全球开源模型史上第一次公开声明“为了安全削减智能”,随即在海外开发者与安全社区引发激烈交锋: - **支持方立场**:认为直接从底层移除数据远比后期设置“拒答规则”靠谱得多,因为后置的拒答容易被下游微调绕过或洗掉,而“数据不在就是不在”。 - **反对方立场(防御工程师)**:对这一做法提出质疑,有安全专家明确表态:“我恰恰需要擅长找漏洞的模型”,认为削减网络攻防能力反噬了白帽防御者的工具效能。
[03:38](https://www.bilibili.com/video/BV1UEHA6VEMa?t=218s) 三盆冷水与外部评价:部署门槛与落地分工
面对发布引发的热潮,作者给出了三盆冷静的冷水: - **第一盆冷水(缺乏独立验证)**:发布不到一天,目前所有亮眼跑分均为月之暗面的官方自测,尚无第三方独立复现。且其博客引用的竞品数据存在统计口径差异,例如 Opus 5.5 在官方基准榜单中为 64.8 分,而月之暗面博客采用的是对手宣传口径的 66.4 分。 - **第二盆冷水(体感与跑分脱节的前科)**:上一代 K3 曾出现“跑分惊艳但实际体验落差大”的反馈,同时订阅限额过低的问题也曾遭遇集中吐槽,本次升级能否彻底改善真实体验仍待观察。 - **第三盆冷水(极高的私有化部署门槛)**:“3T 是企业的 3T”,2.8 万亿总参数的原生权重高达 1.56 TB,即便利极限压缩也需要 600 GB 显存,消费级与普通个人设备仅能进行技术性测试运行,若想真正私有化部署,必须以 8 卡计算节点起步。
在外部独立评价方面,评测机构 Artificial Analysis 给予 K3.1 Pro 1846 分的高分,总榜位列第三,仅次于 Opus 5.5,相比原版 K3 跃升了 300 多分。行业分析普遍指出,当前顶尖开放模型落后闭源前沿约 6 个月,而 DeepSeek V4.1 Flash 大约落后 12 个月。社区中正形成一套务实的协作打法:“规划交给 Kimi,执行交给 DeepSeek。”
正如作者最后总结的行业启示,三个月前月之暗面主动认输,三个月后交出一份 8 项第一、降价三分之一并树立安全治理先例的答卷;在技术路线上,“架构创新还能再挖出一大块红利,K3.1 补了下半句,架构定了之后,后训练本身就是一条前沿。”这套模型的真正实力,仍要等到 11 月 4 日权重正式开源、独立评测出炉后才能见分晓。
## Notable quotes > [03:38](https://www.bilibili.com/video/BV1UEHA6VEMa?t=218s) 架构定了之后,后训练本身就是一条前沿。 — AI技术投降派
> [03:38](https://www.bilibili.com/video/BV1UEHA6VEMa?t=218s) 规划交给 Kimi,执行交给 DeepSeek。 — 开源社区开发者
## Mentioned 月之暗面, Kimi K3, Kimi K3.1 Pro, Fable 5, GPT 5.6 Sol, GPT-6 Astra, Claude Opus 5.5, DeepSeek-R1, DeepSeek V4.1 Flash, Terminal-Bench 4.0, Agent's Last Exam, Office QA, Terminal-Bench Science, Artificial Analysis, AI技术投降派
## Video description 三个月前我们讲 Kimi K3 的时候,官方在博客里说了句大实话:整体性能仍落后于 Fable 5 和 GPT 5.6 Sol。昨天深夜,月之暗面交卷了:K3.1 Pro,14 项基准 8 项第一。这次逐项对账。
先说它是什么:不是新架构。官方原话,"K3 的后训练版本,后训练算力大幅增加"。底座还是 2.8 万亿参数、每 token 激活 104B、KDA 线性注意力,预训练没动,架构没换,提升全部来自大规模强化学习。国外社区的判断:这是 R1 之后开放模型第一次追平闭源前沿,而且靠的是光训练更久——发动机没换,调教把成绩提上来了。
成绩单:Terminal-Bench 4.0 拿 65.7,超过 GPT-6 Astra 的 58.2,略逊 Opus 5.5;长程任务、办公基准拿第一;幻觉率从 23.4 降到 8.3,不带工具时 5.4 只比 Astra 差一点。偏科也照实说:科学推理 38.1,被 Astra 的 68.1 碾压。全能型老二,短板明显。
最有意思的一件事:官方主动砍了自己一刀。训练中发现网络攻防能力随强化学习自动上升,他们追溯语料、清除了相关数据——内部攻防基准从 90.5 降到 81.0。这是全球开源模型第一次公开声明"为了安全削减智能"。国外社区吵翻了:支持方说数据移除比拒答靠谱,拒答能被微调掉,数据不在就是不在;反对的防御工程师说,我恰恰需要擅长找漏洞的模型。
价格反而降了三分之一(输入 13 元/输出 68 元),Highspeed 版快 2-3 倍回应"K3 太慢"的批评。三盆冷水也要泼:发布不到一天全是官方自测,独立验证没出;K3 有跑分高体感差的前科;2.8T 参数极限压缩还要 600GB,自部署八卡节点起步。完整权重 11 月 4 日前放出,许可证还没公布。
00:05 三个月前的认输与这次交卷 00:33 不是新架构:纯后训练推前沿 01:13 成绩单:8项第一与偏科 02:10 价格反降与 11.4 权重日 02:44 主动砍一刀:为安全削智能 03:38 三盆冷水 04:24 外部评价:AA第三与规划执行分工 04:55 架构红利上半句,后训练下半句
[Source](https://www.bilibili.com/video/BV1UEHA6VEMa)