MiniMax交付M3.1 Flash权重 250GB内存门槛与商用限制引关注
AI技术投降派
尽管MiniMax按期上线经QAT量化的开源权重并采取全天平价策略,但250GB起步的物理内存硬门槛与两千万美元营收授权条款,令个人与大企业端落地面临重重现实约束。
AI-assisted summary of MiniMax开放M3.1Flash权重,数据测评 — original source. Check the original for full context.
Source published:
Key ideas
- MiniMax M3.1-Flash 权重准时在海外模型仓库、魔搭社区与托管平台同步上线,包含 48 个分片与 1 个用于推测解码的两亿参数草稿头,主流推理框架与国内芯片厂商已完成 Day-0 适配。 (0:00)
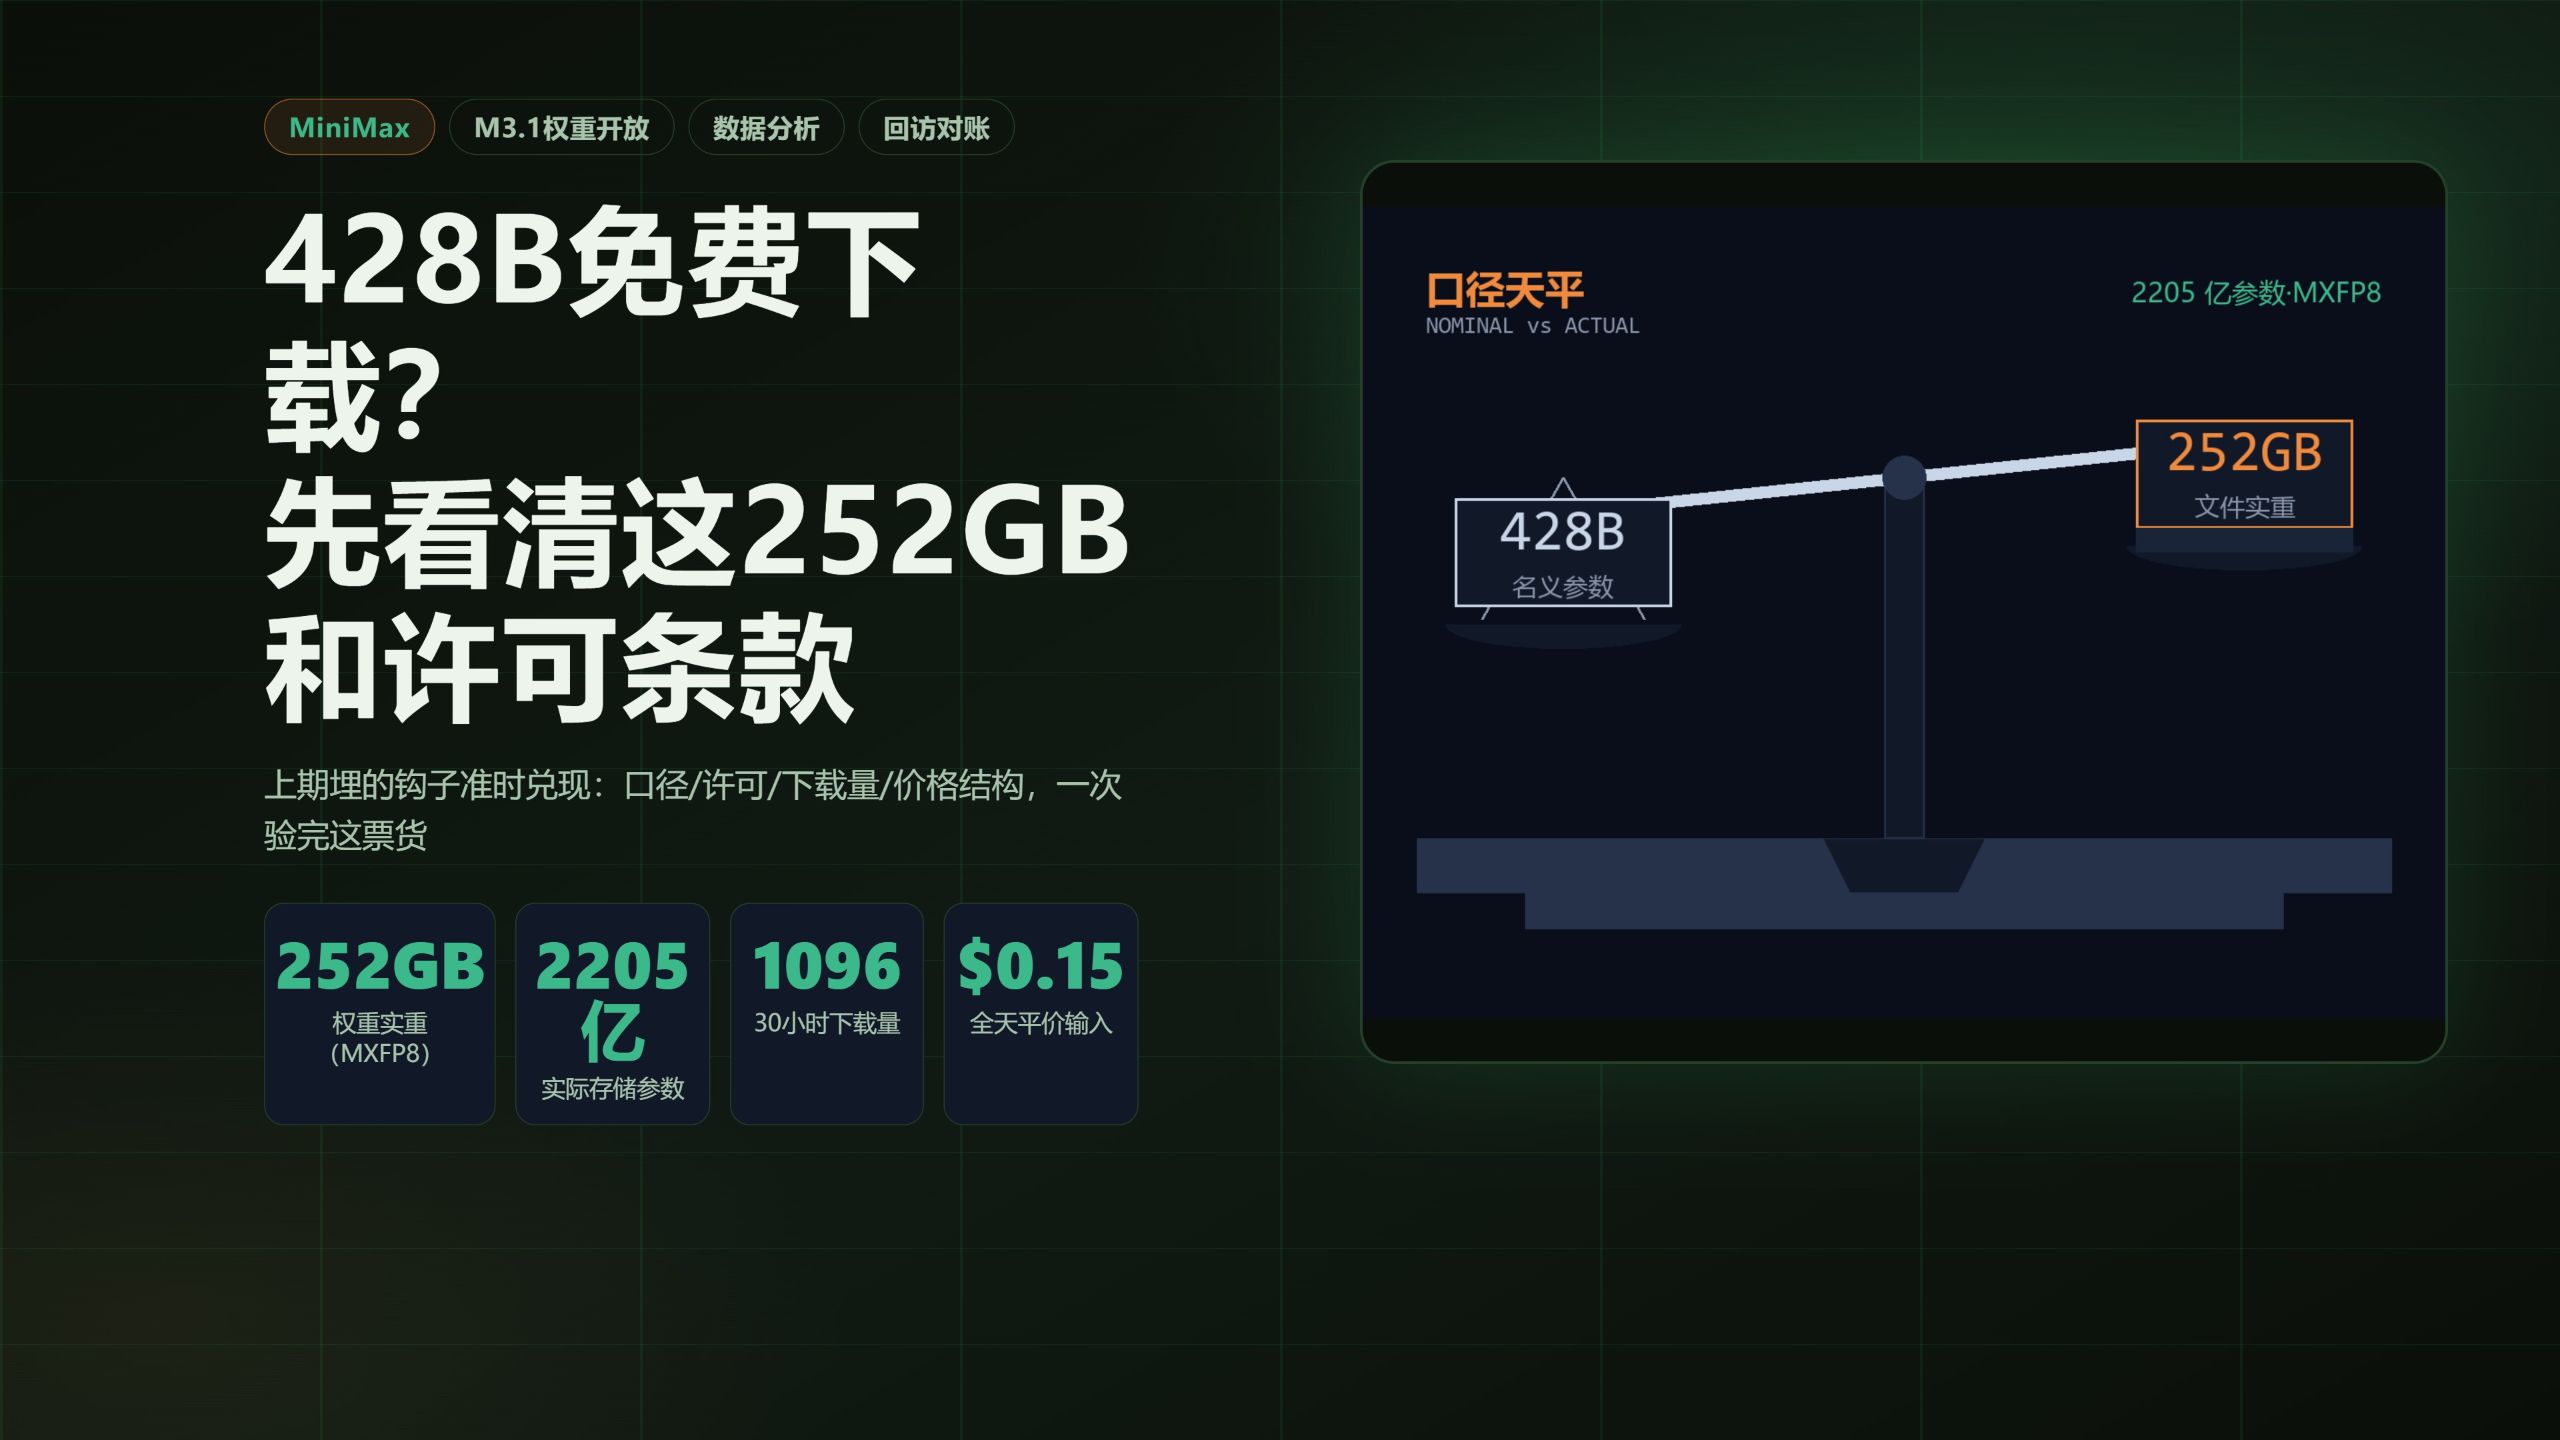
- 官方宣称的名义参数为 428B,但实际下载文件体积为 252GB,系采用量化感知训练(QAT)直接打包发行,内部实际存储约 2205 亿参数且大多数专家采用低比特打包。 (0:00)
- 许可证采用自定义社区协议而非宽松的 MIT 许可,商用免费但必须显著署名,且年营收超过 2000 万美元的企业需另行获取官方书面授权。 (2:08)
- API 定价采取全天平价策略(输入 $0.15/M tokens,输出 $0.60/M tokens),对比 DeepSeek 咬死其谷时价但无峰时翻倍,更适合连续重负载的 Agent 场景。 (3:40)
- 本地部署门槛极高,运行内存需 250GB 以上起步,声称 16G 显卡能跑属于标题党;基准测试在计算机使用上领先十多分,但在代码 Agent 与第三方综合评测上略逊于竞品。 (3:40)
Detailed notes
## Background 该视频由 Bilibili 频道“AI技术投降派”于 2026 年 10 月 24 日发布。视频围绕 MiniMax 旗下 M3.1 Flash 模型权重的准时开源展开,作者在简介中明确表示本期不谈模型跑分高低,只专注于对文件大小、许可协议、下载冷启动、定价结构与实测门槛进行逐项“到站验货”。
## TL;DR MiniMax 如期在多平台同步开源了 M3.1 Flash 模型权重,包含 48 个权重分片与专用于推测解码的独立草稿头。虽然名义口径宣称为 428B,但因采用量化感知训练打包,本地物理文件实际仅为 252GB,实存参数约 2205 亿。协议方面采用了对个人免费商用但设有限制、大企业需书面授权的自定义社区许可,其上线 30 小时的下载冷启动速度受门槛等多重变量影响显著慢于竞品。API 定价采取全天平价策略与 DeepSeek 的峰谷价形成差异化博弈,同时作者浇下“三盆冷水”,直指其部署需 250GB+ 物理内存的高门槛、基准测试在代码 Agent 上的短板,并勘误了此前将推理用量误传为训练量的 200 万亿 Token 数据。
## Atmosphere & style 整期内容透着一股冷峻、克制且极度严谨的“质检员”气质,语言干练务实,毫不随大流吹捧宣发噱头。作者以火车站“到站验收、对账交卷”为贯穿叙事,一边抽丝剥茧拆解官方的营销话术与技术暗度陈仓,一边连续浇下三盆扎实的冷水。观看体验既像是一场毫不留情的工业级提货验资,又展现出技术硬核博主尊重事实、坦率勘误的理性与笃定。
## Bulletin - [00:00](https://www.bilibili.com/video/BV169Hw68EML?t=0s) MiniMax M3.1-Flash 权重准时在海外模型仓库、魔搭社区与托管平台同步上线,包含 48 个分片与 1 个用于推测解码的两亿参数草稿头,主流推理框架与国内芯片厂商已完成 Day-0 适配。 - [00:00](https://www.bilibili.com/video/BV169Hw68EML?t=0s) 官方宣称的名义参数为 428B,但实际下载文件体积为 252GB,系采用量化感知训练(QAT)直接打包发行,内部实际存储约 2205 亿参数且大多数专家采用低比特打包。 - [02:08](https://www.bilibili.com/video/BV169Hw68EML?t=128s) 许可证采用自定义社区协议而非宽松的 MIT 许可,商用免费但必须显著署名,且年营收超过 2000 万美元的企业需另行获取官方书面授权。 - [03:40](https://www.bilibili.com/video/BV169Hw68EML?t=220s) API 定价采取全天平价策略(输入 $0.15/M tokens,输出 $0.60/M tokens),对比 DeepSeek 咬死其谷时价但无峰时翻倍,更适合连续重负载的 Agent 场景。 - [03:40](https://www.bilibili.com/video/BV169Hw68EML?t=220s) 本地部署门槛极高,运行内存需 250GB 以上起步,声称 16G 显卡能跑属于标题党;基准测试在计算机使用上领先十多分,但在代码 Agent 与第三方综合评测上略逊于竞品。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV169Hw68EML?t=0s) MiniMax 如期在三方渠道同步上线权重文件,包含 48 个权重分片和一个独立的 2 亿参数推测解码草稿头。 - [00:00](https://www.bilibili.com/video/BV169Hw68EML?t=0s) 生态适配做到 Day-0 齐备,两大主流推理框架及国内数家芯片厂商均在同日官宣支持并提供镜像。 - [00:00](https://www.bilibili.com/video/BV169Hw68EML?t=0s) “名义参数 428B”与“实重 252GB”并不矛盾,源于该模型通过量化感知训练(QAT)直接打包低比特 MoE 专家网络,实存参数约 2205 亿。 - [02:08](https://www.bilibili.com/video/BV169Hw68EML?t=128s) 开源许可并未采用 MIT,而是设立了自定义社区许可,对年营收超 2000 万美元的企业设置了书面授权门槛并附带受限用途清单。 - [02:08](https://www.bilibili.com/video/BV169Hw68EML?t=128s) 权重落地约 30 小时海外下载量为 1096 次,对比竞品 7 天 5.7 万次冷启动较慢,但受到文件体积翻倍、社区量化版分流及时间窗口不同等干扰变量影响。 - [03:40](https://www.bilibili.com/video/BV169Hw68EML?t=220s) API 采取全天平价计费(输入 $0.15 / 输出 $0.60),与 DeepSeek 的峰谷分时策略形成差异化博弈,选型取决于业务是连续运行还是批处理错峰。 - [03:40](https://www.bilibili.com/video/BV169Hw68EML?t=220s) 官方宣称“Agent 成本降低七成”是与自家上一代模型对比,由单价减半叠加推理提速折算而来,官方未公开拆解公式。 - [03:40](https://www.bilibili.com/video/BV169Hw68EML?t=220s) 本地运行硬件门槛严苛,物理内存要求 250GB 起步,双卡旗舰服务器实测吞吐约每秒 554 个 Token,个人上手主要依赖大内存工作站。 - [03:40](https://www.bilibili.com/video/BV169Hw68EML?t=220s) 基准测试呈现两面性:官方评测中“计算机使用”大幅领先 10 多分,但代码 Agent 落后 10 多分,第三方测评(43分 vs 45分)同样略逊于竞品。 - [03:40](https://www.bilibili.com/video/BV169Hw68EML?t=220s) 勘误此前讨论的 200 万亿 Token 为匿名盲测期间的真实推理调用总量,绝非预训练数据集规模。 - [03:40](https://www.bilibili.com/video/BV169Hw68EML?t=220s) MiniMax 展现出成熟的发行节奏:先匿名压测积攒口碑与调用量,再以发布会承接流量,最后准时交卷开放权重沉淀开发者生态。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV169Hw68EML?t=0s) 准时交卷:多渠道同步上线与“428B”参数的虚实辨析
三天前关于 MiniMax M3.1 的铺垫终于在 10 月 23 日迎来了兑现时刻。作者强调这一期不聊模型跑分有多强,而是要把这票实打实的“货”拆开验一验。在发布当天,海外模型仓库、国内的魔搭社区以及海外托管平台三个渠道同步开放下载。打开仓库,文件结构整整齐齐地切分成了 48 个分片,外加一个独立的草稿头目录,专门存放用于推测解码的两亿参数小模型。生态适配也做到了“Day-0”齐备,不仅两大主流推理框架官宣支持、提供针对多种 GPU 架构的现成镜像,国内数家芯片厂商也在同日跟进适配,整体呈现出一场经过精心排练的同步发行。
随之而来的是核心的口径对账。官方宣传物料标注的是“总参数 428B,每个 Token 激活 230 亿”,但用户下载到本地的文件实重却只有 252GB。针对这两个数字的冲突,作者指出这绝非数据造假,而是源于量化感知训练(QAT)的发行模式——模型在训练阶段就按照量化数值运行,最终以量化形态直接打包发布。模型卡元数据显示,文件内部实际存储了约 2205 亿个参数,大多数 MoE 专家网络都采用了低比特打包处理。428B 只是对标前代满血存储规模的名义口径,252GB 才是硬盘承担的物理重量。正如作者所提醒的那样:“但下次再看到428B免费四个字,先想想252GB的下载量,和跑起来要什么门槛。”
- **发货渠道**:海外模型仓库(如 Hugging Face)、国内魔搭社区(ModelScope)、海外托管平台三方同日开放。 - **权重文件构成**:48 个主体权重分片 + 1 个独立的推测解码(Speculative Decoding)草稿头(装载 2 亿参数小模型)。 - **名义与实重**:名义参数 428B(激活 23B),实存参数约 2205 亿,文件总大小 252GB,系采用量化感知训练(QAT)发布的低比特形态。
---
[02:08](https://www.bilibili.com/video/BV169Hw68EML?t=128s) 社区许可与冷启动对账:商用门槛与下载数据复盘
在许可证层面,MiniMax 此次并未采用宽松的 MIT 协议,而是制定了一套自定义的社区许可协议。整份协议的核心可以概括为三条明确规则:其一,商用完全免费,但必须在衍生产品中显著标注“基于该模型构建”;其二,年营收超过 2000 万美元的企业级客户必须另行获取官方的书面授权,若未经书面授权收到官方通知后也可按要求补办;其三,附带了一份明确的禁止用途合规清单。作者对比了 DeepSeek Flash 系列彻底开源放任的 MIT 许可,直言 MiniMax 这套条款虽然对普通个人开发者几乎没有体感,但对于企业法务部门而言却是一道必须前置审核的闸门。
在下载量数据上,权重上线约 30 小时后,海外主仓库录得 1096 次下载和 259 个点赞。对比同档竞品 DeepSeek 在 10 月中旬迭代时创下的“7 天 5.7 万次下载(日均约 7900 次)”,MiniMax 的冷启动速度粗算慢了近 7 倍。不过作者强调不能单看数字下断论,其中夹杂着三个关键的干扰变量:首先是文件体积差了一倍(252GB 对 510GB),下载门槛天然不同;其次是社区第三方格式转换量化版的分流;最后则是两方统计的时间窗口完全不一致。正如作者总结道:“冷启动慢是事实原因复杂也是事实两件事都得讲。”
```mermaid flowchart TD accTitle: MiniMax M3.1-Flash 落地核心维度对比 accDescr: 对比许可协议差异、下载冷启动变量以及价格结构策略
subgraph License["许可条款对比"] L1["MiniMax 社区许可<br/>商用免费但须署名<br/>年营收>2000万美元需书面授权"] L2["DeepSeek MIT 许可<br/>完全自由宽松使用"] end
subgraph ColdStart["下载冷启动变量"] C1["30小时 1096 次下载"] C2["变量1: 252GB vs 510GB 门槛差异"] C3["变量2: 社区量化版切片分流"] C4["变量3: 统计时间窗不同"] C1 --> C2 C1 --> C3 C1 --> C4 end
subgraph Pricing["API 计费结构"] P1["MiniMax 全天平价<br/>输入 $0.15 / 输出 $0.60"] P2["DeepSeek 峰谷分时<br/>谷时同价 / 峰时翻倍"] end ```
- **许可条款要点**:个人及中小团队免费商用(须显著署名);年营收超 2000 万美元需书面授权;附带受限/禁止用途清单。 - **冷启动数据对账**:首发约 30 小时内下载 1096 次、点赞 259 次;对比竞品 7 天 57000 次下载,日均流速存在显著差距。
---
[03:40](https://www.bilibili.com/video/BV169Hw68EML?t=220s) 价格结构博弈与“三盆冷水”:部署门槛、基准温差与勘误
针对模型 API 价格,作者分析了其计费结构上的心机。从名义价格看,MiniMax 输入每百万 Token 0.15 美元、输出 0.6 美元,恰好咬死在 DeepSeek 的“谷时价”上。然而二者的定价逻辑截然不同:MiniMax 采取全天平价策略,没有峰谷时段限制;而 DeepSeek 实行峰谷双排策略,峰时价格翻倍,谷时半价且命中缓存后还有额外折扣。因此,企业如何选型取决于业务的任务画像——跑连续重负载 Agent 选平价,错峰批处理任务选峰谷价。至于官方宣传“Agent 成本比前代降低七成”的说法,作者指出口径是对比自家的上一代模型,由“单价腰斩”叠加“推理近三倍提速”综合折算而来,因官方未公开具体拆解公式,本期不做过多复算。
最后,作者照例给狂热的舆论浇下“三盆冷水”: 1. **部署硬件门槛极高**:即便经过低比特量化,运行内存依然要求 250GB 以上起步。实测双卡旗舰服务器的推理吞吐在每秒 554 个 Token 出头。作者批评道:“标题里写16G显卡能跑的属于标题档个人想上手基本只有大内存工作站一条路。” 2. **基准测试的温差与两面性**:在官方测试中,其“计算机使用”(Computer Use)基准大幅领先同档对手 10 多分,但在代码 Agent 基准上反手落后了 10 多分;第三方独立测评榜单上其得分为 43 分,同样略逊于 DeepSeek 的 45 分,再次验证了各家自测榜与独立榜之间普遍存在的温差。 3. **关键数据勘误**:针对上期提到的“200 万亿 Token”,作者特别澄清那是匿名试跑期间用户产生的真实推理用量,绝非预训练数据集规模,官方至今未披露实际训练量。
作者梳理了 MiniMax 逐渐清晰的发行打法:先在匿名期悄悄上线接受公众盲测压测,攒足真实调用量与社区口碑;随后借官方发布承接集中爆发的流量;最后准时交出权重收割开发者生态,步步为营。正如作者在文末的立场所言:“承诺写在时刻表上我们就按时来对账这里是道战验收我们下期见。”
- **API 定价模型**:输入 $0.15 / M tokens,输出 $0.60 / M tokens(全天平价,无峰时加价)。 - **实测硬件吞吐**:双卡旗舰服务器实测约 554 token/s,物理内存需 250GB+ 起步。 - **评测成绩落差**:计算机使用基准领先竞品 10+ 分;代码 Agent 基准落后 10+ 分;独立第三方基准得分 43 分(低于竞品的 45 分)。 - **匿名用量勘误**:此前引发讨论的 200 万亿 Token 系匿名测试期间的推理调用总量,非预训练数据集规模。
## Notable quotes > [00:00](https://www.bilibili.com/video/BV169Hw68EML?t=0s) 下次再看到428B免费四个字,先想想252GB的下载量,和跑起来要什么门槛。 — AI技术投降派
> [03:40](https://www.bilibili.com/video/BV169Hw68EML?t=220s) 标题里写16G显卡能跑的属于标题档个人想上手基本只有大内存工作站一条路。 — AI技术投降派
## Mentioned MiniMax, MiniMax M3.1-Flash, DeepSeek, DeepSeek Flash, 魔搭社区, Hugging Face, ModelScope, MIT 许可证, QAT
## Video description 上一班我们说:模型权重 10 月 23 日开放,兑现与否,站台见。今天到站了——权重准时上架,没跳票,没缩水。这一班不讲模型多强,只讲这票货本身。
先验货:海外的模型仓库、魔搭社区、托管平台三个卸货口同日开放,48 个分片加一个推测解码草稿头,两大推理框架 Day-0 官宣支持,国内多家芯片同日适配。
再过秤:官方说总参数 428B,但你硬盘上的是 252GB。这不是造假——量化感知训练的发行方式,文件里实际存储约 2205 亿参数,大部分专家低比特打包。428B 是名义口径,252GB 是实重。
许可要看清:不是 MIT,是自定义社区许可。商用免费但要署名,年营收超两千万美元的企业需书面授权。
数据对账:落地约三十小时下载 1096 次,对比同档竞品七天五万七千,冷启动慢了约七倍——但货重差一倍、量化版分流、时间窗不同,三个变量都得交代。
价格看结构:MiniMax 全天平价 0.15/0.60 美元,DeepSeek 谷时同价但峰时翻倍。Agent 成本降七成的口径是比上一代,官方没给拆解公式,我们不复算。
三盆冷水照例:250GB 内存起步、16G 显卡是标题党;计算机使用基准领先十多分但代码 agent 基准落后;勘误——上期的两百万亿 token 是匿名期推理用量,不是训练量。
[Source](https://www.bilibili.com/video/BV169Hw68EML)