OpenAI存储延迟从120砍到10毫秒 三件事拆解
AI技术投降派
AI-assisted summary of OpenAI存储延迟从120砍到10毫秒 三件事拆解 — original source. Check the original for full context.
Source published:
Key ideas
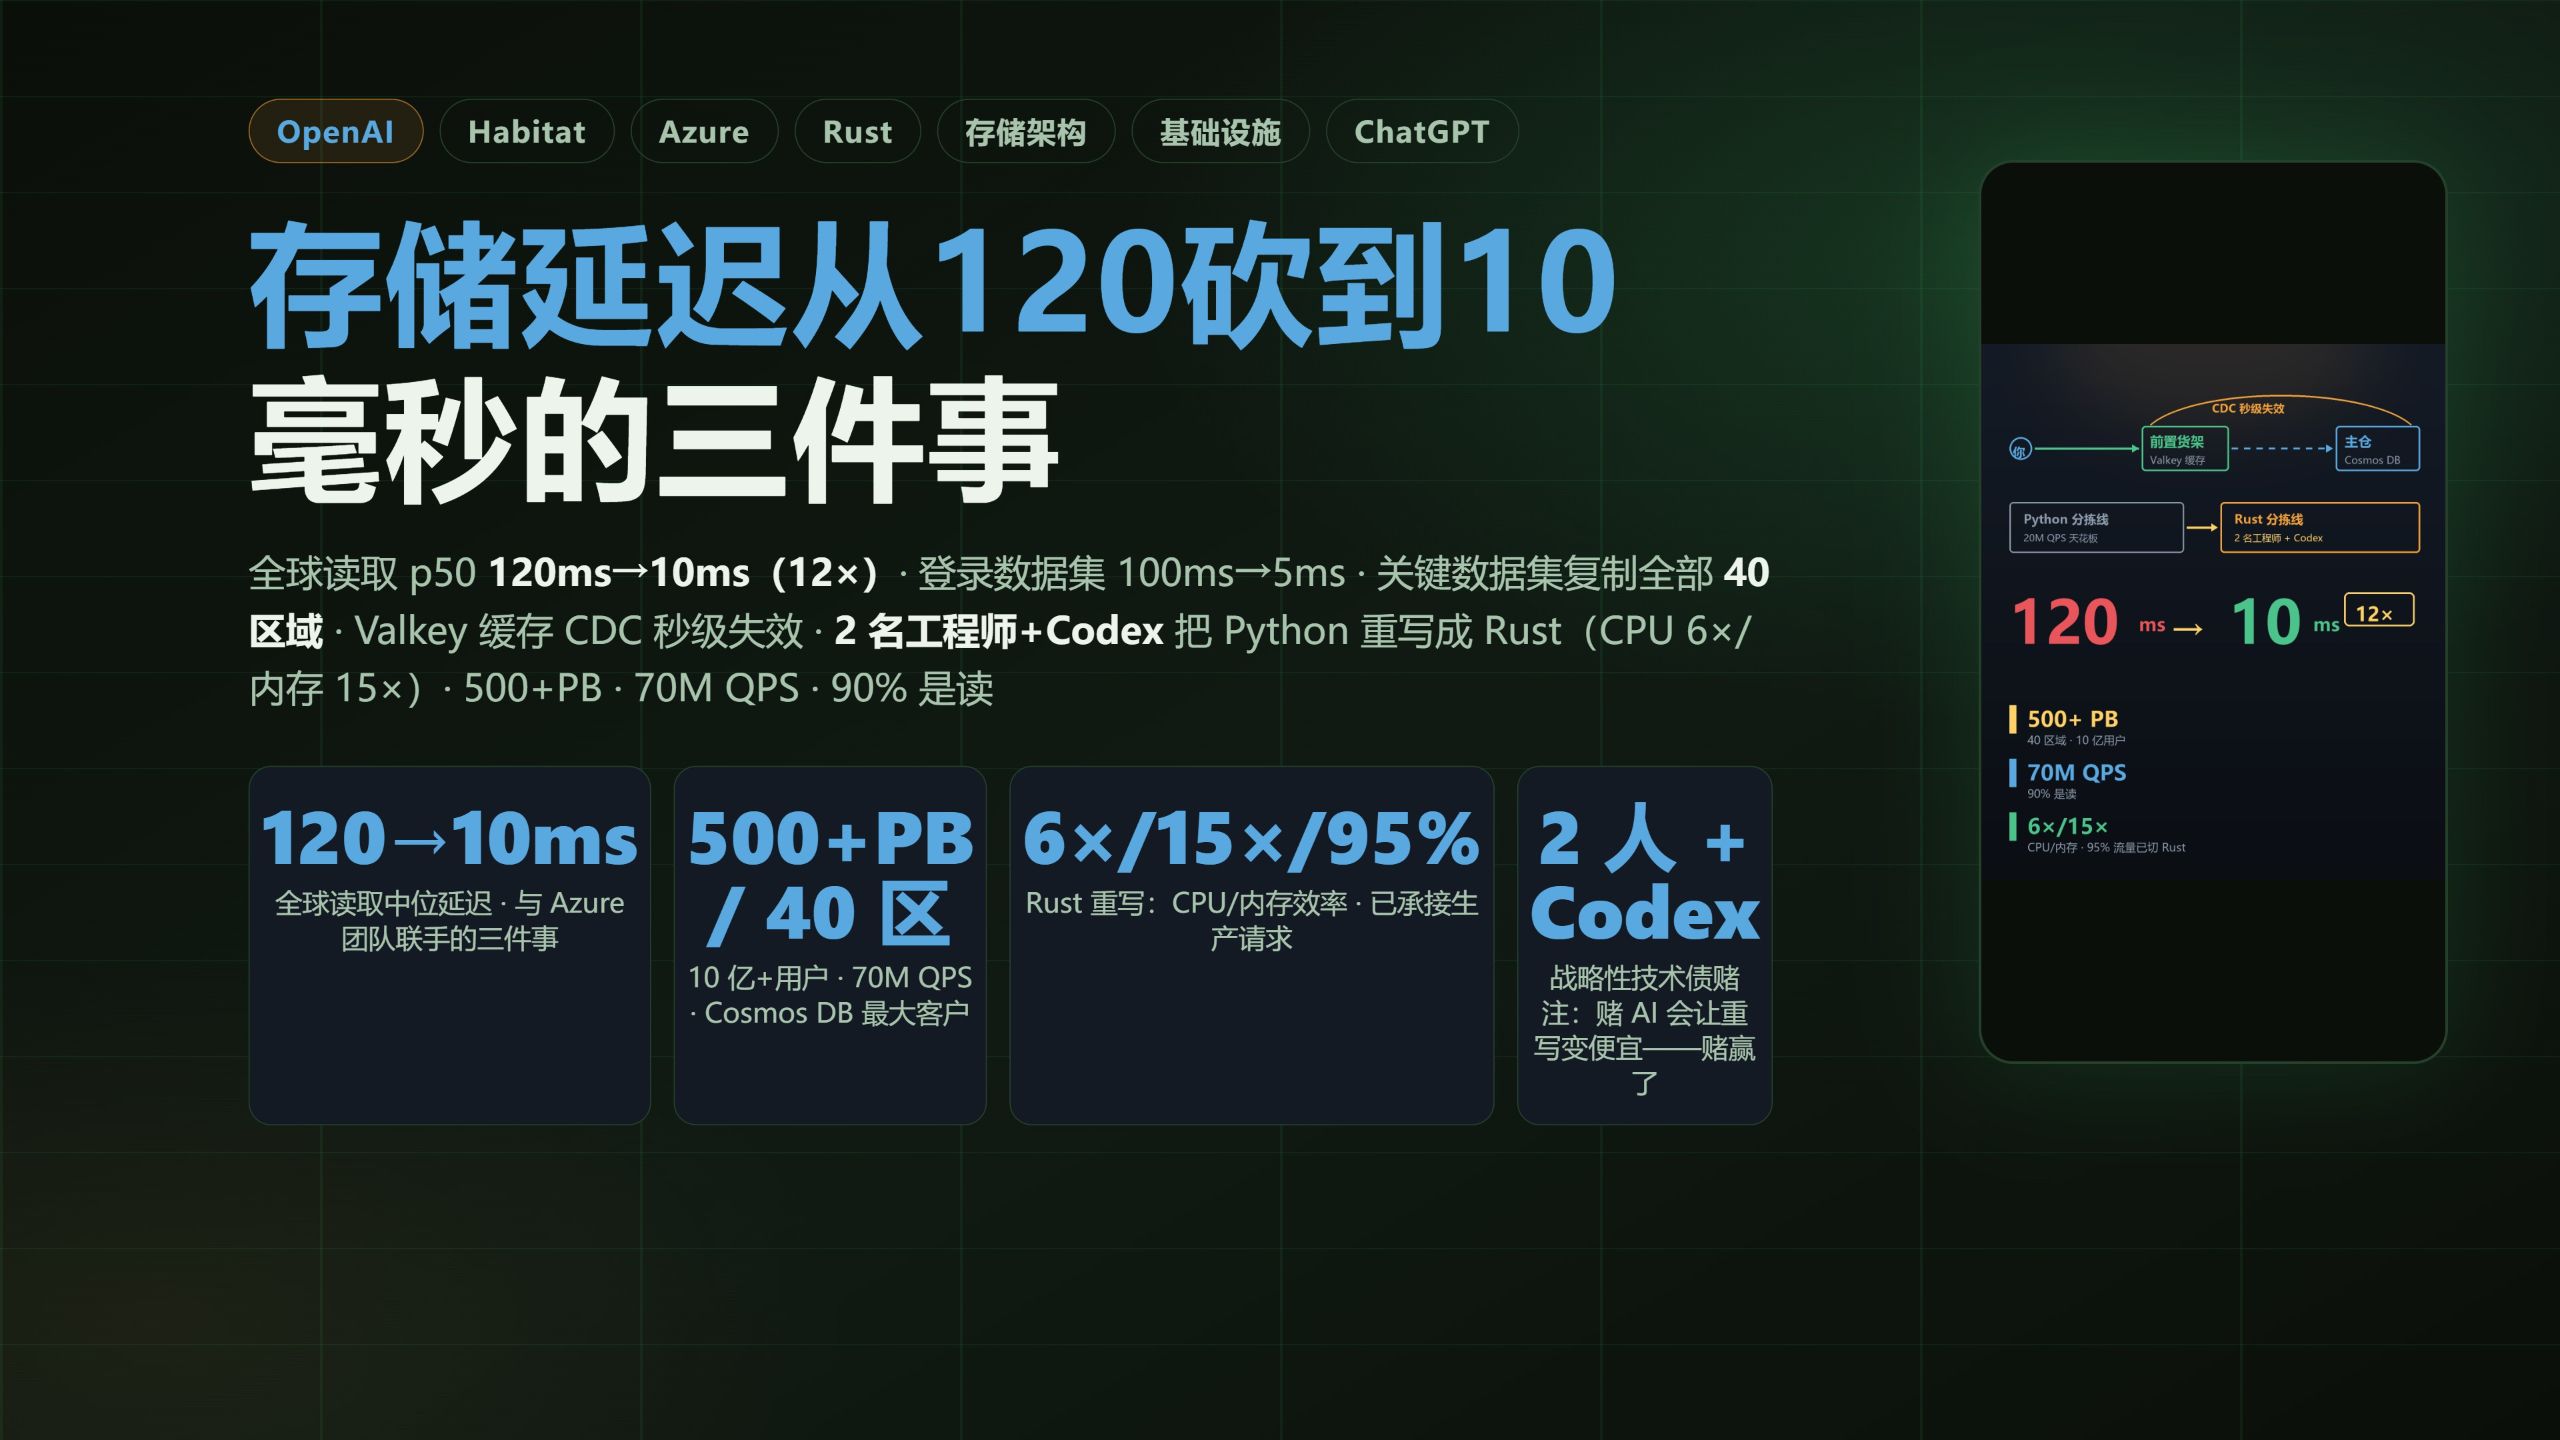
- OpenAI 披露其在线记录级存储系统 Habitat 的架构升级成果,全球读取中位延迟从 120 毫秒锐减至 10 毫秒(提速 12 倍),承接超 10 亿用户与每秒 7000 万次请求。 (0:00)
- 通过分级多区域复制与紧邻部署的 Valkey 缓存结合 Cosmos DB 变更流(CDC)数秒级主动失效,登录等高敏数据集的读取延迟从 100 毫秒降至 5 毫秒。 (1:34)
- 仅由两名工程师结合 Codex 辅助,便将核心服务从 Python 完整重写为 Rust,CPU 效率提升约 6 倍、内存效率提升约 15 倍,已承接 95% 线上流量。 (3:29)
- 虽然 OpenAI 是 Azure Cosmos DB 全球最大客户并与其深度联调,但官方已预告正基于收购的 Rockset 技术秘密自研下一代 EB 级存储系统。 (4:41)
Detailed notes
## Background 该视频由 Bilibili UP 主“AI技术投降派”于 2026 年 10 月 25 日发布。内容基于 OpenAI 与微软 Azure 团队在 10 月底联合披露的工程博客下半篇,深度拆解了支撑 ChatGPT 十亿用户记录级在线存储的自研系统 Habitat,如何通过三项核心工程改动将全球读取中位延迟从 120 毫秒锐减至 10 毫秒。
## TL;DR 视频系统剖析了支撑 500 PB 数据与每秒 7000 万次请求的 Habitat 系统实现 12 倍延迟缩减的三大杀招:首先是将最核心的敏感认证元数据在 40 个区域全覆盖铺货以实现就近读取;其次是部署紧挨请求处理节点的 Valkey 缓存,并通过 Cosmos DB 的 CDC 变更流实现全球秒级主动失效;最后是仅凭 2 名工程师借助 Codex 将原 Python 服务全面用 Rust 重写,实现 CPU 效率约 6 倍、内存效率约 15 倍的跃升。此外,视频还复盘了团队在多租户容器架构上“共享—拆分—带闸重回共享”的折返探索,并揭示了 OpenAI 表面深度绑定 Cosmos DB、暗中依托 Rockset 研发 EB 级自研存储的微妙博弈。
## Atmosphere & style 全片节奏干练明快,充斥着硬核系统架构师的通透与务实。讲解风格不搞虚词套话,而是像对照工业图纸施工般抽丝剥茧,将冷冰冰的微秒数字与复杂的分布式拓扑讲得层层递进、逻辑严丝合缝。文风中带着恰到好处的技术讽刺与行业幽默(如调侃多租户的‘折返跑’以及‘Meta 不养闲人’),既展现了工业级超大规模分布式系统在物理法则与成本制约下的真实权衡,也让观众真切感受到 AI 重构软件工程底层的时代震撼感。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1SSHg6NEsB?t=0s) OpenAI 披露其在线记录级存储系统 Habitat 的架构升级成果,全球读取中位延迟从 120 毫秒锐减至 10 毫秒(提速 12 倍),承接超 10 亿用户与每秒 7000 万次请求。 - [01:34](https://www.bilibili.com/video/BV1SSHg6NEsB?t=94s) 通过分级多区域复制与紧邻部署的 Valkey 缓存结合 Cosmos DB 变更流(CDC)数秒级主动失效,登录等高敏数据集的读取延迟从 100 毫秒降至 5 毫秒。 - [03:29](https://www.bilibili.com/video/BV1SSHg6NEsB?t=209s) 仅由两名工程师结合 Codex 辅助,便将核心服务从 Python 完整重写为 Rust,CPU 效率提升约 6 倍、内存效率提升约 15 倍,已承接 95% 线上流量。 - [04:41](https://www.bilibili.com/video/BV1SSHg6NEsB?t=281s) 虽然 OpenAI 是 Azure Cosmos DB 全球最大客户并与其深度联调,但官方已预告正基于收购的 Rockset 技术秘密自研下一代 EB 级存储系统。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1SSHg6NEsB?t=0s) Habitat 是管理登录、会话与元数据的记录级在线存储系统,借鉴 Meta TAO 架构,目前管理超过 500 PB 数据且九成以上为读请求。 - [01:34](https://www.bilibili.com/video/BV1SSHg6NEsB?t=94s) 全量数据跨 40 个区域复制在成本与容量上不可行,OpenAI 采取分级策略:核心认证元数据全量铺货,其余关键数据各大洲保底一份。 - [02:33](https://www.bilibili.com/video/BV1SSHg6NEsB?t=153s) 缓存架构摒弃被动 TTL 超时,改用基于 Azure Cosmos DB CDC 变更流的数秒级全球失效机制,大幅压低登录链路延迟至 5 毫秒。 - [03:29](https://www.bilibili.com/video/BV1SSHg6NEsB?t=209s) OpenAI 曾因预期 AI 代码生成能力会飞速演进而选择暂缓技术债重构,这一判断在二季度利用 Codex 重写 Rust 中得到回报验证。 - [03:29](https://www.bilibili.com/video/BV1SSHg6NEsB?t=209s) 120 毫秒降到 10 毫秒是临近复制、CDC 缓存与 Rust 重写三者协同的结果,绝非单纯依靠更换编程语言。 - [03:47](https://www.bilibili.com/video/BV1SSHg6NEsB?t=227s) 多租户架构经历了从‘全共享’到‘专用容器’再回到‘带四道安全闸的共享容器’的折返,证明超大规模下高效多租户必须深度工程自建。 - [04:41](https://www.bilibili.com/video/BV1SSHg6NEsB?t=281s) 优化本质是拿存储空间置换延迟,物理网络限制决定了未缓存冷数据的跨区域长尾请求仍是系统的延迟天花板。 - [04:41](https://www.bilibili.com/video/BV1SSHg6NEsB?t=281s) OpenAI 正基于 Rockset 自研 EB 级存储,呈现出一边与 Cosmos DB 深度捆绑、一边推进自研替代的商业与技术张力。 - [05:32](https://www.bilibili.com/video/BV1SSHg6NEsB?t=332s) 当单一客户体量膨胀至宇宙级时,标准商用托管云服务失效,必然转向客户与云厂商深度互嵌的‘共同托管’模式。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1SSHg6NEsB?t=0s) 什么是 Habitat:背负十亿用户的“存储税”与草根演进
每次打开 ChatGPT,在模型真正开口吐字之前,用户其实都要先在底层“交一笔存储税”。用户的登录状态、历史会话列表、文件元数据以及 Codex 设置,在 ChatGPT 处理每一个请求时都必须先摸一遍。这些记录级在线数据全部存储在 OpenAI 自研的在线存储系统 Habitat 中。今年之前,Habitat 在全球范围内的读取中位延迟大约是 120 毫秒,而现在直接降到了 10 毫秒,速度提升了整整 12 倍。这是 OpenAI 工程博客与微软 Azure 团队在十月底联合披露的架构演进下半篇。
要看懂这次调优,首先要厘清 Habitat 的本质定位:它并不是用来存视频或照片的大文件对象存储,而是针对登录、对话等记录级的在线存储底座。它的架构接口学习了 Meta 的分布式图存储 TAO,将数据组织成对象(objects)与边(edges),设计原则是只做简单的点查与关系查询,复杂的分析任务全部甩给离线链路处理。
Habitat 的出身非常草根。2023 年为了配合 GPTs 功能的快速上线,它最初仅仅是一个连接单个数据库的 Python 客户端库。但在随后的三年时间里,它的规模以每年增长十倍的恐怖速度膨胀。如今的 Habitat 已经支撑着极为庞大的基础设施体量,底层完全托管在 Azure Cosmos DB 之上,OpenAI 也因此成为了 Cosmos DB 全球最大的客户。
- 核心数据规模:管理超过 500 PB 数据,覆盖 40 个地理区域,服务超过 10 亿用户。 - 流量吞吐特征:每秒处理高达 7000 万次请求,其中 90% 以上是读取操作。 - 底层技术底座:以 Azure Cosmos DB 为基础,上层构建类似 Meta TAO 的对象与边模型。
```mermaid flowchart TD accTitle: Habitat 架构与延迟优化拆解 accDescr: 展示从客户端请求到缓存、路由、跨区域复制及底层 Cosmos DB 的整体数据读取流转路径。
subgraph UserSide["客户端请求"] Req["ChatGPT / Codex 请求<br/>(登录信息/会话列表/元数据)"] end
subgraph ComputeLayer["计算与服务层 (Rust 重写)"] RustSvc["Habitat Service<br/>(2 名工程师 + Codex 重写)"] end
subgraph CacheLayer["区域缓存层"] ValkeyCache["Valkey 缓存服务器<br/>(紧挨请求处理部署)"] end
subgraph StorageLayer["存储与多区域路由"] Router["跨区域路由层"] AllRegionData["全局 40 区域副本<br/>(极小高敏感认证元数据)"] ContRegionData["洲际单副本<br/>(次关键数据集)"] CosmosDB["Azure Cosmos DB<br/>(底层 EB/PB 级存储源)"] CDC["Cosmos DB 变更流 (CDC)"] end
Req --> RustSvc RustSvc --> ValkeyCache ValkeyCache --"未命中"--> Router Router --> AllRegionData Router --> ContRegionData Router --> CosmosDB CosmosDB -.->|"数据变更数秒内通知"| CDC CDC -.->|"全球被动失效"| ValkeyCache ```
[01:34](https://www.bilibili.com/video/BV1SSHg6NEsB?t=94s) 前两把斧:关键数据邻近复制与 Valkey 缓存 CDC 失效
要将全球读取延迟从 120 毫秒砍到 10 毫秒,核心逻辑被拆解成了三件事。第一件事是“高频小件全仓铺货”,把最要命的小数据复制到离用户最近的地方。为什么不能把所有数据全量复制?因为 500 PB 乘以 40 个区域,在物理容量和经济成本上完全不现实。OpenAI 的解法是只挑选体积最小、对延迟最敏感的核心数据集——典型如每次请求都必查的认证元数据。他们将复制策略划分为两档:最关键的账户元数据全量复制到全部 40 个区域,其余次关键数据至少在每个大洲保留一份副本;上层配合跨区域路由层,让请求自动就近访问副本。
第二件事是利用区域内缓存承接剩余的高频读取流量。缓存层选用开源的 Valkey,服务器紧挨着请求处理节点部署。但这项设计的胜负手不在于缓存组件本身,而在于缓存的失效策略。系统并没有赌不靠谱的 TTL(超时失效),而是直接接入 Azure Cosmos DB 的变更流(CDC)。一旦底层主库数据发生变更,数秒钟之内全球各区域的缓存便全部主动失效。这个模式同样借鉴了 Meta TAO 的缓存失效哲学。实测秒表给出的提升非常直接:登录服务相关数据集的读取延迟直接从大约 100 毫秒锐减到了 5 毫秒。
- 关键数据集分级复制:核心认证元数据 40 个区域全覆盖,其余关键数据各大洲保底一份。 - 智能路由与铺货:高频小件全仓铺货,跨区域路由层保障请求就近读取。 - Valkey 紧邻部署:消除跨机房网络往返开销。 - CDC 全球秒级失效:依托 Cosmos DB Change Feed 实现数据变更后数秒内全网缓存失效,彻底告别被动 TTL。 - 登录链路收益:读取中位延迟从 100ms 降至 5ms。
[03:29](https://www.bilibili.com/video/BV1SSHg6NEsB?t=209s) 两人加 Codex 重写 Rust,以及多租户的“折返跑”哲学
第三件事是用 Rust 彻底重写服务层。在此之前,Python 版本的服务其实已经支撑到了惊人的每秒 2000 万次请求,是 OpenAI 内部消耗 CPU 核心数第二大的服务。然而 Python 的缺陷是结构性的:事件循环调度抖动、全局解释器锁(GIL)卡死多核性能,甚至连连接池策略都引发过线上事故。面对这种技术债,OpenAI 早期做出了极具个性的决策——先按兵不动硬撑。谈及当时的考量,视频作者指出:“OpenAI 的选择是先不换,他们的原话是赌 AI 编码能力的进步会让未来的重写变得便宜。”
这个赌注最终大获全胜。今年第二季度,仅凭两名工程师配合 Codex,便将这套庞大的服务完整重写为了 Rust 版本。重写后的系统 CPU 效率提升约 6 倍,内存效率提升约 15 倍,目前已经承接了线上 95% 的生产请求。不过作者也特意强调,120 毫秒到 10 毫秒是三件事共同作用的结果,Rust 只是其中一环;正如一位 SRE 的精辟解读:这个数字意味着绝大多数读取在每一层都实现了命中。
伴随系统重构的,还有一段极具戏剧性的多租户演进折返跑: 1. 第一阶段(全共享):所有租户共用默认容器,导致业务间严重的“吵闹邻居”互相干扰。 2. 第二阶段(拆专用):为了隔离痛定思痛,把租户拆成独立专用容器,结果导致容量规划陷入噩梦,还连续引发了两次生产事故。 3. 第三阶段(回归共享):重新回到共享容器架构,但附带了“四道安全闸”——热点键限流、离线批量任务降优先级、改进版 Serverless 弹性,以及与 Azure 团队的深度共同管理。
面对社区调侃团队是“把单体巨石拆开又装了回去”,作者分析这种路线图上的“折返”恰恰是工业软件最真实的写照。正如官方总结的那样:“高效的多租户不是买来的,是造出来的。”第一次的共享是因为没得选,而这次的共享是遍历所有代价后主动做出的工程权衡。
| 演进阶段 | 架构模式 | 核心痛点 / 解决方案 | 最终结局 | |:--- |:--- |:--- |:--- | | **阶段一** | 全局默认共享容器 | 多业务互相干扰,缺乏隔离 | 体验极差,被迫拆分 | | **阶段二** | 租户拆分专用容器 | 资源碎片化,容量规划成噩梦 | 发生 2 次线上事故,难以为继 | | **阶段三** | 共享容器 + 四道闸门 | 热点键限流 + 离线降级 + Serverless 改进 + 微软共管 | 成功支撑 10 亿用户与 7000 万 QPS |
[04:41](https://www.bilibili.com/video/BV1SSHg6NEsB?t=281s) 空间换延迟的物理天花板,与自研 EB 级存储的野心
在亮眼的延迟数据背后,官方也坦诚算清了两笔账。第一笔账是物理规律决定的硬性天花板:整个优化本质上是拿空间换延迟。临近复制和全球广泛复制都受到物理存储容量和成本的严格约束;官方承认,线上最慢的长尾请求依然不得不跨区域去拉取未缓存的冷数据,这是纯物理距离带来的延迟上限,无法靠缓存彻底抹平。
第二笔账则是官方博客文末埋下的重磅彩蛋:OpenAI 正在基于此前收购的 Rockset 技术,秘密自研下一代 EB(Exabyte)级在线存储系统。这就带来了一种极具戏剧性的商业张力:一边是作为 Azure Cosmos DB 全球最大客户的深度绑定,甚至拉着微软工程师一起联手做多租户底座优化;另一边却在水面之下积极研发完全属于自己的替代系统。
这种技术与人才的循环也耐人寻味。TAO 架构出自 Meta,而 Rockset 的联合创始人同样出自 Meta 的核心基础设施团队。这印证了知乎上广为流传的一句调侃:“Meta 不养闲人。”
对于普通终端用户而言,延迟从 120 毫秒降到 10 毫秒,意味着登录和新建对话等操作中的卡顿等待感基本消失。而对于基础设施工程师来说,这场技术战役留下了两个真正的行业启示: - AI 编写系统级基础设施代码成为现实:仅仅两名工程师加上 Codex,就完成了支撑 10 亿用户核心服务的 Rust 重写,这在两年前的软件工程领域是不可想象的。 - 云上托管服务的边界被重新定义:当单一客户的业务体量膨胀到“宇宙级”时,标准的商业托管服务便不再适用,最终都会被迫演变成客户与云厂商工程团队深度互嵌的“共同托管”。
## Notable quotes > [03:29](https://www.bilibili.com/video/BV1SSHg6NEsB?t=209s) 高效的多租户不是买来的,是造出来的。
## Mentioned OpenAI, ChatGPT, Habitat, Azure, Azure Cosmos DB, Meta, TAO, GPTs, Python, Codex, Valkey, Rust, Rockset
## Video description 你每次打开 ChatGPT,在模型开口之前,先要交一笔存储税:登录信息、会话列表、文件元数据,存在 OpenAI 自研的在线存储系统 Habitat 里。今年之前,全球读取中位延迟约 120 毫秒;现在 10 毫秒,快了 12 倍。这是 OpenAI 工程博客十月底刚披露的下半篇,跟 Azure 团队联手做的。怎么做到的?三件事,当图纸拆。
先弄清 Habitat 是什么:不是存视频照片的对象存储,是记录级在线存储——登录、对话、Codex 设置,每个请求都要摸一遍。接口学 Meta 的 TAO,数据组织成对象和边。出身草根:2023 年为支持 GPTs 上线,最初就是一个 Python 客户端库,然后连续三年每年增长十倍。现在 500 PB 数据、40 个地理区域、超 10 亿用户、每秒 7000 万次请求,九成以上是读,底层跑在 Azure Cosmos DB 上——OpenAI 是它最大的客户。
三件事。第一,高频小件全仓铺货:500 PB 乘 40 区域不现实,只复制最小最延迟敏感的数据集(认证元数据),最关键的复制到全部 40 区域,其余每大洲一份。第二,前置货架:Valkey 缓存紧挨请求部署,关键在不赌 TTL,用 CDC 变更流数秒内全球失效——登录数据集读取从 100 毫秒降到 5 毫秒。第三,换分拣线:Python 版其实撑到了每秒 2000 万请求,但 OpenAI 赌 AI 会让未来的重写变便宜——赌赢了。今年二季度,两名工程师加 Codex 把整个服务重写成 Rust:CPU 效率约 6 倍,内存约 15 倍,已承接 95% 生产请求。要说清楚:120 降到 10 是三件事叠加,Rust 只是其中一件。
下半篇还有一段多租户的折返哲学:共享容器→拆专用容器(容量噩梦+两次事故)→回到共享+四道闸(热点限流/离线降级/serverless 改进/Azure 共同管理)。用他们自己的话说:高效的多租户不是买来的,是造出来的。两笔账也算清楚:跨区域读未缓存数据仍是最慢路径;文末彩蛋预告 OpenAI 正基于 Rockset 自研 EB 级存储——一边是 Cosmos DB 最大客户的深度绑定,一边是自研替代,这个张力值得玩味。
00:05 存储税:120→10 毫秒 12 倍 00:40 Habitat 是什么:500PB/40 区域/10 亿人 01:34 第一件事:关键数据集邻近复制 02:33 第二件事:Valkey 缓存+CDC 秒级失效 03:29 第三件事:2 人+Codex 的 Rust 重写 03:47 多租户折返:不是买来的是造出来的 04:41 天花板与彩蛋:自研 EB 存储 05:32 两个真主角:AI 写基础设施+托管的边界
官方博客:openai.com/index/scaling-storage-one-billion-users-part-two
[Source](https://www.bilibili.com/video/BV1SSHg6NEsB)