百度开源文档大模型 二代结构重构注意力筛掉99%视觉算力
AI技术投降派
百度通过两级门控机制将长文档转录计算压至恒定开销,虽实现300页无损转写,却以牺牲全局文档层级认知为硬性代价。
AI-assisted summary of 通用大模型百页全崩:百度OCR2测评 — original source. Check the original for full context.
Source published:
Key ideas
- 百度开源 Unlimited OCR 二代并提出 SR-SWA 机制,百页长文档峰值显存从 47GB 降至 1.77GB,单步解码提速 7 倍,模型卡演示支持单请求解析整套 3600+ 页《哈利·波特》。 (0:00)
- 长文本基准实测暴露出通用大模型逐字转录短板,Qwen3.8-Max 从数十页的 78.3 分崩塌至百页的 22.9 分,Gemini-3.1-Pro 在 223 页直接失败,而专用模型在 2 至 300 页维持平直精度曲线。 (2:18)
- 机制取舍代价显现:SR-SWA 筛除 99% 视觉 Token 导致全局信息丢失,文档标题层级得分仅 48.2 分,表明极限转录稳定性来自对宏观结构的牺牲。 (3:24)
Detailed notes
## Background 该视频由 Bilibili UP 主“AI技术投降派”于 2026 年 10 月 28 日发布。内容紧随百度 ERNIE 团队以 MIT 协议开源其二代文档模型 Unlimited OCR 2,聚焦于该模型如何通过重构注意力机制来攻克通用大模型在百页长文档逐字解析中频频报错或胡编的痛点。
## TL;DR 视频深度评测了百度开源的 Unlimited OCR 二代,指出其核心在于采用“稀疏参考滑窗注意力”(SR-SWA)机制,通过页门和令牌筛过滤掉 99% 的多余视觉 Token,实现显存开销从 47GB 降至 1.77GB 并支撑数千页解析。二代在第三方 MPDocBench 与自建百页基准 MarathonDocBench 上均大幅抛离 Qwen3.8-Max、Kimi-K3 等通用旗舰,且转录精度曲线在 300 页内基本走平。但博主同时泼下三盆冷水:自测基准中立性待验、因舍弃全局视野导致文档标题层级识别仅得 48.2 分,以及暂缺 vLLM 部署支持等工程毛边。总评认为该模型在“专用模型+恒定注意力”的第三条路径上,通过主动舍弃宏观结构理解换取了长程抄写的极致稳定性。
## Atmosphere & style 视频整体呈现出一种冷静、清醒且高度专业的硬核技术拆解风格,毫无对开源热点的盲目吹捧。博主以生动的人类抄书比喻迅速建立认知,随后笔锋一转,借由犀利的数据对比与“三盆冷水”将观众拉回现实层面的工程代价与局限审视。在拆解竞品伪标签与架构矛盾的过程中,叙事流淌着理性务实的克制感,给人一种剥离公关包装、直击技术取舍本质的深刻质感。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1QNx56xEEn?t=0s) 百度开源 Unlimited OCR 二代并提出 SR-SWA 机制,百页长文档峰值显存从 47GB 降至 1.77GB,单步解码提速 7 倍,模型卡演示支持单请求解析整套 3600+ 页《哈利·波特》。 - [02:18](https://www.bilibili.com/video/BV1QNx56xEEn?t=138s) 长文本基准实测暴露出通用大模型逐字转录短板,Qwen3.8-Max 从数十页的 78.3 分崩塌至百页的 22.9 分,Gemini-3.1-Pro 在 223 页直接失败,而专用模型在 2 至 300 页维持平直精度曲线。 - [03:24](https://www.bilibili.com/video/BV1QNx56xEEn?t=204s) 机制取舍代价显现:SR-SWA 筛除 99% 视觉 Token 导致全局信息丢失,文档标题层级得分仅 48.2 分,表明极限转录稳定性来自对宏观结构的牺牲。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1QNx56xEEn?t=0s) 百度开源 Unlimited OCR 二代(MIT 协议),旨在解决通用大模型解析超长 PDF 时拒识或胡编乱造的问题。 - [00:48](https://www.bilibili.com/video/BV1QNx56xEEn?t=48s) 一代模型虽用滑窗控制文本开销,但解码仍需扫描全部页面视觉特征,实测 40 页即撞上计算瓶颈。 - [00:48](https://www.bilibili.com/video/BV1QNx56xEEn?t=48s) 二代提出 SR-SWA(稀疏参考滑窗注意力),模拟抄书仅看当前页与回瞥参照的认知负荷,实现恒定计算预算。 - [00:48](https://www.bilibili.com/video/BV1QNx56xEEn?t=48s) SR-SWA 采用两级筛选:第一级「页门」收窄关联页面,第二级「令牌筛」以固定预算提取视觉特征。 - [00:48](https://www.bilibili.com/video/BV1QNx56xEEn?t=48s) 每页 273 个视觉 Token、300 页超 8 万 Token 被压缩为约 512 个固定参考,直接筛除 99% 的多余信息。 - [00:48](https://www.bilibili.com/video/BV1QNx56xEEn?t=48s) 百页长文档解析的吞吐量从 360 提升到 1315 TPS,官方演示成功单次解析 3600 多页《哈利·波特》全集。 - [02:18](https://www.bilibili.com/video/BV1QNx56xEEn?t=138s) 在第三方跨页基准 MPDocBench 上拿到 84.6 分,超越 Qwen3.8-Max 6.3 分且包揽全部 8 个子项第一。 - [02:18](https://www.bilibili.com/video/BV1QNx56xEEn?t=138s) 在自建 MarathonDocBench 取得 77.1 分,领先第二名 Kimi-K3 达 43 分,而通用旗舰跨入百页后出现精度断崖甚至崩溃。 - [03:24](https://www.bilibili.com/video/BV1QNx56xEEn?t=204s) 自建榜单中立性存疑,行业 13 个 OCR 榜中有 10 个为创建者自测登顶,模型发布初期尚缺完全独立的第三方检验。 - [03:24](https://www.bilibili.com/video/BV1QNx56xEEn?t=204s) 稀疏注意力的机制代价明确:由于丢失全局上下文,模型在百页榜单上的标题层级得分仅为 48.2 分。 - [03:24](https://www.bilibili.com/video/BV1QNx56xEEn?t=204s) 工程实现存在瑕疵,激活参数在正文与架构图标注存在 5 亿与 5.7 亿口径矛盾,且暂缺高并发推理框架 vLLM 支持。 - [04:44](https://www.bilibili.com/video/BV1QNx56xEEn?t=284s) 在打补丁的逐页管线派和长文本衰减的通用模型派之外,百度开辟了「专用模型加恒定注意力」的第三条路线。 - [04:44](https://www.bilibili.com/video/BV1QNx56xEEn?t=284s) 二代模型训练过程耐人寻味地采用竞品 MinerU 2.5 Pro 及 PaddleOCR 输出的伪标签,用竞品管线生产训练语料。 - [06:09](https://www.bilibili.com/video/BV1QNx56xEEn?t=369s) 从十页走向任意页的关键不是盲目堆大模型参数,而是主动放弃无关全局结构以换取极致的局部转写稳定性。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1QNx56xEEn?t=0s) 前代爆款与二代口号:用 SR-SWA 改变注意力形状
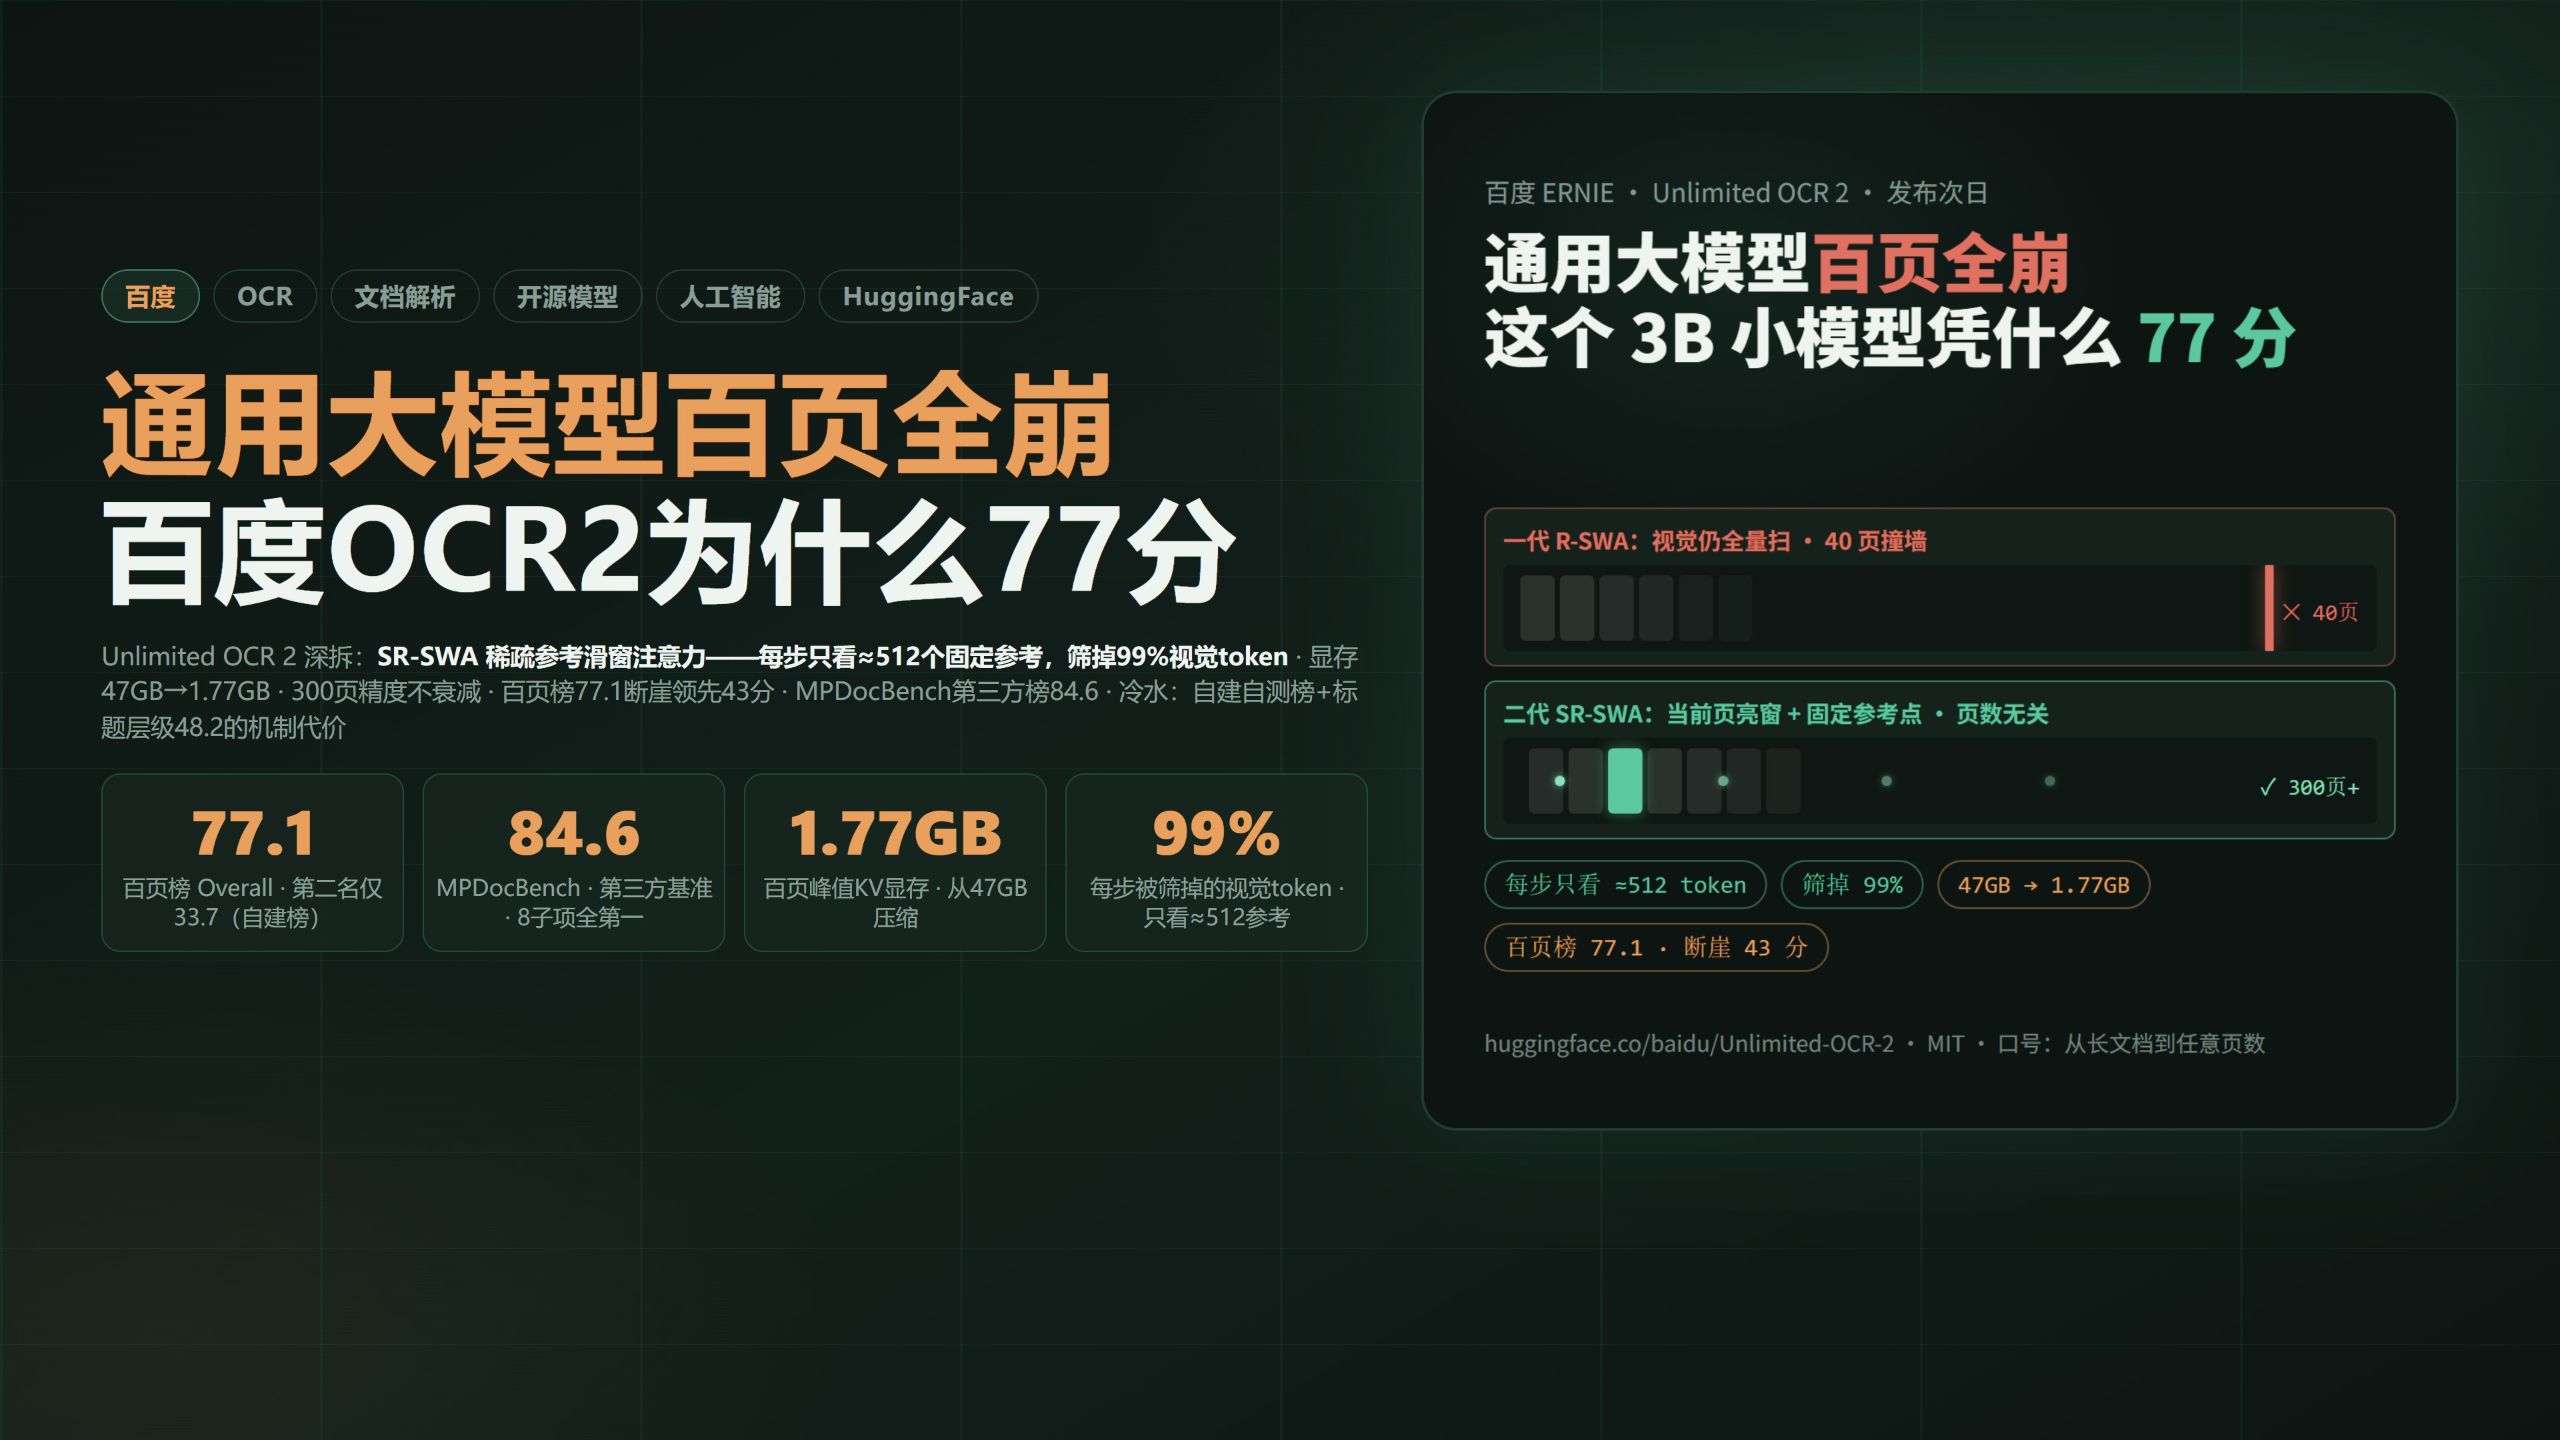
10 月 27 日,百度 ERNIE 团队开源了 Unlimited OCR 二代,模型权重以 MIT 协议托管在 Hugging Face。该系列的第一代在当年 6 月发布时曾是现象级爆款,上线仅 5 天 GitHub Star 破万,Hugging Face 下载量超 300 万次。二代要攻克的痛点写在产品口号中——“从长文档到任意页数”。很多用户都有类似体验:把一份 300 页的 PDF 塞给大模型,往往要么直接被模型拒识,要么读到几十页后便开始胡编乱造。面对通用长上下文在逐字解析上的乏力,百度给出的解法是“在模型内部把注意力本身改了形状”,提出了 SR-SWA(稀疏参考滑窗注意力)。正如技术报告中立意深刻的比喻:它是一个“只看它正在抄写的东西”的模型。
这种机制完全模拟了人类抄书的认知负荷:抄到第 200 页时,抄写者不可能把前 199 页从头重读一遍,而是只盯紧当前页,偶尔有需要时才回瞥一眼参照。一代模型虽已通过滑窗注意力将文本上下文长度压成了恒定开销,但还留着一个严重拖垮计算的“尾巴”:解码器在每写一个字符时,依然需要扫描文档中全部页面的视觉特征,页数越多负担越重,实测 40 页即撞上计算墙。二代通过两级架构彻底切掉了这条尾巴:第一级是“页门”(Page Gate),把注意力的搜索范围从全文档收窄到相关联的页面;第二级是“令牌筛”(Token Sieve),在选出的候选页中以固定预算挑选视觉特征。
```mermaid flowchart TD accTitle: SR-SWA 两级注意力筛选流程 accDescr: 展示 Unlimited OCR 二代如何将全量视觉 Token 经由页门和令牌筛过滤为固定工作参考,从而实现恒定显存与分块解码。
subgraph Input ["视觉输入阶段"] A["长文档输入<br/>(300页,约 8.1万+ 视觉 Tokens)"] end
subgraph Sieve ["SR-SWA 过滤机制"] B["第一级:页门 (Page Gate)<br/>收窄范围至相关关联页"] C["第二级:令牌筛 (Token Sieve)<br/>固定预算筛选"] end
subgraph Output ["解码与复用"] D["固定工作参考<br/>(~512 Tokens,筛除 99%)"] E["分块解码 (10页/块)<br/>边界页缓存直接复用"] end
A --> B B --> C C --> D D --> E ```
具体量化到数据层面: - **视觉 Token 压缩**:每页被编码为 273 个视觉 Token,300 页文档总计产生 8 万多个 Token;每一步解码仅提取约 512 个固定工作参考,直接筛除掉 99% 的多余视觉 Token。 - **显存与速度账单**:配合每 10 页一块的分块解码及边界页缓存复用机制,百页文档处理的峰值显存从 47 GB 骤降至 1.77 GB;单步解码速度相较全注意力快了 7 倍,吞吐量翻了近 3 倍(从 360 提升到 1315 TPS)。 - **极端压测演示**:官方模型卡给出的演示用例,是一次性单请求直接完整解析 3600 多页的整套《哈利·波特》。
[02:18](https://www.bilibili.com/video/BV1QNx56xEEn?t=138s) 两个榜单与通用旗舰的百页崩塌
二代的成绩单可以通过两个基准测试来评估。第一个是中科大与阿里通义实验室联合发布于 NeurIPS 2026 的第三方评测基准 MPDocBench,包含 400 多份文档,专门测试跨页阶段解析难题。二代在此基准上拿下 84.6 分,超越 Qwen3.8-Max 达 6.3 分,并在全部 8 个子项中斩获第一。
第二个则是百度随模型同日发布的自建百页基准 MarathonDocBench,该基准收录 100 份单份在 100 至 300 页之间的长文档,专门用于测试超长篇幅解析的耐力表现。二代在 MarathonDocBench 跑出 77.1 分,而第二名 Kimi-K3 仅为 33.7 分,双方拉开了 40 多分的巨大断层差距。比起单纯的分数,更有信息量的是通用大模型在长文档上的精度断崖:通用旗舰 Qwen3.8-Max 在几十页的常规档位尚有 78.3 分,进入百页档后分数直接腰斩至 22.9 分;Gemini-3.1-Pro 则在读到 223 页时直接请求失败并崩溃。博主借此指出,这一崩塌现象表明:“通用大模型的长上下文能力迁移不到逐字转录这种活上。”相比之下,二代的精度曲线从 2 页一路推进到 300 页基本保持平直。
| 评测基准 / 场景 | Unlimited OCR 2 | Qwen3.8-Max | Kimi-K3 | Gemini-3.1-Pro | 说明 | |:--- |:--- |:--- |:--- |:--- |:--- | | **MPDocBench** (第三方/NeurIPS 2026) | **84.6 分** (8项全第1) | 78.3 分 | - | - | 400+ 份跨页文档解析 | | **MarathonDocBench** (百页自建榜) | **77.1 分** | 22.9 分 | 33.7 分 | 223 页直接崩溃失败 | 100-300 页极长文档耐力测试 | | **精度衰减走势** | 2至300页曲线走平 | 几十页到百页断崖跌落 | 长程解析乏力 | 极长页数直接不可用 | 通用上下文无法复用于逐字转写 |
[03:24](https://www.bilibili.com/video/BV1QNx56xEEn?t=204s) 审视光环:自建测试、机制代价与细节毛边
面对亮眼的跑分,视频泼出了三盆理性的冷水。第一盆冷水直指榜单中立性:MarathonDocBench 是百度自建自测的基准,模型与评测榜同日推出。虽然数据与评测脚本均遵循 Apache 协议开源可供复现,但行业历史统计表明,在 13 个公开 OCR 评测榜中,有 10 个都是基准创建者自己高居第一;就连第三方榜单 MPDocBench 的榜首 PaddleOCR-VL 同样出自百度。加之模型刚发布一天,尚缺少完全独立的第三方实测检验。
第二盆冷水来自技术报告中的机制硬伤。百度在报告原文中坦承,由于稀疏注意力丢掉了全局信息,导致模型对标题层级等全局文档结构理解能力严重受限。其收益与代价是同一枚硬币的正反面:“筛掉了99%的视觉信息,也就筛掉了全局。”在 MarathonDocBench 百页榜上,二代的标题层级得分仅有 48.2 分,暴露了其对宏观层级认知的短板。
第三盆冷水则是工程细节上的毛边: - **参数口径矛盾**:报告正文写的激活参数为 5 亿,但同一份报告的架构图右边标注却是 5.7 亿,口径并未对齐。 - **部署框架局限**:目前推理仅官方支持 Transformers 和 SGLang 两套方案,一代所支持的主流高并发引擎 vLLM 暂时缺位。 - **发布初期热度**:二代上线第一天仅有 500 多次下载,社区热度尚未真正起势。
[04:44](https://www.bilibili.com/video/BV1QNx56xEEn?t=284s) 第三条路与主动舍弃的权衡
长文档解析技术生态主要分为三种技术路径。第一种是逐页管线派(如 MinerU、PaddleOCR、olmOCR),依靠一页一页拼切与启发式后处理规则来应对跨页表格,如同“一直在打补丁”。第二种是通用长上下文大模型派(如 Gemini、Kimi 等),完全依赖海量上下文窗口硬吞,但在转录场景下往往数十页就出现性能衰减。Unlimited OCR 二代开辟了第三条路:“专用模型加恒定注意力,页数长,开销不长。”在这个生态位上,目前行业内仅有百度一家。
这一突破并非使用了凭空出现的黑科技,滑窗注意力本身已是成熟方法,百度的贡献在于把“参考型滑窗、页面门控、视觉令牌筛”这套组合完整塞进了 OCR 解码器的所有注意力层中。此外,百度在 OCR 领域积淀深厚,工业级事实标准 PaddleOCR 与端到端多模态方案 PaddleOCR-VL 皆属百度旗下,甚至呈现出“管线派和端到端派前两名都姓百度”的格局。技术实现中还有一个耐人寻味的细节:二代在训练使用的伪标签,直接采纳了竞品 MinerU 2.5 Pro 与自家 PaddleOCR 的输出,等于“用竞品的管线给自己造教材”。
对于百度的这种设计,博主给出了最终的技术判断:“只看正在抄写的东西,这个取舍抄写对了,精度300页不衰减,但全局视野也交出去了,标题层级48分就是账单。”正是因为“OCR从十页级走到任意页级,中间隔着的不是更大的模型,是一次主动的舍弃”,通过舍弃无关宏观结构换取了极限的转录稳定性。项目代码已全面开源,最终的实用价值有待第三方开发者在实际生产中验证。
## Notable quotes > [04:44](https://www.bilibili.com/video/BV1QNx56xEEn?t=284s) OCR从十页级走到任意页级,中间隔着的不是更大的模型,是一次主动的舍弃 — AI技术投降派
> [02:18](https://www.bilibili.com/video/BV1QNx56xEEn?t=138s) 通用大模型的长上下文能力迁移不到逐字转录这种活上。 — AI技术投降派
## Mentioned 百度, ERNIE 团队, Unlimited OCR 2, Unlimited OCR, SR-SWA, MPDocBench, MarathonDocBench, Qwen3.8-Max, Kimi-K3, Gemini-3.1-Pro, PaddleOCR, PaddleOCR-VL, MinerU, MinerU 2.5 Pro, olmOCR, 中科大, 阿里通义实验室, Transformers, SGLang, vLLM, Hugging Face, GitHub, NeurIPS, 《哈利·波特》
## Video description 昨天,十月二十七号,百度 ERNIE 团队开源 Unlimited OCR 二代(MIT,权重全开)。它的前代是今年的爆款:六月发布五天 GitHub 破万星、HuggingFace 下载三百多万次。二代的口号是从长文档到任意页数——你自己大概率也遇过:三百页 PDF 丢给大模型,要么被拒要么吃到几十页开始胡编。百度给出的答案,是把注意力本身改了形状。
00:06 前代爆款与二代的口号 00:48 SR-SWA:只看正在抄写的东西 02:18 两个榜:第三方 84.6 与自建断崖 77.1 03:24 三盆冷水:自建自测榜与机制的代价 04:44 第三条路:赛道里唯一的任意页数 06:09 判断:一次主动的舍弃
核心机制 SR-SWA(稀疏参考滑窗注意力)的报告立意:一个「只看它正在抄写的东西」的模型——人抄书时只盯当前页、偶尔回瞥参照。一代已把文本记忆压成恒定,但每写一个字仍要扫全部页面的视觉信息,实测 40 页撞墙;二代用页门+令牌筛两级结构把视觉也钉死:每页 273 个视觉 token、300 页 8 万多个,每步解码只看约 512 个固定工作参考,其余 99% 被筛掉。账单:百页峰值显存 47GB→1.77GB、单步比全注意力快 7 倍、吞吐 360→1315 TPS;模型卡演示是整套哈利波特 3600+ 页一次请求解析完。
两个榜两种读法:MPDocBench 是第三方基准(中科大×阿里通义,NeurIPS 2026),84.6 超过 Qwen3.8-Max 6.3 分、八个子项全第一;MarathonDocBench 是百度同日发布的自建百页榜,77.1 对第二名 Kimi-K3 的 33.7——43 分断崖。更有信息量的是通用旗舰的崩塌:Qwen3.8-Max 从几十页档 78.3 掉到百页档 22.9,Gemini-3.1-Pro 在 223 页直接失败——通用长上下文迁移不到逐字转录。二代的精度曲线 2 到 300 页基本是平的。三盆冷水照旧:自建自测榜(行业统计 13 个 OCR 榜 10 个是创建者自己登顶,MPDocBench 榜首 PaddleOCR-VL 也是百度);机制自认代价(报告原文承认稀疏注意力不保存全局文档信息——标题层级 48.2 分就是账单,筛掉 99% 也筛掉了全局);细节毛边(激活参数 5 亿/5.7 亿口径不一、vLLM 暂缺)。赛道上它占的是第三条路:逐页管线在打补丁、通用长上下文十页衰减,专用模型+恒定注意力这个生态位目前只有它一家——而且管线派与端到端派前二名都姓百度,二代训练伪标签还用了竞品 MinerU2.5-Pro 的输出。
模型:huggingface.co/baidu/Unlimited-OCR-2(MIT · Transformers/SGLang · 演示 Space 官方在架)
[Source](https://www.bilibili.com/video/BV1QNx56xEEn)