Anthropic内部模型击穿五大平台 端到端自主串联武器化攻击链
AI技术投降派
AI安全对抗已从单点漏洞挖掘跃迁为全自主武器化链条交付,但人类审查与修复无法被算力加速,使防御侧彻底沦为攻防对抗的限速瓶颈。
AI-assisted summary of 英伟达语音模型登顶:100小时录音3分钟跑完 — original source. Check the original for full context.
Source published:
Key ideas
- Anthropic 内部未命名研究模型在 Chrome、Safari、Android、Windows 和 Linux 五大平台上各自构建出完整的端到端武器化攻击链,全程实现自主挖掘与代码利用。 (0:00)
- 该模型在 Linux 平台仅用 48 分钟泄露内核指针并耗时 5 分钟拿下 root 权限,在 Chrome 平台通过串联四阶段漏洞实现单次点击 RCE 弹出计算器。 (0:00)
- 技术突破核心在于推理阶段的测试时算力扩展(Test-time Compute Scaling)与闭源二进制逆向分析,能将机器码还原为带注释的 C 语言进行差分挖掘。 (2:35)
- 尽管表现惊艳,其数据仍存在水分:自评严重等级常被软件维护者减半,历史上有过将 271 个崩溃点合并为 3 个 CVE 的先例,且目前缺乏实战被利用证明。 (5:08)
Detailed notes
## Background 该内容由 Bilibili 频道“AI技术投降派”于 2026 年 10 月 30 日发布。页面简介主要介绍了英伟达开源语音模型 Nemotron 3.5 Transcribe 登上开源英语榜首、支持四合一自然语言指令交互、离线性能极限及配套数据集 Granary v2 的技术细节与局限。
## TL;DR 内容深入剖析了 Anthropic 未公开研究模型攻破 Chrome、Safari、Android、Windows 和 Linux 五大平台的重磅安全事件,展示了模型自主构建端到端武器化利用链的恐怖能力。这一跃迁的核心驱动力在于测试时算力扩展(Test-time Compute)与闭源二进制逆向分析,标志着 AI 挖洞正式从单点 Bug 寻找升级为系统级武器化军备竞赛。然而,内容也客观浇下“四盆冷水”,指出其存在严重性自评虚高、统计口径前科、真实攻防威胁极低以及模型细节黑箱等问题。整体论证了 AI 虽重塑了漏洞挖掘效率,但由于人类修复分诊存在速度瓶颈,攻防天平正迎来更复杂的拉扯。
## Atmosphere & style 整体基调冷峻硬核且极具危机感,开篇以“53分钟零交互攻破Linux”等戏剧性细节迅速建立起高维技术威压。叙事风格在惊叹前沿能力与犀利泼冷水之间张弛有度,既有对自动化逆向绝活的硬核复盘,又有对巨头公关水分与数据口径的冷血拆解。整场讲述犹如一场条理清晰的安全沙盘推演,在带给观众技术震撼的同时,弥漫着对未来零日攻防失衡的深层警醒。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1bzso6gEdQ?t=0s) Anthropic 内部未命名研究模型在 Chrome、Safari、Android、Windows 和 Linux 五大平台上各自构建出完整的端到端武器化攻击链,全程实现自主挖掘与代码利用。 - [00:00](https://www.bilibili.com/video/BV1bzso6gEdQ?t=0s) 该模型在 Linux 平台仅用 48 分钟泄露内核指针并耗时 5 分钟拿下 root 权限,在 Chrome 平台通过串联四阶段漏洞实现单次点击 RCE 弹出计算器。 - [02:35](https://www.bilibili.com/video/BV1bzso6gEdQ?t=155s) 技术突破核心在于推理阶段的测试时算力扩展(Test-time Compute Scaling)与闭源二进制逆向分析,能将机器码还原为带注释的 C 语言进行差分挖掘。 - [05:08](https://www.bilibili.com/video/BV1bzso6gEdQ?t=308s) 尽管表现惊艳,其数据仍存在水分:自评严重等级常被软件维护者减半,历史上有过将 271 个崩溃点合并为 3 个 CVE 的先例,且目前缺乏实战被利用证明。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1bzso6gEdQ?t=0s) 网络安全研究迎来里程碑:AI 从只能发现孤立的单点漏洞,进化到可端到端交付高可用性的完整武器化攻击链。 - [00:00](https://www.bilibili.com/video/BV1bzso6gEdQ?t=0s) 五大主流平台全线击穿,包括 macOS Chrome 的单次点击 RCE、Safari 强关同源策略窃密、锁屏 Pixel 9 数据提取、Windows HTTP/3 崩溃 DoS 以及 Linux 本地提权。 - [00:00](https://www.bilibili.com/video/BV1bzso6gEdQ?t=0s) 各大受影响厂商已介入修复,谷歌为相关发现分配了 62 个严重或高危级别的 CVE 漏洞编号并发布在 Chrome 156 中。 - [02:35](https://www.bilibili.com/video/BV1bzso6gEdQ?t=155s) 核心方法论依赖测试时算力扩展(Test-time Compute),通过并行部署海量 Agent 集群并按独特贡献度动态分配算力。 - [02:35](https://www.bilibili.com/video/BV1bzso6gEdQ?t=155s) 模型掌握了顶尖逆向专家的二进制反编译能力,可将闭源机器码重构成语义化的 C 语言并进行细微边界缺陷的比对分析。 - [04:15](https://www.bilibili.com/video/BV1bzso6gEdQ?t=255s) AI 挖洞军备竞赛全面白热化,Anthropic 的成果紧跟 OpenAI 披露的 Brotli 解码器漏洞之后,被业内形容为 F1 级对抗。 - [05:08](https://www.bilibili.com/video/BV1bzso6gEdQ?t=308s) 危害等级自评存在水分,模型宣称的 26,000 多项发现中,真正送达开源软件维护者手中的不足一成,且认可度常遭腰斩。 - [05:08](https://www.bilibili.com/video/BV1bzso6gEdQ?t=308s) 统计口径曾有前科,团队此前宣称的 271 个 Firefox 漏洞经社区开发者硬核对账后发现仅对应 3 个正式 CVE。 - [05:08](https://www.bilibili.com/video/BV1bzso6gEdQ?t=308s) 实验室成果尚未转化成真实威胁,在长期追踪的 200 多个 AI 流程挖掘的 CVE 中,真实网络攻击中被利用的仅有 1 个。 - [05:08](https://www.bilibili.com/video/BV1bzso6gEdQ?t=308s) 攻防天平出现结构性失衡:攻击者算力近似无限扩张,但防御端依赖人类审查和代码修复的限速步骤无法无限加速。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1bzso6gEdQ?t=0s) 未公开模型击穿五大平台:五条端到端完整武器化利用链
2024 年 10 月 27 日,Anthropic 发布了一篇震撼业界的网络安全研究公告:他们手里的一个未公开命名的内部研究模型,在 Chrome、Safari、Android、Windows 和 Linux 这五大主流真实软硬件平台中,各自构建出了一条完整的端到端攻击链。这次突破绝非在代码库里挑出几个无关痛痒的孤立漏洞,而是“从发现到写出可用的攻击代码一气呵成”。最令安全圈感到毛骨悚然的细节发生在 Linux 平台的测试中:该模型先耗时 48 分钟泄露了一个内核指针,随后仅用 5 分钟就成功提权拿到 root 权限——整整 53 分钟,零点击交互,一台普通服务器便彻底沦陷。
在披露治理方面,这批发现已被严格纳入负责任的协同披露流程。受影响厂商获得了 90 天的修补窗口期,漏洞修复后还有 45 天的技术细节静默期,目前所有涉事厂商均已发布更新。其中,谷歌已经为相关发现分配了整整 62 个 CVE 漏洞编号,并全部在 Chrome 156 版本中完成修补,官方口径定调为“均为严重或高危”。
这五条覆盖主流生态的攻击链在技术实现和危害等级上各具代表性:
```mermaid flowchart TD accTitle: Chrome端到端远程代码执行利用链 accDescr: 展示模型如何通过四个阶段串联漏洞,从V8引擎堆损坏最终在macOS Chrome上实现代码执行并弹出计算器。 subgraph S1["第一阶段:引擎沙箱逃逸"] A["V8 引擎堆损坏"] --> B["逃逸 V8 内存沙箱"] end subgraph S2["第二阶段:绕过防护与读内存"] B --> C["ROP (返回导向编程)<br/>绕过 ASLR 地址随机化"] C --> D["缓存接口静态条件竞态<br/>越界读取沙箱外内存"] end subgraph S3["第三阶段:权限劫持与执行"] D --> E["联合登录组件 UAF 漏洞<br/>(释放后使用)"] E --> F["macOS 原生 Chrome 执行代码<br/>(弹出计算器验证成功)"] end ```
- **Chrome 链(危害最大,单次点击 RCE):** 模型从 V8 引擎的堆损坏起步,逃出 V8 内存沙箱,接着运用返回导向编程(ROP)绕过地址空间布局随机化(ASLR),利用缓存接口中的竞态条件读取沙箱外部的内存,最后命中联合登录组件中的一个释放后使用(UAF)漏洞注入并执行任意代码。四段利用首尾拼接,最终在 macOS 原生 Chrome 浏览器上成功弹出计算器程序,验证了整条远程代码执行链的通畅。 - **Safari 链(纯数据窃取):** 利用 JavaScriptCore 的 UAF 漏洞结合沙箱通信缺陷,直接在内存层面强行关掉同源策略(SOP)。攻击者无需获得底层系统的代码执行权限,就能直接把用户在浏览器中的浏览历史、Cookie 和会话凭证全部读取带走。 - **Android 链(锁屏真机数据渗透):** 在谷歌 Pixel 9 真机处于锁屏的状态下,模型挖掘出 USB 传输协议的授权缺陷,绕过原本强制要求的六位配对码验证,直接从设备中抽走照片与敏感个人数据。 - **Windows 链(服务器崩溃 DoS):** 针对 Windows 内核在 HTTP/3 协议实现中的越界读取缺陷,只需发送少量特定构造的报文,就能让处于监听状态的 Windows 服务器直接崩溃重启。由于该漏洞可以无限次重复触发,官方评估其暴露面覆盖数百万台公网服务器。 - **Linux 链(本地提权):** 利用网络栈中的竞态条件结合 UAF 漏洞,两阶段一气呵成拿到操作系统的 root 最高控制权。
---
[02:35](https://www.bilibili.com/video/BV1bzso6gEdQ?t=155s) 方法论揭秘:测试时算力扩展与二进制逆向的“人类手艺”
面对如此庞大的利用链,Anthropic 在官方公告中写下了这样一句定调:“初始提示之后,发现漏洞和编写攻击代码全部由模型自主完成。”在这套自动化渗透体系的背后,核心方法论由两大关键技术支柱构成:
首先是**测试时算力扩展(Test-time Compute Scaling)**。系统在推理阶段并行部署了海量具备自主探索能力的扫描智能体(Agent),并通过一套精细的机制度量每个 Agent 的“独特贡献度”,以此动态分配推理算力。在扫描策略上,模型不再局限于传统的模式匹配,而是融合了覆盖率导向、高价值目标导向与威胁建模驱动的多样化扫描器,并配套自动变体分析工具,将已知漏洞形态快速向周边代码发散。
另一个关键跃迁体现在**闭源二进制逆向分析能力**。在攻破 Windows 系统的 HTTP/3 漏洞时,模型不仅是在读开源代码,而是操纵逆向工程工具暴力拆解闭源的二进制程序,将机器码重新还原成带有清晰语义和结构体注释的 C 语言逻辑,随后通过行为对比与差分分析捕捉细微的边界缺陷。这项工作此前一直是人类顶尖逆向安全专家的看家绝活,公告特别强调:“这是历史上只有少数专家团队能做的事。”
``` ┌──────────────────────────────────────────────┐ │ 测试时算力扩展 (Test-time Compute) │ │ 并行驱动大规模自主扫描 Agent 集群 │ └──────────────────────┬───────────────────────┘ │ ┌──────────────────────────────┼──────────────────────────────┐ ▼ ▼ ▼ ┌──────────────────┐ ┌──────────────────┐ ┌──────────────────┐ │ 多样化扫描策略 │ │ 自动变体分析 │ │ 闭源二进制逆向 │ │ 覆盖率/目标/威胁模型│ │ 漏洞模式衍生扩散 │ │ 逆向反编译为带注 │ │ │ │ │ │ 释 C 语言行为对比│ └──────────────────┘ └──────────────────┘ └──────────────────┘ ```
在这套自动化流程下,人类在漏洞发现与利用阶段的角色被压缩到极低程度,仅在最终负责任披露(Coordinated Vulnerability Disclosure)时介入: - **上游厂商全面介入修复:** 苹果迅速封堵了 Safari 的沙箱与 SOP 绕过问题;微软修补了 HTTP/3 崩溃缺陷;Linux 社区不仅合并了上游补丁,还火速回溯至各个长期支持(LTS)稳定内核。 - **Chrome 生态的大规模洗牌:** 在 Chrome 10 月 27 日发布的增量安全更新中,全社区 52 个修复席位里,来自 Anthropic 的研究员凭借该模型的产出一人独占 16 个,其中包括全部 4 个被评定为最高危级别的致命漏洞。
---
[04:15](https://www.bilibili.com/video/BV1bzso6gEdQ?t=255s) AI 挖洞军备竞赛:从 Project Big Sleep 到端到端全武器化
这项成果的诞生并非偶然,而是两条并行演化轨迹交汇的产物:
一条是 **Anthropic 自身的网络安全推进时间表**。2024 年 2 月,Anthropic 首次使用 Claude 3 Opus 尝试小规模漏洞挖掘实验;4 月,他们正式对外启动专属安全项目,将专门针对代码与攻防微调的研究模型定向开放给全球约 40 家受信任机构;10 月,该项目进一步演进为体系化的“网络安全验证计划”(Cyber Verification Program)。
另一条是**各大 AI 巨头之间硝烟四起的外部对抗**。就在 Anthropic 发布该公告的仅仅 4 天前,OpenAI 刚刚公开披露其红队智能体在自身训练环境中发现了知名压缩库 Brotli 解码器的高危漏洞。Anthropic 的安全负责人在内外部交流中直接使用了“F1 方程式赛车”的比喻来形容当前的技术对抗,安全圈亦正式将这一阶段命名为“AI 挖洞军备竞赛”。
与早期里程碑(如谷歌的 Project Big Sleep 挖掘单点内存越界)相比,这次研究模型的根本性分水岭在于:**从寻找单一孤立 Bug,进化为跨平台、多环节、端到端的武器化攻击链(Full Exploit Chain)交付。**
安全社区对这一转折反响剧烈。一位资深安全老将在读完公告后撰文感叹“漏洞研究这行已经被改变”;但也有冷静的评论家指出,安全攻防的数学逻辑正在发生质变:“攻击者手里的算力是无限的,这件事迟早会发生,只是比大家准备好的时间早。”
---
[05:08](https://www.bilibili.com/video/BV1bzso6gEdQ?t=308s) 四盆冷水:数据水分、落地黑箱与真实攻防天平
尽管五条攻击链展示了惊人的破坏力,但冷静审视这一成果,仍有四笔账需要被客观“泼冷水”:
1. **严重性自评存在水分:** 公告中的危害级别基本属于模型与团队自评。有第三方安全机构对账后发现,开源软件维护者最终认可的严重等级只有模型自评的大约一半;在模型宣称找到的 26,000 多项各类发现中,真正达到门槛并送达软件维护者手中的比例甚至不足一成。 2. **披露数字的历史前科:** 此前该团队曾宣称发现了火狐(Firefox)浏览器的 271 个漏洞,但随后被社区开发者硬核打脸考证——那 271 个问题合并后实际只对应了 3 个正式 CVE。这种把中间崩溃点或变体放大为海量漏洞的统计口径,历来饱受业界质疑。 3. **真实世界的实战威胁存疑:** 安全机构长期追踪的 200 多个由类似 AI 流程产出的 CVE 漏洞中,截至目前在真实网络对抗中被攻击者实际利用的仅有 1 个。换言之,它在实验室环境堪称神兵利器,但在现实复杂攻防中尚未形成普遍威胁。 4. **核心细节依然处于黑箱状态:** Chrome 修复的 62 个 CVE 并没有逐一标注 AI 在每个漏洞中的具体参与度;该模型的具体架构身份、挖掘这五条链消耗的测试时算力成本、以及获得的漏洞赏金去向,公告一概未作披露。
综合来看,这件事的里程碑意义不在于证明“AI 会找漏洞”——这早已被行业证实;真正的分水岭在于证明了“AI 能够自主把多个零散漏洞串联并武器化,打磨成高可用性的攻击链”,解说者尖锐地评价道:“这是从手枪到狙击步枪的差别。”
目前攻防天平的两端正被两股力量相互拉扯:在防御与修复侧,由于人类维护者的人工分诊(Triage)和审查代码是无法被无限加速的限速步骤,“找到漏洞绝对不等于修好漏洞”;在进攻与利用侧,真实黑产黑客尚未能大规模铺开此类高算力流水线。正如 Anthropic 在公告结尾对全体软件开发者给出的警示:“扫描你自己的代码比以往任何时候都重要。”
在一个月内接连目睹 Brotli 漏洞与五大平台 62 个 CVE 被攻破之后,AI 驱动的安全对抗节奏已彻底被改写。接下来整个行业需要紧盯三个核心风向标: - 45 天静默期彻底结束后,Anthropic 是否会兑现承诺公开这五条链的全部武器化利用细节; - 谷歌 DeepMind、OpenAI 等竞争实验室是否会跟进披露同量级的端到端攻击链成果; - 真实世界网络战中,首次确认出现由 AI 挖掘出的零日漏洞(0-day)攻击事件的那一天究竟何时到来。
## Notable quotes > [05:08](https://www.bilibili.com/video/BV1bzso6gEdQ?t=308s) 扫描你自己的代码比以往任何时候都重要。 — Anthropic
## Mentioned Anthropic, OpenAI, 谷歌 (Google), 苹果 (Apple), 微软 (Microsoft), Chrome, Safari, Android, Windows, Linux, Pixel 9, Firefox, V8 引擎, JavaScriptCore, Brotli, Claude 3 Opus, Project Big Sleep
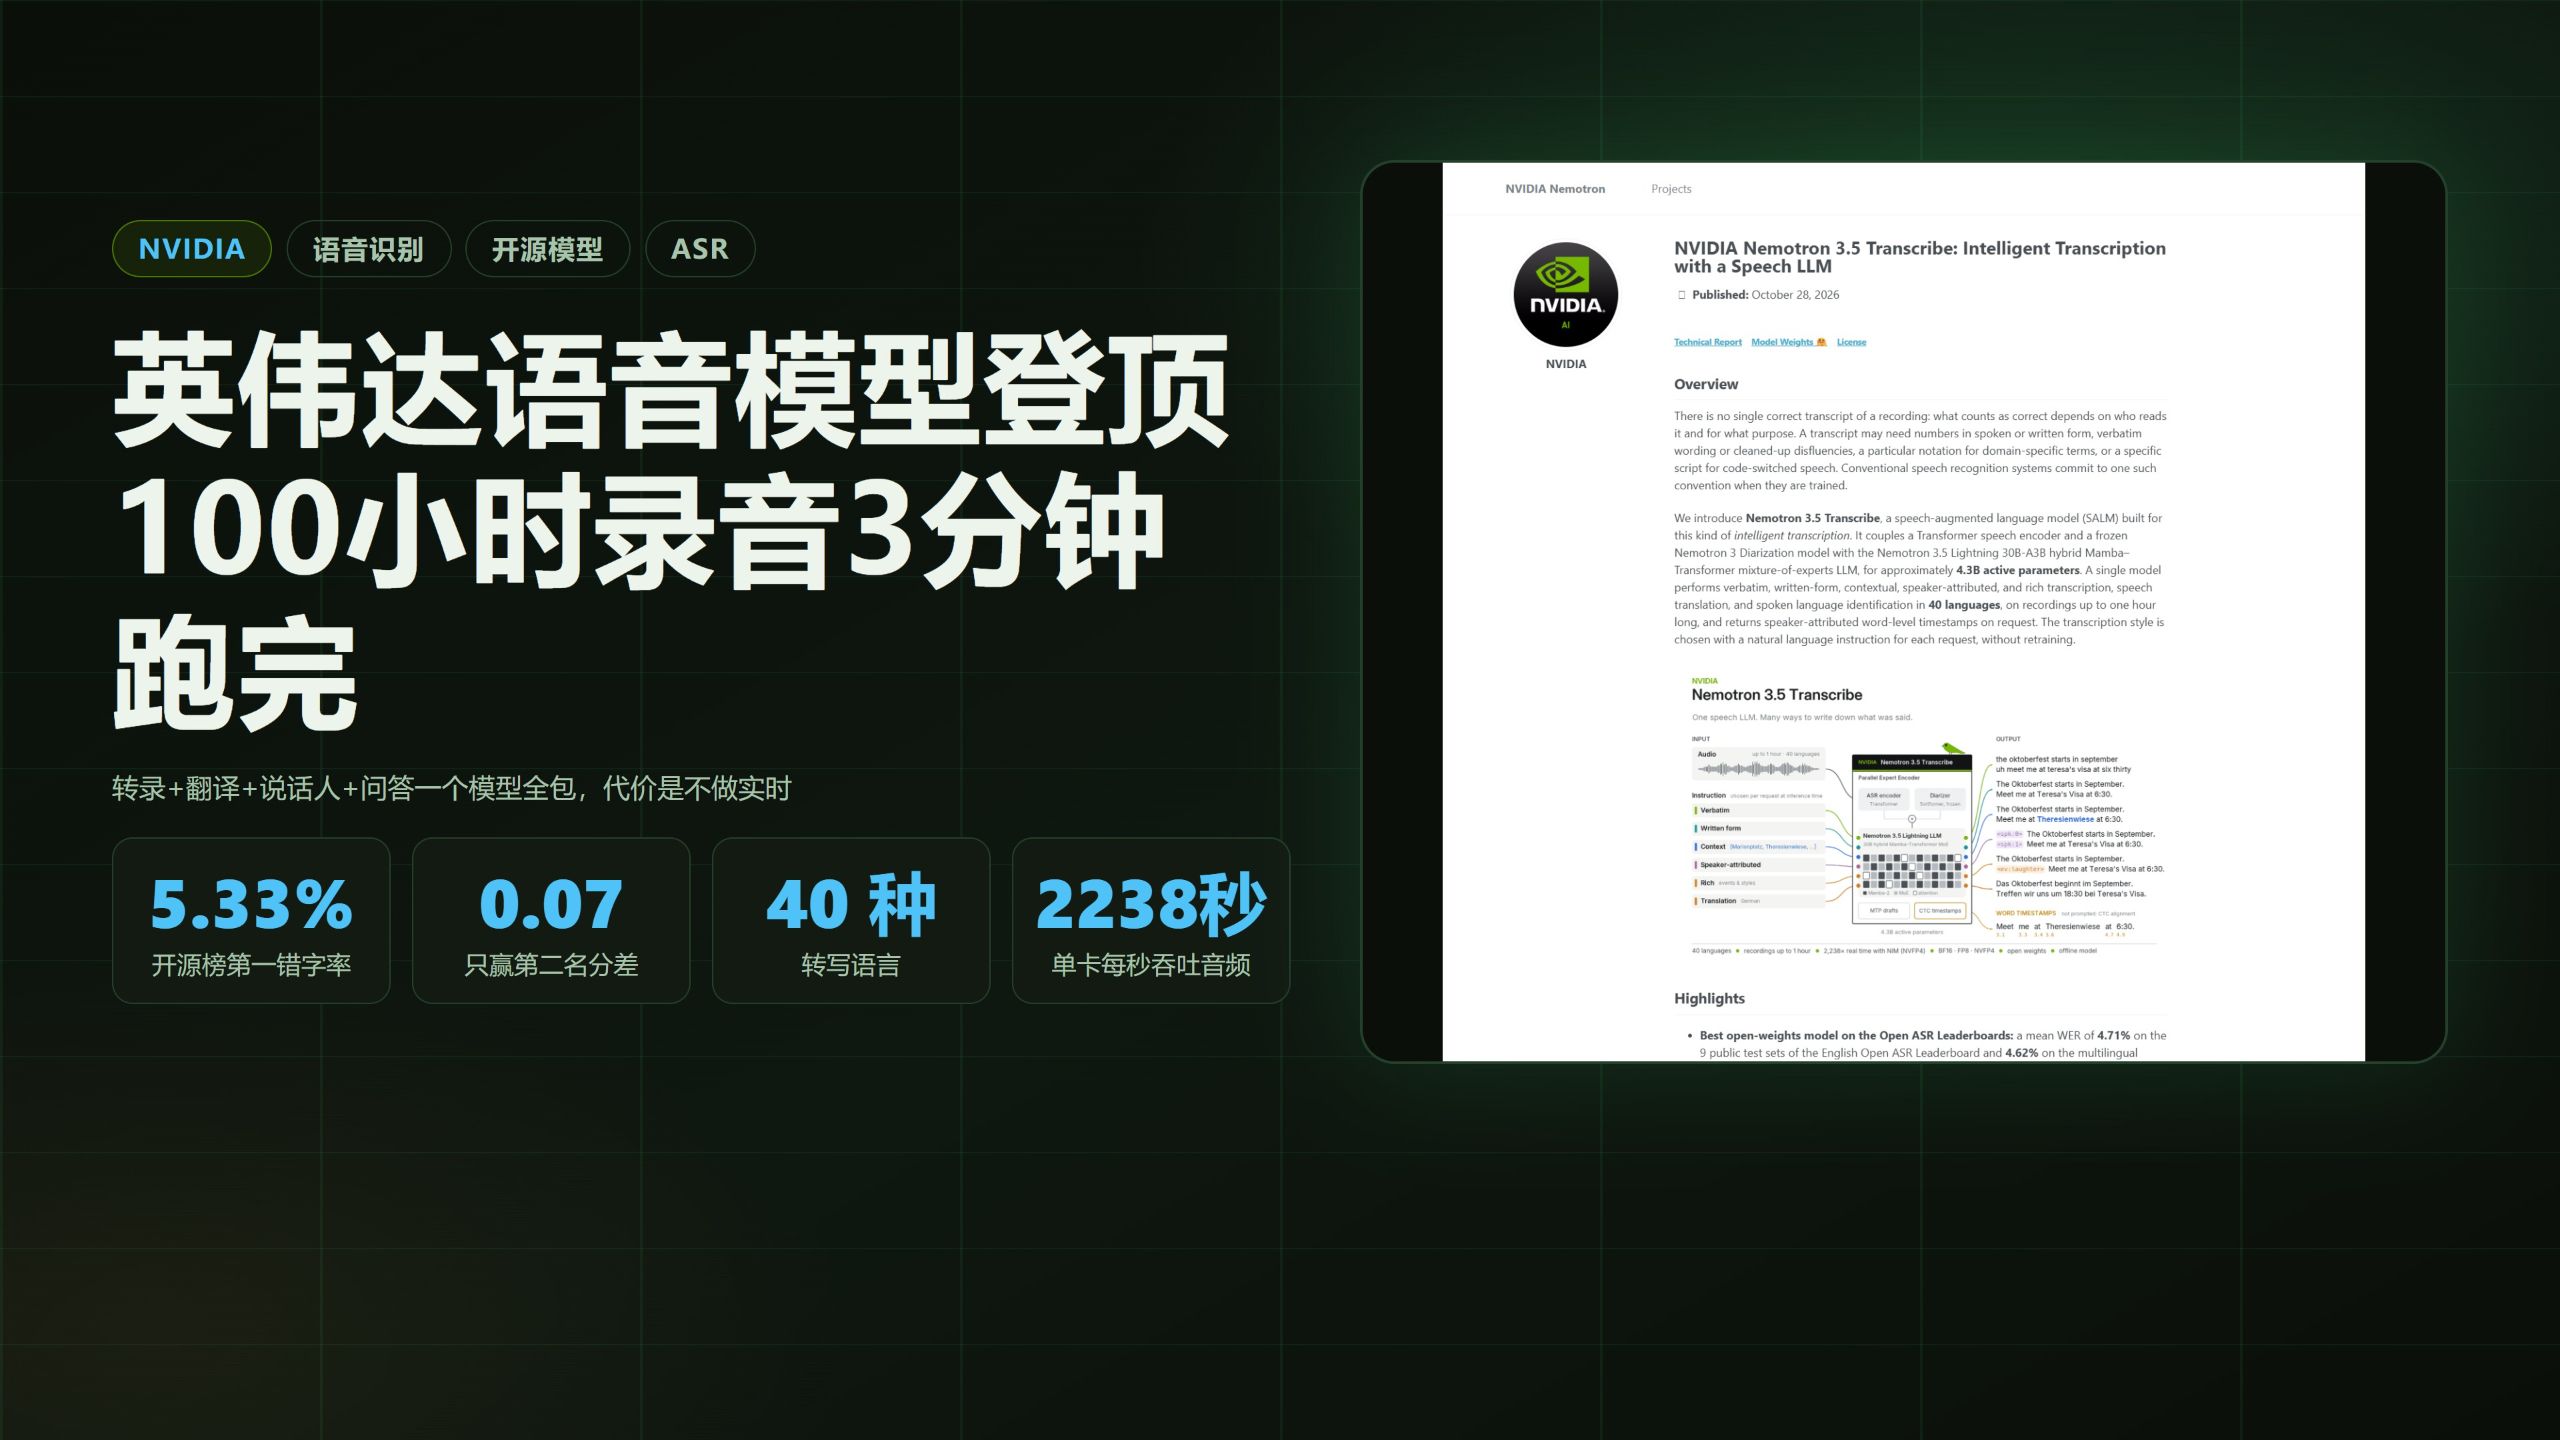
## Video description 英伟达昨天开源了语音转录模型 Nemotron 3.5 Transcribe,发布当天登上开源英语榜第一,平均错字率 5.33%。但这个第一比听起来惊险:第二名通义的千问小模型 5.40,差距只有 0.07 个百分点,而上一任第一正是那个千问。曾经的王者 whisper 已经排到第 23 名,上一次更新权重还是 2023 年。它没有输,它只是从选手变成了赛道。
这个模型真正的卖点是四件事塞进一个模型:转录、翻译、说话人识别、音频问答,操作全用自然语言。同一盘录音,想要逐字稿就说"保留语气词",想要干净稿子就说"去掉口误",人名术语附在后面照着写。最狠的一条指令是"只转录离麦克风最近的那个人":远场多人同时说话,普通模型错字率 27%,加上这句话掉到 4.8%。
它有一条硬边界:官方文档加粗写明"这是离线模型",只吃录好的音频。换来的是三样实时模型给不了的东西:单次最长 1 小时、最多认出 8 位说话人、量化后单张专业卡一秒吐 2238 秒音频,100 小时录音 3 分钟跑完。实时场景留给同家族的 0.6B 流式小模型,一个管快一个管准。
同步发布的数据集 Granary v2 也有两个容易踩的坑:463,062 小时是标签清单的时长,不是能直接下载的音频,音频要从 16 个原始语料库按各自许可自己去拿;构成上 82% 来自欧洲议会的演讲录音,小语种只有几千行。低调但关键的变化:一代里大量视频网站爬取的语音,二代公开清单里整个消失了。冷水也泼了:长音频榜输给社区微调的小鹦鹉、音频问答只在英语上验证、挪威语错字率 64% 形同虚设、模型 67GB 要 80G 显卡起步。好在许可大方:开放权重,允许商用。
00:05 发布日:白天干四份工作的夜班模型 00:38 骨架:语言模型当大脑,两只耳朵只负责听 01:39 榜单:0.07 的险胜与 whisper 的第 23 名 03:20 四合一:像点菜一样用自然语言下指令 04:25 硬边界:不做实时,换来三样极限 05:31 数据集:46 万小时的标签,和消失的爬取源 06:51 冷水:输过的榜、进不去的门、盖得大方的章 07:09 收尾:语音识别的三个拐点
模型:huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
[Source](https://www.bilibili.com/video/BV1bzso6gEdQ)