蚂蚁开源560B基座与指令模型 纯MIT大MoE阵营扩至三家
AI技术投降派
蚂蚁通过7比1混合注意力与同步开放全量基座,在超大MoE领域凑齐了商业无限制与超长上下文的唯一交集,进一步打破闭源大模型的垄断叙事。
AI-assisted summary of 蚂蚁560B开源文本模型:一个月分数三级跳 — original source. Check the original for full context.
Source published:
Key ideas
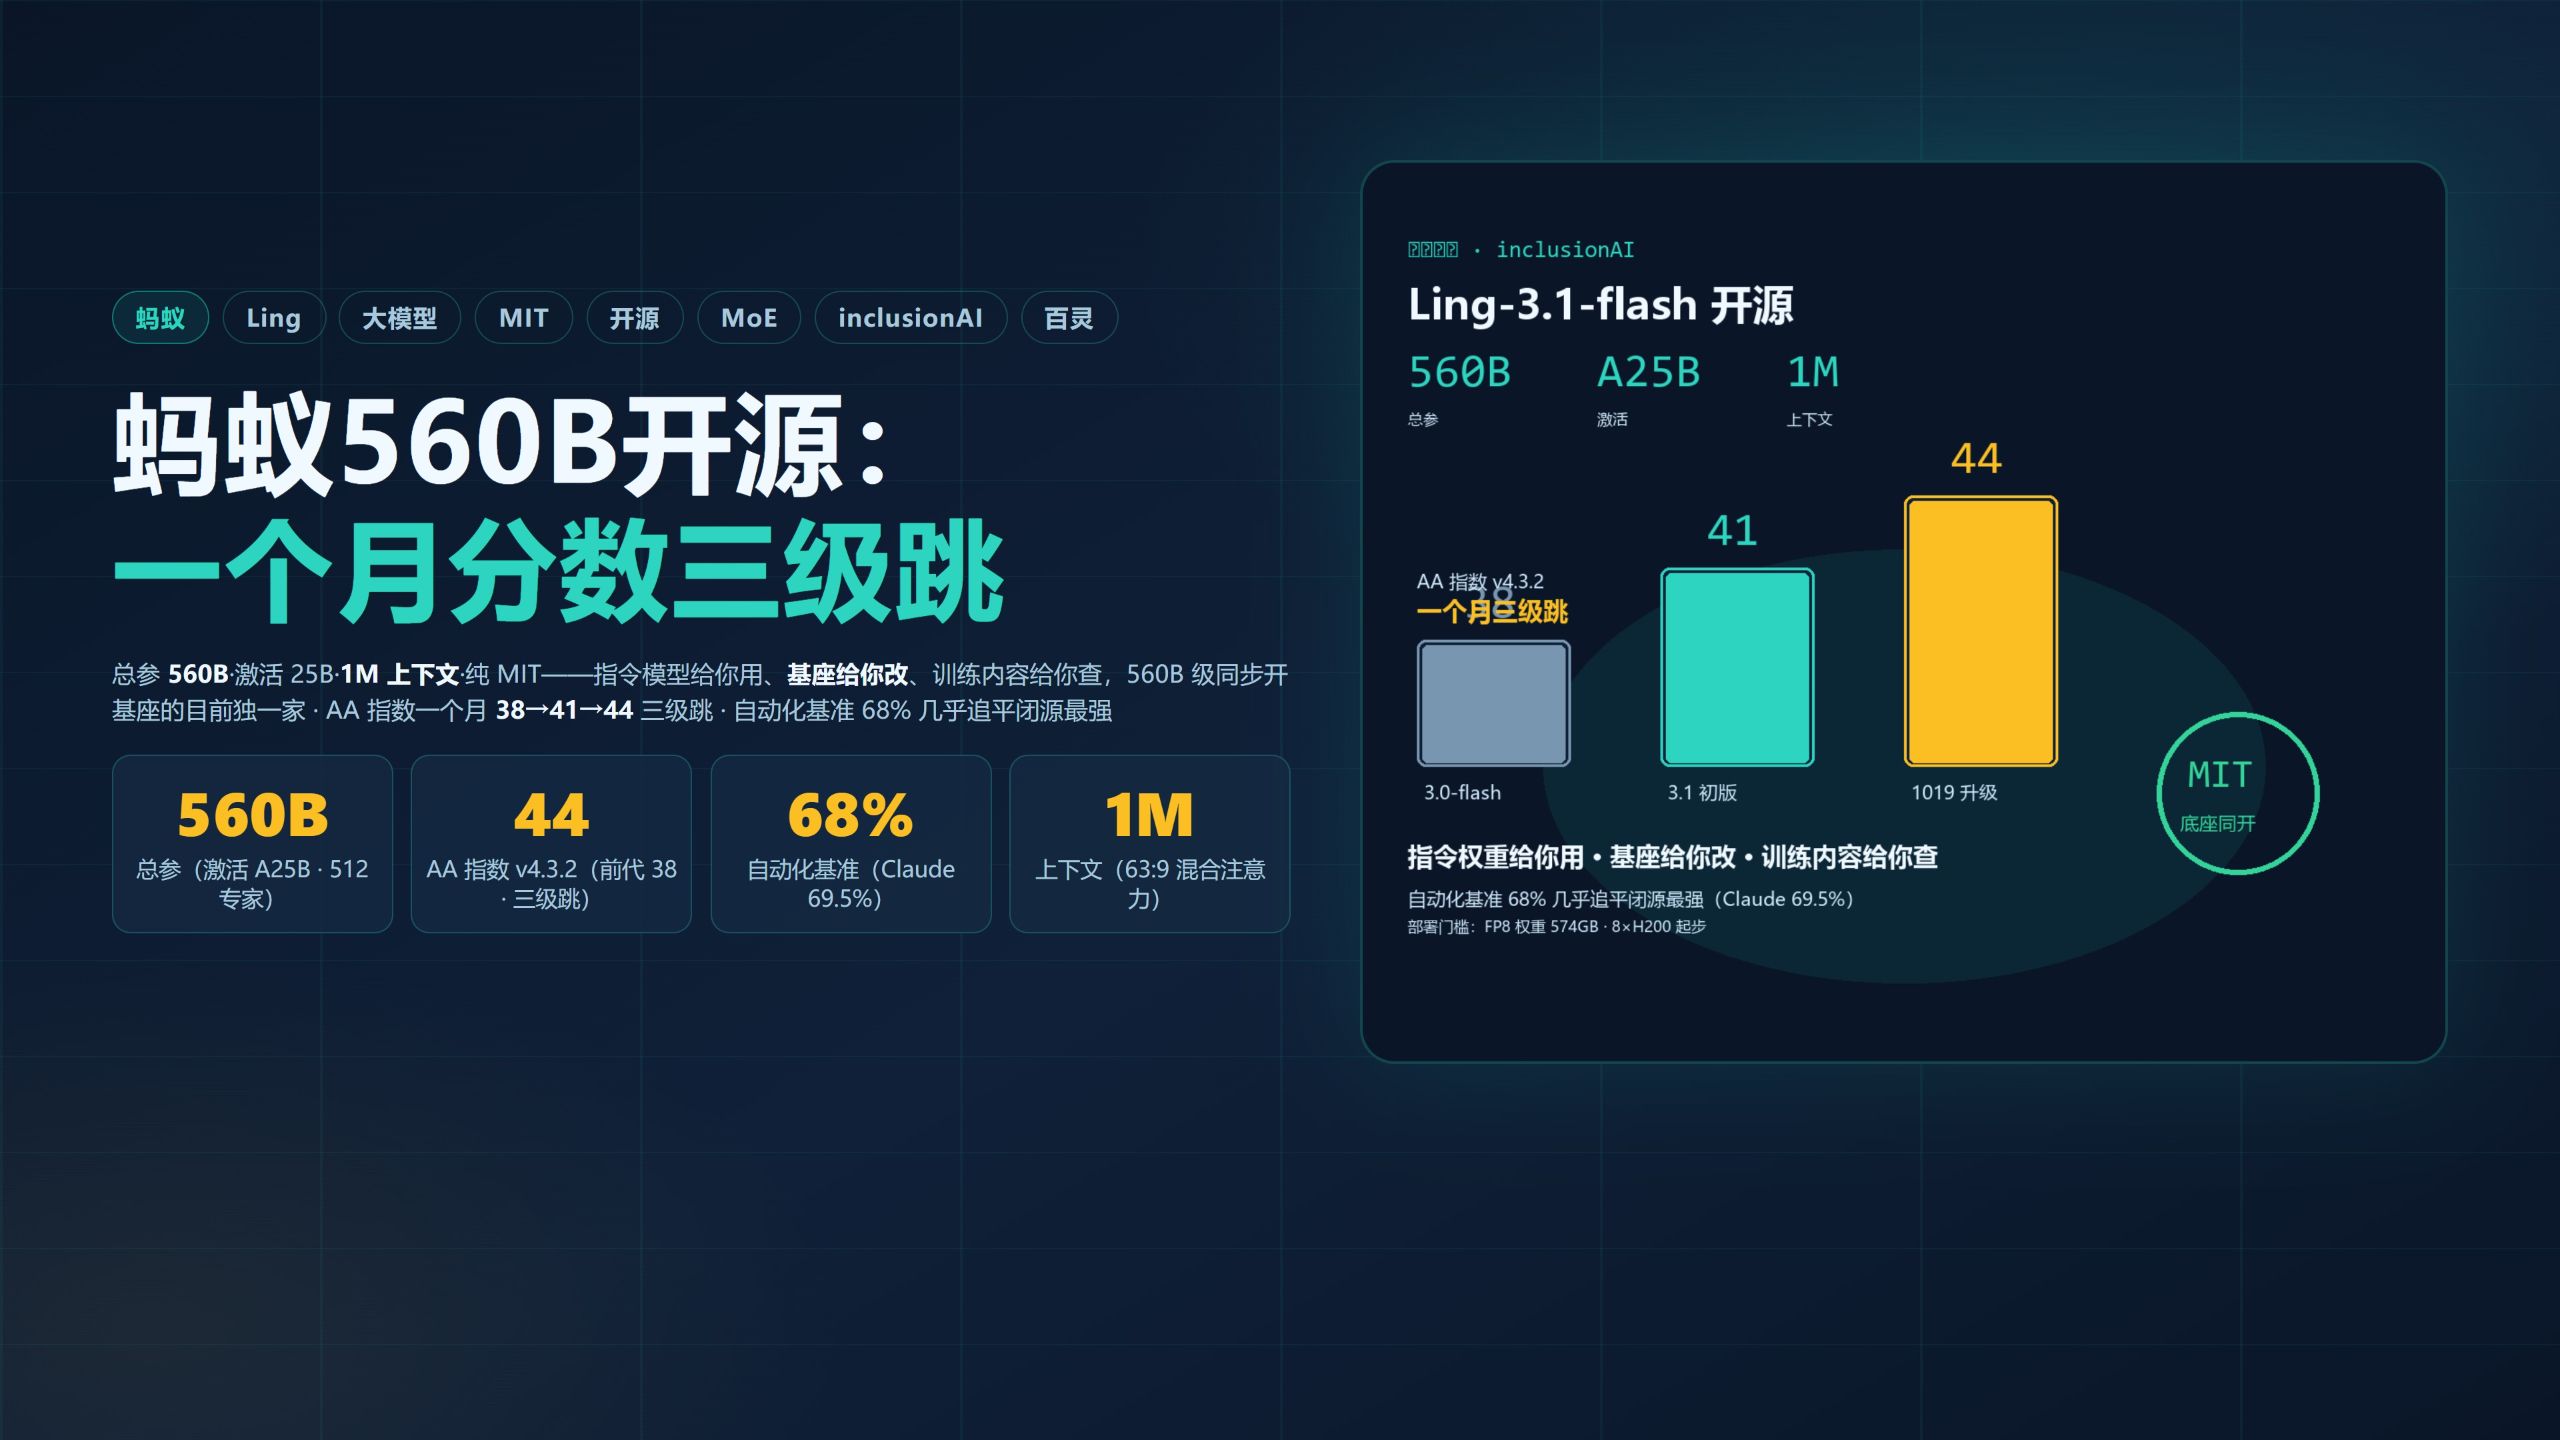
- 蚂蚁百灵团队开源 560B 参数混合专家模型 Ling-3.1-Flash,支持 1M token 上下文并采用无限制的 MIT 许可证,一个月内评测分完成 38、41 到 44 的三级跳。 (0:00)
- 模型架构创新采用 7:1 的非对称注意力机制,72 层网络中 63 层使用低成本线性注意力,仅 9 层使用完整多头潜变量注意力,以此大幅降低 1M 窗口的 KV 缓存成本。 (1:07)
- 在模拟办公软件真实工作流的自动化基准中,Ling-3.1 测得 68%,逼近闭源榜首 Claude 3.5 Sonnet 的 69.5%。 (1:07)
- 蚂蚁同步开放 FP8 指令权重、BF16 全量基座权重及 6 份数据透明度报告,成为当前 500B+ 梯队中唯一集齐纯 MIT 协议、1M 窗口与基座同开的厂商。 (2:51)
Detailed notes
## Background 该内容由 Bilibili UP 主“AI技术投降派”于 2026 年 10 月 30 日发布。视频聚焦蚂蚁百灵团队开源的 5600 亿参数文本旗舰模型 Ling-3.1-Flash,围绕其一个月内完成分数三级跳、开放指令与基座双权重及 MIT 许可证等核心动作展开解读。
## TL;DR 视频深入剖析了蚂蚁开源的 560B MoE 文本模型 Ling-3.1-Flash。该模型采用 7:1 的线性注意力与全注意力混合架构,以极低 KV 缓存成本撬动 100 万 token 上下文,在自动化工作流评测中跑出 68% 的高分逼近闭源王者 Claude。蚂蚁不仅提供 FP8 指令权重与数据透明度报告,更少见地同步开源了 BF16 全量基座模型,与 DeepSeek、智谱 GLM 共同构筑起纯 MIT 协议大 MoE 的开源三足鼎立格局。同时,主讲人也冷静算清了高昂部署门槛、评测量表切换及技术报告缺失等现实短板,指出参数只是手段,该模型实质上找回了关键的智能余量。
## Atmosphere & style 全片呈现出极度硬核、犀利且抽丝剥茧的技术研判风格。主讲人语速紧凑、条理明晰,既对蚂蚁“三个抽屉全开”的开源诚意与亮眼实测战绩给予充分认可,又在情绪高点迅速泼下一盆冷水,带着工程师特有的审慎算清门槛与短板账本。整场拆解毫无公关吹捧的浮躁,充盈着在开源与闭源博弈暗涌中客观推演的理智感与技术通透感。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1QAx56oEdu?t=0s) 蚂蚁百灵团队开源 560B 参数混合专家模型 Ling-3.1-Flash,支持 1M token 上下文并采用无限制的 MIT 许可证,一个月内评测分完成 38、41 到 44 的三级跳。 - [01:07](https://www.bilibili.com/video/BV1QAx56oEdu?t=67s) 模型架构创新采用 7:1 的非对称注意力机制,72 层网络中 63 层使用低成本线性注意力,仅 9 层使用完整多头潜变量注意力,以此大幅降低 1M 窗口的 KV 缓存成本。 - [01:07](https://www.bilibili.com/video/BV1QAx56oEdu?t=67s) 在模拟办公软件真实工作流的自动化基准中,Ling-3.1 测得 68%,逼近闭源榜首 Claude 3.5 Sonnet 的 69.5%。 - [02:51](https://www.bilibili.com/video/BV1QAx56oEdu?t=171s) 蚂蚁同步开放 FP8 指令权重、BF16 全量基座权重及 6 份数据透明度报告,成为当前 500B+ 梯队中唯一集齐纯 MIT 协议、1M 窗口与基座同开的厂商。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1QAx56oEdu?t=0s) Ling-3.1-Flash 具备 5600 亿总参数,每个 token 激活 250 亿参数,提供权重开源与第一方 API 双通道支持。 - [00:00](https://www.bilibili.com/video/BV1QAx56oEdu?t=0s) 评测跑分实现了快速迭代:前代 Ling-3.0 为 38 分,Ling-3.1 初版为 41 分,10 月 19 日升级快照版进一步拉升至 44 分。 - [01:07](https://www.bilibili.com/video/BV1QAx56oEdu?t=67s) 底层 MoE 架构包含 512 个路由专家与 1 个共享专家,每 token 动态激活 8 个路由专家。 - [01:07](https://www.bilibili.com/video/BV1QAx56oEdu?t=67s) 采用 7:1 的线性注意力与全注意力混合比例,兼顾了长文本吞吐的高吞吐低成本与关键特征的高维表达能力。 - [01:07](https://www.bilibili.com/video/BV1QAx56oEdu?t=67s) 高难测试成绩经官方模型卡实测披露,SWE-bench 多语言跑分达 88.5,高难度推理 HLE 测试拿到 37 分。 - [02:51](https://www.bilibili.com/video/BV1QAx56oEdu?t=171s) 开源资源全盘开放:FP8 指令模型体积为 574GB,社区量化版本门槛最低可压至 130GB 显存运行。 - [02:51](https://www.bilibili.com/video/BV1QAx56oEdu?t=171s) 同步释出 BF16 全量基座权重,打破了业内大参数量模型普遍只放指令权重、保留基座权重的潜规则。 - [03:59](https://www.bilibili.com/video/BV1QAx56oEdu?t=239s) 在纯 MIT 开源的大 MoE 阵营中,Ling-3.1 与 DeepSeek、智谱 GLM 形成三足鼎立,区别于带有附加限制的 Kimi 和采用 Apache 2.0 的 Qwen。 - [05:00](https://www.bilibili.com/video/BV1QAx56oEdu?t=300s) 私有化部署硬件门槛极高,官方推荐 8 张 H200 或 4 张 GB200/GB300 起步,中小团队本地托管难度大。 - [05:00](https://www.bilibili.com/video/BV1QAx56oEdu?t=300s) 基准测试口径需冷静看待:44 分基于评测机构切新量表前的旧体系成绩,且 68% 的自动化高分主要来自升级快照版。 - [05:00](https://www.bilibili.com/video/BV1QAx56oEdu?t=300s) 学术透明度与生态适配仍有补足空间,包括训练 token 总量未披露、缺少标准学术技术报告,以及部分框架工具调用的适配问题。 - [06:35](https://www.bilibili.com/video/BV1QAx56oEdu?t=395s) 蚂蚁大模型技术演进历经万亿参数立项、7.9B 端侧落地到 560B 找回智能余量,体现出参数是手段而非执念的工程务实路径。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1QAx56oEdu?t=0s) 一个月三级跳:蚂蚁文本旗舰 Ling-3.1 登场
10 月 15 日,蚂蚁百灵团队将旗下文本旗舰模型 Ling-3.1-Flash 的权重正式上传至 Hugging Face(账号 inclusionAI)。这是一颗参数规模达 5600 亿的大模型,每个 token 激活 250 亿参数,原生支持高达 100 万 token 的上下文窗口,并采用极其宽松的 MIT 开源许可证,向社区同步提供模型权重与第一方 API 调用的双通道。更令人瞩目的是其密集的迭代节奏:在发布后的半个月内,官方连补两记重拳——10 月 19 日放出了训练快照升级版,评测分数直接从 41 分拉升到 44 分;10 月 25 日,又将可供下游继续训练的基座模型(Base Model)完全公开。
在解读这一成绩时,主讲人特意厘清了一个极易被外界混淆的口径问题:44 分对 41 分并不是跨代模型的对比,而是 Ling-3.1 自身升级前后的演进;而上一代 Ling-3.0-Flash 的成绩仅为 38 分。主讲人指出:“一个月内,这个系列完成了 38、41、44 的三级跳。” 本期内容将核心聚焦在三件事:Ling-3.1 本身的技术战斗力究竟有多强、蚂蚁开源的诚意给到了什么程度,以及它在当下的开源大模型版图中占据了怎样的生态位。
- **核心规格**:总参数量 560B(5600 亿),每 token 激活 25B(250 亿),上下文支持 1M(100 万)tokens。 - **发布节奏**:10 月 15 日上线 Ling-3.1-Flash;10 月 19 日升级快照版(分数跃升至 44 分);10 月 25 日补齐 BF16 基座模型。 - **开源协议与分发**:代码与权重采用无附加条款的纯 MIT 许可证,托管于 Hugging Face。
---
[01:07](https://www.bilibili.com/video/BV1QAx56oEdu?t=67s) 7:1 混合注意力架构与追平闭源的硬核战绩
Ling-3.1 能够撑起 100 万超长窗口的关键,在于其非对称的注意力机制创新。模型底层采用混合专家(MoE)架构,总计包含 512 个路由专家和 1 个共享专家,每个 token 动态激活 8 个专家。其最具辨识度之处在于注意力层的设计:在整整 72 层网络中,有 63 层采用了极度廉价的线性注意力(Linear Attention),仅保留 9 层使用完整的多头潜变量注意力(Full Attention/MLA),二者比例高达 7:1。线性层负责以极低成本吞吐超长上下文,而计算昂贵的全注意力机制则精准留给最关键的信息交互节点。主讲人强调:“这就是它敢开 100 万窗口的底气,KV 缓存成本,结构性低于全注意力方案。”
```mermaid flowchart TD accTitle: Ling-3.1 架构设计 accDescr: 展示 Ling-3.1 的 7 比 1 混合注意力层与混合专家 MoE 路由设计
subgraph Attention_Layers ["72 层注意力系统 (7:1 混合比例)"] A["63 层 线性注意力<br/>(负责低成本吞吐 1M 上下文)"] B["9 层 完整多头潜变量注意力<br/>(负责关键位置高维特征捕捉)"] end
subgraph MoE_System ["专家路由系统"] C["输入 Token"] --> D{"路由门控网络"} D -->|"每 Token 激活 8 个"| E["512 个路由专家 (Routed Experts)"] D -->|"全量常驻"| F["1 个共享专家 (Shared Expert)"] end
Attention_Layers --> MoE_System ```
在实测性能方面,Ling-3.1 展现出了逼近甚至叫板闭源王者的硬实力: - **综合智能指数**:测得 44 分,与当前开源榜首的 GLM 差距不到 1 分。 - **自动化工作流基准**:模拟真实办公软件与复杂操作环境的评测中,从初始版的 62% 暴涨至升级版的 68%。作为对比,闭源霸主 Claude 3.5 Sonnet 在该榜单上为 69.5%,Ling-3.1 几乎已经实现了平视。 - **高难任务评测**:软件工程终端基准 SWE-bench 多语言测试跑出 88.5 分;中文社区公认难度天花板的 HLE(Humanity's Last Exam)推理测试拿到 37 分。主讲人特别说明,这些分数全部来自官方模型卡实测披露,并没有虚标吹嘘。
---
[02:51](https://www.bilibili.com/video/BV1QAx56oEdu?t=171s) “三个抽屉”全开:指令、基座与透明度报告
蚂蚁此次的开源姿态被生动地形容为“打开了三个抽屉”,把能用的、能改的和能查的资源一次性全盘托出:
1. **第一个抽屉(即刻能用的指令模型)**:提供 FP8 精度的 Instruct 权重,体积约为 574GB,官方推荐部署配置为 8 张 H200 或 4 张 GB200/GB300 显卡起步。与此同时,社区量化生态迅速响应,量化专家 Bartowski 仅用一天时间就推出了多达 24 档的 GGUF 量化版本,极限情况下最低只需 130GB 显存即可运行。 2. **第二个抽屉(自由修改的基座模型)**:10 月 25 日如约上线 BF16 全量基座权重,供机构和开发者进行二次预训练(Continual Pre-training)与下游微调。主讲人指出开源圈的一大潜规则:“指令权重只能用,基座权重才能改。” 虽然 Qwen 和 DeepSeek 向来有放基座的传统,但在 5600 亿这一超大规模梯队中,目前能做到同步开放基座权重的只有蚂蚁一家。 3. **第三个抽屉(详尽透明的数据溯源)**:公开仓库中附带了 6 份横跨各代训练数据的透明度报告,开发者可以清晰查阅模型到底吃了哪些语料。主讲人结合蚂蚁此前的开源表现称赞道:“之前我们讲过他们把语音五件套全部 MIT 送出,这家的风格是给就给干净。”没有任何商业附加条款,完完全全交还给社区。
---
[03:59](https://www.bilibili.com/video/BV1QAx56oEdu?t=239s) 开源格局:纯 MIT 大 MoE 的三足鼎立
将 Ling-3.1 置于 5000 亿至 6000 亿总参数的 MoE 竞技场中审视,当前能够下场肉搏的头部玩家主要有四到五家,但许可证阵营界限分明: - **纯 MIT 自由阵营**:仅有 DeepSeek、智谱 GLM 和蚂蚁 Ling-3.1 三家,允许商业机构无门槛集成、魔改与闭源分发。 - **条件限制阵营**:Kimi(Moonshot)采用了附带商业限制条款的修改版协议;Qwen 则长期坚持 Apache 2.0 许可证。
主讲人客观分析,如今“100 万 token 上下文俱乐部”已经算不上绝对稀缺的门槛,各大厂商的旗舰产品基本都能涉足。Ling-3.1 真正的不可替代性在于它罕见的四重交集:**“纯 MIT 许可证 + 500B 超大参数量 + 100 万长窗口 + 指令与基座双开”**。在当下的全球开源生态中,能把这四个严苛条件全部集齐的,唯有蚂蚁百灵这一家。
| 模型梯队 / 代表 | 总参数规模 | 上下文窗口 | 许可证类型 | 500B+ 同步开源基座 | |:--- |:--- |:--- |:--- |:--- | | **蚂蚁 Ling-3.1** | 560B (激活 25B) | 100 万 (1M) | **纯 MIT 协议** | **是 (BF16 全量)** | | **DeepSeek 系列** | 600B+ 级别 | 128K 起 | 纯 MIT 协议 | 是 | | **智谱 GLM 系列** | 500B+ 级别 | 128K - 1M | 纯 MIT 协议 | 视具体版本开放 | | **Kimi (Moonshot)**| 超大 MoE | 200K - 1M | 附加限制条款协议 | 否 / 有限开放 | | **阿里 Qwen 系列** | 多种尺寸 | 32K - 1M | Apache 2.0 协议 | 是 |
---
[05:00](https://www.bilibili.com/video/BV1QAx56oEdu?t=300s) 清醒四笔账与智能余量的逻辑回归
在充分肯定其技术亮点的同时,主讲人也冷静地给热度泼了冷水,算出了社区使用者必须面对的“四笔账”: 1. **部署成本门槛高企**:FP8 权重足有 574GB,官方推荐 8 张英伟达 H200 算力卡起步,这意味着普通中小团队难以独立托管私有化实例;即便是社区极端量化压缩到 130GB 左右,依然需要多张 40GB/80GB 级大显存专业卡组合才能跑动。 2. **基准跑分需拆分口径**:榜单评测机构 Artificial Analysis(AA)在 10 月 27 日刚刚切换到了全新的评测体系量表,因此 Ling 拿下的 44 分是旧版本量表下的最后一批成绩,新旧量表之间不能直接换算;此外,68% 的惊艳自动化表现主要归功于 10 月 19 日的升级快照版,初版仅为 62%,不同版本之间存在明显性能阶梯。 3. **技术透明度仍有欠缺**:尽管有内容层面的透明度报告,但模型训练的具体 token 规模并未公布,相较于 Qwen 或 DeepSeek 动辄数十页详尽的标准学术技术报告(Tech Report),蚂蚁目前仅依靠几篇推文和说明文档,严密性上尚有距离。 4. **工具调用与框架生态的磨合**:部分主流推理框架中,Ling 的结构化输出标记仍显示为 False,注意力与外接 Tool Calling 的无缝适配仍在持续修整中;且官方对“-1019”这种内部训练快照命名的缘由缺乏清晰的技术说明。
梳理蚂蚁近两年的大模型战略脉络,可以看到一条从万亿参数证明“能做”,到 7.9B 端侧小模型证明“能用”,再到如今用 560B MoE 找回“智能余量”的完整闭环。主讲人总结道,参数只是达成智能的工程手段而非终极执念;随着纯 MIT 大 MoE 阵营凑齐三家,“闭源独大的叙事又被撬了一角。”想要上手该模型的开发者,可直接在 Hugging Face 搜索 `inclusionAI` 下载权重。
## Notable quotes > [02:51](https://www.bilibili.com/video/BV1QAx56oEdu?t=171s) 指令权重只能用,基座权重才能改。 — AI技术投降派
> [05:00](https://www.bilibili.com/video/BV1QAx56oEdu?t=300s) 闭源独大的叙事又被撬了一角。 — AI技术投降派
## Mentioned Ling-3.1-Flash, Ling-3.0-Flash, 蚂蚁百灵, 蚂蚁集团, Hugging Face, inclusionAI, DeepSeek, GLM, 智谱, Kimi, Moonshot, Qwen, 阿里, Claude 3.5 Sonnet, SWE-bench, HLE, Bartowski, Artificial Analysis, NVIDIA H200, GB200, GB300
## Video description 蚂蚁又掏东西了,这次是文本旗舰。十月十五号,蚂蚁百灵团队把 Ling-3.1-flash 的权重挂上 Hugging Face:总参数五千六百亿,每个 token 激活两百五十亿,一百万 token 上下文,MIT 许可证,权重加第一方 API 双通道。半个月连补两件:十月十九日训练快照的升级版,分数从四十一涨到四十四;十月二十五号,可继续训练的基座模型也放出来了。先说清楚一个容易搞混的点:四十四比四十一是 Ling-3.1 自己升级前后的对比,前代 Ling-3.0-flash 只有三十八分——一个月内完成三十八、四十一、四十四的三级跳。
00:05 开场:一个月三级跳与口径澄清 01:07 模型本体:七比一混合注意力,追平闭源的单项 02:51 三个抽屉:能用的、能改的、能查的全给 03:59 开源格局:纯 MIT 大 MoE 三大家 05:31 清醒四笔账 06:35 判断:参数是手段不是执念
架构是混合专家:五百一十二个路由专家加一个共享,每 token 激活八个。最有特点的是注意力:七十二层里六十三层用线性注意力,只有九层用完整注意力,比例七比一——线性层便宜管长上下文,这就是敢开一百万窗口的底气。实测硬数字:自动化基准从百分之六十二升到六十八——这个基准测的是模拟办公软件里的真实工作流,六十八是什么概念?闭源榜第一的 Claude 是六十九点五,几乎追平。SWE-bench 多语言八十八点五,高难推理 HLE 三十七分是模型卡自己列的,没吹。
给到什么程度?三个抽屉。指令模型:FP8 精度五百七十四 GB,官方推荐八张 H200;社区量化最低一百三十 GB 也能跑。基座模型:BF16 全量权重,供继续预训练和后训练研究——指令权重只能用,基座才能改;这一代五千六百亿级还同步给基座的,目前只有蚂蚁一家。训练内容披露:六份各代透明度报告放公开仓库。加 MIT 无附加条款,之前我们讲过这家把语音五件套全部 MIT 送出——给就给干净。
开源格局:纯 MIT 大 MoE 阵营是 DeepSeek、GLM 和蚂蚁三家,Kimi 是附条款的修改版,Qwen 走 Apache。一百万上下文不稀缺,Ling 的差异在组合:MIT 加五百 B 级加基座同开加一百万,四条件同时满足只有它。注意量表:AA 机构十月二十七号刚切新量表,四十四是旧量表最后一批成绩,新旧不能直接比。清醒四笔账:部署门槛是真的(574GB、8×H200);高分项拆开看(68% 主要是升级版拿的,各家口径不一);透明度有差距(token 数未披露、无传统技术报告);-1019 命名无官方解释。判断:Ling 两年走了万亿证明能做、7.9B 证明能用、560B 找回智能余量的回环——参数是手段不是执念。纯 MIT 阵营凑齐三家,闭源独大的叙事又被撬了一角。权重在 Hugging Face 搜 inclusionAI。
[Source](https://www.bilibili.com/video/BV1QAx56oEdu)