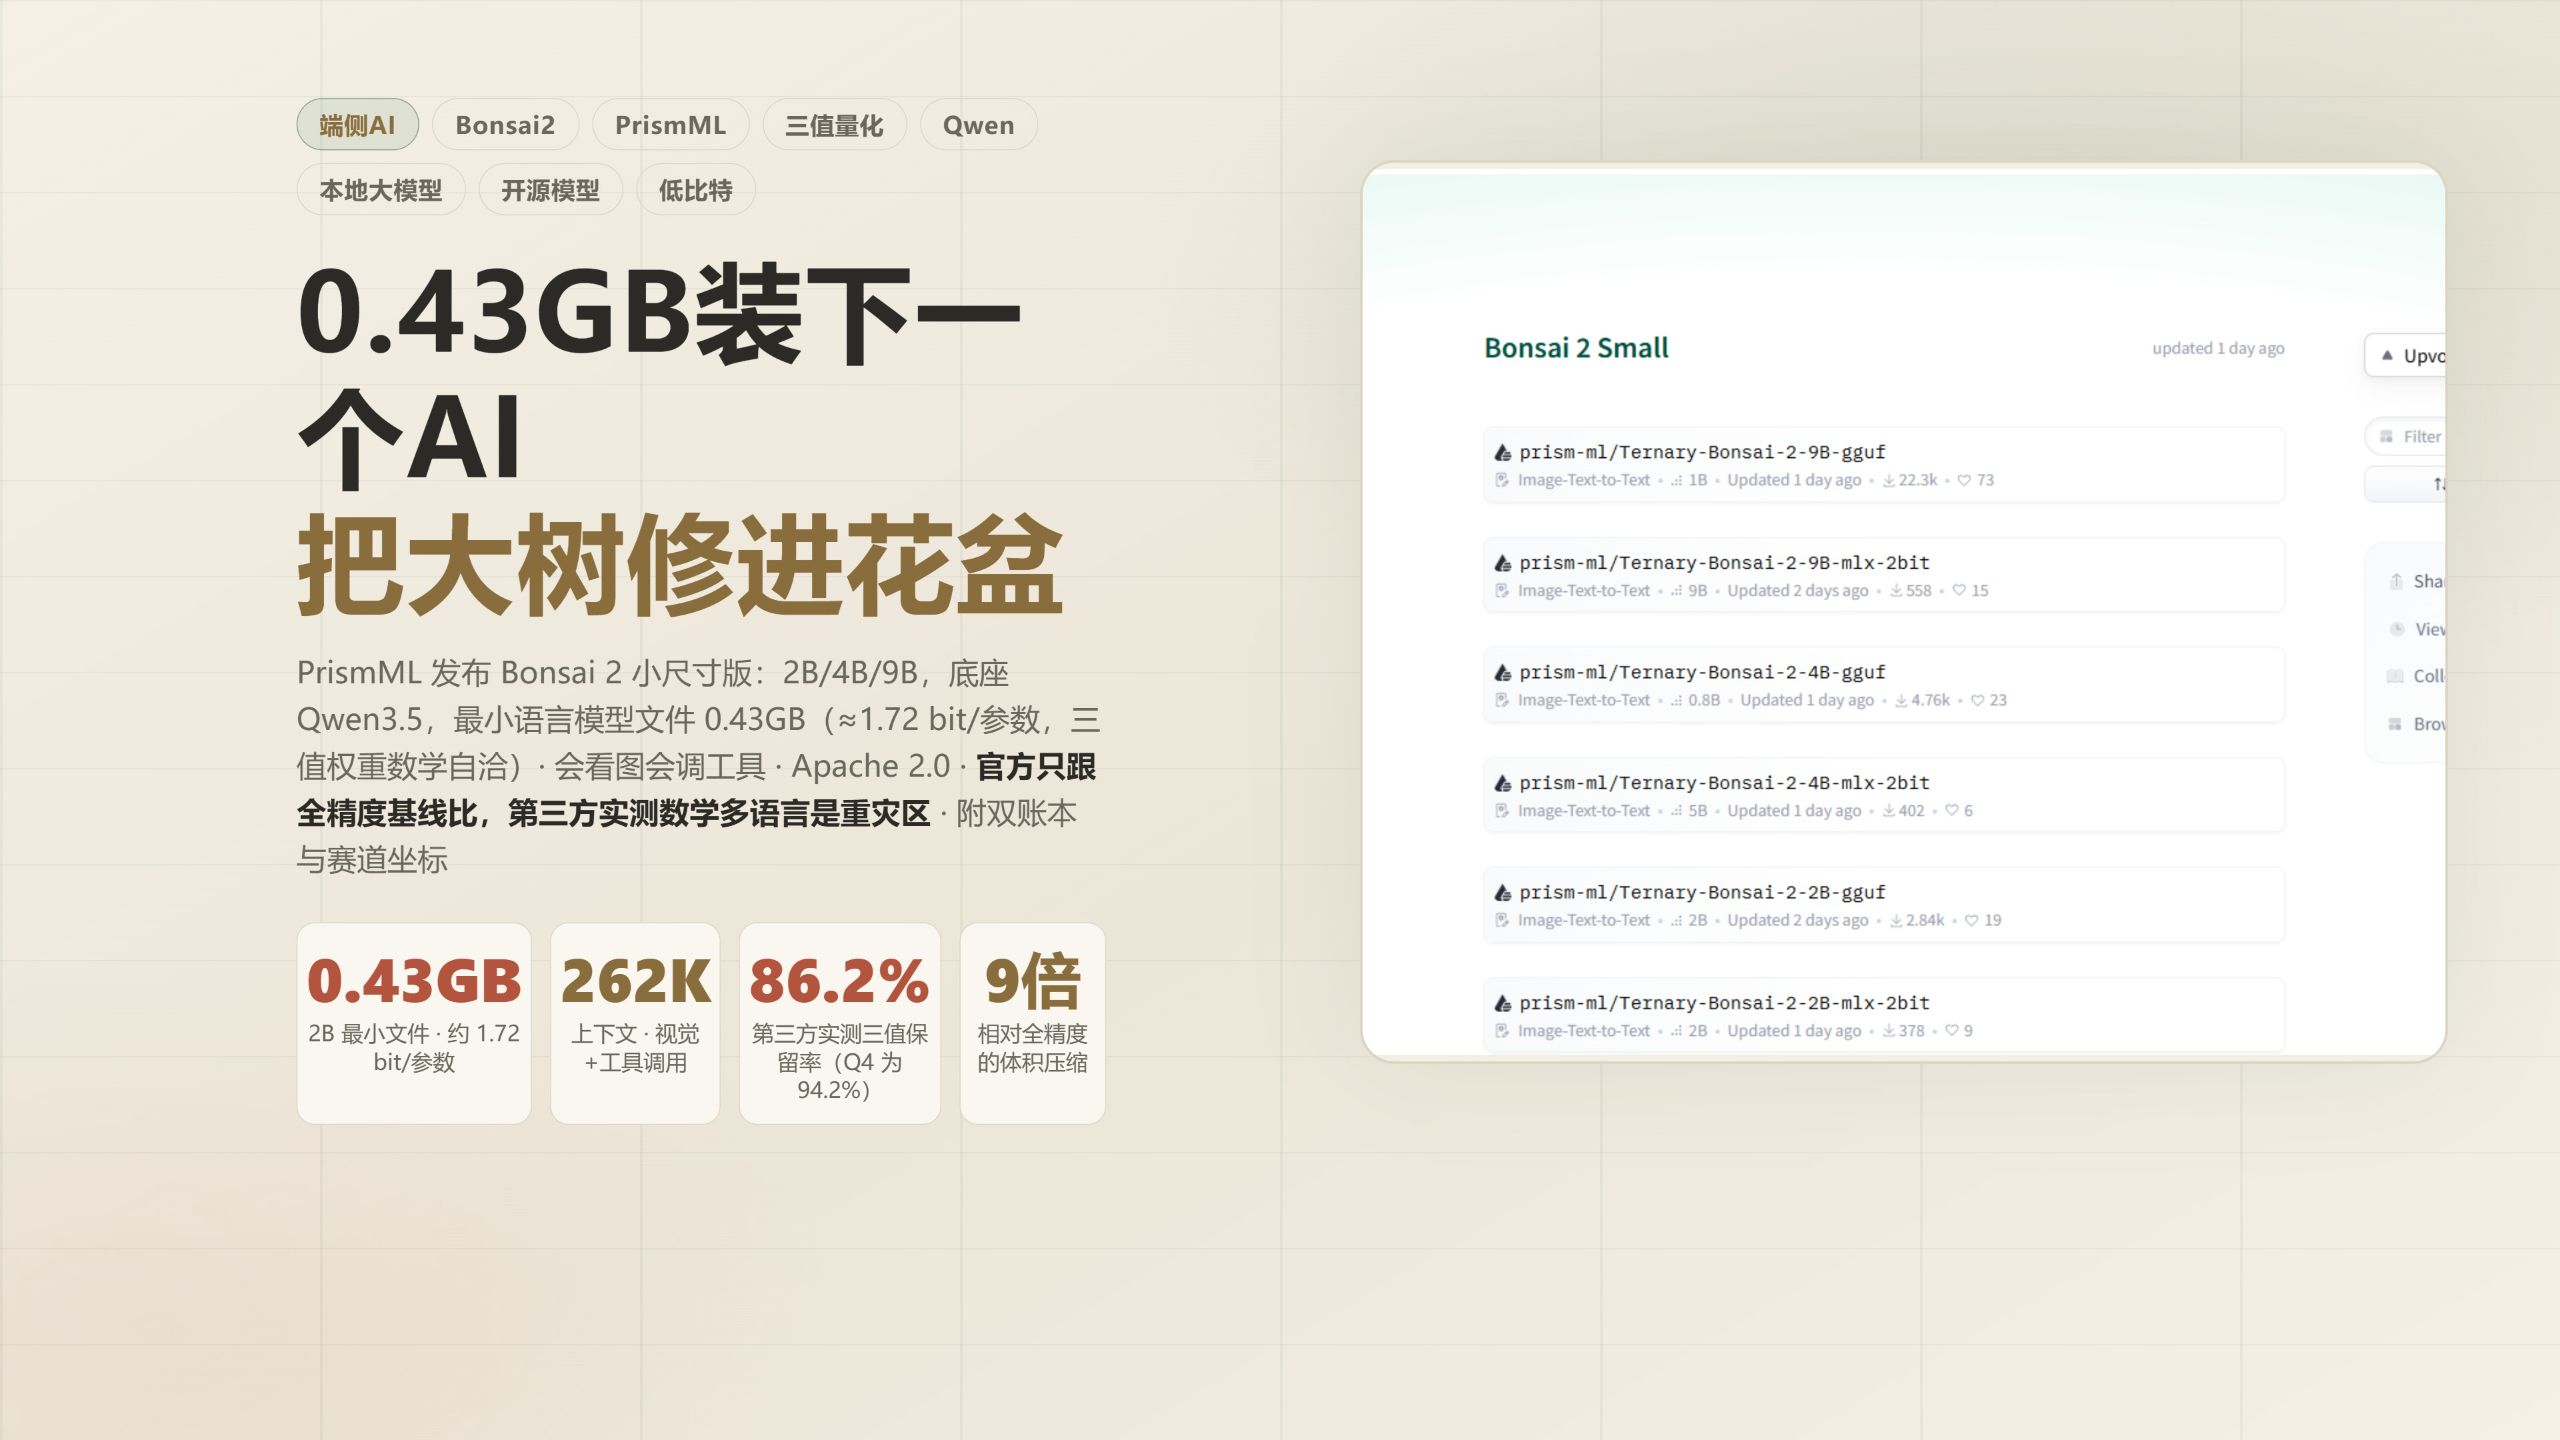
PrismML推三值模型Bonsai 2 极限压缩至0.43GB抢占超低比特端侧
AI技术投降派
第三方实测揭示额外比特比额外参数更重要,三值模型虽大幅释放显存但数学与多语言能力出现明显衰减。
AI-assisted summary of 0.43GB装下一个AI?把大树修进花盆的Bonsai 2 — original source. Check the original for full context.
Source published:
Key ideas
- 加州理工背景的 PrismML 发布 Bonsai 2 小尺寸系列模型(2B/4B/9B),基于 Qwen3.5 架构并采用 Apache 2.0 开源,最小的 2B 语言核心文件仅 0.43GB,原生支持 262K 上下文、视觉及工具调用。 (0:00)
- Bonsai 2 通过训练期三值权重(-1/0/+1)实现参数压缩,理论极限 1.585 比特加上共享缩放系数开销,最终严丝合缝折合为每个参数 1.72 比特。 (0:40)
- 实测展现明显性能代价与压缩边界:第三方评测显示 27B 底座三值权重性能保留率为 86.2%,数学推导与多语言成为重灾区,且 1 比特的 27B 表现不及 8B 三值模型,证明额外比特比额外参数更重要。 (2:20)
- 在 4 比特内卷严重的端侧赛道,Bonsai 2 独占 1-2 比特且带多模态的生态位,在 8GB 显存的 RTX 3070 上可实测以 40 token/s 运行 27B 模型。 (4:01)
Detailed notes
## Background 该视频由 Bilibili UP 主“AI技术投降派”于 2026 年 10 月 31 日发布。视频简介指出,内容围绕加州理工背景的 PrismML 发布的 Bonsai 2 小尺寸系列模型展开,重点拆解其最小仅 0.43GB 的 2B 语言模型背后的三值权重数学原理、官方与第三方的评测成绩单,以及极限压缩所付出的能力代价。
## TL;DR 视频深度评测了基于 Qwen3.5 架构的极低比特开源模型 Bonsai 2,解释了其如何通过 -1/0/+1 的三值权重设计实现每个参数仅 1.72 比特的极小体积(语言核心 0.43GB,Ollama 完整包约 911MB)。博主对比了两份截然不同的评测账本:官方宣称保留率高达 95% 至 99%,但第三方实测显示其性能保留率已降至 86.2%,且在数学与多语言任务上缩水严重,印证了“额外比特比额外参数重要”的规律。尽管复杂的逻辑推理仍有局限,但 Bonsai 2 在 1-2 比特且带视觉与工具调用的生态位上独树一帜,能让 RTX 3070 级别的 8GB 显卡流畅跑起 27B 模型,极为契合日常端侧轻量任务。
## Atmosphere & style 全片充斥着硬核、克制且极具穿透力的极客思辨风格,既无盲目吹捧也无恶意贬损。博主用“把大树修进花盆”这样生动传神的比喻切入复杂的数学论证,行文节奏明快干练,算起性能与体积的“两本账”时言辞犀利、直戳痛点。观感上既有窥见前沿低比特压缩黑科技的兴奋感,又带着清醒审视技术能力边界与工程妥协的冷静与通透。
## Bulletin - [00:00](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=0s) 加州理工背景的 PrismML 发布 Bonsai 2 小尺寸系列模型(2B/4B/9B),基于 Qwen3.5 架构并采用 Apache 2.0 开源,最小的 2B 语言核心文件仅 0.43GB,原生支持 262K 上下文、视觉及工具调用。 - [00:40](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=40s) Bonsai 2 通过训练期三值权重(-1/0/+1)实现参数压缩,理论极限 1.585 比特加上共享缩放系数开销,最终严丝合缝折合为每个参数 1.72 比特。 - [02:20](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=140s) 实测展现明显性能代价与压缩边界:第三方评测显示 27B 底座三值权重性能保留率为 86.2%,数学推导与多语言成为重灾区,且 1 比特的 27B 表现不及 8B 三值模型,证明额外比特比额外参数更重要。 - [04:01](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=241s) 在 4 比特内卷严重的端侧赛道,Bonsai 2 独占 1-2 比特且带多模态的生态位,在 8GB 显存的 RTX 3070 上可实测以 40 token/s 运行 27B 模型。
## Key takeaways - [00:05](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=5s) PrismML 推出 Bonsai 2 小尺寸全家福(2B、4B、9B),主打将大模型修剪进极限体积的花盆中。 - [01:42](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=102s) 2B 语言模型权重文件低至 0.43GB,但实际部署存在口径差异:加上 0.36GB 起步的视觉编码器,Ollama 完整运行包约为 911MB。 - [00:40](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=40s) 模型突破传统 PTQ 难以跨越 2.2 比特的瓶颈,基于训练期三值量化({-1, 0, +1})将每个参数严密压缩至 1.72 比特。 - [01:42](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=102s) 全系列基于 Qwen3.5 底座,原生具备 262K 超长上下文窗口、视觉图像理解与函数/工具调用(Tool Calling)能力。 - [02:20](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=140s) 官方基准拿三值模型对比 16 位全精度基线(声称 9B 保留 95%-99%、2B 数学达 122%),避开了端侧业界通用的 4 比特量化基准,引发社区质疑。 - [02:20](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=140s) 第三方统一题库实测揭示性能衰减阶梯:4 比特保留率 94.2%、三值权重 86.2%、1 比特 82.9%,性能损失主要集中在数学与多语言任务。 - [04:45](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=285s) 测试打破“参数量迷信”,得出核心结论:1 比特 27B 表现不及 8B 三值模型,在极低比特领域“额外比特比额外参数重要”。 - [03:17](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=197s) PrismML 团队具备纯正加州理工学院学术背景,由 Khosla Ventures 领投 2225 万美元种子轮,7 个月内完成四次高频迭代。 - [04:01](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=241s) 避开 SmolLM、Granite、Gemma 等选手高度内卷的 4 比特红海,Bonsai 2 成为当前 1-2 比特且带多模态赛道中唯一的开源商业选手。 - [04:01](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=241s) 显存占用极低且推理速度出众,在 8GB 显存的消费级 RTX 3070 显卡上,27B 模型推理吞吐可达 40 token/s。 - [04:01](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=241s) 生态成熟度尚有局限,模型依赖官方 fork 定制推理框架,且面对复杂长程逻辑推理时容易崩溃。 - [04:45](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=285s) 选型总结:Bonsai 2 适合用于低显存设备上的日常问答、看图和轻量工具调用,但若涉及严谨数学计算,仍需回归大参数或高比特模型。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=0s) 把大树修进花盆:0.43GB 与三值权重的数学自洽
加州理工背景的 AI 初创公司 PrismML 正式发布了 Bonsai 2 小尺寸系列模型,涵盖 2B、4B 与 9B 三个档位。其中最小的 2B 语言模型权重文件仅有 0.43GB,相当于半张高清手机照片的体积,却塞进了一个既能看图又能调用工具的多模态大模型。模型取名“Bonsai”(盆栽),寓意正是“把一棵大树修进花盆”。传统后训练量化技术(PTQ)如果硬将大模型压到 2.2 比特以下,输出质量基本会彻底崩溃;而 Bonsai 2 能做到 0.43GB,核心在于它从训练阶段就采用了三值权重(ternary weights)方案。
```mermaid flowchart TD accTitle: Bonsai 2 三值权重与文件体积构成 accDescr: 展示 Bonsai 2 参数三值化压缩机制以及 0.43GB 语言模型与多模态部署包的体积差异
subgraph Weight["权重参数层 (1.72 bit/参数)"] T["三值量化取值: {-1, 0, +1}"] -->|"理论极限"| B["1.585 比特"] S["共享缩放系数 (Scale Factors)"] -->|"元数据开销"| M["+0.135 比特"] B & M --> Total["严丝合缝的 1.72 比特 / 参数"] end
subgraph Packaging["部署文件口径"] Total --> LLM["2B 语言核心: 0.43 GB"] V["视觉模块: 0.36 GB 起"] LLM & V --> Ollama["Ollama 完整运行包: 约 911 MB"] end ```
这种机制将每个模型参数严格限制在 -1、0、+1 三个离散取值中,并配上一组共享缩放系数。根据信息论,三个离散值的理论存储下限为 $\log_2(3) \approx 1.585$ 比特,再加上缩放系数所需的元数据开销,最终严丝合缝地折合为每个参数 1.72 比特。这项技术并非凭空捏造,微软曾在 2025 年通过 BitNet 论文在学术上验证了极端低比特路线,而 PrismML 则首次将其推向了商业落地规模。
需要注意的是,在模型体积上官方与实际部署存在口径差异。视频作者指出:“0.43GB是语言模型文件的尺寸,视觉部分是另一个文件。”在实际工程中,视觉编码器组件为 0.36GB 起步,若通过 Ollama 本地一键拉取运行,整个 2B 版本的镜像大约在 911MB 左右。尽管统计口径有别,但在当前 1GB 以内的极限轻量级区间中,支持 262K 超长上下文、同时兼顾视觉理解与工具调用能力的开源模型此前从未出现过。
- **模型基座与协议**:全系列基于 Qwen3.5 架构,采用宽松友好的 Apache 2.0 协议开源。 - **上下文与功能**:支持 262K tokens 上下文窗口,原生支持视觉输入(Vision)与函数/工具调用(Tool Calling)。 - **规格覆盖**:本次发布的小尺寸版本包含 2B、4B、9B 三档,补全了 9 月份率先发布的 27B 旗舰版。
---
[02:20](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=140s) 两本成绩单与性能代价:官方基准 vs 第三方阶梯
评估 Bonsai 2 的表现需要看两本不同的“账本”。第一本是官方公布的数据,在 6 大类共 19 个评测基准上,官方均拿三值量化版本去对比自家的全精度(16 位浮点)Qwen3.5 基线。在这份成绩单中,9B 档模型性能大多保留了 95% 到 99%,个别单项甚至实现反超,2B 版的数学测试跑分更是达到了基准的 122%。然而,这种对比方式引发了开源社区的广泛质疑,因为在端侧边缘部署的现实业务中,几乎没有人会用高显存消耗的 16 位全精度模型作为基线,行业通行标准通常是 4 比特量化(如 INT4/AWQ/GPTQ)。
第二本账来自独立第三方的标准化统一题库评测。第三方实测揭示了极度压缩下的性能衰减阶梯:在同一款 27B 尺寸的模型底座上,传统的 4 比特量化保留率为 94.2%,三值权重版本保留率为 86.2%,而极限压缩的 1 比特版本仅剩 82.9%。极端三值化修剪的性能损失高度集中在特定领域,数学推导和多语言任务成了最为严重的“重灾区”。
更重要的是,第三方测试给出了一个打破“参数量迷信”的扎心规律:针对这套压缩技术作者总结道,“还有一条扎心的结论,1比特的27B还不如8B的三值,额外比特比额外参数重要,这是这条路线的边界。”
| 量化等级 / 格式 | 27B 模型性能保留率 | 核心特征与表现瓶颈 | |:--- |:--- |:--- | | **4 比特量化 (INT4)** | **94.2%** | 行业标准基线,综合能力损耗极小 | | **三值权重 (1.72 bit)** | **86.2%** | 极限显存压缩,日常任务可用,数学与多语言出现断崖下跌 | | **1 比特极端压缩** | **82.9%** | 输出稳定性衰减严重,大参数优势被低比特精度损失抵消 |
---
[03:17](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=197s) 团队背景、生态坐标与硬件实测
PrismML 拥有纯正的加州理工学院(Caltech)学术血统。公司联合创始人兼 CEO Babak Hassibi 本身即为加州理工学院电气工程与应用数学系教授,学术顾问团队中还坐镇着加州大学伯克利分校教授、分布式计算权威 Ion Stoica。资本与研发节奏异常凶悍:公司在今年 9 月刚刚完成了由 Khosla Ventures 领投的 2225 万美元种子轮融资。从今年 3 月发布第一代技术实现千万级下载,到 7 月将 27B 模型塞入手机并在 Hacker News 登顶夺得 700 多分,再到 9 月推出 Bonsai 2 27B 旗舰版拿下 490 万下载量,直至 10 月正式补齐小尺寸全家福,7 个月内四次高频迭代。此外,甚至有媒体报道苹果公司正在接触团队洽谈合作,不过官方对此保持不予置评。
```mermaid flowchart LR accTitle: 端侧开源小模型赛道生态分布 accDescr: 对比4比特与1-2比特赛道选手,凸显Bonsai 2的生态位差异
subgraph INT4["4比特成熟红海赛道 (严重内卷)"] direction TB S["SmolLM"] G1["Granite"] G2["Gemma"] N["Nemotron"] end
subgraph Sub2Bit["1-2比特前沿极低显存生态位"] direction TB B["Bonsai 2"] F1["- 1.72 bit 三值权重"] F2["- 原生带视觉与工具调用"] F3["- 独占生态位,尚无竞品"] end
INT4 -.->|"量化挤压"| Sub2Bit ```
放眼端侧 AI 赛道,SmolLM、Granite、Gemma、Nemotron 等轻量化选手全都在 4 比特档位进行高烈度内卷。而在 1 至 2 比特、且原生支持视觉多模态的超轻量领域,目前市场中只有 Bonsai 一家,其真正不可替代的卖点在于极低的显存开销与飞快的推理吞吐。实测表明,在仅有 8GB 显存的消费级显卡 RTX 3070 上,27B 的三值模型跑出了每秒 40 个 token 的可用速度;而在低功耗边缘设备上,8B 模型也能稳定跑到 46 token/s。
当然,其生态成熟度与能力边界也相当骨感:复杂的长程逻辑任务极易崩溃,依赖官方 fork 的定制推理框架,且上游主线 llama.cpp 对三值格式的原生兼容仍在推进中。面对要不要在本地部署“养一盆”盆栽模型的选择,作者给出了极具画面感的总结:
> “文件是真的小,三值权重,数学自洽,不是障眼法。缩水是真的有,官方口径自选基线,第三方实测数学多语言是重灾。位置是真的空,4比特档位挤满选手,1比特档位只此一家。要不要在自己设备上养一盆?日常问答、看图、跑个工具,可以试试;要它算数学题,先把花盆还给树。”
## Notable quotes > [02:20](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=140s) 1比特的27B还不如8B的三值,额外比特比额外参数重要,这是这条路线的边界。 — AI技术投降派
> [03:17](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=197s) 日常问答、看图、跑个工具,可以试试;要它算数学题,先把花盆还给树。 — AI技术投降派
> [03:17](https://www.bilibili.com/video/BV1mFJv6ZEnS?t=197s) 文件是真的小,三值权重,数学自洽,不是障眼法。缩水是真的有,官方口径自选基线,第三方实测数学多语言是重灾。位置是真的空,4比特档位挤满选手,1比特档位只此一家。 — AI技术投降派
## Mentioned PrismML, Bonsai 2, Qwen3.5, Babak Hassibi, Ion Stoica, Khosla Ventures, 加州理工学院, 加州大学伯克利分校, 苹果公司, 微软, BitNet, SmolLM, Granite, Gemma, Nemotron, Ollama, RTX 3070, llama.cpp
## Video description 10月15日,加州理工背景的PrismML发布Bonsai 2小尺寸版:2B/4B/9B三档,底座Qwen3.5,最小语言模型文件0.43GB——大概半张手机照片的大小,会看图、会调工具、Apache 2.0开源。名字就叫盆栽:把一棵大树,修进花盆。这期拆三件事:0.43GB怎么来的,成绩单有几本,这一剪刀到底剪掉了什么。
00:05 开场:三个盆,0.43/0.95/2GB 00:40 换算:1.72bit/参数,三值权重的数学自洽 01:42 规格:262K上下文+视觉+工具调用,口径账(Ollama实际911MB) 02:20 双账本:官方保留率 vs 第三方阶梯(94.2%→86.2%→82.9%) 03:17 修树的人:Caltech团队2225万种子轮,七个月四连发 04:01 赛道坐标:4比特档挤满选手,1-2比特档只此一家 04:45 结论:额外比特比额外参数重要
它的做法是三值权重:每个参数只取-1/0/+1,理论最小1.585比特,加上缩放系数,1.72比特严丝合缝——文件小是数学必然,不是障眼法。但账要算两本:官方只跟全精度基线比(9B保留95-99%,2B数学122%),第三方统一题库实测的压缩阶梯是4比特94.2%、三值86.2%、1比特82.9%,损失集中在数学和多语言。还有一条扎心结论:1比特的27B不如8B的三值——额外比特比额外参数重要。真卖点是速度和显存:8GB的RTX 3070跑27B每秒40个token。
日常问答、看图、跑工具,可以养一盆;要它算数学题,先把花盆还给树。
模型:huggingface.co/prism-ml 运行:ollama run bonsai2:2b 文档:docs.prismml.com
[Source](https://www.bilibili.com/video/BV1mFJv6ZEnS)