立正凭800万字语料上线个人AI 称语料密度让廉价模型反超旗舰
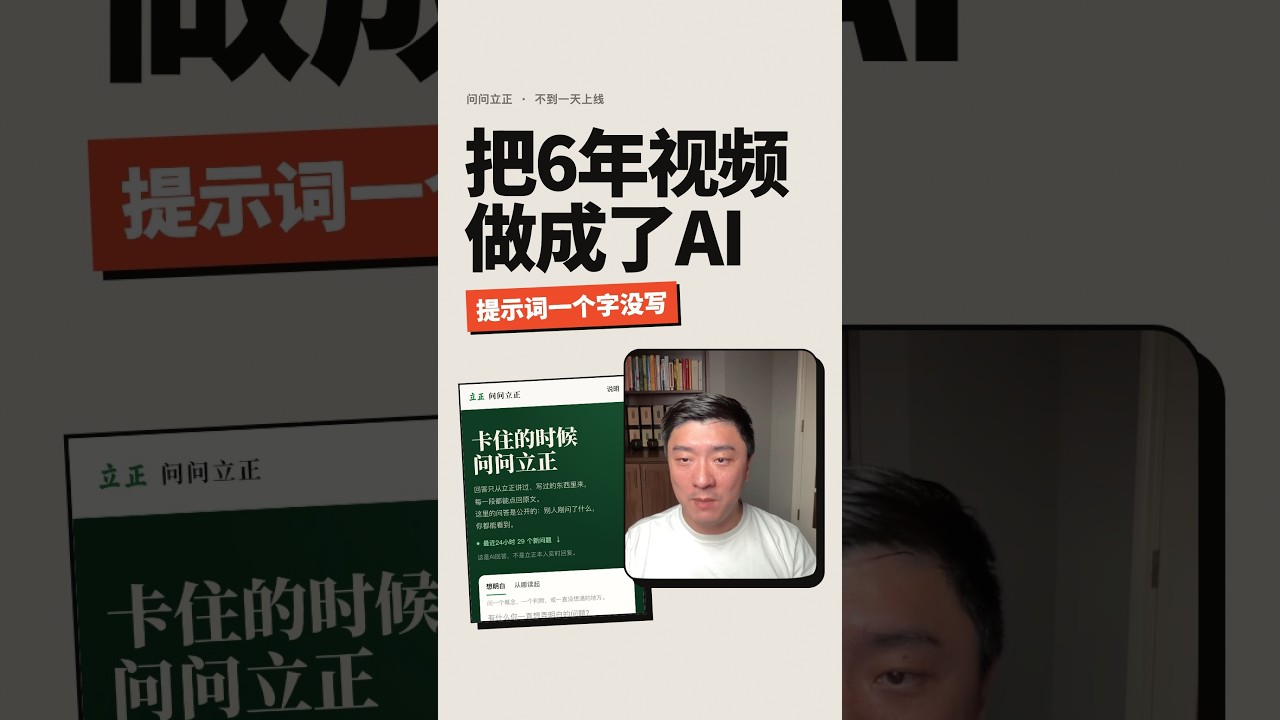
课代表立正
高密度私域语料能让廉价大模型自主涌现深度洞见,但决定系统生死的底层架构权衡与业务减法依然无法被AI替代。
AI-assisted summary of I Turned 6 Years of Videos Into an AI: Zero Prompting Required, Launched in a Day | Ask Li Zheng — original source. Check the original for full context.
Source published:
Key ideas
- 课代表立正将6年积累的800多万字内容做成AI产品“问问立正”,整个项目从开工到上线耗时不到一天,代码与语料库已全部开源。 (0:00)
- 系统长达5000多字的提示词完全由AI自动生成,作者未手动编写提示词,而是采用日常对话形式指导AI进行开发迭代。 (1:13)
- 底层模型采用低成本的DeepSeek,在充分喂入高质量长上下文后展现出反思与挑战用户假设的涌现能力,回答效果超越昂贵旗舰模型。 (2:19)
- 上线第4天因“千人千面未读问答”逻辑导致数据库请求量3天暴增100倍并停摆,作者通过砍掉冗余业务逻辑而非盲目付费升级化解危机。 (3:29)
Detailed notes
## Background 该视频由 YouTube 频道“课代表立正”于 2026 年 11 月 1 日发布。视频简介说明,作者将自己过去 6 年的视频、对谈与文章做成了专属 AI 工具“问问立正”,用一天时间上线且未手写一行提示词,通过高性价比的 DeepSeek 模型取得了媲美顶尖模型的效果,并借此分享打造个人 AI 的三项核心反常识认知与 AI 无法替代人类的关键环节。
## TL;DR 视频复盘了个人知识库 AI“问问立正”从搭建到上线的完整实战经验,打破了必须苦练提示词和采购昂贵模型的固有迷思。作者依靠直接对话让 AI 自行生成了 5000 多字的系统提示词,并证实只要喂入高密度的扎实语料,即使是廉价的 DeepSeek 也能涌现出极具洞见的思考与反思能力。面对上线后因“千人千面”展示逻辑导致数据库请求暴增 100 倍的雪崩危机,作者通过果断做业务减法、重构系统架构化解了停摆风险,印证了商业决策与工程架构权衡是 AI 无法替代的人类核心能力。目前该产品不仅作为作者个人的高效外脑,还通过免费限额与会员无限次实现了商业转化闭环,相关代码和语料库也已全面开源。
## Atmosphere & style 整期内容务实明快、干货密集,充满了极具启发性的反共识洞察。立正以第一人称的开发者视角切入,既有直接发消息“太慢了”、“换模型”的洒脱幽默,又有面对后台监控曲线暴涨、数据库停摆时临危不乱的架构师老练感。叙事打破了市面上神化“提示词工程”与“高价旗舰模型”的虚火,让技术落地回归到真实的业务思考与工程减法上,带给观众极强的实操底气与清醒感。
## Bulletin - [00:00](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=0s) 课代表立正将6年积累的800多万字内容做成AI产品“问问立正”,整个项目从开工到上线耗时不到一天,代码与语料库已全部开源。 - [01:13](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=73s) 系统长达5000多字的提示词完全由AI自动生成,作者未手动编写提示词,而是采用日常对话形式指导AI进行开发迭代。 - [02:19](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=139s) 底层模型采用低成本的DeepSeek,在充分喂入高质量长上下文后展现出反思与挑战用户假设的涌现能力,回答效果超越昂贵旗舰模型。 - [03:29](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=209s) 上线第4天因“千人千面未读问答”逻辑导致数据库请求量3天暴增100倍并停摆,作者通过砍掉冗余业务逻辑而非盲目付费升级化解危机。
## Key takeaways - [00:00](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=0s) 基于个人长期创作内容打造专属AI问答工具无需漫长开发,低代码和AI辅助编程能将上线周期压缩至一天内。 - [01:00](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=60s) 打造垂直知识库AI的核心在于三点:无需专学提示词、无需买最贵模型,以及人类需负责关键工程与业务权衡。 - [01:13](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=73s) 系统提示词工程可完全交给AI代劳,创作者只需通过自然语言直接表达体验、提出挑战即可完成调优。 - [02:19](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=139s) 高质量、高密度的上下文语料(Context)是AI能力涌现的关键,语料充足时AI会从执行工具转变为思考伙伴。 - [02:19](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=139s) 廉价模型结合高密度私有上下文,在特定垂直领域的回答深度与洞察力完全可以匹敌甚至超越最新昂贵模型。 - [03:29](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=209s) 面对系统性能雪崩,AI往往只会建议花钱升级套餐,人类开发者必须从系统架构和曲线趋势排查根本计算瓶颈。 - [03:29](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=209s) 不合理的“千人千面”全量比对逻辑会导致数据库查询发生乘数级爆发,果断做产品功能减法是降低架构开销的关键。 - [04:50](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=290s) 知识库AI不仅是外部用户的咨询窗口,更是创作者自身用于精准检索过往观点的高效“第二大脑”。 - [04:50](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=290s) 通过“普通用户免登录每日限额提问、会员无限次提问”的分层机制,可平滑构建从公域流量到私域会员转化的商业闭环。
## Detailed walkthrough ### [00:00](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=0s) 把6年视频做成了AI:“问问立正”
课代表立正将自己过去6年间(从2020年至2026年)积累的所有视频、对谈与文章做成了一个专属AI工具——“问问立正”(访问网址为 ask.lizheng.ai)。用户可以通过网页端使用,也可以在苹果 App Store、Google Play 或国产安卓应用商店中点击下载,作为手机 App 随时随地查阅。产品界面提供了一个“别人在问什么”的板块,收录了600多个公开回答以及最常被问及的高频问题。当用户提出一个问题时,系统会综合作者过往6年的所有知识内容,给出针对性的系统解答。
整个项目的实现过程充满反常识:教导 AI 回答的提示词,作者一个字都没写;底层驱动模型选用的是成本极其低廉的 DeepSeek,但在很多场景下的回答表现甚至超越了 OpenAI 与 Claude 最新、最昂贵的旗舰模型;更重要的是,从项目正式开工到产品上线,耗时不到一天(GitHub 提交记录完整印证了这一时间线),后续的大量精力则主要用于持续迭代。针对也想打造个人知识库 AI 的创作者,立正总结了三条核心认知: - 第一:不用特意去学怎么写提示词; - 第二:不用购买市面上最贵的模型; - 第三:有一件事情,AI 绝对无法替代人类。
---
[01:13](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=73s) 第一件:不用学写提示词
在实际系统中,负责教导 AI 如何回答的系统提示词(System Prompt)长达 5000 多字,但全部由 AI 自动生成,作者本人“一个字没写”。立正特别感谢了润宇老师与斯斯老师(他们曾探讨过“问问润宇”和“问问斯斯”等类似产品方向),正是两位老师提到此类工具非常值得做,才促使他启动项目。在此之前,立正一直迟迟没有动手,原因是觉得回答系统架构极其复杂,深知“回答问题这件事,是一件很有技术含量的事”,光凭空构思系统提示词太难。
真正动手时,立正采用的完全是日常对话式的交互工作流,而非传统的提示词工程: - **直白表达体验:** 嫌 AI 运行太慢,就直接发消息“太慢了”;嫌回答质量不好,就直接要求它“换模型”。 - **直接挑战方案:** 当 AI 要求重新写一套完整的登录逻辑时,立正直接反问:“你为啥不能直接复用上次那套?” - **喂入扎实语料:** 立正将自己过去 6 年积累的 800 多万字原始内容全部喂给 AI,并且每一段内容都带有清晰的出处标注。
为了让所有人都能低门槛复刻,立正已经将这些底层原料库(Open Context)与完整代码开源,用户可以直接免费取用。
---
[02:19](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=139s) 第二件:不用买最贵的模型与上下文涌现
“问问立正”底层选用的回答模型是价格非常便宜的国产大模型 DeepSeek。立正以一个实际问答案例展示了其表现:有用户提问“没有销售资源,产品怎么分发?”,DeepSeek 给出的第一个小标题直接是“先检查‘缺销售资源’这个前提”。模型在正文中犀利指出:“你问怎么分发,就等于默认产品没问题,只差推广。但这个判断本身可能就是错的。”
立正透露,自己从未专门教过 DeepSeek 必须在 System Prompt 里去挑战用户的前提假设。之所以模型能自发做到这点,是因为他在过往 800 万字的资料库中多次反复阐述过类似的商业底层逻辑,“资料够了 它自然就领悟了”。
这印证了超线性学院(Stay Superlinear)知识库中《AI User 与 AI Builder 的 5 个差距》的核心论点:当 Context(上下文)的密度达到临界阈值之后,AI 会自然而然地从单纯的“执行工具”涌现为能够提出洞见的“思考伙伴”。正因如此,一个价格低廉的模型搭配高质量、高密度的上下文语料,产出的回答质量往往能超越最昂贵的模型。
```mermaid flowchart LR accTitle: 上下文密度引发的 AI 涌现机制 accDescr: 展示高质量语料达到密度阈值后,便宜模型如何从执行工具转变为思考伙伴 subgraph Input ["输入层"] A["6年积累语料<br/>(800万字带出处内容)"] B["高性价比模型<br/>(DeepSeek)"] end
subgraph Processing ["质变临界点"] C["Context 密度<br/>达到阈值"] end
subgraph Emergence ["能力涌现"] D["执行工具<br/>(按指令输出)"] E["思考伙伴<br/>(反思与挑战用户假设)"] end
A --> C B --> C C -->|"能力跃迁"| D D -->|"认知涌现"| E ```
---
[03:29](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=209s) 第三件:有一件事,AI替代不了你
上线仅仅第 4 天,项目就遭遇了突发的技术危机:数据库每月 50 万次的免费调用额度被彻底耗尽,导致网站直接停摆了 20 分钟。面对这一事故,辅助编程的 Claude 建议立正将数据库订阅升级至每月 10 美元的不限次数套餐,并安抚称既然花 10 美元就不限请求量了,这个问题“不急着改”。
但立正通过查阅后台监控曲线发现,每小时的请求量在短短 3 天内暴增了 100 倍。深入排查架构后,立正发现了系统雪崩的根源: 1. **致命的计算逻辑:** 在原版产品中,除了“最近问”和“最常问”标签外,立正设计了一个名为“没看过”的功能——每个用户刷新页面时,系统必须只展示该用户未看过的问答。 2. **指数级数据库读写:** 为了实现千人千面的“没看过”,每一个新访客进入,数据库都要把全量问题读一遍、排重比对一遍。随着访问人数与问题库数量同步增长,请求量直接呈现乘数级、指数级爆发,瞬间撑爆数据库。 3. **架构层面的重构:** 立正果断将“没看过”功能彻底砍掉,改为让所有用户统一浏览同一份“最近问”与“最常问”的公共列表。这一调整直接去除了千人千面的实时全量遍历,当天的数据库请求曲线瞬间骤降回安全区间。
立正总结道:“AI 在这里边看的是这个月的账单,我看的是这个曲线,它背后其实是架构的功底。”商业决策背后的工程架构权衡、成本动态预判与业务减法,是 AI 目前根本无法替人类承担的核心职责。
---
[04:50](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=290s) 重新理解“套壳”与产品商业闭环
在动手之前,立正也曾对开发这类应用抱有怀疑态度,觉得所谓的“问问立正”不过是在大语言模型外面套了一层壳,“大家买这个东西,可能还是买 GPT 的能力”。然而在真正上线并供公众免费使用后,他体会到了多维度的超预期价值: - **作者自身的个人高效外脑:** 即使是立正本人,在突然想查证自己过去的观点时(例如“立正讲恩格斯陷阱在哪里”),也可以直接向它提问,产品瞬间变成了一个精准检索个人毕生创作的极简搜索引擎。 - **合理的商业分层设计:** 产品采取“免费、免登录,但普通用户每天限额提问 3 次”的策略;如果需要不限次数使用,则需要成为 Superlinear(超线性学院)的会员,从而顺畅完成了从免费公域工具到付费会员体系的商业转化与飞轮闭环。
立正呼吁,任何积累了数年笔记、文章或视频的创作者,都可以尝试搭建属于自己的 AI 知识库。目前“问问立正”的前端代码与底层内容库 Open Context 均已全部开源,可供所有人直接克隆与参考使用。
## Notable quotes > [02:19](https://www.youtube.com/watch?v=5-z-DkvUkUE&t=139s) 你问怎么分发,就等于默认产品没问题,只差推广。但这个判断本身可能就是错的。 — DeepSeek
## Mentioned 课代表立正, 问问立正, DeepSeek, Claude, OpenAI, GitHub, App Store, Google Play, 润宇, 斯斯, 超线性学院 (Stay Superlinear), 《AI User 与 AI Builder 的 5 个差距》, Open Context
## Video description 我把这6年的视频、对谈和文章,做成了一个AI:问问立正。教它怎么回答的提示词,我一个字没写;回答用的是便宜的DeepSeek,很多时候却比Claude、OpenAI最新最贵的模型答得还好。从开工到上线,不到一天。
如果你也想做一个这样的AI,这条视频讲三件事:不用学写提示词,不用买最贵的模型,还有一件事,AI替代不了你。
章节 0:00 把6年视频做成了AI 0:38 三个反常识 1:00 如果你也想做一个:三件事 1:13 第一件:不用学写提示词 2:19 第二件:不用买最贵的模型 3:29 第三件:有一件事,AI替代不了你 4:50 一开始我也觉得是套壳
问问立正:https://ask.lizheng.ai/ (所有人每天可以问3次,Stay Superlinear 的 Founding Member 不限次) 代码开源:https://github.com/sunyuzheng/ask-lizheng 资料库 Open Context:https://github.com/sunyuzheng/lizheng-open-context 复盘长文:https://www.superlinear.academy/c/share-your-projects/ask-lizheng-not-just-a-wrapper AI User 与 AI Builder 的5个差距:https://www.superlinear.academy/c/ai-resources/ai-mastery
[Source](https://www.youtube.com/watch?v=5-z-DkvUkUE)