大肥鱼怎么知道第37分钟发生了什么?
AI技术投降派
AI-assisted summary of 大肥鱼怎么知道第37分钟发生了什么? — original source. Check the original for full context.
Source published:
Key ideas
- 开源项目 dsh-video-storyboard 开辟多模态视频理解第三条路,将视频切为 9 至 16 格九宫格并生成时间码清单,90 秒视频仅耗约 1900 Token,成本仅为 Gemini 原生输入的 1/14。 (0:28)
- 底层算法将帧缩放至 64×36 极低分辨率转入 HSV 色彩空间进行环形色相比差与自适应阈值切割,实测精准识别出 178 处剪辑刀数。 (1:27)
- 项目三天迭代 10 个版本,设计坚持“是证据不是策略”的克制哲学,将提示词注入仅作标注不改执行路径,并生成 .evidence.json 供毫秒级复核。 (2:21)
- 该插件补齐了大肥鱼生态视频理解拼图,但仍存在单格 331×184 无法认脸、缺少缓存重复计费以及无 ASR 时误报等物理限制。 (4:27)
Detailed notes
## Background 该视频由 Bilibili UP 主“AI技术投降派”于 2026 年 11 月 1 日发布。视频围绕“大肥鱼”生态中三天内斩获 114 颗星的开源插件场景感知分镜(dsh-video-storyboard)展开,详细拆解了其如何通过一张九宫格拼图与结构化清单,让 AI 在极低 Token 消耗下看懂长视频的核心机制与工程哲学。
## TL;DR 视频深度解析了“大肥鱼”生态中新开源的场景感知分镜插件(dsh-video-storyboard),指出其跳出了“逐帧抽图”与“只喂字幕”的传统两难,通过 64×36 极低分辨率 HSV 色彩空间算法与信息密度积分,将视频压缩为 9 至 16 格拼图及结构化证据清单,仅用约 1900 Token 即可解析短片。该插件补齐了大肥鱼从读字幕、截屏感知、推流播片到深度理解画面的第四块拼图,实现了本地化低成本运行。作者同时坦率指出了单格分辨率低无法认脸、缺乏缓存导致重复付费及 ASR 状态误报等客观局限。
## Atmosphere & style 全片呈现出一种极度冷静、硬核且不随波逐流的工程师极客质感,语速沉稳克制,毫无浮夸的噱头宣传。叙事上层层剥茧,不仅有对算法细节和社区审计博弈的敏锐剖析,还带着难能可贵的“泼冷水”式自我审视,既有见证技术闭环的从容与浪漫,又始终保持着扎实的实证主义态度。
## Bulletin - [00:28](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=28s) 开源项目 dsh-video-storyboard 开辟多模态视频理解第三条路,将视频切为 9 至 16 格九宫格并生成时间码清单,90 秒视频仅耗约 1900 Token,成本仅为 Gemini 原生输入的 1/14。 - [01:27](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=87s) 底层算法将帧缩放至 64×36 极低分辨率转入 HSV 色彩空间进行环形色相比差与自适应阈值切割,实测精准识别出 178 处剪辑刀数。 - [02:21](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=141s) 项目三天迭代 10 个版本,设计坚持“是证据不是策略”的克制哲学,将提示词注入仅作标注不改执行路径,并生成 .evidence.json 供毫秒级复核。 - [04:27](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=267s) 该插件补齐了大肥鱼生态视频理解拼图,但仍存在单格 331×184 无法认脸、缺少缓存重复计费以及无 ASR 时误报等物理限制。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=0s) 传统视频理解面临逐帧抽图 Token 爆炸与纯字幕丢失画面信息的两难困境。 - [00:28](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=28s) “大肥鱼”分镜插件将视频压缩为 9~16 格拼图(Token 封顶 384)配以结构化时间码清单,极大降低模型输入开销。 - [00:28](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=28s) 该方案输入 90 秒视频仅需约 1900 Token,消耗仅为常规关键帧方案的 1/2 至 1/4.5,更远低于 Gemini 原生视频输入的 1/14。 - [01:27](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=87s) 核心算法将画面整体缩小至 64×36 并在 HSV 色彩空间中根据色相环形距离比差,动态自适应计算切镜阈值。 - [01:27](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=87s) 分镜网格基于信息密度积分等分,密集混剪段落会自动展开为 4×4 细格子,算法在 10 类实测中准确识出 178 刀剪辑。 - [01:27](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=87s) 算法输出附带 .evidence.json 完整记录时间范围、关键帧时刻与刀数,坚持只提供客观事实、不替模型下主观结论。 - [02:21](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=141s) 项目 3 天迭代 10 个版本并破百星,社区审计指出线性色相差值等严重漏洞后,作者迅速推倒重构核心算法。 - [02:21](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=141s) 面对恶意提示词注入攻击,系统选择在底层标记可疑风险而不拦截执行路径,恪守“这是证据,不是策略”的原则。 - [02:21](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=141s) 作者基于实测拒绝了导致数据膨胀 49%、热路径耗时骤增 2.3 倍的重构 PR,专注于模型实际理解能力而非空洞的代码美感。 - [03:14](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=194s) 该插件补齐了从“字幕读取”、“屏幕变动监测”、“主播推流”到真正“洞悉画面”的陪看四块拼图。 - [03:14](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=194s) 两个独立开发者在互不知情的情况下,不约而同选用 64×36 极低分辨率作为视觉通道,实现了底层优雅收敛。 - [04:27](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=267s) 单格分辨率仅 331×184,当前版本无法用于精细人脸识别与细微道具辨别。 - [04:27](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=267s) 插件缺乏缓存机制导致重复提问重复计费,且暗光不稳定、长镜头刀数偏差及未配置 ASR 时易误报无台词。 - [05:12](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=312s) 该项目将昂贵且依赖云端大模型的视频理解特权降维,转变成任何本地 Agent 均可运行的轻量化透明例行操作。
## Detailed walkthrough ### [00:00](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=0s) 第三条路:用一张图与 1900 Token 看完视频
让多模态大模型“看懂”视频一直面临两难境地。常规的解决路径通常只有两条,且都显得十分笨拙: - 第一条路是**逐帧抽图**。以一部 90 秒的短片为例,若按每秒截取一张图计算,整段视频需要抽取 90 张图像输入模型,导致 Token 消耗直接爆炸; - 第二条路是**只喂字幕**。这种方法成本极低、十分便宜,但代价是彻底丢失了画面视觉信息。
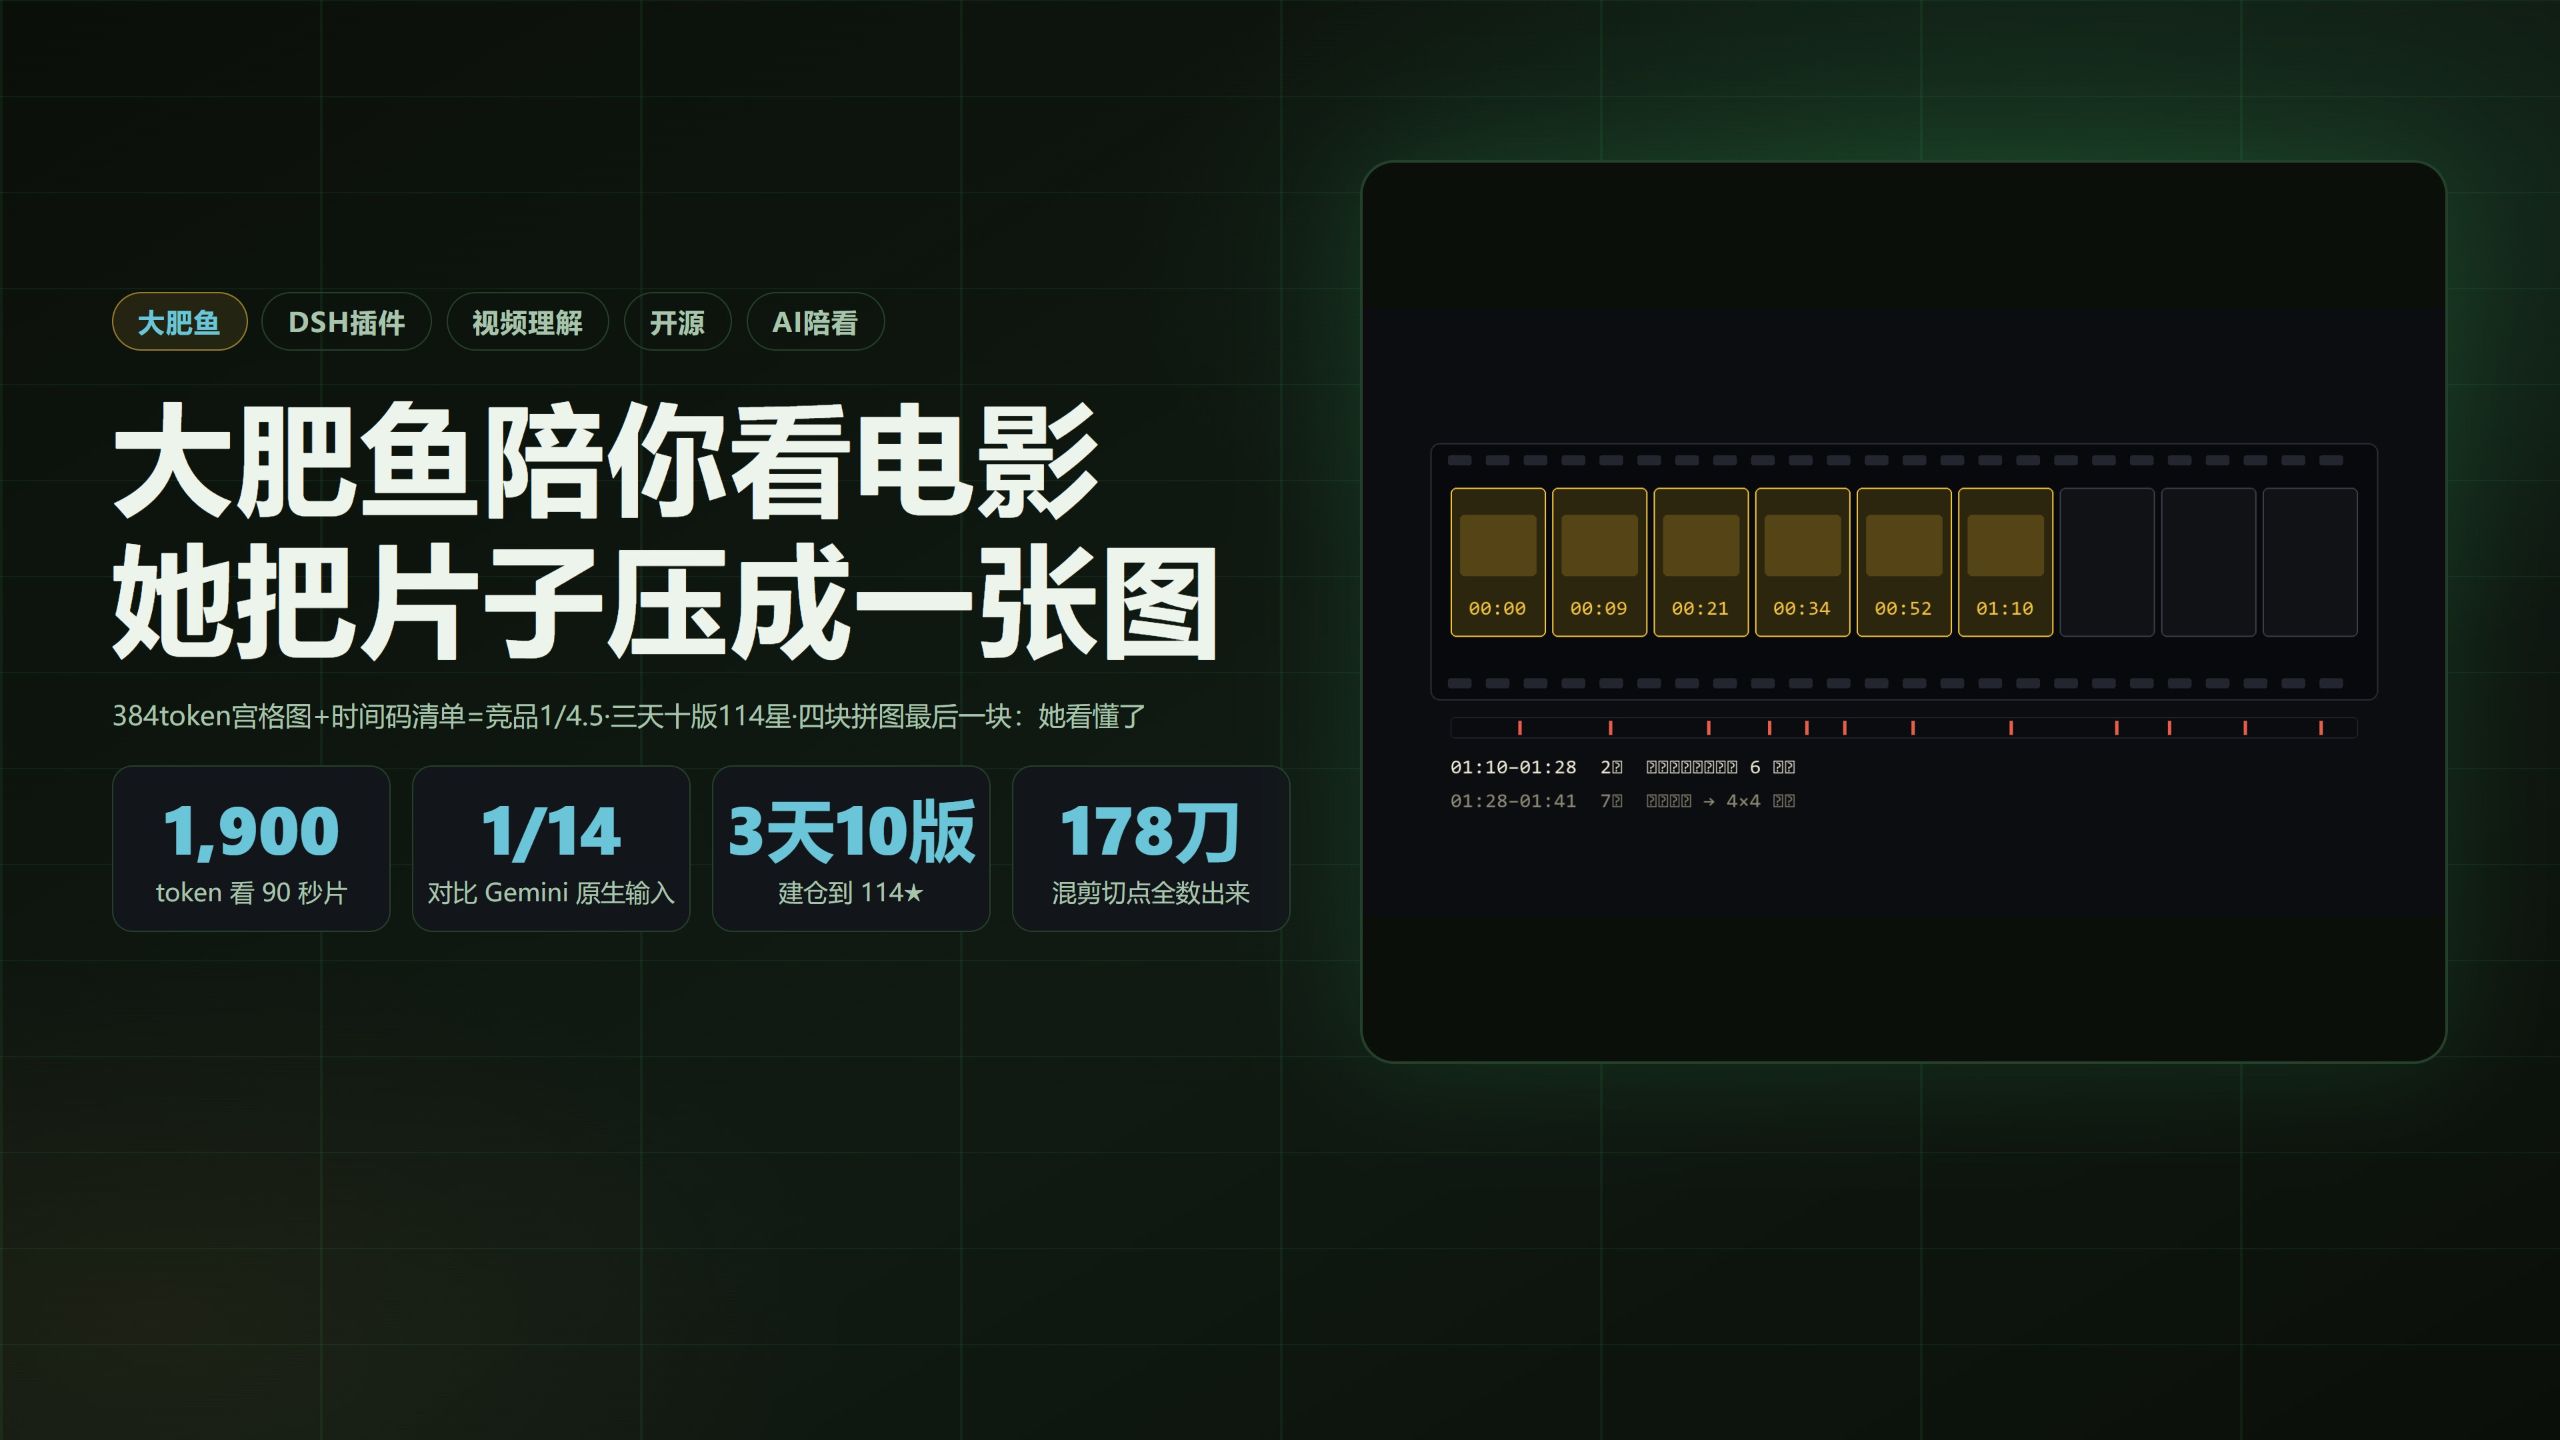
“大肥鱼”生态(`dsh-video-storyboard`,场景感知分镜)选择开辟第三条路:将视频精准切分为 9 到 16 格,拼接成一张整体的九宫格拼图。在这套方案下,图片 Token 被严格封顶在 384;同时系统生成一份结构化文本清单,详细标出每一格画面的起始与终止时间码、台词文本以及切镜(镜头切换)刀数。两者结合,90 秒的短片仅耗费约 1900 个 Token。这一消耗仅为传统关键帧方案的 1/2 至 1/4.5,更是 Google Gemini 原生视频输入的 1/14。用户只需贴入一个 Bilibili 视频链接,后台四件工具便各司其职,无缝完成从场景探测、分镜生成、局部放大细看,到依据一句话精准定位时间码的全流程。
```mermaid flowchart TD accTitle: 场景感知分镜技术流程图 accDescr: 展示视频从输入预处理到 64x36 HSV 算法切分,再到九宫格与证据清单的生成流程。
subgraph IN["输入与预处理"] V["B 站视频源"] --> PRE["视频按帧缩放到 64x36"] end
subgraph CORE["核心感知算法"] PRE --> HSV["HSV 色彩空间逐帧比差"] HSV --> ADAPT["色相环形距离 + 低饱和度降权<br/>自适应阈值计算"] ADAPT --> INT["信息密度积分动态分格"] end
subgraph OUT["交付产物"] INT --> IMG["9~16 格拼图<br/>(Token 封顶 384)"] INT --> TXT["时间码与台词清单"] INT --> EVI[".evidence.json<br/>(原始时间/刀数/取帧记录)"] end ```
[01:27](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=87s) 核心算法:64×36 的一双眼睛与工程实测
这套方案背后的核心算法设计非常精巧:它在预处理阶段先将视频画面整体缩小为仅 64×36 像素的极低分辨率,转入 HSV 色彩空间进行逐帧比差。在计算两帧变化时,色相严格按照环形角度距离计算,并对低饱和度区域进行降权处理;切点阈值拒绝使用写死的固定经验值,而是依据每部视频自身的分数分布进行自适应计算。
在网格划分上,该插件按照信息密度的积分进行等分切割——镜头切得密集的段落,所占的格子排布也更加紧密;如果是快节奏的快闪混剪段落,系统会直接将其摊开为 4×4 的密集子格。作者采用了 10 类 B 站真实素材进行实测调参,覆盖 PPT 录屏、监控录像合集、动画混剪以及长达 41 分钟的纪录片。在高度考验算法的动画混剪实测中,全片 178 处剪辑“刀数”被完整、准确地数了出来。
更难能可贵的是该项目的工程态度。算法每次执行输出时,都会同步生成一份详细的证据文件(`.evidence.json`),清晰记录每一格的具体时间范围、截取关键帧的绝对时刻、镜头切角刀数以及对应的台词原文,无论是人类审核员还是自动化脚本,都能对照原片毫秒级复核。正如作者在设计中所坚持的:清单只给客观原材料,从不下主观结论;如果某些算法统计出的数字不够可靠,就在文档中直接说明。
[02:21](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=141s) 三天十版:社区审计驱动的敏捷迭代
这是一个刚刚诞生三天却展现出惊人进化速度的开源项目: - 10 月 26 日晚间建仓,上线仅 20 分钟后就推出了第一版; - 仅用三天时间便迭代了 10 个版本,GitHub Star 迅速突破 114 颗,整体研发节奏完全是被开源社区推着向前狂奔。
在项目上线第二天,社区提交了一份非常严厉的实相审计(Audit)。其中最核心的漏洞指出:作者在早期版本中,色相差异居然采用了线性差值计算。这导致色相 0 度与 255 度这两种本在色环上紧密相邻的红色,被算法判定为天壤之别的两极;两帧肉眼看起来完全一致的红色画面,却因此拿到了极高的差异分,被算法频繁误判为切镜。收到审计意见后,作者随即彻底重写了打分核心逻辑。
此外,社区在评论区测试发现了多处点名针对“大肥鱼”插件的提示词注入攻击(Prompt Injection)。面对恶意诱导,作者没有粗暴拦截,而是直接在底层落地了一个专门的标记字段,仅用于标明该片段存在可疑注入风险,绝不改变程序的底层执行路径。对于这种克制的设计哲学,作者解释道: > “这是证据,不是策略。”
面对其他开发者提交的代码“大重构”PR,作者在实际 benchmark 后果断予以拒绝。测试数据显示,重构方案会导致输出清单体积膨胀 49%,核心热路径(Hot path)处理速度骤降 2.3 倍;这种改动的收益仅仅是“代码结构变得好看”,对模型最终能否读懂视频没有任何实质帮助。作者直言团队一直在修补自身的认知偏差,每一版都在解决同一个根源问题: > “我们说的和实际做的不一样。”
[03:14](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=194s) 陪你看电影的四块拼图与独立演进
将视线从单点技术拉开,这个分镜插件标志着大肥鱼生态补齐了“陪用户看电影”这幅拼图的最后一块基石。在此之前,整个体系经历了三个阶段: 1. **第一块拼图(太傻 B站 / 字幕读取)**:系统单纯依靠提取视频字幕来理解剧情,画面层面的信息被完全绕开; 2. **第二块拼图(金鱼陪看)**:系统盯着用户的屏幕,每隔两秒截屏瞄一眼,能感知画面发生变动,却完全理解不了究竟变了什么; 3. **第三块拼图(主播模式)**:AI 可以自己推流播放视频,但这纯粹是下游的媒体输出与表演,不代表它理解视频内部信息; 4. **第四块拼图(场景感知分镜)**:大模型第一次凭借自适应分镜图和精准时间码清单,真正“看懂”了长视频的具体脉络。
极具巧合的是,生态中的“陪看插件”与本次的“分镜插件”是由两位不同的开发者在相差五天的时间里独立开发的。然而,两者在没有互相引用、彼此并未串通的前提下,竟然完全独立地选用了同一双底层的“眼睛”——**64×36 极低分辨率视觉通道**。一个用来监测屏幕变化,一个用来理解镜头切换;一个侧重动态感知,一个侧重结构切分。不同的分支在面对同一类工程困境时,自发收敛出了完全一致的优雅解法。
[04:27](https://www.bilibili.com/video/BV1a5sZ6LEN3?t=267s) 泼冷水:局限性、已知缺陷与本地化价值
尽管该插件表现抢眼,但当前版本仍有几盆“冷水”需要泼在头上,使用者必须清醒认识到其物理限制与已知缺陷: - **单格分辨率过低**:拼图中的单个画格分辨率仅有 331×184,用来分析镜头构图和色彩氛围绰绰有余,但无法看清细微道具,更完全无法用来做准确的人脸识别; - **缺乏缓存机制导致重复计费**:每次向模型提问都会重新走一遍生成分镜图与清单的管线,如果反复就同一部片子追问细节,API 消耗费用会线性累积; - **极端光影与运镜失真**:遇到亮度极低的画面时抽帧不够稳定;当遇到复杂的连续长运镜时,算法计算出的切镜“刀数”容易产生偏差。这些算法瓶颈作者均已在官方文档中明确承认; - **ASR 状态误报**:该问题目前尚未彻底修复——当环境没有配置语音识别(ASR)组件时,输出清单可能会直接把“没能听到声音”错误地报成“该时间段没有台词”。
在当前的中文技术社区中,关于“大肥鱼看视频”的教程早已经扎堆,仅三天之内就冒出了十几条,但绝大多数都停留在教人安装插件、跑跑 Demo 的浅层演示阶段;真正去抽丝剥茧讲明白它底层计算逻辑与算法取舍的,目前仅此一家。
这个插件最为深远的意义,在于打破了云端多模态处理的垄断地位。长期以来,让大模型读视频一直是属于高阶云端 API 的特权,需要按照 Token 甚至每秒计费、大笔烧钱。而这套方案成功把整套处理管线搬回了本地终端——任何一个具备基础识图能力的本地 Agent,只要挂载这套轻量级管线,就能把原本昂贵的视频理解降维成随时可跑的本地例行操作,并且全程提供透明可复核的证据链。
从早期的单读字幕、看见动态、开口播片,再到如今真正洞悉画面,四块拼图彻底闭环。正如视频最后所描绘的日常场景:下次当你重新打开一部九十分钟的老片,大可以回过头去问问身旁的那条大肥鱼,第三十七分钟究竟发生了什么,而这一次, > “他真的知道。”
## Mentioned 大肥鱼, dsh-video-storyboard, Google Gemini, Bilibili, 太傻 B站, 金鱼陪看, GitHub
## Video description 一部九十分钟的片子,她十秒钟就能"看完",还能告诉你第三十七分钟发生了什么。不是快进,不是跳着看——她把整部片子压成一张九宫格图,配一份带时间码的清单。这就是大肥鱼宇宙三天的最新插件:场景感知分镜(dsh-video-storyboard),建仓到一百一十四颗星只用了三天。
00:05 她怎么看电影:一张图 + 一份清单 00:28 第三条路:1900 token 看完 90 秒片 01:27 核心算法:64×36 的一双眼睛 02:21 三天十版:被社区推着跑的项目 03:14 陪你看电影的四块拼图,齐了 04:27 泼冷水:单格分辨率、重复付费、ASR 误报 05:12 把看视频从云端特权变成本地例行
这个项目最值得说的是态度:算法用十类 B 站素材实测调参(混剪 178 刀全数出来);每次输出同时写一份 .evidence.json,每格的时间、取帧时刻、刀数全记录,人和脚本都能对着原片复核;遇到提示词注入,只标注可疑片段不改执行路径——作者原话:"这是证据,不是策略"。也有冷水:单格 331×184 认不了人脸,重复查询重复付费,没配语音识别时可能把"没听"报成"没有台词"。另外中文区"大肥鱼看视频"教程已经扎堆,但讲清楚它怎么想的,这是第一支。
项目地址:github.com/SAOS-3624/dsh-video-storyboard(MIT)
[Source](https://www.bilibili.com/video/BV1a5sZ6LEN3)