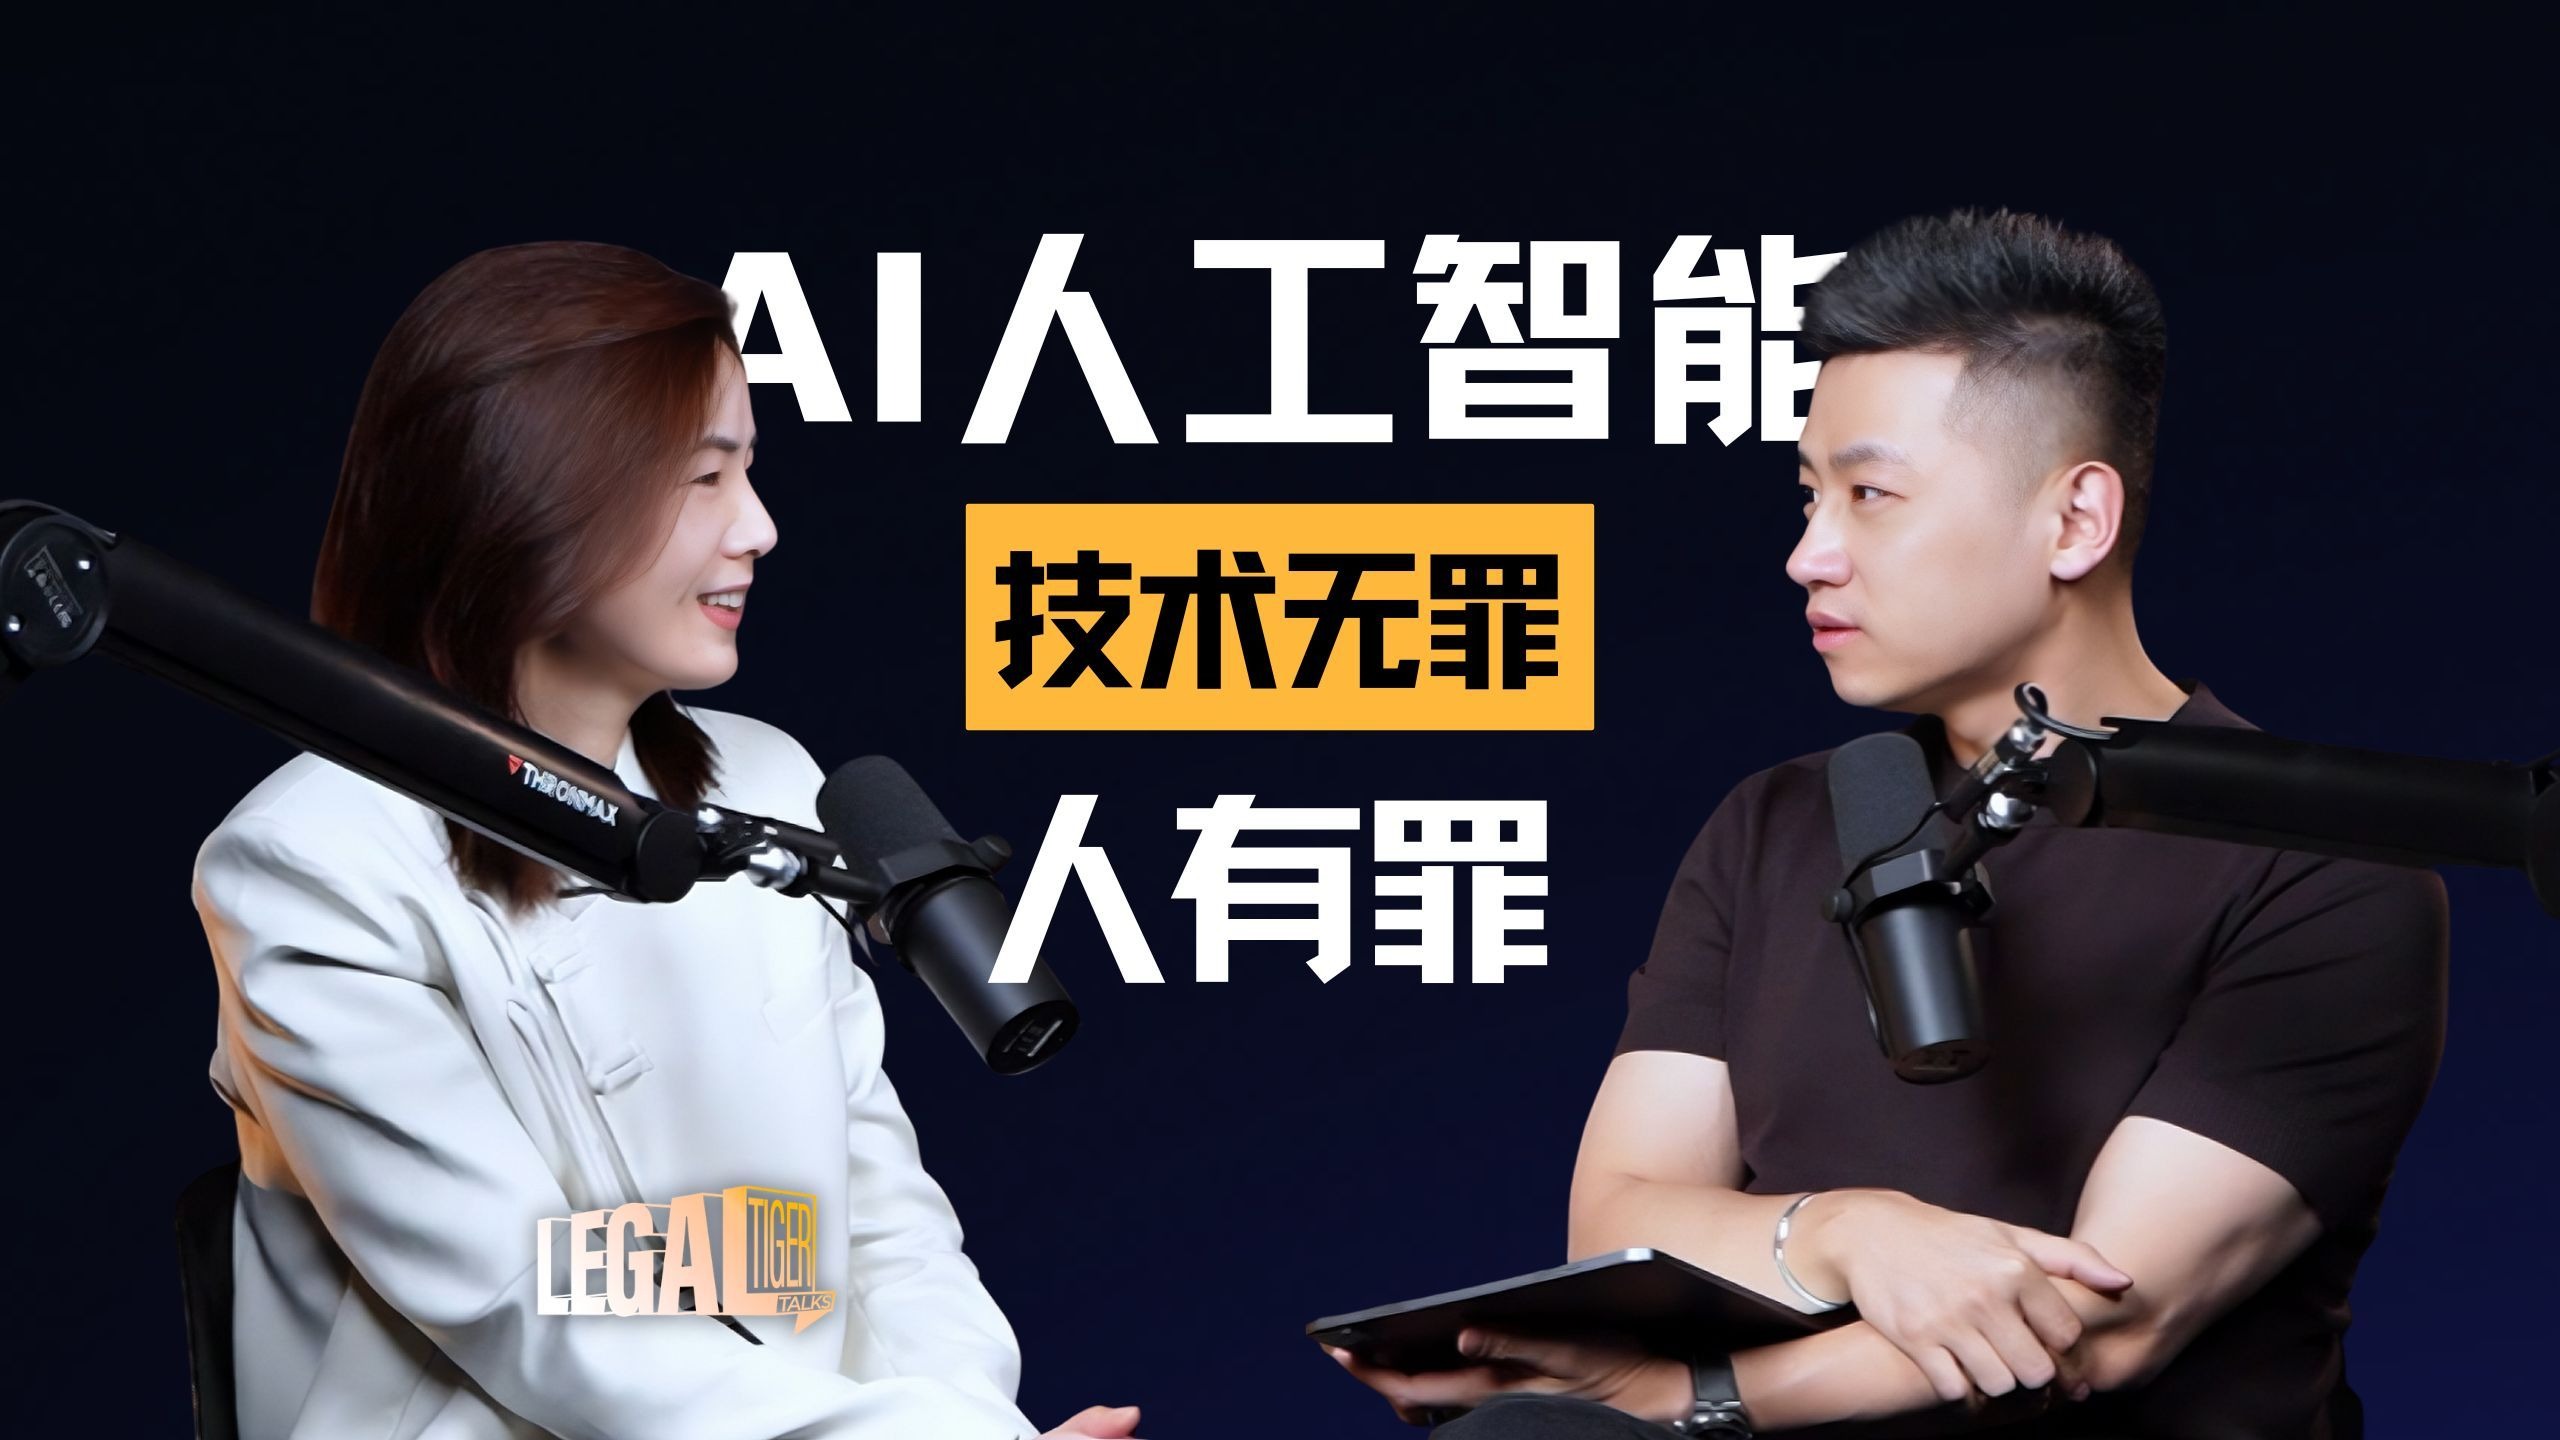
抖音前法务李绕娟指欧洲拉美转入先发展后治理AI新共识
中二的大暄哥
大模型训练阶段的全球数据抓取流量已占互联网半壁江山,针对维权成本高企的现状,应在内容安全与反诈输出端对技术滥用者实施刑事重判而非限制前端研发。
AI-assisted summary of EP004| 李绕娟:AI人工智能,技术无罪,人有罪 — original source. Check the original for full context.
Source published:
Detailed notes
## Background 该视频播客由 Bilibili 平台的“中二的大暄哥”频道于 2025 年 4 月 9 日发布,属于专为亚太地区华语圈高端法律人才打造的《Tiger Legal Talks》节目。节目旨在聚焦热门、硬核的法律话题,通过邀请法律精英与跨界达人进行深度分享,带给受众一场从法律视角洞察世界的思想盛宴。
## TL;DR 本期节目中,前 TikTok 法务 BP、资深数据与隐私律师李绕娟与主持人展开对话,理性剖析了 AI 在法律界的应用现状。李律师结合自身拜访 OpenAI 总部的经历以及行业调研,深入探讨了 AI 生成物的著作权归属、大模型训练在海外的“合理使用”辩论、音色克隆的技术内幕以及全球隐私监管风向。同时,她还分享了当前中国企业出海在面对预算紧缩时,如何通过中国律师的前置调研与海外律师的精简确认,高效解决跨境数据合规与远程技术支持等痛点问题。
## Atmosphere & style 整个对谈呈现出一种极具专业度却又不失风趣幽默的沙龙氛围。主持人与李律师作为前同事,彼此间的互动自然流畅、默契十足,在探讨硬核技术法律条文时,能将复杂的 AI 三要素精妙地比喻为“海淀学区房养孩子”,让枯燥的法理推导变得生动有趣。当李律师自信地分享自己如何研发“高性价比平替方案”并让外国同行只回答“Yes or No”来为客户省钱时,主持人的惊呼调侃更是将节目气氛推向了轻松的笑点高潮,整场听下来既充满干货又十分接地气。
## Key takeaways - [00:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=0s) 李绕娟律师认为当前大众普遍高估了 AI 的短期效果,却低估了其长期收益,并预测在自己有生之年 AI 不会改变当前的法律行业现状。 - [00:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=0s) 李律师主张将 AI 工具严格限定在工作辅助场景,坚决反对用机器来替代人类的情感或社交需求。 - [05:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=300s) 全球法律界目前普遍对“AI 生成物是否构成受著作权保护的作品”持否定态度,李律师亦坚定支持华东政法大学王迁教授“纯粹 AI 生成物不受著作权保护”的观点。 - [05:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=300s) 根据某律所对大模型用户协议的调研,50% 以上的平台约定 AI 生成物的财产权归用户,但平台普遍要求用户授权将输入输出数据抓回后端用于模型训练。 - [05:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=300s) 针对 AI 训练阶段的侵权指控,美国科技巨头提出了两大核心抗辩:一是训练利用属于美国著作权法下的合理使用,二是 AI 是通过 API 结构进行非复制性的深度学习。 - [15:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=900s) 李律师将 AI 训练的三要素(算力、算法、数据)生动地比喻为“养孩子”过程中的学区房、父母智商学历以及日常食物营养。 - [15:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=900s) 关于 AI 侵权诉讼,美国学界泰斗萨米尔森教授支持“训练阶段看合理使用以保障技术发展,输出阶段看实质性相似以判定侵权”的划分。 - [15:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=900s) 中国因非判例法国家,目前的司法裁判在天平两端尚未解决数据合理使用与保护个体权利、支持平台研发之间的根本性制度平衡。 - [20:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=1200s) 在加利福尼亚州隐私法下,“公开的个人信息”不构成定义下的个人隐私,这是大模型能合法抓取公开数据进行训练的重要法律依据。 - [20:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=1200s) 2022 年左右以大模型训练为主的网络数据抓取(Scraping)流量已占据全球互联网总流量的半壁江山(50%)。 - [20:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=1200s) 2025 年巴黎 AI 峰会后,全球(包括欧洲等地区)的监管风向发生重大转变,为了避免落后于中美,纷纷转向“先发展、后治理”的共识。 - [25:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=1500s) 市面上常规的“音色克隆”工具本质上只是录音去噪与音质微调,并未真正提取具备唯一性的声纹信息。 - [25:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=1500s) 李律师坚定站在“技术无罪,人有罪”的立场上,主张通过在内容安全、反诈两端重判以及输出端强制嵌入水印来管控风险,而非限制技术研发。 - [25:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=1500s) 当前中国企业出海在数据合规上的核心痛点在于:境外用户数据向境外服务器传输的合规,以及中国境内研发团队远程跨国访问境外服务器数据的合规。 - [25:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=1500s) 面对合规预算缩水,中国律师可以通过先行出具高完成度 Memo 梳理核心风险、再找境外本地律师进行“Yes or No”确认的方式,大幅削减企业出海的法律合规成本。
## Detailed walkthrough 以下是根据录音剪辑整理的详细内容走读:
[00:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=0s) 律师眼中的 AI 与“技术无罪”论
节目一开始,主持人刘玉轩(大宣哥)便向嘉宾李绕娟(娟姐)抛出核心问题:AI 是否会改变当前法律行业的现状?李律师给出了一个极为直率的回答:“我觉得我死之前应该不会。”在她看来,当下人们普遍高估了 AI 的短期效果,却低估了其长期的收益。
刘玉轩对李律师的教育和职业背景进行了详细介绍,她毕业于加州大学伯克利分校(UC Berkeley)及西安交通大学知识产权研究中心,曾先后在北京市金杜律师事务所、德国泰勒信律师事务所驻北京代表处、普华永道以及阿里影业工作过,在成为独立律师前,还曾担任 TikTok 法务 BP 和抖音集团数据与隐私法务。尽管被主持人评价为“法律圈里最懂 AI 的人”,李律师却坦言自己平时很少用 AI 进行纯娱乐或聊天,甚至在 DeepSeek 爆火时也未盲目跟风。她理性地将 AI 工具(如豆包、Kimi、DeepSeek 和 ChatGPT)严格限定在工作辅助场景,利用 ChatGPT 润色英文邮件或检索海外资料,用国内模型进行信息检索。她明确表示自己从不使用 Character AI 或 MiniMax 的“星野”(Talking)等在国外极火、娱乐属性极强的社交类 AI。李律师强调,自己需要心理咨询会找专业人士,需要倾诉会找朋友,绝不相信用机器来替代人类的情感需求。她直言:“你用了这个东西,你要承担这个东西后面带来的所有的后果,好的和坏的。”
谈及 AI 的发展史,李律师指出,AI 并非在 2022 年下半年 ChatGPT 横空出世时才出现,早在 20 世纪 50 年代的国际会议上达特茅斯学者就提出了“Artificial Intelligence”这一概念。只是随着 ChatGPT 的火爆,法律界才开始密集讨论其带来的数据训练、内容安全、隐私保护以及著作权等核心技术法律问题。
- **李绕娟律师履历要点**:毕业于 UC Berkeley 和西安交大知产中心;历任金杜、德国泰勒信、普华永道、阿里影业,曾任 TikTok 法务 BP 及抖音集团数据与隐私法务。 - **李律师日常使用的 AI 工具分工**: * **ChatGPT**:主要用于英文语料的润色和海外信息的检索。 * **豆包、Kimi、DeepSeek**:纯粹从工作角度用于国内信息的检索与辅助。 - **名言引用**:“大家其实是高估了 AI 短期的效果,低估了它的长期收益。”
---
[05:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=300s) AI 生成物的著作权归属与美国“合理使用”辩论
主持人与李律师聊到两人曾共同在金杜律师事务所任职的往事。李律师指出,在 ChatGPT 爆发前,知产律师与 AI 的交集仅限于涉及人工智能的专利申请或软件著作权保护。关于“AI 生成物是否构成受著作权保护的作品”这一议题,全球法律界普遍持否定态度。英国版权法虽然曾倾向于保护计算机生成物,但目前也在酝酿修改;而美国版权局此前就撤销了某些 AI 绘画作品的著作权证书。在中国学界,李律师非常推崇华东政法大学王迁教授的“人工智能著作权三论”,并坚定支持其“纯粹的 AI 生成物不受著作权保护”的观点。
主持人提出一个具体假设:如果自己使用豆包或 Kimi 编排一部以团队伙伴为原型的职场小说,并生成了相关人像,这个作品的权利到底属于谁?李律师厘清了两个不同的法律层级:首先是“受不受著作权保护”,目前共识是不受保护,意味着别人直接拿去用也不构成侵权;其次是“财产权利归谁”。根据某律所对各大 AI 产品《用户协议》(Terms of Service)的调研,50% 以上的平台在协议中约定 AI 生成物的财产权归属于用户。但平台同时会要求用户授权,允许平台将用户的输入(Input)和输出(Output)拿回后端进行大模型训练。李律师认为,这种平台抓回数据的操作在法理上并不是一种标准的著作权权利授权。
话题随即深入到 AI 训练阶段的侵权争议。李律师分享了她于 2023 年前往旧金山参加技术会议的见闻,当时台上包括 OpenAI 的副总法律顾问(Deputy General Counsel)和微软的法总。这些科技巨头明确表示,隐私并不是 AI 最大的隐患,著作权侵权、内容安全和反诈才是。当时 OpenAI 与微软的法总提出了两个核心抗辩点:第一,美国著作权法中存在非常黄金的“合理使用”(Fair Use)铁律(这与中国法有很大不同),不限是否商用;第二,AI 是通过 API 结构去“学习”(Learn)语料,而非机械地“复制”后再产出。
- **AI 平台用户协议调研数据**:50% 以上的用户协议约定 AI 生成物的财产权归属于用户,但同时要求用户反向授权输入输出数据用于模型训练。 - **美国大模型公司的两大抗辩核心**: * **合理使用**:主张训练阶段对语料的利用属于美国著作权法下的合理使用。 * **非复制性学习**:强调大模型是通过 API 结构进行数据深度学习,而非数据复制。
---
[15:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=900s) “海淀学区房”式的 AI 三要素与国内首案
为了生动解释 AI 的运行逻辑,李律师将训练 AI 巧妙地比喻为“养孩子”。她将 AI 的三大核心要素进行了如下拆解: 1. **算力(硬件、GPU、CPU 设备)**:好比是家长为了孩子疯狂在海淀区、西城区购买的“学区房”,是提供支持的基础硬件资源。 2. **算法(如 Transformer 架构、监督学习、研发人员的调优调教)**:好比是“父母的学历和智商”,决定了平时如何教养孩子以及传授给孩子什么样的学习方法论。 3. **数据(喂给模型的语料)**:好比是“每天给孩子喂的饭和补充的营养”,直接决定了其能否健康茁壮地成长。
针对市面上“因为中文语料不足,有人将 AI 批量生成的内容再喂给 AI 重新吃回去”的传闻,李律师认为,这类似于家长给孩子批改作文、做错题本后让孩子反盘复盘,理论上是一个利用反馈进行纠偏的过程。
谈到完美的 AI,李律师认为它应当像一个饱读中外名著的人,可以写出类似《红楼梦》风格的作品,但绝不构成表达和情节上的实质性近似。然而,现实离完美还差得极远。在美国,针对 AI 的集体诉讼(Class Action)已经出现了十几到二十几个。李律师提到,全美第一起关于 AI 的集体诉讼非常有趣,是由一群程序员委托律所起诉微软、OpenAI 和 GitHub(因其被微软投资控制),指控其侵犯著作权并违反开发者协议。该案起诉后,伯克利(UC Berkeley)举办了一场论坛,全美著作权法泰斗、70 多岁的帕米拉·萨米尔森(Pamela Samuelson)教授在会上与原告律师展开了激烈辩论。萨米尔森教授明确支持:大模型的训练阶段(Training Process)应当适用“合理使用”以保障技术发展;而到了输出阶段(Output),则应回归现有的著作权法,通过判定是否构成“实质性相似”来衡量是否侵权。
相比之下,国内虽然也出现了诸如“奥特曼 AI 案”等若干第一案,但李律师坦言自己并没有过度关注国内的这几个判例。其核心原因在于中国并非判例法国家,目前的司法裁判在天平两端尚未解决根本问题——既无法让训练数据的合理使用完全合理化,也无法在保护个体权利人与支持平台方研发之间找到完美的制度平衡。
- **AI 训练的“养孩子”比喻**: * 算力 = 海淀/西城学区房(硬件资源、GPU) * 算法 = 父母的学历和智商(Transformer 架构、调优方法论) * 数据 = 每天吃的饭(喂养的语料营养) - **中美司法现状对比**:美国已有 10-20 起 AI 相关的集体诉讼(Class Action),知产界倾向于“训练阶段看合理使用,输出阶段看实质性相似”;中国目前通过司法解释或行政法规推进,但因非判例法国家,具体的规则细化仍有待探索。
---
[20:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=1200s) 探访 OpenAI 总部与全球数据跨境监管风向
对于普通用户担心“生成胡白造的作品或模仿名家风格是否会被告”的顾虑,李律师直言,在国内由于“维权成本高、得到的收益低”,且缺乏极高额度的惩罚性赔偿,目前的普遍现状确实是“等别人告了再说”。
随后,李律师分享了她在 2023 年亲身拜访旧金山 OpenAI 总部的趣事。她当时在会议后“追着”OpenAI 的副总法律顾问争取到了拜访机会。在她的描述中,OpenAI 总部的办公环境与国内的科技公司或他们所在的虎头律所非常相似:开放式的大桌子、白墙、升降桌、大屏幕,员工们一排排坐着敲电脑。在与对方交流中,OpenAI 方面对著作权抗辩信心十足,同时透露了隐私合规的边界——在加利福尼亚州隐私法下,“公开的个人信息”(Publicly Available Information)不构成法律定义下的个人隐私,因此大模型可以合法抓取。李律师透露了一个惊人的数字:在 2022 年左右,全球网络抓取(Scraping)的流量已经占到了整个互联网流量的一半左右,其背后核心的驱动力正是大模型的训练需求。
在谈到全球隐私与数据法的演进时,主持人提到了起源于欧洲、于 2016 年出台并经历一年半宽限期后在 2018 年正式生效的 GDPR(General Data Protection Regulation,通用数据保护条例)。虽然该条例因过于严苛而被部分业内人士诟病为“制约了欧洲 AI 的发展”,但李律师指出,在 2025 年刚结束的巴黎 AI 峰会上,欧洲的监管风向已经发生了重大转变。面对欧洲本土缺乏大科技公司的尴尬现实,以及极度担心在 AI 浪潮中落后于中美两国的焦虑,法国、德国、意大利以及韩国、越南、印尼、沙特、南非等国家和地区,纷纷达成了“先发展、后治理”的共识。
李律师还提及了前谷歌 CEO 埃里克·施密特(Eric Schmidt)去年下半年在斯坦福工程学院进行的一场小型闭门分享。该视频被意外上传到 YouTube,施密特在其中断言:在 AI 浪潮中,由于美国拥有英伟达芯片等绝对的算力优势,加之全球顶尖人才齐聚美国的算法优势,以及英文语料的丰富度,美国将领先中国大概十年。然而,DeepSeek 的横空出世迅速打破了这一断言,这也印证了施密特自己的另一句话——“AI 迭代太快,技术可能每三个月到半年就会迎来颠覆性的颠覆,人类根本无法做出准确的长期预判。”
- **OpenAI 总部见闻**:办公布局与国内主流科技公司(如升降桌、大屏)高度一致;法律团队主张公开的个人信息不受加州隐私法保护。 - **关键数据**:2022 年,以大模型训练为主的网络数据抓取(Scraping)流量已占到全球互联网总流量的 50%。 - **GDPR 历史节点**:欧洲通用数据保护条例于 2016 年出台,2018 年正式生效(含 1.5 年 Grace Period)。 - **全球监管共识**:2025 年巴黎 AI 峰会后,法、德、意及中东、东南亚等地区向“先发展、后治理”倾斜,唯恐落后于中美。
---
[25:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=1500s) 音色克隆内幕、“技术无罪”与出海法律平替
主持人分享了自己最近使用软件克隆自身声音给自己讲书的“奇葩癖好”,并表达了对不法分子利用克隆声音(如模仿其声音向其父母诈骗)的深深担忧。李律师随即揭秘了行业内所谓的“音色克隆”技术内幕:真正的克隆需要提取人体的“声纹信息”并进行精密复制;而目前市面上绝大多数平台提供的“音色克隆”,本质上只是把用户录制的一段音频去掉杂音、背景音,并根据音质进行稍微调粗或调圆滑的微调,并未真正提取声纹。
她进一步解释,只有像高德地图使用林志玲、郭德纲等名人的声音时,才需要严格的声纹或音色授权。对于合规平台而言,后端会采取极其严格的技术隔离手段防止数据泄露。面对无法禁绝的技术滥用,李律师坚定地站在“技术是无罪的,人是有罪的”这一立场上。她极力反对通过限制前端技术研发来管控风险,而是主张“抓重点”,在“内容安全”和“反诈”两端下大力度,对利用技术犯罪的人实施刑事重判。同时,她建议在技术售卖的供应链条上加强防范,强制模型和软件在输出端嵌入可追踪的明水印或暗水印(类似于设备的唯一识别符),以便在发生风险时能够精准追责。她还提到了 2020 年曾爆火仅几天便因深度伪造(Deepfake)风险被监管火速下架的换脸软件“ZAO”。
最后,话题转回李律师核心的跨境数据出海业务。她指出,虽然这两年大环境收缩导致企业合规预算整体下降,但中国企业“出海”的刚需依然强劲。早期的出海是建设工程等“重工业出海”,企业核心关注的是本地劳工、税务及文化习惯;随后迎来了以新加坡或香港为架构的“APP 互联网出海”,数据多存储于新加坡等海外数据中心。如今的数据合规痛点在于:虽然出海企业的服务器在海外,但其研发团队通常留在中国国内。这就涉及到了两层合规动作:第一,本地用户(如沙特用户)的数据如何合规传向新加坡服务器;第二,中国境内的研发人员如何远程跨国访问新加坡服务器进行解 Bug 和技术支持。
李律师直言,在疫情前预算充足时,中国律师往往扮演“二道贩子(发包商)”的角色,帮客户去对接极为昂贵的国际大所或中东本地律所(例如沙特本地合伙人的计费高达 900 多美金一小时)。而现在面对预算缩水,李律师为客户开发了一套极具性价比的“平替方案”:由中国律师基于丰富的出海经验,先为客户撰写一份完成度 50% 以上的基础合规 Memo,解决核心的大概率风险(如针对中东游戏市场,调研开箱子、抽卡等“概率玩法”是否会因涉及现金提现而触犯当地严格的赌博罪);随后,将无法确定的极少数细节和监管敏感点列出清单,发给本地律所。李律师自豪地表示,这套方案能将原本需要 50 万人民币的本地律所项目预算,硬生生砍到 15 万人民币。更绝的是,为了省钱,她有时会自己做好全部的背景调研与法理推导,直接发信给外国律师并要求:“你只要给我回答 Yes or No 就可以了。”主持人听闻不禁开玩笑惊呼:“你怎么能做这样的事情!你还要不要有别的国家的同行朋友了?你这属于严重破坏市场规则啊!”
- **音色克隆与声纹的区别**:市面常规 AI 工具仅为录音去噪与音质微调(音色克隆),并未提取具备唯一性的声纹信息。 - **出海两步走合规模型**: 1. 境外用户数据向境外核心服务器传输的合规。 2. 中国境内研发团队跨国远程访问境外服务器数据的合规。 - **商务策略与预算对比**:通过中国律师先行梳理加本地律师“Yes or No”确认的方式,可将沙特等高价地区的合规预算从 50 万元降低至 15 万元。 - **名言引用**:“技术是无罪的,人是有罪的。”
## Notable quotes > [00:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=0s) 大家其实是高估了 AI 短期的效果,低估了它的长期收益。 — 李绕娟
> [00:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=0s) 你用了这个东西,你要承担这个东西后面带来的所有的后果,好的和坏的。 — 李绕娟
> [25:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=1500s) 技术是无罪的,人是有罪的。 — 李绕娟
> [00:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=0s) 我觉得我死之前应该不会。 — 李绕娟
> [25:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=1500s) 你只要给我回答 Yes or No 就可以了。 — 李绕娟
> [25:00](https://www.bilibili.com/video/BV15HdHYeEr3?t=1500s) 你怎么能做这样的事情!你还要不要有别的国家的同行朋友了?你这属于严重破坏市场规则啊! — 刘玉轩
## Mentioned 刘玉轩, 大宣哥, 李绕娟, 娟姐, 加州大学伯克利分校, UC Berkeley, 西安交通大学知识产权研究中心, 北京市金杜律师事务所, 德国泰勒信律师事务所, 普华永道, 阿里影业, TikTok, 抖音集团, DeepSeek, 豆包, Kimi, ChatGPT, Character AI, MiniMax, 星野, 王迁, 华东政法大学, OpenAI, 微软, GitHub, 帕米拉·萨米尔森, Pamela Samuelson, 埃里克·施密特, Eric Schmidt, 斯坦福工程学院, YouTube, 高德地图, 林志玲, 郭德纲, ZAO
## 弹幕氛围 (Danmaku mood) — 126 条 本期视频的观众情绪呈现出较为明显的两极分化。前半段由于内容涉及高密度的专业知识产权和法律条文,且嘉宾表达方式被部分观众认为主线不清、逻辑有些混乱,引发了较多的吐槽与质疑;但随着讨论深入,中后段涉及技术实务、案例和职业拓展时,许多观众逐渐认可了内容的深度与价值,整体氛围由最初的浮躁、批判转向后期的理性探讨与赞赏。
**整体情绪**:😊 正面 35% · 😐 中性 25% · 😞 负面 40%
**热议点** - **吐槽嘉宾表达逻辑与专业深度不足** —— “不知道嘉宾想表达什么 逻辑很混乱” - **调侃老王(王一快)被踢出法律圈/跨界AI** —— “王一块不是法律圈了,可能是ai圈里最懂法律的吧” - **关于知识产权、确权及著作权法专业概念的理性探讨与反思** —— “感觉逻辑上值得再探讨:有没有权利和归属于谁本来就是一个问题的两个方面,并不是单独平行的问题。” - **指出嘉宾举的AI例子过时、车轱辘话以及“没祛魅”** —— “同意前面 举的2年前例子 llm已经天翻地覆的变化了” - **对视频中后期硬核、深度法律内容的正面认可与赞赏** —— “前两期有点大咖唠嗑,这期内容比较干才有意思” - **关注嘉宾的穿搭、口红色号等花絮细节** —— “想知道李律师的口红色号” - **肯定主持人大暄哥掌控节奏和拉回重点的能力** —— “大暄哥一直往回拉节奏和重点”
**代表弹幕** > 老王现在不算“法律圈”,只能叫前律师了
> 姐姐老想表示自己见多识广 结果观点输出好混乱
> 前两期类似于行业科普,但这一期到目前为止都在讨论substantive legal issue,当然讲的更慢
> 总是一下子就进入各种专业细节,表示自己很专业?真正的专业是深入浅出吧
> 主动提了典型案例却又说没关注这个案子……
> 姐是用的免费版的吗
> 科技律师,不给自己设限,太赞啦
> 质量高
[Source](https://www.bilibili.com/video/BV15HdHYeEr3)