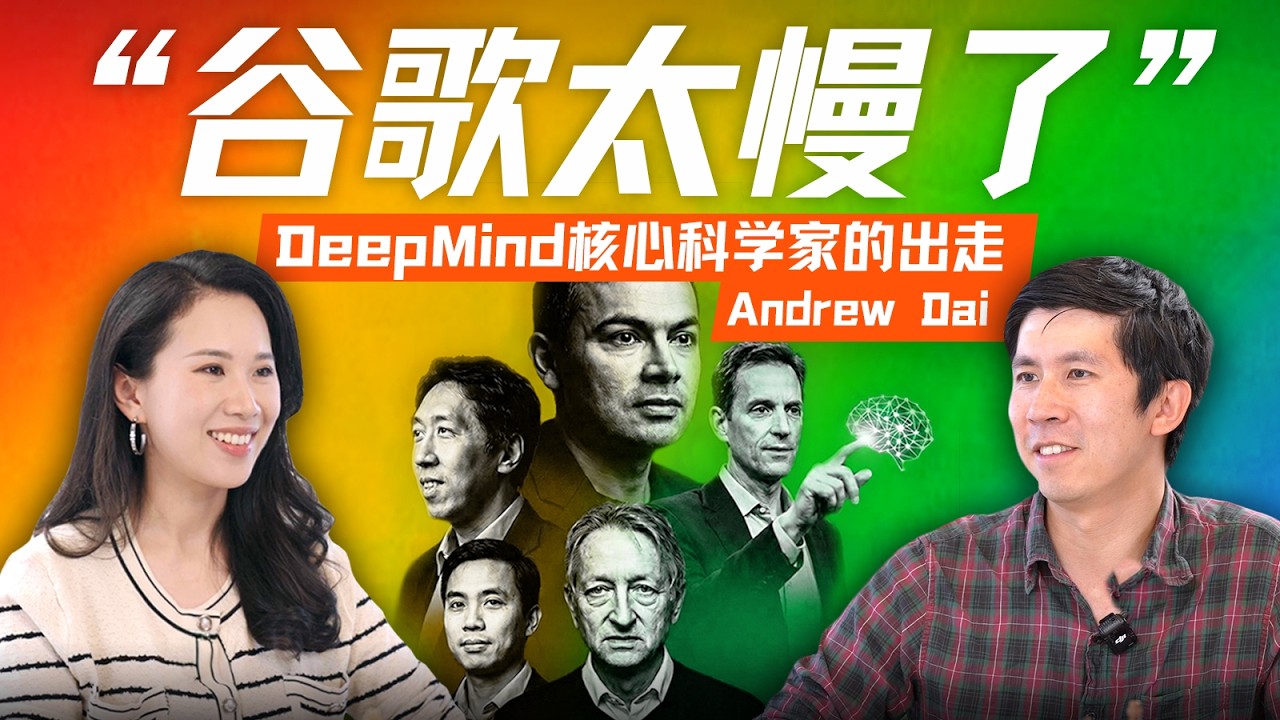
前谷歌DeepMind研究总监戴安度获杰夫迪恩投资创办Elorian AI
硅谷101
戴安度认为纯语言模型无法实现通用人工智能,而科技巨头因过度规避风险正错失多模态视觉推理的技术创新窗口。
AI-assisted summary of 谷歌AI的14年、Gemini翻身之战,与视觉理解模型:专访DeepMind前核心科学家Andrew Dai|Neolabs特辑 — original source. Check the original for full context.
Source published:
Detailed notes
## Background 该视频播客由YouTube频道“硅谷101”于2026年5月19日发布。视频简介指出,这是其Neolabs特辑的第一期,通过专访前谷歌DeepMind研究总监Andrew Dai,回顾了谷歌过去14年的AI发展史,并探讨了他创立的新公司Elorian AI在语言与视觉推理结合路线上的探索。
## TL;DR 在专访中,Andrew 详细透露了谷歌在大模型发展中的内幕,包括早期错过的预训练机遇、被雪藏的MoE架构,以及Brain与DeepMind强行合并带来的严重内耗与技术妥协。随着Gemini 2.0靠数据清洗打赢翻身仗、传奇天才Noam Shazeer回归,谷歌虽重回巅峰,但体制的规避风险促使Andrew离职创业。他创立了Elorian AI,拒绝纯语言模型和纯视觉世界模型的极端路线,致力于通过“多模态视觉推理”开辟通往AGI的新路径。
## Atmosphere & style 整个访谈透露出一种深度、理智且充满行业洞察的氛围,既有对巨头组织博弈、错失良机的犀利坦诚与遗憾,又有科学家对技术信仰的纯粹与热爱。Andrew 用生动形象的比喻(如“老鹰抓兔子”)化解了枯燥的技术概念,与主持人的互动流畅且信息量极准。视频的后半段通过办公室探访,展现了硅谷顶尖极客特有的轻松、务实与浪漫主义色彩,让观众能切身感受到Neolab创业浪潮中所涌动的自由、激情与紧迫感。
## Key takeaways - [00:00](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=0s) Andrew Dai 认为光靠纯语言模型无法实现 AGI,语言与视觉结合的“多模态视觉推理”才是未来关键路径。 - [06:51](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=411s) Google Brain 与 DeepMind 早期有着截然不同的组织哲学,前者侧重实用主义与产品落地,后者更像独立的科学实验室。 - [09:34](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=574s) 2015年发表的《半监督序列学习》论文开创了语言模型预训练与微调范式,但受限于当时的算力未能在谷歌内部推向极大规模。 - [15:54](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=954s) 将 AI 运用于医疗领域的尝试受阻于行业传统文化壁垒、医生信任度以及过长且复杂的去往市场(Go-to-market)链条。 - [16:41](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1001s) 《MaskGAN》是首批将强化学习(RL)引入预训练的探索之一,为后来的模型对齐(Alignment)和 RLHF 奠定了前身范式。 - [18:05](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1085s) 稀疏门控 MoE 架构早在 2021 年就已被 GLaM 模型验证超越 GPT-3,但因谷歌求稳而被冷藏,直到 Gemini 1.5 才被重新启用。 - [22:27](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1347s) FLAN 证明了通过指令微调(Instruction-Finetuning)和思维链能摆脱少样本提示,但同时也带来了模型不懂装懂的副作用。 - [25:55](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1555s) ChatGPT 爆发后谷歌合并 Google Brain 和 DeepMind,早期实行的“双负责人制”引发了严重的内耗和人才流失。 - [31:12](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1872s) 在前沿大模型架构和算力同质化的当下,模型间最大的分歧点和核心壁垒在于对高质量预训练数据的选择与处理。 - [35:12](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=2112s) 由于大厂求稳限制激进创新,寻求更多研究自由与速度的顶尖科学家纷纷选择离职创立独立的前沿实验室(Neolabs)。 - [37:51](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=2271s) Elorian AI 采取语言+视觉的中间派路线,主攻能够理解物理客观世界并进行逻辑推演的“视觉推理专业模型”。 - [01:00:00](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=3600s) 在 AI 辅助编程极大降低代码执行门槛的时代,“人类最宝贵的创意(Ideas)”价值暴涨,成为科学研究的核心资产。
## Detailed walkthrough ### [00:00](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=0s) 专访 Andrew Dai:一位谷歌 AI 核心科学家的 14 年
主持人开场介绍了本次专访的重磅嘉宾 —— 曾在谷歌从事 AI 研究长达 14 年的 Andrew Dai(戴安度)。Andrew 长期处于谷歌 AI 研发的中枢,他早期的 sequence learning(序列学习)论文直接启发了 OpenAI GPT 的诞生;在此之后,他辗转于多个核心项目与产品,从文本生成、对抗训练,到后来的 PaLM、Flan、Gemini、多模态以及长上下文等,几乎见证并推动了谷歌 AI 大模型发展的全过程。与他并肩作战、联合发表论文的皆是谷歌队史上的传奇人物,如 Quoc Le、Ian Goodfellow、Liam Fedus 以及 Jeff Dean 等。主持人心感赞叹地指出,Andrew 的职业轨迹本身就是一部活生生的谷歌 AI 编年史。
在这一节的快节奏剪辑与回顾中,访谈抛出了几个直击行业痛点的核心问题:为什么谷歌一度在大模型赛道上被 OpenAI“吊打”?谷歌又是如何通过强行合并 Google Brain 和 DeepMind,依靠 Gemini 绝地反击重回巅峰的?面对这些疑问,Andrew 透露了诸多不为人知的内幕。例如,他曾在 GPT 诞生前向 Transformer 的作者之一 Shazeer(Noam Shazeer)提议尝试预训练,可惜对方当时因忙于图像处理而作罢,最终这一灵感被 OpenAI 的 Alec Radford 捕捉并放大。针对备受瞩目的 MoE(混合专家)架构,Andrew 犀利地指出,这实际上是他在 2021 年就已着手研发的技术,却被谷歌冷藏,直到 Gemini 1.5 才迫于竞争压力推向前端。而 OpenAI 之所以能迅速用上 MoE,也是因为当时参与 Andrew 团队的实习生 Liam Fedus 被跳槽挖到了 OpenAI。Andrew 坦言:“硅谷其实是没有什么秘密可言的,特别是在大模型领域。”
伴随着 Gemini 3.0 的顺利上线,Andrew 决定离开效力了近 14 年的谷歌。促使他离职的核心原因是为了追求“更多的研究自由与更快的速度”。他看到了大公司由于求稳而不敢走、或发展太慢的路线。Andrew 坚信,光靠大语言模型(LLM)无法将人类带向 AGI(通用人工智能),但他同样不信仰纯粹的计算机视觉世界模型,而是选择成为“中间派系”,聚焦于语言与视觉结合的“多模态视觉推理模型”。2026 年 4 月,他创立的新公司 Elorian AI 宣布完成 5500 万美元的融资,估值达 3 亿美元,投资方阵容豪华,包括 Mellon Ventures、Ultimator Capital 等主流基金,英伟达以及以个人身份参投的谷歌传奇 Jeff Dean。
- **核心观点**:光靠大语言模型无法达到 AGI,视觉与语言的结合(多模态视觉推理)才是未来的关键路径。 - **团队历史**:Andrew 曾带领团队在 2021 年研发出基于 MoE 的 GShard/GLaM 模型,比 GPT-3 效果更好,但未能被谷歌及时推向产品。 - **背景彩蛋**:Andrew 五岁随父母移居英国,剑桥本科、爱丁堡博士毕业,虽然英文是其第一语言,但本期节目他坚持使用中文接受采访。
---
[05:35](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=335s) 从伦敦到硅谷:Google Now 与个性化分发
访谈切入到 Andrew 的早期职场经历。14 年前(即 2012 年),怀揣着对人工智能的极大热情,Andrew 从英国来到硅谷加入谷歌。他回忆道,自己从中学时代起就立志投身 AI 领域,当时 Google Brain 在学术界声名鹊起,而 DeepMind 在伦敦还只是一个非常年轻、名不见经传的初创公司(Startup)。为了进入全球人工智能的研究中心,他毅然选择了硅谷。尽管事后看来,如果他留在伦敦大概率也会加入 DeepMind 并最终随收购进入谷歌,但硅谷独特的创业文化(Entrepreneurship)和源源不断的新公司生态,是他当时最为向往的。
加入谷歌后,Andrew 的第一份工作是在 Google Now 团队(2012-2014年)。那是时任 CEO Larry Page 极为看重的一个战略级项目,旨在结合 Android 系统与社交数据,主动为用户精准推送个性化信息。虽然团队招募 Andrew 是看中他爱丁堡大学 AI 博士的背景,但当他真正进入团队后,才发现当时的技术面临巨大的工程底座(Infrastructure)挑战。为了实现实时个性化新闻分发,Andrew 亲自动手编写了一套系统,确保新资讯产生后能在四五分钟内推送到所有用户的手机上。
在优化系统性能的过程中,发生过一段令 Andrew 记忆犹新的技术趣事。当时团队发现某项新闻数据的分发延迟高达 100 毫秒,所有人都在苦思冥想为什么这么慢。Andrew 仔细排查了数据链路后赫然发现,数据的存储服务器位于美国东海岸,而用户和处理中心在西海岸。他笑着说,自己当时意识到:“根据光速(Speed of light)在光纤中的传播速度计算,跨越这个物理距离本身就需要这么多时间,你不可能超越物理极限走得更快。”这段经历让他深刻体会到了端到端工程(End-to-End Engineering)和底层架构的重要性。在项目的后期,他逐步向 AI 和个性化算法靠拢,并最终顺理成章地转入了 Google Brain 团队。
---
[06:51](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=411s) 两次收购、两种哲学:Hinton 带来深度学习,DeepMind 选择独立
在 2013 至 2014 年间,谷歌在 AI 领域完成了两桩具有里程碑意义的收购,彻底重塑了公司的技术基因。第一桩是 2013 年收购了深度学习教父 Geoffrey Hinton 的公司 DNN Research。Hinton 的加入在谷歌内部引发了震动,高层开始将 AI 提升到空前的战略高度。Andrew 回忆道,那几年 CEO 明确对外宣告“谷歌是一家 AI 公司”,这不仅继承了 Larry Page 和 Sergey Brin 最初创造 PageRank 算法时“让机器读懂网络”的宏大愿景,更标志着谷歌全面步入深度学习时代。公司上下意识到,如果不全力押注这个方向就会被时代抛弃,自此之后,谷歌的产品线开始大量用神经网络模型替代传统算法。
紧接着在 2014 年,谷歌顶着重重压力收购了由 Demis Hassabis 领衔的 DeepMind。然而,DeepMind 与 DNN Research 的融入方式截然不同。DeepMind 在被收购时签署了非常严格的独立性协议(Subscription/Condition):他们保持完全独立的运作,团队全员留在伦敦,无需搬迁至美国,招聘、财务乃至内部代码库都与谷歌总部相互隔离。
这种制度安排导致了 Google Brain 与 DeepMind 在组织哲学上的巨大分歧。Andrew 分析道,Google Brain 的目标非常务实,即通过前沿研究并最终与谷歌的产品线深度整合,将模型落地;而 DeepMind 更像是一个纯粹的独立科学实验室,创始人 Demis 拥有绝对的自主权,“只要他觉得重要,什么项目都可以做”,大名鼎鼎的 AlphaGo 正是在这种极具自由度的土壤中诞生的。这种“谁都不服谁”的独立运作模式,虽然在早期碰撞出了不同的科学火花,但也为多年后两家团队强行合并时的巨大组织摩擦埋下了伏笔。在当时,由于大公司特有的权属划分(Credit Assignment)和项目所有权(Ownership)争夺,两大团队之间的实际官方合作屈指可数。
---
[09:34](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=574s) 半监督序列学习:谷歌错过的“GPT时刻”
2015 年,已经进入 Google Brain 的 Andrew 开始专注于语言模型预训练(Language Model Pre-training)与微调(Fine-tuning)的研究。当时,整个 AI 界在自然语言处理(NLP)上普遍使用的是 Word2Vec、Paragraph Vectors 等文本嵌入技术。Andrew 与 Google Brain 联合创始人 Quoc Le 试图在这个方向上寻找突破。他透露,著名的论文《Semi-Supervised Sequence Learning》(半监督序列学习)的诞生完全是一场美丽的意外(Not planned)。
“我当时做了无数个实验,全都是失败的。”Andrew 充满画面感地描述道。直到有一天,他跑出了一个极其惊艳、远超当时所有主流模型基准线的分数。然而,当他试图去复现(Reproduce)这个结果时,却发现怎么也跑不出来了。他意识到代码中一定藏着某个不为人知的 Bug。经过长达数周的“掘地三尺”,他终于发现了秘密:原来在跑出高分的那个实验中,模型由于配置错误,无意中读取了另一个正在训练“语言模型(Language Model)”的 Checkpoint(检查点)数据,并在其基础上进行了微调。那一刻,他与 Quoc Le 成了世界上最早洞察这一范式的人:先在无标注的大规模文本上做语言模型预训练,再到下游有监督数据上做微调,能够产生极强的语言理解能力。
这篇论文在当时的 NeurIPS 大会上发表后引发了轰动,连 LSTM 的发明者 Sepp Hochreiter 都亲自跑到他们的海报(Poster)前称赞这个方法的精妙。遗憾的是,受限于 2015 年极度匮乏的 GPU 算力,团队没能立刻在尺度(Scale)上继续往上推。2017 年 Transformer 架构横空出世,Andrew 敏锐地意识到这是天作之合,他在论文发布第二天就找到作者之一的 Noam Shazeer,兴奋地建议:“我们要不要在 Transformer 上试一试预训练?”可惜 Noam 当时正全力投入在图像处理的赛道上,无暇顾及。最终,这一灵感锁钥被 OpenAI 的 Alec Radford 拾起,并借助庞大的算力演进成了后来的 GPT-1、GPT-2 和 GPT-3。谷歌直到 GPT-3 迎来全球性的“惊艳时刻”(Turning Moment)时,高层才如梦初醒,意识到自己错过了亲手开启的预训练大模型时代。
---
[15:54](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=954s) 谷歌健康:跨界医疗 AI 失败的教训与科研阵地的转移
2017年前后,正当大语言模型的研究处于爆发前夜,谷歌内部的战略重心却发生了转移。当时,医疗健康(Google Health)成为硅谷各大科技巨头(包括苹果、微软、谷歌)疯狂竞逐的超级蓝海。公司高层给 Andrew 提供了两个选择:要么继续留在 Google Brain 做基础研究,要么加入新成立的 Google Health 部门开拓医疗 AI。出于对技术应用落地的向往,Andrew 选择了后者。
在医疗健康部门期间,Andrew 负责利用患者的医疗记录(Medical Records)去预测未来的疾病走向或用药需求,试图帮医院节省开支并辅助医生决策。尽管他尝试将引以为傲的预训练方法迁移到医疗数据上,但由于当时的算力与模型参数量过小,预训练并未在医疗领域取得预期的突破。不过,那段时期他作为导师,带领了著名的 Google Brain Residency Program(谷歌大脑驻留计划),培养了一大批极其优秀的实习生。这其中就包括后来在 AI 领域大放异彩的 Liam Fedus、Barret Zoph 和 David Haar 等人,他们之中的许多人在结束驻留后纷纷踏上了创业或加入前沿实验室的道路。
回顾这段跨界,Andrew 总结了科技巨头做医疗 AI 难以逾越的文化壁垒。医疗是一个极度依赖传统和临床直觉(Intuition)的行业,拥有数百年传承的医生群体对冰冷的 AI 算法天然抱有审慎和排斥态度,他们会不断质疑:“我行医几十年,为什么要听一个 AI 的?”此外,科技巨头庞大的体量往往让医院和医生感到利益受损和职业威胁(Feel threatened),相比之下,医疗行业的 Go-to-market(去往市场)链条漫长而复杂,技术在当时也远未达到如今 ChatGPT 般让所有人不得不服的临界点。Andrew 感叹:“在错误的时间做正确的技术,往往很难成功,这对我后来的创业是一次极为深刻的教训。”
---
[16:41](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1001s) MaskGAN 与强化学习引入预训练的早期探索
2018 年,即加入 Google Health 部门一年后,Andrew 与对抗网络(GAN)之父 Ian Goodfellow 以及 Liam Fedus 等顶尖学者合作发表了重量级论文《MaskGAN》。这篇论文的核心在于通过引入“填空任务(Infilling Task)”来显著改善文本生成的连贯性与质量。这一探索在底层逻辑上,对后来诸如 BERT 的掩码语言模型以及如今 Gemini 的多模态预训练技术,都产生了深远的启发。
更重要的是,Andrew 指出《MaskGAN》是整个行业内首批将强化学习(RL, Reinforcement Learning)引入语言模型预训练之后的团队。在当时,大部分研究者还局限于纯粹的自回归预训练,而 Andrew 团队已经意识到:“光靠预训练是不够的,模型无法自发学会如何修改写错的字,也无法敏锐感知生成文本的优劣。”通过引入强化学习的 Reward 机制,模型开始具备了审视并修正自身文本生成质量的能力,这成为了今天大模型对齐(Alignment)和 RLHF 技术极其核心的前身范式。
---
[18:05](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1085s) MoE 架构:2021 年研发,被谷歌“雪藏”至 Gemini 1.5
2021 年,伴随着 OpenAI GPT-3 的巨大成功,谷歌内部感受到了前所未有的压力。Andrew 的前医疗部门主管 Claire 重新回到 Google Brain 主持大局,并极力挽留想要离职的 Andrew。她坦言,谷歌当时正在推进的大模型在效果上始终无法匹敌 GPT-3,希望 Andrew 能够回归并主导解决这个问题。Andrew 诊断后发现核心症结在数据处理上。在清洗完数据并全力投入研发后,他联合主导了谷歌划时代的 MoE(混合专家)大模型 —— GLaM 的开发。
在那个时期,大模型的商业化落地遭遇了极为严峻的算力成本(Serving Cost)瓶颈。如果通过 API 部署一个数百亿乃至数千亿参数的稠密模型(Dense Model),每一次推理都要激活全部参数,成本高昂得令人窒息。Andrew 团队敏锐地捕捉到了稀疏门控 MoE 的技术路径:将模型拆解为多个专家网络,每次前向传播时仅激活其中一小部分(例如 Top-2),从而在保证超大参数容量的同时,大幅降低实际计算量。最终,GLaM 成功在多项基准测试上超越了 GPT-3。
然而,令人扼腕的是,这一在 2021 年就已经被验证极其成功的架构,却在谷歌内部遭遇了冷藏。由于谷歌当时庞大的业务体量与求稳心态,高层不愿在生产环境中贸然采用需要复杂优化与微调(Optimization & Tuning)的稀疏架构,导致这一技术未能第一时间在业务中铺开。直到 2023 年底 GPT-4 被爆出采用 MoE 架构,以及后来 DeepSeek V3 将该词汇推向大众视野后,谷歌才急忙在 Gemini 1.5 中重新启用。Andrew 透露,OpenAI 之所以能如此迅速且坚定地走通 MoE,很大程度上是因为他当年的组员、GLaM 的共同作者 Liam Fedus 跳槽去了 OpenAI 并全盘推进了该架构,“大公司之间根本没有秘密,人才的流动决定了技术的底牌。”
---
[22:11](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1331s) PaLM 2 与 FLAN:顺畅的预训练与 ChatGPT 的对话前夜
进入 2022 年至 2023 年初,Andrew 迎来了他在谷歌的一段研发高光期 —— 主导了 PaLM 2 模型的预训练工作。作为谷歌抗衡 OpenAI 的核心重器,PaLM 2 的整个预训练过程展现出了极其惊人的工程稳定性。Andrew 自豪地回忆道:“PALM 2 是我见过的最顺滑的大模型预训练,从头到尾没有发生过一次中断(No rewinds/reboots)。”相比之下,当时 Meta 开源的 OPT 模型在训练日志中记录了无数次的崩溃、重启与策略修正。PaLM 2 团队吸取了之前 GLaM 和 PaLM 1 的工程教训,在架构设计(Architecture)和千卡集群调度上做了极为扎实的微小测试(Pilot runs),使得项目从立项到模型完全跑完,耗时不到一年。
与此同时,Andrew 在 2022 年还联合主导发表了另一篇对如今 ChatBot(聊天机器人)产生决定性影响的论文 ——《FLAN (Scaling Instruction-Finetuned Language Models)》。在 FLAN 问世之前,整个行业普遍依赖少样本提示(Few-Shot/Context Prompting),即用户如果想让大模型解答一个数学题,必须先在 Prompt 里生硬地塞入两三个“问题-答案”的示例,模型才能照葫芦画瓢地给出反应。
FLAN 的核心贡献在于,它证明了通过在微调阶段引入海量且多样化的“指令数据集(Instruction Data)”以及思维链(CoT, Chain of Thought),可以让大模型彻底摆脱对 Few-shot 示例的依赖。模型由此获得了一种“直面指令”的泛化能力:用户输入什么指令,它就能直接输出对应的正解。Andrew 幽默地指出,这种指令微调虽然带来了如今 ChatGPT 这种极度自然的对话体验,但它也有一个著名的副作用 —— 模型学会了“不懂装懂”和瞎编(Hallucination),因为它的底层潜意识被训练成了“必须给出完美的应答”。
尽管 PaLM 2 和 FLAN 表现卓越,但在发布节奏上,谷歌再次被大公司特有的官僚主义(Bureaucracy)拖了后腿。PaLM 2 早在 2023 年初就已经全部训练完毕,但管理层坚持要遵循既定流程,将其捂到 5 月份的 Google I/O 大会上统一作为压轴大戏发布。OpenAI 敏锐地捕捉到了风声,在谷歌 I/O 召开前夕精准卡点发布了震惊世界的 GPT-4。虽然 PaLM 2 帮助谷歌稳住了 Bard(后改名为 Gemini)聊天机器人的产品底座,避免了彻底掉队,但风头依然被 OpenAI 悉数抢走。Andrew 掩饰不住遗憾地表示:“如果能早一点发表,我们就能理直气壮地向世界宣告,我们才是全球最好的模型。”
---
[25:55](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1555s) 拉响红色警报:DeepMind 与 Google Brain 的被迫整合与碰撞
2022 年底 ChatGPT 的引爆让谷歌内部拉响了最高级别的“红色警报(Red Code)”。在巨大的生存危机面前,联合创始人 Sergey Brin 甚至亲自重回一线写代码。谷歌高层快刀斩乱麻,做出了一个在过去难以想象的决定:强行整合各自独立运行了近十年的 Google Brain 与 DeepMind,全力以赴迎战 OpenAI。
Andrew 详尽地描述了这场史诗级组织大合并背后的重重摩擦与张力。在官方正式合并之前,双方被塞进同一个联合项目组去开发第一代 Gemini,这被内部戏称为一次“大合并的预演(Preview)”。由于两家实验室在过去都建立了高度重合且互不服气的职能团队 —— Brain 有自己的底层工程(Infrastructure)团队、多模态团队和数据团队,DeepMind 同样也有一套一模一样的班底。Andrew 当时正是作为 Google Brain 数据团队的负责人(Lead)参与谈判。
为了平衡政治利益并做到表面上的公平,高层设计了一种极其复杂的“双负责人制(Co-Lead Setup)”:每一个核心业务部门,必须由 DeepMind 出一个人、Google Brain 出一个人共同担任 Lead。Andrew 坦言,这种为了照顾两边情绪的 Equal Setup 在实际运行中带来了灾难性的沟通成本。每天团队都要花费大量的精力和时间去争吵、划定势力范围,比如“哪一部分数据清洗工作归伦敦的 DeepMind 做,哪一部分归山景城(Mountain View)的 Brain 做”。这种严重的内耗极大地拖累了模型的研发进度,引发了阵阵换组潮,并直接导致大批受够了政治博弈的顶级研究员从两边纷纷离职。
---
[29:02](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1742s) Gemini 1.0 的仓促上线与 Gemini 2.0 的数据翻身仗
在如此混乱的摩擦与高压的 deadline 逼迫下,2023 年底,Gemini 1.0 终于在一种极其仓促(Rush)的氛围中被推向市场。Andrew 回忆道,当时高层死死卡住了一个圣诞节前的发布节点,而整个多模态大模型几乎是从零开始构建(Start from scratch)。因为时间极度紧张,为了确保模型能按时“吐出来”,团队不得不做出了巨大的技术妥协:彻底舍弃了需要大量时间进行系统优化与对齐的 MoE 创新架构,倒退回了最稳妥、最不容易出错的 Dense(稠密)模型结构。
这种赶工的后果显而易见。Gemini 1.0 上线后,其在少数非英语语种及复杂推理上的糟糕表现遭到了全球媒体的无情炮轰。痛定思痛的团队迅速进入了 Gemini 1.5 和 2.0 的密集迭代期。Andrew 指出,真正让谷歌打赢翻身仗、重新在 Benchmark(基准测试)上阶段性超越 OpenAI 的,正是 Gemini 2.0。
在 Gemini 2.0 的研发中,Andrew 联合主导了一场底层数据质量的革命。他一针见血地指出,在当前节点,各家 Frontier Lab(前沿实验室)的架构设计、算力规模和工程底座其实已经高度同质化,大模型之间最大的分歧点和真正的“独门秘籍(Secret Sauce)”在于**数据的选择与处理**。整个互联网公开的文本资源(Web Data)早已被各大巨头穷尽,接下来拼的是谁能把这锅大杂烩里的“垃圾信息(Spam)”和低质量内容剔除得最干净。Andrew 用了一个生动的比喻:“这就跟养育小孩一样,如果你每天只让他读垃圾广告,他再聪明也成不了大器,你必须精准喂养有真正知识与严密逻辑的内容。”谷歌凭借其在搜索引擎领域长达二十多年的网页爬取(Crawl)与质量分级经验,在这场数据清洗战中展现出了恐怖的底蕴,辅以高质量合成数据(Synthetic Data)的严密过滤,终于让 Gemini 2.0 焕然一新。
---
[35:12](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=2112s) Gemini 3.0 与 Noam Shazeer 的天才时刻:为什么选择离职?
到了 Gemini 2.5 和 3.0 的研发周期,谷歌迎来了一件震动硅谷的回归事件 —— 传奇天才 Noam Shazeer(Character.AI 创始人、Transformer 论文核心作者)通过一场巨额的“人才收购(Acqui-hire)”重新回到了谷歌,并直接介入了 Gemini 2.5 的调优工作。Andrew 在节目中由衷地赞叹 Noam 是一个不折不扣的“纯粹天才(Genius)”。
Andrew 分享了一个极具画面感的细节:有一次他与 Noam 激烈讨论关于 Transformer 架构的一项改进,Andrew 提议在某两个特定层之间增加一条残差连接(Connection)。Noam 听完后,甚至连电脑都没打开,完全没有跑任何模拟模型,仅仅在脑海里推演了一下,便斩截地否定道:“这不可行。因为这样调整后,反向传播的梯度(Gradient)会产生某种特定的偏移,从而无法实现预期的训练效果。”等到代码真正跑完,结果与 Noam 的肉眼预测完全一致。Andrew 赞叹,Noam 卓越的直觉和看一眼代码就能洞悉大模型内部运作机制(How it works)的能力,帮助谷歌在预训练中节省了天文数字般的算力资金与试错时间。
然而,尽管 Gemini 3.0 在数据层和算法上取得了极大的跑分突破,让谷歌的股价一路狂飙、风光无两,身处核心的 Andrew 却感受到了一种深深的窒息感。随着项目规模膨胀到数千人、消耗的算力卡达到几万甚至十几万张,谷歌这家巨头变得越来越倾向于规避风险(Risky)。任何可能对大模型底座产生剧烈颠覆、改变现有数据结构的激进创新(Aggressive Ideas)都会被管理层出于“稳定”的考虑而一刀切地否决。Andrew 意识到,在大厂繁琐而保守的体制下,自己已经无法再追求真正的研究自由(Research Freedom)与颠覆性的演进速度,于是在 Gemini 3.0 顺利上线后,他果断选择解甲归田,离开了他待了近 14 年的谷歌。
---
[37:51](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=2271s) Neolab 爆发:创立 Elorian AI,探索语言与视觉的“多模态视觉推理”
离职后的 Andrew 顺应了当前硅谷前沿顶尖科学家出逃巨头、成立独立实验室(Neolabs)的时代浪潮,正式创立了 Elorian AI。他组建了一支由顶尖数据专家、预训练总监、多模态算法科学家以及 RL Post-training 工程师构成的“全栈全明星团队(Full Stack Team)”。Andrew 认为,像 Anthropic 这样的公司走的是针对代码(Coding)的全栈对齐路线,而 Elorian AI 则要把所有的底层代码、视觉编码器(Vision Encoder)、RL 算法和数据清洗全面向“多模态视觉推理”靠拢。
在谈到具体的 AGI 路径时,Andrew 抽丝剥茧地梳理了当前硅谷的三大主流信仰派系,并阐明了自己为什么选择一条大公司“不敢走、不愿走”的 Specialist(专家模型)中间路线:
1. **纯语言模型派(LLM Generalists)**:如目前的 OpenAI、Gemini 和 Claude。他们疯狂拉长思维链(CoT),坚信只要把语言和编程(Coding) scale 到极致,就能实现自我迭代(Recursive Self-Improvement, RSI),从而率先摘得 AGI 的圣杯。但也正因如此,这些巨头面临着首位登顶的巨大政治压力,导致他们将 90% 的精力都锁死在编程模型上,无暇真正顾及深度的视觉推理。目前的通用大模型在视觉上面临极大的缺陷,“连数桌子上有几个杯子都会经常乱说(Hallucinate)”。 2. **纯视觉世界模型派(World Models)**:由计算机视觉(CV)背景的学术界泰斗(如 Yann LeCun、Fei-Fei Li)领衔。他们信仰“Vision is the key to intelligence”,认为动物没有语言也拥有极高的智能。Andrew 提出了一个极为精妙的“老鹰抓兔子”的比喻:一只老鹰在俯冲捕食时,大脑能瞬间算清楚重力(Gravity)、风速(Wind)、气流扰动(Turbulence),并精确预测兔子钻入桥洞后会从哪里跑出来。这种“视觉世界模型”极其强大,但老鹰永远无法向你解释什么是万有引力常数(Gravitational Constant),因为它缺乏人类社会用符号、数学和物理构建出的抽象概念(Concepts)。因此,纯世界模型无法推导出人类的现代科学,距离真正的 AGI 依然十分遥远。 3. **语言 + 视觉中间派(Elorian AI)**:Andrew 坚信,必须将“老鹰的眼睛”和“人类的推理大脑”完美结合。如果能砍掉通用大模型里那些对视觉推理毫无帮助的冗余数据(例如“二战是谁赢的”、“某场战役在什么地方打”),把所有的参数和算力精准喂养给多模态视频、图片与人类符号推理的交集数据,就能做出一款在多模态视觉推理上完爆所有 Generalist(通用模型)的专业模型(Specialist Model)。
谈及离开谷歌创业后的冰火两重天,Andrew 坦言虽然失去了大公司近乎无限的算力卡支持和自带流量的招聘光环(Recruiting Check),但他重新赢回了最为宝贵的资产 —— **时间**。在大公司,项目优先级每个礼拜都在变,今天给你的卡明天可能就被其他高管抢走;而在 Elorian AI,每一张买来的 GPU 都能雷打不动地执行团队的激进实验。Andrew 动情地总结道,他的 Research Taste(研究品味)很大程度上继承自 Jeff Hinton 的思想:大自然中的大脑最初也是一片空白,是通过不断接触客观物理世界的视觉与反馈才发育出高等智能的。在 AGI 的定义每天都在被异化的今天,Elorian AI 的阶段性目标非常纯粹且务实:做出一款能真正看懂人类现实世界,能帮人类拼装乐高、组装宜家家具、看懂汽车方向盘如何运作的“视觉 AGI”模型。
[55:00](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=3300s) 传奇导师 Jeff Dean 与谷歌的“贝尔实验室”时代
在谈到新公司 Elorian AI 获得 Jeff Dean 的个人投资时,Andrew Dai 深情回顾了这位谷歌传奇人物对自己整个职业生涯的巨大影响。Andrew 刚加入 Google Brain 团队时,模型运行速度极慢,经理便让他遇到数学问题直接去问 Jeff Dean。Jeff 亲自来到他的电脑前,不仅看表面代码,甚至直接深入到比 C++ 和 Python 更底层、更深奥的机器代码(Machine code)中寻找症结,并敏锐地指出问题进行了修改。Andrew 感叹,Jeff Dean 是一个极其注重实战(hands-on)的人,“他什么都懂,他什么都学”,为了创办 Google Brain 甚至自己跑去学习深度学习和相关方法,是当之无愧的行业楷模。如今,Jeff Dean 依然在谷歌内部担任 Gemini 项目的负责人。
除了 Jeff Dean,对 Andrew 影响深远的还有 Quoc Le。两人合作过多个项目并共同指导过数位实习生。在 Andrew 眼中,当时的 Google Brain 和 DeepMind 汇聚了太多惊人聪明的顶尖人才,简直就是这一代科技界的“贝尔实验室”(Bell Labs)。例如极为厉害的 Noam Shazeer,以及怀揣着“用 AI 帮助整个世界”这一独特且宏大愿景的 Demis Hassabis。
- **榜样力量**:Jeff Dean 展现了极强的动手能力,能直接看懂并修改比 C++ 更深层的机器代码。 - **人才密度**:Google Brain 和 DeepMind 被誉为新时代的贝尔实验室,云集了 Quoc Le、Noam Shazeer、Demis Hassabis 等顶尖科学家。
---
[56:54](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=3414s) Elorian AI 的人才招募与视觉推理新范式
在被问及新创立的 NeoLab 实验室——Elorian AI 的招募需求时,Andrew 直言他们正在打造一支世界一流的团队。他以中国的 DeepSeek 等研究所为例,指出正是因为这些团队规模小、人才密度极高,才能够高效地做出惊艳的成果。目前,Elorian AI 正在寻找两类核心人才:在多模态和强化学习(RL)领域深耕的研究员,以及能够管理 GPU 集群、做训练内核(Training Kernels)或 CUDA Kernels 优化的基础设施(Infrastructure)工程师。
谈到为什么顶尖人才应该加入,Andrew 自信地表示,Elorian AI 绝对属于 NeoLab 中最顶尖的梯队(Top Tier)。在市面上,拥有如此丰富的预训练数据经验、大模型研发经验和前沿 Frontier Model 打造经验的团队,在全球可能只能在三四个地方找到,大部分其他 NeoLab 并不具备这样的底蕴。他们所选择的视觉推理(Visual Reasoning)方向也是一条全新的路径,旨在带来“下一代的推理”,这让 AI 的思考逻辑能显著向人类的推理能力靠拢。他的目标是带领团队共同成长为“下一个 Anthropic”或“下一个 OpenAI”。
- **融资情况**:Elorian AI 于 2026 年 4 月完成 5500 万美元融资,Jeff Dean 个人参投。 - **招募岗位**:具备多模态和 RL 经验的研究员,以及擅长 GPU 集群管理与 CUDA 优化的 Infra 工程师。 - **技术愿景**:主攻语言与视觉推理的结合,追求更接近人类的下一代推理能力。
---
[58:06](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=3486s) 探秘新办公室:极客的桌游、硅谷的 Quad 与思维桑拿
专访结束后,主持人跟随 Andrew 探访了 Elorian AI 刚刚搬入的新办公室。周五的下午,办公室里的 15 名员工大都已经离开,四周还堆放着不少未拆封的亚马逊快递纸箱。Andrew 介绍道,目前团队由 15 人组成(还有两人在办理签证),其中包含 12 名研究员、1 名 Infra 工程师和 2 名运营人员,结构非常偏重研究。
他们之所以选中这间办公室,是因为这里拥有一个形似大学校园“Quad”的院子和一处让人放松的喷泉。员工们经常在这里吃午饭或举办 Happy Hour。有趣的是,团队里的研究员们还在提出各种好玩的硬件需求,有人甚至提议白天在办公室里加装一个桑拿房(Sauna)。Andrew 笑着调侃,或许对方和自己一样,在洗澡或者泡桑拿时最容易冒出灵感。此外,Andrew 个人非常喜欢玩桌游,办公室里也堆着准备用来打桌游的设备。他坦言曾尝试用现有的视觉大模型去玩棋盘桌游,但表现实在太差,“连棋盘都看不懂”,他希望未来自己公司做出的模型能够真正陪人类打桌游。随后他展示了自己最爱的角落办公室,那里配有升降桌,光线充足,是他日常眺望窗外思考或打电话的专属空间。
- **团队配置**:目前规模约 15 人,包含 12 位 Research、1 位 Infra、2 位 Operations。 - **办公环境**:带有类似大学 Quad 的庭院和喷泉;研究员提议加装桑拿房以激发灵感。 - **模型局限**:当前的视觉模型能力尚弱,连基础的棋盘游戏都无法理解。
---
[01:00:00](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=3600s) 创意溢价时代与 NeoLab 的时代窗口
关于个人时间的分配,Andrew 透露自己白天的大部分精力都消耗在面试、设计 IT 架构以及搭建 AWS 等琐碎的运营公司事务上。真正的研究与思考往往发生在周末和安静的深夜,许多绝妙的 Idea 都是在洗澡时蹦出来的,然后再通过 Claude 代码工具迅速在云端实现。
在探讨公司内部如何产生灵感时,Andrew 表示他们有些新的 Vision Encoder 想法出自他本人,而 SFT 和数据方面的创意则来自团队。他指出,虽然现在有自动研究(Auto Research)的模型在跑,但它们的想法“太 Average 了”,缺乏真正的创造力(Creativity),而科学研究必须依赖创造力。在过去,由于编程和执行(Execution)的门槛极高,创意往往显得很便宜;但如今随着 Claude Code 和 GPT Codex 等工具的普及,代码执行变得异常简单,这反而让“人类最宝贵的创意(Ideas)的价值迎来了暴涨”,这也是各大公司在疯狂争抢核心创造型研究员的原因。
针对当下硅谷科学家纷纷出逃创业、创办新实验室的“NeoLab 狂潮”,Andrew 认为这一趋势近期仍会持续。得益于开源模型的成熟以及大批公司正排队 IPO,目前的融资环境相对宽裕。但他敏锐地指出,这其实是一个短暂的“时间窗口”,可能也就这两年时间。一旦这一代的 NeoLab 发展壮大、卡住生态位,新的实验室就很难再诞生了。至于窗口关闭后、下一代的实验室会是什么模样,Andrew 坦言或许那是“AGI 之后的实验室”,完全由 AI 自动运行也说不定,但至少在当下,AI 的创造力离人类还差得太远。
- **核心观点**:代码执行工具的普及让“创意的价值(Value of Ideas)”大幅贬值转为暴涨,优秀的创意研究员成为行业最稀缺的资产。 - **窗口预测**:NeoLab 的创业爆发期窗口预计只有这两年(2026-2027年左右),之后行业格局将走向固化。 - **AI 局限性**:目前的 AI 创造力依然远远无法与人类的创造力相提并论。
## Notable quotes > [00:00](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=0s) 硅谷其实是没有什么秘密可言的,特别是在大模型领域。 — Andrew Dai
> [05:35](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=335s) 根据光速在光纤中的传播速度计算,跨越这个物理距离本身就需要这么多时间,你不可能超越物理极限走得更快。 — Andrew Dai
> [09:34](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=574s) 我当时做了无数个实验,全都是失败的。 — Andrew Dai
> [15:54](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=954s) 我行医几十年,为什么要听一个 AI 的? — 医生群体(引述)
> [15:54](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=954s) 在错误的时间做正确的技术,往往很难成功,这对我后来的创业是一次极为深刻的教训。 — Andrew Dai
> [16:41](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1001s) 光靠预训练是不够的,模型无法自发学会如何修改写错的字,也无法敏锐感知生成文本的优劣。 — Andrew Dai
> [18:05](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1085s) 大公司之间根本没有秘密,人才的流动决定了技术的底牌。 — Andrew Dai
> [22:11](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1331s) PALM 2 是我见过的最顺滑的大模型预训练,从头到尾没有发生过一次中断。 — Andrew Dai
> [22:11](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1331s) 如果能早一点发表,我们就能理直气壮地向世界宣告,我们才是全球最好的模型。 — Andrew Dai
> [29:02](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=1742s) 这就跟养育小孩一样,如果你每天只让他读垃圾广告,他再聪明也成不了大器,你必须精准喂养有真正知识与严密逻辑的内容。 — Andrew Dai
> [35:12](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=2112s) 这不可行。因为这样调整后,反向传播的梯度会产生某种特定的偏移,从而无法实现预期的训练效果。 — Noam Shazeer(引述)
> [37:51](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=2271s) 连数桌子上有几个杯子都会经常乱说。 — Andrew Dai
> [55:00](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=3300s) 他什么都懂,他什么都学 — Andrew Dai
> [01:00:00](https://www.youtube.com/watch?v=cqW_VWYbIcU&t=3600s) 人类最宝贵的创意(Ideas)的价值迎来了暴涨 — Andrew Dai
## Mentioned Andrew Dai, 戴安度, Quoc Le, Ian Goodfellow, Liam Fedus, Jeff Dean, Noam Shazeer, Alec Radford, Demis Hassabis, Geoffrey Hinton, Larry Page, Sergey Brin, Sepp Hochreiter, Yann LeCun, Fei-Fei Li, Claire, Barret Zoph, David Haar, Elorian AI, 谷歌, Google, Google Brain, DeepMind, OpenAI, Anthropic, DeepSeek, Mellon Ventures, Ultimator Capital, 英伟达, NVIDIA, Gemini, GPT, PaLM, PaLM 2, Flan, GLaM, GShard, MaskGAN, Word2Vec, Paragraph Vectors, Transformer, LSTM, BERT, Claude, Claude Code, GPT Codex, Character.AI, Google Now, Google Health, DNN Research, AlphaGo, Bard, OPT
[Source](https://www.youtube.com/watch?v=cqW_VWYbIcU)