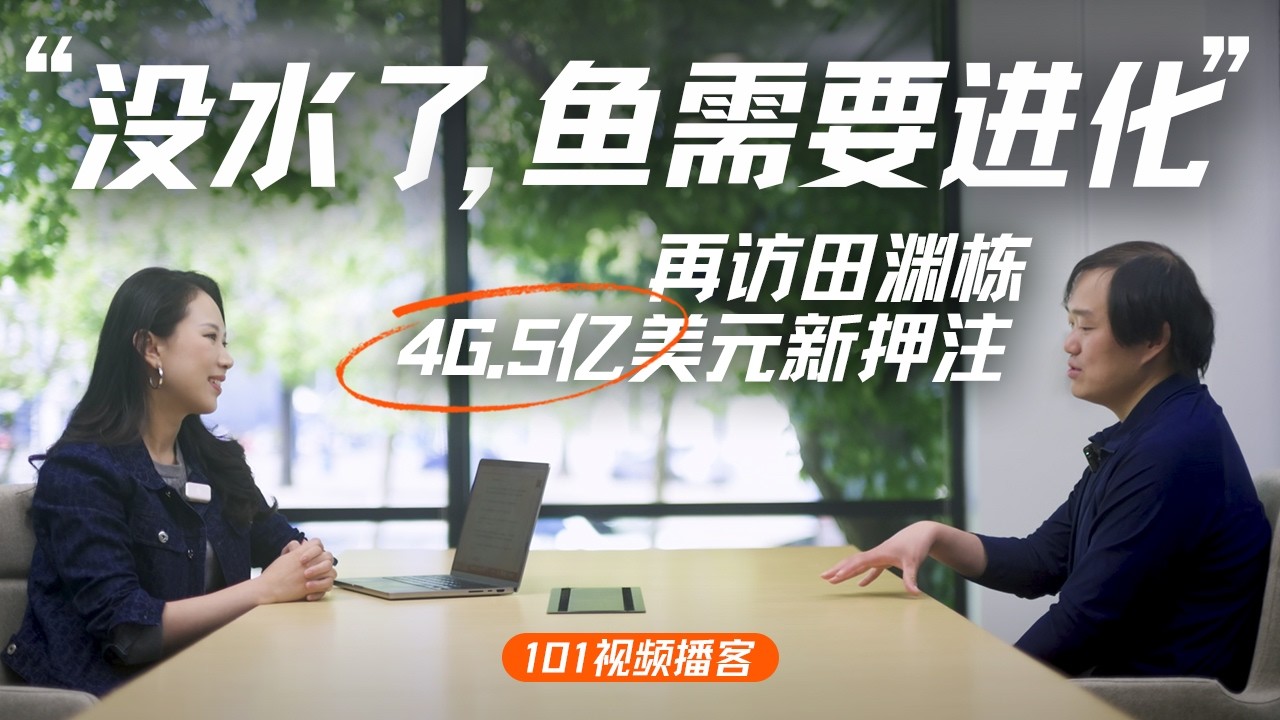
田渊栋携RSI获6.5亿美元融资 押注AI自动化科研自进化 硅谷101
前沿大模型竞争已从纯粹的技术之争演变为组织架构与管理效率之争,普通人必须摆脱传统螺丝钉思维以应对大厂加速蒸馏带来的失业冲击。
AI-assisted summary of 再访田渊栋:46.5亿美金估值的RSI,与AI自进化|Neolabs特辑【101视频播客】 — original source . Check the original for full context.
Source published: 2026-06-05
Detailed notes ## Background
该内容由YouTube频道“硅谷101”于2026年6月5日发布,是一期围绕AI自进化与新一代AI实验室发展的Neolabs特辑视频播客。节目主要聚焦于Meta前FAIR研究总监田渊栋官宣联合创立、估值达46.5亿美元的新实验室Recursive Superintelligence (RSI),探讨AI如何实现自动化科研与自我改进,以及AI时代下个体职业的剧烈冲击与组织架构之争。
## TL;DR
在本次对话中,田渊栋详细阐述了他加入轻量化顶级团队RSI并押注“递归自我改进(Recursive Self-Improvement)”的核心愿景,即通过提升可解释性与潜在推理(Latent Reasoning)等底层算法,让AI代替人类攀爬科学发现的阶梯。同时,他深度剖析了SSI、AMI Labs等下一代AI实验室的技术路线差异,指出当前前沿大模型之争的胜负手正由技术演变为组织架构与管理效率。面对AI全面提升研发效率导致大厂加速“蒸馏”员工的现实,他警示职场人必须摆脱传统螺丝钉思维,进化为能找到独特意义的“四维生物”以应对技术性失业的冲击。
## Atmosphere & style
整场对话洋溢着一种理性、前沿且兼具敏锐洞察的学术与创业交融氛围。田渊栋在分享技术突破和团队理念时充满激情与自信,语言技术导向且直截了当,展现出顶级科学家重回创业一线后的脚踏实地与从容;而在谈到普通人在AI时代的职业危机时,他用“水越来越少的鱼缸”和“进化成鸟的鱼”这一精妙而略显残酷的比喻,将科技大潮带来的紧迫感、宿命感与个体自驱的生存智慧具象化,让听众在感受到科技自进化震撼的同时,引发对自身未来价值的深度静思。
## Key takeaways
- [00:00](https://www.youtube.com/watch?v=F7oNfszczVc&t=0s) 田渊栋与另外七位顶级 AI 研究员共同创立了全新的实验室——Recursive Superintelligence(RSI),并已完成 6.5 亿美元融资,估值达 46.5 亿美元。他直言在 AI 领域最顶级的资本还是看团队的执行力和过往履历。
- [00:00](https://www.youtube.com/watch?v=F7oNfszczVc&t=0s) 大公司目前由于组织架构臃肿、内部沟通成本极高,其执行与对齐速度已经无法跟上 AI 的发展步调,这也促使田渊栋跳出舒适区加入轻量化的顶级初创团队。
- [05:45](https://www.youtube.com/watch?v=F7oNfszczVc&t=345s) RSI 的联合创始人团队背景极其互补,包括 Richard Socher、熊蔡明、Tim Rocktäschel、Jakob Foerster、Josh Tobin、Alexei Dosovitskiy 和田天,完美涵盖了商业化、工程落地与前沿强化学习、视觉、Agent 等研究领域。
- [14:03](https://www.youtube.com/watch?v=F7oNfszczVc&t=843s) RSI 的核心愿景是“递归自我改进”,旨在打破人类精力与生理极限带来的科研瓶颈,让 AI 代替人类进行繁重重复的科研劳动并自主发现科学洞察,最大化人类社会的知识发现速率。
- [19:38](https://www.youtube.com/watch?v=F7oNfszczVc&t=1178s) 在自进化路径中,“可解释性”非但没有被削弱,反而变得更加关键。它不仅是确保安全防范模型作恶的核心,还能让研究员在训练早期评估模型走向,极大地提升算力效率。
- [22:50](https://www.youtube.com/watch?v=F7oNfszczVc&t=1370s) 科学研究的自动化是一个有着清晰阶梯的递进过程。田渊栋认为目前通用人工智能(AGI)或完全自进化的科学能力大概处于 1 到 3 的早期阶段,甚至可能只有 0.5,但 AI 的上限正在以难以想象的速度刷新。
- [25:32](https://www.youtube.com/watch?v=F7oNfszczVc&t=1532s) 田渊栋认为“语言绝对不是思考的本体”,语言在更多时候是一种事后解释。相较于文本语言,在连续的潜在空间中直接进行推理(Latent Reasoning)效率天然更高,每个 Latent Token 能承载更大的信息量。
- [29:22](https://www.youtube.com/watch?v=F7oNfszczVc&t=1762s) 田渊栋团队通过“顿悟(Grokking)”理论研究推导证明,发生泛化所需的数据量约为 $m \log m$ 规模,这有助于大幅提升训练效率。此外,RSI 明确会从头开始做预训练,以此为自进化系统搭建平稳扎实的基座。
- [31:54](https://www.youtube.com/watch?v=F7oNfszczVc&t=1914s) RSI 将在最初的一年到一年半内集中打磨 Level 1 的自主训练系统,并规划了推理加速、训练配方输出和科研工作流替代等清晰的商业化变现路径。
- [38:04](https://www.youtube.com/watch?v=F7oNfszczVc&t=2284s) 当前是以 AI Coding 自动化为代表的生产力工具质变窗口期,小公司能以极高的对齐速度找出全新的协作范式,从而获得长达一到两年的“弯道超车”黄金窗口期。
- [42:36](https://www.youtube.com/watch?v=F7oNfszczVc&t=2556s) 针对其他下一代 AI 实验室,田渊栋指出 Ilya 的 SSI 可能会另辟蹊径寻找提升训练效率的全新模型机制,LeCun 的 AMI Labs 侧重视觉世界模型与机器人,而 David Silver 的 Ineffable 专注于高算力门槛的纯强化学习路径。
- [50:42](https://www.youtube.com/watch?v=F7oNfszczVc&t=3042s) 预训练的上限死死锁定了强化学习的上限。如果模型在预训练阶段没有扎实学习底层推理模式,导致生成的解集中不包含正确的种子候选,后端强化学习做得再精妙也无从下手。
- [52:35](https://www.youtube.com/watch?v=F7oNfszczVc&t=3155s) 当前大模型的一波重大能力跃升得益于将强模型生成的逻辑合成数据重新反哺到预训练中,而为了平衡算力成本,行业也开始大力押注连续学习(Continuous Learning)。
- [55:00](https://www.youtube.com/watch?v=F7oNfszczVc&t=3300s) 面对资源的限制,独立实验室(Neolabs)的核心破局点在于摆脱传统 Scaling Law 堆叠计算资源的依赖。由于大公司自上而下的决策容易趋同和流于追逐热点,独立实验室的护城河在于坚持探索非主流的差异化路线。
- [01:01:10](https://www.youtube.com/watch?v=F7oNfszczVc&t=3670s) AI 对大厂就业的冲击正在加速演进,传统的“螺丝钉”式员工将难有安稳的退路。求职者需要摆脱机器零件思维,向自驱的创业者转型,进化成能够活下来的“四维生物”。
- [01:05:14](https://www.youtube.com/watch?v=F7oNfszczVc&t=3914s) 在 Coding 赛道之后,下一个核心竞争点(The Next Big Thing)将是 AI Research(自主科研)。因为大模型人才成本极高,实现模型自身的自动化迭代将带来天文数字般的投资回报率。
- [01:05:14](https://www.youtube.com/watch?v=F7oNfszczVc&t=3914s) 前沿模型的胜负手已经从纯粹的技术之争演变成了组织架构与管理效率之争。若团队缺乏向管理层 Push back 的空间,高管层施加的激进压力易导致组织地震。
## Detailed walkthrough
### [00:00](https://www.youtube.com/watch?v=F7oNfszczVc&t=0s) 离开Meta之后,RSI的新旅程与资本态度
田渊栋在被 Meta 基础 AI 研究实验室(FAIR)裁员半年后,官宣了他的新动向:与另外七位顶级 AI 研究员共同创立了全新的 AI 研究实验室 —— Recursive Superintelligence(简称 RSI)。该公司已完成 6.5 亿美元的融资,估值高达 46.5 亿美元。在没有任何产品问世的前提下,能够获得如此巨大的资本青睐,田渊栋直言:“最顶级的资本还是看人。” 在技术发展日新月异、充满变数的 AI 领域,资本投的是团队的执行力、过往履历以及对未来愿景的判断与磨合程度。
从 Meta 出来后,田渊栋的手机在去年 10 月底到 11 月初期间几乎被“打爆”,收到了来自 Anthropic、xAI、Amazon、Apple、Microsoft 等众多大团队的橄榄枝。然而他注意到,许多大公司在两三个月后便出现了频繁的架构调整或人员流失。大公司由于组织架构臃肿、沟通成本极高,CEO 传达的战略需要耗费大量时间去向下执行和对齐员工意愿,其组织沟通速度已经根本跟不上 AI 的发展步调。
相比之下,团队小型化、速度变快、内部摩擦变少已成为把事情做成的新趋势。田渊栋在 Meta 工作了快 11 年,亲身体会到了大公司的痛点,因此决定跳出舒适区,选择加入一个刚刚组建、能够提供联合创始人(Co-founder)席位且高度互补的轻量化顶级团队,开启一段不一样的人生。
---
[05:45](https://www.youtube.com/watch?v=F7oNfszczVc&t=345s) “最顶级的资本还是看人”:8位联合创始人的新赌注 RSI 的 8 位联合创始人各自拥有极其互补的专业背景:
* **Richard Socher(CEO)**:曾创立 MetaMind 并被 Salesforce 收购,后担任 Salesforce 首席科学家,随后创立 U.com 并实现盈利,具备丰富的商业化与 CEO 经验。
* **熊蔡明**:曾与 Richard 共同创立 MetaMind,在进入 Salesforce 后担任 Research 高级副总裁(Senior VP)长达十余年。
* **Tim Rocktäschel**:田渊栋在 Meta 时的同事(曾分别在伦敦和加州主导强化学习研究),后加入 Google DeepMind 担任世界模型项目 Genie 1, 2, 3 的负责人,并带领 Agent Openness 团队。他在 Google Venture 的背调中获得了极高的评价,为本次顺利融资做出了巨大贡献。
* **Jakob Foerster**:在 AI Agent 领域深耕十年,其团队近期关于 AI Scientist V2 的论文已被 《Nature》杂志收录,在学术界具有广泛影响力。
* **Josh Tobin**:OpenAI 早期员工,曾担任 OpenAI 的 Agent Science Lead,在工程落地与 Agent 研发方面拥有深厚经验。
* **Alexei Dosovitskiy**:资深强化学习学者,10 年前曾与田渊栋在游戏《Doom》(毁灭战士)的不同赛道中各自斩获第一名。他后来在 Google 担任 Vision Transformer(ViT)的第一作者,该论文首次将 Transformer 引入计算机视觉领域,证明了在大数据量下 Transformer 在视觉上的优异效果。
* **Tim Tian(田天)**:前智能客服独角兽 Cresta 的 CTO,为了 RSI 的共同愿景辞去原公司的管理职务,加入团队担任联创。
外界或许会担心如此多顶尖且极具个性的学者聚在一起会产生冲突,但田渊栋表示,大家都非常聪明且目标一致,内部采用民主讨论的方式进行思想碰撞,合作十分省心顺畅。田渊栋自己在团队中主要负责建模(Modeling)、训练、后训练(Post-training)以及部分 Agent 架构的搭建,完美实现了他此前所追求的“前沿研究与工程落地相结合”的职业路径。
---
[14:03](https://www.youtube.com/watch?v=F7oNfszczVc&t=843s) 递归自我改进:押注AI自动化科研 RSI 的核心愿景是“递归自我改进”(Recursive Self-Improvement),即利用 AI 来自动优化 AI 自身的各种组件,形成左脚踩右脚的螺旋式上升逻辑。田渊栋指出,在传统的前沿大模型研发中,依赖人类去设计模型、收集数据和人工对齐的模式已经遇到了生理极限——人类需要吃喝拉撒和睡觉,无法 24 小时全天候投入。因此,人类成为了科研进程中的瓶颈。RSI 的第一步是让 AI 代替人类进行繁重、重复性的劳动,第二步则是让 AI 自主发现新的科学洞察(Insight),最终实现“最大化人类社会的知识发现速率”(Maximizing the scientific discovery rate)。
针对这种自主性是否会导致模型陷入“评估指标过拟合(Benchmark 刷榜)”的质疑,田渊栋解释道,刷榜只是分解任务后的低阶手段。RSI 追求的是 AI 核心能力的本质提升,即让 AI 的科研水平从本科生跨越到硕士、博士甚至资深研究员的水平。
当 AI 演进到一定高度后,很多评估标准将从客观走向主观(例如评估一段宏观代码的模块架构设计,并没有唯一的标准答案)。此时,“评估者本身也需要被评估(Evaluating the evaluator)”的递归难题会自然演变成一种高度“结果导向(Result-driven)”的模式。人类将不再纠结于评估中间复杂的自主实验过程,而是直接评估 AI 最终交付的产出是否符合人类预期、能否切实解决问题。
---
[19:38](https://www.youtube.com/watch?v=F7oNfszczVc&t=1178s) 当AI开始研究AI:可解释性为什么更重要 在 AI 实现自进化的路径上,田渊栋坚信“可解释性”(Interpretability)不仅没有被削弱,反而变得比以往任何时候都更加关键。RSI 在启动时就将安全放在了核心位置(Safe Superintelligence)。如果人类能够洞察模型内部的运作机制与思考逻辑,就能够清晰地判断 AI 在自主修改代码或权重、设计实验时,究竟是越界(作恶)了,还是在安全的边界内发现了真正的创新。
除了安全(Safety)维度的考量,可解释性在工程和算力层面上也具有极高的实用价值。当前的大模型训练动辄需要消耗几千甚至上万张显卡。如果缺乏可解释性,研究人员只能像开盲盒一样,等到整个模型完全训练结束后才能去评估好坏,研发迭代的周期会非常漫长。而一旦掌握了可解释性的指标,研究人员就可以在训练的早期阶段对模型的发展走向做出前瞻性评估,从而极大地提升算力效率(Budget efficiency)。在技术实现上,除了人类的直接介入,未来还可以通过引入“另一尊 AI 模型”来对当前模型的研究成果进行交叉验证。
---
[22:50](https://www.youtube.com/watch?v=F7oNfszczVc&t=1370s) 人类洞察力VS AI自主性:新的科研协作模式 田渊栋回顾了自己在使用 GPT-5 等前沿模型时的感悟。他发现当前的模型虽然能帮人类做很多琐碎的事务,但依然极度缺乏高层次的人类洞察力(High-level insights)与专业领域的直觉,仍需人类引导。这看似与 RSI “让 AI 自主提出假设并验证”的自动化路线相冲突,但田渊栋坦言:“正因为现在 AI 做不了,这才是我们需要发挥和研究的地方。”
科学研究的自动化并非 0 和 1 的二进制飞跃,它不像无人驾驶技术那样容不得半点差错(只要有 1% 的失误就会撞车)。AI 科研的自主性是一个有着清晰阶梯的递进过程:也许今天 AI 只能写出基础代码,明天能够读懂学术论文,后天能理解问题的部分本质,接着才能攻克更复杂的科研难题。在这个不断攀爬阶梯的过程中,每前进一步,都会解锁海量的实际应用场景。
如果将终极的通用人工智能(AGI)或者完全超越人类的自进化科学能力定义为第 10 阶段,田渊栋认为我们目前大概处于 1 到 3 的早期阶段,甚至可能只有 0.5。因为人类已知的科学边界虽然可以量化,但翻过这座山头之后,AI 可能会看到一片包含 100 甚至更广阔的未知领域。近期 OpenAI 等前沿实验室频繁证明出完全非平凡(Non-trivial)的数学定理,且论文发表频次越来越快,这表明 AI 的上限正在以人类难以想象的速度被刷新。
---
[25:32](https://www.youtube.com/watch?v=F7oNfszczVc&t=1532s) “语言不是思考本体”:Coconut与新推理路线 田渊栋在 Meta 期间的一项标志性成果是 **Coconut**。该研究主张让 AI 在连续的潜在空间(Continuous latent space)中直接进行推理,即所谓的 **Latent Reasoning**。来到 RSI 后,田渊栋确认这一方向的研究还将继续推进,但在商业公司环境中,具体的实现细节将作为团队的商业机密(Secret source)被封装在一个黑盒系统中,只通过最终的研究成果或产品来向外界证实其威力。
探讨到行业主流的**思维链(Chain of Thought, CoT)**路线时,田渊栋认为 CoT 非常实用且有效,但“语言绝对不是思考的本体”。从人类自身的体验出发,科学家在思考复杂问题时,脑海中往往最先浮现的是图像或某种说不清、道不明的直觉思路,最后才会将这些思路形诸文字。语言在更多时候是一种“事后解释”,而非思考的直接母体。
从信息密度的角度来看,潜在推理(Latent Reasoning)的效率天然高于文本语言。在连续空间中,每一个 **Latent Token** 能够存储的信息量远远大于一个普通的语言 Token。一个 Latent Token 可以同时包裹并承载两到三个不同的思考路径或解题思路;而在语言 CoT 的范式下,模型必须把每一个思考步骤用文字老老实实地打印出来。目前,Coconut 这篇论文已经引发了学术界的广泛引用,市场上也开始涌现出类似 **Lupi Transformer** 这样基于潜在空间做图形或搜索问题探索的结构。田渊栋透露,坊间传闻 Anthropic 的某些大模型之所以在复杂的图搜索任务上表现出奇优异,可能正是因为暗中采用了类似的技术路线。
---
[29:22](https://www.youtube.com/watch?v=F7oNfszczVc&t=1762s) 顿悟与泛化:重新理解预训练 田渊栋此前关于模型**“顿悟”(Grokking)**的研究在发布后引发了学术界的广泛讨论。这一方向主要研究神经网络如何从单纯的“记忆(Memorization)”突变到实现真正的“泛化(Generalization)”。在结构化的数据输入下,这一转变可以通过数学中的“能量函数”来清晰描述:当数据量不足时,能量函数的最小值对应的都是记忆解;而当数据量跨过某个临界点时,能量函数的结构会发生改变,最小值直接指向泛化解。
通过理论推导,田渊栋的团队已经可以粗略计算出发生这种“顿悟”所需的数据量:在特定的设计框架下,如果总数据的空间是 $m^2$ 的数量级,模型大约需要 $m \log m$ 规模的数据量才能激活泛化。虽然这比纯线性增长要多一点,但相比于庞大的总体数据空间,所需的实际数据量已经大大减少。这一理论的明确,有助于人类未来更深入地理解神经网络的训练机制,并大幅提升训练效率。
在 RSI 的技术实施上,团队目前仍处于积极的探索阶段,但田渊栋明确表示他们**会从头开始做预训练(Pre-training)**。因为预训练本身的 Loss 曲线非常平稳和光滑(Smooth),能够为自进化系统提供一个极其扎实的基座。
---
[31:54](https://www.youtube.com/watch?v=F7oNfszczVc&t=1914s) 商业化思考:RSI如何规划研发路线 针对外界对 RSI 这种前沿科学实验室如何赚钱的疑问,田渊栋强调,RSI 是一个“非常落地且接地气”的实用团队,超过半数的创始人都有过成功的创业经历,内部讨论时极少务虚,时刻在推演技术能否解决实际痛点、能否产生商业效益(Commercial benefit)。
“递归自我改进”这一方向隐藏着巨大的商业化路径:
* **推理加速与效率优化**:如果自进化系统能够训练出某种特定模型,令其 Inference 速度和效率实现数量级的提升,这本身就是极具价值的商业产品。
* **全新训练配方的输出**:AI 自主探索出的全新模型设计或训练 Recipe,可以直接转化商业授权。
* **科研工作流替代**:对人类获取知识、提出假设、验证结果的思维路径进行精准建模,可以直接赋能那些高门槛的研发行业。
目前,RSI 内部已经具备了清晰的技术路线图(Roadmap)。团队规划在最初的一年到一年半时间内,集中精力将 Level 1 的自主训练系统打磨深透,随后逐步向 Level 2、3、4 迭代,并迅速推向具体的商业 Use case。田渊栋认为,这个旅程可能会持续好几年才能看到颠覆性的最终结果,但幸运的是,自进化技术的每一个微小阶梯都具备极高的独立应用与变现价值。它不像受控核聚变或寻找新型超导材料那样,属于“非全功即全败”的豪赌;RSI 的每一步进展,都是可以直接推向市场的护城河。
---
[38:04](https://www.youtube.com/watch?v=F7oNfszczVc&t=2284s) 为什么是“现在”:做RSI最好的时机 为什么 2026 年是做 RSI 最完美的历史节点?田渊栋给出了解释:如果倒退回去年,以 Cursor 为代表的 AI Coding Agent 还没有完全跨越其技术突变点。在去年的模式下,人类依然需要花费大量时间自己写代码,再让 AI 去辅助审核、重构或修改。然而到了去年底今年初,行业迈过了突变点,大模型在代码生成的自动化上表现出了极高的成熟度,人类的工作习惯转变为“人下达 High-level 的核心命令与想法,AI 全权执行代码编写”。
这一生产力工具的质变,给小公司留出了长达一到两年的“弯道超车”黄金窗口期。科技巨头和庞大的软件工程行业需要耗费巨大的人力、物力去缓慢调整组织架构,以适应全新的生产力工具。而小公司由于精简、全员精英,能够以极高的对齐速度找出全新的协作范式,从而在巨头转身的间隙中快速拉近差距。如果再晚一年创业,当大公司普遍适应了这套 AI 驱动的软件工程流程后,这个时间窗口就将彻底关闭。
此外,当前投资人和硅谷创业者面临的最大痛点在于:为某个垂直领域(如营销文案编写、法律助手)量身定制的特殊化大模型,极容易在几个月后被底层技术迭代的、能力更具普适性的一般化(Generalized)大模型直接“降维打击”并彻底取代。为了摆脱这种被动挨打的困境,必须把目光放得足够长远——直接去卷“模型自我进化”这一底层范式。只要“AI 自我优化”的范式立得住,无论上层模型如何厮杀,公司的立足点都将坚不可摧。
---
[42:36](https://www.youtube.com/watch?v=F7oNfszczVc&t=2556s) 下一代AI实验室:SSI、AMI Labs、Ineffable Intelligence 面对当前涌现的下一代 AI 实验室(New Labs)版图,田渊栋分享了他对行业内几家顶尖机构的独到洞察:
* **Ilya Sutskever 的 SSI(Safe Superintelligence)**:团队内部目前处于极度保密状态。尽管融到了巨额资金,但这点体量在如今动辄大几百亿的算力大战中,可能并不足以从头去烧一个类似 GPT 或 Gemini 级别的通用超大规模模型。不过,伊利亚很可能会带领团队另辟蹊径,寻找一种能极大提高训练速度与效率的全新模型机制。田渊栋提到,伊利亚此前的访谈展现出了极高的研究品味(Research taste),关注点同样落在“神经网络为何会发生泛化”等底层数学和理论问题上,这与 RSI 的关切有异曲同工之妙。
* **Yann LeCun 的 AMI Labs**:探索的是一条完全不同的道路。扬·勒昆团队的核心在于世界模型(World Models),尤其是图像和视频级别的视觉世界模型,并试图将其与机器人学(Robotics)相结合。田渊栋坦言自己已多年不涉及视觉领域,但他个人持有一个观点:**语言的上限天然高于图像**。在视觉世界中,像素及其组合(例如一个杯子的形状)相对固定且具象;而语言具有无限嵌套、自指(Self-referential)的能力,人类可以随时在对话中凭空定义一个抽象的新概念,并让后续的所有词汇都指向它。这种信息密度和逻辑深度是视觉难以比拟的。
* **David Silver 的 Ineffable Intelligence**:专注于强化学习(RL)路径。作为 AlphaGo 和 AlphaZero 的核心发明人,大卫·西尔弗的愿景是摆脱对当前大语言模型(LLM)预训练范式的依赖,试图在开放领域重现 AlphaZero 这种纯粹靠“左脚踩右脚”无监督自对弈登顶的奇迹。然而田渊栋指出,围棋或国际象棋有明确定义的胜负规则和完美的评估函数(Evaluation function),而人类现实世界是高度开放且模糊的,纯靠 RL 从零开始摸索需要天文数字般的算力,这在目前是极难被满足的。
---
[50:42](https://www.youtube.com/watch?v=F7oNfszczVc&t=3042s) 预训练VS强化学习:能力提升的两条路径 在行业关于“预训练(Pre-training)上限是否决定了强化学习(RL)上限”的讨论中,田渊栋给出了非常肯定的赞同答复。
根据 RSI 的研究观察,强化学习以及各类后训练(Post-training)的核心功效,本质上是把模型原本生成的、排在第 200 位的那个“正确答案候选”,通过奖励机制打分并提拉到第一位。这种机制发挥效力的铁律是:**在海量的尝试中,模型的初始解集中至少得包含一到两个正确的“种子候选”**。如果大模型在前面的预训练阶段没有把底层的推理模式(Reasoning patterns)和知识表示学习扎实,导致模型尝试一万次吐出来的全是垃圾代码或错误答案,那么后端的强化学习做得再精妙,也根本无从下手。大语言模型真正的涌现能力和对数学、逻辑结构的深度理解,依然沉淀在预训练阶段。因此,光靠压榨强化学习,其上限是完全被预训练死死锁定的。
---
[52:35](https://www.youtube.com/watch?v=F7oNfszczVc&t=3155s) 数据还能怎么往前走:合成数据与连续学习 面对互联网上高质量人类公开数据几乎被前沿大模型“扫荡穷尽”的现实,整个行业都在死磕合成数据(Synthetic Data)。田渊栋指出,当前大模型的一波重大能力跃升,核心秘密就在于研究人员将“推理大模型生成的逻辑数据”重新喂回了模型的训练或中训练(Mid-training)流中,从而初步实现了自我进化的良性循环。随着未来模型变得更加强大,让强模型生成更高质量的合成数据再反哺预训练,是一条必然的路径,但这需要耗费极其恐怖的计算资源。
为了在数据吞吐与算力成本之间取得平衡,行业开始大力押注**连续学习(Continuous Learning / Lifelong Learning,或称实际学习)**。其核心诉求是希望当源源不断的新数据输入时,模型能够以极低的代价进行深度吸收,而不需要每次都大费周章地把全部旧数据拉出来做全量重训。
此外,田渊栋也提到了对 Thinking Machines Lab 的关注。他们最近推出的多模态持续交互模型(Interactive Model)非常有意思,改变了传统“你一言、我一语”的 Turn-by-turn 机械式对话范式,实现了模型能够持续倾听人类说话、不因停顿而打断的流畅人机交互体验。但归根结底,合成数据和交互方式只是外在优化,大模型要真正获得匹敌人类的效率与智能,关键仍取决于未来能否在底层算法和新范式上迎来根本性的突破。
[55:00](https://www.youtube.com/watch?v=F7oNfszczVc&t=3300s) 独立实验室的“护城河”与大公司的“同质化” 面对独立实验室(Neolabs)在当前宏观环境下面临的挑战,田渊栋指出,最核心的破局点在于如何在资源有限的情况下快速产生研究成果与进展。许多独立实验室的成员此前来自大厂等资源极其丰富的环境,习惯了动辄耗资数亿甚至数十亿美元的实验方式。但对于需要融资的初创实体而言,必须思考如何提升学习效率与迭代过程,寻找传统 Scaling Law(缩放定律)之外的路径,通过对问题更深层的理解来绕过对海量计算资源的堆叠。
在谈到与 OpenAI、Google、Anthropic 等前沿大厂的关系时,田渊栋认为目前双方更多是平行发展的关系。大公司目前存在明显的“趋同化”现象,其方向往往由高层自上而下决定,容易流于追逐热点。例如 Coding Agent(代码智能体)火热后,各大厂便纷纷跟进,导致大企业内部的研究员缺乏精力和时间去探索非主流的方向。相反,小公司为了生存,自然会选择大公司尚未涉足的差异化路线。
历史已经多次证明这种路线的有效性。田渊栋回忆道,在去年或前年大家都在刷数学(Math)和 AIME 题目的时候,Anthropic 放出的模型甚至没有公布数学性能指标,而是专注于把代码(Coding)能力刷上去。当市场发现这种模式能够切实变现并带来巨大商业价值时,资金和资源才突然涌入。因此,独立实验室需要有足够的耐心和眼光。即便大公司后续携带无限资金入场试图“盖过”小公司,其内部庞杂的架构也会降低执行效率。例如 Google 虽然成立了由联合创始人 Sergey Brin 亲自挂帅的突击队(Strike Team)力追 Coding,但目前实际效果依然带有大公司的种种弊病。此时如果小公司已经完成了早期的资金和业务积累,将拥有巨大的杠杆优势(Leverage)。
[01:01:10](https://www.youtube.com/watch?v=F7oNfszczVc&t=3670s) RSI 的人才策略与 AI 时代的职业冲击 谈及人才争夺战,田渊栋透露 Recursive Superintelligence (RSI) 非常受欢迎,收到了大量简历。大厂如 OpenAI 能够开出极高的总报酬(Total Package)和福利,吸引的是那些拥有强技术能力但未必热衷于探索全新方向的人;而 RSI 吸引的则是更看重长远愿景和方向影响力的研发人员。在选人品味上,RSI 倾向于招收有丰富经验、具备良好研究品味与方向感,同时又愿意脚踏实地“Hands-on”自己把事情做成的人。对于应届毕业生则是具体情况具体分析(Case by case)。
田渊栋观察到,AI 对大厂就业的冲击正在加速演进,距离他半年多前预测的“技术性失业”正越来越近。今年年初以来,包括 Meta、Amazon 在内的互联网巨头持续裁员,其本质原因在于 AI 已经达到了大厂 Level 4(应届毕业生)甚至 Level 5(资深级别)工程师的水平,极大地提升了组织内部的研发效率。大厂逐渐不再需要传统的“螺丝钉”式员工,这意味着普通人很难再通过在不同大厂之间跳槽来获得安全感。
对于这种职场生态的巨变,田渊栋引用了科幻小说《三体》中关于维度打击的比喻:
> “有些鱼把水弄干了,弄干之后呢,那些其他的鱼就得不停地在跳。但是不停地在跳的时候呢,你会发现水总的来说是越来越少的。你永远找不到(安稳的地方),你最后一定要变成一个四维生物,你才能活下来。所以鱼要进化成鸟,长出翅膀来才能够生存下去。”
在这一背景下,未来的求职者必须摆脱传统机器零件的思维,主动去寻找自己独一无二的意义,成为自驱的创业者或联合创始人。
[01:05:14](https://www.youtube.com/watch?v=F7oNfszczVc&t=3914s) 前沿大模型乱斗:从技术路线到组织架构 针对主流 Frontier Labs 的竞争格局,田渊栋重点谈到了 Andrej Karpathy 加入 Anthropic 的行业信号。他认为 Karpathy 此前在 Twitter 上直播自主科研(Auto Research)并将报告开源的举动极具影响力,他加入 Anthropic 明确聚焦于预训练和自动化科研,这证明了“递归自我改进(Self-Improvement)”和“自动化科研”已经成为行业公认的主流路线。
目前在代码(Coding)赛道上,尽管 Anthropic 凭借 Claude 系列势头迅猛,但各大模型的差距并没有拉开到绝对性的一步。田渊栋自己在同时使用 Claude 和 Claude Code,发现它们依然存在严重的幻觉(Hallucination)问题——会在被指出错误后迅速道歉,但无法事前避免。OpenAI 的 Codex 5.5(应为 GPT 等相关系列)产品力并不差,只要 OpenAI 愿意追赶,差距很快就能抹平。另外,开源领域的 DeepSeek-V4 表现也相当不错,虽然在初始阶段需要约 1 万个 Token 的“预热”才会变聪明,但这些技术瑕疵后续都可以被解决。田渊栋提出一个行业担忧:当模型能力超越用户需求的上限后,用户对超出的性能将不再敏感,届时技术先发优势可能会被削弱,行业甚至可能演变成彻底的价格战。
在 Coding 之后,田渊栋坚信下一个“The Next Big Thing”将是 AI Research(AI 自主科研)。因为大模型人才的成本极其高昂,如果能实现模型自身的自动化迭代与科研,其投资回报率(ROI)将是天文数字,比如发现新药、新材料或者自我进化出更强的新训练方法。
谈及其他大厂,田渊栋指出 OpenAI 和 Anthropic 随着商业化收入(Revenue)的激增,已经从纯粹的科学实验室转变为了必须平衡资产负债表、削减成本(Cost)的商业实体,这也解释了为何 OpenAI 会选择关闭 Sora 等高耗能项目。而对于 Google,尽管 Gemini 2 和 2.5 时代饱受质疑,但 Gemini 3 的推出再次证明了其深厚的技术底蕴。Meta 方面,田渊栋作为大股东披露了利益相关后,评价其新推出的 MuSpark(应指 Llama 系列或 Meta 最新多模态模型)在多模态理解上表现优异。虽然 Meta 近期因裁员以及“强制蒸馏员工工作数据用于训练模型”引发了巨大争议,但田渊栋认为从公司利益出发这无可厚非,只是自上而下的高压和“炼化员工”的对立情绪,可能会诱发员工隐蔽的消极怠工或在数据中“埋雷”。
最后,田渊栋指出,像 xAI 以及 Meta 此前 Lama 4(应指 Llama 4 研发期)遇到的开发受阻、表现不达预期等问题,本质上都是“先进生产力与落后生产关系”的矛盾。当前线大模型的 Scaling Law 还能靠大厂的惯性再卷一阵子时,前沿模型的胜负手,实际上已经从纯粹的技术之争演变成了组织架构与管理效率之争。如果团队缺乏向管理层 Push back(据理力争)的空间,高管层施加的激进压力最终会导致团队给出虚假的交付承诺,从而引发组织地震。
- **RSI 团队规模**:目前约为 25 人,未来计划逐步扩充至 40 人左右的舒适规模。
- **RSI 办公室选址**:位于旧金山市中心(San Francisco Downtown),因为该区域人才密度极高,方便与各类初创公司交流。
- **办公模式**:实行混合办公,三分之二员工在旧金山,三分之一在伦敦,员工每周平均来办公室 3 天。
- **团队文化**:极其扁平,没有独立的管理层办公室,所有人坐在一起。沟通风格崇尚 Technical(技术导向)、Direct(直接反馈)和埋头干活,尽量减少无意义的会议。
## Notable quotes
> [00:00](https://www.youtube.com/watch?v=F7oNfszczVc&t=0s) 最顶级的资本还是看人。 — 田渊栋
> [25:32](https://www.youtube.com/watch?v=F7oNfszczVc&t=1532s) 语言绝对不是思考的本体 — 田渊栋
> [50:42](https://www.youtube.com/watch?v=F7oNfszczVc&t=3042s) 大语言模型真正的涌现能力和对数学、逻辑结构的深度理解,依然沉淀在预训练阶段。因此,光靠压榨强化学习,其上限是完全被预训练死死锁定的。 — 田渊栋
> [55:00](https://www.youtube.com/watch?v=F7oNfszczVc&t=3300s) 大公司目前存在明显的“趋同化”现象,其方向往往由高层自上而下决定,容易流于追逐热点。 — 田渊栋
> [01:05:10](https://www.youtube.com/watch?v=F7oNfszczVc&t=3910s) 有些鱼把水弄干了,弄干之后呢,那些其他的鱼就得不停地在跳。但是不停地在跳的时候呢,你会发现水总的来说是越来越少的。你永远找不到(安稳的地方),你最后一定要变成一个四维生物,你才能活下来。所以鱼要进化成鸟,长出翅膀来才能够生存下去。 — 田渊栋
> [01:05:14](https://www.youtube.com/watch?v=F7oNfszczVc&t=3914s) 当模型能力超越用户需求的上限后,用户对超出的性能将不再敏感,届时技术先发优势可能会被削弱,行业甚至可能演变成彻底的价格战。 — 田渊栋
> [01:22:35](https://www.youtube.com/watch?v=F7oNfszczVc&t=4955s) 前沿模型的胜负手,实际上已经从纯粹的技术之争演变成了组织架构与管理效率之争。 — 田渊栋
## Mentioned
田渊栋, Recursive Superintelligence, RSI, Meta, FAIR, Anthropic, xAI, Amazon, Apple, Microsoft, Richard Socher, MetaMind, Salesforce, U.com, 熊蔡明, Tim Rocktäschel, Google DeepMind, Genie, Google Venture, Jakob Foerster, AI Scientist V2, Nature, Josh Tobin, OpenAI, Alexei Dosovitskiy, Doom, Vision Transformer, ViT, Tim Tian, 田天, Cresta, GPT-5, Coconut, Lupi Transformer, SSI, Safe Superintelligence, Ilya Sutskever, Gemini, Yann LeCun, AMI Labs, David Silver, Ineffable Intelligence, AlphaGo, AlphaZero, Thinking Machines Lab, Google, Sergey Brin, 三体, Andrej Karpathy, Claude, Claude Code, Codex 5.5, DeepSeek-V4, Sora, Gemini 2, Gemini 2.5, Gemini 3, MuSpark, Llama 4
[Source](https://www.youtube.com/watch?v=F7oNfszczVc)
Original transcript [0:00] 大厂不像多人了所以大家就得找到自己的意义今天的这期视频播客我们来到旧金山城里嘉宾是我们的老朋友了田园洞田园洞作为Meta基础AI研究实验室菲尔前研究总监在去年被裁员之后历经半年他最近是官宣了新动向与其他七位顶级研究员一起创立了新的AI研究公司Recursive Super Intelligence简称RSI融资6.5亿美元估值达到46.5亿美元这个令人瞩目的新实验室想做什么样的事情为什么资本会如此看好它们那么过去半年AI市场的格局迅速变化它又如何看待模型技术的趋势与平顶你是正式的官宣来到了RSI半年前接受这么采访的时候其实已经差不多定了很小很精通对白信做成成为一个大的趋势但RSI有八个co-founder在没有任何产品出来的一个前提下为什么觉得资本会对你们买账呢最顶级的资本还是看人recurse of self-improvement你为什么觉得这个方式很关键用AI来优化很多的AI自己的一些东西AI变得更强用AI来做新的发现我们可以增加人类社会进步的速度如果说你们的最终目标是10的话你觉得我们现在大概是在一个什么样的阶段也许我们现在在1和2的位置上你们Lab会从pre-training从头开始做吗是商业化方面有任何的思考吗连带速度可以屁股你们为什么要把自动化AI科研作为第一步我们应该把目标关放得更长远一点如果我们对科学的研究的过程本身有建模的话你可以拿来做很多事情你怎么看世界模型我觉得语言跟视觉相比语言还是一个更加有信号的东西有一些前沿的路线是想把Diffusion跟LLM有一个组合速度上来说肯定会变更快Pre-Training的上线其实是决定了LL想法学习的上线这样的事也是我的观点对吧所以有可能是错的你说大家迟早全部做到事业的了四和五的这些工程师他们的能力就是AI很多事情其实可以做Coding之后的下一个The next big thing是什么我觉得是AI researchOpenEgg and Duabeg的一个比拼你会觉得是什么样的一个结果谷歌还能够追上来你觉得X3发生了什么就是说Macha你怎么评价没有错话大模型又永远赢家应该这么说我前沿大模型之争其实最后变成了一个组织架构之争应该说组织架构在这次的技术进展有很大的一个角色Manta最近有点争议他们要强制针流远空这个事情他吸引大法进客练花之后然后你就被踢出去的话大家都会开心不太顾忌有种感受吧感觉是个大趋势了他就相当于就是一条鱼在水坑里面跳水总来说越来越少了所以你能不能找不到你最容易一定要变成一个四位生物你才能活下来那么接下来就跟我走进RSI那以下就是我与田圆栋的专访非常感谢圆栋欢迎来做客硅谷101非常感谢你们又过来我们可以继续下轮的采访现在我们上次聊的时候其实过了半年的时间然后我知道当时你刚从Mentha出来你当时跟我说已经有很多的团队跟公司在跟你接洽了那其实现在你是真实的官宣来到了RSI能不能跟我们说一下为什么最后选了这家公司对应该说这么说吧其实我当时半年前这首顶采访的时候其实已经差不多定了对,其实应该说是一个比较快速的决定的过程然后呢,我其实也有不少人张识联系我应该说在10月底到11月初这段时间之内我的手机基本上是被打爆的状态然后我所有的message我就属于不能回复因为太多看不过来对那最后还是选了这个觉得对于现在的就是大模型的这个趋势来说呢应该说团队小型化然后那个团队的那个速度变快然后团队之间的摩擦变少然后很小很轻团队把事情做成了成为一个大的趋势有这个趋势之后呢你再在大公司里面再待着呢可能就不太方便对,其实我也经验目睹过很多的这种大团队有大团队的一些问题吧当时也不少的那个大团队来找我的当时有Astrophic的,然后有XAI的有Amazon的,Apple的,Microsoft但是后来你会发现再过在找我之后的可能大概两三个月之后有很多人当时找我的人都走了对,大家看到了很多的这个消息对,当然我也就不一一列举了其实这个原因是因为对大团队来说,他们组织架构比较臃肿,或者人比较多,就一定会有问题,对CEO是非常挤,希望这公司能成功,他就会有很多的命令或者指示,去到下面去做,但对大团队来说,他就要花很多很多时间去试试。
[5:00] 就是上面的这个这个要求然后同时呢对齐啊下面员工的一些啊想法和愿望那如果是这样的话呢那这个过程这个速度呢是应该说是远远慢于小团队的这个对齐速度啊所以你会发现就最近有很多的那个大公司大团队他们平凡的会relog啊平凡的会裁员啊会那个改变自己的方向和战略而主要原因还是因为这个组织沟通上的速度是根本已经跟不上AI的发展速度啊所以是这样的一个当时我毕竟在Meta我也待了快11年了所以我也是能亲身都感觉到了这样的一种趋势所以这段时间之内就是正好麦也给了这个机会那我就去过一个不一样的人生大概是这样的一想法那其实当时来找你的可能也不只是RSI这一家的startup跟Nelab对吧为什么时候选了当时是Richard Suter亲自来找你的然后为什么选择了这一个团队我觉得应该是这样吧就是说一个是这个团队刚刚组建所以当时我也跟Richard还有蔡敏还有Tim Brokish都聊过所以我觉得一个是团队刚刚组建所机会应该比较大是一个人另外就是说这个团队里面我有两到三个人我以前认识而且其中像Tim Brokchell跟我以前是同事他以前也在那个Meta在Meta伦敦做reinforcement然后我在那个加州这边做reinforcement所以也比较熟吧同时呢这个团队纲组建所以也是一个很好的一个机会蔡明跟我之前也有很多connection所以有这个Connection之后我觉得其实可以尝试一下可以做一下这样的事情那么其他的很多的创成统他们也来找我但很多时候这个机会相对来说是稍微没有那么好比如说他们希望招聘员工或者说希望让我进来做比如说像Head of AIHead of Research这样一个职位那么当然了对我来说要创业的话那你希望做KofFounder更好一点那当然是有这个机会但RSI有8个Cofounder啊这个还挺罕见的当时是怎么样一个Side-up能不能给我们讲一讲我觉得是这样吧因为每个Cofounder他们的expertise是不一样的他们各自有各自的擅长的地方和比较欣赏别人的地方所以相对来说我们这8个人还是比较互补的有这个互补的基因的话而且大家都是聪明人嘛所以我觉得合作起来其实也比较顺利那么跟我们介绍一下这八个co-founder你们各自分别负责什么样的工作领域呢像Risha Sos大家可能知道他一直是做CEO的角色他之前创立了Metamind然后被Salesforce收购了收购了之后,他在Salesforce待了4年做Chief Scientist之后他出来开一个新的公司叫U.com现在也是有盈利,还是不错的现在他又出来为我们这边的CEO然后像熊蔡明之前是跟Richard一起做Metamined的他们被Salesforce一起收购了收购了之后,在Richard走了之后曾蔡明他就成为了Salesforce Research的 Senior VP然后在Salesforce 带了十年多了时间还有比如说像Tim Rockshaw他以前是我在Meta的同事他在Meta待了四年之后他就离开了Meta去了Google DeepMindDeepMind是Project GenryGeGenry 1,2,3的一个Lead然后这个是大家都知道做世界模型的然后同时它也Lead了一个Team,叫Agent Openness那么这个Team的方向其实应该说跟我们现在做的方向是非常接近的是非常有相关性的那么它其实在Google的口碑是非常好的其实我们融资应该说它有很大的一个贡献就是说它其实在Google口碑非常好所以Google Venture当时他们做背调然后给了一个非常好的分数然后比如说还有Jeff KulonJeff Kulon也是做Agent of Man-Agnist这样的一个方向他的团队其实在过去的10年里面一直在做这个方向应该说非常投入非常深入然后他们最近的篇文章叫AI Scientist V2这篇文章其实已经被Nature收录了所以应该说这个方向上它的虚拾影响力是非常大的像我们这边还有那个Josh TaubinJosh Taubin他是以前OpenAI的早期员工然后他自己出来开公司之后公司把OpenAI收了之后又回到OpenAI做Agent Science Lead他在Agent这方面有很大的经验然后还有工程上有很多经验
[10:00] 然后他就到我们这儿来是这样子那么还有一个像AlexeiXC Dolorsky他以前是很早以前是做强文学习的我大概十年多以前就认识他当时我们是都是做强文学习的当时有个游戏叫Doom是叫毁灭战士那么我们当时是一个track的第一名然后他是第二track的第一名所以我们通过这个方式我们是认识的后来他去了Google做那个Vision Transformer它也是Ring Transformer的一作Ring Transformer是一篇非常有影响力的文章它第一次把Transformer带入了Compute Vision这个领域然后证明了就是数据量足大的情况下Transformer在Vision上效果也很好那么这篇文章其实影响力非常大那么它其实是在里面做很大的贡献那么之后呢它离开了Google然后去了比如说一些小公司AI for Science公司那么它现在过来也是给我们做客房的所以应该说还有比如说像那个Tim 10天0对吧但是之前Cresta的CPU对吧他在Cresta做了很多年的时间然后把Cresta做成一个非常好的公司那么他现在对这个Recursive对我们这个愿景有很大的很大的这个兴趣然后他就离开了以前的公司他把CTO的事物都辞了到我们这儿来做联创所以这么八个都是非常顶级的人非常核心的AI researcher跟从业者然后继续在一起你们不会打架吗我觉得每个人都是非常的有自己想法的人如果你们遇到不同的意见怎么办对我们还是比较民主我们会有很多讨论很多思想上的碰撞和考虑对然后最终呢还是会有一些想法和逻辑大家同意的一起做的所以应该说就是至少目前为止我们的合作还是相当好而且大家都聪明人嘛就是自己和聪明人合作其实应该说是比较省心的大家都希望花很多时间很多精力然后把事情都做好然后把盘做大我觉得这个其实是一个很好的一个状态你们宣布的这轮融资我觉得还是挺让人瞩目的然后留着5亿美元的融资46.5亿美元的估值在没有任何产品出来的一个前提下为什么觉得资本会对你们买账呢?应该是这么说吧我觉得资本其实还是看人的最顶级的资本还是看人的因为投资融资也好然后比如说最终的商业愿景也好最终的产品也好在AI这个变化非常大的领域里面其实很难在一开始就讲得非常的清楚很多时候是这样就是说你今天说我们要做这个然后过两个月发现谁谁谁又出点新东西那么这个时候团队要怎么应对然后他是不是很快的执行力做一件事情出来这个其实是最重要的应该说资本最重要的还是看人的判断人的以前的经历还有人的能力和团队参与之间的一个磨合和合作的程度这个是最重要的所以这么多这个钱进来这么多人愿意投资我们其实还是能看中我们以前的履历和我们对于这个愿景上的一个投入你在其中主要负责的部分是哪些因为我记得上次我们聊的时候你说像一份工作想做工程家前沿研究结合的这样一个岗位因为我在说这句话的时候我已经知道我差不多要来了所以买了一个伏笔我大概说的时候我心里在想我不能跟你说,我不能跟陈倩说我已经加入这家公司了,或者说我现在加入这家公司因为这还是保密的但是呢,我也希望给大家说一些比较明确的一个路径所以大概是这样的,确实就是我现在来了之后呢也是大概是这样样一个结合因为我们这边以前就是像我和蔡明是做modeling做的比较多的那我们还可以继续做这个modeling做一些建模做一些训练后训练这样一些工作对吧然后工程上也有一些东西可以做像agentic的hanness我们也可以做一些那接下来我们就聊一聊公司聊聊RSI首先你们的这个名字RSI是Recursive Super Intelligence的缩写所以可以看出来这个Recursive它中文叫地归式这个技术是一个关键词非常的重要能不能给我们介绍一下RSI主要想做什么然后Recursive Self-Improvement究竟是什么样的一种方式然后你们为什么觉得这个方式很关键我觉得是这样就是Recursive Self-Improvement的意思就是说我能不能用AI来优化很多的AI自己的一些东西然后让AI变得更强动作方式在做财富再踩上去大概是这样的一个逻辑那么具体来说呢就是说我们希望用AI做很多的就是现在需要人工来做的一些事情比如说像科学家发现新的想法新的逻辑发现科学家像那个比如说训练的过程需不需要用AI
[15:00] 来做强化用AI来做新的发现这个其实都是在我们这个Recursive里面的那么我们最终的愿景是希望就是有一个很好的系统就是这个系统里面就是我放进去各种各样的计算资源然后输出的时候能输出这个新的知识新的那个新的见解新的这个新的洞察力当然是这样的一个一个东西对所以其实我们Recursive的网站上就说了就maximizing the only discovery rate对不对所以通过这个方式呢我们可以增加人类社会进步的速度然后提高人类社会对新知识发现和新知识理解的一个能力然后目前我们看到比如说千言大模型OpenAI, Anthropical, Google主流做法还是依靠人类去设计模型然后手机数据然后大规模的训练然后人工标注对齐那我听你之前有一些分享你认为说这条路上人类是一个瓶颈然后你们压述的是让AI能够自动化研发过程是不是?然后中间能不能跟我们展开来解释一下怎么能实现?对,因为其实应该说现在人类或者说研究员其实在做研究的时候或者在做AI发现的时候大部分时间还是浪费的也不能说浪费,就是说因为人有自己的生理极限嘛对吧你要吃喝拉撒你要睡觉所以你没有办法100%时间花在这上面所以很多时候呢就是如果用AI来至少代替或者说用AI来做一些人类认为比较繁琐比较繁重的或者说比较重复性的劳动这肯定是可以的这是第一步那么第二步呢就是说我们是不是能够让AI在这劳动之上能不能自动发现新的一些洞察新的一些重要的这样的信息然后用它加速AI的整个人类发展的进程那AI系统学会的东西它是一个真正的能力上的提升还是在某个评估指标上的过拧合呢你觉得当然希望AI最终能达到人类上提升因为能力上提升就是说可能AI现在能做比如说相对来说本科生能做的事情那么我们希望AI以后能做数字生或者博士能做的事情或者说更高的比如说研究院能做的事情我觉得这样的程度是我们想要打达到的你说benchmark这个事情应该说是这样就是说你刷榜或者说各种榜单是达成这个目的的手段因为这个手段本身是比较虚的或者说是比较高层次的你要把它真的break down或者把它分解成一步一步的这种小步骤的时候你基本上每一步可能都有一些metric有一些number那么这个就是benchmark所以当AI系统它开始自主的去设计实验自主的去评估结果那人类还可以作为一个可靠的评判者吗然后你们怎么去解决所谓的evaluating the evaluator也就是评估者本身也需要被评估的这个必规的难题呢我觉得是这样了就是说至少现在AI还是达不到人的这个评估的那个标准我觉得所以至少在一定程度之内人类还可以作为评估者这个没有问题然后另外一个第二个点呢就是说就是等到AI厉害到一定程度之后呢应该说很多的评估标准变得主观了而不是非常客观比如说你拿AI写code比如说你发现就是AI对于这个就是人类的指令非常的遵循遵循的非常好那已经做得很好那再往上走比如说你要让AI去做一些人类的设计比如说这个代码怎么设计怎么怎么安排各个模块之间的关系那么这种问题上来说其实每个人的境界是不一样的那么这样的话你就会有一个subjective的有主观性的这样的一个因素在里面那么这种情况下其实应该说已经很难有一个正确答案了所以总是每个人其实我有自己的这个想法大家都是对的在这种情况下其实并不存在说人类的能力达不到的水平很多时候是就是依照每个人的想法去完成这种事情那怎么评估呢这个时候其实很难去评估这个数字就是说你可能最终看你最终结果对吧我与其说评估中间的状态不是说OK我加AI或者说人类加AI最终得到一个东西能够让大家喜欢或者说能够完成某件事情那就可以了所以这个评估就成了就是从这个中间的benchmark到最后的这个结果的评估所以这个评估会往后走这是我的一个预测就会变得非常result drivenresult driven那么中间这些过程其实变成了一个非常自由的一个地方就是你可以做一个想做的事情但最终目的是人家AI最终得到一个结果这个结果是想要的那这样的情况下可解释性这件事情还重要吗因为你之前也提到过就是无论skilling最终成功还是失败可解释性都是必须要解决的如果成功我们需要确保超级AI不作恶如果失败我们需要理解为什么模型在某些地方崩溃那比如说在你们RSI的这条路上当AI可以自己修改自己的
[20:00] 代码或者权重,AI可以设计出一系列的实验的时候那可解释性这件事情会不会变得更加的困难?我觉得这是非常重要的,而且应该说比原来更重要一个当然是关于Safety的问题我们在Launch Recursive的时候,其实非常注重说我们要做Safe的Super IntelligenceSafe这部分其实一个方案就是说通过可解释来完成因为对如果说你对这模型的那个内部机制有理解和有一些想法的话那你就大概知道这个模型是怎么work的那么这样的话呢你就知道这个模型本身啊它对于就是将来可能会有什么样的威胁和问题啊所以这是一番重要的地方然后另外就是说科解式性的本身也提供了一个非常好的一个指标啊去找到一个那个能够更快的找到我们想要的东西啊就比如说你要做那个啊你做这个recursive self-improvements其实它背后是意味着你需要大量的算力组的事情比如说你可能需要花几千块卡或几万块卡比如说训练一个模型那么如果你在对模型本身不理解那你可能只能等到这个模型训练完毕之后你才去预测或者才去评估这个模型好不好那么这样的话这个速度就很很慢那如果有可解释性的话呢那我们是不是可以把这个评估放在前面去完成那如果是这样的话那我们是不是能提高这个预算效率所以应该说可解释性在这个过程中拥有很重要的角色所以你们内部还是有人正门去研究会有的那你们的设想是让AI系统长时间的自主运行去追求研究者定义的这个目标同时产生出超出人类预想的新思路但是超出人类预想和社区控制之间的边界在哪里你们打算用什么样的机制来保证这条线不会被越过我觉得其实还是一个是重要的可解释性对吧就是说你如果知道这个模型在发现的过程中找到什么东西了然后这个东西你们可以让人来做evaluate这个是一个重要的然后模型本性的机制都可以如果能够被inspect的话那么我们就可以通过这方式然后来判断这个模型究竟是越界了呢还是发现一些新龙现在没有越界这是很重要的你甚至可以用另外一模型去比如说去验证这个模型是不是好的这个都是可以的所以应该说在这样的一个就是越难的问题上来说就是说我们希望这个模型找到一些人类做不到的事情同时希望这个模型安全那这种情况下就是我们不能代替模型去发现新东西那我们就得知道模型是怎么想的模型是怎么去思考的模型是不是有一些疯狂的想法有一些地方是超过了我们想要了它做的事情这个其实就是小科技之心我记得你谈到自己在用GPT5的时候的一些感想然后当时你发现模型能够帮你做很多事但是它缺乏高层的人类洞察力和专业知识然后目前仍然需要人类去引导但是RSI的路线和目标恰恰是让AI能够自主的提出实验的假设然后自主的验证然后也就是说要自动化对不要人类的洞察力这件事情你怎么解释这后面的矛盾呢还是说现在技术其实已经有进展了然后改变了你的想法应该是这么说吧就是说正因为现在AI做不了所以我们希望AI能做是这样一个逻辑所以你们选了一个更难的这样一个入境正因为AI做不了那就说OK这就是我们将来研究员能发挥的地方那么我们当然希望开公司让AI能做这事情这个是一个重要的一个点至于就是这个事情本身不是0到1的就不是说是要做不出来就做出来就不像无人车无无人车说你要不在路上100%路上就撞人了不行对所以就是它其实有很多层次的对吧也许AI今天能写代吗但是AI读不了paper然后明天AI能读paper然后AI还是理解不了这个问题的本质那么后天的话也许AI能理解一点点了但是AI还不能理解太难的问题对它会有一层一层的这个层次上去所以它就有很深的一个阶梯在那里那阶梯到能跑到什么程度我们先并不知道但是我们是能往上爬一点那么每一步呢其实应该说会带来大量的一个应用场景和一些可能的这个方向所以应该说就是这个本身是个非常吸引人的有东西那么对于研究员来说当然是希望永攀科学高峰嘛所以这个肯定是一个很有意思的这些地可以走那如果说你们的最终目标是10的话你觉得我们现在大概是在一个什么样的阶段我觉得我们现在还是在那个1到2到3的阶段吧对吧甚至我可以说我们现在可能就是0.5吧因为这个阶梯应该说非常非常高能有多高这个是不知道的因为它可能会这样就是假设我们希望人类的边界是10对吧也许我们现在在1和2的位置上对吧但是过了边界之后也许好像有100那部分我们是不知道的就是你要翻过那一座
[25:00] 才能看见后面的身有多高是的而且在那个时候其实人类编辑会往上走因为人家AI能力很超过我们以前的人的最优水平像最近OpenAI他们发现了一些就是能证明一些完全非平凡的定理那么这个事情其实应该说对于以前的人类来说是很难想象的但是现在你会发现正定理把以前定理都正完了它的新闻的频次是越来越快了所以我想以后应该会出现这种情况你当时在Meta其实比较重要的工作之一就是Coconut然后这个方法就是说让AI在连续的潜在空间里面去做推理做Latent Reasoning然后我很好奇说Coconut的相关研究在RSI里面还会有一个继续的去推进吗然后我也很好奇说你怎么想当前的Chem of Thought的路线以及你接下来的研究工作会不会对这个方向有一个积蓄的往前推演对 我肯定还会做的 这个是没有问题当然具体细节来说我们毕竟是公司嘛 所以很多事情我们不能讲太细对 但是对我们来说我们如果有一个很好的machinery就是我们有一个很好的系统能够做自动化的研究啊自动化的那个理解的话那我们可以用这个东西来继续做研究对吧那么这样的话其实我们的研究更像是一个product对吧我们可以说我们的系统非常厉害然后那个我们做着很好的工作来那么这个工作我们本身可以publish我们本身可以拿来就给大家示威说我们很好的结果至于这个东西怎么做出来我们可以做一个黑盒子我们可以说是我们公司的一个secret source然后刚才我们也稍微提到了一下就是那个Latant reasoning所以你会认为说当前的Chain of Thought的路线是错的吗我觉得当前Chain of Thought的路线不是错的一个是非常实用大家做到用所以肯定不是错的但是我觉得人类在思考问题的时候最终还是需要一个非语言的媒介来做这事情其实至少对我来说我在思考问题的时候其实我并不是需要用语言来做的很多时候是有图像的成分有一些是一些比较说不平道不明的一个思路然后在这个思路里面发现了一个问题然后我把它写下来变成语言所以语言更多情况下是一种解释而不是说是训练的一个或者说思考的过程而且其实我们当时在作品文章的时候我们也发现就是如果通过就是Latant Reasoning来做思考的话那么这个Reading的Path这个过程应该说还是效率应该比这个语言要高的为什么呢是因为Latent Reasoning就是每个Latent Token它里面可以存的这个信息其实是高于每个语言的Token的Latent Token你可以存很多信息比如说你可以同时存几个不同的思路同时存在一起然后最终呢这里面有一个思路是对的那么你这个路径就出来了但如果你要有语言去想的话你就得人工去写下来每个数是什么对一个一个出来对所以这个效率就是不一样的所以这个至少在原理上来说只能看到这个不一样的地方那么当然了具体的在实现和最后的运用场景上来说可能还是有各种各样的不一样的地方但是这个方向本身也是很有意思而且现在你会发现就我们之前这篇CorelandPaper应该说已经有很多的很大很多Citation有很多很多人在这上面做很多拓展当然包括最近有一些LUFI Transformer这样一些结构它本身也是Latent Space然后它也有很好的效果应该说这个方向本身建议应该是有很大的方向很大地方东西可以挖的我觉得也许以后可能是一个有意思的突破点你觉得现在哪一家是比较重视这个方向的?我听说Anstotropic的Mysos model它用的是Lupi Transformer但我也不知道是真的是假的对,这个是一个可能的路径因为为什么大家说这个呢是因为我们大家看到Mysos它在一些图上搜索的问题上它的效果比之前的模型好很多很多所以有人就在怀疑是不是他用了一些新的架构但这个问题你去问A加的人他是不会回答之前你其实有跟观众分享过顿悟的研究能不能再跟我们展开聊聊以及最近有没有什么研究上的新的进展新的进展我就不说了因为我们这边也是比较保密我们不希望有更新进展马上说出来但是你还是在研究这一块对,最后肯定是在做的这个没有什么问题确实应该说这篇文章在发出去之后我收到不少人来信对说挺有兴趣的而且当时跟我说这篇文章我做了一个拓展然后你能帮我看一下其实我也挺开心的有很多的这个有很多的人愿意来找我跟我去讨论这个问题对所以我觉得顿路本身应该说是很有意思
[30:00] 一个问题就是这个模型怎么样从就是记忆然后突然变成一个泛化这样的过程那么这个过程本身呢是应该说是能解是不是能解开整个神迹网络的训练过程的这个秘密的所在应该是这样子对,那么这边然后主要的逻辑就是说我们在一些比较具体的比较那个结构化的数据输入的时候呢就是说你会非常清楚看见这个模型从记忆变成了那个泛化这个过程这过程本身可以通过一个比较清楚的数学过程来描述比如这里面有个能量函数这能量函数在数据不足的时候它得到的最小值都是记忆的解但这个数据足够大到多多因程度之后突然之间这个能量函数的结构就变成了泛化的解那么这个过程就是动物的过程而且我们可以知道我们究竟需要多少数据能够产生这样的一个变化所以这个其实是很有意思的一个过程那么这过程如果理解清楚的话那我们是不是就可以对时间网络的训练过程有更好的理解我们是不是有更好的效率提高这个速度这个的研究其实还是我理解比较早期的阶段我们现在知道多少数据可以对 就是我们有一个就是这边主要还是比较偏理论嘛就是说就是在这个设计设计下我们可以说如果我们总数据是m平方数量级的我们就需要m log m的这样一个数据就是说可能比线性多一点但是呢也没有太多就比总数据的数目相比的还是少很多的你们俩不会从pre training从头开始做吗我们都在照测试吧对因为pre training呢一个也比较好的地方是因为一个是他他本身的这个训练过程呢比较smooth它这个loss curve比较稳定所以其实是一个也是一个挺好的一个方向所以你们什么都会自己做对会有一些就是目前我们还处于这个探索阶段嘛对嘛我们会有一些不同的方向都会去试那在产品方面或者是商业化方面对有任何的思考吗对我觉得这个是我们现在已经有一些思考了对应该说我们这个团队呢是一个非常落地的实际的团队就是团队里面应该说有超过半数的人以前开过公司然后也知道就是怎么样落地怎么把产品做好怎么样去满足用户的需求所以其实应该说就是我们内部在聊的时候很多时候就是说话和讲的那个故事和聊的那些内容都非常接地气就是说是非常实际的说这东西是不是能用那东西是不是能用这个东西是不是可以赚钱或者说可以那个make commercial的那个benefit这个都是在在实际的说这东西是不是能用能不能用这个东西是不是可以赚钱或者说可以那个没 commercial 的那个 benefit这个都是在讨论的其实但应该说就是 self-improvement 的这个方向呢又会有很多的事情可以做很多的那个东西可以完成比如说比如说我们是不是能够训练一个模型让拿这个模型的 inference 变得很快对吧那其实是不是我们就可以让这个 inference 的 speedInference 的 efficiency 变得很高这个当然是可以的对吧比如说我们找到了新的recipe那么这个recipe是不是可以有更好的结果这个都是可以commercialize的或者说我们对这个模型本身的或对人类在做研究的过程中它的思维方式做一个很好的建模的话那么是不是可以拿它来做一些很难的人类社会人类能做的一些研究我们是不是可以让AI来做这都是可以commercialize的但是现在目前看起来就是这个方向本身呢应该说还是比较开放的有很多事情可以完成你们现在其实因为八个人嘛然后你们现在有一个非常有共识并且清晰的这样的一个技术的路线图了吗对我们差不多是有一些我之前看有报告说就是你们第一步呢是要训练一个具备五万名博士能力的系统来自动化AI科研本身然后计划是在今年年中所推出一个level 1的自主训练系统比如说在level 1之后肯定还会有level 2, 3, 4大概的这样迭代速度可以披露我们目前是现在可能在一开始的一年到一年半里面我们会把这个系统很好做好然后做深入然后之后我们就想办法让它落地压制到一些更好的一些use case大概是这样的一个时间我看到那个Sortial之前有在采访说就是说要构建你们要设想的这个技术可能需要好几年的这个时间才能够完成那在你自己的心目当中这个RSI从自动化部分的科研到真正的地规自我改进再到超越人类的整体的能力每个阶段的时间点大概是什么样子的我们需要多长的时间能够完成这件事情以及如果我们要达到这样的突破的话技术上面有哪些是关键的信号呢我觉得其实还是要几年的时间就是目前应该说是一个很好的是点切入的因为在这个时间点内就是大家开始形成的共识就是说以后就是说研究或者说以后就是新的知识获得
[35:00] 发现这个问题肯定还是让AI来做因为人一是没有这么时间和精力去看文献另外二是说人不像AI那么有大的广播的知识然后又有无情无情的时间和精力然后也可以让一个AI做很多事情就是说你可以有几千AI同时进行所以这个事情也可以让AI来做所以这个一定是个趋势这没问题但另外就是说这个时间点比较好的地方是因为大家现在都不知道怎么做所以也在探索阶段所以像这样一个时间点就是大家有这个excitement同时呢大家都不知道怎么做呢是一个很好的节点开始这件事是个旅程吧旅程非常长但这个旅程可能要持续比如说好几年的时间才能开始有美目有一个结果这个我觉得是肯定会发生的对大概是这样技术上来说呢应该说就是说这个技术比较好的地方是它到每个层次呢应该说都有一些应用价值不管是在什么地方它不像有些那个方向呢就是说要不全部做出来要不全部做出来不是这样子像比如说如果你要去找比如说新的材料你要找新的核聚变或者说超导的这样的一个solution那么这个bet就很大要不就是100%就是你真的成功了要不就是你没有办法成功但是如果是做这个self improvements的话就是它每一步的这个进展它其实都会有一些应用价值所以总的来说应该说这个趋势是比较平缓的所以我觉得这也是一个我对这个技术比较有信心的原因之一就是这点还挺有意思的因为我也想问说你们为什么要把自动化AI科研作为第一步因为就是它这个商业化毕竟还是会更困难一点相比起比如说一些比较2B的落地的一些企业服务或者消费的产品那为什么你们选择这个作为起点而不是一个更容易产生收入的方向因为如果你要想更容易产生收入的方向那其实一个问题就是在于大家会时刻担心你用的这个为这个产品的收入产生的具体技术会不会在明天或者在下个月被AI取代这个其实应该说是硅谷或者说是很多投资人的一个很大的一个痛点当然说今天我们可以拉很多人团队我们做一个单独的事情比如说我们要做云赢伴或者说我们要做来三句助手或者我们要为某个垂直领域把一个事情做得很好但是这件事情本身呢就是之前其实应该说在过去的三年里面已经有很多的那个量力证明就是说那个为了某件事情做一个那个比较特殊化的一个模型做的事情呢也许有一天会被一个大的一个比更加一般化的模型给取代或者说给给给给给给给盖掉所以有这样的一个concern之后呢其实应该说我们应该把目标关放更长远一点对吧就是说我们希望就是在这个范式上花时间花精力这个范式说我自我家自我进化这个范式这范式只要不变那我们的公司立场是不变的那么在这范式之下我们再看有没有什么好的应用有没有什么好的可以商业化的机会我觉得这个是一个比较好的立足点我看到Sucher也在采访中说到希望RSI之后把它的应用范围扩展到物理学、化学然后还有临床、生物学等等那在你们Vision当中RSI未来的一些具体的应用场景是什么样子呢比如说谁是你们比较想重点Target的用户群体对这个其实是RIF for Science当然是其中的一个因为如果我们对这个对这个科学的这个研究的这个过程本身有建模的话我们知道就是人是怎么样去获取知识人是怎么样去获取信息的怎么样去得到新的假设新的逻辑然后怎么样去验证然后最终怎么样产生一个有意思的没有不平凡的结果过程我们如果建模建得很好的话你可以拿来做很多事情像刚才我们说了AI for Science这样一些方向那么这个本身就是一个很大的一个市场我们可以做然后本身呢另外就是说我们是不是通过这方式能够提高研究人员的效率然后提高整个研究过程的这个自动化的程度那么这本身能够提高比如说大模型的本身的训练一个效率这本身可能就是也是一个非常重要的一个commercialization的一个方式那其实这个领域竞争也慢慢的变得激烈起来了我们看到OpenAI特别是DeepMind它自己有AlphaFoldAlphaEvolved他们其实也是在做AI for ScienceAI自主科研包括刚才我们提到DeepMind的AlphaEvolved已经是能够用LIM不断去变异和组合算法比如说这和你们的recursive self-improvement有什么样的根本性的不同呢?以及你们的差异化优势会在哪里?我觉得一个当然是大公司和小公司的区别就是说大公司有大公司的BET小公司有小公司的BET对吧,大公司的BET往往是这样的就是说大公司非常多人,几万个人然后可能会有一些研究团队做一些不同方向的事情
[40:00] 但是呢这个一个是对大公司来说这个BET可能是一万中的一个或者一百中的一个对所以他们不会因为因为这个大BET获得很多资源这个是一个问题然后大公司的那些人他们的这个incentive就是说他们这个薪酬结构啊和对于就是目的的这个追求啊就本身呢可能跟小公司也是不一样的小公司说OK我们的使命或者我们的目的就是要做self-improvement那么如果是这样的一条方向的话那小公司会集中所有的能力和所有的资源把所有的事情都花在一个地方把它做出来那么这样的话呢小公司其实应该说是更focus的这个是一个重要的点那另外那个EvaEvom呢其实一个就是说他们还是用AI去优化某个具体的一个比如说一个代码或者什么的对吧但是我们这边希望AI来优化自己就是你刚才也说到说现在是一个很好的timing很好的时机去做这个事情为什么去年不是好的timing为什么明年不是好的timing为什么今年是最好的探明?应该这么说吧,因为去年这个时候AI的coding agent 还没有成熟因为大家还是在用AI辅助coding比如像cursor这样子用AI辅助coding的话大部分时间你还要写代码然后让AI去审核去修改去重构但是应该说去年年底基本上跨过了这个突变点然后突然之间大家发现让AI来做一件事情然后人去下命令去找一些high level的一些想法这个模式其实是更有效率的所以为什么现在AI Coding ToolsAI工具现在变得如此的易用或者说如此的普及所以这个时间点是不一样的那么在这时间点过了之后应该说有很大一段时间人整个应该说整个软件工程行业整个科技巨头他们都需要花时间去适应这个过程那么这个过程本身应该说是小公司弯道超车的一个非常好的时机因为大公司可能需要一年是两年的时间去慢慢适应新生产力工具到产生的变化但是对小公司来说特别是如果小公司非常小大家都是很厉害的人他们聚一起就很快能够fake out找到一个方法能够一起合作那么这个过程应该说远远快于大公司这样的适应过程那么在这种情况下也许小公司有这个能力去追上大公司会有很大的这个upside对 所以应该是这样吧那么所以但是如果你再过一年的话可能就已经晚了对吧对吧因为大家都适应了之后呢你再去创业这可能也是一个很大的一个问题我觉得说这个timing非常对就是也是为什么我们最近看见很多new lab出来很多的核心的研究员从大公司出来以及我们看到很多的VC的资金开始涌向了这些new lab了那现在看一下就是new lab的这个版图然后能不能跟我们来分享一下就是你对NeoLab是怎么看的因为我觉得大家是有很多的派别Elia他的SSR然后盐洛坤的AMI Lab然后包括David Silver然后包括Thinking Machine Labs就是能不能比如说这四家比较典型的公司能不能跟我们来分享一下你对他们是怎么看的首先是EliaElia的SSR应该说非常保密我们现在都不知道它内部在做什么所以也很难评价,我们现在不知道,希望它接下来又会有很大的进展但我们现在并不知道现在内部情况怎么样他们之前的口号是要做SAFE,就为它忍死,对吧?就是安全的人工,超人工智能,但是我们现在并不知道怎么样你觉得它会也是要做模型的,对吧?但是能不会做像GBT或者是像GIMLAI或者是QAWD那么大规模的模型因为它虽然融了很多钱但是可能它的钱也不够支持它去完全做一个新的模型出来这个不好说吧比如说我们发现了一些新的模型的训练机制也许能够极大的提高训练的速度和效率这些是有可能的这个就是不知道的因为我一直觉得现在AI的训练过程应该说还是不是很有效率的如人发现就有很大的所以他有可能是在研究一个新的范式有可能是这样但是这个我也是在猜因为这些猜测都是基于伊利亚去年的一个访谈他就出来做了个博客然后又没有声音了因为其实很有意思的是伊利亚去年的访谈跟我们之前贵物要领埋我们一起做那个访谈很多东西是很接近的比如说像做research your taste对吧,像就是他也在考虑比如说就是为什么模型会泛化对吧,那么generalization,memeralization这些东西其实都是有的我很好奇啊,就是你们在跟VC聊的时候他们对于这种长期然后也不发什么产品然后我就mentally研究
[45:00] 我也不知道他能不能研究出来现在VC的资金对这件事情的tolerance有多高呢就是包括你自己在跟VC聊的时候你怎么感觉这件事情我觉得其实VC很多时候还是投人嘛对 我觉得这是很重要的大家觉得这个人靠谱然后这团队靠谱的话那么至少第一笔的融资应该还是主要是看这些那么之后呢就是说如果还要想融资的话当然希望这团队有进展有一些很有意思的非常让人觉得印象深刻的东西那么才会给你更多的融资是这样子所以应该说我们团队的内部尽量还是比较顺利的应该说是好于预期吧对所以我们还是很有信心的你们这一轮这么多前期的run位会有多久其实run位也就一两年两三年的时间吧大概是这样子因为毕竟大部分的基准资源还是需要那个钱需要这个资金去投入的对那么如果我们有比较多的资金我们会有更多的那个GPU很多资源,探索更多的事情,这是我们现在想做的事情你怎么看世界模型的?你觉得Yang昆的AMI Lab能做出来吗?Yang毕竟是我以前的老板,应该是这么说个Yang这边它是探索一个完全不一样的方向对吧那么这个不一样的方向应该说是一个很有应该说是应该说之前的人探索的程度不足的一个方向比如说那个世界模型特别是在那个视频上的在图像上的一些世界模型那么可能怎么跟Robotics能结合这个其实很有意思的问题但因为我对我来说我可能也不做视觉很多年了啊我现在基本上都是做language所以或者说做一些这个symbolic的和那个neural的一些结合吧应该说就是那么图像这边呢就是我可能不太不太熟悉有批评说觉得JEPA这些视觉模型还是太早太早还要再找到一些新的关键图仆才可以是有一些当然我这边是有一些也不一定这个事情是一个那个非常公正的opinion但是我这边还是有些我评价就是说我觉得语言跟视觉相比呢语言还是一个更加有信号的东西对像对于视觉模型来说就是视觉图像的问题在哪里呢就是图像它里面这个像素和它们像素之间的组合相对来是固定的对吧你现在看到这个杯子这个杯子在那了然后呢我们就知道这杯子形状是什么样子然后你就知道这些像素组合是个杯子但是对于语言来说语言里面的信息有很多时候可以重新定义的还可以定义很多新的东西比如说你今天说了一半说我们定义新概念吧这新概念是什么意思那么以后这个词可能就会指向之前的所有的新概念的那个定义那么所以说语言可以无限嵌套它可以自指它可以有很多的这个新的这个信息和新的深的这种理解在里面所以我觉得语言应该说它的上限可能会比图像更高一点这是我的一个观点但是我必须是对的只是一个想法我看到现在有一些前沿的路线是想把Diffusion跟LM有一个组合去做一些DiffusionLM的东西你觉得那个路线你自己看好吗我觉得这个其实一个速度上来说肯定会变更快其实我们之前应该说在我离开Meta的时候也有一篇文章是做这个的就是怎么样能够让Diffusion叫那个Sandwich那么这个就是说我们能不能以更快的方式来训练比如说那个Diffusion Model用强火学习来做训练是有一篇文章所以我觉得我们的我的感觉上是这样就是它加速上来说是非常好的能够很快的加速然后提高这个decoding的速度但另外一方面呢就是它现在还是没有到这个sota的水平还有很多的问题还是做不到就是像大元模型那样那么厉害所以这个还是有定距离但是还是一个很好的方向可以去做研究然后你怎么看这个David Silver的Inneffable Intelligence我理解他也是一个专注于RNL想法学习然后他目标呢也是要打造一种能够通过自身经验自主探索的学习知识的这样的一个超级学习者你觉得他们跟你们有什么一统吗据我所知可能David Seward他们这边可能更多的像是就是希望完全不用大模型对这可能是跟我们的区别对我们这边还是比较实在就是说如果大模型很厉害我肯定用大模型然后找到更好的方法来训练大模型这都是可以的对那么David他可能更想要做一个就是纯粹是用这个强势息来把这个事情做起来的这样的东西因为DVC的时大家都知道就是AFAGO和AFAZERO的那个主要发明人对吧那么AFAZERO其实就是完全没有人类的任何的知识通过左脚踩右脚踩上去的那么他当然希望在大语言模型或者说在现一代的大模型
[50:00] 这个范式下重现这个故事我觉得这是它的一个愿景当然我之前也做过像OpenGo这样的project其实也是就是类似于AphaZero这样的就是做到台的财政区但我觉得围棋毕竟还是一个或者国相其实还是一个比较局限的一个领域然后这个领域里面它的Evaluation的function或者说胜负的评分应该说都是定义的非常清楚的所以可以做到这一点但是在做一个就是比较开放式的方向其实很难做到这一点所以可能需要大量的算力这个算力现在可能很难满足我看到行业里面有种说法是pre-training的上限其实是决定了RL强化学习的上限你同意这样的说法吗这个确实我是同意的我们确实也发现了就是强化学习后训练它的目的它的很大的功用就是说你把原来你排在比如说第200个的答案把它放到第一个去这个方式可以让模型做一些问题做的比较好但这个条件是这个问题一开始答案至少有一个是对的比如说你让它踹个比如说1000次1万是也许大部分答案是错的但是也许有一到两个答案是可以的有这个种子之后呢强化学习可以通过这个种子把它慢慢提到最高通过这个方式呢来提高这个水平那么最终如果种子都没有的话那强化学习在做还是没有用的这是为什么就是强化学习产生的效果是因为在大元模型已经变得比较成功之后才会有这样子如果你只都强调学习的话你其实他没办法去生成一些比较深的东西所以其实我这边是觉得就是大元模型的最关键的地方呢还是他在预训练他预训练他在训练之后呢他里面的各种各样的这个那个表示呢就是涌现出来了涌现出来之后呢这也表示呢其实能够一程度来说就是能够解释那个数据上的一些结构然后一定程度上的发现或者说能够学习数学中或者数据中的一些有意思的推理模式那么这些推理模式在强化学习中慢慢的被放大然后最终得到一个答案是这样的方式那么如果前面部分的推理模式没有学习的特别好的话那么后面强化学习再做是没有用的所以它光是来压制强化学习这件事情还是上现实对上显示对对对这也是我的观点吧对吧所以有可能是错的对对对你觉得数据还能怎么样发展吗因为现在其实大家这个模型的这个这个参数情况已经是穷尽了所有互联网的数据了对对对那接下来大家就是看更多的这种这种Synthetic Data对对对然后这个数据还能够怎么样更好怎么样从数据上去优化模型的结果呢对我觉得数据上来说还是很重要的就是现在数据应该说很多的大量的用户数据大量的人类数据都已经被用上了那么接下来一个问题说我们能不能制造一些新的数据其实应该说最近这模型一波的大进展很多时候原因是因为我们把推理模型的数据放回了以前的虚拟训练或者说中训练的过程中我们从这方式这个模型变得更强然后就达到了一些一个自我进化的一个初步的目的应该这么说吧 对吧那么以后你可以想象如果我新的模型更强了之后让它伸了很多数据然后把这些数据放回预训练或中训练那是模型会更强这也是一种可能性 对吧当然这个过程本身比较慢就是需要花大量的集团资源来做这事那么接下来怎么办呢就是有人就会提出来叫连续学习叫肯定议斯论领实际学习那么实际学习就是说我希望新数据放进来之后呢能够学得很深但同时呢不用花那么多代价那所以就是为什么大家会提出概念这样的原因但是我觉得就是最终的目的呢还是就是现在可能数据上数据是一个非常重要的一个点能够很快能够让这个模型变得很强但模型最终变得跟人类一样强或者拿到人类上的效率呢可能还是需要看有没有好的算法有没有好的那个新的这个范式去训练这个模型本身所以这可能是最大的问题当然了就是目前如果按照现在范式走的话呢数据还是很重要的对因为如果数据的范式不改变那么数据越多确实效果越更好Thinking Machines Lab怎么说呢应该说就是我对他们也没有特别了解应该说是有一些那个我看他们最近是发了一个就是Human computer interaction,intactive model,这个模型效果也还是不错的,有很多的你可以跟它一直的说话,然后不用打断它,它会一直倾听你的话,那么正过这个方式你可以获得可以跟那个模型产生一个独立交互的这样的一个效果,就是持续交互嘛,不需要是这个turn by turn,而不是持续的交互,这个应该说是挺有意思的,
[55:00] 那么之后就是他会不会就是走比如跟着Human End的这个公司一样路线呢这个我就不清楚那这可能是更多侧重于人和AI如何交互这样的一个方向其实我们刚才就是聊了一些就是New Lab大家在压住的路线嘛然后如果我们从一个更加宏观的一个角度去看现在的New Lab的一个发展的话你觉得New Lab大家互乘河到底在哪里然后以及大家最主要面对的挑战是什么我觉得其实最终还是挑战一个我觉得重要的一个点是如何在这样一个new lab的这样一个环境下能产生research结果能产生很快的产生一个progress这是重要的因为很多new lab的那些成员以前都是比如大厂来的或者说是资源丰富的地方来的他们说我们做实验我们就花很多钱把实验做了可能这个实验花了几百个million或者一个billion但是这都是公司付的钱对所以应该说对于这样的新成立的这样的一个小公司来说像我们这样的lab来说或者说需要融资的这样的一个实体来说我们一非常重要的想法就是说我们怎么能让学习过程变得更有效率我们希望整个迭代过程然后整个流程发现更加有意义然后同时能发现新的新的东西这个其实是一个很大的挑战我觉得是这样子所以其实你说我们是不是还会用传统的Skilling Law来做这事情这个其实是需要考虑的对就比如说我们以前一些朋友比如说他们在大厂里面在一些资源空间的地方那么对他们来说资源可以是无限的或者说是相当充裕的那么可以用可以做各种各样的方式找到一个很好的这个skin law把事情做成但是对于我们来说我们可能需要思考就是成本啊思考各种各样的那个强调的方法去绕开就是大量的计算资源的这个堆叠然后获得更好的结果可能这是一个很大的挑战很大的挑战如果一个人只有Skin Law这个思想的话可能不太容易成功你还是需要在Skin Law之外还有什么其他的一些新的对问题更深的理解那么就能成功就是要看research test了是的因为你刚才也说小的lab肯定会比大公司跑得更快而且小的公司他们可能押注的技术路线可能目前也是大公司他们现在还没有时间去搞的他们可能现在卷coding然后卷 frontier model那你觉得你们在押注的这些路线跟open.in.i.然后或者是googleanthropic他们在押注的路线一定是一个平行发展的关系他们会不会还是有一天会有竞争然后如果是的话这个竞争会发生在什么样的地方呢对 我觉得首先还是一个平易发展的一个关系吧对吧 因为对于那些大公司来说其实我也跟大公司很多人聊过我觉得一个问题是大公司一般现在是有一个趋势是大家趋从化原因是因为大公司很多的方向和方案都是让CEO或者说让高层定的但对高层的人来说他们可能会觉得因为他们往去追热点他们会觉得这个是我们想要做的事情因为别人也做了或者说别人做得很好了那么这样就会导致就是因为自商而下这个结构这样就会导致大公司之间就是相互之间的统治化比较严重大家做的东西都差不多就比如说Coding Agent火了之后然后大家都做Coding Agent因为所有人都觉得我要AI写代码对吧所以就算是你在大公司里面你想做些不一样的事情你会被这个环境和压力所逼迫然后去做这个跟大公司公司方向有关系的东西所以这个事情其实应该说是一个很大的一个趋势所以最终大公司可能会产生这样的结果就是大公司里面那些人他们没有这个能力不是说没有这个能力是有能力但是没有这个时间没有这个精力去做一些跟大方向不一致的东西这非常难了所以其实自然而然小公司它为了能够产生一个很快产生一个效益很快产生一个结果它自然会选择一些大公司不一样的方向所以它们是平行的那么只要等到以后就比如说小公司它公司业务做得很好了然后这个方向开始变成一个新的或者变成一个大家关注的一个新方向的时候可能会有竞争但这个是另外一回设计这件事情应该说在历史上已经出现很多次了对吧因为像Astrophic一开始做的是代码它做coding的时候其实应该说关注人很少我还记得应该说去年或者说前一的时候大家都在刷什么刷Math我们把AIME提得很高但是当时我记得Astrophic它就在每次
[60:00] 宣布的时候说我们这边不刷这个东西他们的模型放出来的时候没有Mass的Performance Number他们就刷这个Coding他们就把这个Coding刷上去那么最后发现大家发现这种确实能赚钱它是一个很好的商业模式突然间所有人都涌用过来了所以这个其实是应该说是以后会发生的一个常态吧所以要去小公司的成员就是有这个耐心和有这个眼光做一些方向大公司现在不做但怎么能确保说大公司看到这个机会之后小公司不会被大公司这么多的资源无限的资金然后给盖住其实也很难应该说首先第一个就是你不会觉得大公司真的有那么有效率你想那个你想Google现在也在追追给它coding嘛对对对除了那个anti gravity对那Google的coding其实应该说还没有做的特别好吧对吧还是有一些有一些大公司大公司的毛病这个都是会发生的而且其实应该在这种事情发生的时候应该说这小公司如果真的成功了那么它已经收了很多的钱收了很多的资金去投入所以那个时候小公司也有很大的librach你觉得现在你们面临的挑战包括招人吗你觉得现在大家抢人这件事情抢得厉害吗应该说这样我们这么说吧就是说首先一个就是我们公司确实还是比较那个受欢迎的有很多的人愿意投机简历给我们所以我们也挺挺惊讶的就是另外就是大公司招人小公司招人可能不是应该说是在不同的方向上招人对于大公司比如说你说TBD他们花很多钱招人那么吸引的人可能跟小公司吸引的人不一样对吧大公司吸引的人可能是那些就是说我有很强的技术能力对吧但是我觉得这个技术能力对大公司有用的但这能力本身可能不是那么新的这样的一些人对小公司来说可能有些人他们是愿意看我们的愿景我们这个方向是不是在将来会产生一个很大的影响所以这两边的应该说的mindset和思路是不同的所以不能说两边相互抢你们喜欢招什么样的人我觉得现在的我觉得感觉上是这样就是有一个是他有一定经验经验比较丰富的因为现在AI扣拥天之图非常强了对所以很多时候经验和品位和方向是更重要的但另外呢就是说我们希望这些人还是比较hand on的所以就说又有经验同时呢又愿意自己把事情做成的人这两个合起来是比较重要的所以你们不考虑毕业生这个也case by case你觉得现在毕业生还能找到工作吗就因为很多junior的工作其实我理解说你们都可以让agent去做了对吧对但是要看嘛就是如果毕业生本身是很厉害的他有很好的工作这工作业界知名大家都觉得这个工作非常好那也是有希望你现在这些年轻的那个researcher聊的时候他们更想去大厂还是更想加入NewLab的这种小一点的东西其实我这边有BIOS嘛对吧你说跟我聊的很多人说哎呀我们能不能来这儿我想去META等你去META的话就不会跟我聊了所以其实有一个safe selection对所以这是一个一个点对吧那么大厂也有大厂因为大厂往往大家讨论的是比如工资多少啊总报是多少啊然后有多少多少福利啊然后多少那个钱和股票对吧这样的一个但是对小厂来说很多更多时候谈论可能是比如说愿景方向然后做的工作内容还有是不是有意思这样的一些问题要做成RSI想做什么事情除了你们很强的八位联合唱试人之外你们还需要多少人然后什么样的一个规模你觉得是会比较舒服的对我们现在是25人左右对吧那之后我们希望能够比如说到40个人吧40人左右吧对大概是这样的一个规模但是这个也看看一个市场情况上变化然后你觉得就是现在整个的就业的版图里面在发生什么样的事情你看到的因为我记得在上次采访里面说你说大家迟早全部都要事业的你觉得半年过去了然后我们现在距离你说的那个场景会更近了吗我觉得是更近了你看Mata最近又裁了一些人对吧就是很多地方都要裁人对啊那个Amazon年初也裁了一些人对吧然后之后也还有其他地方会裁人原因是因为agent确实是对我觉得一个是AIAAIA确实就效率提高了就是以前的AI能力比如说相当于以前的就是四级或者五级的工程师嘛,大概是这样的一个感觉就是因为一般是营业毕业生刚进大厂的时候嘛,叫level 4这个可能是Google和Meta的这个level对吧,然后给说cine一点的话变成level 5是这样子,那么4和5的这些工程师他们的能力就是AI很多事情其实可以做的了
[65:00] 而且四合五应该说是在大厂里面比较多的对 所以确实很就是AI agent 来之后呢 确实有很多的影响对 就是我觉得以后可能会越来越多吧那说到这里呢 我们接下来来说一说现在主流的这些 Frontier Lab然后特别的想听一下你对他们的一些观察那首先呢 我们先来聊一聊这个 Anthropik吧你怎么看这个Andre Kvarty加入Andre Kvarty这件事情的圈内人大家怎么看我觉得一个是说明就是self improvementsautor research非常重要这个我觉得我们也很开心看到这个有意思的进展对吧因为之前Andre Kvarty在那个推特上直播了自己这个做这个autor research这个过程对吧然后把这个图像和把这个report都开圆了然后那个时间应该说很多人对着非常有兴趣然后也有很多人就是跟随了这个Astrophic的路线然后发现这个Auto Research这个路线可以做很多的优化所以应该说他在这方面他的这个影响力很大然后呢他也明确的跟大家说了就是他去Astrophic是做育群链是做Auto Research所以应该说这个就让大家觉得确实self improvements或者说self learning这个方向应该说是主流了或者说大家去承认这个事情是对的我觉得这个是很好的然后Androbic我觉得今年的这个叙事然后这个趋势都非常猛一部分也是因为它上市了一部分也是因为它的商业化确实做的非常增长的非常非常快你觉得它的这个优势能一直延续下去吗因为我们看到OpenAI它其实最喜欢Codex也追的很快我们刚才说到谷歌也出了Antigravity但你觉得就是整个Coding这一块的格局会延续着现在的这样的一个排位吗还是说有机会会出现一些变数的我觉得很难讲因为其实说实在并没有用下来就并没有觉得谁比谁厉害很多很多对吧就比如说Codex 5.5其实我用了之后我觉得挺好的我觉得就是Cloud Code我也在用嘛对吧 都挺好的但是各有各的问题 对吧就比如说Cloud Code有些时候会给你hallucinate对吧 我说这个答案是啥呀就是你给我组结一下可以说一大对话我说这有问题不错然后他说是的是的I'm so sorry就是很快但是为什么我在没讲之前才没说出来呢所以有很多地方还是问题不少而且其实应该说那个Codex它并没有差我觉得并没有差那个Cloud Code的差太多只要我朋友想追就是能力上面还有产品力上面是能够追上去对 我觉得是可以追上去就是看它的执行上的速度多快对所以其实我觉得像Google你说想追也是可以追的嘛你想Google最近他们成了一个strike team他们成了一个team我们就要追coding然后还是那个Sergey亲自挂帅对所以我觉得就是因为如果一个方向上特别火大家都知道还有商业价值那所有人都会去做它那慢慢就会产生就是各种沟通的方案对所以牙齐还有很多开源的比如说像DeepSeekDeepSeek before我觉得还挺好的当然它有一个问题是它可能一开始你必须让它预热一下比如预热1万个Token然后它变聪明一点一开始就有点奇怪但是过预热一段时间之后它就从来间变聪明了就可以做很多事当然有些问题但这些问题但是只是说但这些东西应该说都是都是可以解决的吧就是我觉得这事上这么大肯定会有很多人愿意进来大家会知道会飞嘎熬出来到底怎么办法做很好所以接下来这个份额怎么分其实很难讲其实我这边一直有个就是一个concern就是说因为对于用户来说用户并不需要非常强的模型他就他希望这个模型能力有上限就是说它向这种模型够用就行了就是说这是一条边对吧超过这个上线之后对用户来说它也并无所谓它就用它现在就用出复的模型就可以了所以如果大家顿倒知道上线继续大家是完全看这个价格了OK就可能会变这样了所以你觉得Coding它的先发优势没有那么的重要其实可能最后还是会有一个打价格战的这样的一个事情可能会有这个问题当然一个Counter Argument的时候我们也许能看到就是数据废轮的效应对吧?先发的人获得很多数据然后训练很好,这也是一种可能性对,但另外一方面就是说也许大部分写的代码都不怎么样重要的代码还是那些大神门写出来的所以这个废轮能转起来吗?也不是很清楚这个Android Mythos这个模型然后他们自己说太强了
[70:00] 所以不敢发布就真的有这么强吗这个我也不做comment吧因为确实从数字上来说很好对吧是很强对当然你看网上也有很多人在说其实不怎么样啊其实不强啊对所以现在也不知道这个就等到发布之后再讲所以你觉得Anthrobic模型它强的原因是什么就是除了刚才我们说的它可能是用了一个不一样的Vision Trust Formula的架构然后有可能它的这个数据上面有些数据给弄到Pretrending上面去重新训练主要是这两个点后者其实大家都在用就是说每个人在用后者就说我训练的时候我把推理练的结果放到前面预训练或者中训练里面去这个大家都在做这个我不觉得是一个很大的两创新所以有可能是模型上面有一个创新有可能是模型或者训练优化器或者说模型的recipe这个不知道因为这部分的信息现在是很少的所以你觉得接下来如果大家还要再继续解锁它模型能力上面的话可能真的是要拼这个模型上面的创新了对 我觉得应该是的一个当然是你有更多的卡有更多的机器上资源你可以做对 但是另外就是说我觉得应该是的就是说一个当然是你有更多的卡有更多的那个机器上资源你可以做对吧对但是另外就是说那个我觉得现在在网上就是你这样纯着PinkSkin Law的话很久它是一个指数的这个指数到一定程度之后大家都受不了对吧你要再十倍电力再十倍的资源不可能所以最终一定会撞到一个地方就是希望大家突然回过头来看一下有没有更好的方式来解决问题对所以这个一定会发生所以为什么现在New Lab大家愿意去投资吗也是个原因吗是现在模式不可持续然后Coding之后的下一个The next big thing 是什么最近很多人问我这个问题你觉得会是什么我觉得是AI researchAI research对 就是我觉得我们现在做的能不能让AI变得更强然后AI做一些research做的事情对吧因为Coding为什么那么火我觉得是因为主要因为还是在于就是写code的人或者说写code的RI很高我这个模型很强然后能够做一些本来需要高薪产聘请的人的工作因为有这个所以他才会revenue他才会有收入那么下一波你看因为现在大模型的人才也是非常贵的而且可能比鞋扣的人更贵很多很多那么当然就是能够让这个事情自动化那当然是有很大的RI的那你觉得AI research上面的商业化回报会跟coding一样是有这么大的市场吗这个要看就是你最终的AI research 你发现什么支持对吧 比如说你发现了一个AI for science 发现一个新药那就回报有多少对吧 你发现一个新材料 后来当时都讲多少对吧 你发现了新方法训练模型 回报有多少这个都是天文数字当然这些东西就是高风险高回报的事情然后OpenA跟Android的一个比拼你会觉得是什么样的一个结果短期跟长期来看你都可以说我觉得很难现在很难说吧因为OpenA之前有些问题是有很多的方向它都在做不是不太focus现在看着focus你就很难说两边谁比较好谁比较对吧这个就是问题所以这个我也很难评论吧就是我们看大家其实对用户来说因为通过这方式你有很多东西可以用而且价格会打下来所以不是坏事接下来就是决定他们胜负手的关键因素是什么谁能够找到更新的办事我觉得这倒不是因为代码本身已经很赚钱了接下来的问题是说谁能够让用户愿意去用他们我觉得这可能是重要的所以还是成品方面的竞争因为他们两家都已经在特别是introfic就是说他们最终他们主要的负责是revenue也很高也在往上走revenue一旦有了之后其实这么上来有一个问题就是一旦你开始有revenue了我希望有更多revenue了所以这个其实是一个很有意思的一个现象对吧对那其实那如果是这样的话那他们两边就会有这样的一根色比如说Shorti有Revenue说不然马上就赚钱了那么对问来说你怎么还没赚钱呢对你有很多Revenue但是你还是资本你这个你靠财很高对怎么办那么会不会有这个问题他们都要上市了你要不然就是削减你的cost为什么把sora关了对吧然后要不然你就再多挣点钱他一定要进入这个叙事之后那么这个逻辑有可能以前的一个reserve lab的逻辑不一样了reserve lab的逻辑是说我要证明自己很厉害我做了一个新东西出来你看没人做过吧很厉害超级impressive但是一旦他掉进了这个资本上的一个就是上市啊要做资本叙事要做这个revenue要做资产互债负债表的时候呢你就会回到了之前的就是商业模式就说你可以我希望我的公司
[75:00] 有revenue的,cost又低的,能够稳定赚钱的对,所以其实可能赛道就不一样了你们有一天也会遇到这个问题这个我们还早吧然后我们来说一下谷歌然后谷歌这次的IO发布似乎不太理想你觉得谷歌还能够追上来吗然后机会在哪里这个我就不多评论了对,我觉得还是我觉得谷歌还是很厉害的还有很多人非常厉害在里面然后愿意做很厉害的事情对所以就要领导层有这个重视的话一定还是不错的因为Google之前从当时Gemina 2, Gemina 2.5Gemina 2的时候其实大家一直在说它不行Gemina 3就很厉害Gemina 3就很好对所以接下来应该还是另外就是我们一个公司也是Google Venture投的好的理解然后来说说MataMata在你离开之后是经历过数字的重组然后他们之前是推了MuSpark出来,你怎么评价MuSpark?其实还不错的,我也用了一下我觉得应该说,第一个有利益相关就是我还是有很大的Meta股票感谢披露对,我很大买股票所以我也没有办法讲说可能说实话也不是很客观我觉得Meta的Muse Park还是不错的,还是有很多的,特别是动摩泰,对吧然后还挺好它的understanding,还有一些回答也比较好,都还不错当然总的来说应该说还是可能比Gemina3还是要差一点然后我看到有评论说Vue Spark它是一个为Meta自身产品场景高度定制的这样的一个模型而不是说一个非常强大的通用前沿模型那这是不是意味着Meta其实在AI的策略上就完全转向了就是说我完全就不拼这种最强大的general模型了我倒不觉得是这样我觉得它还是一个general的模型对对至少他从他内部的这个这个工作模式来说还是整种模式肯定先训练一个更整种的模型然后再就是说fine tune for the specific use case这个是这个是更好的就是说他们其实还是没有放弃说我要去那个争夺最强模型的这件事情对啊对不然的话就是就没有必要花很多钱做这个事你觉得他们还有机会吗机会还是有很多吧我觉得应该还有很多的因为毕竟大家还在往前走而且其实大模型一旦有个人训练出来之后不数几个月就会被领域超过大模型里面没有永远赢家应该是这么说对吧现在大家都是犬牙交错的往前走所以很难说所以需要的什么需要有一个人灵光一线那也不是这个还是需要一个团体作战对吧有很多的人大家把事情做好聘在一起就可以对就是大模型很多时候这点上我是挺同意姚淑宇的观点就是我觉得大模型特别是做这种工业级别的然后大厂做大模型很多时候是每个人都在各自赶快上经营业的把它做完然后拍plan通了之后就跑下就行但如果就每个大厂都这样的话那它差一点在哪里呢那就是看你做多细做多细然后你的工作做得多努力然后事情做得多好一些小的东西有些人注意到了有些人没注意到注意到的人可能就获得一些提升没注意到的人就没注意到没获得提升就是这样子所以你觉得TPT不还是有进规的我觉得还是有的吧对但是也要看他们内部怎么样operateMenta最近有点争议他最近就是宣布一方面是裁了7800人还要同时发生一件很有正义的事情就是他们要强制针流员工这个事情然后说要利用员工的工作数据去训练内部的AI模型这样的话他的AI模型就可以通过观察内部员工完成任务的过程来学习说他现在的能力已经是要好于外包人员了我看蛮多人挺身气质的事情你怎么看这个事情呢确实是军官艾书感觉上说的比较吃火热吧所以大家都会有一些意见是这样子因为如果你觉得你知道你自己在将来一段时间之内就会被蒸馏心情大法顶刻炼化炼化了之后然后你就被你就被踢出去的话大家都会开心的对这个其实应该说在做事情上来说应该比较就是不太顾忌有个感受吧这个其实是一个问题对应该说采源本身的过程中应该说我也会觉得是有这个问题一直在一直有一直存在但不管怎么样它是个大公司大家来了之后预言之后就要是院者上购那你来了之后他们有这个条款你就真是这个条款但是蒸留员工这个事情感觉是个大趋势了我觉得有一个人看
[80:00] 做的大家都会做所以这个没有什么对和错的事情对吧如果公司觉得为了公司的利益我要把这个事情就希望把公司的所有数据都拿到手然后把这件事情做成这个是无可厚非的嘛因为对公司来说这是我公司条款之一你来的话就得遵守这个条件但是呢我觉得以后可能大家会发现就这个帧流有没有有多大的用处可能是一个问题可能大部分人会因为有这个条件导致这些人不愿意工作的特别好不愿意把自己最重要的事情给给或者故意在里面买雷或者说买一些奇怪的东西让你去年搞坏掉制造一些叫你偷多什么这个所以就很难去判断所以其实我也不是很希望员工跟公司有这样的对立现在大家都在往一个方向上走但是感觉在非常high level的角度去看这个事情的时候还是不可避免的肯定越来越多的东西,公司希望使AI来做可能以后会发展的一个情况就是我公司确实不需要这么多人了这个是客观事实,其实我最近也写了一篇blog我也在说web coding的一些或者AI工具的一些体会确实我觉得用的人会要有手是这样子所以我去年年初我写了一篇Blog我说以后可能大家都是创业者大家都是Cofounder我觉得以后是会发生的因为最终大家大厂不需要很多人了所以大家就得找到自己的意义以前可能是你被教育传来教育了四年本科两年硕士五年博士最终你希望你的目的成为一个螺丝钉或成为一个某个大机器的一个零件但是现在已经不像大机器不像你的零件了就是你得自己去寻找自己的意义对吧就变成另外一种就是可能一种新的文艺复兴一种你可能回到了以前古希腊的或者说以前的那些状态就是说OK我们每个人都需要找到自己的自己的想要做的事情那么这个过程其实应该说是一个应该说比较痛苦的过程对但是最终可能会不会避免的发生这一天还有多远你觉得?我觉得现在就已经在发生了之后大家能找到的那就会找到自己的方向然后可能找到自己的新的模式然后做的挺开心的那就会变成新时代的一个样本就是一个状态找不到的话就比较难但是这个就比较难的地方整个过程应该说很快发生了可能在将来大概比较三年到五年内就会有很多很多人去面临这样的选择你会发现你去跳到大厂说鸡鸡大厂被裁了你跳另外一大厂过两天又被裁了另外一大厂又被裁了最后因为就是这样它就相当于就是一条鱼在水坑里面跳但是水就在干对吧对吧像前面有句话嘛就是说有人把水弄干了把水弄干了鱼不在这里面对对吧所以这个故事当时是来形容什么四维四维的生物把这个宇宙变成三维这样的一个伪手打击在这样的过程但是呢这个同样的故事呢可以用来讲现在的事情对吧有些鱼把水弄干了弄干之后呢那些其他的鱼就得不停地在跳但是不停地在跳的时候呢你会发现水总来说是越来越少的所以你永远找不到你最后一定要变成一个四位生物你才能活下来对所以你只要鱼要进化成鸟长出翅膀来才能够生存下去是的是这样子所以大趋势是这样子我们再来聊聊XAI你觉得XAI发生了什么就是如果我们按照刚才的这个思路来说我有一个团体我有资源有钱有人才对吧就是我应该能做出来还不错的东西但是就XAI发生了什么我反正听说是这样的就是说确实也跟LAMA4当时情况是比较像的老板还是希望事情很快能发生对但是呢就是说这个压力比较大所以就会导致很多问题导致问题之后呢你就发现查出来的模型可能不达预期啊或者说不是很满意啊那就会有一些问题就是都是这样子就是之前我也说了很多次就是一个组织如果这个组织里面的人他没有这个能力去push back或者说去反驳上面对他要求那么这个呢这个组织的人就只能通过某种方式来顺从这个上面压力但这个一开始这个顺从是可以的但是时间长了之后呢总有一天就会这个上面的人会发现组织的delivery跟promise是不一样的那么就会产生问题产生问题之后呢那你就会有一个shock就是很大的一个地震吧这个地震会打扰很多结果比如说其实那个人说LAMA4跟XCI的结果很像很像老板会觉得你们这些人我不相信你们
[85:00] 我们得外面再拉一个人过来然后去做这个事情那么原来这个组织里面的人可能就会比较就经营就比较惨听起来的话就是这种前线弹模型之争其实最后变成了一个组织架构之争是的应该说组织架构在这次的技术进展中有很大的一个角色应该说本来说是先进生产利益就是和落合生产关系之间的一个矛盾对吧可以这么说可以这么说但是你落入生产关系不可能一下子就消失而且我们现在都不知道什么是先进的生产关系所以因为落入生产关系在那了所以就会产生很多矛盾虽然大家说scaling law到头说了很久了但是目前呢其实那前几个大的lab还在继续卷scaling这件事情你觉得我们还能卷多久还是会卷的至少大厂里面还是会卷的有惯性然后大厂也有资源然后也愿意出钱出力出人所以还是会卷然后大家四个关键还是我们要Skin Law所以还是会卷一阵子我觉得这个小厂是有优势的因为小厂一个是人少然后特别是有一些人他们有自己的这个belief拼起来之后他会有更新的想法去贯彻下去所以销赏可能会比大厂有更多的有希望的地方但Skiller会卷到最后大家卷不动了那就会有其他的方式做出来最后能不能跟我们讲一下你现在的工作状态是什么样子的然后你刚刚跟我说公司因为刚开始大家充满了干劲对吧然后公司的企业文化大概是什么样子的企业文化应该说还是比较一个是比较就是相对来说说话比较直吧对吧 大家都比较direct然后愿意很快的给feedback很快的给大家那个反馈啊然后那个比较technical对 大家都是都是就是干活的就是大家愿意坐下来埋头的把事情做好做好之后然后你看这是我的结果然后这是我现在的那个效果然后大家有什么建议和建议什么的对 然后相对来说也有比较实在嘛也不是什么太划烧的东西有什么事情我们可以有话直说有话大家就可以把东西摊在桌子上然后大家讨论能不能跟我分享一个你最近觉得还挺开心的时刻的有 其实有不少但是我现在暂时不说吧有没有能说的比较开心的时刻应该说公司的launch比较顺利这个是很开心的之前我们准备了也有一阵子了然后融资也很顺利我觉得这个是很不错然后我们在发布之后应该感觉上正面的回复还是很多的大家也很有支持这个对公司来说是很好的第一步大家都会特别是外界的反响应该说还是比较正面我觉得刚才在采访当中你有一句话挺触动我的你说反正你去跳到不同的大厂你发现你水已经没有了反正你都找不到工作那接下来呢就是怎么去找到人生的意义这件事情其实是非常重要的是的对于你来说你怎么去找到你人生意义的这个其实我觉得在GPT4刚出来的时候我就写过一份布朗我说以后就是大家就独一无二就你们能做一件事情别人做不了的但是只有你能做我说只有你愿意去探索的这个是最重要的对不对然后你在独一无二上越走越远你一找到的,你获得的所有的数据,都是新的,都可以给别人分享这样的话,你相当于是一个行走的数据员嘛然后你获得所有东西,你都可以给大家分享的话,你对这个世界是有价值的当然这只是一个非常个人的体验嘛,因为每个人其实是不一样的现在还有时间写小说吗最前段时间比较忙但之后我会考虑一下最近AI的一些进展你自己的一些思考你觉得对写科幻小说是不是有了新的一些idea我觉得我有了紧情性紧迫感嘛如果再不写的话我的idea就没了就已经变成现实了对对现在感觉上写小说可能还来就是写的慢的话可能就跟不上现在AI的进展已经到这样的程度你可以让AI把你写甚至可以帮我写大家有自己的Io所以有办法能够让Io去掉然后能找到自己的想要做的想要写的东西写的比较好那感谢袁洞然后也期待你们接下来的可以宣布的一些新的进展然后到时候可以再聊聊好的好 感谢陈姐谢谢欢迎来到RecursiveSewer Intelligence谢谢你们什么时候搬进来的可能两个多月前吧两个多月前搬进来我发现很多的新那个实验室都是在City在那个旧新天城里面了对对对为什么呀大家都喜欢在城里面不喜欢在那玩我觉得这边就应该是人才密度比较高吧对有很多人有很多的出场公司在这里然后交流一下就没有办法方便对有很多很有意思的事情在发生对现在咱们那个团队有多少人啊现在可能有25个人所以大家都是可以有
[90:00] 的工作的吗还是必须要我现在上了就是有三分之二的人在San Francisco还有三分之一的人在这个在伦敦今天是周二下午就是都没有什么人了大家周在哪周二下午我觉得其实应该还有不少人其实在家里工作嘛但是我们一般一个礼拜我们可能我们可以一个礼拜来个三天嘛对我觉得你们采光还是挺好的这个大玻璃窗你的工位在哪里然后就在那边OKOK对这就是一个就是很随机的一个地方我们没有什么特别说有个地方老板要坐了有个地方公众要坐不是这样我们都坐在一起对然后这样的话交流起来比较方便OK所以没有单独的办公室是可以大家都坐在外面对你们开会多吗不太多对我们的目的当然是不希望开会我希望大家坐下来把事情做成觉得就是跟大厂区别还是挺大的应该是有很大的区别这边还是希望有事情大家做下来很快的交互沟通沟通完之后把事情都做成就好在跟Andre聊的时候他说有个研究员强烈的要求他们在办公室里面放一个桑拿桑拿的一个小房间你看我们这边有一个乒乓球桌做一个桑拿然后需要思考一下这个应该还没有没那么高级我们现在有乒乓球桌你打乒乓球吗会打你会打那么可以打打啥可以打我看已经有机器人可以打乒乓球了是索尼E最近有个机器人平常觉得打得不错那我就先这样那先这样吧感谢大家过来好那以上就是我和天元东对谈的所有内容以及RSI的Office Tour了那我们也会密切的关注包括RSI在内的Neolab的动向以及呢硅谷核心AI研究员的视频播客系列还会继续大家不要忘了关注我们的账号你们的留言点赞和转发是支持我们硅谷要连要做好深度科技和商业内容的最佳动力我是陈倩那我们就下期视频再见了Bye