维谛技术携手英伟达推Omniverse预制方案 押注吉瓦级AI工厂
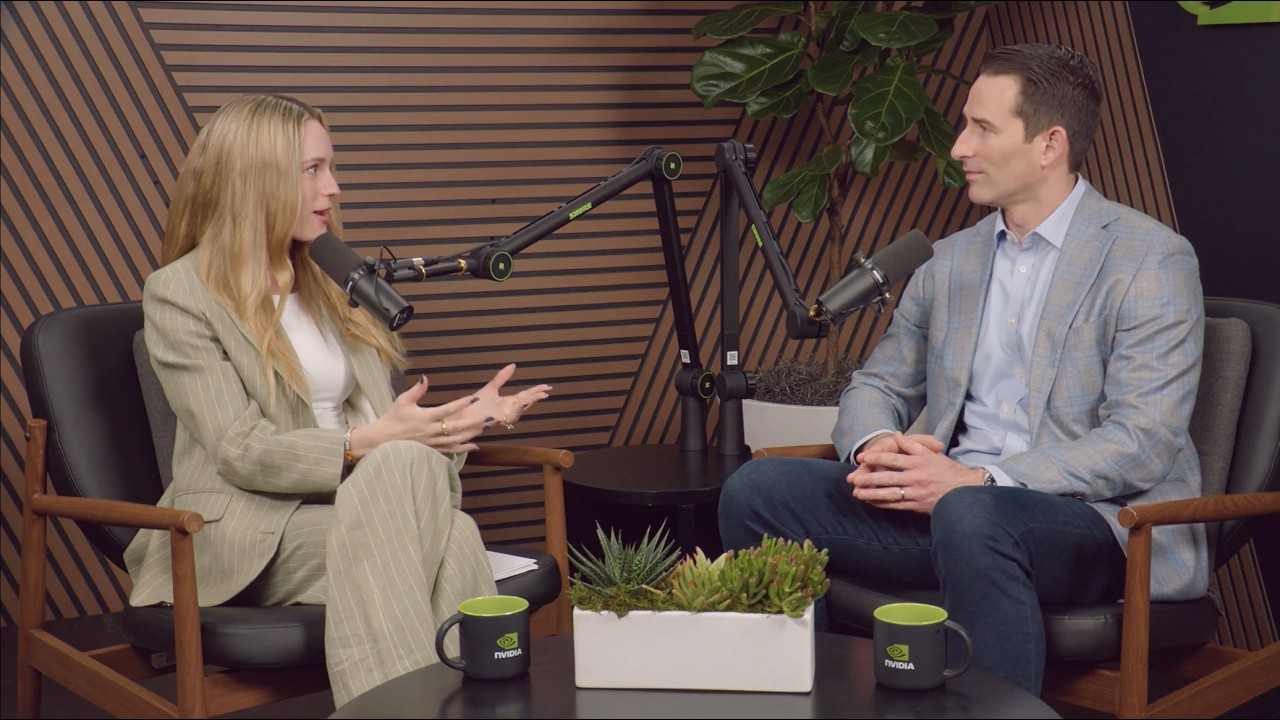
NVIDIA GTC Studio with Insights from Vertiv — NVIDIA

NVIDIA

维谛技术通过数字孪生将供电与液冷系统提前数个GPU世代逆向验证,以工业化融合预制彻底取代现场定制建造模式。

AI-assisted summary of NVIDIA GTC Studio with Insights from Vertiv — original source. Check the original for full context.

Source published:

Key ideas

  • Vertiv 与 NVIDIA 在 GTC 联合发布基于 Omniverse 的 Rubin 系列融合系统整体解决方案,通过物理级仿真在数字孪生空间中前置对齐电力与制冷链路,大幅缩短生成式 AI 工厂的“Token 产出耗时”(Time to Token)。 (3:34)
  • 传统数据中心建设正从割裂的“现场手工定制”转向“工业级融合物理基础设施”,通过预定义模块单元和标准化接口,避免现场返工并实现像汽车装配线一样的标准化预制交付。 (5:15)
  • AI 工作负载彻底颠覆了以往基于通用 CPU 服务器的设计逻辑,基础设施工程师转为围绕特定计算单元(如 SuperPOD)的功耗与性能特征逆向推导供电和冷却拓扑,从而将整座数据中心优化为单一超级计算机。 (8:59)
  • 面对单体数据中心迈向吉瓦(GW)级能耗的超级物理挑战,Vertiv 正在提前数个 GPU 世代进行逆向研发与技术布局,确保电力与液冷设施在下一代芯片交付前完全就绪。 (10:06)

Detailed notes

## Background 该视频由 NVIDIA 官方频道于 2026 年 3 月 30 日在 YouTube 平台发布。内容记录了维谛技术(Vertiv)首席产品与技术官 Scott Armul 在 NVIDIA GTC Studio 现场的访谈,主要探讨 Vertiv 如何在大规模扩展层面满足 AI 基础设施的严苛需求,提供现代数据中心背后的电力与制冷系统,并加速下一代 AI 工厂的设计与交付。

## TL;DR 访谈深入解析了 Vertiv 如何从幕后走向台前,成为驱动高密度 GPU 集群运转的电力与散热核心基石。Scott Armul 详细阐述了双方基于 NVIDIA Omniverse 平台打造的 Rubin 融合系统与数字孪生工程,强调必须告别传统的“现场手工拼装”模式,转向标准化、预制化的融合物理基础设施。随着 AI 工作负载要求将整座吉瓦(GW)级数据中心视作一台单一超级计算机来设计,Vertiv 正通过逆向工程提前数个 GPU 世代研发布局,确保基础设施在下一代算力芯片交付前即已通电就绪。

## Atmosphere & style 整场对话节奏轻快、专业且富有前瞻性,两位对谈者在轻松风趣的开场闲聊中迅速切入硬核的工程底座议题。主持人善用通俗易懂的生活化比喻引导提问,而嘉宾则展现出深厚的基础设施工程洞察,谈及万亿级算力背后的物理极限时充满行业敬畏与自豪感。整体氛围兼具工业级严谨与对算力革命的澎湃激情,让观众清晰感受到在喧嚣的大模型浪潮背后,底层物理世界正在经历一场惊心动魄的工业化重构。

## Bulletin - [03:34](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=214s) Vertiv 与 NVIDIA 在 GTC 联合发布基于 Omniverse 的 Rubin 系列融合系统整体解决方案,通过物理级仿真在数字孪生空间中前置对齐电力与制冷链路,大幅缩短生成式 AI 工厂的“Token 产出耗时”(Time to Token)。 - [05:15](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=315s) 传统数据中心建设正从割裂的“现场手工定制”转向“工业级融合物理基础设施”,通过预定义模块单元和标准化接口,避免现场返工并实现像汽车装配线一样的标准化预制交付。 - [08:59](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=539s) AI 工作负载彻底颠覆了以往基于通用 CPU 服务器的设计逻辑,基础设施工程师转为围绕特定计算单元(如 SuperPOD)的功耗与性能特征逆向推导供电和冷却拓扑,从而将整座数据中心优化为单一超级计算机。 - [10:06](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=606s) 面对单体数据中心迈向吉瓦(GW)级能耗的超级物理挑战,Vertiv 正在提前数个 GPU 世代进行逆向研发与技术布局,确保电力与液冷设施在下一代芯片交付前完全就绪。

## Key takeaways - [00:10](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=10s) 随着 AI 大模型爆发,涵盖供电与制冷(液冷/风冷)的数据中心物理基础设施已从行业幕后一跃成为支撑 AI 算力的显学焦点。 - [01:43](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=103s) 高密度 GPU 并行计算的核心瓶颈高度集中在电力输入与高强度产热的带走、排出乃至余热回收利用上。 - [03:34](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=214s) Vertiv 联合 NVIDIA Omniverse 构建 Rubin 融合系统,通过数字孪生在工程动土前对全链路物理动态进行精确仿真与软硬件对齐。 - [03:34](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=214s) 基于物理法则的数字化前置打磨能够有效规避现场接口不匹配,显著加快 AI 工厂上线并压缩首次“产出 Token 的时间”(Time to Token)。 - [05:15](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=315s) 传统数据中心长期受困于各厂商单点设备在现场的临时拼装与定制,面临极高的施工冗余与现场交涉成本。 - [05:15](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=315s) “融合物理基础设施”倡导以标准化的预定义积木(Building Blocks)和接口规范,实现一体化总成系统的出厂前数字装配验证。 - [07:23](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=443s) 在 AI 基础设施“五层蛋糕”模型中,Vertiv 处于最底层的物理基础设施层,是承载上层一切模型与超密集算力释放的基石。 - [07:23](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=443s) 面对吉瓦(GW)级超级 AI 工厂的扩展,手工作坊式施工容错率降至冰点,必须转向高度预制化的现代化工业装配模式以压低 TCO。 - [08:59](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=539s) 传统数据中心对 CPU 工作负载通用且不敏感,而 AI 基础设施必须围绕具体计算单元(如 SuperPOD)进行精准的逆向匹配设计。 - [08:59](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=539s) 通过对高密度算力 Pod 的电力传输系统(powertrain)和冷却架构进行全园区的协同缩放,整座数据中心被构建为一台统一运转的单一超级计算机。 - [10:06](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=606s) GPU 架构的迅猛演进正驱动数据中心物理基础设施经历“复合型加速”,促使研发团队跨越当前硬件边界提前攻克底层物理难题。 - [10:06](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=606s) Vertiv 的核心研发布局要求提前 2 至 3 个 GPU 世代展开逆向推演,确保吉瓦级供电与散热能力先于新一代芯片到场通电就绪。

## Detailed walkthrough ### [00:10](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=10s) 从幕后走到台前:AI 浪潮下的 Vertiv

在 NVIDIA GTC Studio 现场,主持人 Tiffany Jansen 迎来了维谛技术(Vertiv)的首席产品与技术官(Chief Product and Technology Officer)Scott Armul。Tiffany 坦言自己一直十分期待这次对话,因为 Vertiv 在幕后深耕多年的 AI 与基础设施挑战,如今终于被更广泛的公众所认知。对于这种认知度的跃迁,Scott 幽默而感慨地回应,在过去,Vertiv 在数据中心行业虽然至关重要,但对圈外大众而言几乎是默默无闻的,直到最近人们才开始真正关注他们是谁、在做什么。

Scott 指出,维谛技术本质上是数据中心层面的电力、冷却以及整体基础设施解决方案专家,负责未来数据中心的设计、预制与构建。虽然公司自身的强劲业绩和业务增长带动了一部分知名度,但与 NVIDIA 建立深度合作并共同研发关键基础设施,才真正让这家老牌基础设施巨头一跃进入大众视野,甚至正如 Scott 在录制前与主持人闲聊时所笑称的那样——如今连隔壁邻居都清楚他平时究竟靠什么谋生了。

> “Vertiv, we're the power and cooling and overall solutions infrastructure folks from a data center level.” —— Scott Armul

- 访谈主持人:Tiffany Jansen(NVIDIA GTC Studio) - 受访嘉宾:Scott Armul(Vertiv 首席产品与技术官) - 业务定位:涵盖数据中心级别的供电、制冷(液冷/风冷)及端到端整体关键物理基础设施的设计与预制。

---

[01:43](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=103s) 如何向普通人解释:驱动数千颗 GPU 背后的大脑与冷热链

当被问及如果向非行业背景的邻居或家人解释 Vertiv 到底解决什么问题时,Tiffany 分享了她当天早晨向自己母亲做科普的生动比喻:日常生活中大家所交互的各类 AI 聊天机器人,其底层模型需要数千颗 GPU 同时并行运算才能跑得起来;而这些高密度的 GPU 运算只需两个最基础的核心要素,那就是电力(Power)与制冷(Cooling),这也正是伴随 AI 爆发随之而来的最严峻挑战。

Scott 对这个通俗的解释给予了百分之百的肯定。他进一步阐明,无论是大众在终端查询聊天机器人、运行 AI 推理,还是进行任何现代数据中心的工作负载,所有服务器、芯片和 GPU 都必须承载在具体的物理数据中心内。数据中心首先要稳定送入电力以驱动芯片全速运转,但芯片在高强度计算时会产生极其庞大的热量。Vertiv 部署的一系列技术——无论是先进的直接液冷(Liquid Cooling)、风冷(Air Cooling)还是其他散热手段——核心任务都是迅速把芯片散发出的热量带走,将其排出机架、排出数据机房楼栋,最终释放到大气中,甚至设法对其进行余热回收利用,从而让整个 AI 工厂在提升运算能效的同时减少对环境的足迹。

> “That data center has to deliver power to that chip so that it can run. And effectively that chip creates heat.” —— Scott Armul

```mermaid flowchart LR accTitle: 数据中心能源与热量流动示意图 accDescr: 展示从电力输入到GPU发热,再由Vertiv液冷/风冷系统将热量排出机架并回收的完整链条。

subgraph PowerChain["供电链 (Power Chain)"] Grid["电网 / 能源输入"] --> PDU["高压配电 / 供电系统"] PDU --> GPU["GPU / AI 服务器集群"] end

subgraph ThermalChain["散热链 (Thermal Chain)"] GPU -->|"计算产热"| Cooling["Vertiv 液冷 / 风冷散热"] Cooling --> Rack["移出机架与机房"] Rack --> Atmosphere["大气排放 / 余热回收再利用"] end ```

---

[03:34](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=214s) GTC 重磅发布:基于 Omniverse 的 Rubin 融合系统与数字孪生

在谈及本届 GTC 期间的重磅消息时,Scott 重点介绍了双方联合打造的重大成果:基于 NVIDIA Omniverse 平台构建的 Rubin 系列下一代系统(Omniverse Rubin DSX)整体解决方案。从 Vertiv 的视角来看,这代表着一种全新的工程范式——一种覆盖全数据中心生命周期的端到端、预设计、预装配的融合系统工程(Converged Systems Engineering)。该方案将电力链路(Powertrain)、散热链路(Thermal Chain)、先进液冷系统以及数据中心废热排出等所有模块全部进行了标准化深度整合。

这一变革彻底颠覆了以往数据中心现场拼装的传统设计流程。Vertiv 与 NVIDIA 合作,在数字空间中提前预定义了所有软硬件接口与场地部署方案。借助 NVIDIA Omniverse 强大的物理级仿真能力,工程团队可以在工程现场还未“动土一锹”、施工单位尚未进场之前,就在虚拟世界中完全模拟出设备实际运行时的物理表现,精准掌握大规模芯片组、计算集群与服务器在特定微环境下的真实动态。这种全流程数字化的前置打磨,旨在极大地缩减现场交付周期,帮助客户以最快速度缩短达到首次“产出 Token”(Time to Token)所需的时间。

> “So within NVIDIA's Omniverse, we're trying to drive towards more physics-based and simulated types of designs to speed up a lot of the converged infrastructure approach so that long before a shovel ever hits the ground or a construction company is trying to put up a data center, we understand the performance of our gear.” —— Scott Armul

- 核心发布:结合 NVIDIA Omniverse 的预设计架构(围绕 Rubin 平台与新一代融合系统方案)。 - 工程逻辑:告别传统的滞后调试,通过基于物理法则(Physics-based)的精确建模与数字孪生,在 CAD 和 Omniverse 环境中实现软硬件接口的前置对齐。 - 业务目标:大幅减少现场工程返工,全面提升部署敏捷度,缩短生成式 AI 工厂的“Token 产出耗时”(Time to Token)。

---

[05:15](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=315s) 告别“现场手工定制”,迈向工业级融合物理基础设施

主持人对于数字孪生带来的速度飞跃深感认同,并特别挑出了“深思熟虑地规划”(thoughtfully)这一用词。Scott 借此深入剖析了行业痛点:传统数据中心的建设模式长期陷入在“现场量身定制”(bespoke on-site custom construction)的泥潭中。过去往往是由多家不同厂商独立研发互不连通的单点产品,运抵工地后再由咨询工程师、设计顾问或施工单位在混乱的现场临时寻找拼凑方案,引发了大量的施工冗余与现场交涉。

针对这种乱象,Vertiv 倡导的“融合物理基础设施”(Converged Physical Infrastructure)旨在摒弃华而不实的公关黑话,回归工业化模块思维。它要求从源头上思考预定义的模块单元大小(Predefined Block Sizes)、标准化接口点位以及交付部署模型。通过数字孪生中的物理仿真和全流程 CAD 配合,所有零配件在出厂甚至投产前就已完成数字装配验证。这意味着设备送达机房现场并完成上电试运行后,绝不会再发生因接口不兼容而临时修改设计的混乱,真正实现了由“单点优秀产品”向“一体化总成系统”的质的飞跃。

> “I think it's critical that digital twins are really an enabler for us to get out of this bespoke on-site custom construction world that we've previously lived in to something that is truly more pre-designed and thoughtful around the building blocks that have predefined interfaces and connection points...” —— Scott Armul

- 传统模式弊端: - 各类单点设备(Point Products)由不同厂商割裂研发,缺乏统一接口标准; - 依赖咨询顾问与施工队在机房现场“看菜下饭”,面临大量不可控的返工与调试复杂度。 - 融合物理基础设施核心: - 模块化积木设计(Predefined Building Blocks)与统一物理/电气/水路接口; - 提前在数字化与虚拟环境中进行真实物理受力、热能、流体等全要素验证。

---

[07:23](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=443s) AI 基础设施“五层蛋糕”中的基石层与吉瓦级工厂化扩展

在梳理完从单点硬件走向融合系统的技术演进后,主持人将话题引向宏观产业版图,询问在业界常讨论的 AI 基础设施“五层蛋糕”架构中,Vertiv 究竟处于哪一层。Scott 毫不犹豫地指出:Vertiv 正是位于最底部的“基础设施层”(Infrastructure Layer),也就是承载所有运算的最关键底座。

Scott 强调,底座的牢固与精确设计,决定了上层所有大模型与算力能否跑出应有的潜能。当这层基础设施被赋予深思熟虑、专为 AI 目标打造(Purpose-built)的设计标准时,才能完美对接引入数据中心的高压能源,并高效协同 DSX 这类超密集集群的运转。面向未来动辄吉瓦(Gigawatt, GW)级能耗的超级 AI 工厂,行业绝不能再容忍各工种与多方供应商在工地上相互扯皮、手忙脚乱的局面。唯有通过高度模块化、融合化的预制积木体系,才能将数据中心的兴建转变为如同现代化汽车装配线一样的“工业化制造工厂”,在释放超高算力性能的同时,显著缩短客户的上市时间(Time to Market),并有效降低全生命周期的总拥有成本(TCO)。

> “When you think about scaling to gigawatt levels, we can't be fumbling over ourselves and multiple parties and different trades all trying to work at the same time.” —— Scott Armul

- 基础设施层定位:在 AI 五层架构体系中充当承载全网算力运转的物理基石,必须在最初阶段就与电网接入、变配电及微环境散热深度耦合。 - 吉瓦级(Gigawatt)扩展能力:单体数据中心能耗迈向 GW 规模时,现场施工容错率降至冰点,必须以“交钥匙工厂化预制”替代手工作坊式建造。 - 商业价值落地:通过严密定义的端到端链路设计,为企业带来更优的算力利用率、更短的交付工期和更低的总拥有成本(TCO)。

[08:59](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=539s) AI 工作负载如何颠覆数据中心传统设计逻辑

主持人向 Scott Armul 提问:新兴的 AI 工作负载与系统架构正在如何彻底改变数据中心在功率密度和冷却方面的传统假设?Scott 指出,在以往的传统数据中心时代,基础设施工程师坦率地讲“其实并不关心上面跑的具体是什么工作负载”。那时候一切都运行在标准的基于 CPU 的服务器上,具有相对可预测的热耗或能耗,数据中心设计者不需要深入理解上层计算究竟在做什么。

然而,AI 的爆发从根本上改变了这种模式。AI 采用的是一种高度专门化的“计算单元”(unit of compute)方案,整套架构针对特定的性能参数或工作负载进行了极致优化,基础设施团队从一开始就知道硬件的物理形态和功耗特征。以 NVIDIA 命名的集群规模或 SuperPOD 为例,Vertiv 可以从这些专为 AI 构建的 Pod 反推设计:电力系统(powertrain)和冷却基础设施必须长成什么样,才能在尺寸、优化程度和运行效率上提供最佳支撑。随后,这种设计思路可以无缝缩放扩展到整座园区,使“整个数据中心站点被优化为一台单一的超级计算机协同工作”。

```mermaid flowchart TD accTitle: AI工厂端到端逆向设计架构流 accDescr: 展示从上层特定算力单元反推电力与冷却基础设施,最终构建统一AI工厂的过程。

subgraph ComputeUnit ["算力单元定义"] A["NVIDIA SuperPOD / AI 集群"] --> B["锁定特定性能与功耗特征"] end

subgraph InfraReverse ["逆向基础设施推导"] B --> C["电力传输系统 (Powertrain) 针对性定制"] B --> D["极高密度冷却拓扑优化"] end

subgraph SiteScaling ["整站协同缩放"] C --> E["AI 工厂 (AI Factory) 级扩展"] D --> E E --> F["整座数据中心作为单一计算机运行"] end ```

- 传统模式:基于 CPU 服务器,能耗特征通用化,设计基础设施时无需理解具体工作负载细节。 - AI 驱动模式:以针对特定性能优化的计算单元为核心,围绕计算 Pod 倒推定制供电和冷却链条。 - 架构演进:不仅实现 Pod 内部的效率最大化,还将整座数据中心整体调度为单一大型计算机。

[10:06](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=606s) 复合加速、跨代预判与吉瓦级物理挑战

主持人提到,Scott 在 Vertiv 工作多年,亲历了行业从传统计算到现代基础设施的演变,并询问他对未来几年数据中心前景的预判。Scott 直言,当前整个行业正在经历“复合型加速”(compounding acceleration),这种节奏对 Vertiv 而言令人极度振奋。公司的研发工程师和服务人员已全面对接 GPU 的演进方向;NVIDIA 发布的 GPU 发展路线图以及随之解锁的算力性能跃升,用他的话来说“简直令人叹为观止”(truly mind-blowing)。

面对如此迅猛的发展速度,Vertiv 正在打一场不仅要跟上步伐、更要超前布局的竞速赛。Scott 解释道,团队正在努力向未来眺望数个 GPU 世代,以便提前攻克那些不可避免的底层物理难题:“从我们的视角来看,我们正处于一场竞赛中,不仅要跟上这一步伐,我们还在努力提前研判数个 GPU 世代,去思考:我们接下来需要解决哪些基于物理学层面的难题?”(“From our perspective, we're in a race to try to not only keep up with that pace, but we're trying to look multiple GPU generations ahead to say, what are the physics-based problems we're going to need to solve?”)无论是如何将超大规模电力注入机架,还是如何支撑达到 1 吉瓦(GW)容量规模的整体数据中心与 AI 工厂,Vertiv 都在以近乎执着的态度进行逆向研发,确保技术投资和产品路线图提前就绪,从而使新建数据中心能够在下一代 GPU 集群真正进场交付之前便已完成通电就绪。对谈最后,主持人感谢了 Scott 分享 Vertiv 与 NVIDIA 合作的深度洞察,并引导观众继续关注 GTC 官方目录中的更多精彩分论坛。

- 行业趋势:GPU 路线图带来的算力跃迁引发多层级基础设施的复合型加速。 - 研发策略:跳出当前在售硬件视角,提前锁定 2-3 个 GPU 世代后的物理挑战。 - 终极目标:确保 1 GW 级容量规划与技术研发超前落地,在 GPU 集群到场前完成数据中心供电与冷却的交付就绪。

## Notable quotes > [07:23](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=443s) When you think about scaling to gigawatt levels, we can't be fumbling over ourselves and multiple parties and different trades all trying to work at the same time. — Scott Armul

> [10:06](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=606s) From our perspective, we're in a race to try to not only keep up with that pace, but we're trying to look multiple GPU generations ahead to say, what are the physics-based problems we're going to need to solve? — Scott Armul

## Mentioned Vertiv, NVIDIA, Scott Armul, Tiffany Jansen, NVIDIA Omniverse, Rubin, Omniverse Rubin DSX, NVIDIA SuperPOD

## Video description Scott Armul, Chief Product and Technology Officer at Vertiv, explains how Vertiv meets AI infrastructure demands at scale—delivering the power and cooling systems behind modern data centers and developing the solutions to streamline the design and deployment of next-generation AI factories.

[Source](https://www.youtube.com/watch?v=MyNEr7tf-WQ)

中文简报

Vertiv利用Nvidia Omniverse对电力和冷却进行建模以加速AI建设 GPU能耗需求激增,促使运营商采用经过预先模拟的工厂标准化基础设施取代定制化数据中心建设,以支持600千瓦机架。 本次讨论重点探讨从传统定制化数据中心建设向高密度AI工作负载所需的标准化融合基础设施模式的转变。Armul解释了Vertiv如何利用NVIDIA Omniverse创建电力和冷却系统的数字孪生,从而在物理施工开始前进行基于物理学的模拟,以加速部署并确保性能。通过将自身定位为AI架构“五层蛋糕”的基础层,Vertiv旨在解决未来吉瓦级数据中心面临的散热和电力挑战。 Vertiv正将数据中心部署方式从现场定制施工转向采用预制标准化构件的工厂化模式。 (5:54) 通过集成NVIDIA Omniverse,Vertiv得以创建电力与冷却链的数字孪生,在实际动工前实现基于物理学的模拟。 (3:34) 行业正从通用设计转向专为特定GPU集群架构进行深度优化的专用“AI工厂”。 (8:59) Vertiv正在前瞻性地解决未来的物理限制,包括管理功耗达600千瓦的机架,以及将园区容量扩展至吉瓦级别。 (10:22)

精炼阅读摘要

维谛技术(Vertiv)首席产品与技术官 Scott Armul 在 NVIDIA GTC Studio 对话中指出,生成式人工智能的快速发展已终结传统通用型数据中心的设计范式,促使底层物理基础设施向针对 GPU 集群深度优化的融合架构演进。 从后台走向台前的核心供电与散热挑战 (0:10) Scott Armul 强调,所有日常的 AI 聊天交互、推理与数字服务,最终都依托于数据中心内运行的高性能 GPU。这类算力芯片在消耗庞大电力的同时释放出极高热量,使数据中心物理基础设施从以往不受大众关注的后台支撑,转变为整个 AI 体系不可或缺的关键环节。Vertiv 的核心职能在于设计并部署包括风冷、先进液冷以及排热在内的完整物理系统,确保热量能从芯片端安全导出、移出机架与机房,并最终排放至大气中或进行余热回收利用,以缓解环境负荷。 基于 Omniverse 数字孪生的工程仿真与交付加速 (3:34) 在与 NVIDIA 的合作中,Vertiv 采用 NVIDIA Omniverse 平台开展融合系统工程。在实际工程破土动工前,团队利用基于物理规律的仿真和仿真建模,虚拟验证液冷管道、供电链路与 NVIDIA 芯片集群及服务器在高负载运行下的交互表现。Scott Armul 指出,这种数字孪生机制打破了传统现场定制化安装中由于部件不匹配而在调试阶段临时解决问题的局限,能够大幅缩减实体站点的建设与调试周期,帮助客户加快实现算力上线(Time to Token)。 融合物理基础设施重构数据中心工业化标准 (6:12) Scott Armul 将 AI 技术架构比作“五层蛋糕”,并将 Vertiv 定位为最底层的物理基础设施基石。传统的机房建设高度依赖各厂商孤立的单点设备,再由咨询工程师与施工单位在现场繁琐整合;而 Vertiv 倡导的“融合物理基础设施”方案,则依托预先设计的标准化构件与预定义接口,在 CAD 和 Omniverse 环境中完成全流程虚拟测试。将数据中心建设转型为类似于标准化工厂装配线的模式,能避免不同工种在施工现场产生冲突,并助力客户降低总体拥有成本(TCO)。 从算力单元逆向优化至吉瓦级高密未来 (8:59) 过去的通用 CPU 服务器能耗与散热需求较为平稳,数据中心往往采取与具体工作负载无关的通用化设计。Scott Armul 表示,随着行业转向以超算集群为核心的“算力单元”模式,Vertiv 现已通过解析 NVIDIA SuperPod 架构进行逆向工程,推导出契合高效率要求的供电与冷却参数,进而将整座数据中心优化为如同单一计算机般协同运转。面对未来单机架能耗突破 600 千瓦以及总园区容量迈向吉瓦(Gigawatt)规模的极限指标,基础设施研发团队正尝试提前数代 GPU 开展前瞻技术布局,以攻克潜在的物理约束。 数据中心基础设施已从粗放式建设全面转向以算力为导向的高度集成化工程,但如何在单机架功耗超过 600 千瓦并迈向吉瓦级集群的趋势下,持续跑赢硬件迭代周期并突破极端散热与配电的物理极限,仍是产业链各方长期面临的考验。

Detailed notes — zh

## Background 该视频由 NVIDIA 官方频道于 2026 年 3 月 30 日在 YouTube 平台发布。内容记录了维谛技术(Vertiv)首席产品与技术官 Scott Armul 在 NVIDIA GTC Studio 现场的访谈,主要探讨 Vertiv 如何在大规模扩展层面满足 AI 基础设施的严苛需求,提供现代数据中心背后的电力与制冷系统,并加速下一代 AI 工厂的设计与交付。 ## TL;DR 访谈深入解析了 Vertiv 如何从幕后走向台前,成为驱动高密度 GPU 集群运转的电力与散热核心基石。Scott Armul 详细阐述了双方基于 NVIDIA Omniverse 平台打造的 Rubin 融合系统与数字孪生工程,强调必须告别传统的“现场手工拼装”模式,转向标准化、预制化的融合物理基础设施。随着 AI 工作负载要求将整座吉瓦(GW)级数据中心视作一台单一超级计算机来设计,Vertiv 正通过逆向工程提前数个 GPU 世代研发布局,确保基础设施在下一代算力芯片交付前即已通电就绪。 ## Atmosphere & style 整场对话节奏轻快、专业且富有前瞻性,两位对谈者在轻松风趣的开场闲聊中迅速切入硬核的工程底座议题。主持人善用通俗易懂的生活化比喻引导提问,而嘉宾则展现出深厚的基础设施工程洞察,谈及万亿级算力背后的物理极限时充满行业敬畏与自豪感。整体氛围兼具工业级严谨与对算力革命的澎湃激情,让观众清晰感受到在喧嚣的大模型浪潮背后,底层物理世界正在经历一场惊心动魄的工业化重构。 ## Bulletin - [03:34](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=214s) Vertiv 与 NVIDIA 在 GTC 联合发布基于 Omniverse 的 Rubin 系列融合系统整体解决方案,通过物理级仿真在数字孪生空间中前置对齐电力与制冷链路,大幅缩短生成式 AI 工厂的“Token 产出耗时”(Time to Token)。 - [05:15](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=315s) 传统数据中心建设正从割裂的“现场手工定制”转向“工业级融合物理基础设施”,通过预定义模块单元和标准化接口,避免现场返工并实现像汽车装配线一样的标准化预制交付。 - [08:59](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=539s) AI 工作负载彻底颠覆了以往基于通用 CPU 服务器的设计逻辑,基础设施工程师转为围绕特定计算单元(如 SuperPOD)的功耗与性能特征逆向推导供电和冷却拓扑,从而将整座数据中心优化为单一超级计算机。 - [10:06](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=606s) 面对单体数据中心迈向吉瓦(GW)级能耗的超级物理挑战,Vertiv 正在提前数个 GPU 世代进行逆向研发与技术布局,确保电力与液冷设施在下一代芯片交付前完全就绪。 ## Key takeaways - [00:10](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=10s) 随着 AI 大模型爆发,涵盖供电与制冷(液冷/风冷)的数据中心物理基础设施已从行业幕后一跃成为支撑 AI 算力的显学焦点。 - [01:43](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=103s) 高密度 GPU 并行计算的核心瓶颈高度集中在电力输入与高强度产热的带走、排出乃至余热回收利用上。 - [03:34](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=214s) Vertiv 联合 NVIDIA Omniverse 构建 Rubin 融合系统,通过数字孪生在工程动土前对全链路物理动态进行精确仿真与软硬件对齐。 - [03:34](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=214s) 基于物理法则的数字化前置打磨能够有效规避现场接口不匹配,显著加快 AI 工厂上线并压缩首次“产出 Token 的时间”(Time to Token)。 - [05:15](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=315s) 传统数据中心长期受困于各厂商单点设备在现场的临时拼装与定制,面临极高的施工冗余与现场交涉成本。 - [05:15](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=315s) “融合物理基础设施”倡导以标准化的预定义积木(Building Blocks)和接口规范,实现一体化总成系统的出厂前数字装配验证。 - [07:23](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=443s) 在 AI 基础设施“五层蛋糕”模型中,Vertiv 处于最底层的物理基础设施层,是承载上层一切模型与超密集算力释放的基石。 - [07:23](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=443s) 面对吉瓦(GW)级超级 AI 工厂的扩展,手工作坊式施工容错率降至冰点,必须转向高度预制化的现代化工业装配模式以压低 TCO。 - [08:59](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=539s) 传统数据中心对 CPU 工作负载通用且不敏感,而 AI 基础设施必须围绕具体计算单元(如 SuperPOD)进行精准的逆向匹配设计。 - [08:59](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=539s) 通过对高密度算力 Pod 的电力传输系统(powertrain)和冷却架构进行全园区的协同缩放,整座数据中心被构建为一台统一运转的单一超级计算机。 - [10:06](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=606s) GPU 架构的迅猛演进正驱动数据中心物理基础设施经历“复合型加速”,促使研发团队跨越当前硬件边界提前攻克底层物理难题。 - [10:06](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=606s) Vertiv 的核心研发布局要求提前 2 至 3 个 GPU 世代展开逆向推演,确保吉瓦级供电与散热能力先于新一代芯片到场通电就绪。 ## Detailed walkthrough ### [00:10](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=10s) 从幕后走到台前:AI 浪潮下的 Vertiv 在 NVIDIA GTC Studio 现场,主持人 Tiffany Jansen 迎来了维谛技术(Vertiv)的首席产品与技术官(Chief Product and Technology Officer)Scott Armul。Tiffany 坦言自己一直十分期待这次对话,因为 Vertiv 在幕后深耕多年的 AI 与基础设施挑战,如今终于被更广泛的公众所认知。对于这种认知度的跃迁,Scott 幽默而感慨地回应,在过去,Vertiv 在数据中心行业虽然至关重要,但对圈外大众而言几乎是默默无闻的,直到最近人们才开始真正关注他们是谁、在做什么。 Scott 指出,维谛技术本质上是数据中心层面的电力、冷却以及整体基础设施解决方案专家,负责未来数据中心的设计、预制与构建。虽然公司自身的强劲业绩和业务增长带动了一部分知名度,但与 NVIDIA 建立深度合作并共同研发关键基础设施,才真正让这家老牌基础设施巨头一跃进入大众视野,甚至正如 Scott 在录制前与主持人闲聊时所笑称的那样——如今连隔壁邻居都清楚他平时究竟靠什么谋生了。 > “Vertiv, we're the power and cooling and overall solutions infrastructure folks from a data center level.” —— Scott Armul - 访谈主持人:Tiffany Jansen(NVIDIA GTC Studio) - 受访嘉宾:Scott Armul(Vertiv 首席产品与技术官) - 业务定位:涵盖数据中心级别的供电、制冷(液冷/风冷)及端到端整体关键物理基础设施的设计与预制。 --- ### [01:43](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=103s) 如何向普通人解释:驱动数千颗 GPU 背后的大脑与冷热链 当被问及如果向非行业背景的邻居或家人解释 Vertiv 到底解决什么问题时,Tiffany 分享了她当天早晨向自己母亲做科普的生动比喻:日常生活中大家所交互的各类 AI 聊天机器人,其底层模型需要数千颗 GPU 同时并行运算才能跑得起来;而这些高密度的 GPU 运算只需两个最基础的核心要素,那就是电力(Power)与制冷(Cooling),这也正是伴随 AI 爆发随之而来的最严峻挑战。 Scott 对这个通俗的解释给予了百分之百的肯定。他进一步阐明,无论是大众在终端查询聊天机器人、运行 AI 推理,还是进行任何现代数据中心的工作负载,所有服务器、芯片和 GPU 都必须承载在具体的物理数据中心内。数据中心首先要稳定送入电力以驱动芯片全速运转,但芯片在高强度计算时会产生极其庞大的热量。Vertiv 部署的一系列技术——无论是先进的直接液冷(Liquid Cooling)、风冷(Air Cooling)还是其他散热手段——核心任务都是迅速把芯片散发出的热量带走,将其排出机架、排出数据机房楼栋,最终释放到大气中,甚至设法对其进行余热回收利用,从而让整个 AI 工厂在提升运算能效的同时减少对环境的足迹。 > “That data center has to deliver power to that chip so that it can run. And effectively that chip creates heat.” —— Scott Armul ```mermaid flowchart LR accTitle: 数据中心能源与热量流动示意图 accDescr: 展示从电力输入到GPU发热,再由Vertiv液冷/风冷系统将热量排出机架并回收的完整链条。 subgraph PowerChain["供电链 (Power Chain)"] Grid["电网 / 能源输入"] --> PDU["高压配电 / 供电系统"] PDU --> GPU["GPU / AI 服务器集群"] end subgraph ThermalChain["散热链 (Thermal Chain)"] GPU -->|"计算产热"| Cooling["Vertiv 液冷 / 风冷散热"] Cooling --> Rack["移出机架与机房"] Rack --> Atmosphere["大气排放 / 余热回收再利用"] end ``` --- ### [03:34](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=214s) GTC 重磅发布:基于 Omniverse 的 Rubin 融合系统与数字孪生 在谈及本届 GTC 期间的重磅消息时,Scott 重点介绍了双方联合打造的重大成果:基于 NVIDIA Omniverse 平台构建的 Rubin 系列下一代系统(Omniverse Rubin DSX)整体解决方案。从 Vertiv 的视角来看,这代表着一种全新的工程范式——一种覆盖全数据中心生命周期的端到端、预设计、预装配的融合系统工程(Converged Systems Engineering)。该方案将电力链路(Powertrain)、散热链路(Thermal Chain)、先进液冷系统以及数据中心废热排出等所有模块全部进行了标准化深度整合。 这一变革彻底颠覆了以往数据中心现场拼装的传统设计流程。Vertiv 与 NVIDIA 合作,在数字空间中提前预定义了所有软硬件接口与场地部署方案。借助 NVIDIA Omniverse 强大的物理级仿真能力,工程团队可以在工程现场还未“动土一锹”、施工单位尚未进场之前,就在虚拟世界中完全模拟出设备实际运行时的物理表现,精准掌握大规模芯片组、计算集群与服务器在特定微环境下的真实动态。这种全流程数字化的前置打磨,旨在极大地缩减现场交付周期,帮助客户以最快速度缩短达到首次“产出 Token”(Time to Token)所需的时间。 > “So within NVIDIA's Omniverse, we're trying to drive towards more physics-based and simulated types of designs to speed up a lot of the converged infrastructure approach so that long before a shovel ever hits the ground or a construction company is trying to put up a data center, we understand the performance of our gear.” —— Scott Armul - 核心发布:结合 NVIDIA Omniverse 的预设计架构(围绕 Rubin 平台与新一代融合系统方案)。 - 工程逻辑:告别传统的滞后调试,通过基于物理法则(Physics-based)的精确建模与数字孪生,在 CAD 和 Omniverse 环境中实现软硬件接口的前置对齐。 - 业务目标:大幅减少现场工程返工,全面提升部署敏捷度,缩短生成式 AI 工厂的“Token 产出耗时”(Time to Token)。 --- ### [05:15](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=315s) 告别“现场手工定制”,迈向工业级融合物理基础设施 主持人对于数字孪生带来的速度飞跃深感认同,并特别挑出了“深思熟虑地规划”(thoughtfully)这一用词。Scott 借此深入剖析了行业痛点:传统数据中心的建设模式长期陷入在“现场量身定制”(bespoke on-site custom construction)的泥潭中。过去往往是由多家不同厂商独立研发互不连通的单点产品,运抵工地后再由咨询工程师、设计顾问或施工单位在混乱的现场临时寻找拼凑方案,引发了大量的施工冗余与现场交涉。 针对这种乱象,Vertiv 倡导的“融合物理基础设施”(Converged Physical Infrastructure)旨在摒弃华而不实的公关黑话,回归工业化模块思维。它要求从源头上思考预定义的模块单元大小(Predefined Block Sizes)、标准化接口点位以及交付部署模型。通过数字孪生中的物理仿真和全流程 CAD 配合,所有零配件在出厂甚至投产前就已完成数字装配验证。这意味着设备送达机房现场并完成上电试运行后,绝不会再发生因接口不兼容而临时修改设计的混乱,真正实现了由“单点优秀产品”向“一体化总成系统”的质的飞跃。 > “I think it's critical that digital twins are really an enabler for us to get out of this bespoke on-site custom construction world that we've previously lived in to something that is truly more pre-designed and thoughtful around the building blocks that have predefined interfaces and connection points...” —— Scott Armul - 传统模式弊端: - 各类单点设备(Point Products)由不同厂商割裂研发,缺乏统一接口标准; - 依赖咨询顾问与施工队在机房现场“看菜下饭”,面临大量不可控的返工与调试复杂度。 - 融合物理基础设施核心: - 模块化积木设计(Predefined Building Blocks)与统一物理/电气/水路接口; - 提前在数字化与虚拟环境中进行真实物理受力、热能、流体等全要素验证。 --- ### [07:23](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=443s) AI 基础设施“五层蛋糕”中的基石层与吉瓦级工厂化扩展 在梳理完从单点硬件走向融合系统的技术演进后,主持人将话题引向宏观产业版图,询问在业界常讨论的 AI 基础设施“五层蛋糕”架构中,Vertiv 究竟处于哪一层。Scott 毫不犹豫地指出:Vertiv 正是位于最底部的“基础设施层”(Infrastructure Layer),也就是承载所有运算的最关键底座。 Scott 强调,底座的牢固与精确设计,决定了上层所有大模型与算力能否跑出应有的潜能。当这层基础设施被赋予深思熟虑、专为 AI 目标打造(Purpose-built)的设计标准时,才能完美对接引入数据中心的高压能源,并高效协同 DSX 这类超密集集群的运转。面向未来动辄吉瓦(Gigawatt, GW)级能耗的超级 AI 工厂,行业绝不能再容忍各工种与多方供应商在工地上相互扯皮、手忙脚乱的局面。唯有通过高度模块化、融合化的预制积木体系,才能将数据中心的兴建转变为如同现代化汽车装配线一样的“工业化制造工厂”,在释放超高算力性能的同时,显著缩短客户的上市时间(Time to Market),并有效降低全生命周期的总拥有成本(TCO)。 > “When you think about scaling to gigawatt levels, we can't be fumbling over ourselves and multiple parties and different trades all trying to work at the same time.” —— Scott Armul - 基础设施层定位:在 AI 五层架构体系中充当承载全网算力运转的物理基石,必须在最初阶段就与电网接入、变配电及微环境散热深度耦合。 - 吉瓦级(Gigawatt)扩展能力:单体数据中心能耗迈向 GW 规模时,现场施工容错率降至冰点,必须以“交钥匙工厂化预制”替代手工作坊式建造。 - 商业价值落地:通过严密定义的端到端链路设计,为企业带来更优的算力利用率、更短的交付工期和更低的总拥有成本(TCO)。 ### [08:59](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=539s) AI 工作负载如何颠覆数据中心传统设计逻辑 主持人向 Scott Armul 提问:新兴的 AI 工作负载与系统架构正在如何彻底改变数据中心在功率密度和冷却方面的传统假设?Scott 指出,在以往的传统数据中心时代,基础设施工程师坦率地讲“其实并不关心上面跑的具体是什么工作负载”。那时候一切都运行在标准的基于 CPU 的服务器上,具有相对可预测的热耗或能耗,数据中心设计者不需要深入理解上层计算究竟在做什么。 然而,AI 的爆发从根本上改变了这种模式。AI 采用的是一种高度专门化的“计算单元”(unit of compute)方案,整套架构针对特定的性能参数或工作负载进行了极致优化,基础设施团队从一开始就知道硬件的物理形态和功耗特征。以 NVIDIA 命名的集群规模或 SuperPOD 为例,Vertiv 可以从这些专为 AI 构建的 Pod 反推设计:电力系统(powertrain)和冷却基础设施必须长成什么样,才能在尺寸、优化程度和运行效率上提供最佳支撑。随后,这种设计思路可以无缝缩放扩展到整座园区,使“整个数据中心站点被优化为一台单一的超级计算机协同工作”。 ```mermaid flowchart TD accTitle: AI工厂端到端逆向设计架构流 accDescr: 展示从上层特定算力单元反推电力与冷却基础设施,最终构建统一AI工厂的过程。 subgraph ComputeUnit ["算力单元定义"] A["NVIDIA SuperPOD / AI 集群"] --> B["锁定特定性能与功耗特征"] end subgraph InfraReverse ["逆向基础设施推导"] B --> C["电力传输系统 (Powertrain) 针对性定制"] B --> D["极高密度冷却拓扑优化"] end subgraph SiteScaling ["整站协同缩放"] C --> E["AI 工厂 (AI Factory) 级扩展"] D --> E E --> F["整座数据中心作为单一计算机运行"] end ``` - 传统模式:基于 CPU 服务器,能耗特征通用化,设计基础设施时无需理解具体工作负载细节。 - AI 驱动模式:以针对特定性能优化的计算单元为核心,围绕计算 Pod 倒推定制供电和冷却链条。 - 架构演进:不仅实现 Pod 内部的效率最大化,还将整座数据中心整体调度为单一大型计算机。 ### [10:06](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=606s) 复合加速、跨代预判与吉瓦级物理挑战 主持人提到,Scott 在 Vertiv 工作多年,亲历了行业从传统计算到现代基础设施的演变,并询问他对未来几年数据中心前景的预判。Scott 直言,当前整个行业正在经历“复合型加速”(compounding acceleration),这种节奏对 Vertiv 而言令人极度振奋。公司的研发工程师和服务人员已全面对接 GPU 的演进方向;NVIDIA 发布的 GPU 发展路线图以及随之解锁的算力性能跃升,用他的话来说“简直令人叹为观止”(truly mind-blowing)。 面对如此迅猛的发展速度,Vertiv 正在打一场不仅要跟上步伐、更要超前布局的竞速赛。Scott 解释道,团队正在努力向未来眺望数个 GPU 世代,以便提前攻克那些不可避免的底层物理难题:“从我们的视角来看,我们正处于一场竞赛中,不仅要跟上这一步伐,我们还在努力提前研判数个 GPU 世代,去思考:我们接下来需要解决哪些基于物理学层面的难题?”(“From our perspective, we're in a race to try to not only keep up with that pace, but we're trying to look multiple GPU generations ahead to say, what are the physics-based problems we're going to need to solve?”)无论是如何将超大规模电力注入机架,还是如何支撑达到 1 吉瓦(GW)容量规模的整体数据中心与 AI 工厂,Vertiv 都在以近乎执着的态度进行逆向研发,确保技术投资和产品路线图提前就绪,从而使新建数据中心能够在下一代 GPU 集群真正进场交付之前便已完成通电就绪。对谈最后,主持人感谢了 Scott 分享 Vertiv 与 NVIDIA 合作的深度洞察,并引导观众继续关注 GTC 官方目录中的更多精彩分论坛。 - 行业趋势:GPU 路线图带来的算力跃迁引发多层级基础设施的复合型加速。 - 研发策略:跳出当前在售硬件视角,提前锁定 2-3 个 GPU 世代后的物理挑战。 - 终极目标:确保 1 GW 级容量规划与技术研发超前落地,在 GPU 集群到场前完成数据中心供电与冷却的交付就绪。 ## Notable quotes > [07:23](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=443s) When you think about scaling to gigawatt levels, we can't be fumbling over ourselves and multiple parties and different trades all trying to work at the same time. — Scott Armul > [10:06](https://www.youtube.com/watch?v=MyNEr7tf-WQ&t=606s) From our perspective, we're in a race to try to not only keep up with that pace, but we're trying to look multiple GPU generations ahead to say, what are the physics-based problems we're going to need to solve? — Scott Armul ## Mentioned Vertiv, NVIDIA, Scott Armul, Tiffany Jansen, NVIDIA Omniverse, Rubin, Omniverse Rubin DSX, NVIDIA SuperPOD ## Video description Scott Armul, Chief Product and Technology Officer at Vertiv, explains how Vertiv meets AI infrastructure demands at scale—delivering the power and cooling systems behind modern data centers and developing the solutions to streamline the design and deployment of next-generation AI factories. [Source](https://www.youtube.com/watch?v=MyNEr7tf-WQ)

Source quotes

[7:23] Scott Armul: When you think about scaling to gigawatt levels, we can't be fumbling over ourselves and multiple parties and different trades all trying to work at the same time. [10:06] Scott Armul: From our perspective, we're in a race to try to not only keep up with that pace, but we're trying to look multiple GPU generations ahead to say, what are the physics-based problems we're going to need to solve?