Turbopuffer高管称Cursor实测证伪RAG已死论
AI Engineer
向量嵌入本质是可复用的缓存计算,以多工具迭代检索提纯上下文远比依赖超长上下文窗口更具工程与成本效益。
AI-assisted summary of RAG is dead, right?? — Kuba Rogut, Turbopuffer — original source. Check the original for full context.
Source published:
Key ideas
- 社交媒体上关于“RAG 已死”的言论与真实趋势严重脱节,Google 搜索热度在 2024 年盘整后于 2025 年中迎来全新拐点并呈现爆发式暴涨。 (0:07)
- Cursor 引入语义搜索后,Composer 模型回答准确率提升近 24%,大型代码库留存率增加 2.6%,且用户不满请求降低 2.2%。 (3:15)
- Kuba Rogut 提出核心技术框架:向量嵌入和语义搜索本质上是计算缓存(cached compute),是否做预先索引取决于团队的长尾查询复用度与算力开销权衡。 (6:08)
- 面对超大上下文窗口趋势,Jeff Dean 强调不需要一次塞入一万亿 token,而是需要轻量级的多阶段检索来筛选出最正确的关键百万级 token。 (9:44)
Detailed notes
## Background 该视频由 YouTube 频道“AI Engineer”于 2026 年 6 月 9 日发布,内容为 Turbopuffer 部署工程师 Kuba Rogut 的主题演讲。视频简介指出,社交媒体上“RAG 已死”的唱衰声与实际检索热度的爆发背道而驰;通过 Cursor 与 Claude Code 的工程实践对比,演讲揭示了 RAG 并未消亡,而是正升级为涵盖丰富工具调用与分阶段筛选的智能体检索(Agentic Retrieval)。
## TL;DR Kuba Rogut 指出,2025 年年中以来 RAG 的 Google 搜索热度迎来二次爆发,所谓“RAG 已死”只是对传统单次向量搜索狭隘理解的破灭。Cursor 的实践证明,通过 Merkle 树增量索引与语义搜索,模型回答准确率可大幅提升近 24%,本质是将代码理解转化为可复用的“计算缓存”;相比之下,Claude Code 的纯 grep 机制则是另一种高重复成本的权衡。最终,智能体检索走向了结合向量搜索、BM25 全文检索、正则与路径过滤的动态推理闭环,正印证了 Jeff Dean 的核心洞见:面对海量数据,开发者需要的不是一次性塞入一万亿 token,而是通过分阶段检索精准提炼出关键的一百万。
## Atmosphere & style 现场氛围务实而充满极客底气,演讲者以轻松调侃社交网络论调(“拿去吧,推特”)切入,迅速将全场带入扎实的工程架构剖析中。叙事逻辑层层递进,既有严密清晰的系统调用对比,也有掷地有声的线上真实 A/B 测试数据背书。整场分享节奏明快、观点犀利,不仅直击当前大模型长上下文与检索落地的真实痛点,更给台下身处工程实践前沿的开发者们带来了极具说服力的架构启示。
## Bulletin - [00:07](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=7s) 社交媒体上关于“RAG 已死”的言论与真实趋势严重脱节,Google 搜索热度在 2024 年盘整后于 2025 年中迎来全新拐点并呈现爆发式暴涨。 - [03:15](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=195s) Cursor 引入语义搜索后,Composer 模型回答准确率提升近 24%,大型代码库留存率增加 2.6%,且用户不满请求降低 2.2%。 - [06:08](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=368s) Kuba Rogut 提出核心技术框架:向量嵌入和语义搜索本质上是计算缓存(cached compute),是否做预先索引取决于团队的长尾查询复用度与算力开销权衡。 - [09:44](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=584s) 面对超大上下文窗口趋势,Jeff Dean 强调不需要一次塞入一万亿 token,而是需要轻量级的多阶段检索来筛选出最正确的关键百万级 token。
## Key takeaways - [00:07](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=7s) 社交网络舆论常将智能体文件检索(grep)捧为唯一解,但全球工程界对 RAG 的实际探索与搜索量在 2025 年中出现指数级二次爆发。 - [01:38](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=98s) RAG 的定义被严重窄化;真正的 RAG 绝不等于单次向量相似度查询,而是包含 BM25 全文检索、grep、glob、正则表达式与过滤器的富工具系统。 - [01:38](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=98s) 现代智能体搜索是一个迭代推理过程:智能体按需调用工具查找上下文,并在评估信息不足时持续发起新一轮查询直至解决问题。 - [03:15](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=195s) Cursor 借助 Merkle 树比对不同开发者工作区间的代码哈希,对相似分支与历史数据进行跨用户复用,仅对增量代码进行解析与重新嵌入。 - [03:15](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=195s) 在全量请求中,Cursor 语义搜索显著提升了 Composer 模型的准确率,并将代码留存率提升 2.6%,用户不满请求降低 2.2%。 - [06:08](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=368s) Claude Code 放弃向量 RAG 转向基于运行时的文件系统 grep,展示了零预热索引成本与按需探索之间的明确技术权衡。 - [06:08](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=368s) 向量嵌入可视为“缓存的计算”:如果多位工程师在一段时间内反复提问相似代码逻辑,预先索引相比单次消耗数千 token 的动态 grep 能大幅节省总体成本和延迟。 - [08:38](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=518s) 行业已从 2023 年粗糙的“向量匹配后全塞给上下文”范式,全面演进为多步骤、交互式和工具驱动的智能体检索(Agentic Retrieval)。 - [09:09](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=549s) 成熟的 Agent 能够自主在语义向量搜索与精确全文匹配之间动态切换,实现“为了进一步理解而主动搜索”的认知闭环。 - [09:44](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=584s) 即便未来 LLM 上下文窗口达到一万亿 token,由于信噪比与算力瓶颈,分阶段检索(staged retrieval)仍是提纯关键信息的必经之路。
## Detailed walkthrough ### [00:07](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=7s) “RAG 已死”的舆论与实际搜索热度的背离
Kuba Rogut(Turbopuffer 的部署工程师)登台向满座的观众致意,并介绍了 Turbopuffer 的定位:这是一款直接基于对象存储从第一性原理构建的全文检索与向量搜索数据库。本次演讲的主题直面当下最热门的争议——“RAG 真的死了吗?”(RAG is dead, right?),探讨富工具(tool-rich)的混合检索如何成为严谨智能体搜索(agentic search)的默认范式。
社交媒体(尤其是 X / Twitter)上充斥着关于“RAG 已死,智能体文件搜索(agentic file search)才是唯一所需”的论调,这种声音在 2025 年底至 2026 年初尤为密集。然而,观察过去几年的 Google 搜索热度趋势会发现完全相反的景象:2023 年 AI 兴起时 RAG 搜索量激增,2024 年有所平缓并盘整了一年左右,但到了 2025 年年中,RAG 搜索量迎来了一个全新的拐点,随即呈现爆发式暴涨。Kuba 调侃道:“拿去吧,推特。”(“So take that Twitter.”)这证明舆论泡沫与行业实际技术探索之间存在巨大落差。
- **主讲人背景**:Kuba Rogut,Turbopuffer 部署工程师。 - **Turbopuffer 产品特性**:建立在对象存储底层之上的全文检索与向量数据库。 - **搜索趋势拐点**:2023 年起步,2024 年横盘,2025 年年中迎来二次爆发式上涨。
---
[01:38](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=98s) 重新定义 RAG 与智能体搜索
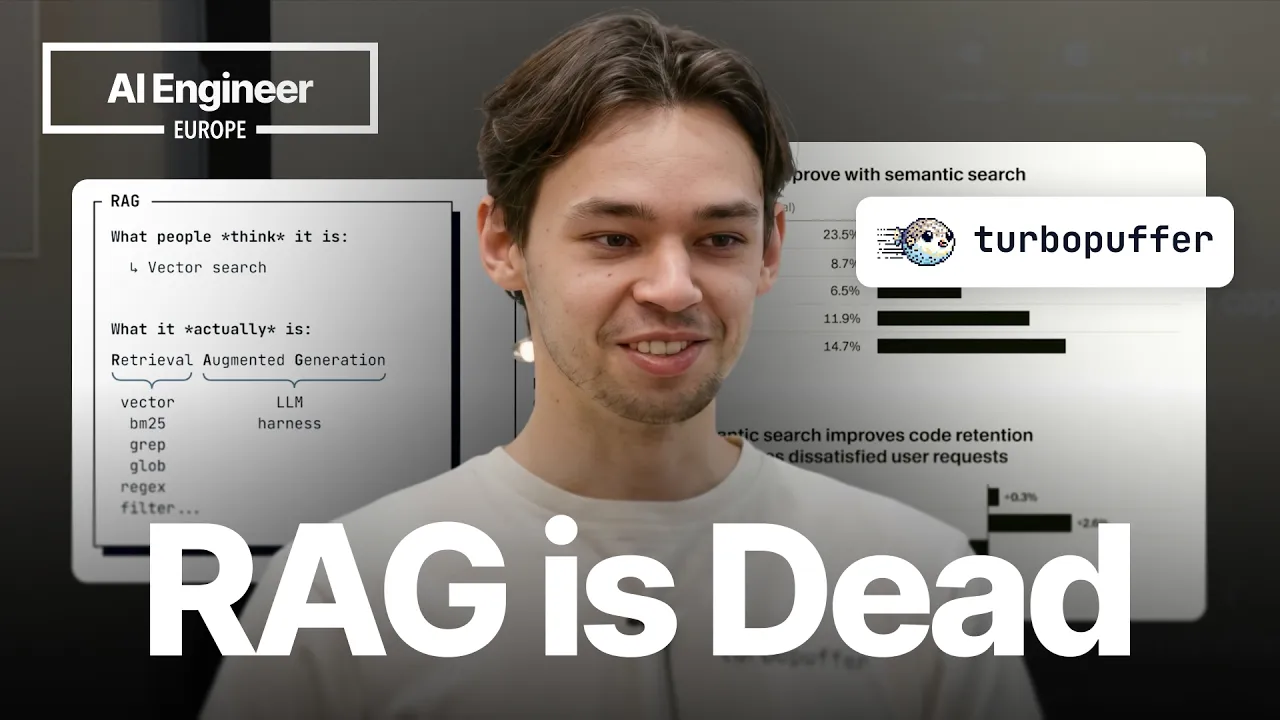
Kuba 深入剖析了大众对 RAG 与智能体搜索的认知偏差。许多人狭隘地将 RAG 等同于“简单的向量搜索”——将语料切块嵌入成向量,查询时检索最相似的片段,直接塞进大语言模型(LLM)。但在 Turbopuffer 看来,如果回归检索增强生成(Retrieval-Augmented Generation)的本义,“检索”(Retrieval)绝不仅限于向量搜索,它是一个多维工具集合,涵盖基于 BM25 的全文检索、grep 文件搜索、glob 路径匹配、正则表达式(regex)以及各种基础的元数据过滤器;而“增强生成”则是将提炼出的上下文精准提供给选定的 LLM。
与此同时,社区对“智能体搜索”的定义也经常被矮化为简单的“文件系统 grep”——类似于 Claude Code 或 Codex 所采用的操作。真正的智能体搜索绝非单纯的命令行抓取,而是赋予智能体一套丰富的工具集,让其能够逐步、迭代地寻找上下文并进行推理。例如在实际运行中,智能体可以先通过 grep 检索文件,阅读其内容,若评估发现当前信息不足以完成目标,便再次发起新的搜索,如此循环往复,直到达到满意状态并继续推进任务。
“这实际上是赋予智能体一套工具,让其能够渐进且迭代地查找并在上下文中进行推理。”(“And what we actually believe it is and you know kind of the definition we want to we want to give it is it's really giving the agents a set of tools to kind of progressively and iteratively find and reason over context.” —— Kuba Rogut)
```mermaid flowchart TD accTitle: 智能体迭代检索流程图 accDescr: 展示智能体在工具集合中迭代查找上下文直至满足任务需求的决策闭环
Start["用户任务目标"] --> AgentDecide{"智能体决策与推理"}
subgraph ToolSet["丰富检索工具集 (Hybrid Tools)"] T1["向量搜索 (Vector Search)"] T2["全文搜索 (BM25)"] T3["文件系统 Grep / Glob"] T4["正则表达式 & 过滤 (Regex/Filters)"] end
AgentDecide -->|"调用检索工具"| ToolSet ToolSet -->|"返回匹配上下文"| Evaluate{"信息是否完备?"} Evaluate -->|"信息不足 / 需进一步验证"| AgentDecide Evaluate -->|"满足条件"| FinalLLM["注入上下文并完成生成任务"] ```
---
[03:15](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=195s) Cursor 的 Merkle 树增量索引与语义搜索收益
作为 Turbopuffer 的最早客户之一,代码编辑器 Cursor 展示了工业级智能体搜索的最佳实践。Cursor 在 2026 年初发布的技术博文披露了其如何对大型代码库进行索引:当开发者打开新代码库或切换分支时,Cursor 会在后台解析代码、分块(chunk)并生成向量嵌入,使其支持语义搜索。
为了避免高昂的重复计算,Cursor 引入了巧妙的工程机制。在一个由 100 名工程师组成的研发团队中,所有人 99% 的时间都在同一个或少数几个代码库上协作。若每次切换分支或拉取代码都重新分块、重新嵌入并全量上传,成本将无法承受。Cursor 利用 Merkle 树(加密哈希树)比对不同工程师工作区之间的代码相似性,若高度相似,则直接跨用户复用已有数据,仅对发生变动的文件进行增量重新解析与嵌入,并借助 Turbopuffer 安全地存储和检索。
这种重度工程投入带来了极其实在的模型表现提升: - **回答准确率大幅提升**:在 Cursor 内部的上下文基准测试(Cursor context benchmark)中,接入语义搜索使多模型平均回答准确率提升了约 12.5% 至 13.5%;在其自研的 Composer 模型上,回答准确率提升了近 24%。 - **线上 A/B 测试指标**:在大型代码库中的代码留存率(code retention)提升了 2.6%,用户不满请求(dissatisfied user requests)降低了 2.2%。 - **指标背后的真实效能**:2.6% 和 2.2% 看似是微小的个位数提升,但必须注意:语义搜索工具并不会在用户的每一次查询中触发。在 100 次随机查询中,很多任务本身不需要语义搜索;分母包含全量请求的情况下,这些端到端指标的净增长反映了语义搜索带来的决定性收益。
---
[06:08](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=368s) 向量嵌入即缓存计算:Claude Code 与 Cursor 的路线权衡
与 Cursor 形成鲜明对比的是 Claude Code。Claude Code 的主要创建者 Boris Cherny 曾在推文中公开证实,Claude Code 的早期迭代版本曾使用过本地向量数据库来实现 RAG,但最终团队发现该路线并不契合其场景,因而转向了无索引的纯文件系统 grep 机制。
Kuba 指出,理解这两条技术路线的分歧,核心在于建立一个概念:“向量嵌入和语义搜索本质上是计算缓存(cached compute)”。这两种取舍可以通过执行调用链(trace)进行直观对比:
| 评估维度 | Claude Code(每次会话动态探索) | Cursor(预先建索引 / 运行时检索) | |:--- |:--- |:--- | | **检索机制** | 运行时 Grep -> 逐文件阅读 -> 评估 -> 重复探索 | 预先解析、切块并生成向量嵌入,运行时通过工具轻量调用 | | **计算成本分摊** | 零预热成本,但探索成本随会话和人数线性叠加 | 承担一次性预先索引成本,运行时单次调用消耗极低 | | **典型单次消耗** | 单个子步骤可能耗费数千甚至 6,000+ tokens | 轻量工具调用,消耗极少 tokens 与时间 | | **重复查询场景** | 10 名开发者在 10 天提出相同机制问题,需重复探索 100 次 | 建立一次缓存索引,后续所有相同或相似查询瞬间命中 |
Kuba 强调,在 Claude Code 模式下,假设团队里有 10 个工程师在不同日期反复询问代码库中“元数据过滤是如何实现的”,智能体每次都必须经历重复的 grep 与上下文阅读,这会消耗大量 token 和等待时间。而 Cursor 模式虽有预先索引的开销,却能将“代码理解”转化为可复用的计算缓存。在运行时,智能体只需发起一次轻量工具调用即可精准命中目标。正是由于运行速度与语义理解能力的飞跃(尤其是结合 Composer 2 模型后),Turbopuffer 内部原本重度使用 Claude Code 的工程师们,已经开始纷纷切换至 Cursor。
“但这是非常重要的一点,也是我们在 Turbopuffer 内部高度认同的理念:向量嵌入与语义搜索本质上是一种缓存计算。”(“But this is something that is important to understand is something we like we've kind of like taken on a lot internally understanding um here at Turbo puffer is this idea that like embeddings and semantic search are kind of cash compute.” —— Kuba Rogut)
---
[08:38](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=518s) 从简单单次 RAG 到智能体检索的演进
Kuba 总结道,行业如今正在经历从简单 RAG 到智能体检索(Agentic Retrieval)的深刻演进。在 2023 年至 2024 年初的 AI 早期阶段,人们口中推崇的典型模式不过是“做一次向量相似度搜索,然后把召回文本一股脑扔进上下文窗口”。
那种粗糙的做法已经被证明无法应对复杂业务场景。如今前沿、成熟的研发团队和客户都不再满足于单次向量命中的初级 RAG,而是全面转向拥有动态循环、工具调用与多路检索能力的智能体搜索范式,从而换取显著的真实性能与准确率收益。
[09:09](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=549s) 检索范式的演进:从单次向量查询到 Agentic 迭代循环
传统的 RAG 正在彻底摆脱那种单调的模式。现在的 Agent 正在解锁全新的产品体验,在执行任务时会进行大量的工具调用,并经历多步骤的推理过程。它们并非盲目拉取数据,而是根据具体场景,在语义搜索(semantic search)与全文搜索(full-text search)之间动态切换,仅精准抓取当前用例真正需要的信息。
Kuba Rogut 强调,检索早已不再是过去那种简单的“向向量数据库发起一次性请求”的操作。如今的检索已经变成高度迭代的过程;Agent 深刻理解自己要搜索什么,同时又在“为了理解更多而继续搜索”,形成了一种引人入胜的认知与检索闭环。
```mermaid flowchart TD accTitle: Agentic 迭代检索闭环 accDescr: 展示 Agent 如何通过多步推理结合语义搜索和全文搜索进行迭代抓取的过程。
subgraph ReasoningLoop["Agent 认知与推理闭环"] A["Agent 多步推理"] --> B{"判断所需信息类型"} B -->|"语义关联"| C["语义检索"] B -->|"精确匹配"| D["全文检索"] C --> E["抓取精准片段"] D --> E E -->|"搜索以进一步理解"| A end ```
- 传统检索是单次线性的:输入 Prompt $\rightarrow$ 向量数据库查询 $\rightarrow$ 拼接上下文。 - 现代 Agent 驱动的检索是多步骤、交互式和工具驱动的,结合了语义向量搜索、全文过滤等多种机制。 - Kuba Rogut 明确总结道:“It's becoming super iterative and these agents are really understanding what they're searching and searching to understand more in a sense.”
---
[09:44](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=584s) Jeff Dean 的上下文启示:你不需要一万亿,你需要对的那一百万
面对模型上下文窗口不断扩大的趋势(例如 Google 的 Gemini 系列模型),Kuba Rogut 引用了 Google 首席科学家 Jeff Dean 在某档节目或播客中的精辟观点。当被问及超大上下文窗口的发展时,Jeff Dean 指出,哪怕模型的上下文窗口未来能够达到一万亿(a trillion)token,盲目将所有数据塞进去也毫无意义。
关键在于分阶段检索(staged retrieval),即需要一种轻量级的机制,能够将这海量的一万亿 token 逐步缩小到几百万甚至更小的可用规模。Kuba Rogut 提到,这是他们在 turbopuffer 日常思考的核心问题。turbopuffer 的客户在系统中存储并嵌入了数万亿 token 的数据,整个系统的价值正是通过分阶段筛选,精准提炼出合适的一万、十万乃至一百万 token,最终喂入大模型的上下文窗口。演讲在致谢与掌声中圆满结束。
- 面对极端长文本,核心架构解法依然是轻量级的“分阶段检索”(staged retrieval)。 - 盲目依赖超长上下文窗口会导致算力浪费与信噪比失衡,多阶段提纯是工程化落地的必由之路。 - Jeff Dean 对此有一句著名的精准论断:“And like the exact quote is you don't need a trillion at once, you need the right million.”
## Notable quotes > [09:44](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=584s) And like the exact quote is you don't need a trillion at once, you need the right million. — Jeff Dean
> [01:38](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=98s) And what we actually believe it is and you know kind of the definition we want to we want to give it is it's really giving the agents a set of tools to kind of progressively and iteratively find and reason over context. — Kuba Rogut
> [09:09](https://www.youtube.com/watch?v=UM6sFg_jdlE&t=549s) It's becoming super iterative and these agents are really understanding what they're searching and searching to understand more in a sense. — Kuba Rogut
## Mentioned Kuba Rogut, Turbopuffer, Jeff Dean, Boris Cherny, Cursor, Claude Code, Composer, Composer 2, Google, Gemini, Twitter / X, BM25, Merkle 树
## Video description Cursor added semantic search and measured a 24% increase in answer accuracy on their composer model, a 2.6% gain in code retention in large codebases, and a 2.2% drop in dissatisfied user requests. Those numbers look small until you factor in that semantic search does not fire on every query. Meanwhile Google search volume for RAG hit a new inflection point in mid 2025 and went through the roof. The Twitter "RAG is dead" discourse and the actual usage curve are moving in opposite directions.
Kuba Rogut's argument is that the problem was never retrieval, it was the narrow definition of it. RAG is not just a vector search call. It is vector search, full text search, glob, regex, and filters used iteratively by an agent that keeps searching until it has what it needs. He contrasts Claude Code (grep per session, no index, repeat cost every run) with Cursor (one time upfront indexing, lightweight tool calls at runtime). Claude Code's approach is not wrong, it is a deliberate tradeoff. The frame that clarifies it: embeddings are cached compute, and whether to cache depends on query volume. Jeff Dean's version: you do not need a trillion tokens at once, you need the right million.
Speaker info: - https://www.linkedin.com/in/kubarogut/ - https://x.com/rogutkuba
Timestamps: 0:00 Introduction to the "RAG is dead" discourse 1:12 Google search volume trends for RAG 1:39 Defining RAG vs. Agentic Search 3:15 Cursor's indexing and semantic search approach 6:10 Contrasting Claude Code (grep) vs. Cursor (indexed) 6:40 The concept of embeddings as cached compute 8:38 The shift from simple RAG to Agentic Retrieval 9:44 Jeff Dean on context windows and stage retrieval
---
Watch along with the corrected transcript, summary, timestamps and resources on this talk's official AIE page: https://ai.engineer/talks/UM6sFg_jdlE-rag-is-dead-right-kuba-rogut-redacted-username
Join our upcoming AI Engineer conferences (see https://ai.engineer landing page):
- AIEi Shanghai, November 5–6 — the first for meeting top Chinese labs and engineers - AIE CODE in SF, November 10–12 — the top AI Coding conference returns - AIEi Sydney, December 7–8 — the first AIEi run alongside NeurIPS 2026 in Sydney
---
[Source](https://www.youtube.com/watch?v=UM6sFg_jdlE)