LangChain押注智能体自愈闭环 推出SmithDB以替代传统日志
LangChain
智能体系统频繁遭遇无法被传统日志捕获的语义级故障,唯有将调用轨迹转化为评估数据并驱动模型、控制框架与上下文的协同迭代,才能实现无需人工干预的自主修复。
AI-assisted summary of How to Build Agents That Improve Over Time: Model, Harness, Context | Interrupt London — original source. Check the original for full context.
Source published:
Key ideas
- LangChain 将 Agent 解构为模型(Model)、控制层线束(Harness)与上下文(Context)三大支柱,并指出 Traces(追踪记录)和 Evals(评估)是支撑所有持续进化回路的底层公约数。 (0:00)
- 针对模型演进,SFT 适用于分类等简单任务且可通过 smithtune CLI 快速调用托管服务,而用于核心推理的 RL 虽工程复杂度极高且缺乏托管平台,但具备显著更高的能力上限。 (3:22)
- LangChain 推出专为语义故障打造的数据库 SmithDB 及 AI Search,并发布 LangSmith Engine 作为沙箱化 Deep Agent,以自动化分析 Traces、聚类错误根因并提交代码 PR 与单元测试。 (5:52)
- Harrison Chase 提出“Evals 即新时代 PRD”的理念,并确立让 Agent 自主感知错误、自动沉淀 Eval 数据点并自提修复补丁的“自愈闭环”北极星愿景。 (12:02)
Detailed notes
## Background 该视频由 LangChain 于 2026 年 10 月 27 日发布在 YouTube 频道,内容为 LangChain 联合创始人兼 CEO Harrison Chase 在伦敦 Interrupt 智能体大会上的演讲。视频简介指出,演讲围绕构建能够随时间自我进化的智能体展开,将智能体解构为模型、框架线束(Harness)和上下文三大核心模块,并深入探讨了 LangSmith Engine、SmithDB、评估体系(Evals)及未来自愈闭环的落地路径。
## TL;DR Harrison Chase 详细拆解了智能体系统的三大演进支柱:模型权重可通过监督微调(SFT)或强化学习(RL)迭代,外围框架代码可通过 LangSmith Engine 进行半自动补丁修复,而上下文则能通过记忆系统与 OpenWiki 等知识库动态更新。他强调追踪记录(Traces)与评估(Evals)是驱动整个改进飞轮的底层基石,并为此推出了专为语义故障设计的 SmithDB 与 AI Search。面对缺乏通用裁判的评测难题,他提出了语义对抗探测与红队测试方案,最终描绘了智能体自主捕获错误、沉淀评测集并自动完成自愈修复的“北极星”愿景。
## Atmosphere & style 整场演讲呈现出典型硅谷顶尖技术布道的高密度与清晰务实感,Harrison Chase 语速沉稳、逻辑严密,摒弃了空洞的概念炒作,直击智能体在真实生产落地中的隐蔽痛点。现场氛围极具工程师思维的理性与穿透力,从底层数据架构的抽丝剥茧,逐步升华至全自主自愈闭环的宏大构想。观众能清晰感受到一种面向下一代 AI 基础设施的探索激情与务实笃定的工程自信。
## Bulletin - [00:00](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=0s) LangChain 将 Agent 解构为模型(Model)、控制层线束(Harness)与上下文(Context)三大支柱,并指出 Traces(追踪记录)和 Evals(评估)是支撑所有持续进化回路的底层公约数。 - [03:22](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=202s) 针对模型演进,SFT 适用于分类等简单任务且可通过 smithtune CLI 快速调用托管服务,而用于核心推理的 RL 虽工程复杂度极高且缺乏托管平台,但具备显著更高的能力上限。 - [05:52](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=352s) LangChain 推出专为语义故障打造的数据库 SmithDB 及 AI Search,并发布 LangSmith Engine 作为沙箱化 Deep Agent,以自动化分析 Traces、聚类错误根因并提交代码 PR 与单元测试。 - [12:02](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=722s) Harrison Chase 提出“Evals 即新时代 PRD”的理念,并确立让 Agent 自主感知错误、自动沉淀 Eval 数据点并自提修复补丁的“自愈闭环”北极星愿景。
## Key takeaways - [00:00](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=0s) 构建能够随时间持续自我进化的 Agent 是 AI 领域的终极目标,其基础在于明确将 Agent 拆解为模型、Harness 与上下文三个独立组成要素。 - [03:22](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=202s) 模型的权重更新成本高昂,通常需由人类主导触发,其技术选型需权衡简单任务的监督微调(SFT)与长程复杂推理的强化学习(RL)。 - [05:52](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=352s) 修改 Harness(控制流、Prompts、工具集成)会全局影响所有用户,需保持人在回路;LangSmith Engine 借助沙箱内的 Deep Agent 实现了错误聚类与自动化修复方案生成。 - [07:13](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=433s) 上下文(Context)是目前最容易持续改进的维度,可在全局、组织及用户记忆层级动态演进,典型实践包括 Hex 的 Review Agent、Profound 的个人档案以及开源项目 OpenWiki。 - [09:23](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=563s) Traces 涵盖 Run、Trace、Thread 和 Trajectory 四级递进抽象,其核心价值在于不可篡改地记录确定性的输入、输出与事件执行序列。 - [10:44](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=644s) 传统系统日志无法捕获 Agent 系统隐蔽的“语义失败”,原生数据库 SmithDB 与自然语言驱动的 AI Search 重构了对语义故障的分诊与检索范式。 - [12:02](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=722s) Evals 取代传统 PRD 成为规范 Agent 复杂行为最精准的载体,通过定义预期输出与拒答边界来充当系统持续进化的安全护栏。 - [12:50](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=770s) 构建 Evals 面临三重核心挑战:获取逼真的真实输入、定义超越精确匹配的评测标准(如环境终态与工具序列),以及搭建避免污染生产系统的仿真环境。 - [16:01](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=961s) 针对缺乏“通用正确性裁判”的理论困境,LangSmith 红队测试采用语义对抗探测算法(对比等价问题的矛盾答复)主动挖掘 Agent 逻辑漏洞。 - [18:46](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=1126s) 持续改进飞轮的核心机制在于将线上反馈与问题 Trace 迅速沉淀为新的 Eval 数据点,以确保代码或模型迭代不会引发历史能力退步(Regression)。 - [19:28](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=1168s) LangChain 的北极星愿景是由 Agent 自主驱动整个改进飞轮:自发察觉错误、自建 Eval 基准、自诊断根因并自动修复 Harness、模型或上下文。
## Detailed walkthrough ### [00:00](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=0s) 构建随时间持续自我进化的智能体:三大核心支柱
Harrison Chase 开篇指出,LangChain 团队内部一直在深度思考一个引领未来行业发展方向的核心命题:“which is building agents that improve over time.”(那就是构建能够随时间持续自我进化的智能体)。尽管通过完全自动化的方式实现这一目标在短期内尚无法彻底普及,但这始终是引导 LangChain 思考产品与技术路径的“北极星”(North Star)。
要谈论如何改进智能体,必须先精确定义智能体的构成。Harrison Chase 强调:“Because you can't improve it if you don't define what it is.”(因为如果你不界定它到底是什么,你就无法去改进它)。LangChain 将一个完整的智能体解构为三个独立但紧密关联的组成要素:
1. **模型(Model)**:智能体的推理与决策中枢(Powerhouse)。除了承担核心工作负载(Core Workload)的大模型之外,外围还会搭配负责 Guardrails(安全护栏)与 Evaluations(评估)的辅助模型。 2. **线束/框架(Harness)**:包裹在模型外围、赋予其真正实用价值的系统控制层(例如 LangChain 的 Deep Agents,或是 Claude Code、Codex)。模型负责推理决策,而 Harness 则负责掌控智能体能看到什么、调度模型意图的具体动作执行、观察与校验执行结果、将状态持久化写入磁盘或数据库,并管理整个循环的控制流。LangChain 打造的 Deep Agents 范例 Harness 封装了一整套最佳实践,包括沙箱与文件系统(Execution Environment)、开箱即用的上下文管理(Skills、Memory、Summarization),以及用于处理人机协作与多智能体分工的 Human-in-the-loop 和 Subagents 机制。 3. **上下文(Context)**:智能体在运行中引入的外部知识层,表现为 Markdown 文档、项目文件、系统工具以及各种外部文本与知识库来源。
```mermaid flowchart TD accTitle: Agent Architecture Overview accDescr: An architecture diagram breaking down an agent into Model, Harness, and Context. subgraph AgentSystem["Agent Architecture"] direction TB C["Context\n(Markdown, Files, Tools, Knowledge)"] H["Harness: Deep Agents / Claude Code\n(Control Flow, Sandbox, Memory, Skills)"] M["Model: Core & Periphery\n(Reasoning, Guardrails, Evals)"] C --> H H <--> M end ```
针对这三个维度的演进,Harrison Chase 提出了三种不同的改进驱动模式: - **手动驱动(Manual / Human-driven)**:由人类 AI 工程师主导整个闭环,这也是当下绝大部分 AI 工程师的日常工作模式。 - **人在回路(Human in the loop)**:由后台守护进程持续监控并提出优化方案,但最终上线改动必须经由人类审核与批准。 - **全自动化(Fully Automated)**:系统在无需人类干预的情况下完成自检、自调优与上线。虽然目前技术水平远未达到,但这代表了终极愿景。
---
[03:22](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=202s) 模型的持续演进:SFT 与 RL 的权衡与实践
在模型的演进路径上,改进通常意味着更新模型的权重(Weights)。开发者可以选择更新驱动核心决策的模型,也可以专门调整外围的 Guardrail 或 Eval 模型。Harrison Chase 提醒,权重训练极其耗费时间与资本,因此这一动作几乎总是由人类发起并深度把控:“It would be pretty costly to just do this continuously in the background or on a whim.”(如果只是心血来潮或在后台无休止地持续自动训练模型,成本将极其高昂)。
在具体技术路线选择上,目前主要存在两种方式:
| 训练范式 | 适用场景 | 实现机制与工具链路 | 现状与天花板 | |:--- |:--- |:--- |:--- | | **监督微调 (SFT)** | 分类、信息抽取、摘要生成等边界清晰的较简单任务(Simpler Tasks) | 从 LangSmith 中拉取轨迹数据(Traces),筛选出表现优异的高质量样本,格式化处理后调用 API 训练。LangChain 推出了 CLI 工具 `smithtune`,可无缝对接 Fireworks、Baseten 等现成 SFT 平台 | 生态成熟,拥有大量托管服务(Managed Offerings),但上限受限于示范数据质量 | | **强化学习 (RL)** | 驱动智能体核心规划、推理与复杂长程调用的核心模型(Core Model) | 预先定义一批任务(Tasks),在环境中执行 Rollouts 让智能体运转,实时打分、反向传播更新模型权重,再进行下一轮 Rollouts 迭代 | 目前缺乏优秀的托管平台,工程实现极其复杂,但能力上限显著高于 SFT(“Higher ceiling”) |
---
[05:52](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=352s) Harness 的进阶演化:LangSmith Engine 的自动化代码与指令调优
当需要改进 Harness 时,本质上是在修改控制逻辑、核心代码、Prompt 指令集或集成的 Tools。由于 Harness 的改动往往会直接下发并影响系统内的所有终端用户,因此在此处保留 Human in the loop 显得尤为关键。标准的工作流通常是:审查大量 Traces、识别共性异常缺陷、制定修复方案并回归验证。
为了在这个环节减少人工负担并逐步迈向自动化,LangChain 打造了 LangSmith Engine。Harrison Chase 解构了 LangSmith Engine 的底层实现:“Engine itself is nothing more than a deep agent in a sandbox with LangSmith CLI and some specialized subagents, some specialized skills, and some specialized prompts.”(Engine 本质上就是一个运行在沙箱中的 Deep Agent,配备了 LangSmith CLI 工具,以及一些专门定制的 Subagents、专业技能与专用 Prompts)。
LangSmith Engine 会作为后台智能体持续监控生产环境的执行 Traces,自动对错误聚类并归纳问题根因。随后,它会主动尝试生成代码修复补丁、提交 GitHub Pull Request、编写针对性的单元测试,并补充 Eval 数据集样本,最终交由人类工程师做最后的审查与合并。
---
[07:13](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=433s) Context 的灵活扩展:Hex、Profound 与开源项目 OpenWiki
在智能体的三个部分中,Harrison Chase 认为上下文是目前最容易演进升级的维度:“this is the easiest to update. This is just text.”(这是最容易更新的,因为它纯粹就是文本)。由于文本改动轻量且无须触碰底层权重或代码,对 Context 的优化可以轻松下沉到不同的层级:既可以在全局智能体级别沉淀公用规则,也可以在租户组织(Org)级别甚至单个终端用户(User)级别维护专属的记忆库(Memory)。
```mermaid flowchart LR accTitle: Harness and Context Improvement Loops accDescr: A flow diagram showing how traces lead to updates in Harness and Context via Engine and Memory systems. subgraph SignalCapture["Trace Aggregation"] T["Production Traces"] end
subgraph HarnessPath["Harness Loop (Global)"] LE["LangSmith Engine\n(Deep Agent in Sandbox)"] PR["PR / Tests / Evals\n(Human Approval)"] HCode["Harness Code & Prompts"] T --> LE --> PR --> HCode end
subgraph ContextPath["Context Loop (Multi-level)"] RA["Review / Synthesis Agent"] Mem["Knowledge / Memories\n(Org Records & User Records)"] CData["Dynamic Context Injection"] T --> RA --> Mem --> CData end ```
Harrison Chase 列举了业界在上下文持续优化方面表现突出的代表案例与自身实践: - **Hex**:作为一款数据分析 Agent 产品,Hex 将统一上下文层(Unified Context Layer)作为核心卖点。系统在后台运行一个专职的“Review Agent”,持续分析用户的交互日志,自动寻找 Context 中存在的知识断层(Context gaps)并提出修补建议。 - **Profound**:将上下文提炼机制推进到用户个体维度。系统不仅在企业层级不断将交互沉淀为“Brand Records”(品牌记录),还会在后台分析用户与 AI Marketer 的每一次会话,构建细粒度的“Personal Records”(个人记忆)。 - **OpenWiki(LangChain 开源项目)**:LangChain 内部孵化的一套开源方案,旨在为代码智能体构建一个可自我迭代的“外部大脑”。OpenWiki 会通过解析用户的代码仓库进行初始构建,并与 Codex、Claude Code 等编程智能体的 Trace 紧密结合;当检测到代码智能体在某些库、文件或架构规范上屡屡碰壁受挫时,OpenWiki 会自动捕获这些失败轨迹,将吸取的教训回填到 Wiki 知识库中。
在盘点了 Model、Harness 和 Context 这三条演进路径后,Harrison Chase 总结指出了贯穿所有循环的底层公约数:“We think there are two things that are common, traces and evals. And we think these are the core foundation of this improvement loop”(我们认为贯穿始终的有两样共同要素:Traces 和 Evals。我们坚信它们正是支撑起整个改进闭环的核心基石)。
[09:23](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=563s) 追踪记录(Traces)的四级结构与核心价值
Harrison Chase 指出,在打造让 Agent 随时间自我进化的闭环时,不同业务场景与垂直领域的改善回路截然不同。对于通过记忆来优化上下文而言,最艰难的部分往往在于选择该记住什么、忽略什么以及如何存储记忆,这很大程度上取决于 Prompt 的设计,具有强烈的领域特定性。然而,LangChain 认为有一套通用的底层支柱能够赋能所有场景,那就是追踪记录(Traces)与评估(Evals)。
为了厘清概念,Harrison Chase 详细拆解了 LangSmith 体系中关于追踪的四层核心概念: 1. **Run(单次运行)**:这是最细粒度的原子操作,代表模型的一次单独调用或工具(Tool)的一次单独执行,本质上就是一个独立的步骤。 2. **Trace(追踪)**:当把多个连续的 Run 累加串联在一起,就形成了一条 Trace。如果用户向 Agent 发送一条消息,Agent 在后台执行了一连串复杂操作,这一整套后台工作的步骤序列就是一个 Trace。 3. **Thread(对话线程)**:将用户与 Agent 在多次交互中产生的多个 Trace 串联起来,就构成了一个包含完整上下文的对话线程(Thread)。 4. **Trajectory(轨迹)**:这是对整个 Thread 采用标准化格式进行投影展现的全局视图。
Harrison Chase 强调,无论是哪一个层级,其核心都在于完整记录下不可篡改的事实链条。他对此总结道:“The important thing is that for all of these, you have the exact inputs, the exact outputs, and the exact sequence of events.” 无论是后续打算对基础模型进行微调(Fine-Tuning),还是借助 Coding Agent 来排查定位 Bug 并修改代码 Harness,这种对输入、输出以及具体事件顺序的确定性回溯都是必不可少的前提。
```mermaid flowchart TD accTitle: Agent 追踪层级结构 accDescr: 展示从单次运行到全局轨迹的四层数据抽象
subgraph Hierarchy ["Trace 数据层级体系"] A["Run 单次运行<br>(模型或工具的单步执行)"] --> B["Trace 追踪<br>(单次请求触发的多步骤执行序列)"] B --> C["Thread 线程<br>(包含多轮交互对话的完整记录)"] C --> D["Trajectory 轨迹<br>(线程在标准化格式下的全局视图)"] end ```
---
[10:44](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=644s) 专为语义故障打造的数据库:SmithDB 与 AI Search
在明确了 Trace 的定义后,Harrison Chase 提出了一个核心观点:Trace 代表了一种全新的数据形态,传统的日志系统已经无法承载它的分析需求。传统软件工程排查的是堆栈报错或 HTTP 500 错误,而 Agent 系统出现的往往是“语义失败”(Semantic Failures)或“逻辑失败”。这些隐蔽的逻辑偏差和上下文崩塌完全不会出现在传统的系统日志中,而是潜伏在错综复杂的对话上下文中。
面对这种新的数据特征,开发者如何处理问题、如何分诊(Triage)故障,以及如何与数据交互并进行检索,都需要彻底重构。正因如此,LangChain 自主研发并推出了专为 Agent 可观测性打造的原生数据库——SmithDB。该数据库在架构上专门针对此类语义化数据的写入、存储、查询与可视化展示进行了深度调优。
为了解决海量 Trace 难以精准筛选的问题,LangChain 推出了基于 SmithDB 的 AI Search(AI 过滤器)。开发者不再受限于传统的关键词匹配或元数据字段过滤,而是可以直接输入自然语言问题(例如“寻找 Agent 出现逻辑自相矛盾的对话”)。在底层架构上,系统会自动针对每一条 Trajectory 进行语义打分,判断其是否契合用户的检索意图,从而为复杂的 Agent 数据提供了全新的检视与检索范式。
---
[12:02](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=722s) Evals 是 AI 时代的新一代 PRD
在拥有了可观测性底座之后,闭环改善的下一个关键支柱是评估(Evals)。Harrison Chase 表达了一个在业界广为流传的观点:“First, they're the new PRD.” 在传统软件工程中,产品经理会撰写详尽的产品需求文档(PRD)来阐明系统行为;但在大模型与 Agent 的世界里,边缘边界情况(Edge Cases)不计其数,单纯依靠自然语言文档早已无法覆盖系统的所有行为。
此时,代码化的 Evals 便成为了定义系统预期表现最精准的载体。Evals 本质上是在定义“什么才是良好的表现”(What good looks like)——它不仅规定了 Agent 在面对特定查询时应该给出怎样的反应,更明确了面对哪些越界指令时必须拒绝回答。通过划定这些明确的安全边界与行为规范,Evals 在整个 Agent 持续迭代的改善回路中充当了不可或缺的护栏,确保系统在持续进化时始终处于安全可控的区间之内。
---
[12:50](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=770s) 构建 Evals 的三重核心挑战
Harrison Chase 直言,尽管评估至关重要,但构建 Evals 极其困难。这并非依靠现成的商业工具就能一蹴而就,正如他所谈到的:“There's not really a silver bullet for evals out there.” 基础设施提供商可以提供评测运行环境和评测结果的可视化看板,但评估本身必须具备极强的领域特定性(Domain-Specific),无论是评测数据集还是评估器(Evaluators)的逻辑,都与具体业务紧密绑定。他将构建 Evals 的难点拆解为三个维度:
1. **获取逼真的真实输入(Realistic Inputs)**:在系统上线前,开发者很难预先穷举用户的真实提问方式。真实用户的提问往往天马行空,甚至完全偏离主题或在边缘试探。如果无法枚举真实输入,就必须依赖生产环境中的 Traces 来反哺评测集。 2. **定义评测标准(Defining What Good Looks Like)**: - **精确匹配(Exact Match)**:要求模型必须提及某个特定数值或包含精准短语。但在复杂 Agent 场景中,这种刚性规则往往过于严苛且不切实际。 - **基于准则的评判(Criteria-based)**:通过正向或反向规则来约束回答,例如“回答中必须包含某要素”或“严禁提及某内容”。 - **环境终态判断(End State of the Environment)**:Agent 通常不仅输出文字,更会操作数据库或修改文件系统。此时评测的核心不应停留在最终文本上,而应检验环境的最终状态是否正确。 - **工具调用序列评估(Sequence of Tool Calls)**:某些业务严格依赖执行过程,评估器需要校验 Agent 是否按照规范的顺序依次调用了正确的工具。 3. **仿真环境的搭建(Simulation Environment)**:当 Evals 需要端到端运行时,Agent 不可避免地会调用各类工具。如果 Agent 在生产环境中需要直接读写数据库,开发者绝不能在运行大批量评估时直接轰击真实的生产系统。
为解决测试安全问题,开发者必须搭建沙箱仿真环境(如 Mock 数据库或独立的 Dev 环境)。Harrison Chase 指出,如果 Agent 交互的是内部自建系统,搭建测试环境尚可把控;但若系统深度集成了 Salesforce 等复杂的外部 SaaS 工具,想要模拟其状态就会变得异常棘手。
---
[16:01](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=961s) 主动出击:红队测试(Red Teaming)与无裁判困境
在排查 Agent 的错误时,业内常见两种手段:一种是在上线后人工检查生产环境中的 Traces,寻找报错节点;另一种是邀请领域专家(SME)模拟用户操作去尝试“玩坏”Agent。然而,专家测试成本高昂且难以规模化,而仅仅依赖生产日志又属于“事后诸葛亮”——某些低频恶性 Bug 在生产环境中首次暴露时往往已经造成了业务损失。
针对这一痛点,LangSmith 推出了主动防御的红队测试(Red Teaming)功能,旨在将潜在隐患扼杀在上线之前。然而,在自动化红队测试中最棘手的问题在于:如何判断回答是否正确?Harrison Chase 深刻指出了缺乏“通用正确性裁判”(Universal Judge)的理论困境:如果系统本身能在运行时精准判断每一次回答的对错,那么直接把这个判断逻辑放入 Agent 主循环中即可,一旦判定错误就重新生成。
由于在现实中不存在这种全知全能的判决器,LangChain 另辟蹊径,设计了一系列巧妙的算法来探测 Agent 的逻辑破绽: - **语义对抗探测算法**:向 Agent 同时发送两条在语义上完全一致但在表述形式上不同的测试查询。如果 Agent 面对这两个等价问题给出了语义截然不同的矛盾答复,系统就能立刻判定其中必定存在错误,进而针对这两条轨迹展开深度调查。这种方法虽然因为成本和延时无法置入实时对话流,但在离线评测中提供了坚实可靠的参照锚点。 - **全方位缺陷扫描**:除了针对事实正确性,红队测试还在持续扩展针对安全性(Security)、公平性(Fairness)等维度的检查矩阵。
Harrison Chase 总结道,红队测试的终极目标是为开发者提供一个可灵活配置的检查项菜单,自动并发运行 Agent 并即时生成详尽的红队安全报告;而这一流程同样深度依赖前面提到的仿真环境技术,确保在自动化探测与模拟攻击时绝不触碰生产系统。
[18:46](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=1126s) 持续改进 Agent 的飞轮模型
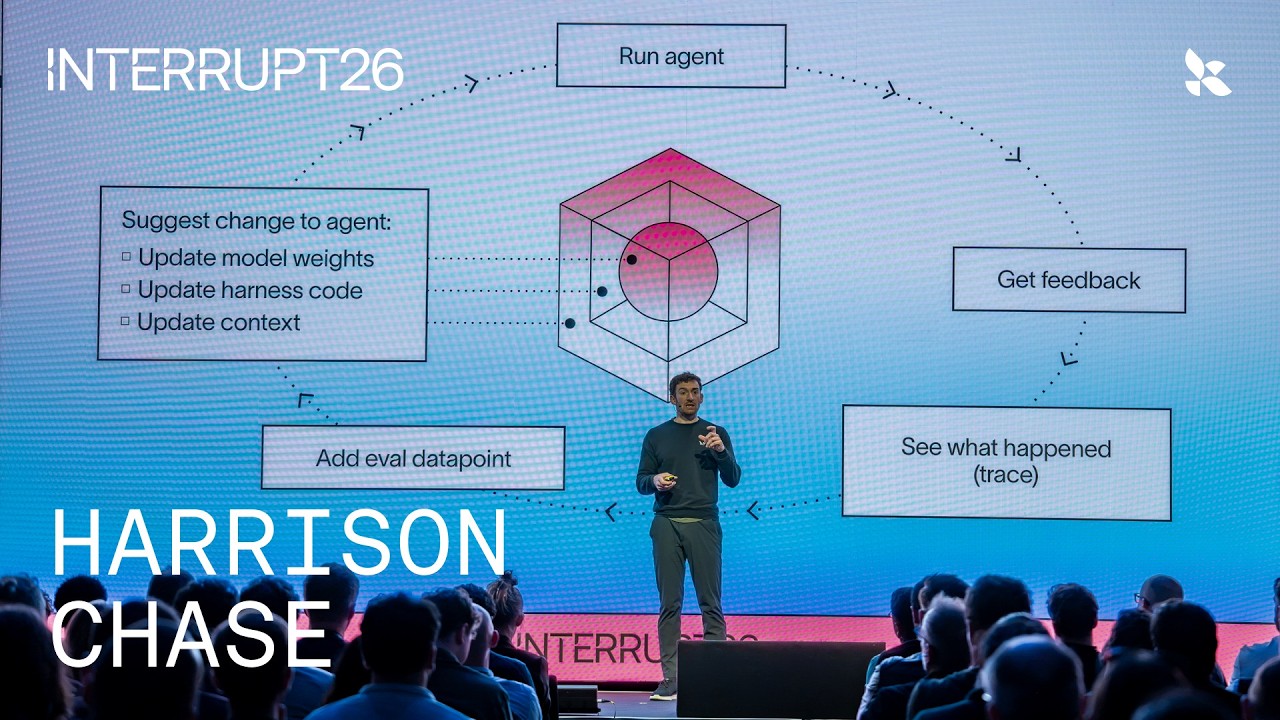
在构建 Agent 的模拟评估环境方面,仍有海量的工程与探索工作要做,LangChain 的 Labs 团队正针对这一领域展开大量深度研究。从全局视角来看,若想让 Agent 随着时间推移不断进化,核心就在于建立起一套高度抽象却闭环运转的“改进飞轮”(Improvement Flywheel)。整个周期的起点是运行 Agent 并收集对其表现的反馈——这种反馈既可以来自人类专家的直接标注,也可以由在线判定模型(Online Judge)自动给出。
拿到反馈之后,开发者需要深入到具体的 Trace(调用追踪)内部,抽丝剥茧地定位导致该反馈的底层原因。紧接着,必须把这个暴露了问题的具体用例沉淀为测试集中的一个评估数据点(Eval Data Point)。这一步至关重要,它保证了后续在迭代修复该问题时,能够准确衡量系统是否真正获得了提升,同时确保不会引发针对历史已有用例的退步(Regression)。在此基础之上,开发者开始针对 Agent 的三大支柱提出具体的修改方案:要么更新模型权重(Model Weights),要么修改 Harness 代码逻辑,要么调整上下文(Context)记忆。正如 Harrison Chase 总结道:“So at a high level, this is like the really high level abstract kind of like flywheel that you want to set up in order to improve your agent over time.”
```mermaid flowchart TD accTitle: Agent持续改进飞轮 accDescr: 展示从运行Agent、获取反馈、分析Trace、沉淀Eval到更新模型、代码或上下文的闭环流程
subgraph Monitoring ["监控与评估"] A["运行 Agent"] --> B["获取反馈<br/>(人类标注 / 在线 Judge)"] B --> C["检查 Trace 追踪详情"] C --> D["沉淀为 Eval 数据点<br/>(防止指标倒退)"] end
subgraph Optimization ["方案迭代"] D --> E["生成修改方案"] E --> F1["更新模型权重<br/>(Fine-tuning / RL)"] E --> F2["修改 Harness 代码"] E --> F3["调整上下文 / 记忆"] end
F1 --> A F2 --> A F3 --> A ```
- **反馈来源**:系统必须支持双轨制反馈输入,包含真人介入评估以及自动化在线 Judge 评估。 - **防止倒退**:将缺陷用例直接转化为持久化的 Eval 数据点,是软件工程回归测试理念在 Agent 架构中的关键落地。 - **改动落脚点**:每一次迭代改进的载体始终明确分布在三处——底层模型权重、外围框架 Harness 代码,或是注入的上下文信息。
---
[19:28](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=1168s) 北极星愿景:由 Agent 自主驱动的自愈闭环
展望更长远的未来演进方向,终极形态应当是由 Agent 完全自主地完成整个改进闭环,而无需人工在各个环节推拉驱动。在理想的“北极星愿景”(North Star Vision)中,Agent 能够在运行过程中敏锐地自我感知到错误;一旦察觉失败,它会主动为自己生成一个对应的 Eval 数据点,随后自行诊断根因并提议改动方案,最终自主生成针对上下文、Harness 业务代码或模型权重的修复补丁。
LangChain 团队已经在 LangSmith Engine 的功能设计与演进规划中探索该愿景的具体落地形态。Harrison Chase 坦言,这套极度精简抽象的高层循环背后隐藏着极为庞杂的落地细节与工程挑战,团队目前正倾注大量精力去攻克其中的各种微观难题。Harrison Chase 在演讲尾声强调:“The really kind of future version of this is where all of this is done by the agent itself.” 他热情邀请在场所有正在思考并尝试构建该自动化改进闭环的开发者与团队交流碰撞,共同探索 Agent 自我进化的技术边界。
- **自主感知与沉淀**:未来的 Agent 不仅负责执行任务,还具备自我监督能力,能够在犯错时自动将其转化为可供回溯的基准测试样本。 - **全栈自我修复**:Agent 的自愈能力跨越三个技术层级,涵盖动态修正记忆与上下文(Context)、重写执行流控制代码(Harness),甚至发起针对自身权重的再训练(Model Weights)。 - **LangSmith Engine 路线图**:LangChain 将这一全自动进化闭环确立为 Engine 产品的核心指引目标(North Star),正加速攻坚其中的关键技术细节。
## Notable quotes > [12:50](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=770s) There's not really a silver bullet for evals out there. — Harrison Chase
> [07:13](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=433s) We think there are two things that are common, traces and evals. And we think these are the core foundation of this improvement loop — Harrison Chase
> [00:00](https://www.youtube.com/watch?v=xy_7SzwsIjM&t=0s) Because you can't improve it if you don't define what it is. — Harrison Chase
## Mentioned Harrison Chase, LangChain, LangSmith, LangSmith Engine, SmithDB, smithtune, OpenWiki, Claude Code, Codex, Fireworks, Baseten, Hex, Profound, Salesforce
## Video description Harrison Chase, Co-Founder and CEO of LangChain, splits an agent into three parts, the model, the harness, and the context, and explains how each one can improve over time: the model's weights through supervised fine-tuning with LangSmith Fine-Tuning and its smithtune CLI, or through RL for more complex tasks; the harness through LangSmith Engine, a deep agent that runs over traces, clusters issues, and proposes fixes with a human in the loop; and the context through memory, where he points to Hex and Profound as companies he thinks do this well and to LangChain's open source OpenWiki project. He argues that traces and evals are the common foundation of all three loops, which is why LangChain built SmithDB and the new LangSmith AI Search for trace data, then covers what makes evals hard (realistic inputs, defining what good looks like, simulation environments) and how red teaming in LangSmith Engine looks for agent mistakes proactively. He closes with what he calls a North Star vision: an agent that notices its own mistakes, creates its own eval data points, and suggests its own fixes.
This session was captured at Interrupt London, the agent conference by LangChain.
Chapters: 0:00 What is an agent, and how do you improve it? 3:22 When should you fine-tune the model behind your agent? 5:52 How LangSmith Engine proposes fixes to your harness 7:13 Why context is the easiest part of an agent to improve 8:42 How OpenWiki gives coding agents a brain that updates 9:11 Why traces and evals are the foundation of improvement 10:44 Why LangChain built SmithDB and AI Search for traces 12:02 Why evals are the new PRD 12:50 Why is building evals so hard? 14:57 How to run evals without hitting production systems 16:01 How red teaming finds agent mistakes ahead of time 16:54 How do you judge correctness without a universal judge? 18:54 The flywheel that improves your agent over time 19:28 What if the agent ran its own improvement loop?
Resources: → LangSmith Engine: https://www.langchain.com/langsmith/engine → LangSmith Fine-Tuning (smithtune): https://docs.langchain.com/langsmith/smithtune → OpenWiki on GitHub: https://github.com/langchain-ai/openwiki → LangSmith: https://www.langchain.com/langsmith → Interrupt, the agent conference by LangChain: https://interrupt.langchain.com
[Source](https://www.youtube.com/watch?v=xy_7SzwsIjM)