Databricks开源Omnigent并推自愈运维 押注私有上下文化解算力内耗
Databricks
企业级AI的真正阻碍并非大模型基础智力不足,而是缺乏受治理的私有业务上下文,唯有通过统一下下文系统才能制止智能体陷入死循环与算力浪费。
AI-assisted summary of Data + AI Summit Keynote 2026 | Day 2 — original source. Check the original for full context.
Source published:
Key ideas
- Databricks 推出并全面开源 Meta-Harness 框架 Omnigent,以中立规范整合 Claude Code、Cursor 等碎片化 Harness,提供基于 Docker、PostgreSQL 与 OpenTelemetry 的多 Agent 协同编排与上下文敏感安全控制。 (18:56)
- 正式发布 Agent Bricks 记忆与安全组件,包含基于 Lakebase 的 Agent Memory Services 及毫秒级冷启动的 Databricks Sandbox,配合 Unity AI Gateway 的动态受污染(Tainted)状态管控实现防数据外泄与成本分流。 (44:23)
- 发布 Serverless GPU 算力平台 AI Runtime 及面向生产的机器学习智能体矩阵:Genie Code for ML 实现 90 分钟从零构建上线模型,Genie ZeroOps for ML 首次将人类从 On-Call 维护中解放出来实现模型自主修复与自愈。 (97:07)
- Databricks 收购云原生安全分析平台 Panther Labs,并发布基于湖仓底座的原生 Agentic 安全平台 Lakewatch 与 Agentic CDP CustomerLake,推动无限营销战役(Infinity Campaigns)与端到端自主威胁狩猎。 (120:00)
Detailed notes
## Background 该视频由 Databricks 官方频道于 2026 年 6 月 18 日发布在 YouTube 平台上,内容为 Data + AI Summit 峰会第二天的全长主题演讲。简介表明,大会汇聚了超过 3 万名数据工程师、科学家、分析师与业务领袖,重点发布了开源创新、Databricks 平台重磅升级,以及面向智能体时代的营销与安全垂直解决方案。
## TL;DR 主题演讲围绕“企业级智能体需要的是上下文而非单纯更高的模型智力”这一核心论点展开,全面推出了构建智能体基础设施所需的关键技术。Databricks 发布了开源 Meta-Harness 框架 Omnigent,以解决 Agent 运行环境割裂与互操作难题,并基于 Agent Bricks 带来了 Agent Memory Services、Databricks Sandbox 与深度整合成本策略的 Unity AI Gateway。此外,演讲还展示了支持氛围编码(Vibe Coding)安全落地的 Databricks Apps 与 Genie App Builder、端到端自动化机器学习工具(AI Runtime、Genie Code for ML、Genie ZeroOps),以及颠覆传统模式的原生 Agentic CDP CustomerLake 和智能体安全平台 Lakewatch。
## Atmosphere & style 整场 Keynote 节奏紧凑而充满雄心,兼具硬核技术拆解与高度工程化的工业底气。演讲嘉宾们交替登场,从 Ali Ghodsi 沉稳宏大的顶层战略定调,到 Matei Zaharia 直指多 Harness 碎片化痛点的犀利剖析,再到实机演示中即兴幽默与真实代码交织的松弛感,全方位展现了工程领导者的自信。现场穿插的大量真机终端操作、策略拦截与端到端自动化修复演练,让观众切身感受到大模型正从单纯的概念验证(PoC)与“Token 狂飙”,切实转向由上下文治理、企业级安全与生产级自动化驱动的价值深水区。
## Bulletin - [18:56](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=1136s) Databricks 推出并全面开源 Meta-Harness 框架 Omnigent,以中立规范整合 Claude Code、Cursor 等碎片化 Harness,提供基于 Docker、PostgreSQL 与 OpenTelemetry 的多 Agent 协同编排与上下文敏感安全控制。 - [44:23](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=2663s) 正式发布 Agent Bricks 记忆与安全组件,包含基于 Lakebase 的 Agent Memory Services 及毫秒级冷启动的 Databricks Sandbox,配合 Unity AI Gateway 的动态受污染(Tainted)状态管控实现防数据外泄与成本分流。 - [01:37:07](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=5827s) 发布 Serverless GPU 算力平台 AI Runtime 及面向生产的机器学习智能体矩阵:Genie Code for ML 实现 90 分钟从零构建上线模型,Genie ZeroOps for ML 首次将人类从 On-Call 维护中解放出来实现模型自主修复与自愈。 - [02:00:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=7200s) Databricks 收购云原生安全分析平台 Panther Labs,并发布基于湖仓底座的原生 Agentic 安全平台 Lakewatch 与 Agentic CDP CustomerLake,推动无限营销战役(Infinity Campaigns)与端到端自主威胁狩猎。
## Key takeaways - [00:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=0s) 企业级 AI 落地的瓶颈不再是模型推理智力本身,而是缺少与企业私有知识深度融合的上下文,必须依托选择权、掌控力与安全、成本控制及统一上下文四大支柱推进。 - [11:11](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=671s) 大模型本质仅是 Token 预测器,外层的 Agent Harness 缺乏互操作性标准,导致多 Agent 协同面临组合、跨窗口移交与提示注入误操作等严重瓶颈。 - [18:56](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=1136s) 开源 Meta-Harness 框架 Omnigent 通过顶层双层架构(Runner 与可选 Server)规范 Agent 执行流程,支持会话分支派生(Fork)、多 Agent 监督决策与状态化预算拦截。 - [36:11](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=2171s) 智能体开发中规划回路(Agent Loop)仅占 1%,剩余 99% 的工作量深陷在权限认证、协议集成、上下文提取与成本失控等基础设施陷阱中。 - [45:18](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=2718s) Agent Bricks 推出 Agent Memory Services 与 Databricks Sandbox,利用 OnBehalfOf 降权机制与毫秒级虚拟机环境为智能体提供安全直通企业数据的隔离执行空间。 - [46:51](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=2811s) Unity AI Gateway 引入上下文安全策略与智能分流,根据任务复杂度跨模型调度,配合柔性预算治理遏制过度消耗(Tokenmaxxing),推动企业转向价值最大化。 - [01:02:40](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=3760s) Satya Nadella 指出企业正由记录系统演变为上下文系统,通过业务追踪数据与强化学习,小参数模型(如 5B)可在特定场景击败通用大模型并积累企业 Token 资本。 - [01:15:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=4500s) 针对从氛围编码(Vibe Coding)到生产环境的合规鸿沟,Databricks Apps 推出 AppSpaces 空间治理与动态缩容至零的 Serverless Micro Apps 架构。 - [01:20:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=4800s) Genie App Builder 借助 Genie Ontology 业务语义网,可将平民开发者构建的原型秒级转化为受控生产应用,并内置未授权数据调用与分享阻断规则。 - [01:34:22](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=5662s) 生产级机器学习隐性工程债务阻碍了场景拓展,AI Runtime 提供免预付费承诺的分布式 Serverless GPU 算力,为全流程自动化奠定底座。 - [01:42:43](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=6163s) Genie Code for ML 与 Genie ZeroOps for ML 实现了生产级 ML 的端到端自动化,由智能体全天候接管特征排障、重训与灰度发布,人类仅需进行最终点击审批。 - [01:52:48](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=6768s) 消费者全面转向委托 AI 代理比价下单倒逼营销变革,CustomerLake 原生嵌于湖仓构建 Customer 360,驱动一人一策常青运转的无限营销战役(Infinity Campaigns)。 - [02:20:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=8400s) 传统 SIEM 因容量与成本被迫截断日志导致无法应对 AI 自动化攻击,湖仓安全平台 Lakewatch 借助 Agent 贯通 OCSF 数据清洗、情报检索、回测及代码后门溯源全流程。 - [02:40:48](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=9648s) Databricks 全栈智能体底座以 Lakeflow、Lakehouse RT、Lakebase 为基础,借助 Genie 1 统一入口与 Genie Ontology 为全企业构建开放无锁定的智能体数据基础。
## Detailed walkthrough ### [00:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=0s) 开场回顾:AI 的核心不是更多智慧,而是更多“上下文”
峰会第二天早上 8 点整,Databricks 联合创始人兼 CEO Ali Ghodsi 走上舞台。他首先调侃大家竟然都能准时在早晨 8 点赶到现场,并坦言自己要起这么早也着实不易。在切入当天的重磅发布之前,Ali 回顾了前一天定下的技术基调:行业并不需要模型本身变得无限聪明,真正缺失的是企业级上下文。
> “我们认为 AI 本身已经足够聪明了。我们不需要 AI 拥有更高的智力,我们需要的是更多的上下文。”——Ali Ghodsi
Ali 强调,各行各业的企业内部沉淀了海量的业务背景、历史数据与流程逻辑,只要能将这些组织内独有的上下文精准注入 AI,AI 就能施展真正的魔力。为了彻底解决上下文难题,企业必须把握好四个关键支柱: 1. **自主选择权(Choice & Openness)**:坚持开源,允许自由选择任何模型、底层基础设施、云厂商和存储文件格式。回顾过去二三十年,阻碍企业创新的最大元凶就是不断被锁定在复杂技术栈的各类私有软件中,Databricks 自开源社区起家,破除厂商锁定是其一贯的使命。 2. **掌控力与安全性(Control & Security)**:针对 AI 代理、底层数据和基础设施建立完备的安全规则、治理策略与可审计性。 3. **成本控制(Cost Controls)**:随着 AI 应用铺开,推理和算力开销将呈指数级爆发。未来 6 至 12 个月内,极度昂贵的账单甚至可能成为阻碍大部分企业使用 AI 的“不可承受之重”。 4. **统一上下文(Context via Genie Ontology)**:通过 Genie Ontology 在后台持续计算并学习组织内的全部数据(不仅限于 Databricks 或 Lakehouse 内部),如同为企业级数据构建了一个专属的“PageRank”,在大幅加快代理运行速度的同时显著降低成本并提升输出质量。
```mermaid flowchart TD accTitle: Enterprise Context Foundation accDescr: 企业级 AI 上下文落地的四大核心支柱体系架构
subgraph FourPillars["企业级 AI 上下文四大支柱"] Choice["1. 自主选择权 (Choice)<br/>开源、跨云、模型与格式零锁定"] Governance["2. 安全管控 (Control)<br/>策略审计、数据安全与权限边界"] Cost["3. 成本控制 (Cost Control)<br/>Advisor 模式降本、消除昂贵账单"] Ontology["4. 上下文沉淀 (Context)<br/>Genie Ontology 持续学习与索引"] end
DataSources["企业全域多源数据"] --> Ontology FourPillars --> EnterpriseAI["高可用、低成本的企业级智能体 (Agents)"] ```
[03:21](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=201s) 当日重磅发布速览:Agent Bricks、Advisor 模式与智能体产品矩阵
在梳理完宏观架构后,Ali 详细预告了当天 keynote 的技术分享阵列。Casey 和 Ankit 将登台介绍面向开发者的 **Agent Bricks**,该平台不仅集成了沙盒(Sandbox)安全执行环境和持久化记忆(Memory),还深度集成了刚刚开源的 **Omnigent** 框架。
在模型开销控制上,Ali 重点推荐了结合 Agent Bricks、Omnigent 和 Unity AI Gateway 的 **Advisor 模式(Advisor Pattern)**: - 系统默认采用成本极低、轻量的小模型(如开源模型)执行绝大部分日常任务或编写代码; - 同时为小模型挂载一个工具:一个能力极强但调用单价高昂的顶级大模型; - 系统设定严格约束,规定小模型仅在真正陷入困境(Get stuck)时才触发调用该高级模型进行求助或纠错。
> “其运作逻辑是,你使用一个便宜得多、体量更小的模型——它可以是个开源模型——但你给它配置一个工具。这个工具是一个聪明得多、更庞大但也更昂贵的大模型,并规定它:只有在卡住搞不定时才去使用它。”——Ali Ghodsi
除 Advisor 模式外,Ali 还预告了以下一系列重磅产品和能力演进: - **Genie Code 与机器学习自动化**:突破以往仅聚焦编写数据工程流水线与零运维(ZeroOps)排障的定位,Genie Code 将升级为全功能的机器学习与数据科学代理,能够端到端编写 ML 流水线、自主排查错误并形成全自动闭环。 - **Databricks Apps 与代理记录系统(Agent System of Record)**:直击企业内部向成千上万名员工推广应用时的身份认证、授权与数据访问难题,将 AI 驱动的“氛围编程(vibe coding)”规范化推向企业级生产。 - **Lakewatch 与 Panther 协同**:展示两个月前推出的安全信息与事件管理(SIEM)系统 Lakewatch 的重大升级,并结合 Databricks 宣布收购 Panther 的背景,介绍开源 Agentic 安全数据湖仓。 - **CustomerLake(智能体客户数据平台 CDP)**:重塑企业营销架构,以沉浸式教学的方式向参会者展示新一代 Agentic CDP 如何赋能实时业务决策。
[05:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=300s) 开放生态与印度信实工业(Reliance)的数字化实践
在引出联合创始人兼首席技术官 Matei Zaharia 上台介绍开源项目 Omnigent 之前,Ali 特意幽默地提示现场导播和摄像团队:“请给他的鞋子拉一个特写镜头,务必拍清楚,因为那是他接下来演讲中非常重要的一个梗。”
随后,Ali 谈到 Databricks 与印度巨头信实工业(Reliance Industries)会长 Mukesh Ambani 的深度战略合作,指出普及 AI 不应只依赖少数极度昂贵的前沿模型,更需要通过开源、高性价比方案来兼顾不同国家的数字化主权。紧接着现场播出了 Mukesh Ambani 的致辞视频: - **使命愿景**:Reliance Intelligence 旨在通过“AI Everywhere for Everyone(让 AI 无处不在、服务每一个人)”的口号,为 15 亿印度民众普及智能化能力,赋能农民、中小微商户、教育、医疗与公共事业,并探索能够服务于占据全球五分之四人口的“全球南方”(Global South)国家的 AI 解决方案。 - **技术迁移规模**:Reliance 依托 Databricks 搭建了全集团统一的智能平台,已跨 Jio 电信、零售、能源、新材料和媒体等多业务板块迁移了数 PB(Petabytes)级别的数据,直接支撑了超过 8 亿客户的连接关系。 - **范式转变**:Ambani 总结指出,传统企业使用数据往往是“向后看”,依赖静态报表,而新一代智能体系将推动企业由“数据仪表盘(dashboards)全面转向智能化决策(decisions)”,实现即时响应与持续进化。
[10:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=600s) 印度作为 AI 的最严苛试验场与 Reliance 的规模化落地
来自印度 Reliance 的发言人指出,公司已经在广泛使用 Databricks Genie,让决策者能够直接通过自然语言提问并在实时环境中获取高价值商业智能,目前该能力正逐步推广至全集团数以千计的业务决策者。发言人动情地阐述了印度市场在人工智能应用上的特殊地位:由于巨大的抱负规模、高度的人口多样性、极其复杂的语言需求、严格的可负担性约束以及迅猛的技术采纳速度,印度可以说是全球 AI 最具挑战性的试金石。发言人充满信心地表示:“If an AI solution works for India, it can serve the world.”(如果一套 AI 解决方案能在印度跑通,那它就能服务全世界。)基于这样的背景,Reliance 与 Databricks 携手探索,希望为全球企业建立一套负责任、开放且具备大规模扩展能力的数据与 AI 实践蓝图。发言人对 Databricks 首席执行官 Ali Ghodsi 的愿景与深厚友谊致以谢意,并坚信双方的强强联手才刚刚拉开序幕。
随后,Databricks 联合创始人 Matei Zaharia 在热烈的掌声中登台,正式开启峰会第二天的技术主旨演讲。Matei 兴奋地宣布,Databricks 工程团队在上周六刚刚开源发布了一套全新的基础架构软件。这套软件源于团队在观察各类 Agent(智能体)开发与落地模式时所发现的共性瓶颈。随着智能体在各个场景的渗透,现有的 Agent 技术栈暴露出许多无法依靠单点加速解决的断层,业界迫切需要一层架设在现有 Agent 架构之上的全新抽象层。Matei 将这个全新层级形象地定义为“Meta-Harness”(元马具/元封装层),即一种跨越所有 Agent Harness 的顶层协同架构。
---
[11:11](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=671s) 什么是 Agent Harness?每个人都在造轮子带来的互操作性危机
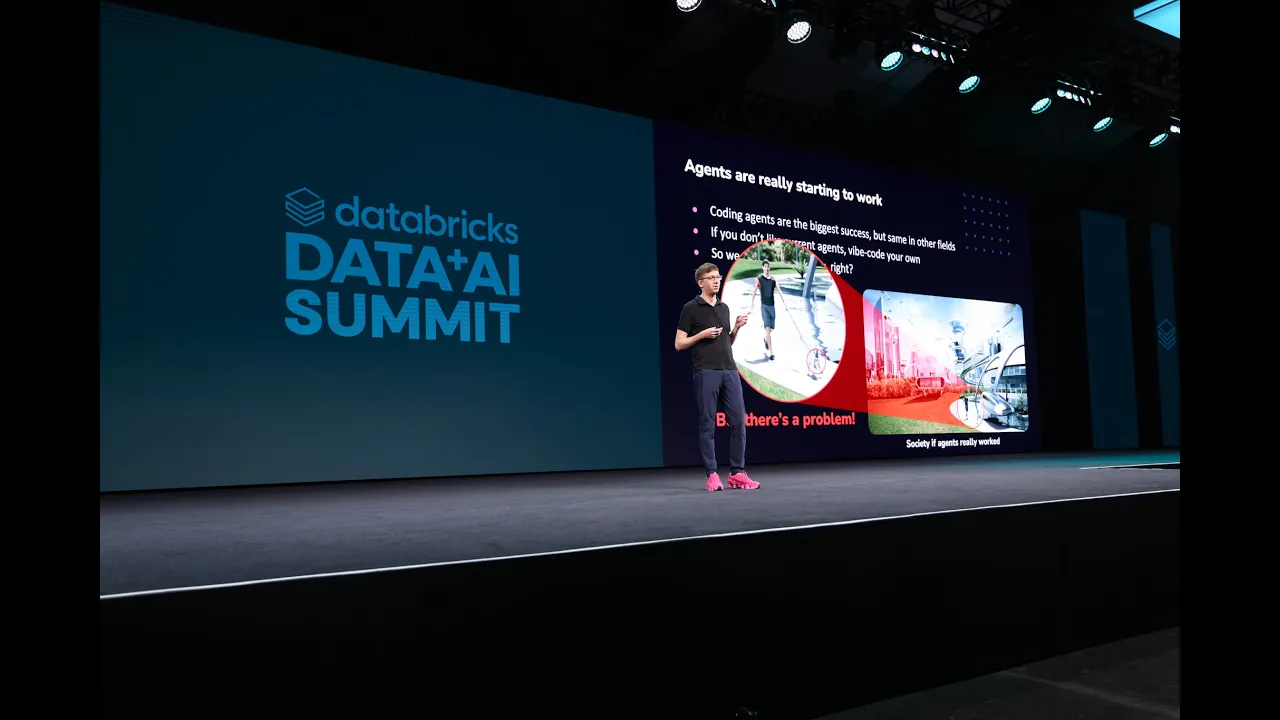
Matei 指出,当前智能体已经真正开始发挥威力。以编程智能体(Coding Agents)为先导,几乎每位开发者在日常工作中都建立起了与 Agent 的协作习惯;而在垂直领域中,类似于 Genie 这样的分析型智能体也取得了显著成功。正因为编程门槛在 AI 辅助下急剧降低,很多人开始产生疑问:我们是否还需要繁重的智能体基础设施?如果不喜欢现有的 Agent,开发者难道不能随手“Vibe Code”一个专属于自己的 Agent 吗?这种乐观情绪让人误以为软件问题已被彻底攻克。然而现实远非完美,当业务主管面对各种混乱的 Agent 时常常感到抓狂,尤其是面对潜藏的安全漏洞与权限失控时更是不寒而栗。
问题的症结正隐藏在包裹着语言模型的那套外壳——即所谓的“Agent Harness”。Matei 解释道,底层的大语言模型(如 Claude)本质上只是一个根据输入预测并输出 Token 的推理引擎;而真正将这个引擎与现实世界连接起来的外部软件系统才是 Harness。以 Claude Code 或 Codex 为例,Harness 负责提供文件系统访问、终端交互、用户界面呈现、环境搭建以及安全权限校验。由于构建简单的 Harness 门槛极低,加上软硬件与特定模型的协同设计(Co-design)往往能带来性能红利,导致整个行业陷入了疯狂造轮子的狂欢:各种开源库、专有 Harness、以及各家厂商的 Agent SDK 层出不穷。Matei 幽默地拿周末逛宠物店挑选五颜六色、形状各异的牵引背带(Harness)作比喻,形容当前 Agent 工具的泛滥。
```mermaid flowchart LR accTitle: Agent 与 Harness 的架构解耦示意图 accDescr: 展示底层语言模型如何通过外层的 Harness 软件系统连接现实世界的各类接口。
subgraph LLM_Core ["模型核心层"] direction TB M["大语言模型 LLM<br/>(Token 预测与输出)"] end
subgraph Harness_Layer ["Agent Harness 封装层"] direction TB UI["用户交互界面"] FS["本地文件/环境系统"] SEC["安全与权限管控"] TOOL["工具与 API 调用"] end
M <--> Harness_Layer Harness_Layer <--> ENV["现实世界 / 开发者工作区"] ```
然而,这种自立山头的割裂生态直接阻碍了系统的互操作性。Matei 一针见血地指出,单凭更快的编码速度根本无法弥合系统间的隔阂:“If everyone is just Vibe coding their own thing, they will still be incoherent.”(如果每个人都只是随性 Vibe Code 自己的工具,系统之间依然是支离破碎的。)为了真正让智能体在企业中规模化落地,业界必须在 Harness 之上建立一层能够横跨不同系统的公共接口与协议。
- **Harness 的核心职责**:管理本地上下文、建立命令行或图形界面交互、执行外部工具调用、维持会话状态并控制系统的执行边界。 - **生态现状**:各类编码工具(如 Claude Code、Cursor、OpenAI Codex)和自定义开发包(如 OpenAI Agents SDK)各自建立封闭壁垒,缺乏跨 Harness 的标准化沟通规范。
---
[15:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=900s) 多 Agent 协作的三大瓶颈:组合、协作与控制
Matei 结合 Databricks 内部数千名工程师使用编码智能体的实践,以及构建企业级面向客户产品(如 Genie)的经验,深入剖析了多 Harness 架构面临的“组合、协作与控制”三大核心难题:
首先是**组合难题(Composition)**。在复杂的真实开发中,工程师往往同时开启多个编码智能体,当一个 Agent 遇到死锁或 Bug 时,便将代码转交另一个 Agent 尝试,甚至调度多个 Agent 并行处理不同子任务。业界衍生出了多种强大的组合模式: 1. **循环模式(Loops)**:让智能体之间相互审查、在闭环流水线中自主迭代纠错。 2. **顾问模式(Advisors)**:使用小巧、快速且廉价的模型处理日常琐碎任务,同时挂载昂贵的前沿旗舰模型(Frontier Model)担任高层督导。这种架构不仅出现在 Harvey AI、Anthropic 的前沿实践中,Matei 在加利福尼亚大学伯克利分校(UC Berkeley)的研究实验室也专门发表过相关论文;Databricks 在 Genie 的架构中也证明了多模型编排能有效兼顾高质量与低成本。然而,缺乏统一抽象使得跨 Harness 实现多模型编排极其晦涩。
其次是**协作难题(Collaboration)**。Matei 展示了自己每天工作时极其繁杂混乱的电脑屏幕:左侧堆满了各种 Agent 的独立对话窗口,右侧则是 Slack 与 Google Docs,人整天在充当在各个窗口之间“机械复制粘贴文本”的低效搬运工。不仅人与 Agent 缺乏统筹协作通道,人与人之间的协作更是被硬生生切断。例如,当一名工程师在特定的 Agent 中调试到一半因故离开时,目前根本无法将带有完整环境、执行状态与上下文的会话无缝“移交”给另一位同事继续处理。
最后是**控制与安全难题(Control)**。Agent 面临严重的提示注入攻击(Prompt Injection)威胁,而且即使在完全未受攻击的情况下,Agent 也可能在复杂指令下犯错,甚至直接执行删除生产数据库的灾难性操作。当前大多数系统的防御手段极其原始,往往直接把风险转嫁给用户——例如 Claude Code 动辄弹出一条请求确认:“是否允许执行这段 100 行的 Python 脚本?Yes/No”。普通用户面对这类专业代码审计要么视而不见直接放行,要么彻底被频繁的打扰压垮,这种控制机制形同虚设。面对这一失控局面,Matei 断言:“So this control and security layer is another common problem across harnesses that we want to solve.”(因此,这层横跨所有 Harness 的控制与安全层,正是我们决心要解决的共性难题。)
---
[18:56](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=1136s) 开源 Meta-Harness:Omnigent 的诞生与架构理念
在经历了内部多支工程团队的反复推演后,Databricks 达成共识:业界必须在 Harness 之上建立一层全新的开放式抽象架构,即“Meta-Harness”。为了避免这一层再度沦为某家商业公司的专属护城河,Databricks 决定将其彻底开源,赋能整个开发者社区自由接入任何模型、工作流、自定义工具及 Harness。这个在上周末刚刚公开发布的开源项目被命名为 **Omnigent**。
Matei 阐述了 Omnigent 的底层运行机制:Omnigent 并不取代既有的 Agent Harness,而是将其沉淀为底层受控组件。无论是市面上顶尖的编码智能体(项目发布仅仅几天内,社区便根据开发者呼声迅速适配支持了 Antigravity 与 Cursor),还是开发者基于 OpenAI Agents SDK 等框架自研的业务专有 Agent,都能平滑接入 Omnigent。尽管各个底层的 Harness 实现逻辑各异、甚至与特定语言模型深度绑定,Omnigent 都能在最顶层为它们抽象出一套统一的标准接口,从而彻底打通跨模型的智能体组合能力与跨人机的上下文协作机制。
- **Omnigent 支持范围**:开箱即用支持主流编码 Agent(如 Claude Code、Cursor、Antigravity 等)及基于主流 Agent SDK 构建的企业级自定义 Agent。 - **设计初衷**:以中立、完全开放的 Meta-Harness 规范,化解各工具孤岛之间的通信摩擦,提供统一的安全执行沙箱与成本控制平面。
[20:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=1200s) Omnigent 的双层架构与核心能力:组合、协作与上下文控制
演讲者深入阐释了 Omnigent 试图解决的核心问题及其背后的系统架构。Omnigent 的交互接口设计非常直接:输入消息、输出事件流,以及支持工具调用。在整体架构上,Omnigent 分为两大部分: 1. **Runner(运行器)**:包裹在现有 Agent 外层,通过沙箱机制强制执行安全策略与各类控制,并全程监控 Agent 的运行状态。 2. **Server(服务器,可选组件)**:将 Agent 连接至该服务器后,即可获得团队协作与集中式策略管理能力。服务器集中保存完整的会话历史、提供用于共享 Agent 的 Catalog、支持统一配置 MCP(Model Context Protocol)与各类技能(Skills),并能下发安全策略与共享运行产物(Artifacts)。
在此架构之上,无论底层使用的是何种 Agent,Omnigent 都能提供一致的统一界面。用户既可以保留终端原生的 UI(如果底层 Agent 支持),也可以随时通过 Web 界面、原生桌面应用(Native App)、移动端甚至 REST API 进行交互。最关键的是,Omnigent 完全开源,不依赖任何 Databricks 服务,可以独立在任何环境下运行;其底层依赖 Docker、PostgreSQL 和 OpenTelemetry 等标准开源技术,既能轻量单机运行,也能支撑大规模企业级部署。
```mermaid flowchart TD accTitle: Omnigent 架构与交互全景图 accDescr: 展示 Omnigent 的终端/Web/API层、Server中心管控层以及底层通过 Runner 封装各类 Agent 的运作流程。
subgraph Interfaces["多端交互层 (Uniform Interfaces)"] UI_Term["终端 Terminal"] UI_Web["Web 界面 / Native App"] UI_API["REST API / 移动端"] end
subgraph ControlPlane["中央服务层 (Omnigent Server - 可选)"] History["集中历史记录 (History)"] Catalog["Agent 目录 (Catalog)"] Policies["上下文安全 & 成本策略 (Policies)"] MCP["MCP & 技能管理 (Skills)"] end
subgraph RuntimePlane["运行与沙箱层 (Omnigent Runner)"] Runner1["Omnigent Runner\n(OS 沙箱隔离)"] Runner2["Omnigent Runner\n(OS 沙箱隔离)"] end
subgraph Agents["底层 Agent 引擎"] AgentA["Claude Code"] AgentB["OpenAI Codex"] end
Interfaces --> Runner1 Interfaces --> ControlPlane ControlPlane -.->|"下发策略/技能"| Runner1 ControlPlane -.->|"下发策略/技能"| Runner2 Runner1 --> AgentA Runner2 --> AgentB ```
演讲者指出,这一抽象层为开发者带来了三大根本性优势: - **组合性(Composition)**:开发者只需编写简单的 YAML 配置文件,即可将基于不同 Harness 和大模型的 Agent 组合起来使用;不仅支持在运行时无缝切换不同的 Harness,还能自由接管与分支执行。 - **协作性(Collaboration)**:支持实时多人协作,用户可以直接邀请团队成员加入会话,共同与 Agent 对话,并对代码文件和生成结果进行实时批注。演讲者坦言:“一旦用上这个,我几乎所有的工作都想通过它来完成。” - **上下文敏感的控制机制(Contextual Control)**:当前多数 Agent 框架的权限控制极为僵硬,仅能在工具调用时死板地判断“允许、拒绝或询问用户”。而 Omnigent 引入了**上下文策略(Contextual Policies)**,其权限会根据 Agent 之前的操作历史动态改变。例如:若 Agent 已经读取了企业的机密内部文档,系统便会阻止它向外部发送邮件;但若它只读取了公开的市场文档,发送外部邮件就是合法的。此外,Omnigent 还支持精确的成本控制策略(例如设定单次任务上限为 5 美元),并提供灵活的操作系统级沙箱(OS Sandbox)防止 Agent 破坏本地机器。
演讲者在谈及安全设计的突破时强调:“针对 Agent 相关的安全性,我们进行了大量深入探索,最终构建出了一个比目前市面上更加优雅、更加强大的控制模型。”
[23:20](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=1400s) 实机演示:用 Omnigent 包装现有 Agent 与多端双向同步
随后,演讲者进入现场实机演示环节。演示环境基于其在 Databricks 内部的开发机(Dev Box)与笔记本电脑。为了展示如何无侵入式包装现有 Agent,演讲者在终端中执行了一个极简命令:在原本的 Claude 命令前加上 `omni` 前缀启动。
启动后,Omnigent Runner 立即在底层拉起,终端呈现出熟悉的 Claude Code 交互界面。这台机器上的 Claude 已经配置好了 Databricks 内部专用的全套环境与 MCP 插件。演讲者在 Omnigent 源码项目中向 Claude 询问当前项目是什么,Claude 迅速响应并返回分析结果,终端甚至展示了针对 Databricks 内部语义定制的特殊提示。
接着,演讲者展示了单机开发者如何立即从 Omnigent 获益:无需改变后台 Agent,浏览器中已同步生成了对应的 Web UI。终端里的每一个对话、输入输出以及文件变更,都与 Web 端的会话实时双向同步映射。在 Web 界面中,用户可以获得完整的可视化文件目录与格式清晰的 Chat 视图,甚至能在浏览器中直接内嵌查看终端窗口。
- 启动方式完全兼容原有 CLI,只需添加 `omni` 前缀即可无缝托管原有 Agent。 - Web 界面与本地终端双向即时打通,在 Web 端发送的指令与在 CLI 发送的指令完全等价并实时呈现。 - 支持直接在 Web 端可视化浏览项目所有文件,极大降低了纯终端操作的认知负荷。
[25:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=1500s) 界面联动、Session 派生与多 Agent 协同监督(Poly)
为了展示双向联动的威力,演讲者在 Web 界面下发指令,要求 Claude 在项目的 `README.md` 顶部添加一个笑话。Web 消息发出后,本地终端立刻同步捕获了该指令并开始执行。随后,Web UI 上直观地标记出变更文件 `README.md`,并直接高亮渲染了 Markdown 的 Diff 视图。演讲者现场在 Diff 视图中对代码进行了内联批注(Inline Comments),要求 Claude 删除部分笑话并重新修改,Agent 立即根据这些可视化批注自动执行了调整。演讲者特别提到,除了浏览器外,他们还推出了专用的原生应用(Native App),有效解决了日常工作时浏览器标签页泛滥、难以定位任务以及通知易被遗漏的问题。
随后,演讲者演示了强大的会话派生(Fork)与 Agent 切换能力。在同一个对话流中,如果当前 Agent 卡壳或遇到瓶颈,用户可以直接基于当前历史上下文派生出一个新分支,无缝切换至另一个完全不同的模型(例如 OpenAI Codex)。演示中,Codex 接管了包含之前所有交互历史的终端,并继续执行在文档中追加第二个笑话的任务。
更具突破性的是基于组合机制实现的**多 Agent 协同监督架构**。演讲者现场运行了一个名为 **Poly** 的多 Agent 协作代码监督器示例。Poly 能够作为 Supervisor 统一调度底层不同的 Agent: 1. 启动后,Poly 会自动检查本机是否安装了 Claude Code 和 Codex; 2. Poly 在后台并发启动了两个独立的 Worker(一个基于 Claude,另一个基于 Codex); 3. Supervisor 将任务(为 README 中的笑话打分)分发给两个 Worker 独立执行; 4. 用户不仅可以在 UI 中点击展开查看每一个 Worker 各自独立的终端与推理执行过程,还能在汇总视图中直接看到 Supervisor 的结论。最终 Poly 汇总反馈:第一个笑话效果不错,第二个稍逊一筹。
演讲者分享了他日常的高频使用技巧,例如让 Supervisor 抓取 GitHub 仓库中所有相关的未解决 Issue,并发派遣多个 Worker 去代码库中调查这些 Issue 是否已被隐式修复。最后,演示自然过渡到了团队协作环节:当开发者在本地生成了一个满意的改动时,可以直接通过 Omnigent 邀请其他工程师进入当前动态会话进行代码审查与提交。
- 支持在同一任务历史中一键 Fork 出新会话并切换底层模型(如从 Claude 切换至 Codex)。 - 内置 Supervisor 调度器(Poly),具备自动化检测环境、并发启动不同框架 Worker 并汇聚结果的编排能力。 - 支持细粒度追踪每个 Worker 的底层终端过程,兼具宏观决策汇总与微观执行可观测性。
[30:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=1800s) Omnigent 实时协作与状态化预算策略演示
在展示了 Omnigent 的核心开发功能后,Matei Zaharia 现场演示了其协作功能。为了审查一段对项目 `README.md` 的修改建议,他直接在演示中给 AI 团队的工程师 Ankit 拨通了电话。当电话接通时,现场观众被这一突击查岗逗乐了,Ankit 略带惊讶地开玩笑道:“天呐,Matei 居然在我休假时给我打电话?”Matei 随即邀请他查看共享的会话界面,请求协助判断应该选用哪一个版本的笑话。Ankit 浏览后回复说:“我知道智能体说笑话一更好,但我个人更喜欢笑话二。”Matei 借此说明,通过 Omnigent 邀请团队成员进入同一会话极为流畅,协作者不仅可以实时查看完整的历史记录和上下文、添加批注,还可以直接在对话框中给智能体下达指令接管任务。同时,所有交互历史和智能体运行状态都会持久化存储在服务器端,便于后续集中审计与分析。
随后,Matei 演示了 Omnigent 内置的状态化策略(Stateful Policies)与成本治理。界面顶部会实时追踪每个智能体消耗的费用。系统允许管理者或开发者设置具备上下文感知能力的约束策略。例如,可以配置一个阈值规则:“在当前会话中,如果智能体累计花费超过特定金额(比如 1 美元),在向用户申请许可之前不得擅自继续执行。”为了现场测试,Matei 将阈值设定为极具戏剧性的 20 美分,而当前会话已经花费了 25 美分,接着他派发了一个需要扫描大量文件的繁重任务。智能体开始思考并启动工具执行时,界面立即弹出了审批拦截窗口,暂停了操作直到获得人工授权。Matei 强调,用户既可以批准单次放行,也可以给子智能体分配固定额度(如仅限花费 1 美元),甚至设定当会话达到 5 美元硬性上限时彻底终止运行。这种集中式策略控制不仅适用于单个智能体,还能跨云端大模型和底层代码引擎统一部署。
```mermaid flowchart TD accTitle: Omnigent 预算与权限控制拦截流程 accDescr: 展示用户为 Omnigent 智能体设定预算上限并触发人工审批的机制
subgraph User["用户与团队协作"] A["设置状态化预算策略<br/>(例如单次会话上限或单步限制)"] B["协作者加入会话<br/>(共享上下文与查看执行进度)"] end
subgraph AgentExecution["智能体执行回路"] C["分派任务并读取项目文件"] D{"实时费用监测<br/>是否超出预算阈值?"} E["触发权限拦截<br/>等待人工批准"] F["继续执行后续复杂操作"] G["达到硬性上限<br/>自动终止会话"] end
A --> C B -.-> C C --> D D -- "未超额" --> F D -- "超额" --> E E -- "批准" --> F E -- "达到绝对上限" --> G ```
- **实时多人协同**:支持会话无缝共享、实时评论介入与任务交接,实现人机协同及团队跨地域协作。 - **动态状态化策略**:支持细粒度的上下文感知预算控制,防止复杂的循环调用或大规模文件扫描导致费用失控。 - **层级授权机制**:支持对主智能体和衍生的子智能体分别设置独立配额,并在集中控制台实施统一策略。
---
[33:05](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=1985s) 为什么将 Omnigent 开源:构建 Harness 之上的生态中枢
完成演示后,Matei 转向幻灯片深入解释了将 Omnigent 全面开源的核心逻辑。他指出,智能体技术的发展必须超越单一 Harness 或专用 SDK 的狭隘范围,行业亟需一个中立的“元框架(Meta-harness)”抽象层。正如开放的数据格式(如 Delta Lake 或 Parquet)与通用共享协议推动了现代数据架构繁荣一样,智能体生态也需要标准化的互操作协议来避免割裂。开源正是为了让社区能够跨厂商、跨模型达成共识,共同探索智能体协同的未来形态。
Matei 强调,自项目在 Summit 开展前的周六初步公开以来,团队已经收获了大量高质量的社区代码贡献。在实际调研中,绝大多数正在构建智能体的开发团队都渴望获得一个功能完备的前端应用——涵盖协作、会话回放、细粒度安全策略与移动端适配等能力。Omnigent 将这一整套开箱即用的前端与管理平台完整开源,团队不仅可以用它写代码,还能将其包装为任何垂直领域的业务智能体。关于这一层架构的必要性,Matei Zaharia 总结道:“我们真正认为 AI 需要一个位于 Harness 之上的抽象层,它让日常工作变得容易得多。”
- **开源标准生态**:采用与开放数据标准相同的理念,消除不同框架之间的孤岛效应。 - **全栈开箱即用应用**:提供包含协作、安全管控和移动端支持的高质量开源界面,非代码任务同样适用。 - **跨职能使用普及**:在 Databricks 内部,该工具已广泛渗透到产品经理、UI 设计师以及核心工程团队的日常工作流中。 - **后续规划路线**:未来将逐步加入智能体自动优化引擎及更广泛的上下游生态工具集成。
---
[34:44](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=2084s) Databricks Free Edition:为未来人才架起产业桥梁
一段短片随后展示了 Databricks Free Edition(免费版)为全球教育和学术研究带来的深远影响。已有数十万名高校学生和数据从业人员借助该平台学习数据与 AI 技能,应用场景覆盖了智能体构建、生物医学文献智能挖掘、乃至跨学科环境数据集整合等前沿领域。
视频重点强调了降低准入门槛对弥合学术理论与行业实践鸿沟的重要性。一位教育代表指出,让学生在正式步入职场之前便熟悉生产级环境,赋予了他们契合雇主需求的实用竞争力。拥有实际操作经验的毕业生能够迅速上手,省去了漫长的工作流适应期,在入职初期即可着手解决真实商业挑战。通过提供包含 Lakeflow Designer 在内的全套生产力工具,Databricks 承诺将核心平台能力永久向学习者免费开放,持续赋能新一代数据与 AI 人才。
---
[36:11](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=2171s) Agent Bricks 登场:破解“1% 智能体回路与 99% 基础设施陷阱”
Databricks 产品管理总监 Casey Uhlenhut 走上讲台。她回顾了大会首日的重点——Genie 如何让企业中的各类知识工作者通过自然语言直接消费 AI,并明确指出第二天的核心是开发者:“开发者是构建驱动业务运转并为产品提供卓越客户体验的智能体的核心力量,而 Agent Bricks 正是为他们量身打造的。”自一年前推出 Agent Bricks 以来,该平台已孕育了超过 100,000 个定制企业智能体;AI Gateway 累计处理了超过一千万亿(1 Quadrillion)Token;用于大模型实验记录与端到端追踪的 MLflow 下载量突破 10 亿次。诸如 7-Eleven(加速设备维护)、MasterCard(在数十亿笔交易中检测欺诈)和 AstraZeneca(为药物研发团队加速商业洞察)等知名企业均已在生产中深度部署。
然而,Casey 犀利地指出,现存的演示和概念验证(PoC)掩盖了严峻的工程现实:“当你看到智能体演示和概念验证时,通常只看到了智能体循环(Agent Loop),但智能体循环只占你全部工作的 1%,剩下那 99% 才是真正的拦路虎。”工程师为了将一个原型推向企业级应用,不得不耗费海量精力处理身份认证、与模型上下文协议(MCP)对接、管理访问权限以及维持长生命周期会话的防超时崩溃机制。当企业试图将这种孤立构建扩展为数千个协同智能体时,整个工程团队便无可避免地陷入了“疲于搭基建而无法专注于智能体本身”的泥潭。
```mermaid flowchart LR accTitle: 智能体落地工程工作量对比 accDescr: 展现智能体循环仅占开发工作量的 1%,其余 99% 为基础设施陷阱
subgraph AgentCore["核心业务逻辑 (1%)"] Loop["智能体推理与规划回路<br/>(Agent Loop)"] end
subgraph InfraBurden["企业级基础设施陷阱 (99%)"] Auth["认证与身份管理 (IAM)"] Protocols["MCP 协议与工具集成"] Stability["长时运行稳定性与防超时"] DataGov["碎片化多源数据上下文摄取"] Security["防越权操作与生产数据隔离"] Cost["Token 爆炸与预算防护"] end
Loop --> InfraBurden ```
Casey 进一步总结了阻碍工程团队向生产落地的三大核心痛点: 1. **技术栈快速迭代与“重构噩梦”**:AI 技术的前沿几乎每周都在刷新。新型基础模型与像 Omnigent 这样的元框架层出不穷,半年前构建的系统往往迅速落后时代一到两个代际。若要跟进最先进的能力,企业通常被迫推翻现有的整套技术栈,承受巨大的重新平台化(Re-platforming)迁移成本。 2. **碎片化数据带来的“上下文选取难题”**:企业的真正护城河是私有数据。然而这些数据极度分散,形式五花八门,涵盖了非结构化 PDF 文档、关系型仓库以至外部 API,让智能体在海量噪音中精准提取并对齐正确的上下文极为困难。 3. **最高特权实体的“安全与合规风险”**:Casey 提醒大家:“智能体是企业中拥有最高特权的执行者。”它们既能访问敏感的客户隐私,又具备执行增删改查甚至外部接口调用的行动能力。近期频繁出现的负面新闻正是明证——失控的智能体删除了生产数据库、泄露了敏感资产,亦或在短时间内耗尽计算预算,导致团队在项目尚未走出测试期时就面临严重的财务超支。
[40:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=2400s) Agent Bricks 的核心价值:赋予开发者“选择权”(Choice)
演讲者开篇指出,企业在构建 Agent 时反复遇到基础设施层面的阻碍,而 Agent 开发者平台必须满足三大核心要素:选择(Choice)、上下文(Context)与控制(Control)。为了让工程师能够从底层基础设施中解脱出来,专注于 Agent 本身的构建,Databricks 推出了 Agent Bricks。
```mermaid flowchart TD accTitle: Agent Bricks 架构全景 accDescr: 展示 Agent Bricks 围绕 Choice、Context 与 Control 三大支柱构建的系统架构
subgraph AgentBricks["Agent Bricks 开发者平台"] direction TB subgraph Choice["1. 选择 (Choice)"] C1["前沿模型 (Claude Opus, GPT, Gemini, Qwen, Kimi, Grok)"] C2["RL 自定义强化学习平台"] C3["编排框架 (Omnigent, LangGraph, OpenAI Agent SDK)"] end subgraph Context["2. 上下文 (Context)"] CT1["Unity Catalog 集中管理与治理"] CT2["Genie Ontology 元数据层"] CT3["Document Intelligence 文档解析"] CT4["Agent Memory Services (会话与偏好记忆)"] CT5["托管外部 MCP 接口"] end subgraph Control["3. 控制 (Control)"] CR1["Databricks Sandbox (安全毫秒级隔离 VM)"] CR2["Unity AI Gateway (治理、成本与上下文安全策略)"] end end
Choice --> Context --> Control ```
在“选择权”维度,Agent Bricks 原生集成了几乎所有前沿主流模型,包括 Claude Opus、GPT、Gemini、Qwen 以及近期引入的 Kimi;现场更重磅宣布与 xAI / SpaceX 合作,将 Grok 模型家族引入平台。然而演讲者强调,前沿通用模型有时难以胜任极其特化的任务,此时需要定制化的强化学习(RL)模型。Databricks 提供了完整的 RL 训练与部署平台。演讲者举例证明其技术实力:Genie 团队通过自身平台的强化学习训练,在特定任务上的表现成功超越了旗舰模型 Claude Opus,而这些自研模型可与所有主流模型无缝并排部署在平台中。
除了模型层面的灵活性,平台还在框架层面给予开发者充分自由。开发者既可以使用开源的 Omnigent 在 Databricks 内部构建和部署 Agent,也可以继续沿用自己喜爱的生态框架(如 OpenAI Agent SDK、LangGraph 等)。演讲者总结道: > “So we believe choice is about giving you the flexibility to stay at the cutting edge without having to re-platform your solution every time, and we're able to do this by giving you a unified interface across all of your models so that you can easily switch amongst them.”
- **原生支持的前沿模型**:Claude Opus、GPT 系列、Gemini、通义千问(Qwen)、Kimi 以及新宣布合作的 Grok 系列。 - **自定义强化学习能力**:支持用户针对特定场景定制训练 RL 模型,Genie 团队自研模型性能已在特定任务中优于 Claude Opus。 - **框架兼容性**:全面支持 Omnigent、LangGraph、OpenAI Agent SDK 等主流开源及自研框架。
---
[42:11](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=2531s) 解决上下文难题:从企业知识、文档智能到 Agent 记忆服务
“再优秀的模型,其效果也完全取决于你喂给它的信息”,演讲者由此切入第二大支柱——上下文(Context)。在企业语境中,上下文的本质就是数据。在 Agent Bricks 中,所有内部数据与外部连接数据均通过 Unity Catalog 实施集中式元数据与工具化管理,甚至报表仪表板(Dashboards)都能直接作为工具被 Agent 动态发现并调用。然而,仅能“发现”并不够,更关键的是确保 Agent 检索到“正确且精准”的上下文。这也正是大会前一天发布的 Genie Ontology 如此重磅的原因——它为所有智能体资产铺设了一层语义元数据网络。
面对实际业务中成千上万份 PDF 合同、票据等非结构化复杂资产,Databricks 推出了专用文档智能(Document Intelligence)方案,内置专为高难度文本解析、字段提取与分类构建的定制模型。演讲者表示,企业内部有着数以百万计的此类文件,该方案在“质量-成本曲线”上做到了极致优化,确保企业在解锁海量文档价值时绝不超支。对于散落在平台外的数据,平台提供开箱即用的托管外部 MCP(Model Context Protocol)连接器,替开发者屏蔽复杂的安全鉴权逻辑。
针对用户级个性化需求,演讲者明确表示:“你不可能为每个单一用户单独构建一个专属 Agent,那简直是无底洞。”为此,平台正式发布 **Agent Memory Services**。开发者只需接入托管 API,即可集中存储用户的个人偏好、历史会话上下文与多轮 Session 状态。演讲者坦言,上下文是当前 Agent 领域最艰难的课题,因此 Databricks 组建了专门的科研团队主攻“Agent 记忆、Agent 检索与 Agent 搜索”三大难题,所有理论突破与技术成果均直接内嵌于 Agent Bricks 与 Genie 产品中。
- **Genie Ontology**:为智能体资产构建元数据图谱,大幅提升上下文检索与语义召回的精确度。 - **Document Intelligence**:在解析数百万份 PDF 合同与复杂票证时,提供业内最优性价比的结构化提取模型。 - **Agent Memory Services**:托管式上下文状态与记忆 API,免去为每个终端用户单建 Agent 的繁琐架构。 - **专项研究聚焦**:设立独立科研团队攻克 Agent Memory、Agent Retrieval 以及 Agent Search 底层瓶颈。
---
[45:18](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=2718s) 安全执行与 Databricks Sandbox:为自主代码构建“沙盒围栏”
解决了上下文连接后,Agent 必须拥有行动能力(Act),但这引发了严重的安全隐患。演讲者幽默地指出,失控的 Agent 一旦在企业内部肆意横行,甚至可能误删生产数据库;但如果因噎废食全面封锁,又会扼杀其创造力: > “They can do like amazingly creative things if you just kind of let them cook, but you don't want them to take down production.”
为了两全其美,Databricks 正式发布 **Databricks Sandbox**。它为 Agent 提供完全受控、安全隔离的代码执行虚拟机(VM)环境。不同于市面上通用的通用虚拟机方案,Databricks Sandbox 是业界唯一开箱即用打通企业内部数据的沙盒环境。它借助 `OnBehalfOf` 权限机制对数据进行精准降权(Downscoped access),使 Agent 能在完全不危及外部生产系统的前提下,自由调用企业真实数据施展才华。
此外,该沙盒具备极致的启动速度,其实例初始化仅需毫秒(Milliseconds)级别。这意味着 Agent 可以在执行单次微任务时瞬间拉起沙盒、运行完毕后立刻销毁,其生命周期与 Agent 的思考步调高度同步,彻底解决了企业执行任意动态代码的后顾之忧。
- **安全代码执行**:隔离的虚拟机容器,杜绝危险脚本破坏核心生产环境与底层数据库。 - **业内首创数据直通**:利用 `OnBehalfOf` 机制授予沙盒精确降权的数据访问通道。 - **毫秒级冷启动**:以毫秒级速度创建与销毁沙盒实例,完美匹配 Agent 快速、多轮的交互节奏。
---
[46:51](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=2811s) Unity AI Gateway:全方位纳管资产、上下文安全策略与成本控制
作为控制层面的重头戏(Pièce de résistance),演讲者隆重推介了 **Unity AI Gateway**。这是 Databricks 打造的集中式治理、安全与成本控制中枢,旨在统筹管控企业内的模型、Agent、MCP 以及 Skills 工具链。演讲者提醒台下观众“系好安全带”,并逐一拆解该网关带来的核心新特性。
```mermaid flowchart LR accTitle: Unity AI Gateway 动态上下文安全策略流 accDescr: 演示 Agent 根据是否触碰 PII 数据而动态改变安全状态并限制后续操作的逻辑
subgraph Step1["步骤 1:访问数据"] A["Agent 执行任务"] --> B{"数据敏感级别检查"} B -->|"触碰客户敏感 PII 数据"| C["状态被标记为:Tainted (受污染)"] B -->|"仅读取公开透明数据"| D["状态保持:Normal (正常)"] end
subgraph Step2["步骤 2:动态策略限制"] C --> E{"执行后续操作"} E -->|"允许"| F["发送内部邮件给同事"] E -->|"严格拦截"| G["发布任何内容至公网/外部通道"]
D --> H["允许向公网或外部服务发布内容"] end ```
第一项关键功能是**统一 Agent 资产注册表(Agent Registry)**。面对企业内部各团队使用异构框架构建的成百上千个 Agent,AI Gateway 提供了统一的系统资产台账(System of Record),无论这些 Agent 部署在 Databricks 内部、第三方平台,还是关联了各色 MCP 和 Skills,都能被集中索引与发现。
第二项突破性功能是**上下文安全策略(Contextual Security Policies)**。演讲者通过极具说服力的案例解释了其动态状态机机制:当某个 Agent 在某一步骤中触碰了包含客户 PII(个人身份信息)的高危敏感数据时,系统会将其运行时状态标记为“受污染”(Tainted)。一旦进入该状态,其后续操作权限将被实时重写——系统允许它向内部同事发送邮件汇报,但会绝对封杀其向公网外部接口发布任何数据的通道;反之,若在另一独立会话中该 Agent 仅处理了公开信息,则公网发布权限保持放开。演讲者强调: > “And this is the best illustration of what a dynamic and stateful policy can do that's contextual to your data. And this is only possible on Agent Bricks, because our agent platform is built and integrated into our data platform.”
除自研策略外,Databricks 还与多家业界安全机构达成生态合作,内嵌主流安全防护围栏(Guardrails)。最后,演讲者切入开发者最焦虑的痛点——“Token 刷爆”(Tokenmaxxing)。在缺乏硬性配额与路由控制时,很多团队的项目预算往往在取得实质进展前就被耗尽,而 Unity AI Gateway 正为此提供了精细化的成本风控底座。
- **Agent Registry**:打通多平台边界,建立涵盖所有 Agent、MCP 及技能模块的企业级唯一定位账本。 - **有状态动态策略**:依据 Agent 所触碰数据的敏感度(如是否接触 PII)动态调降/重塑后续工具调用权限。 - **原生数据架构优势**:唯有将智能体层与底层数据湖仓深度绑定,才能在执行的“每一步”精准注入细粒度安全规则。 - **Tokenmaxxing 防护**:针对模型开销设立精细化配额拦截与成本管控规则,杜绝意外预算超支。
[50:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=3000s) Unity AI Gateway 的核心功能:智能路由与 Agent 追踪
Unity AI Gateway 不仅能够帮助企业掌握具体消费,还通过“预算”(Budgets)功能允许管理员为不同的用户和用户组设定支出上限。然而,仅仅了解已经花了多少钱并不足够;更理想的方案是依赖一个自动化智能系统主动分担成本控制负担。这正是“智能路由”(Intelligent Routing)发挥作用的地方:系统能够根据任务本身的复杂度,自动评估并分派最匹配的模型——将简单琐碎的日常提问直接派发给低成本、高响应速度的轻量模型,将高难度复杂任务交由功能强大且昂贵的模型处理。此外,得益于多云与多 AI 架构支持,企业可以跨模型提供商(Model Providers)与跨公有云设置故障转移(Failover),打造高可用性的 Agent 系统。
Unity AI Gateway 引入的另一项重磅能力是 Agent 追踪(Agent Tracing)。基于 MLflow Tracing,系统能够完整捕获并记录 Agent 运行期间的每一次输入、每一次输出以及所有中间执行步骤,并集中存入 Unity Catalog 表中。由于这类调用链路信息包含高度敏感的企业机密,数据的所有权完全归企业自己所有。一旦数据落盘至 Unity Catalog,企业不仅可以借助 Genie 展开自然语言分析与调试,还能将其接入 LakeWatch 安全信息与事件管理(SIEM)系统,在发生数据泄露风险时触发实时告警。演讲者总结道:
> “So this is what AI governance should look like in the enterprise, where all of your assets can be centrally managed, you can have contextual policies to enforce security, you have an open ecosystem where you can connect to partners, and you can have the cost controls that you need.”
随着统一治理架构的确立,企业管理员能够在确保安全与合规的前提下,负责任地将 AI 工具普及给全员。
```mermaid flowchart TD accTitle: Unity AI Gateway 核心能力示意图 accDescr: 展示请求通过统一网关进行预算检查、智能模型路由,并将追踪日志沉淀至 Unity Catalog 的链路。
Req["用户 / 编码 Agent 请求"] --> Gateway["Unity AI Gateway"]
subgraph Controls["网关治理与控制"] Gateway --> Budget["智能预算策略 (Budgets)"] Budget --> Router["智能路由 (Intelligent Routing)"] end
subgraph Execution["模型执行分流"] Router -->|"简单任务"| CheapM["廉价高速模型 (如 Databricks Kimmy)"] Router -->|"复杂任务"| HeavyM["高智能重型模型 (如 Opus / Gemini)"] end
subgraph StorageAnalysis["安全监控与分析"] CheapM --> Trace["MLflow Agent Tracing"] HeavyM --> Trace Trace --> UC["Unity Catalog 集中日志表"] UC --> Genie["Genie 智能诊断调试"] UC --> LakeWatch["LakeWatch SIEM 实时告警"] end ```
---
[52:37](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=3157s) 现场演示:借助网关控制激增的开发者 AI 开销
Databricks 软件工程师 Ankit Mathur 登台展开实机演示。他幽默地跟台下打招呼,表示自己刚休假归来,并直面开发组织正在面临的严峻挑战:过度依赖 AI 工具使得企业成本呈现指数级攀升。当前在开销最高的 1% 用户中,每人每年的 AI 支出甚至高达 90,000 美元,而且这种指数增长完全没有放缓的势头。原因在于目前已经不仅是专业工程师在写代码,全公司各业务线的员工都在并行调遣 Agent;加之模型能力日益成熟,只要人类不喊停,Agent 就会无休止地运行下去,导致预算迅速失控。
为证明在不牺牲员工生产力的前提下如何规范使用 AI,Ankit 重点演示了 Unity AI Gateway 的三大功能:预算(Budgets)、智能路由(Smart Routing)和 Agent 追踪(Agent Tracing)。他从所有开发人员最熟悉的起点——终端命令行(Terminal)开始演示。开发者无需改变原有的工作习惯,只需执行简单的一行命令将现有的编码工具指向网关:
```bash gateway codex ```
启动之后,开发者的 Codex 界面与以往毫无二致,但在底层,所有的模型推理请求和 MCP(Model Context Protocol)调用都必须经过这个集中的网络关卡(Central Choke Point)。这意味着所有的 MCP 路由统一经由中央注册中心进行权限认证,用户只需登录认证一次即可;更重要的是,团队能为跨多款工具的编码活动统一设定总预算,实现透明的开销管控。
- **顶尖消耗群体数据**:排名前 1% 的高频消耗用户,年均 AI 支出达 90,000 美元。 - **单点接入无缝迁移**:通过 `gateway codex` 命令,开发者在保留熟悉 UI 和工作流的同时,自动接入了企业级流量追踪与单一鉴权体系。
---
[55:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=3300s) 柔性预算策略、Omnigent 元编排与全链路审计
在日常工作中,开发者通常会被配置固定预算(例如 Ankit 账户设定的单日 50 美元限额)。然而 Unity AI Gateway 的管控策略并不是简单粗暴的“硬性阻断”(Hard Caps),而是根据消耗进度渐进引导的“柔性智能预算策略”(Smart Budget Policy)。当开发者在终端中询问“查找 Moscone Center 附近的咖啡馆”这类日常问题时,系统会提示其正在逼近单日预算阈值。在预算充裕的清晨,开发者可以自由选用任何昂贵模型;当预算消耗接近上限时,系统开始主动建议切换到高 Token 效率的经济型模型(如本周全新发布的 Databricks Kimmy,其成本显著低于其他竞品);而当预算达到 100% 时,系统才会针对后续启动的新会话强制启用平价模型,既不打断当前正在进行中的紧要任务,又避免了资金无底线穿透。
当 Unity AI Gateway 与元调度框架 Omnigent 结合使用时,智能路由的潜力得到了进一步放大。由于 Omnigent 拥有高于单个任务的全局视角,它能将复杂的用户目标拆解并按需分派:
> “Specifically, when you have a meta harness, you can make decisions at the higher level than an individual task, which allows you to make intelligent routing decisions.”
例如,在面对“在 Omnigent 开源仓库中找出前 4 个 Bug”这类复合指令时,Omnigent 会根据子任务特性灵活选择模型,并通过 Databricks Sandbox 安全沙箱并发拉起多个隔离环境进行分析: 1. **全局代码库扫描**:由于扫描动作极其消耗 Token,路由自动调用成本极低、延迟极小的 Databricks Kimmy; 2. **边缘用例(Edge Case)审查**:选用推理敏锐且兼顾性价比的 Gemini 3.5 Flash; 3. **核心业务逻辑与深度审计**:交由推理质量过硬的中高端或高阶旗舰模型处理。
```mermaid flowchart TD accTitle: Omnigent 与网关协同智能分流架构 accDescr: 展示 Omnigent 接收复杂代码排查任务后,将不同消耗特性的子任务路由至对应等级的模型并在沙箱中并发执行的过程。
Task["任务: 扫描分析开源仓库 Top 4 Bug"] --> Meta["Omnigent (Meta-Harness)"]
subgraph Sandbox["Databricks Sandbox (并行安全沙箱环境)"] Meta -->|"高消耗粗排"| A["代码库全面扫描<br/>(Databricks Kimmy - 极速/低成本)"] Meta -->|"边缘场景验证"| B["边界用例审查<br/>(Gemini 3.5 Flash - 兼顾智能与开销)"] Meta -->|"深度攻坚"| C["核心逻辑深度审计<br/>(旗舰/中高阶昂贵模型 - 保证代码质量)"] end
A --> Results["汇总诊断分析报告"] B --> Results C --> Results ```
在演示的最后环节,Ankit 强调,如果没有数据沉淀,企业就无法真正做到“以数据为驱动”(Data-driven)。过去散落在每台开发者机器上的本地会话,如今由网关自动将 Trace 轨迹推送到 Unity Catalog 的集中审计表中。因为上下文内容极其敏感(甚至可能涉及高管级别的机密信息),企业可以直接沿用 Unity Catalog 现成的属性基访问控制(ABAC)与治理标签(Governed Tags)实施严密的权限隔离。依托汇聚的数据,团队还能利用 Genie 展开数据诊断。Ankit 透露,在网关路由策略正式推行之前,通过对研发团队历史会话样本的真实分析发现:
> “...because our default model was the most expensive one, like Opus, 90% of our sessions were overkill.”
由于当时默认将最昂贵的模型(如 Claude Opus)设为底座,导致 90% 的简单问候或标准化常规任务(Paved Path Tasks)产生了过度且不必要的算力溢价。借助网关集中回流的 Trace 数据,企业不仅能够精准发现这些浪费,还能以此为指引提炼标准化开发技能(Skills),并将沉淀出的公共能力再次注册回 Unity AI Gateway,持续迭代企业的 AI 投资回报率。
[01:00:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=3600s) 从“Token 狂飙”转向“价值最大化”:Agent Bricks 平台总结
Ankit 完成了他的演示并总结道,借助 Unity AI Gateway 的预算策略(Budget Policies)、智能模型路由器(Intelligent Model Router)和链路追踪(Tracing),企业终于能够扭转在 AI 调用成本上呈指数级增长的失控曲线。他指出,智能本身是生态系统中最宝贵的稀缺资源,企业在积极部署 AI 的同时,必须对其调用的具体模型保持清醒。正如 Ankit 所总结的那样:“And so hopefully we can take the world from the old world of token maxing to something a little bit more like value maxing with the Unity AI gateway.”(希望借助 Unity AI Gateway,我们能引领业界从旧时代的 Token 狂飙转向追求价值最大化。)
随后 Casey 登台总结了 Agent Bricks 的核心价值。她强调 Agent Bricks 是 Databricks 打造的端到端 Agent 开发者平台,主要建立在三大支柱之上: 1. **多重选择(Choice)**:提供模型、Agent 与 Harness 的灵活自由度,让企业始终保持在技术前沿,而无需推倒现有的企业基础架构进行重构(replatform)。 2. **上下文洞见(Context)**:让 Agent 能够接触并识别正确的元数据,从而在执行各项 Agent 任务时精准抓取所需数据。 3. **治理与控制(Controls)**:通过 Unity AI Gateway 实现自主 Agent 的集中管控,并结合 Databricks Sandbox 提供的虚拟机环境,在经过降权(downscoped)的数据范围内实现安全的代码隔离执行。
Casey 补充说,Agent Bricks 之所以具备独一无二的优势,根本原因在于它与底层的统一数据平台进行了深度集成。正是这种紧密的原生结合,才催生了 Unity AI Gateway 的智能模型路由、Databricks Sandbox 的隔离运算以及环境感知的上下文安全策略。
```mermaid flowchart TD accTitle: Agent Bricks Platform Architecture accDescr: An architecture diagram showing how Agent Bricks integrates Choice, Context, and Controls on top of the Databricks data platform.
subgraph Platform["Agent Bricks 统一开发者平台"] C1["灵活性与多重选择 (Choice)<br/>多模型 / 多 Agent / 异构 Harness"] C2["上下文洞见 (Context)<br/>元数据直通 / 精准数据抓取"] C3["集中管控与安全 (Controls)<br/>Unity AI Gateway / Databricks Sandbox"] end
Data["统一数据平台底座 (Databricks Data Platform)"] --> Platform Platform --> Apps["企业自主 Agent 应用生态"] ```
---
[01:02:40](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=3760s) 对话 Satya Nadella:从模型崇拜走向企业专属上下文生态
Databricks 首席执行官 Ali Ghodsi 登台并迎来了微软董事长兼 CEO Satya Nadella。两位掌门人回顾了 Databricks 与微软长达近十年的战略合作。谈及市场的剧烈变迁,Satya 指出,过去一年客户评估 AI 价值的底层逻辑发生了根本性转变:市场正在从“对前沿模型的单向崇拜(frontier model worship)”,快速演进为构建企业自身的前沿生态,核心在于如何让每家企业用自己的专有 IP 参与到这一浪潮中。
Ali 提到了 Satya 在微软 Build 大会上的核心论点——“企业的未来形态”将由其拥有的核心 IP 决定,而保护专有数据正是筑牢竞争壁垒的关键。Satya 完全认同并指出,企业数据绝非静态资产,而是一个持续处于流动演进状态的体系。企业过去关注的是“记录系统(system of record)”或“交互系统(system of engagement)”,而在 AI 时代,必须构建“上下文系统(systems of context)”。Satya 直言不讳地指出:“The one way to waste a lot of tokens is not have the best context.”(过度消耗和浪费 Token 的最直接途径,就是缺乏优质的上下文。)
Ali 也形象地将缺少上下文的 Agent 执行比作程序里不断空转的“for 循环”:Agent 像在数据迷宫里进行随机漫步,反复扫描同一批信息,在无休止的计算中挥霍巨额 Token 和漫长时间。
---
[01:04:41](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=3881s) 5B 小模型击败前沿大模型:Token 资本积累与深度产品集成
Satya 进一步分享了一个在微软 CEO 峰会上展示过的惊人案例:MAI 团队研发的一个仅有 50 亿参数(5B)的小型模型,在特定评估标准上成功击败了前沿级(Frontier-class)的庞大基座模型。Satya 解释道,这并非源于某种神秘代码,而是因为该模型深度结合了企业的真实业务数据:当把企业级数据与 Agent 的执行追踪(Agent traces)灌入企业级强化学习(RLE / Reinforcement Learning Environment)回路时,小模型便凭借高度相关的上下文战胜了那些体量庞大却缺乏企业真实环境的前沿模型。目前业界普遍存在的“盲目狂飙 Token、外泄自身 Trace 数据”的狂热现象,将很快迎来急转弯并迅速纠偏。
```mermaid flowchart LR accTitle: Enterprise Data and Agent Traces Feedback Loop accDescr: Feedback loop showing how enterprise data and traces improve smaller models over raw frontier models.
subgraph Inputs["企业专有资产"] D["企业内部业务数据"] T["Agent 执行链路追踪 (Traces)"] end
subgraph Loop["企业级学习闭环 (RLE)"] M["5B 轻量化学习模型"] end
Inputs --> Loop Loop --> R["超越通用前沿大模型的任务表现<br/>(构建企业专有 Token Capital)"] ```
随后,双方梳理了 Databricks 与微软生态的全面深度交织: - **Databricks Genie 融入企业工作流**:不仅嵌入到了 Microsoft 365 Copilot 和 Teams,更通过 Copilot Studio 开放了 Genie 的 MCP Server(Model Context Protocol 服务端),使外部开发者能够更便捷地基于其构建高效率 Agent。 - **跨平台安全与数据互联**:整合了 Microsoft Entra ID 与 Agent 365 体系,并在底层通过 Microsoft Fabric OneLake 与 Databricks 存储架构实现流畅的双向读写。
谈及未来十年的展望,Satya 强调了对企业本质的深刻洞察:企业可以采购现成工具,甚至可以外包具体的某项工作或职能,但绝对无法外包自身的“学习机制”。正如 Satya 所总结的那样:“Tomorrow they'll have human capital and token capital that is building that tacit knowledge that really drives enterprise value for them.”(未来的企业将同时依靠人力资本与 Token 资本的交织互补,共同构筑真正驱动企业内在价值的隐性知识资产。)
- **十载伙伴关系**:微软与 Databricks 携手重构了以云原生为基底的数据层,未来将继续赋能客户自主留存与沉淀核心资产。 - **Token 资本(Token Capital)**:企业除依靠数字工具的人力资本外,将开始形成属于自身的“Token 资本”,让企业的隐性知识(tacit knowledge)产生复利效应。
---
[01:09:16](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=4156s) Databricks Apps:打破 AI 落地瓶颈与重构代码生产力
在 Ali 感谢并送别 Satya 后,Databricks 产品管理总监 Justin de Brabant 登台。他开场打趣道,这个舞台通道走起来比看起来要长得多。随后他将聚光灯转移到应用开发领域:Databricks Apps。
Justin 指出,Databricks 推出 Apps 的初衷始终是让数据和 AI 走向平民化与普及化。他敏锐地观察到,在如今遍地开花的编码 Agent(Coding agents)推动下,编写代码的直接边际成本已被无限压缩,“代码变得极度廉价(code is cheap)”。企业构建 AI 应用的最大阻碍,早已不再受制于工程开发的人力与代码量,真正的核心瓶颈全面转移到了企业级数据本身——即如何能够安全、受控且合规地访问到生产级上下文数据。正如 Justin 所指出的:“Coding agents have proliferated, code is cheap, but the bottleneck is enterprise data.”(编码 Agent 已经泛滥成灾,代码变得廉价,但如今的瓶颈落在了企业数据上。)
[01:10:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=4200s) Databricks Apps 的爆发与三大核心能力
企业级应用程序绝非仅仅是代码的堆叠,它们的核心在于获取并使用数据。然而,阻碍应用从原型走向生产环境的最大瓶颈,正是对这些数据进行受治理的访问。为此,Databricks 构建了业内首个以数据安全与治理为基石的企业应用平台——Databricks Apps。在过去一年中,该平台迎来了爆发式增长:目前已有超过 5,000 家企业客户使用 Apps,累计构建了 150,000 款应用程序,实现了同比 6 倍的飞速增长,每周更有数十万活跃用户在其中工作,其中许多人此前在日常业务中从未接触过数据和 AI。
演讲者分享了客户借助该平台进行创新的生动案例。多国航空航天巨头泰雷兹(Thales)重塑了其机上智能平台,将整个全球机队的系统健康状态、机上娱乐内容参与度以及乘客满意度汇聚在一起;机舱运营团队由此能在乘客察觉之前预先发现问题,极大提升了飞行体验。这一应用背后融合了 Databricks 的多项核心技术:利用 Lakebase 处理实时数据、在 Lakehouse 中进行深度分析、结合 Genie 以及驱动预测的机器学习模型。另一个案例来自全电动垂直起降飞行器制造商 Joby,面对复杂的材料计划挑战,他们构建了一个统一视图应用,覆盖所有生产制造项目的需求、库存、零部件与订单,帮助计划员在零件短缺演变成生产延误之前及早预警。
```mermaid flowchart TD accTitle: Databricks Apps 平台能力框架 accDescr: 展现 Databricks Apps 的三大核心支柱:治理、托管和构建及其各自的特性。
subgraph Platform["Databricks Apps 核心支柱"] direction LR Govern["治理 (Govern)"] Host["托管 (Host)"] Build["构建 (Build)"] end
subgraph G_Details["治理特性"] G1["Databricks SSO 统一身份"] G2["Unity Catalog 权限管控"] G3["实时可观测性与 Unity 托管表"] end
subgraph H_Details["托管特性"] H1["可配置实例与水平自动扩缩容"] H2["负载均衡与粘性会话"] H3["版本化构建与零停机部署"] end
subgraph B_Details["构建特性"] B1["支持 Python 与 JavaScript"] B2["AppKit (TypeScript SDK)"] B3["编码智能体与生态伙伴集成"] end
Govern --> G_Details Host --> H_Details Build --> B_Details ```
Databricks Apps 的能力被划分为三大支柱:治理(Govern)、托管(Host)与构建(Build)。在治理方面,平台提供开箱即用的托管身份验证(Managed Auth),无需配置独立的身份提供商(IDP)即可通过 Databricks SSO 实现单点登录;底层依托 Unity Catalog 在应用级别或用户个体级别细粒度管理资源与数据访问;同时还支持开箱即用的实时可观测性,平台团队能实时监控谁在访问哪些服务,所有日志实时写入 ZeroBus 并同步至 Unity 托管表。在托管方面,平台摆脱了过去只有单一常驻实例的局限,现已支持灵活配置实例规格、水平自动扩缩容、负载均衡、粘性会话(Sticky Sessions),以及版本化构建和零停机发布。在构建方面,平台不绑定任何开发框架,兼容 Python 与 JavaScript,并推出了 TypeScript 应用 SDK “AppKit”,内置连接 Lakebase、Genie、Agents、Jobs 和 Lakehouse 的预置插件;此外,还针对编码智能体深度适配了自定义技能(Skills)与模型上下文协议(MCP),携手广泛的合作伙伴生态系统共同加速应用落地。
- “Enterprise apps are not just code. They need access to the data. And the real challenge in going from prototype to production is governed access to that data.” ——演讲者强调企业应用的核心挑战在于受治理的数据访问。 - 平台已拥有超 5,000 家客户,构建了 150,000 款应用,实现 6 倍年增长。 - Thales 运营团队利用整合了 Lakebase、Genie 和 ML 预测模型的应用,实现“在乘客察觉之前预先发现客舱问题”。 - Joby 利用该平台整合了机队制造全流程的需求、库存与零件订单数据,有效防止供应链脱节。
[01:15:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=4500s) “氛围编码”的鸿沟、AppSpaces 与 Serverless Micro Apps
根据行业预测,到 2028 年全球将涌现出 10 亿款全新的企业定制应用程序,而其中绝大多数预计将由“平民开发者”(Citizen Developers)构建。这一趋势带来了全新的挑战:此前由核心数据团队开发应用,天然具备平台资源与数据权限;但当全员创新普及至普通业务人员时,原型与生产之间的鸿沟(Prototype to Production Gap)便急剧拉大。
演讲者讲述了一个发生在其公司内部的真实故事:Databricks 的一位销售运营经理为了精简季度业务复盘(QBR)流程,想要开发一款聚合客户消耗量、Salesforce 近期沟通记录以及内部预测模型的工具。她使用 Replit 进行“氛围编码”(Vibe Coding)迅速搭建出了酷炫的原型,兴奋地展示给高管层,以为大功告成。然而当她寻求平台工程团队将其上线时,工程团队立刻抛出了一连串问题:“你需要什么数据?共享策略是什么?依赖项、代码规范和预算怎么解决?”由于销售经理缺乏访问含敏感客户数据的生产环境权限,双方陷入了漫长的反复拉扯中。演讲者警告称,这种“氛围编码”在各个企业内部正在发生数千次,“除非我们拿出一套受治理的解决方案,否则它终将让我们应接不暇。”
面对如何在不牺牲安全性、数据治理与成本预算的前提下赋能海量开发者的诉求,Databricks 正式发布了两项重大创新:
1. **AppSpaces(应用空间)**:针对以往只能按单个应用进行治理的痛点,AppSpaces 引入了多应用策略(Multi-app Policies),管理员可在空间层级批量应用安全与合规规则,限定空间内应用的共享边界(例如规定某销售空间内的应用仅能共享给销售团队成员),并集中监控该空间内所有应用的调用量、成本与各项运维指标。 2. **Serverless Micro Apps(无服务器微应用)**:过去的常驻与自动扩缩容实例适合关键核心业务,但对于低频或轻量级工具(如每月仅使用数次的运营看板)而言成本过高。Serverless Micro Apps 引入了基于细粒度切分 CPU 与内存的全新架构,支持动态缩容至零(Scale to Zero)。在触发访问时,它可在数秒内快速冷启动;即便运行在共享基础设施之上,依然能保证全面的多租户隔离与安全合规。
- “Vibe coding is taking over. And unless we have a governed solution to it, it's going to overrun us.” ——演讲者指明氛围编码虽势不可挡,但亟需平台层面的治理机制。 - 预计到 2028 年,新增企业定制应用将达到 10 亿款,且主要由平民开发者创造。 - AppSpaces 实现了对数千款应用的集中式权限下发、共享范围管控及运维成本监控。 - Serverless Micro Apps 具备按需秒级拉起、空闲缩容至零以及细粒度资源切分特性,完美适配长尾、低频企业内部应用。
[01:20:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=4800s) 发布 Genie App Builder:深度理解企业业务的 Vibe Coding
演讲者指出,当前企业面临的最大痛点之一,是需要能够深度理解业务的“Vibe Coding”(氛围编码)工具——不仅理解数据,还要理解应用部署的整体上下文,包括资源配置、运行环境与共享策略等。为此,Databricks 正式推出 Genie App Builder。
Genie App Builder 将氛围编码与业务上下文深度绑定,具备三大核心优势: 1. **上下文感知(Context-aware)**:依托 Genie 本本体(Genie Ontology),使代码生成能够深刻理解企业业务语义与底层数据。 2. **内嵌且完全由 Databricks 托管(100% Databricks-managed)**:提供企业级的严格安全与治理保障。 3. **开箱即具备生产级品质(Production quality by default)**:底层内置 AppKit SDK 与自定义技能,自动将最佳工程实践植入生成的每个应用中。
演讲者强调:“Genie App Builder is vibe coding that understands your business.”
---
[01:21:11](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=4871s) 演示:将 Vibe Coding 原型秒级转为生产应用
演讲者通过现场实操,扮演“Brickster Cup”赛事的供应链运营经理(Supply Ops Manager),展示如何利用 Genie App Builder 打造一个实时库存指挥中心(Inventory Command Center),实现库存监控、需求预测以及直接触发生产调整的操作闭环。
```mermaid flowchart TD accTitle: Genie App Builder 生产化部署流程 accDescr: 展示从 GitHub 原型导入、资源绑定、治理策略校验到最终生产部署的完整流程。
subgraph Input["输入与上下文接入"] A["GitHub 原型仓库 (Vibe Coded)"] --> B["Genie App Builder 界面"] C["App Space (供应链运营空间)"] --> B end
subgraph Context_Binding["上下文自动绑定"] B --> D["SQL Warehouse (报表查询)"] B --> E["Model Serving Endpoint (预测)"] B --> F["Lakebase (实时库存数据)"] B --> G["Genie 智能问答 Agent"] end
subgraph Governance["治理与安全拦截"] H{"未授权制造数据?"} -->|"无权限"| I["向管理员申请审批 / 移除图表"] J{"跨部门 Slack 推送?"} -->|"无 Connector"| K["拦截外部推送"] L{"全员公开分享?"} -->|"超出策略"| M["限制仅运营团队可见"] end
Context_Binding --> Governance Governance --> N["Serverless Micro VM 并排预览"] N --> O["秒级一键发布至生产环境"] ```
在演示中,演讲者首先从 GitHub 导入先前通过外部 Vibe Coding 工具生成的应用原型。进入指定的“供应链运营(Supply Chain Ops)”应用空间(App Space)后,Genie App Builder 会根据该空间预设的计算资源、统一凭证(OBO)、权限范围及外部连接器,自动识别并绑定应用所需的所有组件: - 自动关联 SQL Warehouse 驱动仓库数据; - 挂载 Model Serving 终端运行库存需求预测; - 接入 Lakebase 实例提供实时库存流; - 自动为内置的 Genie Agent 配置行业特定的默认问答。
数据加载后,右侧实时预览区即刻渲染出真实业务数据。当应用试图调用未经授权的生产制造数据时,系统立即弹出权限申请并给出风险阻断提示。演讲者通过自然语言交互直接移除未授权图表,并指令“把这个图表改成绿色”,系统随即自动完成代码重构与界面微调。
随后,演讲者展示了平台的微虚拟机隔离能力与严格的安全边界: - **微虚拟机并排预览**:底层采用 Serverless Micro VMs 技术,并行启动多个轻量级应用实例,提供改动前后的无缝并排视觉对比。 - **治理边界合规检查**:当尝试让 Agent 每日自动向 Slack 发送摘要时,系统因当前空间未配置 Slack Connector 而主动拒绝;当尝试将应用“分享给公司所有人(Share with everybody)”时,系统提示该空间仅限供应链运营组访问,严密阻断越权分享。
完成调整后,点击“Deploy”按钮,整个应用在数秒内便成功部署到生产环境。演讲者宣布所展示的功能即日开放使用,并推介了全新上线的开发者中心(developers.databricks.com),该中心汇集了原型模板、Prompt 库、示例应用与操作指南。
---
[01:28:01](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=5281s) 客户案例:Virtue Foundation 借助 Genie 赋能全球医疗援助
大屏幕随后播放了非政府组织 Virtue Foundation 的真实应用案例。Virtue Foundation 的使命是为中低收入国家和地区提供关键临床救护。借助 Genie,该机构打造了专属的定制化 Agent,将数十年积累的现场实地调研数据转化为可行动的权威事实源(Source of Truth)。
Virtue Foundation 代表分享道:“Using Genie has allowed us to take what would have taken a research assistant months. We're now able to get answers to questions in seconds.” 过去需要助理数月调研的问题(例如“加纳有多少家医院?”“加纳有哪些医院能做心脏科手术?”),现在通过 Agent 提问几秒钟内便能给出精确答案。该机构特别指出,这些技术突破最终连接的是现实中的人类生命,能够切实为真实的人群解决生死难题令人倍感谦卑。
---
[01:29:22](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=5362s) 机器学习的智能体时代:从手工运维迈向 Agentic MLOps
在大屏幕视频结束后,Databricks 产品管理总监 Mike Del Balso 登台。他开场打趣道:“Justin was right, this is a deceptively long walk.”
Mike Del Balso 回顾了自己在生产级机器学习领域的长久职业生涯: - 早期就职于 Google 的广告机器学习团队,参与奠定了现代 MLOps 领域的早期形态; - 随后协助 Uber 组建机器学习团队,主导并打造了著名的企业级内部机器学习平台 Michelangelo; - 如今致力于将 AI Agent 引入现代 ML 工程全流程,以彻底解决企业机器学习规模化落地中的高昂工程与运维瓶颈。
[01:30:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=5400s) 生产级机器学习的隐性债务与 Agent 自动化的必然性
演讲者首先分享了自己的从业背景:过去几年他一直在经营自己的生产级机器学习初创公司,近期该公司加入了 Databricks,他们如今在 Databricks 致力于解决同样的行业难题。回顾整个职业生涯与机器学习产业,所有人的核心诉求与梦想始终如一:“将机器学习变得尽可能简单、尽可能自动化,从而将智能化决策引入业务中所有重要的节点。”尽管过去无数企业前仆后继且多数以失败告终,但如今局势终于迎来了转机。
演讲者展示了一张经典图表,这出自他约 12 年前在 Google 工作时团队共同发表的里程碑式论文(即关于机器学习系统隐性技术债务的研究)。图表中仅有极小一部分红色方块是真正的机器学习算法代码,而围绕在其周围的庞大系统——特征提取、数据验证、资源管理、服务设施、分析工具及监控组件等——才是生产级 ML 系统的真正重担。究其本质,这底层完全是一个数据工程问题。
很多人以为生成式 AI(Gen AI)的爆发会降低企业对传统机器学习的需求,事实恰恰相反,生成式 AI 大大加速了对 ML 的渴求。随着企业构建出前所未有的海量软件与数字化产品体验,需要推荐的商品变得更多、动态定价场景成倍增加、待检测的欺诈行为更加隐蔽、需要审核的贷款申请量级骤升,企业内部需要即时做出的关键决策呈爆炸式增长。
然而,企业目前严重“配给制”式地限制了机器学习的使用范围,仅在极少数业务核心场景中部署模型。对比各家企业生产环境中拥有的模型数量,与成千上万原本可以被自动化、智能化的实际决策节点相比,差距悬殊。未能广泛应用智能机器学习,意味着企业正在“把钱白白留在桌面上”,只能退而求其次地依赖启发式规则(heuristics)、经验法则或死板的静态硬编码逻辑进行次优决策。
要实现规模化,唯一的出路就是将机器学习全流程彻底自动化。在传统的流程中,几乎每一个环节都需要人类专家的深度参与——拥有博士学位的数据科学家需要人工判断构建哪些特征、哪种模型表现良好、实际的优化目标到底是什么,以及哪一个模型能够晋级到生产环境。要让软件自动完成这类高层次决策,目前行业中唯有 Agent(智能体)技术具备这种潜力。尽管 Agent 已经彻底颠覆了软件工程的构建模式,但在机器学习领域尚未引发同样的革命。其阻碍主要在于两点:其一,全球仅有极少数公司具备驱动端到端自动化 ML 的完整基础设施;其二,Agent 缺乏人类机器学习工程师所掌握的深度上下文信息,无法做出同等质量的决策。
```mermaid flowchart TD accTitle: Production ML Technical Debt and Context accDescr: Diagram illustrating that ML code is only a tiny fraction of production ML systems, surrounded by vast infrastructure and human context.
subgraph VastInfra["庞大的生产基础设施系统 (数据与系统工程)"] A["数据收集与验证"] B["特征工程与提取"] C["计算资源调度"] D["模型服务与监控"] end
subgraph CoreML["核心算法"] E["ML 代码 (极小部分)"] end
subgraph HumanLoop["传统人类专家决策上下文"] F["特征评估"] G["模型选型"] H["指标权衡与上线审核"] end
A --> E B --> E E --> C E --> D HumanLoop -.->|"输入经验与业务洞察"| VastInfra ```
---
[01:34:25](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=5665s) 面向 Agent 的新型机器学习基础设施与 AI Runtime 发布
为了让智能体真正接管机器学习全生命周期,Databricks 采取了两步走战略:首先打造“面向 Agent 就绪(Agent-Ready)”的 ML 基础设施;其次提供具备深度业务上下文、能以团队工作方式驱动闭环的专门 Agent。在过去十余年中,Databricks 一直是数据科学和 ML 领域的行业领头羊,仅在过去一年中,在 Databricks 上训练的模型数量就超过了 5 亿个,在各类权威分析师报告中牢牢占据“最右上角”的领军者位置。
然而,现存的平台和工具链在过去都是为人类操作量身定制的。为了适应 Agent 自主运作的时代,Databricks 在过去 18 个月内对其整套技术栈进行了深度重构与优化:
1. **全面 Serverless 化(Serverless by Default)**:彻底免去 Agent 配置集群参数、维护底层计算节点状态的负担,使 Agent 能够随时按需极速拉起或销毁弹性资源。 2. **统一的数据模型贯穿全链路**:训练数据、特征数据、模型推理与在线服务数据、生产监控与漂移数据,全部沉淀并对齐在同一套受治理的元数据表结构中。这为 Agent 提供了覆盖整个机器学习生命周期的单一事实来源(Single Source of Truth),使其所做的任何修改都能被立即观察到反馈闭环。 3. **原生默认治理(Governed by Default)**:除了早已在 Unity Catalog 中实现管控的模型资产、实验记录和服务端点外,如今进一步将治理延伸到了 Agent 可执行的具体操作动作上,确保自动化机器学习循环中的所有变更安全可信。
在此坚实底座之上,演讲者隆重发布了 Databricks 全新的计算形态——**AI Runtime**。AI Runtime 提供按需提供、无需预付费承诺(No upfront commit)的 Serverless GPU 算力,专为企业构建深度学习模型和大语言模型(LLM)打造。该服务在近两个月的预览期内已被数百家企业采纳并取得显著成效(例如默沙东 Merck 基于此平台训练前沿药物研发模型)。演讲者更进一步宣布,AI Runtime 即日起全面支持**多节点分布式训练(Multi-node Training)**,使企业能在任意规模的数据集上无缝训练任意复杂度的深度学习大模型。
- 过去一年内在 Databricks 上训练的模型总数超过 5 亿个。 - AI Runtime 提供按需调用的 Serverless GPU 计算,无需任何前期承诺或包月配额。 - 默沙东(Merck)等领军制药公司已率先借助该架构训练最新的药物研发模型。 - 即日起正式扩展支持多节点分布式训练,彻底补全深度学习工作负载版图。
---
[01:38:13](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=5893s) 发布面向生产级工程的 Genie Code for ML
在构建了坚实的基础设施后,核心焦点便转向了能够自主闭环操作这套体系的软件智能体。演讲者正式发布了 **Genie Code for Machine Learning**,这是一套内置在 Genie Code 中、专门针对真实世界机器学习任务进行强化的高级智能能力,且即日起正式可用。
在整个数据智能领域,没有任何一家厂商比 Databricks 见证过更多真实生产环境下的机器学习系统。工程团队将这些年积累的宝贵行业实战经验——哪些架构行之有效、哪些方案容易翻车、生产级最佳实践的标准究竟是什么——全量融入到了 Genie Code for ML 的训练与提示体系中。
与其他通用的编码辅助智能体相比,Genie Code for ML 原生深度集成了 Databricks 完整的机器学习工具链,不仅精通如何调度和运用平台底座上的各项组件与资产,更在上下文理解能力上完成了重大跃迁。它能够深刻理解企业内部机器学习团队和数据科学团队在现实业务中的协同工作模式,从而能够像人类同事一样提供极具前瞻性的建议,甚至肩并肩承担复杂的工程落地任务。演讲者指出,当年在 Google 论文中提出的经典架构图只是解决了人类面临的基础设施繁复问题,但在现实操作中,人类数据科学家在推进每个阶段时,实际上是在融合调用庞大而隐蔽的多源上下文知识,而这正是 Genie Code for ML 赋予 Agent 的核心突破点。
> “没有任何人比 Databricks 在真实世界中见识过更多的机器学习实践。因此,我们汲取了所有这些经验教训——什么有效,什么无效,在生产环境中真正优秀的状态到底是什么样——并将这一切注入到了 Genie Code 之中。”(“Nobody has seen more machine learning in the real world than Databricks. So we've taken all of those lessons, what works, what doesn't work, what good looks like in production, and we've built that into GenieCode.” —— 演讲者)
[01:40:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=6000s) Genie Code 与 Genie Ontology:具备企业上下文的机器学习构建代理
在构建生产级机器学习(ML)系统时,工程师面临的核心痛点往往不是模型算法本身,而是决策所需的庞大上下文碎片化地散落在整个平台中:团队之前跑过哪些实验、特定业务指标究竟代表什么含义、哪些尝试有效或无效,以及关键的评估脚本保存在何处。演讲者指出,如果 AI 代理无法获取这些深层数据,“它就会使用错误的数据,采用错误的评估方式,最终给出看似合理但完全错误、无法令人信任的答案”。
为了彻底解决这一断层,Databricks 将前一天由 Ken 发布的 Genie Ontology(本体层)与 Genie Code 进行了深度整合。通过 Ontology 注入的上下文,Genie Code 能够精准理解各家企业内部 ML 团队的工作模式、特征工程习惯与模型构建管线:
- **沿用工程范式**:Genie Code 能够像团队中的资深工程师一样,采用完全相同的模式构建特征,复用现有的训练脚本,契合既有的工作流。 - **沿用既有评估基准**:它会自动检索并复用团队沉淀的评估脚本(eval scripts)。当 Genie Code 汇报某个模型达标时,团队可以给予充分信任,因为该模型经历的是团队自己认可的同一套准入标尺。 - **落地效能剧增**:演讲者提到,跨国工程巨头丹佛斯(Danfoss)借助 Genie Code,在短短 90 分钟内就从零搭建出完整的生产级机器学习系统;而在很多企业中,类似的项目通常需要耗费数周、数月乃至数个季度。
```mermaid flowchart LR accTitle: Genie Code Architecture with Ontology accDescr: 展现 Genie Ontology 如何为 Genie Code 提供企业上下文,驱动端到端模型构建与评估
subgraph ContextLayer ["企业上下文层 (Genie Ontology)"] Exp["历史实验记录"] Feat["特征工程规范"] Eval["既有评估脚本"] end
subgraph AgentLayer ["Genie Code ML 智能体"] GC["Genie Code Agent"] end
subgraph OutputLayer ["生产级交付"] Train["复用训练脚本"] Audit["基准评测验证"] Prod["90分钟投产系统"] end
ContextLayer --> GC GC --> Train GC --> Audit Train --> Prod Audit --> Prod ```
---
[01:42:43](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=6163s) 颠覆传统运维:发布 Genie ZeroOps for ML
尽管构建速度能提升百倍,但现实中 ML 团队真正的大头开销并不在开发阶段。演讲者强调:“如果你与一线的实际 ML 团队交流,会发现构建并不是他们工作的主要部分。他们实际上将 60%、70% 甚至 80% 的时间花在维护机器学习应用上。”随着模型产出数量以百倍增长,维护负担若同步放大,任何团队都将不堪重负。
在生产环境中,模型上线后随时可能遭遇数据漂移(Data Drift)、推理服务延迟突增、上游数据管道破损等成百上千种长尾故障。为此,演讲者正式发布了被其誉为“机器学习领域近十年最重大的发布”——**Genie ZeroOps for ML**。
这一产品实现了运维范式的根本性转变:传统的监控系统只是被动观察指标并在发现异常时向人类抛出告警(“这里看起来出错了”),而 Genie ZeroOps for ML 不仅能捕获异常,还会自主排查根因、设计修复方案并直接端出解决方案。
> “在机器学习的整个历史中,我们一直让团队成员为模型待命(on call)。而 ZeroOps for ML 彻底颠覆了这一点,让代理来负责 On-Call,团队只需对代理给出的建议进行最终审批。”
- **持续自主巡检**:全天候监控每个生产模型,自主追踪问题根因并生成补丁。 - **保留人类监督(Human-in-the-loop)**:在方案真正部署应用之前,严格保留人工审核和点击确认流程。
---
[01:45:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=6300s) 现场演示:Genie ZeroOps 毫秒级自愈门票预测系统
Databricks 的 Amber 登台进行了现场演示,展示 Genie ZeroOps 如何在无人值守的情况下自动闭环修复生产故障。背景设定在虚拟的 Bricksports Global 公司,团队有一个用于预测“Data and AI World Cup”各场比赛门票销量的生产级模型。该预测直接关系到赛事安保、运营与场馆调配等数千万元的资金支出;一旦预测失准造成门票定价过高导致大面积空座,损失将极其惨重。
Amber 首先演示了如何利用 Genie Code 极简配置告警规则。她输入自然语言,要求在实际门票销量与预测偏差超过 ±5% 时触发告警,Genie Code 随即自动创建并注册了监控代理。
紧接着场景快进至周五下午 5:30,正当 Amber 结束连续会议准备下班时,邮箱收到了 30 分钟前触发的严重告警——门票预测精度骤降。此时邮件中新增了一个醒目的“View investigation in Genie ZeroOps”按钮。点击后进入控制台,Genie Code 早已在后台自主完成了深入排查与修复验证:
1. **多维度根因定位**:得益于 ML 项目完整的 Ontology,Genie Code 深入分析了构建模型的 Notebook、查询了 Unity Catalog 元数据表、执行 SQL 查询、比对特征值变动并调取 MLflow 实验。最终定位出根本原因:**模型缺少了表示“比赛所处赛段”的关键特征**。当世界杯进入淘汰赛阶段后,球迷关注度和需求爆发,原有模型无法感知这一变量,导致预测急剧偏离。 2. **端到端自主修复**:定位问题后,Genie Code 自动检索到系统内已有赛事阶段与对阵信息的数据,基于这些未充分利用的数据生成了新特征,重新训练模型并完成了超参数调优(Hyperparameter Tuning)。 3. **血缘复用与安全合规**:凭借对全生命周期血缘的掌握,Genie Code 复用了旧模型原有的评估脚本与验收基准,并在 MLflow 中完成了新模型的注册与合规验证,成功将预测准确率拉回正常区间。 4. **一键部署小流量测试**:调查报告中清晰呈现了完整的评估指标与实验对比,Amber 确认无误后,只需在界面上一键批准,即可将新模型以灰度放量(canary rollout)的形式推向生产环境。
[01:50:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=6600s) 迈入 100 倍 ML 时代:Genie ZeroOps、Genie Code 与 AI Runtime
演示者在成功发布版本 2 后长舒了一口气。在传统运维流程中,一个模型陈旧失效(stale model)往往会演变成全团队级别的重大生产事故,可能导致业务瘫痪数小时甚至数天,潜在损失高达数千万元;而 Genie ZeroOps for ML 能够迅速排除故障并恢复正常,最大限度减少了对工程团队的干扰。
当前机器学习正步入“100 倍规模时代”。伴随模型数量激增 100 倍,系统复杂度也将暴增 100 倍,这正是平台必须为团队构筑护城河的地方。正如演示者强调的:“Give ML teams the tools that they need to stop spending all this time fighting operational toil and start building breakthrough AI.”(让 ML 团队拥有所需的工具,彻底摆脱日常运维苦工,全身心投入到突破性 AI 的构建中。)
回顾本环节发布的三项核心能力: - **AI Runtime**:现已开启公开预览(Public Preview),提供 Serverless GPU 算力,便于企业快速构建深度学习模型和 LLM。 - **Genie Code for Machine Learning**:现已正式发布(GA),直接内置于笔记本电脑已有的 Genie Code 环境中,即开即用。 - **Genie ZeroOps for Machine Learning**:定于今年夏季正式上线。
长期以来,机器学习行业的核心梦想就是实现 ML 全流程自动化。如今,完备的基础设施配合智能代理驱动闭环,使模型构建速度提升 100 倍、模型吞吐量提升 100 倍成为现实。ML 可以规模化下沉至企业的所有决策链路,真正实现全产品线的高度个性化与业务决策优化。
---
[01:52:48](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=6768s) 智能代理正在重塑消费行为:人类决策与无头商业
Databricks 隆重引荐了负责 CustomerLake 的总经理 Tassos Argyros。Tassos Argyros 回顾了自己过去 20 年的创业经历:前 10 年致力于打造数据库公司,后 10 年深耕营销技术(MarTech)领域,致力于将底层数据与面向业务的前端 UI 深度结合。今天重返这一领域,他展示了数据与 Agent 如何真正赋能核心业务。
各行各业顶尖企业的核心壁垒往往建立在客户体验(CX)上,高达 80% 的企业明确表示自身主要依赖客户体验展开竞争。然而,AI 正在颠覆传统的消费购买模式,直接倒逼客户体验重新设计: 1. **人类不再孤立进行购买决策**:现场调查显示,近 80% 的人在购物前会咨询 LLM。在不久的将来,人们不再仅仅向聊天机器人寻求建议,而是将全流程彻底委托给代理(Agent)——由 Agent 自主完成背景调研、比价发现、选品下单及物流跟进。 2. **决策链路从“天/周”级缩减至“秒/分”级**:传统漫长的消费者购买旅程在 Agent 接管后被大幅压缩至几秒或几分钟之内。 3. **电商走向“无头化”(Headless Commerce)**:Agent 天然擅长与各类 API 进行无缝对接,能够同一时间在多个渠道并发进行选品调研与交易下单。
---
[01:55:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=6900s) 告别瀑布式营销:迈向无限营销战役(Infinity Campaigns)
面对 Agent 驱动的全新购买生态,传统营销流程暴露出致命短板。以往营销团队普遍遵循“瀑布式模式”(Waterfall Model):营销人员制定策略,数据工程团队汇聚梳理客户 360 度数据(Customer 360),营销运维团队圈选包含数百万人的大体量受众群体(Audiences),创意团队生产物料,最终营销人员触发投放并监测效果。这种模式虽然支撑了过去的业务,但其流程极其冗长、僵化,根本无法适应 Agent 在秒级内跨多渠道并发下单的新现实。
为此,Tassos Argyros 提出了颠覆性的全新营销理念——**无限营销战役(Infinity Campaigns)**。其核心逻辑不再是将数百万人划入粗颗粒度分群,而是构建面向每一个客户的“一人受众”(Audience of One): - **为每位客户配备专属 Agent**:Agent 实时抓取并解析客户产生的最新行为信号,自主推演下一步最佳行动(Next Best Action),动态生成高度定制化的内容。 - **构建无限循环(Infinity-like Loop)**:客户收到信息并完成交互或交易后,会生成新的数据信号反哺给 Agent,驱动下一轮互动。 - **常青运转(Evergreen)**:活动不再有明确的起止时间节点,Agent 能够根据客户行为与业务目标持续自我调节与演进。 - **无限创意变体与极速响应**:可在极短时间内调用海量内容变体,以零延迟应对客户与采买 Agent 的瞬时需求。
```mermaid flowchart LR accTitle: 无限营销战役运作闭环 accDescr: 展示了从客户行为信号到客户专属 Agent 处理,再到个性化内容反馈的闭环流程。 subgraph BuyerSide["客户侧"] C["客户 / 采买 Agent"] end subgraph AgenticSide["Agent 闭环"] A["客户专属 Agent"] NBA["推演下一步最佳行动"] CNT["生成定制内容"] end C -->|"产生最新行为信号"| A A --> NBA NBA --> CNT CNT -->|"跨渠道瞬时触达"| C ```
Tassos Argyros 特别澄清,这绝不意味着人类营销人员被完全边缘化。在 Infinity Campaigns 架构下,人类营销专家始终处于掌控地位,担任“首席战略官、首席编排官与首席审批官”(Chief strategist, chief orchestrator, and chief approver)。人类制定战略框架,由庞大的 Agent 军团承担原本因人力速度受限而无法落地的“一对一实时超个性化”执行工作。
要实现这种全自动闭环,传统的客户数据平台(CDP)形态必须迎来重构。作为连接底层原始数据与上游营销工具的业务应用,传统 CDP 承担着清洗 Customer 360 数据以及提供给业务人员圈选人群、编排用户旅程的职能,但在数据流转与 Agent 协同上已然捉襟见肘,亟需向原生 Agent 化演进。
[02:00:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=7200s) 传统 CDP 的局限与 Agentic CDP 的兴起
传统客户数据平台(CDP)的核心工作流通常终结于向营销工具输出数据:通过“反向 ETL(Reverse ETL)”将数据从 CDP 推送到电子邮件系统或广告投放平台,以便向最终客户提供内容。然而,传统 CDP 的致命短板在于它们本质上只是与底层数据割裂的中间件。随着 AI 代理(Agent)时代的到来,单纯拥有数据已经远远不够,代理的高效运行必须同时依赖丰富而精准的上下文(Context),而且数据与上下文必须和代理处于同一个物理与架构空间中。为此,业界需要新一代的 CDP 架构来驱动“无限活动(Infinity Campaigns)”,这便是所谓的 **Agentic CDP**。
Agentic CDP 绝非空泛的概念性包装,而是具备三个高度具体的判断标准: 1. **深度嵌入 Lakehouse**:由于数据、业务上下文以及代理本身正加速向 Lakehouse 汇聚,CDP 必须原生嵌入湖仓内部; 2. **以大语言模型(LLM)为系统架构核心**:它绝非只是在传统系统上外挂一个打辅助的 Copilot,而是将 Agent 作为全套运转机制的心脏; 3. **原生驱动 Infinity Campaigns**:具备支撑常态化运作(Evergreen)、实时响应、持续自适应的活动能力,让一个个独立代理为每一位真实客户量身定制个性化体验。
基于上述理念,Databricks 正式发布了专为湖仓平台打造的原生 Agentic CDP——**CustomerLake**。演讲者在台上特别强调了它的独特性:“Customer Lake is an agentic CDP built specifically for the Databricks platform. It's embedded, meaning data never has to leave the lake house, and all the governance for data and agents that you've done with Unity Catalog will be transferred immediately into Customer Lake.” 这意味着数据无需离开湖仓,Unity Catalog 赋予数据与代理的所有安全治理策略均可无缝继承。同时,它具备面向业务人员的专属 UI(Business-first UI),并能以全自动化的方式“每天十亿次地提供极致客户体验”。CustomerLake 包含两大核心模块:负责将原始数据治理为全景视角的 **Profile Agents**,以及赋能营销人员实现 Infinity Campaigns 的 **Campaign Agents**。
```mermaid flowchart TD accTitle: CustomerLake Architecture accDescr: High-level overview of CustomerLake modules built inside Databricks Lakehouse.
subgraph Lakehouse["Databricks Lakehouse 统一底座"] direction TB Data["企业全量数据 & 上下文"] UC["Unity Catalog 集中安全治理"] end
subgraph CustomerLake["CustomerLake: Agentic CDP"] direction TB PA["Profile Agents: 原始数据 -> Customer 360"] CA["Campaign Agents: 自然语言 -> Infinity Campaigns"] end
subgraph Activation["下游营销与广告平台"] direction LR OutEmail["邮件营销系统"] OutAd["广告投放渠道"] end
Data --> CustomerLake UC --> CustomerLake PA --> CA CA -->|"原生 Reverse ETL"| Activation ```
---
[02:02:40](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=7360s) Profile Agents 与 Agentic 身份解析
**Profile Agents** 的定位是实现从杂乱原始数据到“业务就绪型(Business-ready)”Customer 360 的全自动化处理闭环。业务人员仅需输入一段定义业务场景的自然语言 Prompt,Profile Agents 即可自动进行数据摄取、清洗转换、特征富化、身份解析(Identity Resolution)及档案质量评估,形成持续自我优化的代理循环机制。在准备阶段,它依托 LakeFlow Connect 摄取来自第三方应用的数据或直接调用现有湖仓数据,通过语义标签自动修复错误邮箱、地址或电话等脏数据,并借助 Databricks Marketplace 引入外部数据实现数据补水(Data Hydration)。
在数据处理环节中,最核心的一环是处理第一方数据时的**身份解析**——即在缺乏统一全局主键(Customer Key)的前提下,跨多个异构数据集识别出同一个真实客户。如果姓名、地址或邮箱拼写存在细微差异却未被正确归一,系统就会将同一客户误判为不同的人,给后续营销与客户体验带来灾难性混乱。对此,Databricks 推出了一套革新性的“Agentic 身份解析(Agentic Identity Resolution)”范式: - **三级自适应判定机制**:先由代理自动总结并推演规则;当确定性规则无法判别时,大语言模型(LLM)介入做概率推理;若仍存疑,则主动回退引入人工反馈(Human Feedback)。 - **闭环自我进化**:解析的身份案例越多,代理体系的学习就越深入,促使匹配规则与 LLM 的推理准确度呈螺旋式上升。 - **超越传统方法**:彻底打破了过去单纯依赖死板 SQL 规则或周期冗长、泛化能力差的传统机器学习模型的局限。
对于来自外部合作伙伴的第三方数据,系统通过 Databricks Clean Rooms(数据净室)实现身份比对解析,实现数据在全流程绝不流出企业湖仓的隐私优先(Privacy-first)架构。在完成数据摄取、清洗治理与实体解析后,Profile Agents 自动执行 Schema 映射、存活规则裁决(Survivorship)以及数据质量自检评估,极速交付可直接用于业务的高质量 Customer 360 数据资产。
---
[02:05:45](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=7545s) Campaign Agents 与 Infinity Campaigns
第二大核心组件 **Campaign Agents** 专门用于全自动化接管繁琐的营销活动链路。营销人员只要输入自然语言 Prompt,代理便能根据业务上下文与预设目标自动撰写出详尽的活动简报(Campaign Brief);营销人员完成确认审核后,即可一键下发代理执行端到端的个性化交付。除了传统的受众圈选(Audiencing)功能全面升级为 Genie 驱动的自然语言交互外,系统还保留了直观易用的业务 UI,让营销运营人员随时复核、修改代理的工作成果,轻点一下就能将圈选受众直接转化为营销战役。
Campaign Agents 的灵魂正是 **Infinity Campaigns**。传统自动化营销往往需要耗费数月去开发、测试专有机器学习模型,或依赖漫长收敛的决策树系统;而以 LLM 为核心构建的 Infinity Campaigns 能够做到真正的开箱即用,瞬间对个体展开一对一的精准个性化触达。该系统原生自带了仿真运行(Simulation Runs)、安全防护栏(Guardrails)与转化度量工具。更为重磅的是,为了解决用户长期的痛点,Databricks 首次推出了完全由平台托管的原生 **Reverse ETL** 连接器服务,一键即可与广告营销及客户体验生态直接打通: - **首发规模**:上线即支持与主流生态伙伴的约 20 个原生连接器; - **后续规划**:承诺在年底前再追加十多个连接器,后续还将持续扩充。
---
[02:08:53](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=7733s) Demo:CustomerLake 实机操作演示
演讲者邀请同事 Justin 登台,进行 CustomerLake 的全球首发实机演示。Justin 登台后幽默打趣这是今天的一场“返场演示(Encore demo)”,并明确本次演示的上下文:假设用户已经提前使用 Profile Agents 完成了客户数据的摄取、建模与身份归一化清洗,接下来将重点展示业务人员如何利用 Campaign Agents 与 Genie 快速完成受众圈选,并借助 Infinity Campaigns 执行一对一自适应决策。
Justin 现场以虚拟运动品牌“Bricksport”的营销经理视角切入系统: - 屏幕上呈现出统一的营销活动主看板(Campaigns Dashboard),清晰陈列着所有当前活跃的营销活动、核心监控受众群体以及各通道最为活跃的反向 ETL 数据同步状态; - Justin 随后点击切换到受众管理界面(Audiences),展示已有受众的规模量级及近期随时间波动的百分比变化; - 紧接着,他现场启动了新建受众流程,准备展示借助底层 Genie 的自然语言交互能力直接生成全新受众圈选。
[02:10:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=7800s) 演示 CustomerLake 营销智能体与可解释的个性化决策
在现场演示中,主讲人展示了如何通过自然语言提示词(Prompt)与 Genie 交互来构建受众群,完全摆脱了手动编写复杂规则与筛选条件的繁琐流程。他在输入框中粘贴了一段提示:“纳入我们最有价值的美国队(Team USA)粉丝,即本赛季在周边商品上消费超过 500 美元的人群;同时排除所有已经购买过美国队球迷装备包(USA Fan Kit)的人。”Genie 随即自动分析系统内现有的受众与属性数据,秒级生成了一个包含 80 万客户的高价值受众群。生成的规则条件完全可视化且支持人工调整,后台还对应着一段极其复杂的 SQL 查询语句。主讲人指出,以往数据工程师为支持市场部拉取名单必须手写这类庞杂的 SQL,而现在仅凭一句自然语言便能自动生成。
```mermaid flowchart LR accTitle: Genie 驱动的受众生成与动态触达流程 accDescr: 展示从自然语言提示词到受众群体生成,再经由 Campaign Agents 决策引擎完成个性化触达的端到端架构。
subgraph AudienceGen["受众生成 (Audience Gen)"] A["自然语言提示词<br>(NL Prompt)"] --> B["Genie 智能解析"] B --> C["自动生成复杂 SQL"] C --> D["80万高净值受众群"] end
subgraph AgentDecision["智能决策引擎 (Agent Engine)"] D --> E["Infinity Campaign<br>配置与护栏"] E --> F{"逐人实时研判<br>(One-to-One 评估)"} F -->|"延后触达<br>(频控/无信号)"| G["暂不发信 (Defer)"] F -->|"高转化意图"| H["升级优惠券 (15% Off)"] F -->|"赛事即时信息"| I["比赛日指南 (Matchday Guide)"] end ```
生成受众后,系统会为每个受众群体动态生成专属的数据分析看板,不仅能提供洞察,还能直接将人群资产推送到新营销活动中进行实时同步。随后,演示转入一个正在运行的现场“无限营销活动”(Infinity Campaign)——“场馆内球迷体验”(In-Venue Fan Experience)。该活动预先配置了转化指标、防护边界(如频控限制 Guardrails)以及可选素材库(如“比赛日指南”和“比赛日升级优惠”)。
其核心突破在于智能体后台(Agents Tab)对客户进行端到端的“千人千面”逐一研判: - **暂缓触达决策**:系统抽检客户 Marcus 的档案时,智能体判定“推迟”(Defer)发送信息。后台公开了该决定的完整可解释性推理链路(Reasoning),包括评估的历史数据信号、时间窗口以及频次上限等防护机制。 - **差异化内容推送**:另一位符合转化特征的客户收到了一张“座位升舱 85 折专属优惠券”;而另一位普通到场球迷收到的则是涵盖开球时间、球场停车指引等基础服务的“比赛日指南”。
通过这种方式,营销智能体(Campaign Agents)得以全天候、持续性地为每一位独立客户实时定制触达策略,彻底重塑了活动看板与点击/转化率追踪形态。主讲人对此总结道:“这便是 CustomerLake 营销智能体——全球首个智能体驱动的客户数据平台(Agentic CDP)。”
---
[02:15:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=8100s) CustomerLake 开启私有预览与 AI 时代安全攻防困境
演示结束后,主持人宣布 CustomerLake 正式进入私有预览(Private Preview)阶段。该产品的研发依托于全球顶级品牌客户的早期实战反馈,并联合了覆盖数据底层、广告投流、创意内容与实施服务的全套生态合作伙伴网络。为了让与会者更深入了解技术细节,当天大会同步开设了专属 CDP 技术分论坛及下午 1 点的营销峰会,由一线研发工程师及早期客户共同解密如何实现“每天十亿次完美的个性化客户体验”。
紧接着,Lakewatch 业务总经理 Andrew Tu 登台,带来了重磅安全发布——面向安全场景的新一代湖仓产品 Lakewatch(该产品最初于 RSA 大会亮相),并结合前一天 Databricks 宣布收购安全检测平台 Panther Labs 的战略动作展开剖析。
Andrew 从攻击侧的范式演变剖析了打造 Lakewatch 的深层原因。在过去,挖掘闭源或开源软件中未公开的“零日漏洞”(0-Day),通常依赖国家级黑客团队耗费数月甚至数年的逆向工程;而如今,顶尖的大语言模型(LLM)让任何普通人都能瞬间挖掘复杂脆弱点。更为严峻的是,AI 已经实现了黑客攻击全流程的自动化。Andrew 列举了 Anthropic 近期披露的真实案例:黑客完全借助 Claude 渗透了墨西哥政府系统:
> “黑客让智能体在一批服务器中搜寻漏洞;智能体找到漏洞后,他们命令它向其中一台发起攻击并成功攻破;随后黑客要求提权至 Root 权限,智能体在 crontab 配置条目中迅速找到破绽并夺取了最高权限;最终黑客指使智能体检索敏感数据,卷走了 2 亿条人事档案以及数以 GB 计的机密数据。”
面对这种以史无前例的规模和速度爆发的 AI 攻击,传统的防御模式已无力招架。主流企业安全运营中心(SOC)普遍遵循三步走链路:第一步从笔记本、服务器、身份凭证系统汇集全量遥测与日志;第二步基于中心化数据编写规则(如检测短时间内跨越半个地球的异常异地登录);第三步将成千上万条报警推给事故响应(Incident Response)分析师团队进行人工排查。然而在 AI 驱动的全自动攻击面前,唯有打破壁垒、推动安全团队与数据工程团队深度联手,构建基于安全湖仓的智能体主动防御,才能扭转不对称的攻防战局。
- **重点动态与数据**: - CustomerLake 进入 Private Preview,并在大会设立 CDP 分会场与 Marketing Forum。 - Databricks 宣布正式收购云原生安全分析平台 Panther Labs。 - 黑客利用 LLM 智能体自动化实施渗透、Linux Crontab 提权,窃取墨西哥政府 2 亿条敏感人事记录。 - 传统 SOC 流程因无法承载海量告警与秒级攻防响应,亟需向数据与智能体结合的现代化安全底座演进。
[02:20:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=8400s) 传统 SIEM 面临的数据瓶颈与 Agentic 威胁挑战
传统的安全运营团队在面对安全警报时,每天都要排查海量事件,核实其究竟是真实的入侵威胁还是单纯的误报。一旦确认是真实攻击,分析师就需要执行封禁 IP、强制重置密码等补救措施。然而,当前安全运营所依赖的工具(如传统的 SIEM,即安全信息和事件管理系统)早已跟不上当下的威胁规模。
传统 SIEM 的首要死穴在于“根本无法将所有数据完整写入”,这一方面受制于系统架构的技术瓶颈,另一方面也受到高昂成本的制约。安全团队为了妥协,不得不施展各种“杂技”来削减入库数据量:他们不仅被迫抛弃存放超过 30 天的历史数据,还会部署过滤程序剔除看似价值较低的信息,但这极易漏掉致命线索。更严重的是,现代威胁调查急需的上下文数据——如 LLM 调用日志、源代码、Jira 任务记录、Slack 聊天消息等——传统 SIEM 根本无力摄取,导致分析师无法准确判断用户究竟是在合法调试服务,还是整台设备已被黑客攻破。
第二个致命痛点是流程高度依赖繁重的人工。2020 年左右,每家大型机构的安全响应分析师每周只需应对约 7,000 起警报,而如今这一数字已飙升至每周 30,000 多起。每排查一起事件(查验当事前后的登录痕迹、环境历史等)平均耗时 30 分钟;照此推算,企业需要维持一支超过 400 人的庞大团队才能勉强处理现存告警。演讲者犀利地指出了人机对抗的不对等:
> “So the reality is that with the tools we have today, we don't stand a chance in meeting these agentic threats. We're dealing with incomplete data because we can't afford and we can't scale to bring it in. We're dealing with humans fighting agent attackers.”
为了打破数据孤岛和人肉运维的死局,Databricks 推出了构建在自身底层之上的 Agentic 安全数据湖仓——**Lakewatch**。所有数据均采用开源格式存储,在大幅降低成本的同时,通过 Unity Catalog 实行集中的数据治理与合规管控;更进一步,Lakewatch 深度整合了 Agent Bricks 和 Genie,并在专为安全团队定制的 UI 中,将 AI Agent 赋能到安全链路的每一步: - **数据摄取(Ingest):** Agent 自动执行 ETL 与数据规范化,即使遇到上游模式(Schema)变更也能自主修正管线,杜绝链路中断。 - **威胁检测(Detection):** Agent 自动生成检测规则和分析查询。 - **事件调查(Investigation):** Agent 自动完成背景调查并拼装完整案卷,分析师只需最终复核与批准处置策略。
```mermaid flowchart TD accTitle: Lakewatch 架构与 Agent 自动化闭环 accDescr: 展示从多源异构数据摄取、经由 Unity Catalog 与 Agent 处理,最终输出规范化检测与自动调查的全流程。
subgraph S1["数据摄取层 (Ingest)"] D1["异构与多模态数据<br>(LLM/代码/Jira/Slack/WAF/EDR)"] A1["Agent ETL 与自主修复管线"] D1 --> A1 end
subgraph S2["湖仓治理与规范化 (Lakehouse)"] U1["Unity Catalog 数据治理与合规"] O1["OCSF 规范化 Gold 表"] A1 --> U1 U1 --> O1 end
subgraph S3["Agentic 检测与响应 (Genie & Agents)"] G1["Genie 威胁调研 Agent<br>(检索 CVE 与公开情报)"] G2["检测 SQL 自动构建与验证<br>(回溯 24h/30d 排查误报)"] G3["自动化事件背景调查<br>(预先拼装 Case 供人工复核)"] O1 --> G1 G1 --> G2 O1 --> G3 end ```
---
[02:25:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=8700s) Lakewatch 实操演示:基于 Genie 的自主威胁检测与分析
随后,Lakewatch 的技术主管 Michael Anderson 登台带来了系统实机演示。用户开通后可直接在 Databricks 的 App Switcher 中打开 Lakewatch,整套系统覆盖了 SIEM 全生命周期。在数据源接入端,除了 Databricks 原生的高效导入能力,Lakewatch 额外预置了数十种安全专用连接器,可将包含多模态在内的全部安全日志汇聚入湖。
针对多云、多厂商工具所产生的异构数据混乱问题,Lakewatch 集成了自 RSA 大会发布以来的新功能:**由 Genie 驱动的全自动规范化数据管线**。该管线可自主分析源数据,将其统一转化为开放网络安全架构框架(OCSF, Open Cybersecurity Schema Framework)格式并写入 Gold 表,实现“一次编写检测,跨多云和多厂商通用调查”。
在检测编写环节,传统 SOC 分析师从调研新型威胁、编写规则到验证往往需要数天甚至数周。Michael 在现场通过提示词向 Genie 下达任务:“请调研并为我编写一条针对 Storm-2460 的检测规则”(*“Please research and write me a detection for Storm-2460.”*)。Storm-2460 是一种攻击链路复杂的复杂恶意软件。系统即刻并行触发了后台调研 Agent 与内部数据剖析链路: 1. **情报搜集与资产匹配:** Genie 后台调研 Agent 迅速检索外部网络、公开安全分析与 CVE 报告,梳理出该攻击链的各阶段特征;与此同时,它检查了企业内部的数据管线,确认接入了 CrowdStrike 且数据已通过规范化流程落入 OCSF `process_activity` 表。 2. **逻辑构建与假设检验:** Genie 结合内外部上下文形成检测假设,扫描样本数据以确认必备字段,随后自动生成检测 SQL。系统在内部数据上测试发现了密集的系统搜索工具(Search Utility)活动,并排查出这些均为合法操作、当前尚未失陷。 3. **历史回测与误报排除:** Genie 自动在过去 24 小时的数据上测试通过,随后进一步对过去 30 天的历史数据进行全量回测,确认误报率为 0(Zero False Positives)。 4. **规则输出与 MITRE 框架标注:** 验证完毕后,Genie 自动将检测 SQL 转化为生产级规则,覆盖了该恶意软件攻击链的全部 7 个阶段(Seven Phases),并在左侧预填 SQL,在右侧完整补全了 MITRE ATT&CK 框架的标签元数据,方便统一纳入成千上万条规则矩阵进行矩阵覆盖率分析。
Michael 强调,过去耗费一周的人工编写验证流程,如今缩短到了短短两分钟。在生成的“安全案件(Security Cases)”列表中,被 Genie 图标标记的告警(例如来自 WAF 的限流突增告警)均已被后台 Agent 自动完成了前期调查与上下文补全,极大释放了安全运营中心的人力。
- **调研效率对比:** 过去 SOC 分析师耗费数天至数周的威胁规则研判与编写,通过 Genie 缩减至“几分钟内全自动闭环”。 - **攻击覆盖度:** Genie 自动编写的检测规则能够一口气锁定 Storm-2460 攻击链的全部 7 个阶段,并自动打上 MITRE ATT&CK 标签。 - **回测验证流程:** 规则生成后会自动经过 24 小时和 30 天的历史日志测试,确保在完全无误报的前提下转为正式规则。
[02:30:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=9000s) Genie 自主深度调查与代码后门发现
Michael 继续展示 Genie 在安全调查方面的惊人能力。在前面的案例中,Genie 不仅生成了完整报告,还找到了针对 Web 应用防火墙(WAF)相似攻击模式的相关案件,关联了相同 IP 地址发起的活动,查询了威胁情报源(threat intelligence feed)验证其是否为已知恶意 IP,甚至深入企业内网边界,检查该 IP 是否成功穿透 WAF 并在内网执行了后续操作。所有排查工作在安全分析师点击进入案件前就已全自动完成,省去了机械执行重复 Runbook 的繁琐步骤。更关键的是,Genie 具备自主学习能力,能参考安全分析师以往处理案例的调查逻辑,在未来遇到类似案件时直接套用优化后的分析路径,使人类分析师能够把全部精力集中在新型异常和实际威胁缓解上。
为了展现这一实时处理流程,Michael 挑选了一个此前未经 Genie 调查的“信息级(Informational)”案件。这是一个低保真度(low fidelity)的可疑 API 请求信号,日常面对成千上万报警的 SOC 团队根本无暇顾及这种仅为“偏离既定基线(statistical differentiation from an established baseline)”的细微异常。Michael 现场触发 Genie 介入调查,系统随即调取事件详情:这是一个针对特定端点的 POST 请求,其参数 `readContext` 出现异常偏离。Genie 迅速检索提供该端点服务的应用源代码,试图弄清这种新请求模式的实际危害;同时并发检索威胁情报源,核查发起请求的 IP 是否属于已知僵尸网络(botnet)或恶意资产。
随着调查推进,Genie 在源代码中取得突破性发现:当传入的 `readContext` 参数命中一种非常特殊的特征模式时,代码中竟存在一个硬编码后门(hard-coded backdoor)。该后门会绕过所有访问控制检查,直接返回解密密钥。Genie 随即自主扩大调查范围,追查该后门是由谁提交、何时引入、是否存在于其他代码路径中,以及该员工是否提交过其他可疑内容。调查结果显示,该代码在当天刚刚被提交至两个不同位置,正与该可疑 API 请求发起的时间完全吻合。紧接着,Genie 进一步调取了该员工的主管信息,并检索是否有对应的 Jira 工单以解释此次变更的原由,但没有找到任何关联工单。结合富化数据(enrichment data)显示该恶意请求来源于 Google Cloud,Genie 迅速起草报告,将该漏洞利用与上下文清晰列出,并建议立即将该告警升级为高严重性(High severity)并判定为真阳性(true positive)。
Michael 激动地评价道:“This is really a pivotal moment in security. This is the first time in history that my capacity to investigate cases and my capacity to be thorough in investigating every single thing in my infrastructure is no longer bounded or limited by the size of my SOC team.”(这是安全领域的关键转折点。这是历史上第一次,调查案件的能力以及深入排查基础设施中每一处异常的能力,不再受到 SOC 团队人员规模的束缚与限制。)借助 Genie 的能力与 Lakewatch 汇入 Security Lakehouse 的海量数据,企业能够以任意规模开展安全调查,彻底改变必须依赖人类逐条坐在屏幕前操作的现状。
```mermaid flowchart TD accTitle: Genie 自动化安全事件调查与后门定位流程 accDescr: 展示 Genie 如何从低保真异常告警出发,并发执行情报排查与代码审计,最终定位后门并完成工单交叉验证的全流程
subgraph INGEST ["1. 初始告警捕获"] A["低保真度告警<br/>可疑 POST API 请求"] --> B["特征识别<br/>readContext 参数偏离基线"] end
subgraph ENRICH ["2. 并发交叉排查"] B --> C["威胁情报库核验<br/>检索 IP 归属及僵尸网络关联"] B --> D["源码审计<br/>定位提供该端点的微服务代码"] end
subgraph DEEP_DIVE ["3. 深度取证与上下文拓展"] D --> E["检测到硬编码后门<br/>绕过 ACL 直接导出解密密钥"] E --> F["Git 提交溯源<br/>当天提交且分布在两处代码中"] F --> G["协同系统核查<br/>检索 Jira 变更工单与直属主管"] end
subgraph OUTPUT ["4. 自动化研判结论"] C --> H["未命中已知威胁库<br/>归属地: Google Cloud IP"] G --> I["未关联任何合法工单<br/>缺乏业务合理解释"] H --> J["综合安全报告<br/>建议定性为真阳性并上调至高危"] I --> J end ```
- **消除重复工作**:Genie 学习分析师历史操作,自动跑完复杂调查流程,使分析师仅需关注独特性威胁与缓解措施。 - **低保真信号全覆盖**:打破因告警海量而忽略低置信度异常的困局,利用 Agent 具备的自动化并发推理能力将细微偏差挖穿至根源。 - **端到端多源串联**:一次完整的 Agentic 调查打通了运行期日志、威胁情报、Git 源代码库、组织架构与 Jira 项目管理系统的全链条上下文。
[02:35:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=9300s) Lakewatch 愿景与收购 Panther:AI 驱动的 SOC 变革
随后 Andrew 重新回到台上,总结了 Lakewatch 所带来的安全范式演进:企业在面对黑客利用 AI 构筑攻击链时,终于可以使用以防守 Agent 为核心的武器进行对等反击;由于数据全部基于开放生态和开放格式存储,安全团队摆脱了传统私有存储的数据孤岛与容量成本限制。Lakewatch 推出数月以来,已吸引 Atlassian、Adobe 和 NAB(澳大利亚国民银行)等旗舰客户。以 Adobe 为例,其以往的传统架构难以承担 PB 级别的安全数据分析,迁移至 Databricks 后,通过引入 AI 与机器学习技术,成功挖掘出了以往根本不可能检出的隐藏威胁。Andrew 呼吁数据 AI 专家与安全团队紧密携手,以开放的 Security Lakehouse 架构武装基础设施。
紧接着,Databricks 联合创始人兼工程执行副总裁 Reynold Xin 登台,探讨前一天 Ali Ghodsi 宣布收购 Panther 的重大交易。Panther 是一家提供领先 AI SOC 平台的网络安全企业。Reynold 邀请 Panther 创始人兼 CEO Jack Naglieri 登台交流。Jack 拥有约八年一线网络攻防运营经验,在创立 Panther 之前曾主管 Airbnb 的检测与响应工程团队(Detection and Response Engineering)。Jack 坦言,传统开箱即用的 SIEM 产品在面对现代海量高频日志时往往“速度慢、费用高昂且运维负担沉重”,逼得他们当年在 Airbnb 走上了自研系统的道路,而后将其开源演化为了 Panther 的雏形。目前 Panther 的服务对象涵盖 Coinbase、Docker、Block 等全球顶级科技企业。
谈及创业历程,Reynold 揭露了一个极为罕见的细节:作为 CEO 的 Jack 在几年前大模型技术兴起时,主动向董事会申请卸下日常管理运营职责,重返一线“100% 全职敲代码写系统”,潜心探索如何用第一性原理将 AI Agent 深度植入 SOC 的核心,而非仅仅将 AI 作为插件强行缝合在老旧的手工流程之上。Jack 解释说,他们从利用 LLM 自动编写检测规则起步,逐步攻坚突破至让 AI 实现端到端自动化警报分诊(alert triage),彻底打破了 SOC 多年受困于告警过载的根本性扩展瓶颈。对于安全与数据团队协作的未来,Jack 指出安全人员应当聚焦于攻击机理和事件响应的本职领域,Panther 与 Databricks 的结合旨在为安全团队提供极致的数据底座红利与应用层支撑,在无需深陷复杂基础设施运维细节的前提下,全面推进威胁检测响应与合规落地。
- **解除规模与成本束缚**:Lakewatch 帮助 Adobe 等企业突破原有专用 SIEM 的容量墙,以湖仓经济性与开放格式支撑数 PB 级日志的深度安全审计。 - **从规则生成到端到端分诊**:Panther 将大语言模型的应用范式从最初的规则代码生成,推进至告警全流程自主分拣处置,重构安全运营中枢。 - **安全与数据基础设施解耦**:安全分析师保留“运营人员与攻防专家”的核心职能,底层的海量分布式算力与数据治理则由 Databricks 现代数据架构透明承载。
[02:40:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=9600s) 安全智能体的广阔前景与 Panther 合作回顾
在与 Panther 联合创始人兼 CEO Jack 交流的尾声,讲台上的讨论集中在安全团队如何利用智能体(Agents)获得更广阔的企业数据访问权。传统的安全分析往往受制于孤立的日志库,而当安全智能体能够触达更全面的业务和系统数据集时,它们就能执行更精准的数据丰富化(enrichment)和告警分流(triage),大幅提高安全团队处置威胁的准确率与响应速度,同时全力支撑底层业务的持续扩张。
主持人向 Jack 表达了感谢:“Okay. Well, I don't want to keep you here for too long. Thank you very much, Jack. And we're now going to pass back to Ali to just Give us some closing thoughts.” 随着现场观众的热烈掌声,Databricks 首席执行官兼联合创始人 Ali Ghodsi 重新回到舞台中央,准备对为期两天的 Data + AI Summit 2026 Keynote 进行系统性的宏观复盘。
[02:40:48](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=9648s) 智能体时代的数据底座:从 Lakeflow 到 Lakebase 与 LakeTap
Ali Ghodsi 首先带领全场观众回顾了本次大会的核心命题:当今世界上已经涌现出令人惊叹的尖端 AI 模型,但要让企业级智能体真正发挥效能,关键在于将底层的所有数据与业务上下文(Context)源源不断地供给它们。而过去两天发布的所有产品与技术架构,正是为了彻底解决企业上下文注入与管控这一瓶颈。
在数据底座层面,大会首先推出了 Lakeflow。它如今已成为汇聚各异构数据源的核心枢纽,凭借新增的数百个官方连接器,企业能够以任意开放格式将数据低门槛导入 Lakehouse。紧随其后的是 Reynold Xin 梦寐以求的实时引擎 Lakehouse RT(代号 Raiden 引擎),其极致的查询速度不仅让下游 BI 仪表盘实现亚秒级极速渲染,更为自主运行的智能体在海量数据上的高频穿梭提供了强劲动力。而在存储与事务层,基于 Serverless Postgres 架构的 Lakebase 极大降低了企业构建应用的总拥有成本(TCO),更重磅的是通过 LakeTap 技术将分析型 Lakehouse 与操作型 Lakebase 深度融合,打通了事务与分析的界限。
```mermaid flowchart LR accTitle: Lakehouse RT and LakeTap Architecture accDescr: Diagram showing data flowing from multi-source connectors into Lakeflow, then into Lakehouse RT and Lakebase via LakeTap to power Agents and Dashboards.
subgraph Ingestion["数据摄取层"] S["数百种异构数据源"] --> LF["Lakeflow 连接器"] end
subgraph Storage["智能数据底座"] LF --> LH["Lakehouse (开放格式)"] LH <-->|"LakeTap 双向打通"| LB["Lakebase (Serverless Postgres)"] end
subgraph Consumption["高速消费层"] LH --> RT["Lakehouse RT (Raiden 引擎)"] RT --> DB["极速仪表盘 Dashboards"] RT --> AG["智能体 Agents"] end ```
- **Lakeflow 扩展**:内置数百个企业级数据连接器,无缝将异构多源数据同步至开放格式 Lakehouse 中。 - **Lakehouse RT (Raiden)**:专为极致性能打造的实时分析引擎,保障海量数据上的快速检索与交互体验。 - **Lakebase 与 LakeTap**:Serverless Postgres 实例降低了应用基础设施开销,借助 LakeTap 实现操作型事务与分析型数仓的一体化联动。
[02:41:40](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=9700s) 统一治理、Genie 本体网络与 Genie 1 统一入口
在数据准备完毕后,架构的关键支柱转向了治理与企业知识表示。Databricks 通过 Unity Catalog 与 Unity AI Gateway 构建了全面的管控体系。Ali 特别提到了 Ankit 的演示:通过 Unity AI Gateway 实现的“顾问模式(Advisor Pattern)”,让系统先使用成本极低的开源小模型完成常规任务,仅在遇到高难度复杂推理时才调用昂贵的外部旗舰模型作为顾问,以此在生产环境中实现大幅度的成本削减(Valuemaxxing)。
而在整个智能体架构的最顶层,最核心的基石当属 Genie Ontology(本体网络)。系统在后台持续自动构建一张贯穿整座企业的全局知识图谱,并实时向各类应用智能体喂送精确的语义与业务逻辑。在此之上,大会推出了旗舰级产品 Genie 1——它是整个 Databricks 平台的统一玻璃视窗(Single pane of glass)。企业不再需要让业务人员在碎片化的工作区(Workspaces)或不同的数据仓库之间来回切换,任何人都能在一个界面用自然语言向数据提问。
Ali 动情地向现场所有的技术决策者呼吁:“Please help your organization get Genie 1 in everyone's hands.” 企业只需在 Databricks 中开启自动身份管理(Automatic Identity Management, AIM),为全员分配经过权限裁剪的“Consumer Role”,即可让非技术背景的普通员工无障碍使用 Genie 1,而不会被复杂专业的大数据工作台界面所劝退。
- **顾问模式(Advisor Pattern)**:小模型跑日常流水,大模型按需作为顾问介入,兼顾系统智能化与成本断崖式下降。 - **Genie Ontology**:持续在后台运作的企业级知识图谱,为全组织智能体提供确定性的业务上下文。 - **自动身份管理(AIM)**:一键开启全员登录,配合专有 Consumer Role 角色权限,抹平普通业务用户的技术鸿沟。
[02:43:08](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=9788s) 全栈智能体矩阵:Genie 系列、Agent Bricks、Lakewatch 与 CustomerLake
在全栈智能体赋能方面,Ali 逐一串联了本次大会呈现的矩阵式产品布局: 1. **Genie Agents 与 Genie Code**:Genie Agents 充当全天候协作的“数字同事”,按预定计划自主推进工作;而正如 Mike Delmaso 演示的那样,面向机器学习工程的 Genie Code 能让团队自主构建高阶预测模型,并提供全流程的故障排查与持续监控。 2. **Genie ZeroOps**:被 Ali 盛赞为他个人最喜爱的工具,专为数据管线(Pipelines)运维而生,能够在生产管线崩溃时自主定位并自动完成代码修复与重启。 3. **Databricks Apps 与 App Builder**:Justin 演示的 Genie App Builder 赋予了企业员工通过“氛围编码(Vibe coding)”快速定制低成本微应用的能力,弹性扩缩容以满足多变需求。 4. **Agent Bricks 与 Omnigent**:Matei Zaharia 发布的开源元框架(Meta-harness)Omnigent 以及 Agent Bricks 记忆、沙箱存储服务,解决了开发者自建智能体环境下的碎片化与互操作难题。 5. **行业智能体应用**:安全领域的开放安全湖仓 Lakewatch(联合 Panther 打造)通过智能体消除检测告警分流与威胁狩猎中的繁重体力劳动;营销领域的 CustomerLake 则革新了传统的 CDP 概念,支持构建 Customer 360 与全自动推进的无限营销活动(Infinity Campaigns)。
[02:45:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=9900s) 开放无锁定的智能体数据基座与闭幕致辞
在 Keynote 的最后,Ali Ghodsi 将所有创新收束为 Databricks 坚守的四大基石:自主选择权(Choice)、坚定不移的开源承诺(Open source)、精细的成本与安全管控(Cost controls & Governance),以及位于金字塔顶尖的 Genie Ontology 上下文层。
Ali 掷地有声地总结了 Databricks 对下一代企业技术架构的终极承诺:“In short, we want you to have any data, any model, and any harness, no cloud lock-in, for your whole infrastructure.” 无论使用何种底层云服务,企业都将在统一的数据智能平台上掌控所有数据模型与智能体开发框架,享受极致的成本治理,并在统一的企业上下文中激发生产力。
伴随着对后续研讨会、展厅合作伙伴与赞助商展台的指引,Ali 向全场与线上超过 30,000 名数据与 AI 专业人士表达了感谢,并热烈邀请所有人参加当晚在 Oracle Hall 举办的由 The Chainsmokers(烟鬼组合)助阵的峰会官方派对,在激昂欢快的音乐背景声中为本届 Data + AI Summit Day 2 Keynote 画上了句号。
## Notable quotes > [00:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=0s) 我们认为 AI 本身已经足够聪明了。我们不需要 AI 拥有更高的智力,我们需要的是更多的上下文。 — Ali Ghodsi
> [36:11](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=2171s) 当你看到智能体演示和概念验证时,通常只看到了智能体循环(Agent Loop),但智能体循环只占你全部工作的 1%,剩下那 99% 才是真正的拦路虎。 — Casey Uhlenhut
> [01:10:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=4200s) Enterprise apps are not just code. They need access to the data. And the real challenge in going from prototype to production is governed access to that data. — Justin
> [01:02:40](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=3760s) The one way to waste a lot of tokens is not have the best context. — Satya Nadella
> [02:30:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=9000s) This is the first time in history that my capacity to investigate cases and my capacity to be thorough in investigating every single thing in my infrastructure is no longer bounded or limited by the size of my SOC team. — Michael Anderson
> [42:11](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=2531s) 再优秀的模型,其效果也完全取决于你喂给它的信息 — Casey Uhlenhut
> [10:00](https://www.youtube.com/watch?v=sn9My5Pj0mE&t=600s) If an AI solution works for India, it can serve the world. — Reliance 发言人
## Mentioned Ali Ghodsi, Matei Zaharia, Casey Uhlenhut, Ankit Mathur, Mukesh Ambani, Satya Nadella, Justin de Brabant, Mike Del Balso, Michael Anderson, Jack Naglieri, Reynold Xin, Databricks, Microsoft, Reliance Industries, Anthropic, OpenAI, Google, xAI, Panther Labs, MasterCard, AstraZeneca, 7-Eleven, Adobe, Atlassian, Thales, Joby, Danfoss, Merck, Agent Bricks, Omnigent, Unity AI Gateway, Genie, Genie Code, Genie ZeroOps, Genie Ontology, Genie App Builder, Genie 1, Lakewatch, CustomerLake, Databricks Apps, Databricks Sandbox, Agent Memory Services, Document Intelligence, Unity Catalog, MLflow, Lakebase, Lakeflow, Lakehouse RT, AppSpaces, Serverless Micro Apps, AI Runtime, AppKit, Claude Code, Claude Opus, OpenAI Codex, Grok, Gemini 3.5 Flash, Model Context Protocol (MCP), Microsoft 365 Copilot, Copilot Studio
## Video description Watch the full keynote from day 2 of Data + AI Summit, which brought together 30,000+ data professionals across data engineering, scientists, analysts, architects, and business leaders.
The speakers covered new open source innovations, major updates to the Databricks Platform, and marketing and security solutions built for the agentic era.
0:00 Databricks CEO and Co-founder Ali Ghodsi on how context + AI unlocks enterprise agents that work 3:21 Product updates and innovations you’ll explore in this keynote 11:11 The AI harness problem: anyone can build their own agent harness, making interoperability hard 18:56 Why we built Omnigent, an open meta-harness, and how it works 23:20 Demo: Omnigent OSS 33:05 Why we open sourced Omnigent 34:44 What’s new in Databricks Free Edition 36:11 Engineers get stuck building infrastructure, and Agent Bricks solves this problem 40:28 Agent Bricks provides choice across models, agents, and harnesses 42:11 Agent Bricks solves the context problem 44:23 Announcing Agent Memory Services, powered by Lakebase 45:18 Announcing Databricks Sandbox: VMs for secure code execution 46:51 New capabilities in Unity AI Gateway: centralized governance, security, and cost controls over agents, models, and tools 52:37 Demo: from toxenmaxxing to valuemaxxing with Unity AI Gateway 1:09:16 Governed access data is the biggest roadblock to production for AI apps 1:13:04 How Databricks Apps brings app vibe coding in the enterprise 1:16:35 The prototype to product gap with vibe coded apps 1:17:53 What’s new in Databricks Apps 1:21:11 Demo: Building an app with Genie App Builder 1:28:01 Virtue Foundation powers healthcare with Genie 1:29:22 The only way to automate ML is with agents 1:37:07 Announcing AI Runtime: Serverless GPU compute for enterprise deep learning 1:38:13 Announcing Genie Code for ML: an agent for production ML engineering 1:42:43 Announcing Genie ZeroOps for ML: an agent that runs your ML systems 1:45:22 Demo: Genie ZeroOps for ML 1:51:01 Agentic ML engineering is here 1:52:48 AI is changing how people buy 1:57:12 Infinity Campaigns, a new approach to marketing campaigns, powered by the agentic CDP 2:01:33 Announcing CustomerLake: an agentic CDP to power the perfect customer experience – a billion times a day 2:08:53 Demo: CustomerLake Campaign Agents for always-on engagement 2:16:25 Agents are fundamentally changing security 2:22:29 Lakewatch: fight every security threat with agents 2:24:43 Demo: Lakewatch, an open agentic security lakehouse 2:35:45 Databricks x Panther 2:40:36 The Agentic Data Foundation
[Source](https://www.youtube.com/watch?v=sn9My5Pj0mE)