Databricks发布Genie ZeroOps并升级Lakeflow以替代Kafka与自建Airflow
Databricks
通用编程智能体因缺乏血缘感知和生产写权限无法胜任数据运维,数据工程自治必须依托常驻数据平面的智能体与沙箱浅克隆验证闭环。
AI-assisted summary of Unlocking agentic data engineering with Lakeflow + Genie — original source. Check the original for full context.
Source published:
Key ideas
- Databricks 正式推出后台常驻的自主运维智能体 Genie ZeroOps,依托数据平面与 Unity Catalog 权限,实现故障检测、多 Agent 根因排查、PB 级数据浅克隆沙箱验证与修复 PR 自动生成的全流程闭环。 (12:34)
- 全新完全托管服务 Zerobus Ingest 实现 100% 兼容 Kafka 网络协议,支持 12 GB/s 吞吐直写开放湖仓且避免小文件碎片问题,允许企业无缝平迁并淘汰自建 Kafka 基础设施。 (5:40)
- 由 Genie 驱动的无代码数据准备工具 Lakeflow Designer 正式面向全球商用(GA),拖拉拽生成的代码百分之百转换为标准开源 Apache Spark 声明式流水线,杜绝影子 IT 与专有格式锁定。 (4:50)
- Genie Code 发布仅 3 个月,平台上已有 60% 的 Lakeflow 流水线由其生成;同时 Spark 声明式流水线日处理量已达 200 万亿行,Lakeflow Jobs 每月调度达 17 亿次。 (2:21)
Detailed notes
## Background 该视频由 Databricks 官方频道于 2026 年 6 月 23 日发布在 YouTube 平台上。视频记录了在 2026 Data + AI 峰会上,Databricks 产品管理高级总监 Bilal Aslam 围绕 Lakeflow 的核心更新,并正式发布面向数据与 AI 自主运维的智能体系统 Genie ZeroOps 的精彩演讲。
## TL;DR 随着 AI 应用与智能体的大爆发,传统数据工程中割裂臃肿的“混乱中间层”让工程师面临前所未有的维护重负。Databricks 通过全开放的 Lakeflow 技术栈重塑底座:利用 Apache Spark 声明式流水线统一批流与语言、正式商用无代码工具 Lakeflow Designer 终结影子 IT、推出协议 100% 兼容 Kafka 的 Zerobus Ingest,并升级全托管 Serverless 架构的 Lakeflow Jobs。针对通用编程智能体无法触碰生产数据的运维死局,大会重磅发布常驻数据平面的 Genie ZeroOps,依托数据血缘图排序、多智能体协同以及零风险的浅克隆沙箱验证,实现故障自动溯源、自愈与 PII 合规治理,让数据运维彻底迈向自动驾驶。
## Atmosphere & style 整场演讲兼具行业洞察的犀利清醒与技术发布的激情澎湃。Bilal Aslam 身着标志性的亮眼紫色西装登台,开场幽默风趣,随即用极其接地气的数据工程师视角一针见血地撕开光鲜 AI 背后的架构乱象,引发全场强烈共鸣。台上与台下关于“生产写入权限”的敏锐互动将演讲推向技术高潮,实机演示环环相扣,呈现出一种从令人焦虑的告警泥潭中解脱、走向优雅自治与极简创造的振奋氛围。
## Bulletin - [12:34](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=754s) Databricks 正式推出后台常驻的自主运维智能体 Genie ZeroOps,依托数据平面与 Unity Catalog 权限,实现故障检测、多 Agent 根因排查、PB 级数据浅克隆沙箱验证与修复 PR 自动生成的全流程闭环。 - [05:40](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=340s) 全新完全托管服务 Zerobus Ingest 实现 100% 兼容 Kafka 网络协议,支持 12 GB/s 吞吐直写开放湖仓且避免小文件碎片问题,允许企业无缝平迁并淘汰自建 Kafka 基础设施。 - [04:50](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=290s) 由 Genie 驱动的无代码数据准备工具 Lakeflow Designer 正式面向全球商用(GA),拖拉拽生成的代码百分之百转换为标准开源 Apache Spark 声明式流水线,杜绝影子 IT 与专有格式锁定。 - [02:21](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=141s) Genie Code 发布仅 3 个月,平台上已有 60% 的 Lakeflow 流水线由其生成;同时 Spark 声明式流水线日处理量已达 200 万亿行,Lakeflow Jobs 每月调度达 17 亿次。
## Key takeaways - [00:00](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=0s) AI 应用与智能体的大爆发对底层数据产生巨大渴求,连接异构系统与 AI 应用的“混乱中间层”让数据工程师的维护负担愈发沉重。 - [01:00](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=60s) 传统数据栈依赖大量专有 SaaS、胶水代码和独立编排器,面临无法全栈版本控制、全局数据治理缺失以及成本伸缩困难三大结构性痛点。 - [02:21](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=141s) 编码智能体 Genie Code 普及速度惊人,发布 3 个月即生成了平台 60% 的 Lakeflow 流水线,但也带来了海量新流水线的维护隐患。 - [02:58](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=178s) 解决数据工程危机的途径不是堆砌更复杂的系统,而是依托开放格式、开放框架的 Lakeflow 技术栈来全面简化基础架构。 - [03:18](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=198s) Lakeflow 转向开源 Apache Spark 声明式流水线,成功统一了批处理与流处理、SQL 与 Python 混编,并原生集成了毫秒级低延迟的实时模式。 - [04:50](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=290s) 无代码数据准备工具 Lakeflow Designer 正式商用,前台交互生成的底层逻辑完全编译为标准开源 Spark 代码,有效解决了业务分析师带来的影子 IT 难题。 - [05:40](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=340s) Lakeflow Connect 官方连接器突破 100 款,底层统一基于 Spark 声明式流水线运行,消除第三方同步工具的私有格式治理黑盒。 - [06:18](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=378s) Zerobus Ingest 提供 100% 兼容 Kafka 协议的托管替代方案,以高达 12 GB/s 峰值吞吐直写湖仓,彻底终结了微小文件碎片灾难。 - [06:57](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=417s) Serverless Lakeflow Jobs 现已支持纯 Python 与可视化 DAG 编排,并提供超 50 个开源集成插件,助力超过 80% 运行陈旧 Airflow 的客户平滑现代化。 - [08:48](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=528s) 通用编程智能体无法胜任数据运维,因为数据工程故障往往是静默且永久的,外部 Agent 缺乏底层遥测与数据血缘,且面临不可承受的生产写入权限风险。 - [11:30](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=690s) 运维智能体必须常驻在数据平面(Data Plane)之内,只有原生嵌入 Unity Catalog 的治理边界,才能安全实现自主检测与修复。 - [12:34](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=754s) Genie ZeroOps 采用“主管智能体 + 子智能体集群”架构,基于 Unity Catalog 数据血缘执行图排序遍历,精准锁定异常的真正上游源头。 - [13:20](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=800s) 依托浅克隆(Shallow Clone)与沙箱隔离技术,Genie ZeroOps 可在不触碰真实生产数据的前提下完成修复逻辑验证,最后输出标准的 Pull Request。 - [14:04](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=844s) Genie ZeroOps 提供类似高优先级收件箱的运维视图,具备多故障并发聚合能力,并能主动扫描 PII 泄露风险并一键下发治理策略补丁。
## Detailed walkthrough ### [00:00](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=0s) 数据工程与“混乱的中间层”
Databricks 产品管理高级总监 Bilal Aslam 穿着一袭亮眼的紫色西装外套登台。他开场打趣道,自己在两年前谈论 Lakeflow 时就穿了这件紫色外套,去年没穿,结果收到的最大反馈竟然是“把紫色外套带回来”,于是今天它如约而归。在向 Mugesh、Arsalan、Ali 和 Kenan 等前面登台探讨 AI 与智能体(Agent)的嘉宾致谢后,Bilal 指出,面对大屏幕上描绘的光明 AI 前景,任何一名真正干活的数据工程师心里都在打鼓:“这一切确实很棒,但所有这些都需要数据。”所有的应用程序、智能体和 AI 都极度渴求数据,这意味着数据工程师的工作并没有变得轻松,反而更艰难了。
在传统的数据工程体系中,目标的终点往往很纯粹——向业务价值的最右端迈进,实现智能体、实时业务运营与各类智能化应用;然而起点却在最左侧极其分散的原始数据源:从 Kafka、Salesforce、NetSuite 等 SaaS 系统,到部署在本地数据中心的 Oracle 与 SQL Server 关系型数据库。连接这两端的“混乱中间层”(The Messy Middle),正是数据工程师日复一日所承担的工作。多年来,企业被迫在这些系统之间堆砌庞大而臃肿的架构图:密密麻麻的技术组件 Logo、相互缠绕的连线,甚至仅仅为了把数据从 A 点搬运到 B 点就需要维护几十个工具。
工程师们早已对这种架构复杂性妥协,抱着“至少它还能跑”的心态勉强维系。但大家心知肚明,这种割裂的架构缺乏最底层的核心能力:数据工程师渴望像对待应用代码一样对所有资产进行版本控制,然而现实中只能版本化 Spark 代码,却管不了 Kafka 基础设施;企业渴望处处实施数据治理,但因为读写端点过多、部分技术栈被完全锁死在私有格式中,全局治理几乎沦为空谈;此外,各层组件的扩展性参差不齐,成本居高不下,直接制约了业务创新的步伐。
- **起止两端的落差**:左侧是异构繁复的原始系统(SaaS、流式消息队列、本地传统数据库),右侧是需要即时喂养的 AI 应用与智能体,中间则是极其脆弱、胶水代码丛生且高成本的数据搬运管道。 - **孤岛架构的核心痛点**:无法做到全栈版本控制(Version Control)、全链路统一治理(Governance)缺失,以及底层计算存储难以平滑弹性伸缩(Scalability)。
---
[02:21](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=141s) Genie Code 的普及与数据工程师面临的新挑战
随后,Bilal Aslam 抛出了一个令人警醒的论断,直言数据工程师的好日子不仅没有到来,反而即将迎来更大的工作量冲击。他展示了专为数据科学、机器学习和数据工程构建的编码智能体 Genie Code,并公布了一组惊人的运营数据:Genie Code 刚刚发布仅仅 3 个月,整个平台上就已经有高达 60% 的 Lakeflow 数据流水线是由其自动生成的。
这一极高的采纳率让技术团队感到振奋,但站在数据工程负责人的视角,Bilal 坦言自己其实深感担忧。他虽然痴迷于智能体技术,但智能体的激增必然催生海量全新的数据诉求与流水线请求,如果底层依然是那些脆弱且割裂的传统架构,工程师团队很快就会被海量维护工作彻底淹没。破局的唯一出路在于化繁为简——不是用一套新的复杂体系去覆盖旧的复杂体系,而是用完全开放的格式、开放的框架和开放的工具去简化整个数据技术栈。Bilal 当场立下断言,认为 Lakeflow 正是能够提供这一开放 AI 底座的统一技术栈,帮助企业构建应有的未来。
> “I'm here to tell you that your job and my job as a data engineer is about to get quite a bit harder.” —— Bilal Aslam
```mermaid flowchart TD accTitle: Legacy Data Stack vs Lakeflow Architecture accDescr: A comparison showing how the messy legacy stack with multiple proprietary tools is replaced by Lakeflow's open declarative foundation.
subgraph Legacy["传统割裂架构(混乱的中间层)"] L1["异构原始数据源\n(Kafka / Oracle / Salesforce)"] --> L2["专有 SaaS / 自建同步\n(治理黑盒、格式私有)"] L2 --> L3["ETL 转换层\n(传统 Spark + Flink + dbt)"] L3 --> L4["独立编排器\n(自维护旧版 Airflow)"] L4 --> L5["业务与 AI 应用\n(脆弱、成本高、难以伸缩)"] end
subgraph Lakeflow["Lakeflow 统一开放技术栈"] R1["数据源接入\n(Zerobus Ingest / Lakeflow Connect)"] --> R2["开放声明式引擎\n(Apache Spark Declarative Pipelines)"] R2 --> R3["统一开发体验\n(Lakeflow Designer + Python/SQL)"] R3 --> R4["全托管编排\n(Serverless Lakeflow Jobs)"] R4 --> R5["AI 智能体与实时洞察\n(Delta Lakehouse 开放底座)"] end ```
---
[03:18](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=198s) 借助 Apache Spark 声明式流水线简化 ETL 与流处理
在具体拆解技术栈简化方案时,Bilal 首先聚焦于消耗工程师最多时间和企业最多预算的核心领域:ETL 与数据转换。针对企业中普遍存在的遗留 Spark 作业、运行在 AWS EMR 或其他商业发行版上的孤岛集群,Lakeflow 全面转向了开源的 Apache Spark 声明式流水线(Apache Spark Declarative Pipelines)。这种声明式范式让工程师只需关注数据转换的最终状态逻辑,且该框架具有高度开放性,不仅能在云端运行,也能在工程师的本地笔记本电脑上无缝执行;正因其语义清晰、接口开放,AI 编程智能体在编写和优化这类声明式流水线时展现出了惊人的效率。
此外,该体系彻底打破了技术栈中长期存在的多重二元对立: 1. **批处理与流处理的统一**:告别维护两套引擎的痛点,单一流水线兼顾离线批量与实时流式计算。 2. **SQL 与 Python 的统一**:早年采用 SQL 编写转换逻辑时 dbt 几乎是唯一选择,而 Spark 声明式流水线原生支持 SQL 和 Python 的自由混编,工程师无需在语言工具上作痛苦妥协。 3. **低延迟流处理的统一**:过去企业选择 Flink 往往是因为在 Spark 或 Databricks 上做超低延迟流处理存在门槛。去年 Databricks 开源了全新的低延迟流处理引擎“实时模式”(Real-time Mode),Bilal 正式宣布该模式现已完整集成至 Spark 声明式流水线中,使开发者能够在统一的开源规范下直接获得毫秒级的流处理性能。
> “So you can get millisecond streaming on an open framework that runs anywhere.” —— Bilal Aslam
---
[04:50](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=290s) 终结影子 IT:Lakeflow Designer 正式商用
在解决完核心数据工程师的底层代码框架之后,Bilal 将话题转向了企业内部广泛滋生的“影子 IT”(Shadow IT)隐患。现实中,一家公司可能只有 20 名专业数据工程师,但业务部门却分布着数百名数据分析师。为了赶业务进度,分析师们常常使用各类拖拉拽桌面工具自建流水线。这些管道大多跑在个人笔记本电脑上,采用供应商专有数据格式,一旦当事人离职,整套业务逻辑便彻底成为无人能接盘的黑盒。
针对这一顽疾,Bilal 正式宣布由 Genie 驱动的无代码数据准备工具 **Lakeflow Designer** 结束预览,即日起正式面向全球商用(GA)。现场随之响起了掌声。Bilal 特别强调,Lakeflow Designer 与市面上那些建立专有围墙的商业无代码工具截然不同:用户在前台通过无代码或低代码完成交互式数据清洗与加工后,系统在底层自动编译并生成的完全是标准的 Apache Spark 声明式流水线。这意味着没有任何专有格式锁定,生成的代码完全可审计,并能迁移到任何支持 Spark 的环境中运行。
> “Super excited to share that Lake Flow Designer, the no-code data prep tool powered by Genie, is now available. It's generally available.” —— Bilal Aslam
- **打破人员交接断层**:避免业务分析师离职后留下的专有黑盒逻辑,所有操作透明转化为标准工程资产。 - **全开放生成机制**:界面拖拉拽生成的不是封闭逻辑,而是百分之百开源、可在本地笔记本或集群跨平台运行的声明式代码。
---
[05:40](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=340s) Lakeflow Connect 生态扩展与 Zerobus Ingest 替代 Kafka
接下来是针对数据摄入(Ingestion)环节的重塑。许多企业依赖功能繁多的第三方 SaaS 同步服务,虽然连接器数量庞大,但往往将数据沉淀为专有格式,AI 智能体无法自动化操作这些闭环系统,更难以实施统一的监控和全流程治理。继 Databricks 首席执行官 Ali Ghodsi 之前的主旨演讲后,Bilal 进一步披露,**Lakeflow Connect** 官方支持的原生连接器总数已正式突破 100 款大关。除了官方覆盖主流数据源之外,开源社区也在蓬勃共建新连接器,企业亦可自建扩展。与前述组件一致,这些连接器底层统一运行在 Spark 声明式流水线之上。
而在处理海量遥测日志与实时事件流时,Kafka 一直是数据工程师不可或缺的高吞吐缓冲层,但其底层集群的搭建、调优和运维也一直是工程团队的沉重负担。为此,Bilal 带来了重磅宣布:Databricks 推出了完全托管的服务 **Zerobus Ingest**,且该服务实现对 Kafka 网络协议的 **100% 协议兼容(Wire Compatible)**。
这一兼容性意味着开发者完全无需修改现有的业务生产端代码,只需将原有往 Kafka 发送消息的 Endpoint 重新指向 Zerobus Ingest,数据便能以完全开放的格式直接流式写入 Lakehouse,原生为后续 AI 计算做好准备。更关键的是,该服务针对文件系统做了深度优化,即使面对高达每秒 12 GB 的超高写入吞吐,也不会产生困扰业内多年的“数以百万计的小文件”碎片灾难。企业自此可以彻底在技术栈中剔除笨重的自建 Kafka 基础设施。
> “Super excited to share that Zero Bus Ingest is a fully managed service that is now 100% wire compatible with Kafka.” —— Bilal Aslam
- **无缝平迁 Kafka**:完全兼容 Kafka 线路协议,现有代码无需重构,切换 Endpoint 即可直连 Lakehouse。 - **治理小文件痛点**:以 12 GB/s 峰值吞吐直写开放湖仓,杜绝数百万微小文件堆积导致读取性能急剧衰退的问题。
---
[06:57](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=417s) 现代编排升级:Lakeflow Jobs 与大规模生产验证
在数据流水线的最上方,往往还悬挂着调度和触发整个工作流的编排器(Orchestrator),例如业界普遍采用的 Apache Airflow。为了进一步收敛系统架构,**Lakeflow Jobs** 在编排能力上迎来全面升级。针对习惯编写代码定义工作流的工程师,Lakeflow Jobs 现已支持直接使用原生纯 Python 编写复杂工作流,同时保留了直观的可视化有向无环图(Point-and-click DAGs)构建界面。
整个编排平台基于全托管 Serverless 架构,彻底免除了基础设施的维护负担。Bilal 分享了一项内部调研数据:超过 80% 的受访客户目前仍在运行陈旧过时的自维护 Airflow 版本,不仅常年承担繁重的安全漏洞修补与运维补丁工作,还无法享受到现代工作流的先进特性。此外,针对以往 Lakeflow Jobs 只能高效编排 Databricks 内部任务、对外部系统整合乏力的短板,本次大会推出了超过 50 个开源集成插件(功能类似 Airflow Operator),允许工程师自由编排包括 Snowflake 在内的各类第三方跨平台系统。
在完成这一系列技术栈简化梳理后,Bilal 强调,Lakeflow 并非纸上谈兵的全新实验性产品,其核心组件早已在大规模工业级生产环境中承受严苛考验。他列举了一组权威性能指标:
> “Spark declarative pipelines now process 200 trillion rows of data every single day.” —— Bilal Aslam
| 核心组件 / 维度 | 关键生产指标(规模量级) | 技术优势与架构价值 | |:--- |:--- |:--- | | **Spark 声明式流水线** | 每日处理 **200 万亿行(200 Trillion rows)** 数据 | 统一批流与 SQL/Python,毫秒级低延迟,完全开源跨平台 | | **Lakeflow Jobs 编排调度** | 每月承载 **17 亿次(1.7 Billion runs)** 作业运行 | 原生纯 Python 与可视化 DAG,内嵌 50+ 外部系统集成(含 Snowflake) | | **Serverless 无服务器计算** | 超过 **50% 的客户** 已主动选择开启 Serverless | 彻底告别虚拟机与复杂 VPC 网络配置,开箱即用弹性伸缩 |
[08:48](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=528s) 为什么通用编程智能体无法解决数据运维难题
在让数据管道的构建变得更加简单之后,Bilal Aslam 话锋一转,指出了一个更严峻的现实隐患:如果仅仅降低构建门槛,让更多人能用 AI 编写代码、搭建管道,其结果很可能是引发更多的系统故障和宕机。根据合作伙伴的一项调研,数据工程团队超过 50% 的时间都耗费在系统维护上,而且即便投入了如此多的精力,企业每月仍要承受高达 60 个小时的宕机时间。针对“能否直接用通用编程智能体(Coding Agent)通过 API 修复问题”的疑问,Bilal 直截了当地指出,这根本行不通,因为数据工程与传统软件工程有着本质区别:
在软件工程中,代码本身是自解释的,测试结果具有确定性,且故障发生时往往伴随着显式的调用栈和异常(“Failures are loud”),工程师可以立即回滚;但在数据工程中,代码与数据深度交织,数据质量测试是统计学性质的,故障往往是无声且永久的(“Failures are silent and permanent”)。很多时候,团队是在故障发生一周后,接到 CEO 或业务方愤怒的质问电话,才得知数据早已出错。
通用编程智能体在应对数据运维时面临着三大致命断层: 1. **故障检测盲区**:缺乏原生的遥测数据与系统日志;若直接塞入动辄数兆字节的 Spark 日志,极易撑爆上下文窗口。 2. **根因定位缺失**:外部智能体无法原生理解血缘关系(Lineage),难以追踪复杂的上下游拓扑。 3. **验证阶段的权限死局**:修复数据管道不能仅凭单元测试,必须在真实生产数据上运行验证。但没有企业愿意为一个外部不受信任的智能体开放生产数据的读取权限,更不用说具有毁灭性风险的写入权限。
Bilal Aslam 在台上向现场观众犀利发问:“谁愿意给一个随机的智能体授予生产数据的写入权限?肯定得有至少一个人吧?现场一个人都没有,对吧?因为这会引发灾难,甚至抹掉所有数据。”他随后总结了核心洞察:“我们得出的重大认识是,运维智能体实际上必须常驻在数据平面(Data Plane)之内,它绝不能生活在数据平面之外。”
```mermaid flowchart TD accTitle: 传统编程智能体与数据运维需求的断层 accDescr: 对比传统编程智能体在软件工程中的能力与在数据运维中面临的代码加数据、生产验证及安全权限壁垒。
subgraph SE["软件工程场景 (通用 Coding Agent 擅长)"] A["自解释代码"] --> B["确定性单元测试"] B --> C["显式报错与快速回滚"] end
subgraph DE["数据工程运维 (现实挑战与权限死局)"] D["代码与海量动态数据交织"] --> E["统计学与概率性验证"] E --> F["静默故障与上下游级联污染"] F --> G{"外部 Agent 修复痛点"} G -->|"缺少遥测"| H["上下文溢出"] G -->|"缺乏血缘"| I["无法定位根因"] G -->|"需要读写生产数据"| J["严重安全风险 / 无法实地验证"] end ```
---
[12:34](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=754s) 全新发布 Genie ZeroOps:常驻数据平面的自主运维智能体
基于运维智能体必须内置于数据平面的核心洞察,Bilal Aslam 正式发布了 **Genie ZeroOps**——一个在后台常驻运行、将数据与 AI 运维全面自动化的 AI 智能体系统。由于直接生长在 Databricks 数据平面之内,Genie ZeroOps 天然坐拥数据访问权、血缘关系图谱以及 Unity Catalog 的完备治理边界。它将整个数据运维闭环划分为四个核心环节:
- **智能检测(Detection)**:无需用户手动搭建管道收集日志,Genie ZeroOps 会为每一张数据表自主构建机器学习模型并持续微调,原生接入全套指标、事件与系统日志。目前已有数万个此类模型在生产环境中平稳运行。 - **根因评估(Assessment & Root Cause)**:通过在 Unity Catalog 的数据血缘上执行图排序(Graph Ranking)算法向前与向后遍历。系统采用“主管智能体(Supervisor Agent)+ 子智能体集群”的协同架构,由子智能体分头调查并达成共识,最终精准锁定引发异常的最可能诱因。 - **协同修复(Remediation)**:与 Genie Code 深度配合,无缝对接企业的代码仓库、工单系统和版本控制工具,在运维全生命周期中自动更新工单。 - **零风险验证(Verification)**:依托 Databricks 湖仓近十年积累的底层能力,系统会利用类似 Lakebase 分支的技术,为生产数据创建极低成本、极速生成的**浅克隆(Shallow Clone)**,并在原生网络和代码隔离沙箱中运行修复补丁,彻底解决生产数据写入验证的安全隐患。
Bilal Aslam 充满信心地向全场宣布:“我非常非常激动地宣布 Genie ZeroOps,这是一款全新的后台 Genie,它能让你的数据和 AI 运维处于自动驾驶状态。”
---
[14:04](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=844s) 实机演示:故障聚合排查、浅克隆验证与敏感数据治理
在随后的实机演示中,Bilal 展示了 Genie ZeroOps 与众不同的工作界面。该系统彻底摒弃了传统运维仪表盘中密密麻麻的告警红灯和图表堆砌,而是采用了类似于“带优先级的电子邮件收件箱”设计。所有事故均按严重程度排列,避免告警风暴;同时具备自然事件聚类能力,例如将 16 个并发失败的作业自动归集为同一桩故障事件。
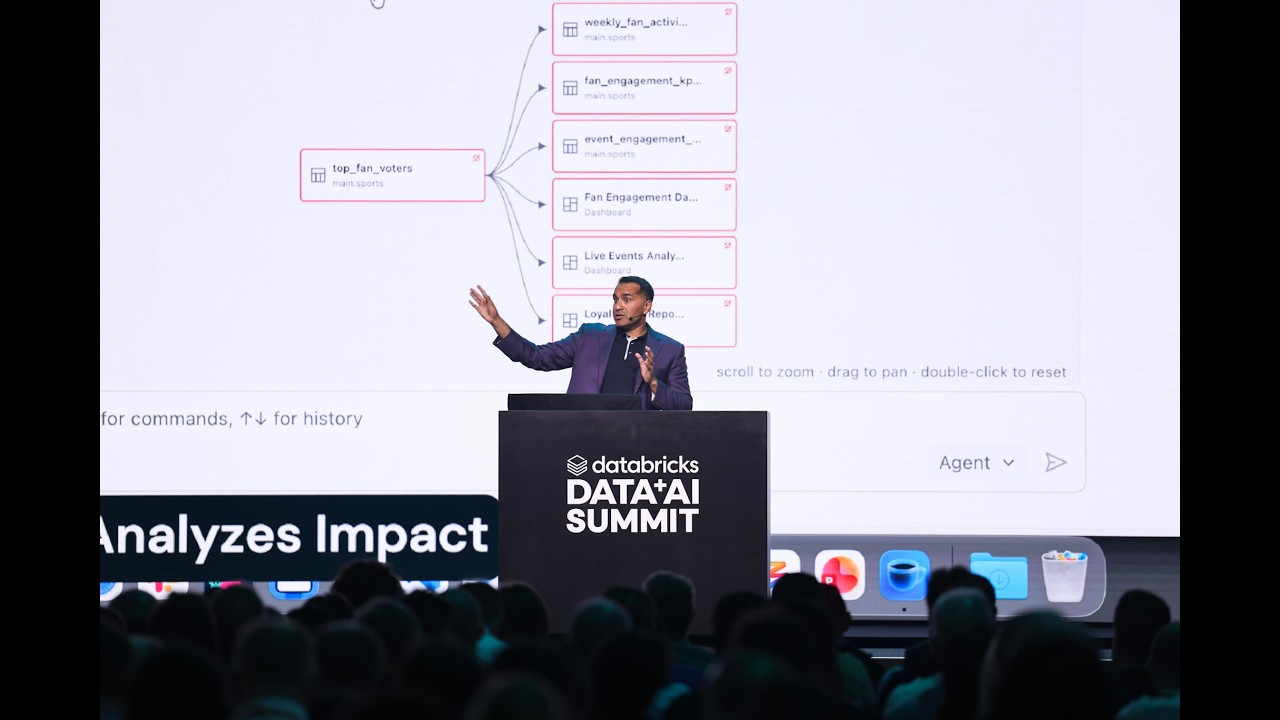
在具体的演示场景中,上游一张名为 `top_fan_voters` 的数据表在约 10 分钟前突发数据行数骤降。当数据工程师登录系统时,Genie ZeroOps 已经在后台完成了全套侦测与归因分析: 1. **影响面评估**:系统顺着数据血缘向下游排查,发现下游有数张关键业务表以及一个关键的“粉丝互动大屏(Fan Engagement Dashboard)”依赖该表,因此自动将该事故定级为严重(Critical)。 2. **多智能体溯源**:系统指派根因分析智能体沿 DAG 图向上游回溯搜索,在错综复杂的依赖中精准排除了其他干扰,锁定了真正出错的源头表——`fan_interactions`。 3. **沙箱与浅克隆验证**:在获得明确授权的前提下,系统自主编写了修复代码,并针对涉及数 PB 数据的生产环境极速创建了一份浅克隆分支。修复代码在隔离分支中完成回放并成功验证返回行数恢复正常,最后自动生成拉取请求(Pull Request),让工程师无缝衔接现有的代码审查与上线流程。
除了管道故障自愈,Bilal 还展示了 Genie ZeroOps 的主动治理能力:在获得权限后,系统会自主扫描数据资产以识别隐私合规风险。演示中,系统精准揪出了一起应用意外泄露约 1000 名用户 PII(个人身份信息)的严重隐患,生成了包含影响面与血缘追踪的报告,并主动开具了一份 Unity Catalog 访问策略修复方案(Policy Fix),只需一键应用即可完成权限封堵。
在演讲的尾声,Bilal Aslam 总结道,这种深度集成的数据自治能力将彻底重塑工程师的工作日常:“对于像我这样的数据工程师,希望对你们也是一样,这意味着用在构建上的时间少得多,用在系统维护上的时间少得多,从而有更多的时间在一个统一且简单的数据技术栈上进行创造。”
- 界面采用收件箱式的高优先级排序,自动实现 16 个底层失败作业的单故障聚合。 - 针对 `top_fan_voters` 表的行数异常,系统秒级识别下游看板的业务影响并将严重度置为最高。 - 验证环节完全基于 PB 级数据的浅克隆隔离环境,不改动真实生产数据即可确认修复逻辑的正确性。 - PII 自主扫描不仅能报告泄露范围,还能直接生成 Unity Catalog 的数据安全策略补丁替代传统硬编码。
## Notable quotes > [08:48](https://www.youtube.com/watch?v=0WDGu-IPmZM&t=528s) 运维智能体实际上必须常驻在数据平面(Data Plane)之内,它绝不能生活在数据平面之外。 — Bilal Aslam
## Mentioned Bilal Aslam, Ali Ghodsi, Mugesh, Arsalan, Kenan, Databricks, Lakeflow, Genie, Genie Code, Genie ZeroOps, Lakeflow Designer, Lakeflow Connect, Lakeflow Jobs, Zerobus Ingest, Unity Catalog, Delta Lakehouse, Apache Spark, Apache Kafka, Apache Airflow, Apache Flink, dbt, Snowflake, Salesforce, NetSuite, Oracle, SQL Server, AWS EMR, Python, SQL
## Video description Data engineering is a messy process, and the growth of AI apps and agents is adding more complexity. The data that AI needs is stored all over the enterprise.
Previously, companies had to rely on brittle, expensive pipelines to move this information. But Lakeflow make it easy to turn raw data stored in these systems into insights and action.
At the 2026 Data + AI Summit, Bilal Aslam, Sr. Director of Product Management at Databricks, shared updates to Lakeflow and introduced Genie ZeroOps, an AI agents for data and AI operations.
Learn more: https://www.databricks.com/blog/introducing-genie-zeroops
00:00 —Data engineering and the "messy middle" 02:21 — Simpliyfing the data stack 03:18 — Building an open data foundation for AI with Lakeflow 04:50 — Now available: Lakeflow Designer 05:40 — Lakeflow Connect's growing ecosystem 06:18 — Ditching Kafka with Zerobus Ingest 06:57 — Updates to Lakeflow Jobs 08:47 — Challenges to using AI in data operations 12:34 — Introducing Genie ZeroOps with live demo 17:23 — What Genie ZeroOps means for data engineers
Presenters: Bilal Aslam, Sr. Director of Product Management, Databricks
[Source](https://www.youtube.com/watch?v=0WDGu-IPmZM)