Databricks推存算分离Postgres 突破60万TPS并支持跨云容灾
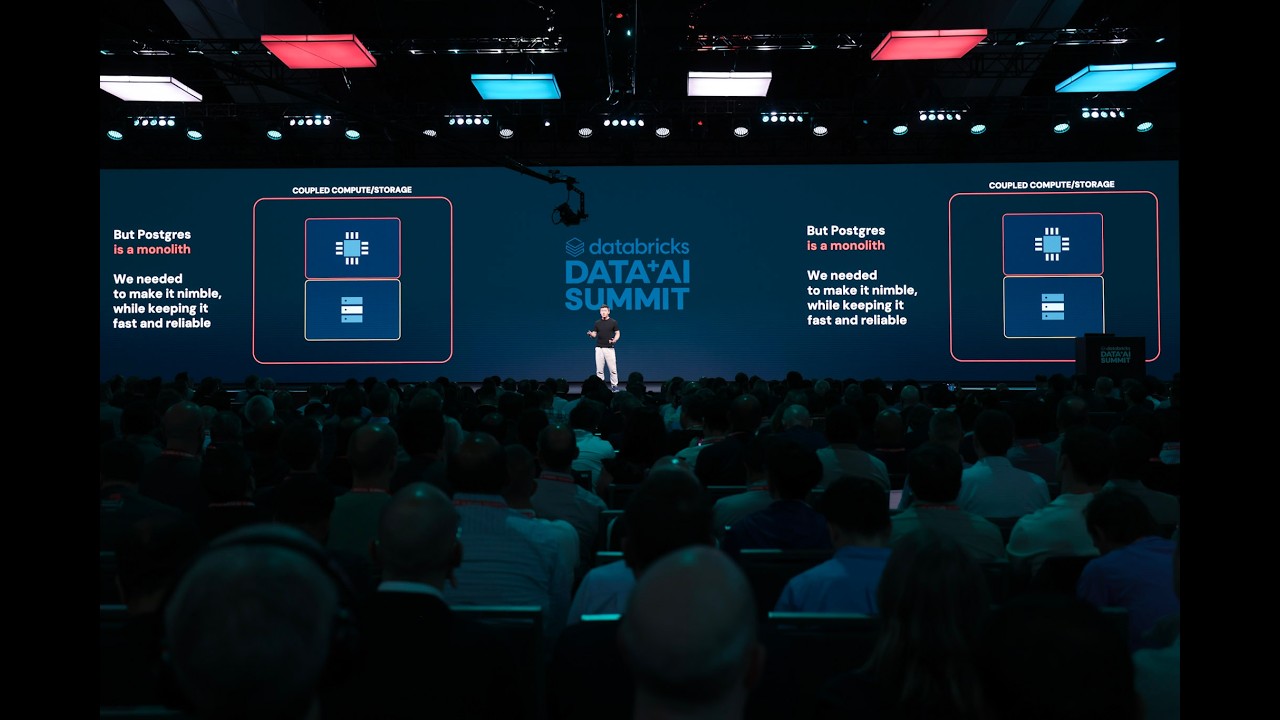
Inside Lakebase: fully-managed serverless Postgres – Nikita Shamgunov, VP, Engineering, Databricks — Databricks

Databricks

面对AI代码大爆发,将存储下沉至数据湖并解耦计算,是满足智能体秒级沙盒分支与承载超高并发交易的唯一解法。

AI-assisted summary of Inside Lakebase: fully-managed serverless Postgres – Nikita Shamgunov, VP, Engineering, Databricks — original source. Check the original for full context.

Source published:

Key ideas

  • Databricks 推出面向 AI 应用与智能体的完全托管 Serverless Postgres 数据库 Lakebase,重构底层存储架构并将数据下沉至数据湖。 (1:56)
  • Lakebase 实例就绪与逻辑分支创建耗时均缩短至 500 毫秒以内,并支持缩容至零与一键快照回滚,为智能体自动化开发与测试提供安全沙盒。 (3:45)
  • 在工业级 TPC-C 基准压测中,Lakebase 吞吐量突破 60 万次操作/秒(OPS),且事务延迟始终稳控在 10 毫秒以下,大幅超越主流公有云托管 Postgres 服务。 (6:03)
  • Lakebase 推出业界首个完全托管的跨云灾备(Cross-cloud DR)功能,支持在 AWS 与 Azure 之间实现瞬时故障转移,目前已被超过 3,500 家企业客户采用。 (7:27)

Detailed notes

## Background 该视频由 Databricks 官方频道于 2026 年 6 月 24 日发布在 YouTube 平台上。视频记录了在 Data + AI Summit 2026 大会上,Databricks 工程副总裁 Nikita Shamgunov 围绕 Lakebase 所做的专题演讲,介绍了为 AI 应用与智能体量身打造的全托管 Serverless Postgres 数据库及其架构重构与跨云容灾特性。

## TL;DR 随着 AI 自动生成代码带来软件开发规模的爆发式增长,底层数据库亟需兼具开源生态熟悉度、极速分支的敏捷性以及任务关键级的可靠承载力。为此,Databricks 针对单体 Postgres 实施了存算分离重构,引入 Safekeepers 和 Page servers 专有服务将存储层直接打通至数据湖,诞生了完全托管的 Serverless 数据库 Lakebase。该系统不仅支持低于 500 毫秒的实例秒启与分支创建、快照秒级回滚与自动缩容至零,更在工业级 TPC-C 测试中展现了突破 60 万 TPS 且延迟低于 10 毫秒的高并发吞吐能力。此外,Lakebase 推出了业界首个全托管跨云容灾方案,在发布短短一年内便已获得超过 3,500 家企业客户在生产环境中的深度采用。

## Atmosphere & style 整场演讲呈现出典型硅谷顶尖技术峰会自信、极客且务实的基调。主讲人 Nikita Shamgunov 谈吐从容坚定,以“未来一年生成的软件将超越人类历史总和”的宏大叙事开篇,迅速抓住全场注意力。随着系统架构图的抽丝剥茧与多厂商 TPC-C 严苛压测数据的对比展示,演讲层层递进,既有攻克底层存储工程难题的坦诚与厚重感,也有在跨云容灾特性公布时激发全场共鸣与掌声的澎湃高潮。

## Bulletin - [01:56](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=116s) Databricks 推出面向 AI 应用与智能体的完全托管 Serverless Postgres 数据库 Lakebase,重构底层存储架构并将数据下沉至数据湖。 - [03:45](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=225s) Lakebase 实例就绪与逻辑分支创建耗时均缩短至 500 毫秒以内,并支持缩容至零与一键快照回滚,为智能体自动化开发与测试提供安全沙盒。 - [06:03](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=363s) 在工业级 TPC-C 基准压测中,Lakebase 吞吐量突破 60 万次操作/秒(OPS),且事务延迟始终稳控在 10 毫秒以下,大幅超越主流公有云托管 Postgres 服务。 - [07:27](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=447s) Lakebase 推出业界首个完全托管的跨云灾备(Cross-cloud DR)功能,支持在 AWS 与 Azure 之间实现瞬时故障转移,目前已被超过 3,500 家企业客户采用。

## Key takeaways - [00:05](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=5s) AI 自动生成代码正引发软件产出量的指数级爆发,促使底层数据库必须针对自主智能体的工作流进行全面革新。 - [00:05](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=5s) 下一代 AI 数据库需具备三大核心支柱:智能体高熟悉度(开源生态)、开发敏捷性(Serverless 与快速分支)以及任务关键性(高可用与强事务)。 - [01:56](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=116s) Postgres 因其极高的人气与完善的生态成为智能体最精通的数据库,但其传统的单体(Monolith)紧耦合架构制约了敏捷性与弹性。 - [01:56](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=116s) Lakebase 实现了计算与存储彻底分离,将底层存储下沉至高性价比、无限扩展的数据湖对象存储中。 - [01:56](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=116s) 为解决数据湖高延迟与弱一致性问题,Lakebase 引入了基于 Paxos 协议保证低延迟写入的 Safekeepers,以及负责页面快速分发的 Page servers。 - [03:45](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=225s) Lakebase 实现 500 毫秒以内的冷启动,并提供自动缩容至零(Scale to Zero)机制,有效削减开发测试阶段的闲置总体拥有成本(TCO)。 - [03:45](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=225s) 提供 500 毫秒级的极速分支(Branching)与一键快照即刻回滚功能,允许智能体在独立沙盒内自由进行 Schema 迁移与代码测试而无惧故障。 - [03:45](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=225s) 在资源弹性方面,用户只需设定计算算力的上下限边界即可实现自动化横向扩缩容,且存储层依托数据湖获得原生无限容量,彻底免除运维扩容负担。 - [06:03](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=363s) 在 TPC-C 高并发基准测试中,传统知名公有云托管 Postgres 在 13 万至 35 万 OPS 附近即遭遇吞吐瓶颈或延迟飙升。 - [06:03](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=363s) Lakebase 在超 60 万 OPS 的极限压测下,依然能将每个操作的事务延迟严格压制在 10 毫秒以内,验证了其在海量高并发事务负载下的稳定性。 - [07:27](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=447s) 首创业界全托管跨云容灾方案,支持将主库置于 AWS、从库部署于 Azure,在遭遇单云区域性宕机事故时实现跨云无缝故障转移。 - [08:57](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=537s) 自推向市场仅一年时间,Lakebase 已获得超过 3,500 家企业客户深度采用并承载其核心生产业务。

## Detailed walkthrough ### [00:05](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=5s) AI 时代的软件大爆发与下一代数据库需求

随着人工智能的迅猛发展,软件工程正在经历一场深刻的范式转移——我们已经从人工手写代码进入了由 AI 自动生成代码的时代。回顾 2026 年前六个月的技术演进轨迹,Nikita Shamgunov 自信地断言,软件的产出速率已经突破了历史极值。然而,无论应用是由人类编写还是由智能体(Agents)自主构建,每一款应用程序依然离不开底层数据库的支撑。这就带来了一个根本性的核心问题:下一代 AI 应用程序和自主智能体,究竟需要什么样的数据库?

Nikita Shamgunov 指出,下一代数据库必须具备三个不可或缺的核心支柱:首先是“熟悉度”(Familiarity)。智能体之所以能够高效运行和维护软件系统,是因为它们在互联网、Stack Overflow 以及 Reddit 等社区中学习了海量公开知识;因此,数据库必须基于广受欢迎、生态成熟且高度可扩展的开源技术,从而使用户能够将主流和利基业务全部整合到单一平台之上。其次是“敏捷性”(Nimbleness)。面对 AI 生成的大量应用以及为每个代码提交(PR)拉起的无数开发、测试和预发布(Staging)环境,数据库必须具备无服务器化(Serverless)与极速分支能力,让智能体拥有安全可控的操作沙盒,同时在闲置时自动控制总体拥有成本(TCO)。最后是“任务关键性”(Mission-critical)。作为驱动核心业务的运营型数据库,它必须提供无限的扩展能力、极致的速度以及坚如磐石的可靠性。

Nikita Shamgunov 在演讲开场时强调: > “And now we can confidently say we're going to have more software generated in the next year than in the history of humanity.”

- **知识普及度**:开源与超高人气使得主流大模型及 AI 智能体天然精通该数据库的操作与故障排查。 - **环境敏捷化**:支撑高并发开发工作流,具备快速分支和无服务器弹性。 - **业务关键承载**:支撑 7x24 小时核心业务,满足无限扩展与低延迟读写。

---

[01:56](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=116s) 重构单体 Postgres:将存储搬上数据湖

基于上述三大要求,Databricks 选择以全球最先进的开源数据库 Postgres 为基石。Postgres 拥有全球最庞大的生态系统和丰富的扩展插件,几乎全网的所有智能体都熟练掌握其指令与机制。然而,原生 Postgres 是典型的单体架构(Monolith),计算与存储高度耦合。这种紧密绑定严重制约了数据库的弹性与敏捷度,要想彻底打破瓶颈,就必须对其底层架构进行重构。

Databricks 的核心构想是实现存算分离,并将存储层直接下沉到数据湖(Lake)中。但这一设想在工程实现上面临着巨大挑战:数据湖对象存储虽然具备极低成本和无限水平扩展的绝佳优势,但其原生特性却是读写延迟高、且缺乏强事务一致性保障。为了克服这一缺陷,工程团队重写了底层存储,并在计算节点与数据湖之间引入了两个专有核心服务: 1. **Safekeepers**:专为写入与事务一致性设计,通过实现 Paxos 共识协议,为上层提供超低延迟的持久化写入保证。 2. **Page servers**:专为读取加速设计,直接向 Postgres 计算节点按需分发页面,实现极低延迟的页面读取。

将这套全新的分布式存储层与数据湖无缝打通后,便诞生了 **Lakebase**——一个完全托管、基于数据湖构建的 Serverless Postgres 数据库。

```mermaid flowchart TD accTitle: Lakebase 存算分离架构 accDescr: 展示 Postgres 计算节点、Safekeepers、Page servers 与底层数据湖存储之间的协作关系

subgraph ComputeLayer["计算层"] Compute["Postgres 无服务器计算节点"] end

subgraph StorageEngine["Lakebase 专有存储引擎"] Safe["Safekeepers (Paxos 共识 / 低延迟写)"] Page["Page servers (页面分发 / 低延迟读)"] end

subgraph LakeLayer["湖存储层"] Lake[("数据湖 (廉价、无限扩展存储)")] end

Compute -->|"事务日志写入"| Safe Compute -->|"数据页请求"| Page Safe -->|"刷盘持久化"| Lake Page -->|"冷数据读取与同步"| Lake ```

Nikita Shamgunov 坦言重构存储的艰难历程: > “The main idea we had is we can decouple storage and compute and move storage into the lake. But it's actually, you know, much harder than you might think.”

---

[03:45](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=225s) 面向智能体的革命性特性:分支、快照与弹性伸缩

全新的存算分离架构赋予了 Lakebase 极其敏捷的生命周期管理能力。在部署与准备速度方面,Lakebase 可以在 500 毫秒以内完成一个 Postgres 实例的供应启动。针对开发者或 CI/CD 流程中为每一个 GitHub Pull Request(PR)动态生成的繁杂环境,Lakebase 支持自动缩容至零(Scale to Zero),在环境闲置时自动关机以极致降低客户的 TCO。

针对智能体软件开发,Lakebase 还推出了两项颠覆性的操作范式: - **极速数据库分支(Branching)**:数据库同样可以在约 500 毫秒内完成逻辑分支分裂,开发者或系统可以秒级拉出真实的 Dev、Test 或 Staging 沙盒,供智能体无拘无束地运行探索,完全不会影响主库生产环境。 - **一键快照与即刻回滚(Snapshot Restore)**:通过简单的图形界面点击或 API 调用,用户可以在智能体动手前为数据库创建快照。智能体随后可以大刀阔斧地编写代码、迁移 Schema、修改或灌入数据。一旦测试结果符合预期,改动即可继续推进;如果不合心意,则可以通过快照实现瞬间回滚(Instant Rollback)。

在弹性扩展方面,Lakebase 摆脱了传统数据库繁琐的手动扩容步骤。用户只需设定计算资源的“误差范围”(Error bars),即最低与最高计算算力边界以控制成本,系统便会在白天高峰期自动横向扩容,并在夜间或周末自动缩容。而在存储端,得益于底层的数据湖架构,存储具备真正的无限扩展性,运维人员永远不必再担心磁盘空间耗尽,也无需再执行繁重的人工扩容运维任务。

- **实例就绪耗时**:低于 500 毫秒。 - **分支创建耗时**:约 500 毫秒。 - **自动休眠机制**:闲置时主动缩容至零以控制计算成本。 - **存储维护负担**:数据湖原生承载,免除一切磁盘容量预警与维护动作。

---

[06:03](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=363s) 突破极限:TPC-C 60 万 TPS 高并发性能实测

在存储层换用分布式与数据湖架构后,业内普遍对数据库的性能表现存疑:它真的够快吗?能否抗衡主流公有云的云原生 Postgres 托管服务?Nikita Shamgunov 展示了采用工业级标准测试基准 TPC-C 的严苛压测数据。与通常查询较重的大数据分析系统不同,OLTP 事务型系统由海量小型查询构成,考验的是极高并发下的极限吞吐与延迟表现。

压测结果显示,某知名流行公有云厂商的原生托管 Postgres 在吞吐量达到约 13 万次操作/秒(OPS)时便已达到承载极限(Tap out);另一家采用了演进架构的知名云厂商,虽然成功将吞吐量推升至约 35 万次操作/秒,但随后延迟出现了剧烈飙升,系统性能断崖式下滑。

相比之下,经过深度工程优化的 Lakebase 展现出了惊人的吞吐与稳定性表现。即便在吞吐量突破 600,000 operations per second(60 万次操作/秒)的超高负载下,Lakebase 仍然能将每一个操作的事务延迟稳稳压制在 10 毫秒以内。

| 数据库 / 厂商平台 | 极限吞吐瓶颈 (TPS / OPS) | 高压下的延迟表现 | |:--- |:--- |:--- | | **知名云厂商 A** | ~130,000 ops/s | 达到吞吐瓶颈后无法继续承载负载 | | **架构改进型云厂商 B** | ~350,000 ops/s | 突破 35 万后延迟开始出现严重尖峰 | | **Databricks Lakebase** | **> 600,000 ops/s** | **全流程事务延迟始终保持在 10 毫秒以下** |

Nikita Shamgunov 自豪地宣布: > “Lake Base can scale under 10 milliseconds for each transaction for each operation all the way north of 600,000 operations per second.”

---

[07:27](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=447s) 首创全托管跨云容灾与业务势头

对于真正承载核心业务的 Mission-critical 数据库而言,除了性能,还必须覆盖完善的企业级功能:企业安全合规、静态与传输加密等能力在 Lakebase 中一应俱全。在此基础上,Nikita Shamgunov 隆重推出了 Databricks 凭借独特跨云架构才能实现的重磅能力——业界首个完全托管的跨云容灾方案(Fully-managed Cross-cloud Disaster Recovery)。

Nikita 坦言,公有云底层故障虽然不常发生,但一旦发生,对全面依赖 AI 和智能体自动化运转的现代企业来说往往是毁灭性的打击。Lakebase 彻底打破了单一云提供商的锁定与依赖:用户可以将 Lakebase 主集群部署在 AWS 美西区域(US West),同时在微软 Azure 美东区域(US East)实时维护一套灾备副本。一旦 AWS 遭遇区域性重大宕机事故,系统可以瞬间执行跨云故障转移(Failover)至 Azure,保障企业业务连续平稳运行,完全不会发生中断。这一特性的发布引发了现场热烈的掌声。

Nikita Shamgunov 在介绍该架构时强调: > “And in the case of AWS outage, you can instantly fail over from one cloud to another and continue your uninterrupted business operations.”

在演讲尾声,Nikita 透露了 Lakebase 的高速增长轨迹:虽然从推向市场至今仅仅过去了一年时间,但 Lakebase 凭借存算分离、面向 AI 时代的敏捷机制以及跨云高可用能力,已经赢得了超过 3,500 家企业客户的深度信任,全面承载着他们至关重要的核心生产负载。

## Notable quotes > [00:05](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=5s) And now we can confidently say we're going to have more software generated in the next year than in the history of humanity. — Nikita Shamgunov

## Mentioned Nikita Shamgunov, Databricks, Lakebase, Postgres, Stack Overflow, Reddit, Safekeepers, Page servers, Paxos, GitHub, TPC-C, AWS, Microsoft Azure

## Video description More software will be built in the next year than throughout the whole history of humanity. And every one of these new systems requires an database designed for AI.

It's why Databricks built Lakebase, a fully-managed, serverless Postgres database for AI apps and agents. At Data + AI Summit 2026, Nikita Shamgunov, VP, Engineering of Databricks, explained how the team re-architected Postgres and outlined the features that help Lakebase out perform industry rivals, including the first fully-managed cloud disaster recovery.

00:00 — How AI is changing software development 01:56 — The pros and cons of Postgres 02:28 — Re-architecting Postgres 03:45 — The transformative power of Lakebase 07:27 — Why Lakebase is ready for any workload 07:44 — The first fully-managed cloud DR 08:57 — Lakebase momentum

[Source](https://www.youtube.com/watch?v=NqJIyP9rIW8)

中文简报

Databricks推出具备跨云故障转移能力的无服务器Postgres 将Postgres计算与数据湖存储解耦,对于提供自主AI智能体所需的亚秒级分支和自动化跨云容灾至关重要。 为应对AI生成软件的激增,Nikita Shamgunov推出了Lakebase,这是一款专为现代智能体和关键业务企业工作负载量身定制的存算分离无服务器Postgres数据库。Databricks通过构建由数据湖存储支持的中间共识Safekeeper节点和页面服务节点,将Postgres计算与存储分离,从而实现了低于500毫秒的配置开通、缩容至零、即时分支以及快速快照恢复。在TPC-C基准测试中,Lakebase以低于10毫秒的延迟维持了超过每秒60万次的操作,性能明显超越传统云竞争对手。该系统还引入了全托管跨云容灾功能,支持在AWS和Azure等主流云服务商之间实现无缝故障转移。 Databricks推出了全托管无服务器Postgres平台Lakebase,通过将计算与湖存储解耦,旨在为AI生成应用和自主智能体的爆发式增长提供支持。 (1:53) 为克服对象存储湖固有的延迟与一致性限制,Lakebase将中间存储划分为用于写入的Paxos驱动Safekeeper节点,以及用于读取的低延迟Page Server节点。 (1:53) 该平台可在500毫秒内完成计算实例配置和完整数据库分支,并具备自动缩容至零以及用于智能体沙盒环境的即时快照回滚功能。 (3:44) 在TPC-C基准测试中,Lakebase以低于10毫秒的延迟维持了每秒超过60万次的操作,轻松领先主流传统云数据库。 (6:03) Lakebase引入了在AWS与Azure等供应商之间运行的全托管跨云容灾功能,第一年内企业客户数量已突破3500家。 (7:44)

精炼阅读摘要

Databricks工程副总裁Nikita Shamgunov指出,随着AI自动生成代码的普及,下一代AI应用与智能体对底层数据库提出了高熟悉度、敏捷性与关键业务可靠性的严苛需求;为此,Databricks推出了存算分离的托管式Serverless Postgres产品Lakebase。 AI智能体驱动的新数据库需求 (0:05) 软件开发正经历向AI自动生成代码的根本性转变。Nikita Shamgunov在2026年初表示,来年AI生成的软件总量可能超过人类历史上的总和,但这波软件浪潮仍离不开底层数据库的支撑。下一代AI应用和自主智能体对运行型数据库提出了三项核心要求:一是熟悉度,智能体通过抓取公开技术论坛训练而成,对开源且普及广泛的平台理解更深,因而组织需要采用易于扩展并能整合多种负载的标准数据库;二是敏捷性,为应对AI密集生成应用所带来的海量测试与开发环境,数据库必须支持全Serverless架构、秒级分支与严格的成本控制;三是关键业务级别的可靠性,必须提供低延迟、无限扩展与企业级高可用能力。 基于数据湖重构的存算分离架构 (1:53) 为契合上述需求,Databricks选择以PostgreSQL为核心基础,但传统Postgres的单体架构紧密耦合了计算与存储,难以满足云原生环境的灵活性要求。Databricks将计算与存储完全解耦,并将持久化层直接迁移至数据湖存储中。由于数据湖存储成本低且易扩展,但在天然属性上面临读写缓慢与事务一致性不足的缺陷,Lakebase引入了两个专用的中间服务层以兼顾ACID事务保证:其一是Safekeepers写路径共识节点,基于Paxos共识协议保障低延迟写入与严格一致性;其二是Page Servers读路径缓存与检索节点,负责向Postgres计算实例极低延迟地提供请求的数据页。这一架构组合构成了Lakebase的核心支撑。 面向AI工作流的极致弹性与沙箱机制 (3:44) 解耦设计赋予了Lakebase针对智能体工作流的运维管控能力。系统可在500毫秒内启动并提供Postgres计算实例,并在闲置时自动缩容至零,以抑制因GitHub拉取请求频繁创建临时环境而带来的云成本失控。针对智能体频繁测试的需求,Lakebase支持在500毫秒内完成数据库即时分支,便于工程师或智能体快速建立隔离的沙箱环境。同时,开发人员在将任务交予智能体前,可通过单次API调用或点击完成即时快照,一旦智能体破坏了数据模式或写入异常数据,可随时秒级回滚到快照状态。在容量管理上,管理员仅需设定计算资源的上下限防护栏,系统便会随流量高低自动伸缩,而底层的湖存储则免去了传统的手动磁盘扩容与容量告警流程。 并发性能基准与跨云容灾能力 (6:03) 在面向高并发、低延迟小查询的TPC-C标准行业基准测试中,Lakebase展现出显著优于传统云厂商数据库的性能。测试数据显示,某云厂商1在达到每分钟约13万次操作时即触及瓶颈,云厂商2在达到每秒约35万次操作后延迟出现剧烈飙升,而Databricks Lakebase在操作规模超过每秒60万次的情况下,事务延迟仍能保持在10毫秒以内。为防范单云故障导致业务瘫痪,Lakebase还推出了完全托管的跨云灾难恢复能力,支持用户在AWS美西建立主实例并在Azure美东部署活跃副本,遇故障时可瞬时切换至另一云服务商。据Shamgunov介绍,Lakebase在推出一年内已有超过3,500家企业客户将其部署于生产负载。 Lakebase通过将Postgres计算与数据湖存储解耦并辅以共识及缓存服务,解决了AI代码爆发期应用对沙箱隔离、自动缩容与跨云高可用的需求;不过,其实际大规模落地效果仍取决于企业在复杂混合云与跨云环境下的长期网络成本与协同治理。

Detailed notes — zh

## Background 该视频由 Databricks 官方频道于 2026 年 6 月 24 日发布在 YouTube 平台上。视频记录了在 Data + AI Summit 2026 大会上,Databricks 工程副总裁 Nikita Shamgunov 围绕 Lakebase 所做的专题演讲,介绍了为 AI 应用与智能体量身打造的全托管 Serverless Postgres 数据库及其架构重构与跨云容灾特性。 ## TL;DR 随着 AI 自动生成代码带来软件开发规模的爆发式增长,底层数据库亟需兼具开源生态熟悉度、极速分支的敏捷性以及任务关键级的可靠承载力。为此,Databricks 针对单体 Postgres 实施了存算分离重构,引入 Safekeepers 和 Page servers 专有服务将存储层直接打通至数据湖,诞生了完全托管的 Serverless 数据库 Lakebase。该系统不仅支持低于 500 毫秒的实例秒启与分支创建、快照秒级回滚与自动缩容至零,更在工业级 TPC-C 测试中展现了突破 60 万 TPS 且延迟低于 10 毫秒的高并发吞吐能力。此外,Lakebase 推出了业界首个全托管跨云容灾方案,在发布短短一年内便已获得超过 3,500 家企业客户在生产环境中的深度采用。 ## Atmosphere & style 整场演讲呈现出典型硅谷顶尖技术峰会自信、极客且务实的基调。主讲人 Nikita Shamgunov 谈吐从容坚定,以“未来一年生成的软件将超越人类历史总和”的宏大叙事开篇,迅速抓住全场注意力。随着系统架构图的抽丝剥茧与多厂商 TPC-C 严苛压测数据的对比展示,演讲层层递进,既有攻克底层存储工程难题的坦诚与厚重感,也有在跨云容灾特性公布时激发全场共鸣与掌声的澎湃高潮。 ## Bulletin - [01:56](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=116s) Databricks 推出面向 AI 应用与智能体的完全托管 Serverless Postgres 数据库 Lakebase,重构底层存储架构并将数据下沉至数据湖。 - [03:45](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=225s) Lakebase 实例就绪与逻辑分支创建耗时均缩短至 500 毫秒以内,并支持缩容至零与一键快照回滚,为智能体自动化开发与测试提供安全沙盒。 - [06:03](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=363s) 在工业级 TPC-C 基准压测中,Lakebase 吞吐量突破 60 万次操作/秒(OPS),且事务延迟始终稳控在 10 毫秒以下,大幅超越主流公有云托管 Postgres 服务。 - [07:27](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=447s) Lakebase 推出业界首个完全托管的跨云灾备(Cross-cloud DR)功能,支持在 AWS 与 Azure 之间实现瞬时故障转移,目前已被超过 3,500 家企业客户采用。 ## Key takeaways - [00:05](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=5s) AI 自动生成代码正引发软件产出量的指数级爆发,促使底层数据库必须针对自主智能体的工作流进行全面革新。 - [00:05](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=5s) 下一代 AI 数据库需具备三大核心支柱:智能体高熟悉度(开源生态)、开发敏捷性(Serverless 与快速分支)以及任务关键性(高可用与强事务)。 - [01:56](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=116s) Postgres 因其极高的人气与完善的生态成为智能体最精通的数据库,但其传统的单体(Monolith)紧耦合架构制约了敏捷性与弹性。 - [01:56](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=116s) Lakebase 实现了计算与存储彻底分离,将底层存储下沉至高性价比、无限扩展的数据湖对象存储中。 - [01:56](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=116s) 为解决数据湖高延迟与弱一致性问题,Lakebase 引入了基于 Paxos 协议保证低延迟写入的 Safekeepers,以及负责页面快速分发的 Page servers。 - [03:45](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=225s) Lakebase 实现 500 毫秒以内的冷启动,并提供自动缩容至零(Scale to Zero)机制,有效削减开发测试阶段的闲置总体拥有成本(TCO)。 - [03:45](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=225s) 提供 500 毫秒级的极速分支(Branching)与一键快照即刻回滚功能,允许智能体在独立沙盒内自由进行 Schema 迁移与代码测试而无惧故障。 - [03:45](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=225s) 在资源弹性方面,用户只需设定计算算力的上下限边界即可实现自动化横向扩缩容,且存储层依托数据湖获得原生无限容量,彻底免除运维扩容负担。 - [06:03](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=363s) 在 TPC-C 高并发基准测试中,传统知名公有云托管 Postgres 在 13 万至 35 万 OPS 附近即遭遇吞吐瓶颈或延迟飙升。 - [06:03](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=363s) Lakebase 在超 60 万 OPS 的极限压测下,依然能将每个操作的事务延迟严格压制在 10 毫秒以内,验证了其在海量高并发事务负载下的稳定性。 - [07:27](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=447s) 首创业界全托管跨云容灾方案,支持将主库置于 AWS、从库部署于 Azure,在遭遇单云区域性宕机事故时实现跨云无缝故障转移。 - [08:57](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=537s) 自推向市场仅一年时间,Lakebase 已获得超过 3,500 家企业客户深度采用并承载其核心生产业务。 ## Detailed walkthrough ### [00:05](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=5s) AI 时代的软件大爆发与下一代数据库需求 随着人工智能的迅猛发展,软件工程正在经历一场深刻的范式转移——我们已经从人工手写代码进入了由 AI 自动生成代码的时代。回顾 2026 年前六个月的技术演进轨迹,Nikita Shamgunov 自信地断言,软件的产出速率已经突破了历史极值。然而,无论应用是由人类编写还是由智能体(Agents)自主构建,每一款应用程序依然离不开底层数据库的支撑。这就带来了一个根本性的核心问题:下一代 AI 应用程序和自主智能体,究竟需要什么样的数据库? Nikita Shamgunov 指出,下一代数据库必须具备三个不可或缺的核心支柱:首先是“熟悉度”(Familiarity)。智能体之所以能够高效运行和维护软件系统,是因为它们在互联网、Stack Overflow 以及 Reddit 等社区中学习了海量公开知识;因此,数据库必须基于广受欢迎、生态成熟且高度可扩展的开源技术,从而使用户能够将主流和利基业务全部整合到单一平台之上。其次是“敏捷性”(Nimbleness)。面对 AI 生成的大量应用以及为每个代码提交(PR)拉起的无数开发、测试和预发布(Staging)环境,数据库必须具备无服务器化(Serverless)与极速分支能力,让智能体拥有安全可控的操作沙盒,同时在闲置时自动控制总体拥有成本(TCO)。最后是“任务关键性”(Mission-critical)。作为驱动核心业务的运营型数据库,它必须提供无限的扩展能力、极致的速度以及坚如磐石的可靠性。 Nikita Shamgunov 在演讲开场时强调: > “And now we can confidently say we're going to have more software generated in the next year than in the history of humanity.” - **知识普及度**:开源与超高人气使得主流大模型及 AI 智能体天然精通该数据库的操作与故障排查。 - **环境敏捷化**:支撑高并发开发工作流,具备快速分支和无服务器弹性。 - **业务关键承载**:支撑 7x24 小时核心业务,满足无限扩展与低延迟读写。 --- ### [01:56](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=116s) 重构单体 Postgres:将存储搬上数据湖 基于上述三大要求,Databricks 选择以全球最先进的开源数据库 Postgres 为基石。Postgres 拥有全球最庞大的生态系统和丰富的扩展插件,几乎全网的所有智能体都熟练掌握其指令与机制。然而,原生 Postgres 是典型的单体架构(Monolith),计算与存储高度耦合。这种紧密绑定严重制约了数据库的弹性与敏捷度,要想彻底打破瓶颈,就必须对其底层架构进行重构。 Databricks 的核心构想是实现存算分离,并将存储层直接下沉到数据湖(Lake)中。但这一设想在工程实现上面临着巨大挑战:数据湖对象存储虽然具备极低成本和无限水平扩展的绝佳优势,但其原生特性却是读写延迟高、且缺乏强事务一致性保障。为了克服这一缺陷,工程团队重写了底层存储,并在计算节点与数据湖之间引入了两个专有核心服务: 1. **Safekeepers**:专为写入与事务一致性设计,通过实现 Paxos 共识协议,为上层提供超低延迟的持久化写入保证。 2. **Page servers**:专为读取加速设计,直接向 Postgres 计算节点按需分发页面,实现极低延迟的页面读取。 将这套全新的分布式存储层与数据湖无缝打通后,便诞生了 **Lakebase**——一个完全托管、基于数据湖构建的 Serverless Postgres 数据库。 ```mermaid flowchart TD accTitle: Lakebase 存算分离架构 accDescr: 展示 Postgres 计算节点、Safekeepers、Page servers 与底层数据湖存储之间的协作关系 subgraph ComputeLayer["计算层"] Compute["Postgres 无服务器计算节点"] end subgraph StorageEngine["Lakebase 专有存储引擎"] Safe["Safekeepers (Paxos 共识 / 低延迟写)"] Page["Page servers (页面分发 / 低延迟读)"] end subgraph LakeLayer["湖存储层"] Lake[("数据湖 (廉价、无限扩展存储)")] end Compute -->|"事务日志写入"| Safe Compute -->|"数据页请求"| Page Safe -->|"刷盘持久化"| Lake Page -->|"冷数据读取与同步"| Lake ``` Nikita Shamgunov 坦言重构存储的艰难历程: > “The main idea we had is we can decouple storage and compute and move storage into the lake. But it's actually, you know, much harder than you might think.” --- ### [03:45](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=225s) 面向智能体的革命性特性:分支、快照与弹性伸缩 全新的存算分离架构赋予了 Lakebase 极其敏捷的生命周期管理能力。在部署与准备速度方面,Lakebase 可以在 500 毫秒以内完成一个 Postgres 实例的供应启动。针对开发者或 CI/CD 流程中为每一个 GitHub Pull Request(PR)动态生成的繁杂环境,Lakebase 支持自动缩容至零(Scale to Zero),在环境闲置时自动关机以极致降低客户的 TCO。 针对智能体软件开发,Lakebase 还推出了两项颠覆性的操作范式: - **极速数据库分支(Branching)**:数据库同样可以在约 500 毫秒内完成逻辑分支分裂,开发者或系统可以秒级拉出真实的 Dev、Test 或 Staging 沙盒,供智能体无拘无束地运行探索,完全不会影响主库生产环境。 - **一键快照与即刻回滚(Snapshot Restore)**:通过简单的图形界面点击或 API 调用,用户可以在智能体动手前为数据库创建快照。智能体随后可以大刀阔斧地编写代码、迁移 Schema、修改或灌入数据。一旦测试结果符合预期,改动即可继续推进;如果不合心意,则可以通过快照实现瞬间回滚(Instant Rollback)。 在弹性扩展方面,Lakebase 摆脱了传统数据库繁琐的手动扩容步骤。用户只需设定计算资源的“误差范围”(Error bars),即最低与最高计算算力边界以控制成本,系统便会在白天高峰期自动横向扩容,并在夜间或周末自动缩容。而在存储端,得益于底层的数据湖架构,存储具备真正的无限扩展性,运维人员永远不必再担心磁盘空间耗尽,也无需再执行繁重的人工扩容运维任务。 - **实例就绪耗时**:低于 500 毫秒。 - **分支创建耗时**:约 500 毫秒。 - **自动休眠机制**:闲置时主动缩容至零以控制计算成本。 - **存储维护负担**:数据湖原生承载,免除一切磁盘容量预警与维护动作。 --- ### [06:03](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=363s) 突破极限:TPC-C 60 万 TPS 高并发性能实测 在存储层换用分布式与数据湖架构后,业内普遍对数据库的性能表现存疑:它真的够快吗?能否抗衡主流公有云的云原生 Postgres 托管服务?Nikita Shamgunov 展示了采用工业级标准测试基准 TPC-C 的严苛压测数据。与通常查询较重的大数据分析系统不同,OLTP 事务型系统由海量小型查询构成,考验的是极高并发下的极限吞吐与延迟表现。 压测结果显示,某知名流行公有云厂商的原生托管 Postgres 在吞吐量达到约 13 万次操作/秒(OPS)时便已达到承载极限(Tap out);另一家采用了演进架构的知名云厂商,虽然成功将吞吐量推升至约 35 万次操作/秒,但随后延迟出现了剧烈飙升,系统性能断崖式下滑。 相比之下,经过深度工程优化的 Lakebase 展现出了惊人的吞吐与稳定性表现。即便在吞吐量突破 600,000 operations per second(60 万次操作/秒)的超高负载下,Lakebase 仍然能将每一个操作的事务延迟稳稳压制在 10 毫秒以内。 | 数据库 / 厂商平台 | 极限吞吐瓶颈 (TPS / OPS) | 高压下的延迟表现 | |:--- |:--- |:--- | | **知名云厂商 A** | ~130,000 ops/s | 达到吞吐瓶颈后无法继续承载负载 | | **架构改进型云厂商 B** | ~350,000 ops/s | 突破 35 万后延迟开始出现严重尖峰 | | **Databricks Lakebase** | **> 600,000 ops/s** | **全流程事务延迟始终保持在 10 毫秒以下** | Nikita Shamgunov 自豪地宣布: > “Lake Base can scale under 10 milliseconds for each transaction for each operation all the way north of 600,000 operations per second.” --- ### [07:27](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=447s) 首创全托管跨云容灾与业务势头 对于真正承载核心业务的 Mission-critical 数据库而言,除了性能,还必须覆盖完善的企业级功能:企业安全合规、静态与传输加密等能力在 Lakebase 中一应俱全。在此基础上,Nikita Shamgunov 隆重推出了 Databricks 凭借独特跨云架构才能实现的重磅能力——业界首个完全托管的跨云容灾方案(Fully-managed Cross-cloud Disaster Recovery)。 Nikita 坦言,公有云底层故障虽然不常发生,但一旦发生,对全面依赖 AI 和智能体自动化运转的现代企业来说往往是毁灭性的打击。Lakebase 彻底打破了单一云提供商的锁定与依赖:用户可以将 Lakebase 主集群部署在 AWS 美西区域(US West),同时在微软 Azure 美东区域(US East)实时维护一套灾备副本。一旦 AWS 遭遇区域性重大宕机事故,系统可以瞬间执行跨云故障转移(Failover)至 Azure,保障企业业务连续平稳运行,完全不会发生中断。这一特性的发布引发了现场热烈的掌声。 Nikita Shamgunov 在介绍该架构时强调: > “And in the case of AWS outage, you can instantly fail over from one cloud to another and continue your uninterrupted business operations.” 在演讲尾声,Nikita 透露了 Lakebase 的高速增长轨迹:虽然从推向市场至今仅仅过去了一年时间,但 Lakebase 凭借存算分离、面向 AI 时代的敏捷机制以及跨云高可用能力,已经赢得了超过 3,500 家企业客户的深度信任,全面承载着他们至关重要的核心生产负载。 ## Notable quotes > [00:05](https://www.youtube.com/watch?v=NqJIyP9rIW8&t=5s) And now we can confidently say we're going to have more software generated in the next year than in the history of humanity. — Nikita Shamgunov ## Mentioned Nikita Shamgunov, Databricks, Lakebase, Postgres, Stack Overflow, Reddit, Safekeepers, Page servers, Paxos, GitHub, TPC-C, AWS, Microsoft Azure ## Video description More software will be built in the next year than throughout the whole history of humanity. And every one of these new systems requires an database designed for AI. It's why Databricks built Lakebase, a fully-managed, serverless Postgres database for AI apps and agents. At Data + AI Summit 2026, Nikita Shamgunov, VP, Engineering of Databricks, explained how the team re-architected Postgres and outlined the features that help Lakebase out perform industry rivals, including the first fully-managed cloud disaster recovery. 00:00 — How AI is changing software development 01:56 — The pros and cons of Postgres 02:28 — Re-architecting Postgres 03:45 — The transformative power of Lakebase 07:27 — Why Lakebase is ready for any workload 07:44 — The first fully-managed cloud DR 08:57 — Lakebase momentum [Source](https://www.youtube.com/watch?v=NqJIyP9rIW8)

Source quotes

[0:05] Nikita Shamgunov: And now we can confidently say we're going to have more software generated in the next year than in the history of humanity.