Rob Pike重构Go标准库模板 弃用正则改以状态函数分词
Lexical Scanning in Go - Rob Pike — GoogleFOSSSydney

GoogleFOSSSydney

并发本质上是解耦控制流的设计手段而非单纯追求并行,通过自引用的递归状态函数替代复杂状态机与正则匹配,既能实现输入文本零拷贝分词,又能消除包初始化阶段的调度死锁。

AI-assisted summary of Lexical Scanning in Go - Rob Pike — original source. Check the original for full context.

Source published:

Key ideas

  • Rob Pike 提出利用 Go 语言的状态函数与递归类型定义(`type stateFn func(*lexer) stateFn`)替代传统的庞大 switch 语句,使词法分析器的主循环精简至单行代码。 (11:46)
  • 词法分析器最初被设计为与解析器并行的协程(goroutine),通过 channel 进行类似 Unix 管道的单向通信,从架构上解耦了输入缓冲与解析控制流。 (15:41)
  • 由于 Go 规范严禁在包初始化(`init`)阶段等待并发 goroutine 完成,团队通过带缓冲 channel 与 select-default 轮询机制,在不破坏状态机架构的前提下将并发逻辑改造成同步的 `nextItem` API。 (33:39)
  • 整个词法扫描过程对输入文本实现了零内存拷贝,所有向解析器传递的词法项(item)均直接复用底层输入字符串的切片(slice)。 (44:32)

Detailed notes

## Background 该视频由 YouTube 频道 GoogleFOSSSydney 于 2011 年 8 月 30 日发布。内容为 Rob Pike 在悉尼 Google 技术用户组(GTUG)聚会上的技术演讲,主题是介绍 Go 语言中一种基于状态函数与并发模型构建的新型词法扫描器(Lexical Scanning in Go)。

## TL;DR Rob Pike 深入探讨了编译器前端中常见的“结构不匹配”问题,并批判了传统词法生成工具(如 Lex)和正则表达式在分词任务中的局限与冗余。他展示了 Go 标准库重构模板系统时采用的一种极简方案:将状态与动作统一为递归类型定义的状态函数(`stateFn`),使主循环收敛为单行代码,并通过 Goroutine 与 Channel 优雅解耦词法分析器与语法解析器。针对 Go 包初始化期间禁止后台 Goroutine 运行的死锁问题,他进一步利用 Channel 缓冲与 `select` 语句将并发逻辑无缝收拢为传统的 `nextItem` API。最后,演讲强调并发不仅关乎并行性能,更是理顺程序控制流与消除样板代码的强大设计思维。

## Atmosphere & style 现场氛围亲切、松弛且洋溢着浓厚的极客幽默,Rob Pike 举重若轻地在白板式的幻灯片前拆解复杂的编译器概念。他的讲解风格直率而富有洞察力,既有对早期粗糙实现的坦诚自嘲,也有对正则表达式滥用者的风趣调侃,令台下的技术受众不时报以会心笑声。整场演讲兼具底层架构的严谨推演与语言哲学的写意表达,最后因真实的日程冲突在略显匆忙却热烈掌声中戛然而止,真实感与启发性拉满。

## Bulletin - [11:46](https://www.youtube.com/watch?v=HxaD_trXwRE&t=706s) Rob Pike 提出利用 Go 语言的状态函数与递归类型定义(`type stateFn func(*lexer) stateFn`)替代传统的庞大 switch 语句,使词法分析器的主循环精简至单行代码。 - [15:41](https://www.youtube.com/watch?v=HxaD_trXwRE&t=941s) 词法分析器最初被设计为与解析器并行的协程(goroutine),通过 channel 进行类似 Unix 管道的单向通信,从架构上解耦了输入缓冲与解析控制流。 - [33:39](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2019s) 由于 Go 规范严禁在包初始化(`init`)阶段等待并发 goroutine 完成,团队通过带缓冲 channel 与 select-default 轮询机制,在不破坏状态机架构的前提下将并发逻辑改造成同步的 `nextItem` API。 - [44:32](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2672s) 整个词法扫描过程对输入文本实现了零内存拷贝,所有向解析器传递的词法项(item)均直接复用底层输入字符串的切片(slice)。

## Key takeaways - [00:02](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2s) 协程(Coroutines)的历史初衷正是为了解决控制流与数据块之间的“结构不匹配(structural mismatch)”,而非分布式或并行计算。 - [02:30](https://www.youtube.com/watch?v=HxaD_trXwRE&t=150s) Go 早期模板系统因缺乏形式化的词法与语法分析,导致引入数字常量与带引号字符串时代码变得极其脆弱和臃肿。 - [05:07](https://www.youtube.com/watch?v=HxaD_trXwRE&t=307s) 词法项定义为包含类型的结构体,词法扫描阶段保留原始文本字符串(如 `23.2`),避免过早将其转换为浮点数等机器类型。 - [09:03](https://www.youtube.com/watch?v=HxaD_trXwRE&t=543s) 词法生成工具(如 Lex)生成的代码体积庞大且难以生成高质量错误信息,而通用正则表达式对于静态确定的词法分析过于沉重,属于“杀鸡用牛刀”。 - [11:46](https://www.youtube.com/watch?v=HxaD_trXwRE&t=706s) 状态函数的本质是将“状态”与“动作”合二为一,使程序计数器直接指向下一个待执行逻辑,彻底规避了跳回外层 switch 重新解析状态的损耗。 - [15:41](https://www.youtube.com/watch?v=HxaD_trXwRE&t=941s) 将词法分析器拆解为独立的 goroutine 并通过 channel 投递 token,使词法分析与语法解析双方可以完全独立编写并自动协调控制权。 - [19:11](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1151s) 利用 `start` 和 `pos` 两个整数游标界定滑动窗口,配合 `emit` 方法投递切片并推进游标,保证了轻量高效的词法单元生成。 - [28:17](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1697s) 借助 `accept` 和 `acceptRun` 等辅助函数,词法分析器能以流水线方式清晰地扫描包含进制、浮点、指数和虚数后缀的复杂数字常量。 - [28:17](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1697s) 词法分析器的职责是贪婪匹配潜在的数字边界,严格的语法与数值合法性验证应合理交给下游解析器去完成。 - [32:10](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1930s) 错误处理函数 `errorf` 发送带有格式化错误描述的 `itemError` 并返回 `nil`,使主循环自然停机退出,避免了异常机制并简化了错误传递。 - [33:39](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2019s) Go 语言禁止在包全局变量初始化期间等待 goroutine 完成,这迫使设计必须规避在模板初始化阶段产生并发死锁。 - [35:25](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2125s) 通过引入 `nextItem` 与小容量缓冲 channel,在保持状态函数优雅内部结构的同时,对外部调用方隐藏了并发并消除了初始化死锁。 - [38:28](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2308s) 并发的核心价值在于作为一种解耦问题的程序设计手段,它支持并行但并不等同于并行,在词法分析中更体现为同步的线性控制流。 - [44:32](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2672s) 整个词法分析流程坚持零拷贝(zero-copy)设计,词法项直接持有原输入字符串的切片,面对超大静态文本时开销极低。 - [46:40](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2800s) 词法分析器的底层字符吞入逻辑仅需对 `next` 方法稍作抽象,即可由固定字符串输入平滑迁移至支持 `io.Reader` 流式读取。

## Detailed walkthrough ### [00:02](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2s) 结构不匹配问题与协程的历史渊源

在悉尼举办的 Google 技术用户组(GTUG)聚会上,主持人 Tim 宣布活动开始后,Rob Pike 登台带来了关于“Go 语言中的词法扫描(Lexical Scanning in Go)”的分享。Rob Pike 首先向台下抛出了一个看似与编译器无关的问题:“你们有多少人熟悉迈克尔·杰克逊(Michael Jackson)的研究工作?”面对台下零星的举手和会心的笑声,他解释此处的杰克逊并非流行音乐之王,而是开创了“杰克逊结构化程序设计”(Jackson Structured Programming, JSP)的计算机科学家。JSP 的核心在于解决计算领域极其普遍的“结构不匹配(structural mismatch)”问题。当程序试图将一种形态的数据转换为另一种形态,而两边的控制流无法自然契合时,代码就会迅速陷入混乱——比如读取固定数据块并尝试解析为文本行时,面对半截行和半个块的交错状态,程序不得不充斥着两端各自的缓冲区、前瞻窥探(look ahead/peek)、回溯状态以及繁琐的边界条件检查。无论是数据包重组还是词法解析,本质上都是这一痛点的体现。

```mermaid flowchart LR accTitle: 数据结构不匹配与传统解析困境 accDescr: 展示输入块与输出行由于流控制不匹配所导致的复杂缓冲与状态管理。 subgraph InputSide["输入端 (数据源)"] Block["原始数据块 (Blocks)"] end subgraph Mismatch["控制流不匹配核心区"] Buffer["缓冲区 / 前瞻窥探 (Lookahead)"] State["繁琐的边界与状态机管理"] end subgraph OutputSide["输出端 (解析目标)"] Lines["目标逻辑单元 (Tokens / Lines)"] end Block --> Buffer Buffer <--> State Buffer --> Lines ```

Rob Pike 指出,计算机科学史上一个有趣的巧合在于,协程(Coroutines)这一并发概念的诞生,其实早在杰克逊明确归纳结构不匹配问题之前,就是专门为了解决这种本地数据流转换而发明的。通常大家把协程视为现代并发编程的先驱,但其最初动机却是一个非常纯粹的非分布式数据管理问题。如果采用协程模型,开发者可以分别编写独立运行的数据块读取器和文本行处理器,让两者在需要时自动交出控制权并切换执行,这会让整个程序的代码结构变得极其清晰优雅。Rob Pike 强调,这种利用并发模型解耦控制流的思想,正是他接下来要展示的词法扫描器架构的基础:“When you do a coroutine model right, you get to write both pieces of the problem the block reader and the line processor or whatever completely independently and they switch control as necessary and the program can become quite a bit nicer as a result.”

- 结构不匹配在计算中无处不在,典型场景包括数据分块与解块、网络数据包重组以及词法与语法解析。 - 协程的最初诞生正是为了在无需复杂外部调度的情况下优雅解决双向缓冲与状态前瞻的问题。

---

[02:30](https://www.youtube.com/watch?v=HxaD_trXwRE&t=150s) 旧模板引擎的缺陷与新系统的语法构成

Rob Pike 进而切入本次演讲的实际工程背景:Go 语言标准库中的模板系统。在 Go 语言早期开发阶段,他曾亲手实现过一个文本模板包(即后来的 `text/template` 前身),尽管初衷是作为更通用的系统,但形式上类似 HTML 模板。对此他非常坦率地自我批评道,团队当时自以为做得很酷,但后来事实证明他们完全错了。初版实现不仅僵化且缺乏表现力,社区贡献者不得不频繁实现自己的替代方案,更严重的是其内部代码极其脆弱:“As it developed, we started to want to add things like numerical constants and quoted strings, and the whole code just sort of didn't accept it very well, it was clunky.” 当需要引入数值常量、带引号的字符串等现代语法特性时,既有代码框架根本无法顺畅承载,变得臃肿不堪。因此在 2011 年初,基于对模板应有形态的深刻认识,Rob 决定彻底重构,将其打造成一个具备正规词法分析与语法分析(Lex/Parse)的系统,并在此过程中摸索出了一套格外漂亮的词法分析器架构。

```mermaid flowchart TD accTitle: Go 模板语法解析层次 accDescr: 模板内容被拆分为外部原生文本与被双花括号包裹的内部动作。 RawInput["模板原始输入"] RawInput --> PlainText["普通文本 (Actions 外部内容)"] RawInput --> Action["动作块 {{... }}"] subgraph ActionDetails["动作内部语法元素"] Field[".title (上下文数据字段)"] Func["函数调用 (如 printf)"] Const["数值 / 复数常量 (Complex)"] Control["控制结构 (range / if / else)"] end Action --> ActionDetails ```

虽然本次讲座的重点并非教授模板使用,但 Rob 简要梳理了词法分析器需要处理的目标语法结构。模板由两部分组成:普通的静态文本,以及由双大括号包围的求值指令——动作(Actions,即 `{{... }}`)。动作内部承载着需要被求值的表达式、方法调用或数据结构字段: - **简单字段访问**:如 `{{.title }}`,在一个隐式的当前上下文环境中求值; - **函数与格式化**:如调用 `printf` 并传入十六进制格式化指令; - **复杂常量**:支持数值甚至包含复数常量(Rob 开玩笑表示这或许是第一个把复数常量写进演示幻灯片的模板系统); - **控制流结构**:用于循环遍历(`range`)与条件分支(`else`、`end`)等逻辑。

除了 Perl 那些极为特化的语法之外,这个模板动作内部几乎具备了现代通用编程语言所拥有的一切基础词法要素。词法分析器的职责,就是从连续的输入字符流中把这些语义块切分成语法分析器(Parser)能够理解的标记(Token / Lex Item),以便后续构建语法分析树。

---

[05:07](https://www.youtube.com/watch?v=HxaD_trXwRE&t=307s) 词法项(Item)建模与 Go 特性实践

词法扫描器的核心产物是“项”(Rob 将其命名为 `item`)。传统编译器实现中,一个词法项通常由两部分组成:类型(type)和值(value)。类型用来向解析器指示当前项的语法类别(如数字、标识符或操作符),在底层通常表示为一个整数;值则是对应的字面内容。Rob 明确指出,在词法扫描阶段,数值项如 `23.2` 的值应当保留为其原始的文本字符串 `"23.2"`,而非过早转换为浮点数或机器类型,这一规则对绝大多数词法分析器均适用。为了表示词法类型,他在 Go 中将其定义为一个独立类型:`type itemType int`。Rob 强调,虽然这表面上类似于 C/C++ 的 `typedef`,但在 Go 语言中它是一个货真价实的新定义类型,无法直接与普通整数混用,从而提供了更强的静态类型安全,并允许在其上附加专有方法。

```go type itemType int

const ( itemError itemType = iota // 错误项,值为 0 itemDot // 字段操作符. itemEOF // 文件结束标志 itemElse // 关键字 else itemEnd // 关键字 end itemLeftMeta // 左定界符 {{ itemRightMeta // 右定界符 }} itemNumber // 数字字面量 //... ) ```

在枚举常量的定义上,Go 的 `iota` 语法展现出了极简的工业美感。常量声明块的第一行写为 `itemError itemType = iota`,指示编译器开启枚举自增计数,随后的常量会自动依次获得递增的整型值(如 `itemDot` 为 1,`itemEOF` 为 2),且每个常量的底层类型都牢牢锁定为 `itemType`。除了常规的代码元素外,枚举列表中特别包含了 `itemError` 与 `itemEOF` 这类特殊标记。

```mermaid flowchart TD accTitle: Item 结构与 String 方法打印逻辑 accDescr: 根据 itemType 分支判断输出格式,包括 EOF、错误项以及过长文本截断。 A["调用 item.String()"] --> B{"匹配 item.typ"} B -->|itemEOF| C["输出字符串 'EOF'"] B -->|itemError| D["直接输出由 val 携带的错误消息"] B -->|其他类型| E{"val 长度是否过长?"} E -->|超过限制| F["截断字符并追加 '...' 输出"] E -->|未超限制| G["原样格式化输出 (类型与字面值)"] ```

紧接着,Rob 展示了如何利用 Go 的接口机制为词法项提供优雅的调试支持。Go 的 `fmt.Printf` 拥有一项独特性质:“Any type that has a method called String that returns string as a basic type is known to Printf and can be used by Printf so you get a default pretty print for that type value.” 只要为 `item` 结构体实现 `String() string` 方法,它便能自动被格式化打印。在 `String()` 的分支处理中隐藏着两个精妙的设计: 1. **错误传递技巧**:当类型为 `itemError` 时,词法扫描器会直接将人类可读的错误文本保存在该项的 `val` 字段中(即便这串文字并非来自模板源代码),打印方法直接将其原样输出,简化了错误状态流转; 2. **大文本防御性截断**:由于外部静态文本块可能长达上万字符,如果在调试时直接全量打印会导致终端刷屏,因此代码中加入了长度检测,对于超出限制的长字符串自动截断并追加省略号(`...`),保证调试输出紧凑清晰。

- 词法项(`item`)设计为包含 `typ itemType` 和 `val string` 两个字段,数值和标识符均以原生字符串形式暂存。 - `itemType` 依靠 `iota` 机制实现类型安全的自增枚举,避免了裸使用 `int` 带来的混淆隐患。 - 借由 Go 标准库约定的 `String()` 签名实现优雅打印,集成了错误文本承载和长文本自动截断保护机制。

[09:03](https://www.youtube.com/watch?v=HxaD_trXwRE&t=543s) 为什么不用现成工具:Lex 与正则表达式的局限性

一旦为 `item` 实现了格式化输出方法,就可以直接用 `fmt.Printf` 打印出整洁的词法项。但随之而来的核心问题是:如何对输入流进行分词(tokenization)?行业内有许多广为人知的方法,例如使用生成工具(如 Mike Lesk 最初编写、后来由实习期的 Eric Schmidt 重写的著名工具 Lex),或者使用正则表达式,抑或是通过状态、动作与 `switch` 语句手写状态机。Rob Pike 明确表示自己不会使用上述任何一种方案,并逐一分析了它们的不足。

首先针对词法分析生成工具(如 Lex),Rob Pike 澄清自己并不否定这类工具的价值,但他强调了工具常被忽视的缺陷:“在解析输入时,生成优质的错误信息非常重要,而工具往往让输出良好的错误信息变得比预期更加困难;在词法分析阶段,这尤其是一个棘手的问题。”此外,开发者不仅要学习工具本身,通常还得学习一门专门用来为工具编写规则的辅助语言。既然手中已经有了像 Go 这样功能完备的编程语言,为何还要倒退一步去学另一门语言?更严重的问题在于尺寸和性能。Lex 以针对极其简单的词法状态机生成极其庞大的数据结构而著称,因此在他看来,Lex 已经不再适合胜任现代任务(尽管像 Ragel 这样的后继者要优秀得多)。

针对正则表达式,Rob Pike 提到他在演讲前一周刚写过一篇相关博文,起因是在代码审查中有一位开发者试图使用正则表达式编写词法分析器。Rob Pike 指出正则引擎对于词法分析这样简单的任务来说“过于庞大且沉重”: - 正则表达式引擎庞大且复杂,必须在庞大的状态空间中进行评估。 - 正则引擎所求解的问题往往远比词法分析所需的复杂得多——开发者只需要判断下一个字符是什么,根本不需要去匹配 55 个可能存在的关键字。 - 正则表达式是非常动态、极具表现力且精美的机制(Rob Pike 本人也曾多次实现并十分喜爱正则),但词法分析语法是完全静态且已知的,引入动态匹配机制属于典型的“杀鸡用牛刀”(Overkill)。

```mermaid flowchart TD accTitle: 传统词法分析方案的缺陷对比 accDescr: 对比词法生成工具与正则表达式在做词法分析时的核心劣势

subgraph Tools["词法分析生成工具 (如 Lex)"] T1["错误信息难以精细控制"] T2["需要额外学习 DSL / 工具专用语言"] T3["生成的数据结构庞大且运行缓慢"] end

subgraph Regex["正则表达式 (RegEx)"] R1["引擎复杂,状态空间评估开销巨大"] R2["计算模型过重 (Overkill)"] R3["高度动态机制难以匹配静态词法需求"] end ```

---

[11:46](https://www.youtube.com/watch?v=HxaD_trXwRE&t=706s) 传统手写状态机的困境与突破:从 switch 转向状态函数

既然不用生成工具也不用正则,手写词法分析器便成了自然的选择。现代编程语言的词法结构极为相似,学会为一门语言编写分词器后,几乎可以直接套用到其他任何语言中。传统的手写做法通常是定义一系列状态(例如“在注释中”、“在普通文本中”、“在动作标签中”)以及对应的动作(如吸收字符直至数字末尾),然后用一个外层的 `switch` 语句包裹状态:根据当前状态跳转执行动作,动作消耗输入并返回一个新状态以及词法项。

Rob Pike 指出,这种典型的 `switch` 模型虽然简单直观,但极其单调乏味,且存在逻辑设计上的倒退:“当你从动作 2 返回并附带返回一个状态时,你必须退回到调用者,接着再次进入 `switch` 重新推导自己的位置;状态变量在此刻丢失了程序刚才所处的上下文。”明明刚退出动作 2 时已经清楚接下来该去状态 1,为何还要离开、重新进循环、再次做一遍条件判断,而不是直接跳转到状态 1?

为了彻底消除这个繁琐的调度损耗,Rob Pike 提出了将“状态”(State)与“动作”(Action)合二为一的优雅方案: 1. **状态的本质**:代表我们在输入中所处的位置,以及接下来预期会看到什么。 2. **动作的本质**:代表在该状态下针对特定输入所执行的具体操作。 3. **状态函数(State Function)**:执行该函数即执行了对应动作,执行完毕后,它的返回值直接就是下一个状态函数。

由此,Go 语言中诞生了一个极具美感的递归类型定义: ```go type stateFn func(*lexer) stateFn ``` Rob Pike 形容这个定义“有点令人脑洞大开(mindblower)”,因为一个状态函数的定义正是返回其自身类型的函数。通过将状态的推进直接交由函数指针维系,词法分析器的内部主循环被压缩成了仅有一行的极其纯粹的形式:

```go for state:= startState; state!= nil; { state = state(l) } ```

“原先的 `switch` 语句被折叠成了一行不断自我运行的代码:获取一个状态、调用它、得到新状态、再次调用它……程序计数器(PC)永远精确地指向我们下一步要去的地方。”

---

[15:41](https://www.youtube.com/watch?v=HxaD_trXwRE&t=941s) 引入并发模型:基于 Channel 的词法分析器架构

将整个词法分析器折叠进单行 `state = state(l)` 循环之后,随之暴露出了一个明显的工程问题:在纯粹的状态流转中,根本看不到向外发射(emit)Token 的机制。如果外部的解析器(Parser)需要获取词法项,应该如何与这套闭环的状态机交互?

Rob Pike 在此展示了 Go 语言原生并发能力的威力。传统架构通常让解析器主动调用 `lex.nextToken()`,而 Rob Pike 选择将词法分析器设计为一个与解析器并行运行的协程(Goroutine):

```mermaid flowchart LR accTitle: 词法分析器与语法解析器的并发管道模型 accDescr: 展示词法分析器如何通过 Go Channel 将 Item 传递给解析器

subgraph LexMachine["词法分析协程 (Lexer)"] L1["状态循环: state = state(l)"] L2["扫描字符并构造 Item"] end

subgraph Comm["通信桥梁"] CH["chan item (类似 Unix Pipe)"] end

subgraph ParseMachine["语法解析协程 (Parser)"] P1["从通道接收 Token"] P2["构建 AST / 语法树"] end

L1 --> L2 L2 -->|"发射词法项 (lob over the wall)"| CH CH -->|"接收并驱动解析"| P1 P1 --> P2 ```

词法分析器和解析器被拆分为两个完全独立的实体。词法分析器专注遍历输入并发射词法项,每当构造出一个新的 `item` 时,直接借助 Go 的 `channel` 将其“隔墙扔给”解析器。Rob Pike 将这种通道比喻为带有更严格语义的 Unix 管道(Pipe)。在具体的数据结构定义中,`lexer` 结构体聚合了所有内部解析状态,而最为关键的对外出口正是一个通道字段: - `items chan item`:作为词法分析器向解析器输送数据的管道通道。

在工厂函数的早期版本中,创建词法分析器的函数会同时返回 `*lexer` 指针与 `chan item`。Rob Pike 坦承这种 API 显得有些怪异,但强调“这是真实生产环境下的早期代码,后续会逐步对其进行修正与重构”,从而为下一步完整展示字符扫描与并发通道结合的具体代码埋下了伏笔。

[17:35](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1055s) 启动词法分析器与并发通道通信

Rob Pike 讲解了词法分析器的启动函数 `lex`。该函数接收模板名称和输入字符串作为参数,创建 `lexer` 结构体并初始化相关字段。在 Go 语言中,结构体初始化只需显式填写关心的字段,其余未填字段均会自动赋予零值。随后,Rob Pike 指出核心逻辑所在的语句:通过 `go l.run()` 启动一个独立的并发执行流。

```mermaid flowchart LR accTitle: 词法分析器并发运行与管道交互 accDescr: 描述词法分析器在独立的 goroutine 中运行并通过 channel 将 token 发送给语法解析器的流程 subgraph S1["并发执行流 (Goroutine)"] A["词法分析器 run()"] -->|"遍历状态"| B["状态函数 (stateFn)"] B -->|"emit(item)"| C["items channel"] end subgraph S2["调用方主线程"] C -->|"接收 token"| D["语法解析器 (Parser)"] end ```

此时状态机作为独立的 goroutine 与调用者并行运行,随后 `lex` 函数立即向调用方(通常是语法解析器 parser)返回构造好的词法分析器实例。解析器接着开始解析,并通过通道(channel)持续接收由后台运行器投递过来的词法单元(lexemes)。随后他展示了真正的 `run` 方法实现,强调这段代码真实不带半点水分:它首先设定初始状态为普通文本状态 `lexText`,接着进入 `state = state(l)` 循环不断执行状态函数,并在循环终结时调用 `close(l.items)` 关闭通道,明确通知语法解析器不会再有后续 token。

“Notice in Go you don't only have to fill in the ones you care about; the rest will be initialized to zero, and then this line here is where the magic starts: `go l.run()`.”

- 启动函数 `lex(name, input string) *lexer` 负责实例化并派发 goroutine。 - 真实的 `run` 方法以 `lexText` 为起始状态,并在状态循环结束后关闭 `items` 通道。

[19:11](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1151s) 游标管理与词法单元发射机制 (`emit`)

为了将切分出来的 token 传送回调用者,Rob Pike 解释了 `lexer` 内部控制扫描位置的两个核心整型游标:`start` 与 `pos`。尽管他开玩笑说这两个名字算不上特别优雅,但含义极其明确。扫描沿字符串单向推进时,`start` 标记当前正在扫描(即将发射)的 token 起始偏移量,而 `pos` 则是当前扫描器所探查到的最新字符位置。两者之间的子切片 `input[start:pos]` 便构成了完整的词法单元。

```mermaid flowchart TD accTitle: Token 扫描与发射切片示意图 accDescr: 说明 input 字符串中 start 和 pos 游标如何界定词法单元并在 emit 时更新游标 subgraph Slice["输入字符串切片"] T["... 已处理..."] --- S["start"] S --- W["当前待发射词法单元 (Token)"] W --- P["pos"] P --- R["... 未处理输入..."] end W -->|"emit(itemType)"| CH["l.items 通道"] CH -->|"推进游标"| UP["start = pos"] ```

在 `emit` 方法中,接收一个 token 类型参数 `itemType`,随后使用 Go 语言的通道发送操作符 `<-` 将构造好的 `item` 推入 `l.items` 通道中。完成向解析器“越墙投掷”token 的动作后,词法分析器只需执行 `start = pos` 将起始点移动到当前位置。Rob Pike 生动地将该流程比喻为一路快跑扫描:“扫描、扫描、扫描,啊哈!这里有个 item,把它扔过围栏,接着处理下一个再扔过去,这就是整个运作模型。”

- `input[start:pos]` 确立了当前词法单元的文本范围。 - `l.items <- item{typ, l.input[l.start:l.pos]}` 将切分后的数据投递到通道。 - 投递后执行 `l.start = l.pos` 完成滑动窗口更新。

[20:26](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1226s) 文本状态扫描与定界符匹配 (`lexText` 与 `lexLeftMeta`)

在明确了游标与发射机制后,Rob Pike 回顾了初始状态 `lexText` 的具体实现细节。词法分析器首要任务是寻找动作定界符(即模板标记的左双大括号 `{{`,在代码中定义为常量 `leftMeta`)。`lexText` 函数内部使用 `for` 循环不断步进输入,如果在当前位置 `pos` 遇到了左定界符,且 `pos > start` 说明之前累积了非空的纯文本内容,就会立即调用 `emit(itemText)` 将其作为普通文本 token 发送给解析器。

```mermaid flowchart TD accTitle: 状态转移流程:纯文本到动作块 accDescr: 展现从扫描普通文本到识别左定界符并进入动作块的状态转移 T["lexText 状态"] -->|"未见 leftMeta"| T T -->|"发现 leftMeta"| ET["emit(itemText)"] ET -->|"返回新状态"| LM["lexLeftMeta 状态"] LM -->|"pos += len(leftMeta)"| ELM["emit(itemLeftMeta)"] ELM -->|"返回新状态"| IA["lexInsideAction 状态"] ```

发出文本之后,`lexText` 并不直接在当前函数里拆解定界符,而是返回一个新的状态函数 `lexLeftMeta`。“Here's a state function, and it returns a state function.” Rob Pike 解释道,`lexLeftMeta` 的工作极其纯粹:因为前置判断已经确认定界符的存在,它直接使 `pos += len(leftMeta)` 跳过两个大括号,紧接着调用 `emit(itemLeftMeta)` 抛出定界符 token,然后将状态自然切换到 `lexInsideAction`,正式步入动作块内部。

- 模板中普通文本与模板动作的交界处由常量 `leftMeta` 触发判定。 - 每个状态函数各司其职,`lexText` 只管纯文本,识别到定界符后将控制权交由 `lexLeftMeta`。 - 文本扫描遭遇 EOF 的处理机制十分整洁,不会干扰主逻辑状态跳转。

[23:04](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1384s) 动作块内部状态分支调度 (`lexInsideAction`)

进入动作块内部后,词法分析面对的是更为复杂多变的语法元素。Rob Pike 展示了 `lexInsideAction` 的实现,指出这非常具有手写词法分析器的代表性:由于程序无法预知接下来会遇到数字、标识符还是字符串,因此需要通过单字符窥视来展开一系列多路分支提问。

首先检查是否遇到闭合定界符 `rightMeta`,若匹配成功则返回 `lexRightMeta` 准备退回到纯文本逻辑。若未闭合,则调用辅助方法 `l.next()` 读取下一个字符(Rune)并做模式匹配:遇到 EOF 或换行符直接返回报错,因为模板系统不允许动作块跨行;遇到空白字符则直接忽略跳过;遇到管道符 `|` 则做相应处理;遇到双引号 `"` 返回 `lexQuote`;遇到反引号 ``` ` ``` 则切换到 Go 特有的原始字符串状态 `lexRawQuote`。当读到加号 `+`、减号 `-` 或数字字符时,表明扫描器已经迈入了数值常量的第一个字符,此时只需调用 `backup` 后退一步,接着转移到 `lexNumber` 状态;同理,遇到字母时同样退回一步并转移到标识符状态。

“And compared to what a regular expression does to work this out, it's actually in some senses simpler; of course there's more code, but it's really nice how you just sort of pick a one character, what do I do now, I move on.”

- 模板系统强制规定动作块不得跨换行符存在,否则触发语法错误 `l.errorf`。 - 通过识别首字符并在状态跳转前执行 `backup` 回退,实现了优雅的分支预测与状态衔接。

[25:14](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1514s) 字符级辅助工具函数:`next`、`ignore` 与 `backup`

为了支撑上述状态函数的高效切换,Rob Pike 深入解释了底层的几个关键辅助函数。首先是 `next()`,它负责从输入流提取下一个字符。在 Go 语言中,这被称为 `rune`,因为它代表经过完整 UTF-8 解码的 Unicode 码点,而不仅仅是单个字节。`next()` 在读取到字符串末尾时返回一个代表 EOF 的带外特殊符;否则利用 UTF-8 解码提取字符,依该字符的字节宽度相应推进 `pos` 游标,并将读到的 `rune` 返回给调用方。

此外还有两个操作游标极简却强大的辅助工具: 1. `ignore()`:直接执行 `l.start = l.pos`。当在动作块中遇到无意义的空格或间隔符时,直接调用该函数将起始游标同步推进,丢弃无用字符。 2. `backup()`:作为 `next()` 的逆操作,将 `pos` 游标按当前字符的宽度向后回退。Rob Pike 强调,正是由于 `next` 负责吞入字符判断类型,当判定属于数字或标识符时,`backup` 能够立即撤销这单步移动,使得专门的状态函数(如 `lexNumber`)能够从该 Token 的首个字符处重新干净地开始解析。

- Go 语言中使用 `rune` 来完整支持 UTF-8 字符解码。 - `ignore` 通过重设起始索引 `start = pos`,不发送任何 token 即可丢弃空白字符。 - `backup` 提供了单字符回退能力,配合状态机在关键分支处无缝平移。

[026:29] 基础光标移动:backup 与 peek

Rob Pike 介绍了词法分析器用于在输入流中调整读取位置的关键辅助方法。词法分析器的 `next` 方法在前进时会自动记录读取的字符宽度(width),因此当分析器读取过头时——比如本来并不想步入某个数字字符——执行回退极为简便:只需调用 `backup`,将内部位置 `pos` 减去刚记录的宽度即可。正如 Rob Pike 所言:“Oops, nope, that was wrong, back up.”(“哎呀,不对,读错了,退回去。”)

与此配合的是许多同类文本处理软件中常见的 `peek` 方法。它的核心需求是:“我不打算真正向前推进,但我必须提前知道接下来是什么。”在当前的词法分析器架构下,实现 `peek` 异常平凡:只需调用一次 `next` 读取下一个 rune,紧接着立即调用 `backup` 退回一步。这种组合虽然简单,却赋予了分析器无损向前窥探单个字符的能力,为后续构建更高级的匹配逻辑铺平了道路。

[027:06] 字符接收器:accept 与 acceptRun

拥有了基础的位置游标操作后,Rob Pike 引入了两个强大的字符接收器(acceptor)方法,用以极为干净地扫描复杂的文本片段。第一个方法是 `accept`,它是绑定在 `lexer` 上的一个方法。调用方会向它传入一个包含合法字符集的字符串(例如一串纯数字或一组字母),询问当前输入中的下一个字符是否属于这个字符集。其内部通过 `strings.IndexRune` 来判断下一个字符是否存在于指定字符串中。如果匹配成功,字符被正式消费并返回 `true`;如果匹配失败,说明读取超出了预期范围,分析器会自动调用 `backup` 撤销这一步操作并返回 `false`。

第二个辅助方法是 `acceptRun`。它的参数与 `accept` 相同,但内部置于一个 `for` 循环中,意图是“尽可能多地吸收匹配字符”——例如直接吃掉一整串连续的数字或连续的英文字母。在当前的模板词法分析器实现中,`acceptRun` 甚至不需要返回值,只要持续贪婪地循环吸收合法字符即可;不过在其他场景下,也可以让其返回是否匹配到了任何内容。这两个接收器极大地简化了复杂的匹配逻辑,免去了手写大量条件分支和位置计算的麻烦。

[028:17] 解析数字常量与解析器的分工协作

为了展示 `accept` 与 `acceptRun` 的威力,Rob Pike 以数字的词法分析为例。数字的解析实际上相当棘手:它涵盖十进制、八进制、十六进制,还包括带有小数点或不带小数点的浮点数、正负符号、正负指数以及各种变体。Rob Pike 调侃道,如果试图用正则表达式来完整匹配所有数字形式,“你可以试着写写看,写出来的表达式大概有这么长,会让你大吃一惊”。而在本词法分析器中,由于底层机制一直在通过 `pos` 指针自动追踪切片范围,代码根本不需要手动维护提取出的子串,只需要一路找到数字的边界即可。

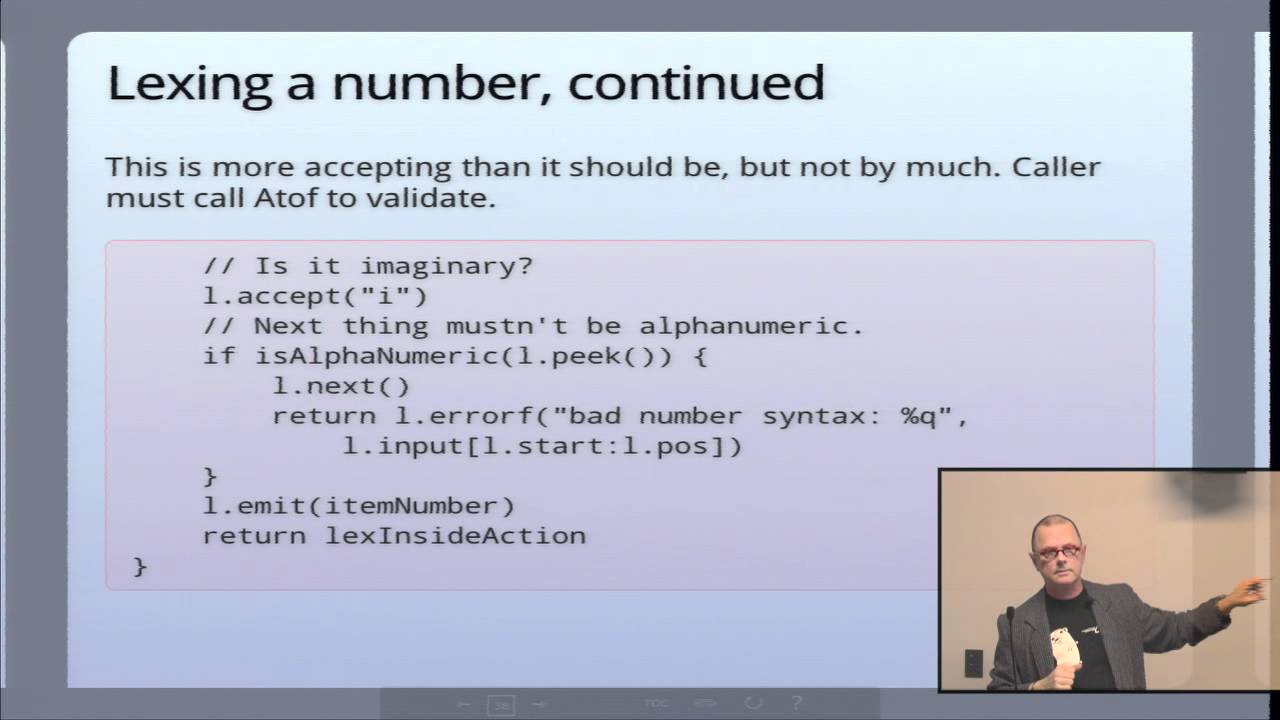
扫描数字的完整流程如同流水线般优雅推进:首先调用 `accept("+-")` 吸收可能存在的前置正负号;接着默认将候选字符集设为十进制数字;随后调用 `accept("0")` 与 `accept("xX")` 探测是否为十六进制,若成立则将字符集切换为十六进制的 `0-9a-fA-F`;紧接着调用 `acceptRun` 贪婪吸收整串基数对应的数字。在此之后,若能通过 `accept(".")` 接收到小数点,则继续吸收小数点后的数字;若能接收到指数符号 `eE`,则继续处理其符号与后续指数数字。Go 语言还原生支持虚数常量,因此末尾还尝试调用 `accept("i")` 吸收虚数单位。当到达数字的最长边界后,分析器还会做一项错误校验:紧随其后的下一个字符绝不能是字母数字字符,必须是空格或标点等合法分隔符,否则就属于非法语法。

```mermaid flowchart TD accTitle: 数字词法分析流程 accDescr: 展示 Lexer 扫描数字字面量时依次调用 accept 与 acceptRun 处理符号、进制、小数、指数及虚数后缀的完整逻辑。

subgraph SignAndBase["1. 符号与基数探测"] A["进入 lexNumber"] --> B["accept('+-')<br/>可选正负号"] B --> C{"探测 0x/0X?"} C -->|"是"| D["基数设为十六进制<br/>acceptRun('0-9a-fA-F')"] C -->|"否"| E["基数设为十进制<br/>acceptRun('0-9')"] end

subgraph Parts["2. 浮点、指数与虚数"] D --> F["accept('.') 探测小数"] E --> F F --> G["accept('eE') 探测指数"] G --> H["accept('i') 探测虚数单位"] end

subgraph ValidationAndEmit["3. 校验与发射"] H --> I{"下一个字符是否为<br/>合法边界标点/空白?"} I -->|"否 (仍为字母数字)"| J["l.errorf 报错"] I -->|"是"| K["emit(itemNumber)"] K --> L["返回 lexInsideAction 状态"] end ```

Rob Pike 特别强调了词法分析器(lexer)与语法解析器(parser)之间的合理分工:当前逻辑确实可能匹配出并非合法常量的字符串(例如十六进制中带有浮点指数形式的 `0x3e4`)。但他明确指出:“It's fine for a lexer to say, 'I think I know what this is,' and still the parser to validate it.”(“词法分析器说‘我觉得我知道这是什么’,并留给解析器去验证,这是完全没问题的。”)词法分析器的职责只是负责找出最大长度的潜在数字串,然后将其发射为 `itemNumber`,直接交由 Go 标准库中现成的数值转换函数去严格校验。一旦发射完成,状态函数将返回 `lexInsideAction`,让状态机继续在动作内部运转。

[032:10] 优雅的错误状态与终止机制

随后 Rob Pike 剖析了代码中的错误处理设计。在状态函数中,报错并不是抛出异常,而是通过 `return l.errorf(...)` 来完成。因为任何状态函数都必须返回一个状态函数类型(`stateFn`),所以这里的 `errorf` 本身也设计成了一个返回 `stateFn` 的函数。`errorf` 的接口形式类似于 `fmt.Printf`,接收格式化字符串与变长参数(即 `interface{}`,Rob Pike 类比为通用对象或 C 语言的 `void *`),能够输出包含出错上下文文本的高质量错误信息。

在 `errorf` 内部,它会将构造好的 `itemError` 与格式化文本发送到 `items` 通道中,随后关键的一步是直接返回 `nil`。由于前文定义的词法状态机在当前状态变为 `nil` 时会自动终止循环,返回 `nil` 意味着词法分析器彻底关闭停机。Rob Pike 强调,他坚信极佳的错误提示至关重要,而这种设计提供了一种极简且优雅的报错路径。对于模板扫描而言,一旦遇到语法错误,停下来正是最合理的选择,它完美契合了当前的并发状态模型。

- `errorf` 具有类似 `printf` 的格式化签名,通过 `items` 通道发射 `itemError`。 - `errorf` 执行完毕后返回 `nil`,使主循环 `for state!= nil` 自然退出并关闭状态机。 - 采用提前探测错误并生成携带上下文文本的错误信息,免去下游解析器猜测错误原因的负担。

[033:39] 初始化阶段的并发死锁困境

在总结这套词法分析器的构建体验时,Rob Pike 表示自己仅用了一个晚上(甚至更短的时间)就完成了原型。在推翻并丢弃了前几种令人不快的实现方式后,一旦将词法分析与解析器之间的结构性不匹配问题视作并发问题来解决,通过 Go 语言切片、状态函数闭包和通道,一切都变得异常顺畅且富有乐趣。然而,这套自鸣得意的设计却遭遇了一个致命现实问题:Go 语言的包初始化规范(package initialization)。

在真实的 Web 场景中,开发者通常希望将 HTML 模板声明为全局变量,并在程序启动的 `init` 阶段完成模板解析,以便服务启动后立即可用。然而,Go 语言为了维持清晰确定、没有歧义的包初始化语义,做出了非常严格的语言规范决策:禁止在初始化函数执行期间运行并发的 goroutine 直至其完成。Rob Pike 严肃地解释了这一规则背后的权衡:“It was a difficult decision, but we decided you just simply cannot run a goroutine to completion during initialization. You can create one, but it won't run — it doesn't run until initialization is done.”(“这是一个艰难的决定,但我们最终决定:在初始化期间,你绝不能让一个 goroutine 运行直到完成。你可以创建一个 goroutine,但它不会运行——直到初始化全部完成它才会跑。”)

这就导致了严重的冲突:由于当前的词法分析器严重依赖后台独立 goroutine 与解析器通过通道并发通信,如果在包全局变量初始化(或 `init` 函数)中解析模板,词法分析器的 goroutine 根本不会被调度执行,通道读取将陷入永久阻塞与死锁。这一限制险些彻底推翻“并发词法分析”的实用价值,但他随即安抚听众不必担心:这个问题不仅有解,而且解决起来出奇地容易。

[35:25](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2125s) 移除显式并发:封装传统的 NextItem API

Rob Pike 谈到,可能有人会觉得大费周章设计了如此优美的并发模型,现在却要“把并发拿掉”听起来很糟糕。但实际上,只通过极少的代码改动就能把原先基于 channel 的词法分析器改造成传统的词法分析 API(即调用者只需反复调用一个函数来获取下一个 token,完全不需要关心 channel)。在改造过程中,构造函数 `lex` 不再直接把 channel 返回给调用方,而是返回词法分析器本身的句柄(handle)。在内部,程序依然创建了一个 channel,但将其隐藏起来并加上了缓冲(buffering)。通过给 channel 添加两三个单元的缓冲容量,它实质上变成了一个环形缓冲区(ring buffer):词法分析器可以向其中 emit 若干 token,稍后再自行读取,从而摆脱了原本严格的同步限制。

```mermaid flowchart TD accTitle: 传统 nextItem API 执行流 accDescr: 展示 nextItem 函数内部通过 select 消费 channel 并在无就绪 token 时驱动单步状态机的逻辑流程

subgraph API["nextItem() 内部循环"] Start(["调用 nextItem()"]) --> Sel{"select 多路监听"} Sel -->|"channel 中已有就绪 item"| Ret["直接取出并 return item"] Sel -->|"default: channel 为空"| Step["执行单步状态函数: state = state(l)"] Step --> LoopCheck{"是否有 token 吐出到 channel?"} LoopCheck -->|"已生成 token"| Sel LoopCheck -->|"未生成(继续循环)"| Sel end ```

为了让外部解析器(parser)能够按照传统方式拉取 token,Pike 引入了 `nextItem` 方法。虽然表面上它替代了原本常驻后台的 `run` 循环,但内部运行机制完全相同,只是进行了解构:在一个无限循环(`for {}`)内放置一个 `select` 语句。如果内部的 item channel 中已经有词法分析好的 token,`select` 分支立即将其读出并返回给调用者;如果 channel 为空,则走 `default` 分支,在该分支下驱动状态机向前推进单步迭代(`state = state(l)`)。如果这次推进没有生成 token,循环继续,`select` 再次走 `default` 推进状态机,直到成功生成 token 为止。

Rob Pike 称赞这段实现说:“So it's kind of magic this is sort of the most magical slide of the ones I'm showing you but if you don't understand this that's okay all I want to show you is that that's all that was required to remove the concurrency from the picture.” 外部使用者看到的只是一个再普通不过的 API:创建一个词法分析器,并在循环中调用 `nextItem` 直至遇到 `EOF`;然而在底层,内部依然保留着利用并发思想构建出的干净、清晰的架构。

---

[38:28](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2308s) 并发作为设计手段与模板系统的演进

Rob Pike 强调,如果一开始就从编写 `nextItem` 这个 API 出发,开发者很可能写不出这么优雅的词法分析器。传统方式通常需要使用庞大的 `switch` 语句,每次重新进入函数时都必须痛苦地做状态恢复(state recovery)、判断当前所处位置并不断重启。而利用并发与状态函数的设计,重启不过是将状态机稍作不同形式的运转,状态函数原本的清晰度与表达力完全得以保留。

Pike 由此引出了关于并发的核心观点:“Concurrency is a design approach it's not about parallelism concurrency enables parallelism doesn't require it it's really about thinking about your problem as independently executing items that may run at the same time or not but conceptually each one is an independently executing item.” 他幽默地指出,这里用来解决结构失配(structural mismatch)的理论来自于计算机科学家 Michael Jackson,“顺便说一句,他并不是那位音乐家,以免你们以为是同一个人。” 并发不是灵丹妙药,但它带来了一种优雅的设计维度;结合 Go 语言的方法与面向对象特性,使得整个架构具有极强的适应性。演讲中所展示的词法分析器代码其实是他从版本库里翻出的第一天写的早期版本,随着模板语言在边设计边开发的过程中增加大量功能与 token 类型,每次调整都仅仅是修改一两行代码或增加一个两行的状态函数,这种扩展性是旧版模板系统所完全不具备的。

- 总结寄语:“Lexers are fun concurrency is fun and go is a lot of fun so I encourage you to play around with it.” - 官方资源与版本计划:所有 Go 代码与相关信息均托管在 `golang.org`。演讲中介绍的新模板系统将在下一个版本中取代旧系统,旧系统已被废弃(deprecated)。

---

[41:04](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2464s) 问答环节:构建产物、性能开销与状态机步进

进入问答阶段后,现场观众就构建产物形态、执行性能以及并发执行细节提出了具体问题:

一位观众询问编译输出的形式,比如在.NET 场景下它是否表现为可引用的库文件。Rob Pike 回答,Go 通常编译为静态链接的独立二进制文件(statically compiled binary),其性能特征是编译型语言而非解释器。词法分析器则是作为标准库代码链接进程序中。Go 官方支持多种 CPU 架构和操作系统,当时社区也有人在开发面向.NET 的实现,但 Go 的核心定位始终是高效的静态编译型语言。

另一位观众询问该词法分析器是否有性能测试数据(performance stats)。Pike 坦承自己在开场前就料到会有人问性能,但他目前还没有做基准测试: > “The answer is it's probably okay but not great because I'm using the language a little too having a little too much fun with the language and doing the channel communication and and that kind of stuff actually puts more overhead into the inner loop than that needs to be there.”

他进一步分析,如果追求极致性能,内部循环中由 channel 通信带来的开销是可以被进一步优化的;不过状态函数本身的性能在理论上已经非常接近最优解。唯二能比它更快的做法只有手写状态机、利用数组查表并跳转函数指针,但结构本质其实相差无几。

针对取消外部 goroutine 后的执行机制,另一位观众提问如果存在多个处理阶段,能否重新把 goroutine 加回来在初始化外部运行,以及 `nextItem` 是否会在没有 token 时发生阻塞。Pike 解释道,在模板解析阶段必须让词法分析执行完毕以构建解析树,不可能将其无限期搁置。至于 channel 缓冲大小,数字 `2` 是一个很精妙的设计(magic number),因为在当前实现中,词法分析器单次调用最多只会吐出两个 token;虽然将缓冲区设置得更大也完全可行,但没有必要。在调用 `nextItem` 时,词法分析器在生产出所需 token 前会持续运转,若是跨 goroutine 通信,在未获得下一个 token 时确实会等待阻塞;如果把 channel 缓冲区设得极大,词法分析器确实可以跑到很远之前,但在当前场景下并没有超前执行的必要。

[44:32](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2672s) 并发与线性的执行模型

Rob Pike 在回答现场观众前强调了当前词法分析器(lexer)的运行特性。虽然通过 goroutine 和 channel 实现了结构上的解耦,但整个设计完全是同步的,因此根本不存在复杂的调度问题。从底层的控制流来看,它始终是单线程且线性执行的:词法分析器吐出一个 token 就会停下来等待解析器(parser)读取,解析器需要 token 时才会推进词法分析器。这种模式属于并发(concurrency)而非并行(parallelism),线程无需频繁切换上下文。

```mermaid flowchart LR accTitle: 词法分析器与解析器的同步控制流 accDescr: 展示词法分析器与解析器通过无缓冲 Channel 实现严格同步的交替线性执行

subgraph LexerSide["词法分析器 (Goroutine)"] L1["运行状态函数 stateFn"] L2["向 Channel 发送 item"] end

subgraph ParserSide["解析器 / 客户端"] P1["从 Channel 接收 nextItem()"] P2["处理抽象语法树 AST / 逻辑"] end

L1 --> L2 L2 -->|"阻塞等待接收"| P1 P1 --> P2 P2 -.->|"请求下一个 Token"| L1 ```

随后主持人转达了来自 IRC 聊天室的提问:是否可以放弃 channel,改用列表(list)或向量(vector)将所有 token 收集起来?Rob Pike 透露,在他写完这套代码后,同事 Nigel Tao 确实提交过一个修改清单(Changelog / CL),把 channel 换成预存列表,这样能消除可能的微小性能开销。“The solution gets pretty because you can use concurrency to solve the problem and there's nothing inherently concurrent about the problem only the solution,” Rob Pike 明确指出。问题本身并没有并发属性,但引入并发能让代码设计变得优雅;如果未来遇到极其苛刻的性能瓶颈,他也会毫不犹豫地手写约 10 行代码实现一个环形缓冲区(ring buffer)。

现场有观众询问整个分析流程中输入文本被拷贝了多少次。Rob Pike 斩钉截铁地回答是“零次”。整个词法分析器接收一个原始字符串,后续所有传递给解析器的 token 都是基于原字符串的切片(slice)。即使输入包含数兆字节(MB)的纯文本而没有任何模板标记,Go 也绝不会复制这几兆字节的数据,切片操作开销极小且无内存拷贝。

- 内存开销极低:词法分析器对输入文本实现零拷贝(zero-copy),仅通过底层字符串切片(string slicing)传递 token 内容。 - 架构权衡:用并发通道传递 token 主要是为了代码结构的优雅与清晰;若要极致性能,可无缝替换为手写的环形缓冲区(ring buffer)。

[46:39](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2799s) 拓展支持 io.Reader 与 Go 语言的设计哲学

现场观众接着提问,如果要让词法分析器支持 `io.Reader` 接口而不是预先读取好的字符串,需要改动多少工作量。Rob Pike 解释说这非常容易实现:`io.Reader` 是 Go 语言中表示任何可读流(如文件、网络连接、内存缓冲区)的标准接口。若要改为流式驱动,只需在词法分析器结构体中增加相应的字段,并改写内部的 `next()` 方法去读取流。虽然在流上实现字符回退(backup)可能会稍显繁琐,但并不困难。在专注小模板解析的 `template` 包中,直接传字符串足以胜任;若用于通用正则表达式扫描器,基于 `io.Reader` 就会合理很多。

谈及这种设计是否会推广到 Go 标准库的其他解析器(如 XML、HTTP 或日期解析)时,Rob Pike 表示目前没有专门针对这些进行重构,但他提到了前一周的轶事:有人在博客上写文章用正则表达式去解析 HTML,结果被他“迎头痛击”(Smackdown)。值得称赞的是,那位作者认真接受了意见并修正了实现方式。

关于为何选择这个主题做分享,Rob Pike 总结道,词法分析虽然是一个冷门的极客问题(“Not very many people write lexers for a living”),但这套代码完整展现了地道的 Go 语言风格(Idiomatic Go): “It's not clear that it's the solution to world hunger, but it's a solution to Lexing my templates,” Rob Pike 幽默地解释道。它巧妙融合了适度的并发、小巧的面向对象封装、灵活的字符串操作以及方法与一等函数(first-class functions)的协作。

- 适配扩展:只要将内部读取字符的 `next` 逻辑绑定至 `io.Reader` 接口,就能以极小的改造成本支持流式输入。 - 核心设计元素:兼顾了函数作为状态(state functions)、goroutine 同步解耦、无类型转换的多态调用。

[48:39](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2919s) 语法分析生成器对比与事件监控

一位观众探讨了该技术是否可拓展用于语法分析生成器(parser generator),让工具自动生成类似的 Go 代码。Rob Pike 认为理论上完全可行,因为词法分析器和语法分析器本质上都是状态机。但他指出两者的复杂度不在同一个数量级:当前的模板词法分析器大约只有 10 到 15 个状态函数,而一个通用的语法分析器通常拥有数百个状态,纯手工编写会产生大量模版样板代码(boilerplate),更适合交由生成器生成。他还提到了状态机编译器 Ragel,指出 Ragel 生成的代码在底层逻辑上与这种状态机模型同构,只是机器生成的跳转更晦涩难懂。

随后观众追问:若处理非常大的文件,如何向外发送进度更新(progress updates)或事件通知,甚至将某些内容写入磁盘?Rob Pike 指向了幻灯片中的并发 `select` 语句。借助 `select` 的多路复用能力,仅需增加大约四行代码,就可以增加一个信号通道: - 外部可在任意时刻“ping”词法分析器以轮询当前处理偏移量; - 或者让词法分析器在主循环中设置计数器,每处理 1KB 或 10KB 自动向通道推送一次进度通知。

至于在特定条件下将数据写入文件,Rob Pike 笑着表示 Go 是完整的通用编程语言,随时都能执行写文件操作,“Files are cool, underrated.”

分享进入尾声时,Rob Pike 看了一下时间,突然向全场观众致歉:由于出现了极其糟糕的日程冲突(scheduling conflict),他在半小时前(讲座刚开始时)本该准时出席另一场重要安排,因此不得不立刻离场,演讲在匆忙而热烈的氛围中结束。

## Notable quotes > [38:28](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2308s) Concurrency is a design approach it's not about parallelism concurrency enables parallelism doesn't require it it's really about thinking about your problem as independently executing items that may run at the same time or not but conceptually each one is an independently executing item. — Rob Pike

> [09:03](https://www.youtube.com/watch?v=HxaD_trXwRE&t=543s) 在解析输入时,生成优质的错误信息非常重要,而工具往往让输出良好的错误信息变得比预期更加困难;在词法分析阶段,这尤其是一个棘手的问题。 — Rob Pike

> [28:17](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1697s) It's fine for a lexer to say, 'I think I know what this is,' and still the parser to validate it. — Rob Pike

## Mentioned Rob Pike, Michael Jackson, Go, Google, Google Technology User Group, GTUG, Lex, Mike Lesk, Eric Schmidt, Ragel, text/template, Nigel Tao, Unix

## Video description Lexical Scanning in Go, a talk by Rob Pike at Google Technology User Group given on Tuesday, 30 August 2011.

The slides: http://rspace.googlecode.com/hg/slide/lex.html

[Source](https://www.youtube.com/watch?v=HxaD_trXwRE)

中文简报

Rob Pike 在 Go 中以递归状态函数替代 Lex 与正则表达式 将并发视为架构结构而非并行工具可化解输入输出结构不匹配的问题,使开发者能够用自推进的递归状态函数消除 switch 语句分发循环。 Rob Pike 探讨了 Go 模板包词法分析器的架构重构,重点围绕解决标记生成器与消费者之间经典的结构性不匹配问题。Pike 没有依赖重量级的正则表达式、Lex 等代码生成工具或臃肿的 switch-case 分发循环,而是引入了一种基于返回下一个待执行状态的递归状态函数的优雅模式。他展示了 Go 通道和 goroutine 如何通过零拷贝字符串切片将扫描器与解析器解耦,并说明了如何利用小型内部通道缓冲区和 select 循环将该并发模型无缝转换为同步的 nextItem API,以适配 Go 的包初始化规则。 Rob Pike 介绍了一种地道的 Go 词法扫描器,使用递归状态函数(`type stateFn func(*lexer) stateFn`)替代传统的基于 switch 的状态机,将分发循环缩减为单行自推进代码。 (13:46) 通过将词法分析器作为 goroutine 并发运行并通过 Go 通道进行通信,该设计无需复杂的前瞻缓冲即可清晰解决迈克尔·杰克逊提出的经典输入输出结构不匹配问题。 (0:02) 由于 Go 不允许在包 `init()` 执行期间运行 goroutine 直至完成,因此可以使用 select 循环和大小为 2 的通道缓冲区将并发词法分析器转换为同步的 `nextItem()` API。 (33:39) 扫描器通过直接切片原始输入字符串来实现零拷贝标记生成,而无需分配中间字符缓冲区。 (44:32)

精炼阅读摘要

Rob Pike 提出了一种基于 Go 语言特性重构词法扫描器(Lexer)的设计方案,主张摒弃笨重的词法生成工具、正则表达式以及冗长的 switch 状态机,转而利用递归状态函数与并发通道来优雅化解输入输出间的结构不匹配问题。 结构不匹配与传统词法分析方案的缺陷 (0:02) Pike 引用了计算机科学家 Michael Jackson 提出的“结构不匹配”理论,指出数据输入形式与消费需求往往无法一一对应,而在词法分析器与语法分析器之间,这种控制流扭曲尤为严重。历史上协程的出现正是为了让数据读取端与消费端能各自独立维护控制流并按需交接控制权。Pike 回顾了早期 Go 语言模板引擎的脆弱实现,为了重写该引擎,他审视并否决了三种传统实现方式:专用生成工具(如 Lex、Ragel)、正则表达式以及基于 switch 的手写状态机。 Pike 解释称,Lex 等专用工具不仅报错信息晦涩,还要求开发者学习额外的规范语言,生成的代码往往包含庞大的状态表且运行沉重;而正则表达式功能过于宽泛且底层状态空间复杂,用来做单字符步进的词法分析属于大材小用。至于最常见的手写 switch 状态机,Pike 批评其在架构上存在“丢弃已知状态”的缺陷:动作函数在执行完毕时本已清楚下一步该去向何处,却被迫退出并返回状态值给中央分发循环,再由外层 switch 重新匹配分支,这不仅打断了 CPU 的程序计数器流向,还增加了不必要的代码复杂度。 状态函数与无分发循环的核心机制 (13:46) 为了消除 switch 带来的中转开销,Pike 将状态(词法分析器当前所处位置及预期)与动作(对输入字符执行的操作)统一抽象为函数概念,定义了递归函数类型 `type stateFn func(*lexer) stateFn`。在这个模型下,每个状态函数执行完自身扫描后,直接返回下一个待执行的状态函数指针;当扫描完毕或遇到错误时返回 `nil`。由此,整个扫描器的外层运行循环精简为仅有三行的 `for state != nil { state = state(l) }`,使执行流能够顺畅地在不同状态间直接跃迁。 在输入流导航方面,词法分析器通过记录起始位置 `start`、当前光标 `pos` 和当前 Unicode 字符(rune)字节宽度 `width`,配套构建了 `next`、`backup` 和 `peek` 等轻量助手方法。配合按集合匹配字符的 `accept` 与连续贪婪匹配的 `acceptRun`,扫描器可以轻松处理前缀符号、十六进制基数、浮点指数以及 Go 虚数单位。Pike 强调,词法分析器的职责是圈定最大化有效 token 的切片边界,复杂的数值语义验证应委托给下游解析器;此外,所有生成的 token 均直接切片自原始字符串,实现了零内存拷贝的高效处理。 并发流水线设计与 Go 包初始化陷阱 (15:48) 在最理想的模型中,Pike 将词法分析器置于独立的 goroutine 中运行,扫描出的每个 token 直接“抛过墙”,通过 Go 通道(channel)传递给消费端的语法分析器。错误处理也天然嵌入该机制中:辅助方法 `errorf` 会格式化生成带有错误说明的合成 token 并送入通道,随后返回 `nil`,从而在无需异常处理机制或中断标志的情况下立即终止扫描循环。 然而,这一完全并发的原型在实际应用中遭遇了 Go 运行时规则的制约。在 Web 服务场景中,模板通常在包级别的 `init()` 阶段被编译进全局变量;但 Go 运行时为了保证确定性的包初始化顺序,规定初始化期间创建的 goroutine 会被挂起,直至全部初始化结束。这导致并发词法分析器在 `init()` 阶段等待消费时直接死锁。为了化解这一限制,Pike 将公开 API 重构成同步拉取模式的 `nextItem()`,并利用容量为 2 的带缓冲通道将通道退化为私有环形缓冲区。通过在无限循环内结合 `select` 接收与 `default` 单步执行状态函数,Pike 在未破坏状态函数内核的前提下,完全向调用方隐蔽了并发依赖。 并发作为设计思维与工程落地权衡 (38:28) Pike 借此澄清,并发首先是一种解耦复杂软件架构的设计理念,而非仅仅用于多核并行计算的性能工具。即使在单线程逻辑下,将词法扫描与语法解析视作两个独立运作的协程实体,也能显著降低状态回溯与代码管理的认知负担。在实际演进中,得益于状态函数的清晰隔离,随着模板语法的扩充,新增字面量和关键字支持往往只需添加一到两行逻辑或一个简短的独立状态函数即可完成。 针对现场观众对性能和数据流设计的疑问,Pike 坦承该实现尚未经过严格的基准测试,通道内部调度的开销确实会使内层循环速度受到一定影响,但函数指针的直接调用在效率上已逼近查表分发的理论上限。虽然贡献者 Nigel Tao 曾提交过使用简单切片列表批量收集 token 的优化补丁且性能可能更高,但 Pike 因其破坏了流式交互的设计美感而坚持保留通道方案。此外,Pike 指出状态机目前仅针对模板的 10 至 15 个状态手写维护,对于拥有数百个状态的通用语法解析器,手写该模式会带来大量样板代码,届时仍需代码生成工具辅助。 Pike 总结指出,词法分析本身并非固有并发的业务场景,但并发思维为解耦数据生产与消费提供了极具表现力的架构手段。尽管在高吞吐场景下通道切换会引入轻微性能损耗,且该模式难以直接外推至状态庞杂的通用解析器,但它仍充分展现了 Go 语言在函数类型、零拷贝切片及轻量通信层面的工程美学。

Detailed notes — zh

## Background 该视频由 YouTube 频道 GoogleFOSSSydney 于 2011 年 8 月 30 日发布。内容为 Rob Pike 在悉尼 Google 技术用户组(GTUG)聚会上的技术演讲,主题是介绍 Go 语言中一种基于状态函数与并发模型构建的新型词法扫描器(Lexical Scanning in Go)。 ## TL;DR Rob Pike 深入探讨了编译器前端中常见的“结构不匹配”问题,并批判了传统词法生成工具(如 Lex)和正则表达式在分词任务中的局限与冗余。他展示了 Go 标准库重构模板系统时采用的一种极简方案:将状态与动作统一为递归类型定义的状态函数(`stateFn`),使主循环收敛为单行代码,并通过 Goroutine 与 Channel 优雅解耦词法分析器与语法解析器。针对 Go 包初始化期间禁止后台 Goroutine 运行的死锁问题,他进一步利用 Channel 缓冲与 `select` 语句将并发逻辑无缝收拢为传统的 `nextItem` API。最后,演讲强调并发不仅关乎并行性能,更是理顺程序控制流与消除样板代码的强大设计思维。 ## Atmosphere & style 现场氛围亲切、松弛且洋溢着浓厚的极客幽默,Rob Pike 举重若轻地在白板式的幻灯片前拆解复杂的编译器概念。他的讲解风格直率而富有洞察力,既有对早期粗糙实现的坦诚自嘲,也有对正则表达式滥用者的风趣调侃,令台下的技术受众不时报以会心笑声。整场演讲兼具底层架构的严谨推演与语言哲学的写意表达,最后因真实的日程冲突在略显匆忙却热烈掌声中戛然而止,真实感与启发性拉满。 ## Bulletin - [11:46](https://www.youtube.com/watch?v=HxaD_trXwRE&t=706s) Rob Pike 提出利用 Go 语言的状态函数与递归类型定义(`type stateFn func(*lexer) stateFn`)替代传统的庞大 switch 语句,使词法分析器的主循环精简至单行代码。 - [15:41](https://www.youtube.com/watch?v=HxaD_trXwRE&t=941s) 词法分析器最初被设计为与解析器并行的协程(goroutine),通过 channel 进行类似 Unix 管道的单向通信,从架构上解耦了输入缓冲与解析控制流。 - [33:39](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2019s) 由于 Go 规范严禁在包初始化(`init`)阶段等待并发 goroutine 完成,团队通过带缓冲 channel 与 select-default 轮询机制,在不破坏状态机架构的前提下将并发逻辑改造成同步的 `nextItem` API。 - [44:32](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2672s) 整个词法扫描过程对输入文本实现了零内存拷贝,所有向解析器传递的词法项(item)均直接复用底层输入字符串的切片(slice)。 ## Key takeaways - [00:02](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2s) 协程(Coroutines)的历史初衷正是为了解决控制流与数据块之间的“结构不匹配(structural mismatch)”,而非分布式或并行计算。 - [02:30](https://www.youtube.com/watch?v=HxaD_trXwRE&t=150s) Go 早期模板系统因缺乏形式化的词法与语法分析,导致引入数字常量与带引号字符串时代码变得极其脆弱和臃肿。 - [05:07](https://www.youtube.com/watch?v=HxaD_trXwRE&t=307s) 词法项定义为包含类型的结构体,词法扫描阶段保留原始文本字符串(如 `23.2`),避免过早将其转换为浮点数等机器类型。 - [09:03](https://www.youtube.com/watch?v=HxaD_trXwRE&t=543s) 词法生成工具(如 Lex)生成的代码体积庞大且难以生成高质量错误信息,而通用正则表达式对于静态确定的词法分析过于沉重,属于“杀鸡用牛刀”。 - [11:46](https://www.youtube.com/watch?v=HxaD_trXwRE&t=706s) 状态函数的本质是将“状态”与“动作”合二为一,使程序计数器直接指向下一个待执行逻辑,彻底规避了跳回外层 switch 重新解析状态的损耗。 - [15:41](https://www.youtube.com/watch?v=HxaD_trXwRE&t=941s) 将词法分析器拆解为独立的 goroutine 并通过 channel 投递 token,使词法分析与语法解析双方可以完全独立编写并自动协调控制权。 - [19:11](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1151s) 利用 `start` 和 `pos` 两个整数游标界定滑动窗口,配合 `emit` 方法投递切片并推进游标,保证了轻量高效的词法单元生成。 - [28:17](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1697s) 借助 `accept` 和 `acceptRun` 等辅助函数,词法分析器能以流水线方式清晰地扫描包含进制、浮点、指数和虚数后缀的复杂数字常量。 - [28:17](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1697s) 词法分析器的职责是贪婪匹配潜在的数字边界,严格的语法与数值合法性验证应合理交给下游解析器去完成。 - [32:10](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1930s) 错误处理函数 `errorf` 发送带有格式化错误描述的 `itemError` 并返回 `nil`,使主循环自然停机退出,避免了异常机制并简化了错误传递。 - [33:39](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2019s) Go 语言禁止在包全局变量初始化期间等待 goroutine 完成,这迫使设计必须规避在模板初始化阶段产生并发死锁。 - [35:25](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2125s) 通过引入 `nextItem` 与小容量缓冲 channel,在保持状态函数优雅内部结构的同时,对外部调用方隐藏了并发并消除了初始化死锁。 - [38:28](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2308s) 并发的核心价值在于作为一种解耦问题的程序设计手段,它支持并行但并不等同于并行,在词法分析中更体现为同步的线性控制流。 - [44:32](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2672s) 整个词法分析流程坚持零拷贝(zero-copy)设计,词法项直接持有原输入字符串的切片,面对超大静态文本时开销极低。 - [46:40](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2800s) 词法分析器的底层字符吞入逻辑仅需对 `next` 方法稍作抽象,即可由固定字符串输入平滑迁移至支持 `io.Reader` 流式读取。 ## Detailed walkthrough ### [00:02](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2s) 结构不匹配问题与协程的历史渊源 在悉尼举办的 Google 技术用户组(GTUG)聚会上,主持人 Tim 宣布活动开始后,Rob Pike 登台带来了关于“Go 语言中的词法扫描(Lexical Scanning in Go)”的分享。Rob Pike 首先向台下抛出了一个看似与编译器无关的问题:“你们有多少人熟悉迈克尔·杰克逊(Michael Jackson)的研究工作?”面对台下零星的举手和会心的笑声,他解释此处的杰克逊并非流行音乐之王,而是开创了“杰克逊结构化程序设计”(Jackson Structured Programming, JSP)的计算机科学家。JSP 的核心在于解决计算领域极其普遍的“结构不匹配(structural mismatch)”问题。当程序试图将一种形态的数据转换为另一种形态,而两边的控制流无法自然契合时,代码就会迅速陷入混乱——比如读取固定数据块并尝试解析为文本行时,面对半截行和半个块的交错状态,程序不得不充斥着两端各自的缓冲区、前瞻窥探(look ahead/peek)、回溯状态以及繁琐的边界条件检查。无论是数据包重组还是词法解析,本质上都是这一痛点的体现。 ```mermaid flowchart LR accTitle: 数据结构不匹配与传统解析困境 accDescr: 展示输入块与输出行由于流控制不匹配所导致的复杂缓冲与状态管理。 subgraph InputSide["输入端 (数据源)"] Block["原始数据块 (Blocks)"] end subgraph Mismatch["控制流不匹配核心区"] Buffer["缓冲区 / 前瞻窥探 (Lookahead)"] State["繁琐的边界与状态机管理"] end subgraph OutputSide["输出端 (解析目标)"] Lines["目标逻辑单元 (Tokens / Lines)"] end Block --> Buffer Buffer <--> State Buffer --> Lines ``` Rob Pike 指出,计算机科学史上一个有趣的巧合在于,协程(Coroutines)这一并发概念的诞生,其实早在杰克逊明确归纳结构不匹配问题之前,就是专门为了解决这种本地数据流转换而发明的。通常大家把协程视为现代并发编程的先驱,但其最初动机却是一个非常纯粹的非分布式数据管理问题。如果采用协程模型,开发者可以分别编写独立运行的数据块读取器和文本行处理器,让两者在需要时自动交出控制权并切换执行,这会让整个程序的代码结构变得极其清晰优雅。Rob Pike 强调,这种利用并发模型解耦控制流的思想,正是他接下来要展示的词法扫描器架构的基础:“When you do a coroutine model right, you get to write both pieces of the problem the block reader and the line processor or whatever completely independently and they switch control as necessary and the program can become quite a bit nicer as a result.” - 结构不匹配在计算中无处不在,典型场景包括数据分块与解块、网络数据包重组以及词法与语法解析。 - 协程的最初诞生正是为了在无需复杂外部调度的情况下优雅解决双向缓冲与状态前瞻的问题。 --- ### [02:30](https://www.youtube.com/watch?v=HxaD_trXwRE&t=150s) 旧模板引擎的缺陷与新系统的语法构成 Rob Pike 进而切入本次演讲的实际工程背景:Go 语言标准库中的模板系统。在 Go 语言早期开发阶段,他曾亲手实现过一个文本模板包(即后来的 `text/template` 前身),尽管初衷是作为更通用的系统,但形式上类似 HTML 模板。对此他非常坦率地自我批评道,团队当时自以为做得很酷,但后来事实证明他们完全错了。初版实现不仅僵化且缺乏表现力,社区贡献者不得不频繁实现自己的替代方案,更严重的是其内部代码极其脆弱:“As it developed, we started to want to add things like numerical constants and quoted strings, and the whole code just sort of didn't accept it very well, it was clunky.” 当需要引入数值常量、带引号的字符串等现代语法特性时,既有代码框架根本无法顺畅承载,变得臃肿不堪。因此在 2011 年初,基于对模板应有形态的深刻认识,Rob 决定彻底重构,将其打造成一个具备正规词法分析与语法分析(Lex/Parse)的系统,并在此过程中摸索出了一套格外漂亮的词法分析器架构。 ```mermaid flowchart TD accTitle: Go 模板语法解析层次 accDescr: 模板内容被拆分为外部原生文本与被双花括号包裹的内部动作。 RawInput["模板原始输入"] RawInput --> PlainText["普通文本 (Actions 外部内容)"] RawInput --> Action["动作块 {{... }}"] subgraph ActionDetails["动作内部语法元素"] Field[".title (上下文数据字段)"] Func["函数调用 (如 printf)"] Const["数值 / 复数常量 (Complex)"] Control["控制结构 (range / if / else)"] end Action --> ActionDetails ``` 虽然本次讲座的重点并非教授模板使用,但 Rob 简要梳理了词法分析器需要处理的目标语法结构。模板由两部分组成:普通的静态文本,以及由双大括号包围的求值指令——动作(Actions,即 `{{... }}`)。动作内部承载着需要被求值的表达式、方法调用或数据结构字段: - **简单字段访问**:如 `{{.title }}`,在一个隐式的当前上下文环境中求值; - **函数与格式化**:如调用 `printf` 并传入十六进制格式化指令; - **复杂常量**:支持数值甚至包含复数常量(Rob 开玩笑表示这或许是第一个把复数常量写进演示幻灯片的模板系统); - **控制流结构**:用于循环遍历(`range`)与条件分支(`else`、`end`)等逻辑。 除了 Perl 那些极为特化的语法之外,这个模板动作内部几乎具备了现代通用编程语言所拥有的一切基础词法要素。词法分析器的职责,就是从连续的输入字符流中把这些语义块切分成语法分析器(Parser)能够理解的标记(Token / Lex Item),以便后续构建语法分析树。 --- ### [05:07](https://www.youtube.com/watch?v=HxaD_trXwRE&t=307s) 词法项(Item)建模与 Go 特性实践 词法扫描器的核心产物是“项”(Rob 将其命名为 `item`)。传统编译器实现中,一个词法项通常由两部分组成:类型(type)和值(value)。类型用来向解析器指示当前项的语法类别(如数字、标识符或操作符),在底层通常表示为一个整数;值则是对应的字面内容。Rob 明确指出,在词法扫描阶段,数值项如 `23.2` 的值应当保留为其原始的文本字符串 `"23.2"`,而非过早转换为浮点数或机器类型,这一规则对绝大多数词法分析器均适用。为了表示词法类型,他在 Go 中将其定义为一个独立类型:`type itemType int`。Rob 强调,虽然这表面上类似于 C/C++ 的 `typedef`,但在 Go 语言中它是一个货真价实的新定义类型,无法直接与普通整数混用,从而提供了更强的静态类型安全,并允许在其上附加专有方法。 ```go type itemType int const ( itemError itemType = iota // 错误项,值为 0 itemDot // 字段操作符. itemEOF // 文件结束标志 itemElse // 关键字 else itemEnd // 关键字 end itemLeftMeta // 左定界符 {{ itemRightMeta // 右定界符 }} itemNumber // 数字字面量 //... ) ``` 在枚举常量的定义上,Go 的 `iota` 语法展现出了极简的工业美感。常量声明块的第一行写为 `itemError itemType = iota`,指示编译器开启枚举自增计数,随后的常量会自动依次获得递增的整型值(如 `itemDot` 为 1,`itemEOF` 为 2),且每个常量的底层类型都牢牢锁定为 `itemType`。除了常规的代码元素外,枚举列表中特别包含了 `itemError` 与 `itemEOF` 这类特殊标记。 ```mermaid flowchart TD accTitle: Item 结构与 String 方法打印逻辑 accDescr: 根据 itemType 分支判断输出格式,包括 EOF、错误项以及过长文本截断。 A["调用 item.String()"] --> B{"匹配 item.typ"} B -->|itemEOF| C["输出字符串 'EOF'"] B -->|itemError| D["直接输出由 val 携带的错误消息"] B -->|其他类型| E{"val 长度是否过长?"} E -->|超过限制| F["截断字符并追加 '...' 输出"] E -->|未超限制| G["原样格式化输出 (类型与字面值)"] ``` 紧接着,Rob 展示了如何利用 Go 的接口机制为词法项提供优雅的调试支持。Go 的 `fmt.Printf` 拥有一项独特性质:“Any type that has a method called String that returns string as a basic type is known to Printf and can be used by Printf so you get a default pretty print for that type value.” 只要为 `item` 结构体实现 `String() string` 方法,它便能自动被格式化打印。在 `String()` 的分支处理中隐藏着两个精妙的设计: 1. **错误传递技巧**:当类型为 `itemError` 时,词法扫描器会直接将人类可读的错误文本保存在该项的 `val` 字段中(即便这串文字并非来自模板源代码),打印方法直接将其原样输出,简化了错误状态流转; 2. **大文本防御性截断**:由于外部静态文本块可能长达上万字符,如果在调试时直接全量打印会导致终端刷屏,因此代码中加入了长度检测,对于超出限制的长字符串自动截断并追加省略号(`...`),保证调试输出紧凑清晰。 - 词法项(`item`)设计为包含 `typ itemType` 和 `val string` 两个字段,数值和标识符均以原生字符串形式暂存。 - `itemType` 依靠 `iota` 机制实现类型安全的自增枚举,避免了裸使用 `int` 带来的混淆隐患。 - 借由 Go 标准库约定的 `String()` 签名实现优雅打印,集成了错误文本承载和长文本自动截断保护机制。 ### [09:03](https://www.youtube.com/watch?v=HxaD_trXwRE&t=543s) 为什么不用现成工具:Lex 与正则表达式的局限性 一旦为 `item` 实现了格式化输出方法,就可以直接用 `fmt.Printf` 打印出整洁的词法项。但随之而来的核心问题是:如何对输入流进行分词(tokenization)?行业内有许多广为人知的方法,例如使用生成工具(如 Mike Lesk 最初编写、后来由实习期的 Eric Schmidt 重写的著名工具 Lex),或者使用正则表达式,抑或是通过状态、动作与 `switch` 语句手写状态机。Rob Pike 明确表示自己不会使用上述任何一种方案,并逐一分析了它们的不足。 首先针对词法分析生成工具(如 Lex),Rob Pike 澄清自己并不否定这类工具的价值,但他强调了工具常被忽视的缺陷:“在解析输入时,生成优质的错误信息非常重要,而工具往往让输出良好的错误信息变得比预期更加困难;在词法分析阶段,这尤其是一个棘手的问题。”此外,开发者不仅要学习工具本身,通常还得学习一门专门用来为工具编写规则的辅助语言。既然手中已经有了像 Go 这样功能完备的编程语言,为何还要倒退一步去学另一门语言?更严重的问题在于尺寸和性能。Lex 以针对极其简单的词法状态机生成极其庞大的数据结构而著称,因此在他看来,Lex 已经不再适合胜任现代任务(尽管像 Ragel 这样的后继者要优秀得多)。 针对正则表达式,Rob Pike 提到他在演讲前一周刚写过一篇相关博文,起因是在代码审查中有一位开发者试图使用正则表达式编写词法分析器。Rob Pike 指出正则引擎对于词法分析这样简单的任务来说“过于庞大且沉重”: - 正则表达式引擎庞大且复杂,必须在庞大的状态空间中进行评估。 - 正则引擎所求解的问题往往远比词法分析所需的复杂得多——开发者只需要判断下一个字符是什么,根本不需要去匹配 55 个可能存在的关键字。 - 正则表达式是非常动态、极具表现力且精美的机制(Rob Pike 本人也曾多次实现并十分喜爱正则),但词法分析语法是完全静态且已知的,引入动态匹配机制属于典型的“杀鸡用牛刀”(Overkill)。 ```mermaid flowchart TD accTitle: 传统词法分析方案的缺陷对比 accDescr: 对比词法生成工具与正则表达式在做词法分析时的核心劣势 subgraph Tools["词法分析生成工具 (如 Lex)"] T1["错误信息难以精细控制"] T2["需要额外学习 DSL / 工具专用语言"] T3["生成的数据结构庞大且运行缓慢"] end subgraph Regex["正则表达式 (RegEx)"] R1["引擎复杂,状态空间评估开销巨大"] R2["计算模型过重 (Overkill)"] R3["高度动态机制难以匹配静态词法需求"] end ``` --- ### [11:46](https://www.youtube.com/watch?v=HxaD_trXwRE&t=706s) 传统手写状态机的困境与突破:从 switch 转向状态函数 既然不用生成工具也不用正则,手写词法分析器便成了自然的选择。现代编程语言的词法结构极为相似,学会为一门语言编写分词器后,几乎可以直接套用到其他任何语言中。传统的手写做法通常是定义一系列状态(例如“在注释中”、“在普通文本中”、“在动作标签中”)以及对应的动作(如吸收字符直至数字末尾),然后用一个外层的 `switch` 语句包裹状态:根据当前状态跳转执行动作,动作消耗输入并返回一个新状态以及词法项。 Rob Pike 指出,这种典型的 `switch` 模型虽然简单直观,但极其单调乏味,且存在逻辑设计上的倒退:“当你从动作 2 返回并附带返回一个状态时,你必须退回到调用者,接着再次进入 `switch` 重新推导自己的位置;状态变量在此刻丢失了程序刚才所处的上下文。”明明刚退出动作 2 时已经清楚接下来该去状态 1,为何还要离开、重新进循环、再次做一遍条件判断,而不是直接跳转到状态 1? 为了彻底消除这个繁琐的调度损耗,Rob Pike 提出了将“状态”(State)与“动作”(Action)合二为一的优雅方案: 1. **状态的本质**:代表我们在输入中所处的位置,以及接下来预期会看到什么。 2. **动作的本质**:代表在该状态下针对特定输入所执行的具体操作。 3. **状态函数(State Function)**:执行该函数即执行了对应动作,执行完毕后,它的返回值直接就是下一个状态函数。 由此,Go 语言中诞生了一个极具美感的递归类型定义: ```go type stateFn func(*lexer) stateFn ``` Rob Pike 形容这个定义“有点令人脑洞大开(mindblower)”,因为一个状态函数的定义正是返回其自身类型的函数。通过将状态的推进直接交由函数指针维系,词法分析器的内部主循环被压缩成了仅有一行的极其纯粹的形式: ```go for state:= startState; state!= nil; { state = state(l) } ``` “原先的 `switch` 语句被折叠成了一行不断自我运行的代码:获取一个状态、调用它、得到新状态、再次调用它……程序计数器(PC)永远精确地指向我们下一步要去的地方。” --- ### [15:41](https://www.youtube.com/watch?v=HxaD_trXwRE&t=941s) 引入并发模型:基于 Channel 的词法分析器架构 将整个词法分析器折叠进单行 `state = state(l)` 循环之后,随之暴露出了一个明显的工程问题:在纯粹的状态流转中,根本看不到向外发射(emit)Token 的机制。如果外部的解析器(Parser)需要获取词法项,应该如何与这套闭环的状态机交互? Rob Pike 在此展示了 Go 语言原生并发能力的威力。传统架构通常让解析器主动调用 `lex.nextToken()`,而 Rob Pike 选择将词法分析器设计为一个与解析器并行运行的协程(Goroutine): ```mermaid flowchart LR accTitle: 词法分析器与语法解析器的并发管道模型 accDescr: 展示词法分析器如何通过 Go Channel 将 Item 传递给解析器 subgraph LexMachine["词法分析协程 (Lexer)"] L1["状态循环: state = state(l)"] L2["扫描字符并构造 Item"] end subgraph Comm["通信桥梁"] CH["chan item (类似 Unix Pipe)"] end subgraph ParseMachine["语法解析协程 (Parser)"] P1["从通道接收 Token"] P2["构建 AST / 语法树"] end L1 --> L2 L2 -->|"发射词法项 (lob over the wall)"| CH CH -->|"接收并驱动解析"| P1 P1 --> P2 ``` 词法分析器和解析器被拆分为两个完全独立的实体。词法分析器专注遍历输入并发射词法项,每当构造出一个新的 `item` 时,直接借助 Go 的 `channel` 将其“隔墙扔给”解析器。Rob Pike 将这种通道比喻为带有更严格语义的 Unix 管道(Pipe)。在具体的数据结构定义中,`lexer` 结构体聚合了所有内部解析状态,而最为关键的对外出口正是一个通道字段: - `items chan item`:作为词法分析器向解析器输送数据的管道通道。 在工厂函数的早期版本中,创建词法分析器的函数会同时返回 `*lexer` 指针与 `chan item`。Rob Pike 坦承这种 API 显得有些怪异,但强调“这是真实生产环境下的早期代码,后续会逐步对其进行修正与重构”,从而为下一步完整展示字符扫描与并发通道结合的具体代码埋下了伏笔。 ### [17:35](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1055s) 启动词法分析器与并发通道通信 Rob Pike 讲解了词法分析器的启动函数 `lex`。该函数接收模板名称和输入字符串作为参数,创建 `lexer` 结构体并初始化相关字段。在 Go 语言中,结构体初始化只需显式填写关心的字段,其余未填字段均会自动赋予零值。随后,Rob Pike 指出核心逻辑所在的语句:通过 `go l.run()` 启动一个独立的并发执行流。 ```mermaid flowchart LR accTitle: 词法分析器并发运行与管道交互 accDescr: 描述词法分析器在独立的 goroutine 中运行并通过 channel 将 token 发送给语法解析器的流程 subgraph S1["并发执行流 (Goroutine)"] A["词法分析器 run()"] -->|"遍历状态"| B["状态函数 (stateFn)"] B -->|"emit(item)"| C["items channel"] end subgraph S2["调用方主线程"] C -->|"接收 token"| D["语法解析器 (Parser)"] end ``` 此时状态机作为独立的 goroutine 与调用者并行运行,随后 `lex` 函数立即向调用方(通常是语法解析器 parser)返回构造好的词法分析器实例。解析器接着开始解析,并通过通道(channel)持续接收由后台运行器投递过来的词法单元(lexemes)。随后他展示了真正的 `run` 方法实现,强调这段代码真实不带半点水分:它首先设定初始状态为普通文本状态 `lexText`,接着进入 `state = state(l)` 循环不断执行状态函数,并在循环终结时调用 `close(l.items)` 关闭通道,明确通知语法解析器不会再有后续 token。 “Notice in Go you don't only have to fill in the ones you care about; the rest will be initialized to zero, and then this line here is where the magic starts: `go l.run()`.” - 启动函数 `lex(name, input string) *lexer` 负责实例化并派发 goroutine。 - 真实的 `run` 方法以 `lexText` 为起始状态,并在状态循环结束后关闭 `items` 通道。 ### [19:11](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1151s) 游标管理与词法单元发射机制 (`emit`) 为了将切分出来的 token 传送回调用者,Rob Pike 解释了 `lexer` 内部控制扫描位置的两个核心整型游标:`start` 与 `pos`。尽管他开玩笑说这两个名字算不上特别优雅,但含义极其明确。扫描沿字符串单向推进时,`start` 标记当前正在扫描(即将发射)的 token 起始偏移量,而 `pos` 则是当前扫描器所探查到的最新字符位置。两者之间的子切片 `input[start:pos]` 便构成了完整的词法单元。 ```mermaid flowchart TD accTitle: Token 扫描与发射切片示意图 accDescr: 说明 input 字符串中 start 和 pos 游标如何界定词法单元并在 emit 时更新游标 subgraph Slice["输入字符串切片"] T["... 已处理..."] --- S["start"] S --- W["当前待发射词法单元 (Token)"] W --- P["pos"] P --- R["... 未处理输入..."] end W -->|"emit(itemType)"| CH["l.items 通道"] CH -->|"推进游标"| UP["start = pos"] ``` 在 `emit` 方法中,接收一个 token 类型参数 `itemType`,随后使用 Go 语言的通道发送操作符 `<-` 将构造好的 `item` 推入 `l.items` 通道中。完成向解析器“越墙投掷”token 的动作后,词法分析器只需执行 `start = pos` 将起始点移动到当前位置。Rob Pike 生动地将该流程比喻为一路快跑扫描:“扫描、扫描、扫描,啊哈!这里有个 item,把它扔过围栏,接着处理下一个再扔过去,这就是整个运作模型。” - `input[start:pos]` 确立了当前词法单元的文本范围。 - `l.items <- item{typ, l.input[l.start:l.pos]}` 将切分后的数据投递到通道。 - 投递后执行 `l.start = l.pos` 完成滑动窗口更新。 ### [20:26](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1226s) 文本状态扫描与定界符匹配 (`lexText` 与 `lexLeftMeta`) 在明确了游标与发射机制后,Rob Pike 回顾了初始状态 `lexText` 的具体实现细节。词法分析器首要任务是寻找动作定界符(即模板标记的左双大括号 `{{`,在代码中定义为常量 `leftMeta`)。`lexText` 函数内部使用 `for` 循环不断步进输入,如果在当前位置 `pos` 遇到了左定界符,且 `pos > start` 说明之前累积了非空的纯文本内容,就会立即调用 `emit(itemText)` 将其作为普通文本 token 发送给解析器。 ```mermaid flowchart TD accTitle: 状态转移流程:纯文本到动作块 accDescr: 展现从扫描普通文本到识别左定界符并进入动作块的状态转移 T["lexText 状态"] -->|"未见 leftMeta"| T T -->|"发现 leftMeta"| ET["emit(itemText)"] ET -->|"返回新状态"| LM["lexLeftMeta 状态"] LM -->|"pos += len(leftMeta)"| ELM["emit(itemLeftMeta)"] ELM -->|"返回新状态"| IA["lexInsideAction 状态"] ``` 发出文本之后,`lexText` 并不直接在当前函数里拆解定界符,而是返回一个新的状态函数 `lexLeftMeta`。“Here's a state function, and it returns a state function.” Rob Pike 解释道,`lexLeftMeta` 的工作极其纯粹:因为前置判断已经确认定界符的存在,它直接使 `pos += len(leftMeta)` 跳过两个大括号,紧接着调用 `emit(itemLeftMeta)` 抛出定界符 token,然后将状态自然切换到 `lexInsideAction`,正式步入动作块内部。 - 模板中普通文本与模板动作的交界处由常量 `leftMeta` 触发判定。 - 每个状态函数各司其职,`lexText` 只管纯文本,识别到定界符后将控制权交由 `lexLeftMeta`。 - 文本扫描遭遇 EOF 的处理机制十分整洁,不会干扰主逻辑状态跳转。 ### [23:04](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1384s) 动作块内部状态分支调度 (`lexInsideAction`) 进入动作块内部后,词法分析面对的是更为复杂多变的语法元素。Rob Pike 展示了 `lexInsideAction` 的实现,指出这非常具有手写词法分析器的代表性:由于程序无法预知接下来会遇到数字、标识符还是字符串,因此需要通过单字符窥视来展开一系列多路分支提问。 首先检查是否遇到闭合定界符 `rightMeta`,若匹配成功则返回 `lexRightMeta` 准备退回到纯文本逻辑。若未闭合,则调用辅助方法 `l.next()` 读取下一个字符(Rune)并做模式匹配:遇到 EOF 或换行符直接返回报错,因为模板系统不允许动作块跨行;遇到空白字符则直接忽略跳过;遇到管道符 `|` 则做相应处理;遇到双引号 `"` 返回 `lexQuote`;遇到反引号 ``` ` ``` 则切换到 Go 特有的原始字符串状态 `lexRawQuote`。当读到加号 `+`、减号 `-` 或数字字符时,表明扫描器已经迈入了数值常量的第一个字符,此时只需调用 `backup` 后退一步,接着转移到 `lexNumber` 状态;同理,遇到字母时同样退回一步并转移到标识符状态。 “And compared to what a regular expression does to work this out, it's actually in some senses simpler; of course there's more code, but it's really nice how you just sort of pick a one character, what do I do now, I move on.” - 模板系统强制规定动作块不得跨换行符存在,否则触发语法错误 `l.errorf`。 - 通过识别首字符并在状态跳转前执行 `backup` 回退,实现了优雅的分支预测与状态衔接。 ### [25:14](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1514s) 字符级辅助工具函数:`next`、`ignore` 与 `backup` 为了支撑上述状态函数的高效切换,Rob Pike 深入解释了底层的几个关键辅助函数。首先是 `next()`,它负责从输入流提取下一个字符。在 Go 语言中,这被称为 `rune`,因为它代表经过完整 UTF-8 解码的 Unicode 码点,而不仅仅是单个字节。`next()` 在读取到字符串末尾时返回一个代表 EOF 的带外特殊符;否则利用 UTF-8 解码提取字符,依该字符的字节宽度相应推进 `pos` 游标,并将读到的 `rune` 返回给调用方。 此外还有两个操作游标极简却强大的辅助工具: 1. `ignore()`:直接执行 `l.start = l.pos`。当在动作块中遇到无意义的空格或间隔符时,直接调用该函数将起始游标同步推进,丢弃无用字符。 2. `backup()`:作为 `next()` 的逆操作,将 `pos` 游标按当前字符的宽度向后回退。Rob Pike 强调,正是由于 `next` 负责吞入字符判断类型,当判定属于数字或标识符时,`backup` 能够立即撤销这单步移动,使得专门的状态函数(如 `lexNumber`)能够从该 Token 的首个字符处重新干净地开始解析。 - Go 语言中使用 `rune` 来完整支持 UTF-8 字符解码。 - `ignore` 通过重设起始索引 `start = pos`,不发送任何 token 即可丢弃空白字符。 - `backup` 提供了单字符回退能力,配合状态机在关键分支处无缝平移。 ### [026:29] 基础光标移动:backup 与 peek Rob Pike 介绍了词法分析器用于在输入流中调整读取位置的关键辅助方法。词法分析器的 `next` 方法在前进时会自动记录读取的字符宽度(width),因此当分析器读取过头时——比如本来并不想步入某个数字字符——执行回退极为简便:只需调用 `backup`,将内部位置 `pos` 减去刚记录的宽度即可。正如 Rob Pike 所言:“Oops, nope, that was wrong, back up.”(“哎呀,不对,读错了,退回去。”) 与此配合的是许多同类文本处理软件中常见的 `peek` 方法。它的核心需求是:“我不打算真正向前推进,但我必须提前知道接下来是什么。”在当前的词法分析器架构下,实现 `peek` 异常平凡:只需调用一次 `next` 读取下一个 rune,紧接着立即调用 `backup` 退回一步。这种组合虽然简单,却赋予了分析器无损向前窥探单个字符的能力,为后续构建更高级的匹配逻辑铺平了道路。 ### [027:06] 字符接收器:accept 与 acceptRun 拥有了基础的位置游标操作后,Rob Pike 引入了两个强大的字符接收器(acceptor)方法,用以极为干净地扫描复杂的文本片段。第一个方法是 `accept`,它是绑定在 `lexer` 上的一个方法。调用方会向它传入一个包含合法字符集的字符串(例如一串纯数字或一组字母),询问当前输入中的下一个字符是否属于这个字符集。其内部通过 `strings.IndexRune` 来判断下一个字符是否存在于指定字符串中。如果匹配成功,字符被正式消费并返回 `true`;如果匹配失败,说明读取超出了预期范围,分析器会自动调用 `backup` 撤销这一步操作并返回 `false`。 第二个辅助方法是 `acceptRun`。它的参数与 `accept` 相同,但内部置于一个 `for` 循环中,意图是“尽可能多地吸收匹配字符”——例如直接吃掉一整串连续的数字或连续的英文字母。在当前的模板词法分析器实现中,`acceptRun` 甚至不需要返回值,只要持续贪婪地循环吸收合法字符即可;不过在其他场景下,也可以让其返回是否匹配到了任何内容。这两个接收器极大地简化了复杂的匹配逻辑,免去了手写大量条件分支和位置计算的麻烦。 ### [028:17] 解析数字常量与解析器的分工协作 为了展示 `accept` 与 `acceptRun` 的威力,Rob Pike 以数字的词法分析为例。数字的解析实际上相当棘手:它涵盖十进制、八进制、十六进制,还包括带有小数点或不带小数点的浮点数、正负符号、正负指数以及各种变体。Rob Pike 调侃道,如果试图用正则表达式来完整匹配所有数字形式,“你可以试着写写看,写出来的表达式大概有这么长,会让你大吃一惊”。而在本词法分析器中,由于底层机制一直在通过 `pos` 指针自动追踪切片范围,代码根本不需要手动维护提取出的子串,只需要一路找到数字的边界即可。 扫描数字的完整流程如同流水线般优雅推进:首先调用 `accept("+-")` 吸收可能存在的前置正负号;接着默认将候选字符集设为十进制数字;随后调用 `accept("0")` 与 `accept("xX")` 探测是否为十六进制,若成立则将字符集切换为十六进制的 `0-9a-fA-F`;紧接着调用 `acceptRun` 贪婪吸收整串基数对应的数字。在此之后,若能通过 `accept(".")` 接收到小数点,则继续吸收小数点后的数字;若能接收到指数符号 `eE`,则继续处理其符号与后续指数数字。Go 语言还原生支持虚数常量,因此末尾还尝试调用 `accept("i")` 吸收虚数单位。当到达数字的最长边界后,分析器还会做一项错误校验:紧随其后的下一个字符绝不能是字母数字字符,必须是空格或标点等合法分隔符,否则就属于非法语法。 ```mermaid flowchart TD accTitle: 数字词法分析流程 accDescr: 展示 Lexer 扫描数字字面量时依次调用 accept 与 acceptRun 处理符号、进制、小数、指数及虚数后缀的完整逻辑。 subgraph SignAndBase["1. 符号与基数探测"] A["进入 lexNumber"] --> B["accept('+-')<br/>可选正负号"] B --> C{"探测 0x/0X?"} C -->|"是"| D["基数设为十六进制<br/>acceptRun('0-9a-fA-F')"] C -->|"否"| E["基数设为十进制<br/>acceptRun('0-9')"] end subgraph Parts["2. 浮点、指数与虚数"] D --> F["accept('.') 探测小数"] E --> F F --> G["accept('eE') 探测指数"] G --> H["accept('i') 探测虚数单位"] end subgraph ValidationAndEmit["3. 校验与发射"] H --> I{"下一个字符是否为<br/>合法边界标点/空白?"} I -->|"否 (仍为字母数字)"| J["l.errorf 报错"] I -->|"是"| K["emit(itemNumber)"] K --> L["返回 lexInsideAction 状态"] end ``` Rob Pike 特别强调了词法分析器(lexer)与语法解析器(parser)之间的合理分工:当前逻辑确实可能匹配出并非合法常量的字符串(例如十六进制中带有浮点指数形式的 `0x3e4`)。但他明确指出:“It's fine for a lexer to say, 'I think I know what this is,' and still the parser to validate it.”(“词法分析器说‘我觉得我知道这是什么’,并留给解析器去验证,这是完全没问题的。”)词法分析器的职责只是负责找出最大长度的潜在数字串,然后将其发射为 `itemNumber`,直接交由 Go 标准库中现成的数值转换函数去严格校验。一旦发射完成,状态函数将返回 `lexInsideAction`,让状态机继续在动作内部运转。 ### [032:10] 优雅的错误状态与终止机制 随后 Rob Pike 剖析了代码中的错误处理设计。在状态函数中,报错并不是抛出异常,而是通过 `return l.errorf(...)` 来完成。因为任何状态函数都必须返回一个状态函数类型(`stateFn`),所以这里的 `errorf` 本身也设计成了一个返回 `stateFn` 的函数。`errorf` 的接口形式类似于 `fmt.Printf`,接收格式化字符串与变长参数(即 `interface{}`,Rob Pike 类比为通用对象或 C 语言的 `void *`),能够输出包含出错上下文文本的高质量错误信息。 在 `errorf` 内部,它会将构造好的 `itemError` 与格式化文本发送到 `items` 通道中,随后关键的一步是直接返回 `nil`。由于前文定义的词法状态机在当前状态变为 `nil` 时会自动终止循环,返回 `nil` 意味着词法分析器彻底关闭停机。Rob Pike 强调,他坚信极佳的错误提示至关重要,而这种设计提供了一种极简且优雅的报错路径。对于模板扫描而言,一旦遇到语法错误,停下来正是最合理的选择,它完美契合了当前的并发状态模型。 - `errorf` 具有类似 `printf` 的格式化签名,通过 `items` 通道发射 `itemError`。 - `errorf` 执行完毕后返回 `nil`,使主循环 `for state!= nil` 自然退出并关闭状态机。 - 采用提前探测错误并生成携带上下文文本的错误信息,免去下游解析器猜测错误原因的负担。 ### [033:39] 初始化阶段的并发死锁困境 在总结这套词法分析器的构建体验时,Rob Pike 表示自己仅用了一个晚上(甚至更短的时间)就完成了原型。在推翻并丢弃了前几种令人不快的实现方式后,一旦将词法分析与解析器之间的结构性不匹配问题视作并发问题来解决,通过 Go 语言切片、状态函数闭包和通道,一切都变得异常顺畅且富有乐趣。然而,这套自鸣得意的设计却遭遇了一个致命现实问题:Go 语言的包初始化规范(package initialization)。 在真实的 Web 场景中,开发者通常希望将 HTML 模板声明为全局变量,并在程序启动的 `init` 阶段完成模板解析,以便服务启动后立即可用。然而,Go 语言为了维持清晰确定、没有歧义的包初始化语义,做出了非常严格的语言规范决策:禁止在初始化函数执行期间运行并发的 goroutine 直至其完成。Rob Pike 严肃地解释了这一规则背后的权衡:“It was a difficult decision, but we decided you just simply cannot run a goroutine to completion during initialization. You can create one, but it won't run — it doesn't run until initialization is done.”(“这是一个艰难的决定,但我们最终决定:在初始化期间,你绝不能让一个 goroutine 运行直到完成。你可以创建一个 goroutine,但它不会运行——直到初始化全部完成它才会跑。”) 这就导致了严重的冲突:由于当前的词法分析器严重依赖后台独立 goroutine 与解析器通过通道并发通信,如果在包全局变量初始化(或 `init` 函数)中解析模板,词法分析器的 goroutine 根本不会被调度执行,通道读取将陷入永久阻塞与死锁。这一限制险些彻底推翻“并发词法分析”的实用价值,但他随即安抚听众不必担心:这个问题不仅有解,而且解决起来出奇地容易。 ### [35:25](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2125s) 移除显式并发:封装传统的 NextItem API Rob Pike 谈到,可能有人会觉得大费周章设计了如此优美的并发模型,现在却要“把并发拿掉”听起来很糟糕。但实际上,只通过极少的代码改动就能把原先基于 channel 的词法分析器改造成传统的词法分析 API(即调用者只需反复调用一个函数来获取下一个 token,完全不需要关心 channel)。在改造过程中,构造函数 `lex` 不再直接把 channel 返回给调用方,而是返回词法分析器本身的句柄(handle)。在内部,程序依然创建了一个 channel,但将其隐藏起来并加上了缓冲(buffering)。通过给 channel 添加两三个单元的缓冲容量,它实质上变成了一个环形缓冲区(ring buffer):词法分析器可以向其中 emit 若干 token,稍后再自行读取,从而摆脱了原本严格的同步限制。 ```mermaid flowchart TD accTitle: 传统 nextItem API 执行流 accDescr: 展示 nextItem 函数内部通过 select 消费 channel 并在无就绪 token 时驱动单步状态机的逻辑流程 subgraph API["nextItem() 内部循环"] Start(["调用 nextItem()"]) --> Sel{"select 多路监听"} Sel -->|"channel 中已有就绪 item"| Ret["直接取出并 return item"] Sel -->|"default: channel 为空"| Step["执行单步状态函数: state = state(l)"] Step --> LoopCheck{"是否有 token 吐出到 channel?"} LoopCheck -->|"已生成 token"| Sel LoopCheck -->|"未生成(继续循环)"| Sel end ``` 为了让外部解析器(parser)能够按照传统方式拉取 token,Pike 引入了 `nextItem` 方法。虽然表面上它替代了原本常驻后台的 `run` 循环,但内部运行机制完全相同,只是进行了解构:在一个无限循环(`for {}`)内放置一个 `select` 语句。如果内部的 item channel 中已经有词法分析好的 token,`select` 分支立即将其读出并返回给调用者;如果 channel 为空,则走 `default` 分支,在该分支下驱动状态机向前推进单步迭代(`state = state(l)`)。如果这次推进没有生成 token,循环继续,`select` 再次走 `default` 推进状态机,直到成功生成 token 为止。 Rob Pike 称赞这段实现说:“So it's kind of magic this is sort of the most magical slide of the ones I'm showing you but if you don't understand this that's okay all I want to show you is that that's all that was required to remove the concurrency from the picture.” 外部使用者看到的只是一个再普通不过的 API:创建一个词法分析器,并在循环中调用 `nextItem` 直至遇到 `EOF`;然而在底层,内部依然保留着利用并发思想构建出的干净、清晰的架构。 --- ### [38:28](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2308s) 并发作为设计手段与模板系统的演进 Rob Pike 强调,如果一开始就从编写 `nextItem` 这个 API 出发,开发者很可能写不出这么优雅的词法分析器。传统方式通常需要使用庞大的 `switch` 语句,每次重新进入函数时都必须痛苦地做状态恢复(state recovery)、判断当前所处位置并不断重启。而利用并发与状态函数的设计,重启不过是将状态机稍作不同形式的运转,状态函数原本的清晰度与表达力完全得以保留。 Pike 由此引出了关于并发的核心观点:“Concurrency is a design approach it's not about parallelism concurrency enables parallelism doesn't require it it's really about thinking about your problem as independently executing items that may run at the same time or not but conceptually each one is an independently executing item.” 他幽默地指出,这里用来解决结构失配(structural mismatch)的理论来自于计算机科学家 Michael Jackson,“顺便说一句,他并不是那位音乐家,以免你们以为是同一个人。” 并发不是灵丹妙药,但它带来了一种优雅的设计维度;结合 Go 语言的方法与面向对象特性,使得整个架构具有极强的适应性。演讲中所展示的词法分析器代码其实是他从版本库里翻出的第一天写的早期版本,随着模板语言在边设计边开发的过程中增加大量功能与 token 类型,每次调整都仅仅是修改一两行代码或增加一个两行的状态函数,这种扩展性是旧版模板系统所完全不具备的。 - 总结寄语:“Lexers are fun concurrency is fun and go is a lot of fun so I encourage you to play around with it.” - 官方资源与版本计划:所有 Go 代码与相关信息均托管在 `golang.org`。演讲中介绍的新模板系统将在下一个版本中取代旧系统,旧系统已被废弃(deprecated)。 --- ### [41:04](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2464s) 问答环节:构建产物、性能开销与状态机步进 进入问答阶段后,现场观众就构建产物形态、执行性能以及并发执行细节提出了具体问题: 一位观众询问编译输出的形式,比如在.NET 场景下它是否表现为可引用的库文件。Rob Pike 回答,Go 通常编译为静态链接的独立二进制文件(statically compiled binary),其性能特征是编译型语言而非解释器。词法分析器则是作为标准库代码链接进程序中。Go 官方支持多种 CPU 架构和操作系统,当时社区也有人在开发面向.NET 的实现,但 Go 的核心定位始终是高效的静态编译型语言。 另一位观众询问该词法分析器是否有性能测试数据(performance stats)。Pike 坦承自己在开场前就料到会有人问性能,但他目前还没有做基准测试: > “The answer is it's probably okay but not great because I'm using the language a little too having a little too much fun with the language and doing the channel communication and and that kind of stuff actually puts more overhead into the inner loop than that needs to be there.” 他进一步分析,如果追求极致性能,内部循环中由 channel 通信带来的开销是可以被进一步优化的;不过状态函数本身的性能在理论上已经非常接近最优解。唯二能比它更快的做法只有手写状态机、利用数组查表并跳转函数指针,但结构本质其实相差无几。 针对取消外部 goroutine 后的执行机制,另一位观众提问如果存在多个处理阶段,能否重新把 goroutine 加回来在初始化外部运行,以及 `nextItem` 是否会在没有 token 时发生阻塞。Pike 解释道,在模板解析阶段必须让词法分析执行完毕以构建解析树,不可能将其无限期搁置。至于 channel 缓冲大小,数字 `2` 是一个很精妙的设计(magic number),因为在当前实现中,词法分析器单次调用最多只会吐出两个 token;虽然将缓冲区设置得更大也完全可行,但没有必要。在调用 `nextItem` 时,词法分析器在生产出所需 token 前会持续运转,若是跨 goroutine 通信,在未获得下一个 token 时确实会等待阻塞;如果把 channel 缓冲区设得极大,词法分析器确实可以跑到很远之前,但在当前场景下并没有超前执行的必要。 ### [44:32](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2672s) 并发与线性的执行模型 Rob Pike 在回答现场观众前强调了当前词法分析器(lexer)的运行特性。虽然通过 goroutine 和 channel 实现了结构上的解耦,但整个设计完全是同步的,因此根本不存在复杂的调度问题。从底层的控制流来看,它始终是单线程且线性执行的:词法分析器吐出一个 token 就会停下来等待解析器(parser)读取,解析器需要 token 时才会推进词法分析器。这种模式属于并发(concurrency)而非并行(parallelism),线程无需频繁切换上下文。 ```mermaid flowchart LR accTitle: 词法分析器与解析器的同步控制流 accDescr: 展示词法分析器与解析器通过无缓冲 Channel 实现严格同步的交替线性执行 subgraph LexerSide["词法分析器 (Goroutine)"] L1["运行状态函数 stateFn"] L2["向 Channel 发送 item"] end subgraph ParserSide["解析器 / 客户端"] P1["从 Channel 接收 nextItem()"] P2["处理抽象语法树 AST / 逻辑"] end L1 --> L2 L2 -->|"阻塞等待接收"| P1 P1 --> P2 P2 -.->|"请求下一个 Token"| L1 ``` 随后主持人转达了来自 IRC 聊天室的提问:是否可以放弃 channel,改用列表(list)或向量(vector)将所有 token 收集起来?Rob Pike 透露,在他写完这套代码后,同事 Nigel Tao 确实提交过一个修改清单(Changelog / CL),把 channel 换成预存列表,这样能消除可能的微小性能开销。“The solution gets pretty because you can use concurrency to solve the problem and there's nothing inherently concurrent about the problem only the solution,” Rob Pike 明确指出。问题本身并没有并发属性,但引入并发能让代码设计变得优雅;如果未来遇到极其苛刻的性能瓶颈,他也会毫不犹豫地手写约 10 行代码实现一个环形缓冲区(ring buffer)。 现场有观众询问整个分析流程中输入文本被拷贝了多少次。Rob Pike 斩钉截铁地回答是“零次”。整个词法分析器接收一个原始字符串,后续所有传递给解析器的 token 都是基于原字符串的切片(slice)。即使输入包含数兆字节(MB)的纯文本而没有任何模板标记,Go 也绝不会复制这几兆字节的数据,切片操作开销极小且无内存拷贝。 - 内存开销极低:词法分析器对输入文本实现零拷贝(zero-copy),仅通过底层字符串切片(string slicing)传递 token 内容。 - 架构权衡:用并发通道传递 token 主要是为了代码结构的优雅与清晰;若要极致性能,可无缝替换为手写的环形缓冲区(ring buffer)。 ### [46:39](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2799s) 拓展支持 io.Reader 与 Go 语言的设计哲学 现场观众接着提问,如果要让词法分析器支持 `io.Reader` 接口而不是预先读取好的字符串,需要改动多少工作量。Rob Pike 解释说这非常容易实现:`io.Reader` 是 Go 语言中表示任何可读流(如文件、网络连接、内存缓冲区)的标准接口。若要改为流式驱动,只需在词法分析器结构体中增加相应的字段,并改写内部的 `next()` 方法去读取流。虽然在流上实现字符回退(backup)可能会稍显繁琐,但并不困难。在专注小模板解析的 `template` 包中,直接传字符串足以胜任;若用于通用正则表达式扫描器,基于 `io.Reader` 就会合理很多。 谈及这种设计是否会推广到 Go 标准库的其他解析器(如 XML、HTTP 或日期解析)时,Rob Pike 表示目前没有专门针对这些进行重构,但他提到了前一周的轶事:有人在博客上写文章用正则表达式去解析 HTML,结果被他“迎头痛击”(Smackdown)。值得称赞的是,那位作者认真接受了意见并修正了实现方式。 关于为何选择这个主题做分享,Rob Pike 总结道,词法分析虽然是一个冷门的极客问题(“Not very many people write lexers for a living”),但这套代码完整展现了地道的 Go 语言风格(Idiomatic Go): “It's not clear that it's the solution to world hunger, but it's a solution to Lexing my templates,” Rob Pike 幽默地解释道。它巧妙融合了适度的并发、小巧的面向对象封装、灵活的字符串操作以及方法与一等函数(first-class functions)的协作。 - 适配扩展:只要将内部读取字符的 `next` 逻辑绑定至 `io.Reader` 接口,就能以极小的改造成本支持流式输入。 - 核心设计元素:兼顾了函数作为状态(state functions)、goroutine 同步解耦、无类型转换的多态调用。 ### [48:39](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2919s) 语法分析生成器对比与事件监控 一位观众探讨了该技术是否可拓展用于语法分析生成器(parser generator),让工具自动生成类似的 Go 代码。Rob Pike 认为理论上完全可行,因为词法分析器和语法分析器本质上都是状态机。但他指出两者的复杂度不在同一个数量级:当前的模板词法分析器大约只有 10 到 15 个状态函数,而一个通用的语法分析器通常拥有数百个状态,纯手工编写会产生大量模版样板代码(boilerplate),更适合交由生成器生成。他还提到了状态机编译器 Ragel,指出 Ragel 生成的代码在底层逻辑上与这种状态机模型同构,只是机器生成的跳转更晦涩难懂。 随后观众追问:若处理非常大的文件,如何向外发送进度更新(progress updates)或事件通知,甚至将某些内容写入磁盘?Rob Pike 指向了幻灯片中的并发 `select` 语句。借助 `select` 的多路复用能力,仅需增加大约四行代码,就可以增加一个信号通道: - 外部可在任意时刻“ping”词法分析器以轮询当前处理偏移量; - 或者让词法分析器在主循环中设置计数器,每处理 1KB 或 10KB 自动向通道推送一次进度通知。 至于在特定条件下将数据写入文件,Rob Pike 笑着表示 Go 是完整的通用编程语言,随时都能执行写文件操作,“Files are cool, underrated.” 分享进入尾声时,Rob Pike 看了一下时间,突然向全场观众致歉:由于出现了极其糟糕的日程冲突(scheduling conflict),他在半小时前(讲座刚开始时)本该准时出席另一场重要安排,因此不得不立刻离场,演讲在匆忙而热烈的氛围中结束。 ## Notable quotes > [38:28](https://www.youtube.com/watch?v=HxaD_trXwRE&t=2308s) Concurrency is a design approach it's not about parallelism concurrency enables parallelism doesn't require it it's really about thinking about your problem as independently executing items that may run at the same time or not but conceptually each one is an independently executing item. — Rob Pike > [09:03](https://www.youtube.com/watch?v=HxaD_trXwRE&t=543s) 在解析输入时,生成优质的错误信息非常重要,而工具往往让输出良好的错误信息变得比预期更加困难;在词法分析阶段,这尤其是一个棘手的问题。 — Rob Pike > [28:17](https://www.youtube.com/watch?v=HxaD_trXwRE&t=1697s) It's fine for a lexer to say, 'I think I know what this is,' and still the parser to validate it. — Rob Pike ## Mentioned Rob Pike, Michael Jackson, Go, Google, Google Technology User Group, GTUG, Lex, Mike Lesk, Eric Schmidt, Ragel, text/template, Nigel Tao, Unix ## Video description Lexical Scanning in Go, a talk by Rob Pike at Google Technology User Group given on Tuesday, 30 August 2011. The slides: http://rspace.googlecode.com/hg/slide/lex.html [Source](https://www.youtube.com/watch?v=HxaD_trXwRE)

Source quotes

[38:28] Rob Pike: Concurrency is a design approach it's not about parallelism concurrency enables parallelism doesn't require it it's really about thinking about your problem as independently executing items that may run at the same time or not but conceptually each one is an independently executing item. [9:03] Rob Pike: 在解析输入时,生成优质的错误信息非常重要,而工具往往让输出良好的错误信息变得比预期更加困难;在词法分析阶段,这尤其是一个棘手的问题。 [28:17] Rob Pike: It's fine for a lexer to say, 'I think I know what this is,' and still the parser to validate it.